
概述
AI服務所依賴的機器學習技術發展離不開資料、演算法和算力三大要素。阿里雲AI加速解決方案憑藉領先的資料集和GPU加速器,協調資料密集型應用,最佳化GPU執行個體利用率,加速AI模型訓練和推理任務。您還可以使用阿里雲可定製的雲原生AI訓練平台,根據業務需求進行定製,提升AI基礎設施效率和日常營運水平。
下載白皮書方案亮點
-
高性價比原子加速
藉助極速GPU加速器 AIACC 加速AI模型訓練與推理,據 Stanford DAWN深度學習基準測試,AI訓練模型加速70%,推理加速2-3倍,同時降低成本。
-
高效GPU利用
藉助GPU叢集調度共用同一 GPU 的資源,提升叢集內所有GPU的利用率,並通過GPU隔離機制徹底消除應用間的相互幹擾
-

CNCF認證的資料集加速器
藉助面向資料密集型應用的分布式資料集編排與加速器 Fluid,解決AI訓練中的高訪問延遲、多資料來源並行訪問複雜及資料隔離薄弱等問題。
-
可定製AI訓練平台
利用 阿里雲-Native AI Suite 構建和定製雲原生AI訓練平台,提供開發與營運控制台,提升深度學習全流程的AI工程效率。
工作原理
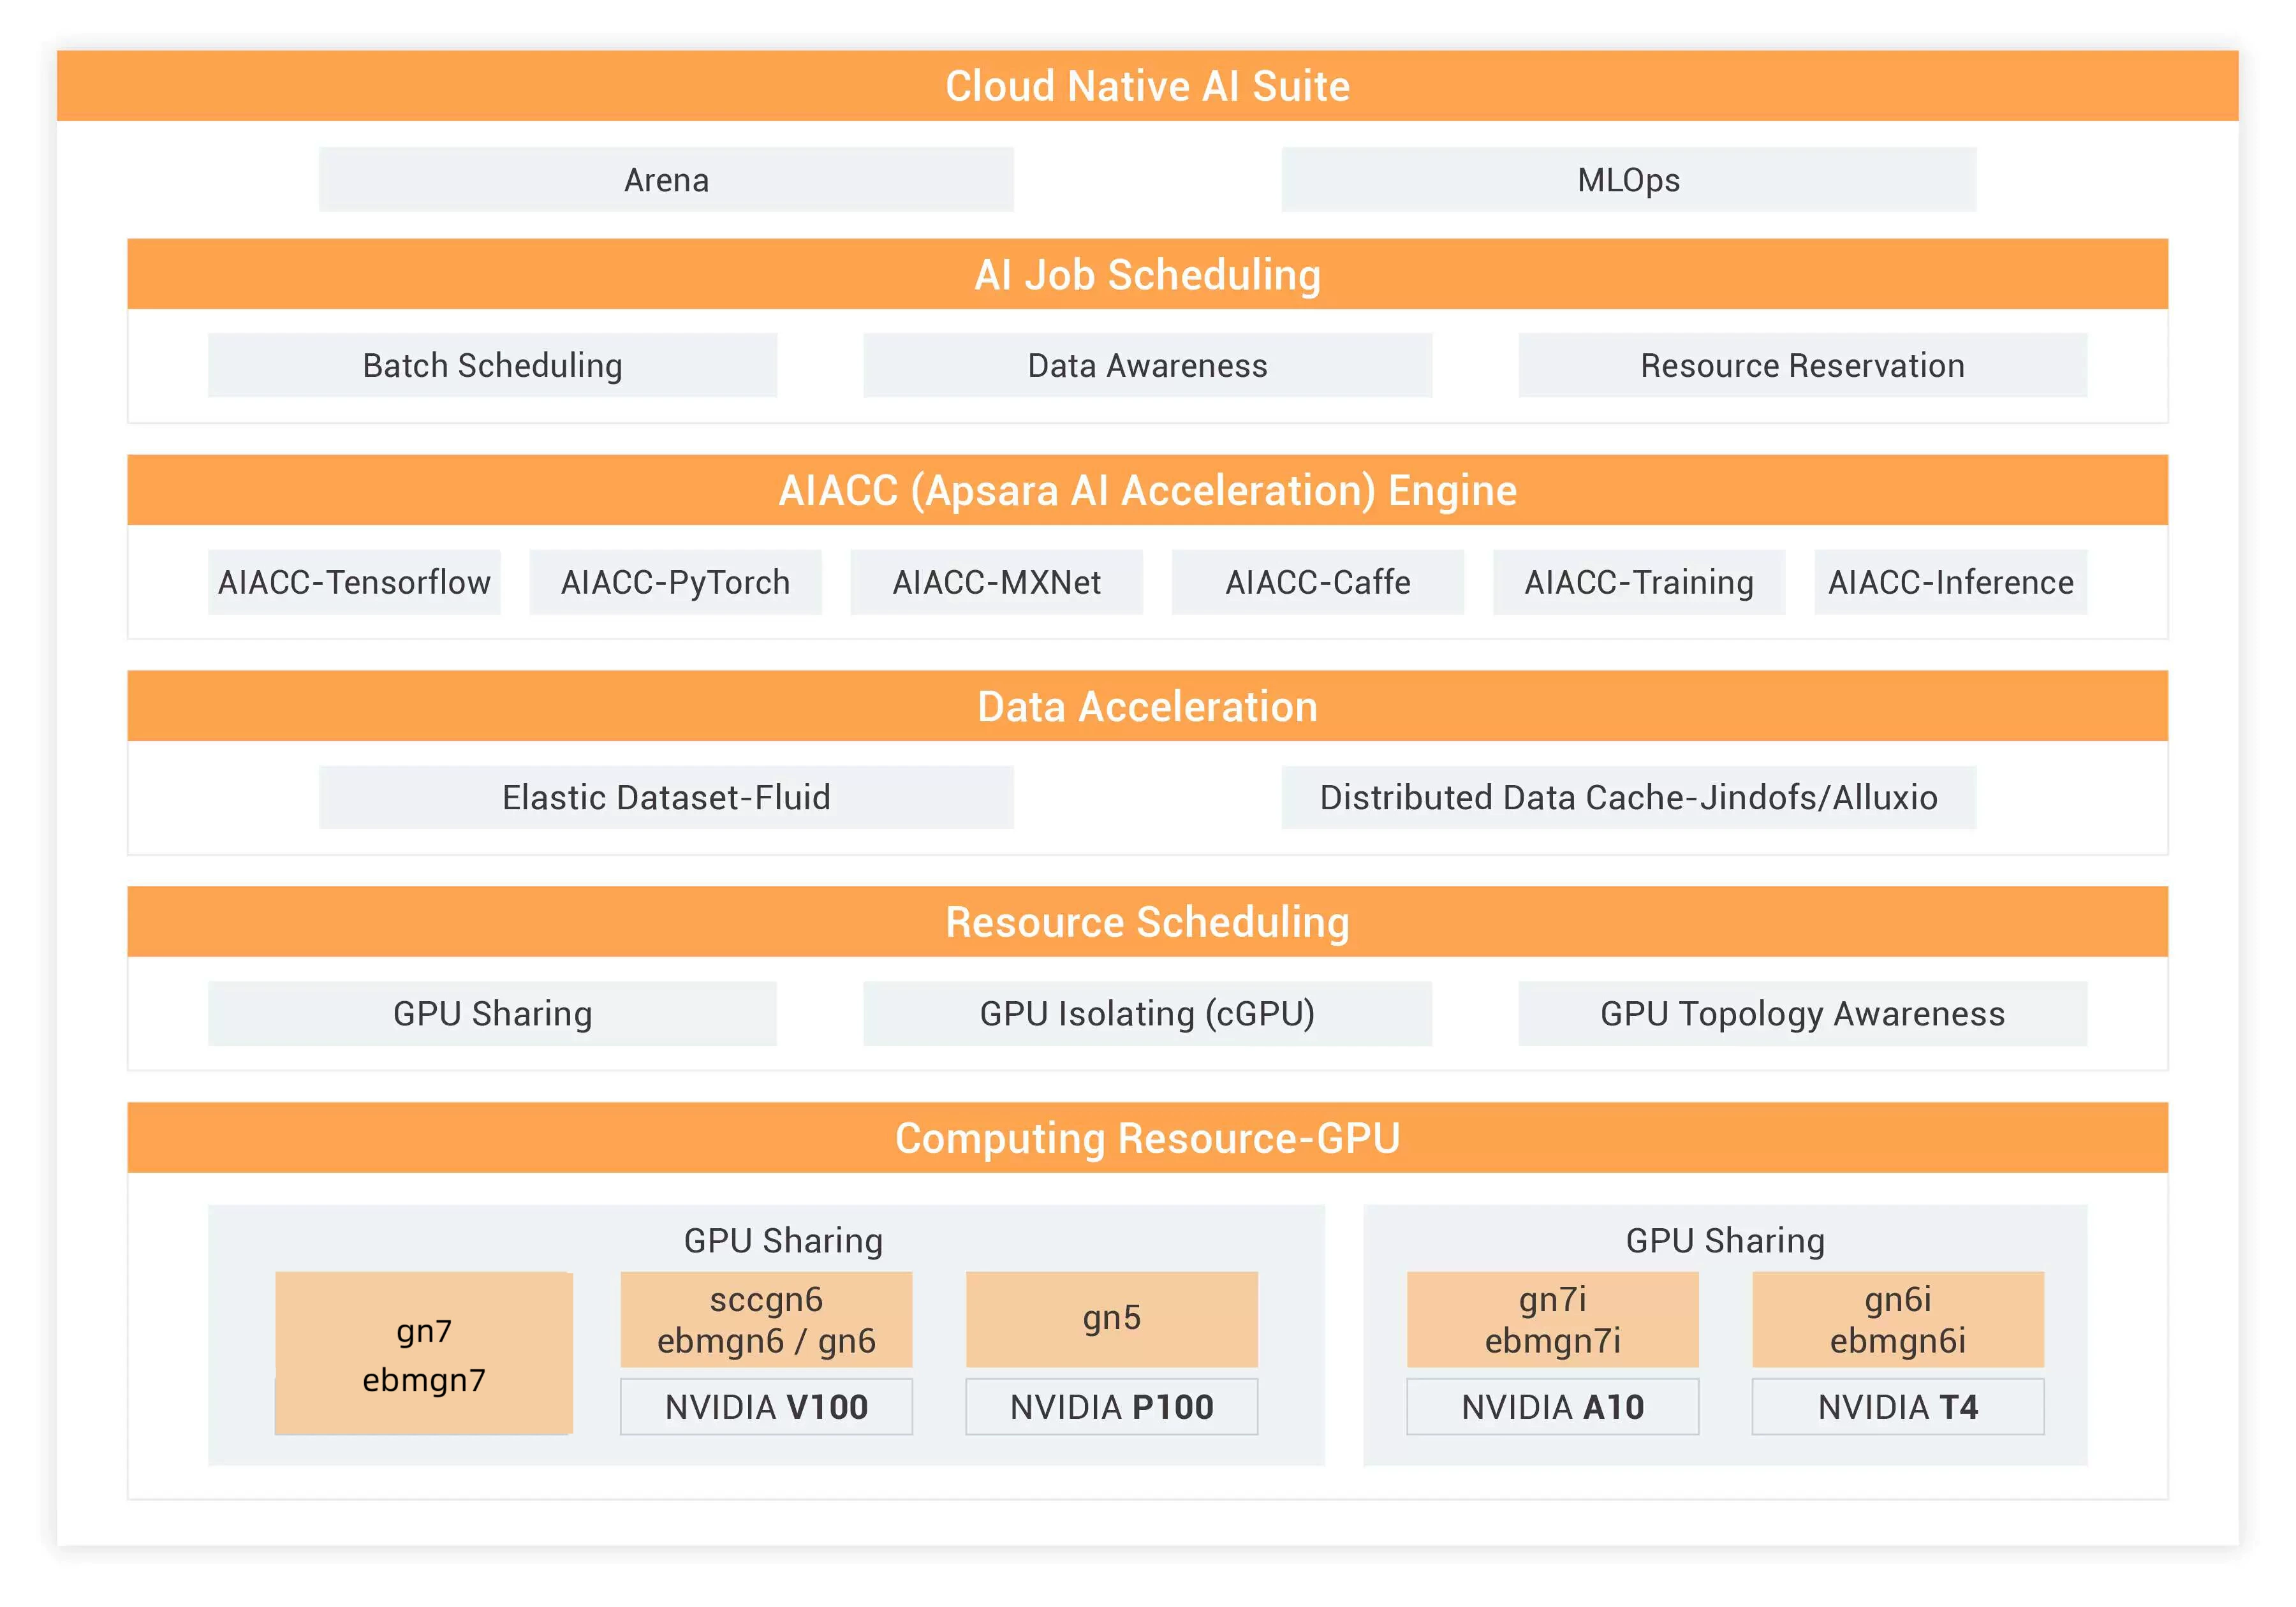
阿里雲AI加速方案套件含雲原生AI套件層、AI作業調度層、AI資料加速層、AI計算加速引擎層、資源調度層和計算資源層。各層針對不同情境的AI應用特點,提供相應的加速方案。
雲原生AI套件:簡化底層服務和組件的營運,監控GPU資源使用率,採集並分析AI作業日誌。支援通過命令列提交AI作業和查看模型訓練調度計劃。
AI作業調度:調度AI作業以加速模型訓練,提高GPU利用率,降低成本。
AIACC:利用TensorFlow、PyTorch、MXNet、Caffe等深度學習架構進行映像分類,實現Image Recognition、點擊率預測、自然語言處理、語音辨識、Face Service等。
資料加速:採用存算分離架構,資料存放區在不同裝置的本地環境中,模型訓練在阿里雲上執行。小檔案資料在訓練前預熱,提升傳輸和訓練效率。
資源調度:通過多個AI作業共用GPU資源,以及單個AI作業跨多GPU分布式訓練,提高GPU利用率並降低成本。
計算資源-GPU:使用cGPU以容器方式管理和調度GPU顯存和算力,加速AI訓練和推理。
應用情境

Image Recognition
MXNet + SyncBN分布式訓練,效能提升50%

NLP
自然語言處理分布式訓練,效能提升6倍

語音辨識
語音即時轉文字,文本同步發送至學生端並在螢幕上顯示。

CTR(點擊通過率)
分布式訓練,效能提升6.6倍
特惠
Apsara File Storage NAS
面向ECS執行個體、HPC及Container Service的彈性可擴充網路儲存。
25% OFF
• 隨用隨付
• 容量型NAS檔案系統
• 效能型NAS檔案系統
Container Registry
提供安全管理與高效分發的企業級容器鏡像平台。
• ACR EE Advanced Edition
• 企業級安全
Global Acceleration
-
 CSA STAR
-
 ISO 27001
-
 SOC2 Type II Report
-
 C5
-
 等保2.0
-
 MTCS
客戶成功案例
“新浪微博通過使用Function Compute處理影像檔,持續節省成本。我們不再需要預留大量閑置機器資源來應對高峰時段的流量突增。我們的工程師無需在監控伺服器狀態等基礎設施管理上浪費時間,而是能夠專註於與產品團隊合作,提升業務價值。”
新浪微博是一個社交媒體平台,致力於協助使用者建立更緊密的串連。它為使用者提供了一種簡單而全新的方式,即時發布內容,通過廣泛傳播且富有資訊量的內容與彼此互動,串連全球使用者。
相關資源
最佳實務
AI加速示範 - AIACC + ACK(TensorFlow)
本示範藉助運行在ACK(K8s)上的AI加速引擎AIACC,使用TensorFlow 2.4訓練ImageNet資料,加速AI訓練。
瞭解更多 >最佳實務
AI加速示範 - AIACC + ACK(PyTorch)
本解決方案藉助運行在ACK(K8s)上的AI加速引擎AIACC,使用PyTorch 1.9訓練ImageNet資料,加速AI訓練。
瞭解更多 >線上課程
藉助AIACC加速深度學習任務
本示範展示如何在不修改現有TensorFlow代碼的情況下實現18%-74%的效能提升,並通過標準MNIST手寫數字資料集和COVID-19胸部X光樣本展示AIACC的加速能力。
瞭解更多 >