
產品優勢
-
![]()
高穩定
脫胎於阿里巴巴集團內部即時傳輸系統,支援曆年11.11購物節,久經考驗,穩定可靠。
-
![#]()
高吞吐
最高支援單主題(Topic)每日T層級的資料量寫入,單個分區(Shard)支援最高每日百GB層級的寫入量。
-
![#]()
低成本
隨開隨用,隨用隨付,用非常低的成本完成傳輸任務。
-
![#]()
生態融合
源于飛天系統,與阿里雲巨量資料系統深度整合,無縫對接MaxCompute、Realtime Compute、互動式分析等產品,打通整個巨量資料體系。
強大的資料同步能力
多樣化的資料接入和同步能力,靈活的資料緩衝及互動方式
資料接入
提供多種SDK、API和Flume、Logstash等第三方外掛程式,讓您高效便捷的把資料接入到資料匯流排。
資料投遞
提供DataConnector模組,稍作配置即可把接入的資料即時同步到下遊MaxCompute、OSS、TableStore等儲存分析系統,極大減輕了資料鏈路的工作量。
資料緩衝
靈活的緩衝時間,下遊可重複消費,自動多備份,保障資料高可靠性。
多種介面
既有適合人互動的Web控制台,也有適合程式互動的API和SDK,滿足各種使用需求。
典型應用情境
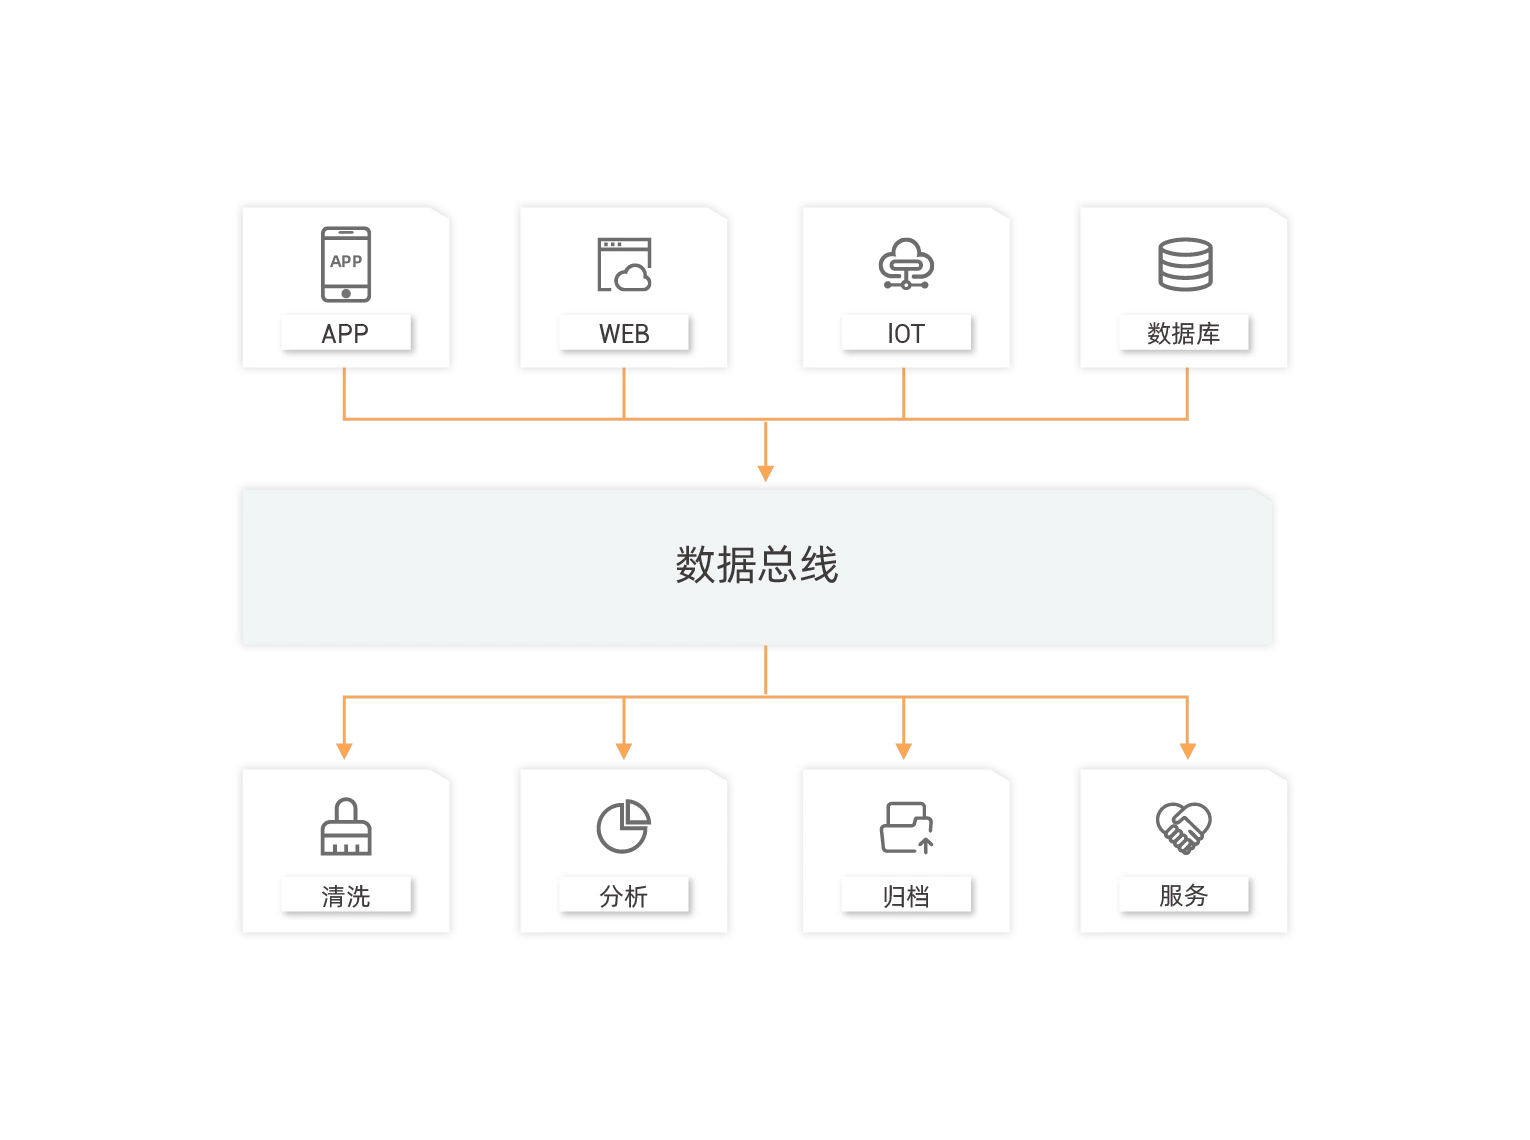
接入多種異構資料並投遞到下遊多種巨量資料系統
通過資料匯流排,您可以即時接入APP、WEB、IoT和資料庫等產生的異構資料,統一管理,並投遞到下遊的分析、歸檔等系統,構建清晰的資料流,讓您更好的釋放資料的價值。
能夠解決
-
 系統解耦
對外,巨量資料系統與業務系統解耦,對內,巨量資料系統各組件之間解耦。
-
即時通道
通過資料匯流排,業務資料能夠即時匯入巨量資料系統,縮短資料分析周期。

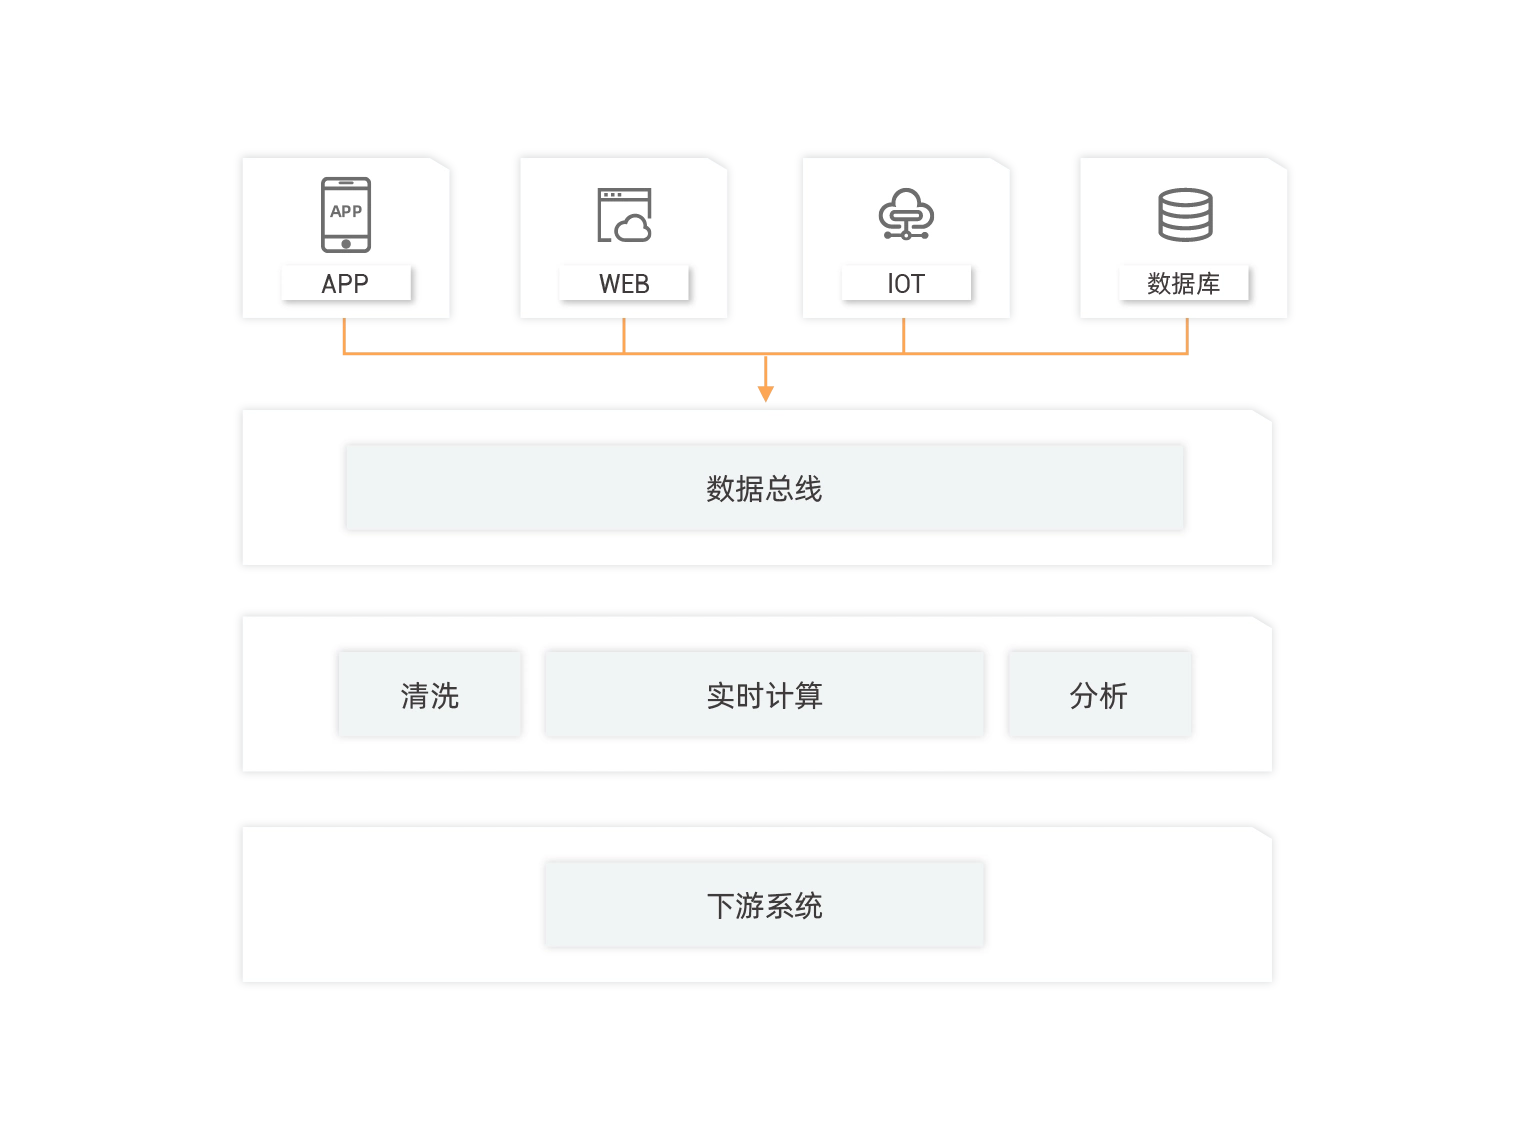
互連網廣告業務即時分析
對互連網公司而言,廣告依然是目前主流的變現方式。廣告的本質是在賣流量,所以這是一個即時決策、線上轉化的過程,離線資料T+1的計算已經不滿足業務需求,整個行業需要即時轉型。
能夠解決
-
即時匯聚多種資料來源
利用DataHub收集不同終端的使用者資訊,後配合Realtime Compute引擎Flink進行廣告即時偵測,反饋失效連結、流量作弊行為等。
-
即時分析決策
不同平台資料統一計算,避免資料孤島,即時情境下引導客戶快速做出業務反應,避免流量損失,提高廣告曝光度。
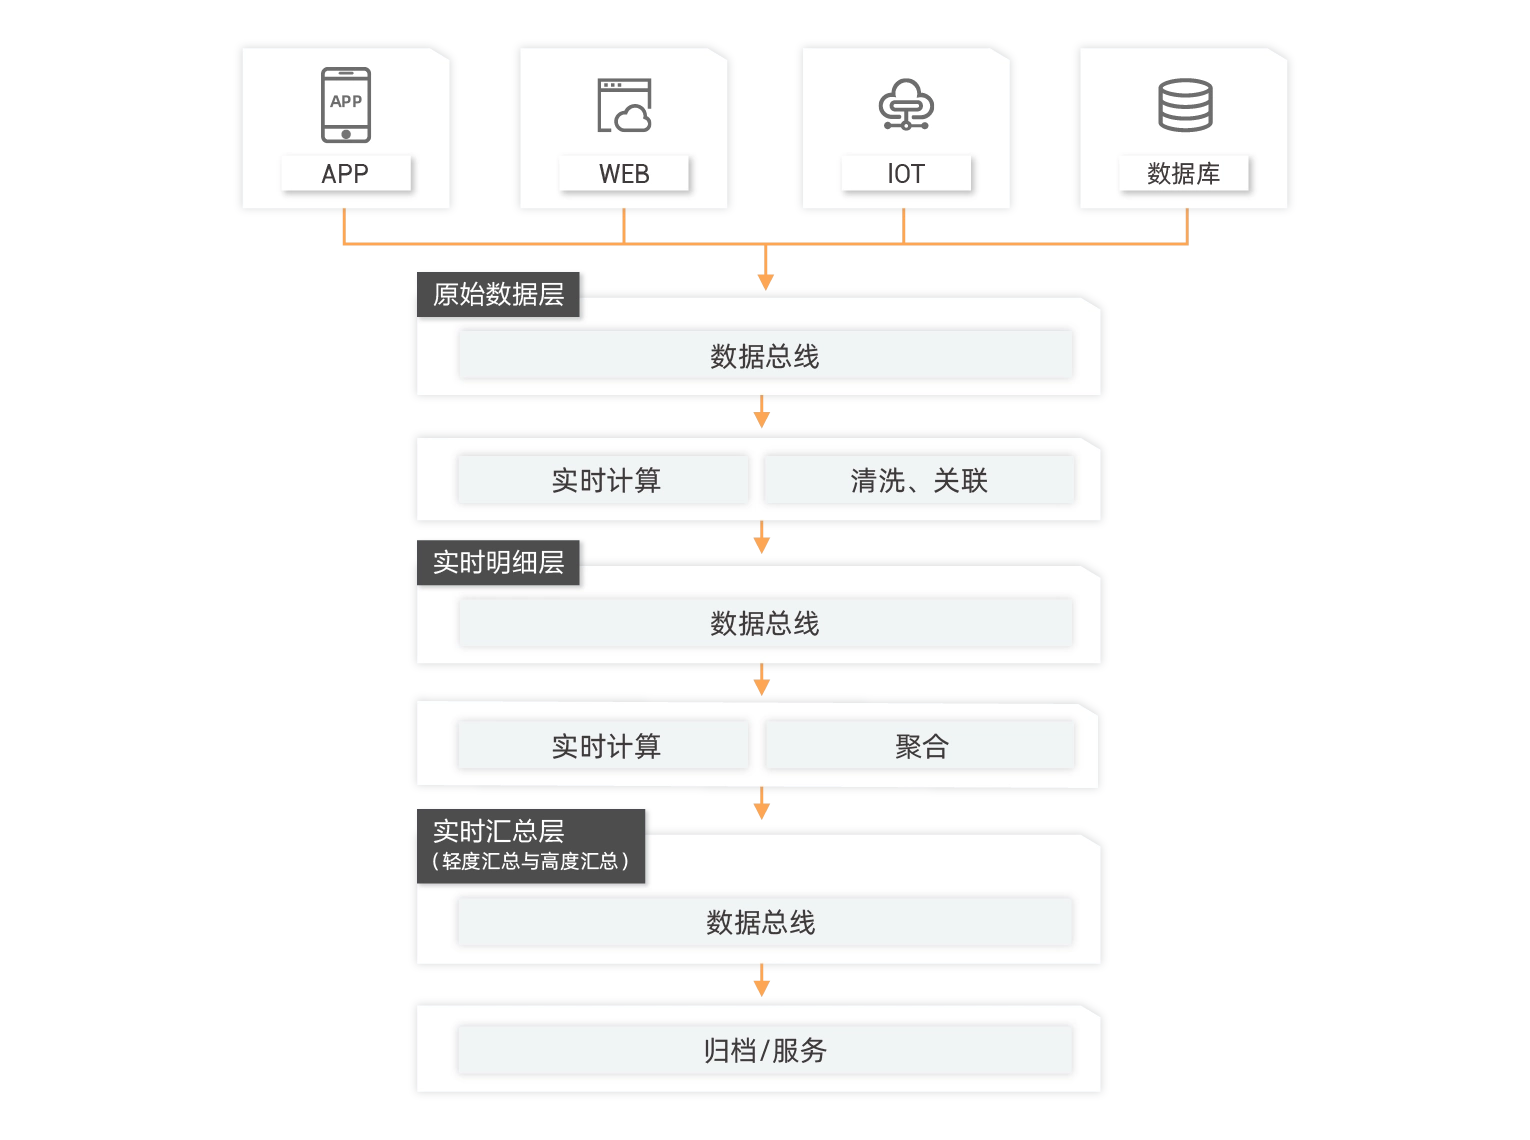
資料匯流排替換傳統資料庫,構建即時數倉
隨著業務向即時需求的轉型,傳統T+1的離線數倉已經無法滿足業務需求。可以利用資料匯流排DataHub和Realtime Compute引擎Flink構建即時數倉系統,將資料分為:公用明細層(dwd),公用匯總層(dws),應用結果層(ads),使用Kappa架構構建整個體系
能夠解決
-
統一的Kappa架構
傳統Lambda架構的兩條鏈路縮減為一條,大大降低維護成本。
-
巨量資料即時化
滿足業務對即時性的需求,做到了資料複用,減少重複計算與儲存;同時使得業務指標口徑統一,避免混亂。

