
Lindorm est un service de base de données cloud capable de stocker et d'analyser de grands volumes de données à faible coût. Il prend en charge plusieurs modèles de données, notamment les tables larges, les séries temporelles, les fichiers et les moteurs de recherche. Lindorm traite les données en ligne en quelques millisecondes. Vous pouvez utiliser des instructions SQL unifiées pour interroger, rechercher et analyser les données de plusieurs modèles dans Lindorm. Lindorm vous permet également d'effectuer des calculs en temps réel grâce à son moteur de traitement de flux intégré. Lindorm est le service de base de données idéal pour de nombreux scénarios métier : finance, facturation, journalisation, Internet des objets (IoT), Internet des véhicules (IoV), Internet industriel, surveillance, systèmes de recommandation, contrôle des risques et imagerie médicale.
Avantages
-
Rentabilité
Lindorm peut répondre à des dizaines de millions de requêtes simultanées en quelques millisecondes. Lindorm utilise des supports de stockage économiques pour constituer un pool de stockage partagé entre plusieurs moteurs de données, avec séparation intelligente des données chaudes et froides et compression adaptative des données.
-
Évolutivité
Lindorm utilise une architecture dans laquelle les ressources de stockage et de calcul sont découplées et peuvent être mises à l’échelle indépendamment. Lindorm propose également des services serverless que vous pouvez adapter et payer en fonction de votre utilisation réelle.
-
Haute stabilité
Lindorm repose sur une architecture haute disponibilité et offre une stabilité de niveau entreprise. Cette architecture a été éprouvée dans l’environnement de production d’Alibaba Group pendant plus de 10 ans, avec une fiabilité démontrée.
-
Haute compatibilité
Lindorm est compatible avec les API standard de plusieurs services open source. Vous pouvez connecter Lindorm à divers moteurs de calcul tels que Spark et Flink dans des scénarios IoV et IoT industriel, afin d’intégrer facilement votre activité aux écosystèmes dominants.
Fonctionnalités
Modèles de données convergés
Lindorm propose une variété de moteurs de données basés sur un stockage cloud natif et vous permet d’interroger les données via le mode de requête multi-modèle unifié ou des API open source, pour un développement flexible et efficace.
Moteur de tables larges
Le moteur wide table permet de stocker de grandes quantités de données clé-valeur et de données tabulaires. Il fournit des index secondaires globaux, des requêtes multidimensionnelles, des colonnes dynamiques et un Time to Live (TTL). Il convient à des scénarios tels que le stockage de métadonnées, de commandes, de factures, de profils utilisateurs, d’informations de réseaux sociaux, de flux et de journaux. Le moteur wide table est compatible avec les standards ouverts de plusieurs logiciels open source, dont Apache HBase, Apache Phoenix et Apache Cassandra.
Moteur de séries temporelles
Le moteur de séries temporelles permet de stocker et de traiter les données de séries temporelles, telles que les données de mesure et les données opérationnelles des appareils, dans des scénarios comme l’IoT et la surveillance. Il fournit une API HTTP compatible avec l’API OpenTSDB et prend en charge les requêtes SQL. Ce moteur offre un algorithme de compression dédié aux données de séries temporelles, prend en charge les requêtes multidimensionnelles et le calcul agrégé sur de grandes quantités de données, et fournit le sous-échantillonnage et la pré-agrégation.
Moteur de recherche
Le moteur de recherche offre des fonctionnalités telles que la recherche en texte intégral, le calcul d’agrégats et les requêtes multidimensionnelles complexes sur de grands volumes de données textuelles et tabulaires. Il peut également stocker de manière transparente les index des moteurs de tables larges et de séries temporelles, accélérant ainsi la récupération et l’interrogation des données. Le moteur de recherche s’applique à des scénarios tels que l’interrogation de journaux, de factures et de profils utilisateur. Il est compatible avec les standards ouverts de la plateforme open source Solr.
Moteur de fichiers
Lindorm est conçu pour stocker de grandes quantités de données non structurées et offre des fonctionnalités de stockage de fichiers flexibles et économiques, compatibles avec HDFS. Lindorm fournit un pool de stockage unifié partagé par plusieurs moteurs de données, permettant aux systèmes externes d’accéder aux fichiers sous-jacents des moteurs de données. Lindorm convient à diverses activités telles que l’analyse big data et les lacs de données, et est accessible via des clients HDFS open source.
Moteur spatiotemporel
Le moteur spatiotemporel est conçu pour stocker et traiter de grandes quantités de données spatiales, spatiotemporelles et GIS. Il est compatible avec les API standard d’outils open source tels que GeoMesa et GeoTools. Ce moteur offre une capacité d’indexation multidimensionnelle efficace pour les données spatiotemporelles ainsi qu’une capacité de requête pour les données spatiales et spatiotemporelles. Vous pouvez utiliser le moteur spatiotemporel avec DLA pour analyser et exploiter des données spatiotemporelles complexes. Ce moteur est idéal pour les activités basées sur les données spatiotemporelles, telles que le transport, le tourisme, la logistique, l’IoT, la navigation, l’aviation et les stations de base mobiles.
Stockage unifié intelligent
Les différents moteurs de Lindorm partagent un pool de stockage unifié et économique offrant une haute fiabilité, une évolutivité et des fonctionnalités hybrides. Lindorm fournit également des API standard compatibles avec les systèmes de fichiers HDFS open source.
Séparation intelligente des données chaudes et froides
Les données dans Lindorm sont stockées dans différentes couches de manière flexible en fonction de la fréquence d’accès, ce qui réduit les coûts de stockage des données froides et améliore les performances d’accès aux données chaudes. Les applications peuvent accéder directement aux données stockées dans Lindorm sans modification.
Supports de stockage multiples
Lindorm prend en charge une gamme de supports de stockage couvrant de multiples scénarios, de la haute performance aux faibles coûts.
Fonctionnalités de requête avancées
Lindorm intègre de multiples fonctionnalités de requêtes de données, telles que les index secondaires, les index inversés et les index de séries temporelles, permettant d’interroger et de traiter rapidement de grandes quantités de données.
Index secondaire global
Lindorm repose sur une architecture distribuée à l’échelle mondiale et offre une forte cohérence ainsi qu’une redondance élevée. Lindorm est compatible avec les modèles de données sans schéma et utilise automatiquement des index à la demande pour accélérer les requêtes sans clé primaire.
Recherche intégrée au stockage
Lindorm intègre plusieurs moteurs, dont le moteur de tables larges, le moteur de séries temporelles et le moteur de recherche, pour stocker et interroger les données de manière unifiée. Vous pouvez par exemple synchroniser les données du moteur de tables larges et du moteur de séries temporelles vers le moteur de recherche en temps réel. Vous pouvez ainsi effectuer des opérations hybrides telles que le stockage, les requêtes multidimensionnelles ou l’indexation en texte intégral sur de grands volumes de données de manière unifiée.
Assistance entreprise
Lindorm offre de multiples fonctionnalités indispensables aux entreprises pour gérer leurs activités critiques à grande échelle, telles que la sécurité, la fiabilité et l’efficacité. Lindorm est donc idéal pour les activités liées à l’Internet des objets (IoT) et à l’Internet des véhicules (IoV).
Géo-redondance mondiale
Lindorm prend en charge la distribution mondiale des données et la réplication multi-maître. Les applications peuvent ainsi accéder aux données géographiquement proches. Lindorm assure également la reprise après sinistre automatique et la tolérance aux pannes, vous permettant de déployer vos applications dans plusieurs régions à travers le monde.
Cohérence forte et haute disponibilité
Lindorm stocke plusieurs réplicas de données dans différentes zones et prend en charge le déploiement de clusters inter-zones pour assurer la récupération des données au niveau des centres de données et une forte cohérence des données. Vous pouvez également utiliser le mode de cohérence à terme pour obtenir de meilleures performances et une meilleure disponibilité.
Accès sécurisé
Lindorm propose différentes méthodes telles que le VPC et les groupes de sécurité pour gérer les accès et met en œuvre un processus complet incluant l’authentification, le contrôle des autorisations, le chiffrement et l’audit pour garantir la sécurité des données.
Sauvegarde et restauration
Lindorm prend en charge la sauvegarde et la restauration régulières des données à la demande. Vous pouvez restaurer rapidement de grands volumes de données de sauvegarde à un instant précis sans interruption. Cela vous aide à vous conformer aux réglementations des entreprises et du gouvernement.
Faible latence
Lindorm peut répondre à des dizaines de millions de requêtes simultanées en quelques millisecondes.
Diagnostics intelligents
Lindorm intègre LDInsight, qui permet de diagnostiquer les problèmes courants tels que les requêtes lentes et les données chaudes. LDInsight peut également être utilisé pour les diagnostics de performance, l’analyse de capacité, la conception de schémas, le dépannage automatique et la recommandation de suggestions.
Compatibilité avec l’écosystème
Lindorm peut être intégré de manière transparente aux moteurs de calcul tels que Spark, Flink, Data Lake Analytics (DLA) et MaxCompute.
Tunnel de données
Vous pouvez utiliser d’autres services tels que LTS et DTS pour synchroniser des données en temps réel ou migrer l’intégralité des données historiques entre Lindorm et les services de stockage courants tels qu’ApsaraDB for HBase, ApsaraDB RDS MySQL et Log Service.
Calcul et analytique
Lindorm fournit des interfaces standard et convertit les formats de données selon les besoins. Vous pouvez intégrer Lindorm à des moteurs de calcul open source tels que Spark, Flink, DLA et Hive pour effectuer des analyses interactives en temps réel et des analyses complexes par lots.
Visualisation des données
Lindorm peut se connecter à QuickBI et DataV pour visualiser et analyser les données de manière graphique.
Scénarios
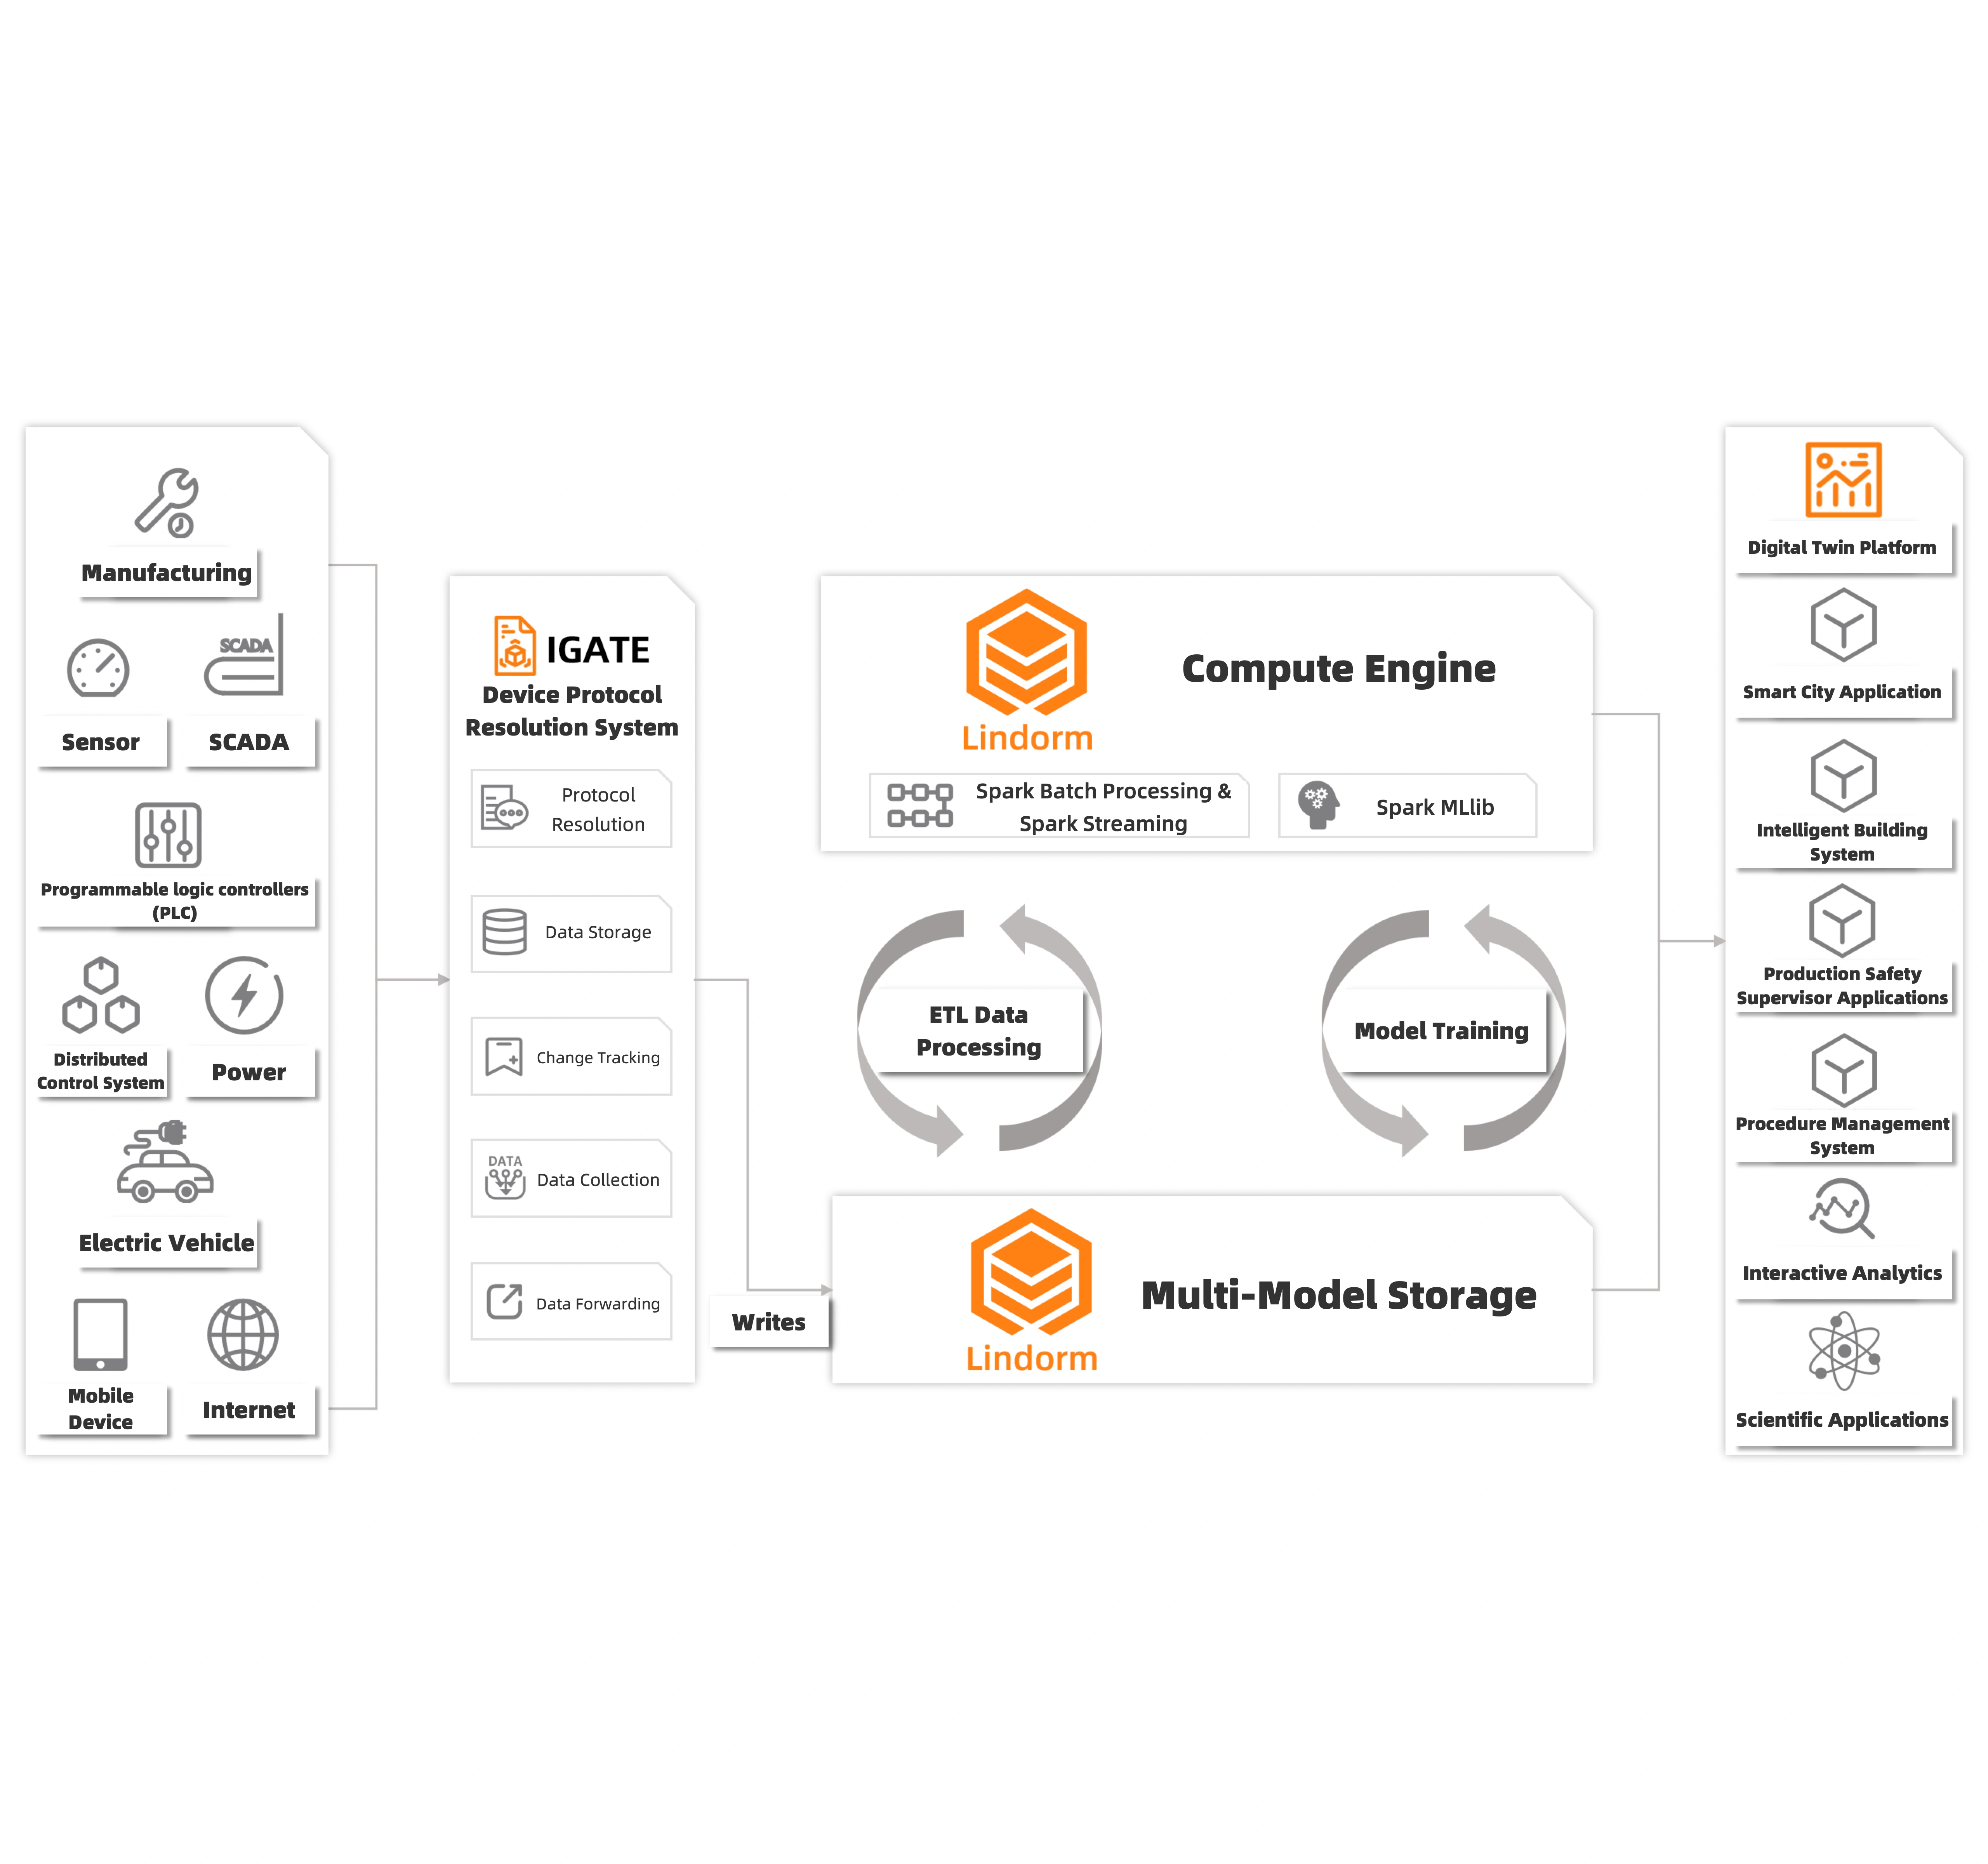
Stockage et analyse des données IT et OT convergentes issues du cloud de données industriel
Lindorm vous permet de stocker de grands volumes de données IT et OT hétérogènes issues de l’IoT industriel. Les moteurs de données de Lindorm vous permettent d’effectuer du calcul distribué haute performance de manière économique et stable, répondant à vos besoins dans divers scénarios tels que la production intelligente, l’exploration et l’analyse interactives de données, le traitement de données IA/ML et le calcul de graphes à grande échelle. Lindorm communique avec divers services en amont et en aval de l’Internet industriel pour normaliser et rassembler les données IT et OT isolées dans les scénarios industriels traditionnels. Vous pouvez ainsi transmettre des informations et configurer des ressources plus efficacement afin de mettre en œuvre la transformation numérique et intelligente de l’industrie manufacturière.
Avantages
-
Rentabilité
Prend en charge des taux de compression élevés, la séparation des données chaudes et froides, ainsi que diverses spécifications.
-
Évolutivité
Utilise une architecture à stockage et calcul découplés. Cela vous permet de faire évoluer les clusters et d’étendre le stockage.
-
Hyperconvergence
Intègre les ressources de calcul et de stockage et prend en charge plusieurs modèles de calcul distribué. Offre divers modes de stockage et d'accès pour une utilisation prête à l'emploi.
-
Haute performance
Écrit les données provenant d'un grand nombre de points de collecte avec un débit élevé et une faible latence. Les données dans Lindorm peuvent être efficacement mesurées, calculées et traitées.
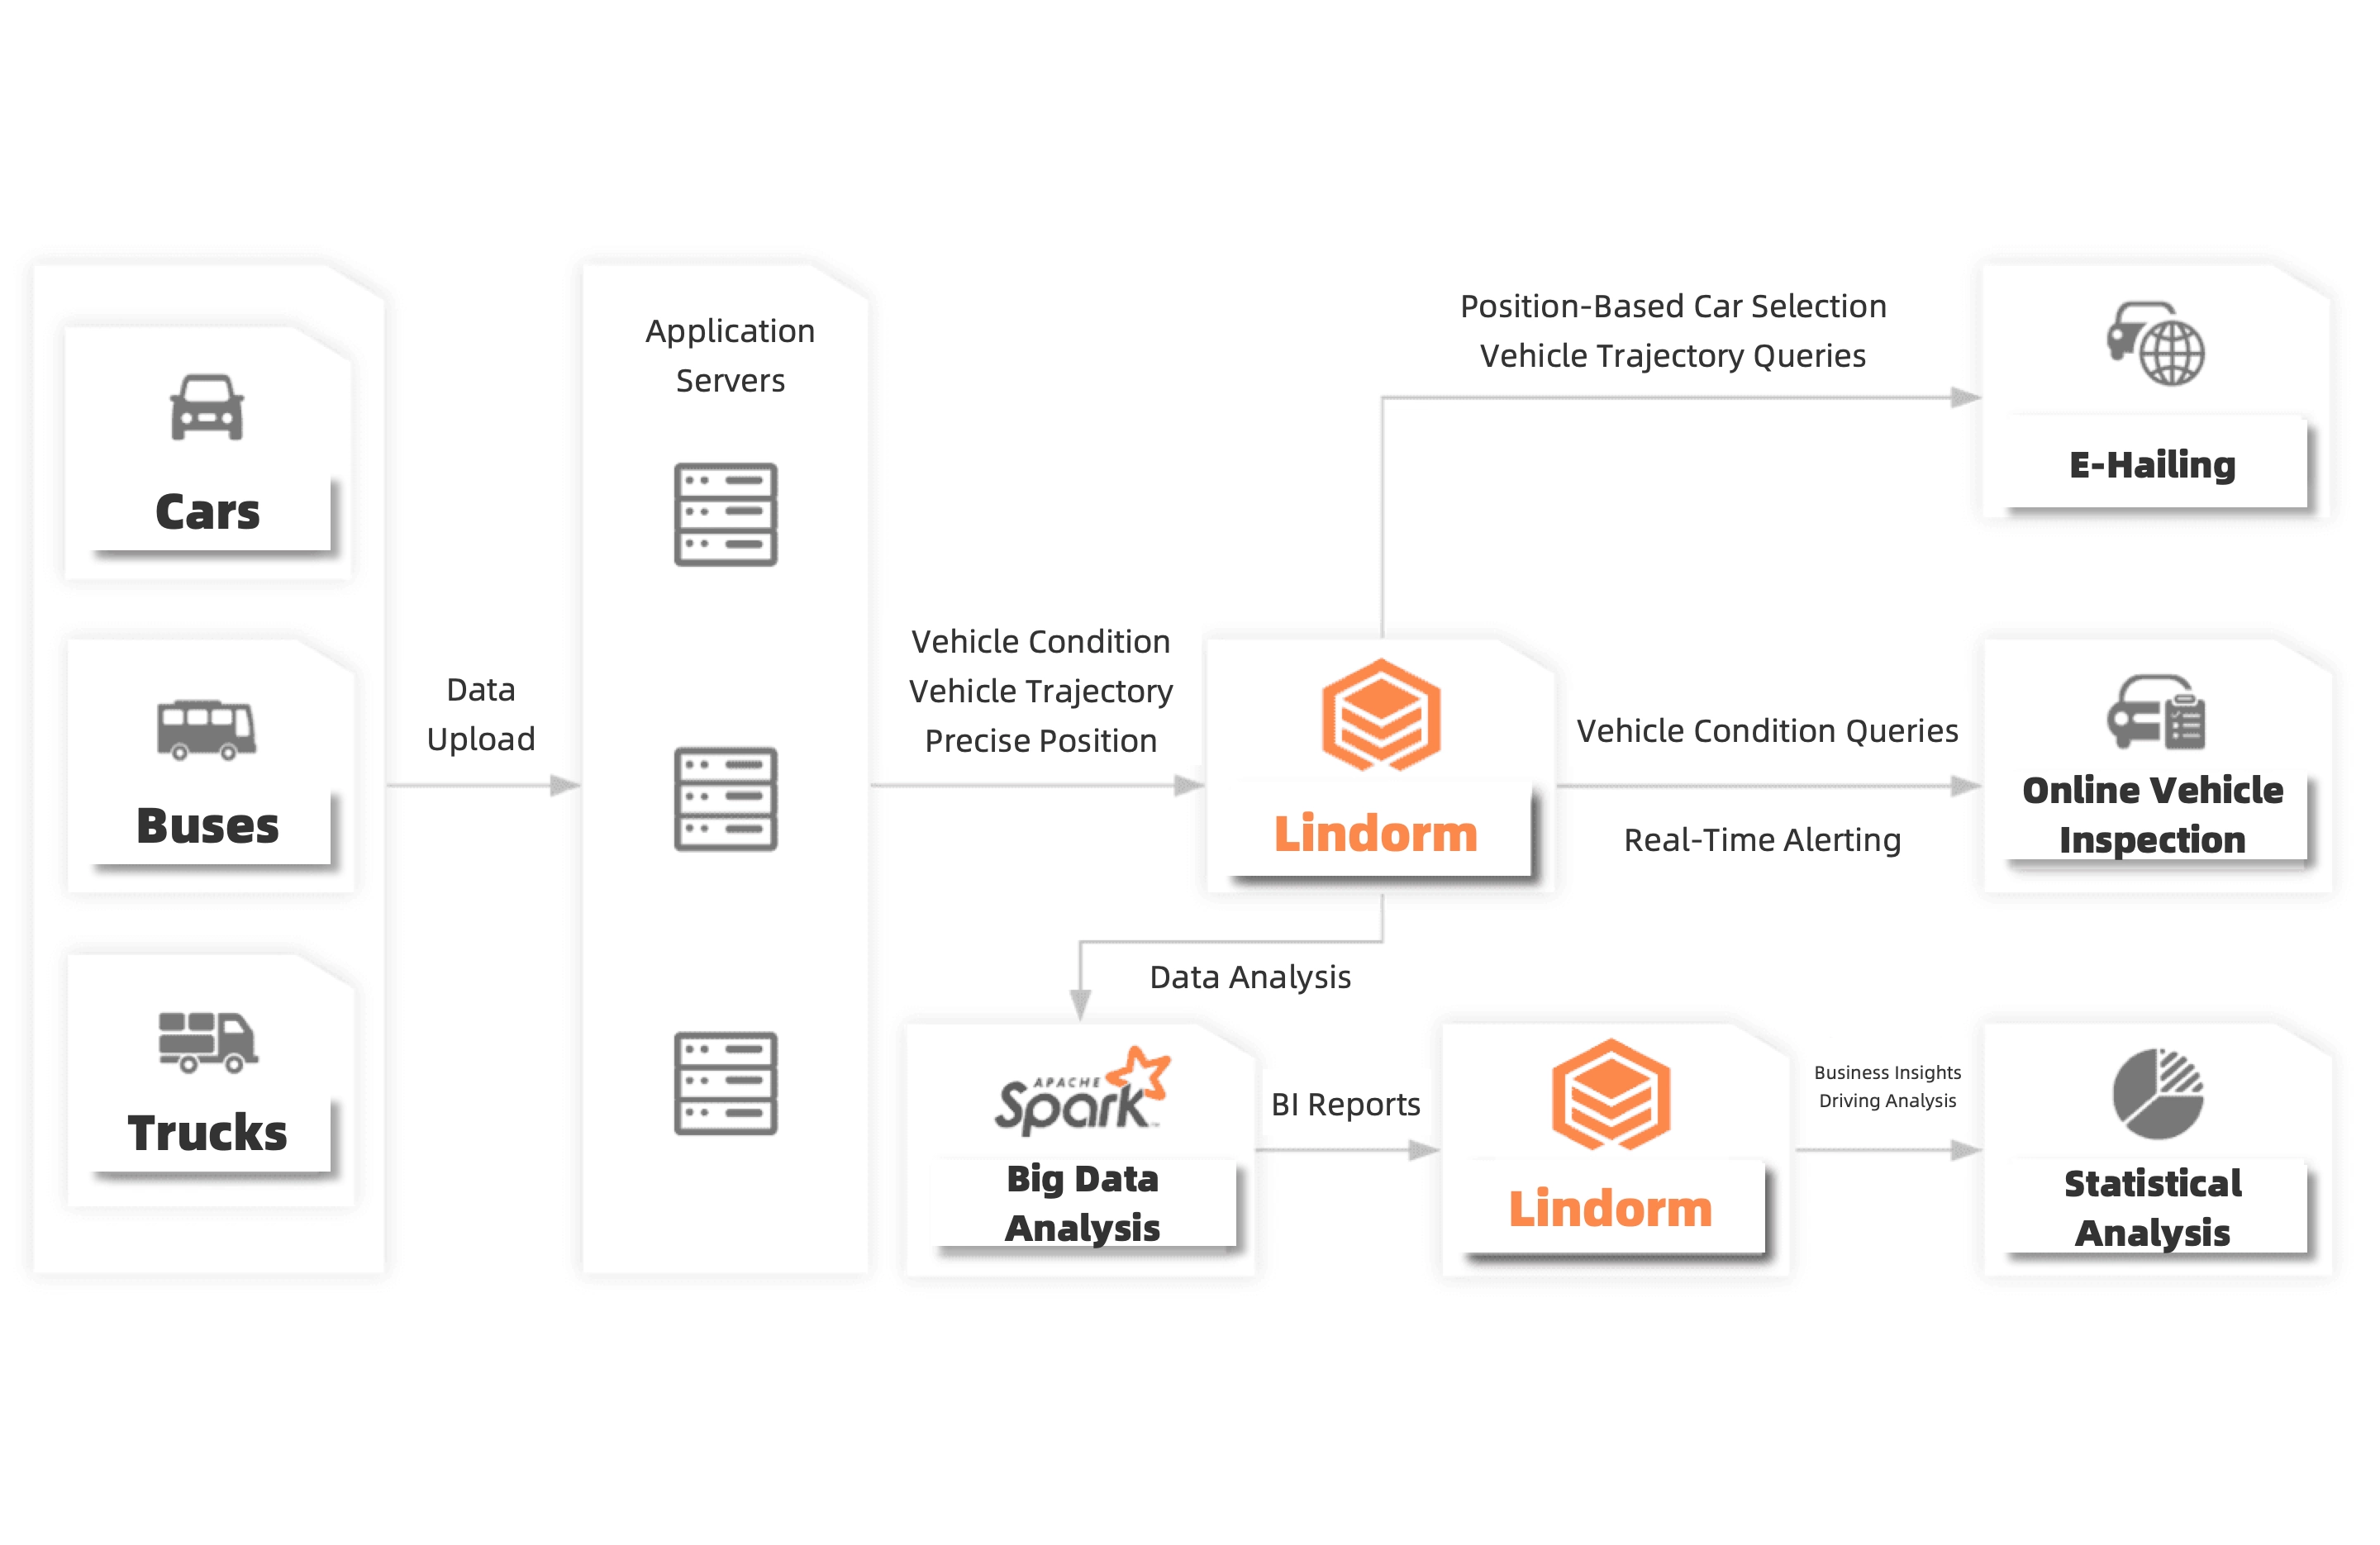
Stockage et traitement des données de trajectoire et d'état des véhicules
Lindorm vous permet de stocker des données essentielles telles que les trajectoires de conduite, l’état des véhicules et les données de positionnement précis dans les scénarios IoV. Lindorm fournit des services évolutifs, fiables et économiques. Il vous permet de créer des services edge performants pour le VTC, la logistique et la détection de véhicules à énergie nouvelle.
Avantages
-
Rentabilité
Prend en charge des taux de compression élevés, la séparation des données chaudes et froides et diverses spécifications.
-
Évolutivité
Utilise une architecture à stockage et calcul découplés. Cela vous permet de faire évoluer les clusters et d’étendre le stockage.
-
Faible latence
Répond à des dizaines de millions de requêtes simultanées en quelques millisecondes.
-
Utilisation flexible
Prend en charge les colonnes dynamiques et le mécanisme TTL. Les fonctionnalités ou les tags peuvent être automatiquement ajoutés ou supprimés des colonnes dynamiques, et les données expirent automatiquement selon le paramètre TTL. Lindorm stocke également plusieurs versions des données.
-
Tunnel de données
Vous permet d’utiliser LTS pour synchroniser les données entre Lindorm et des systèmes tiers de manière simple et efficace.
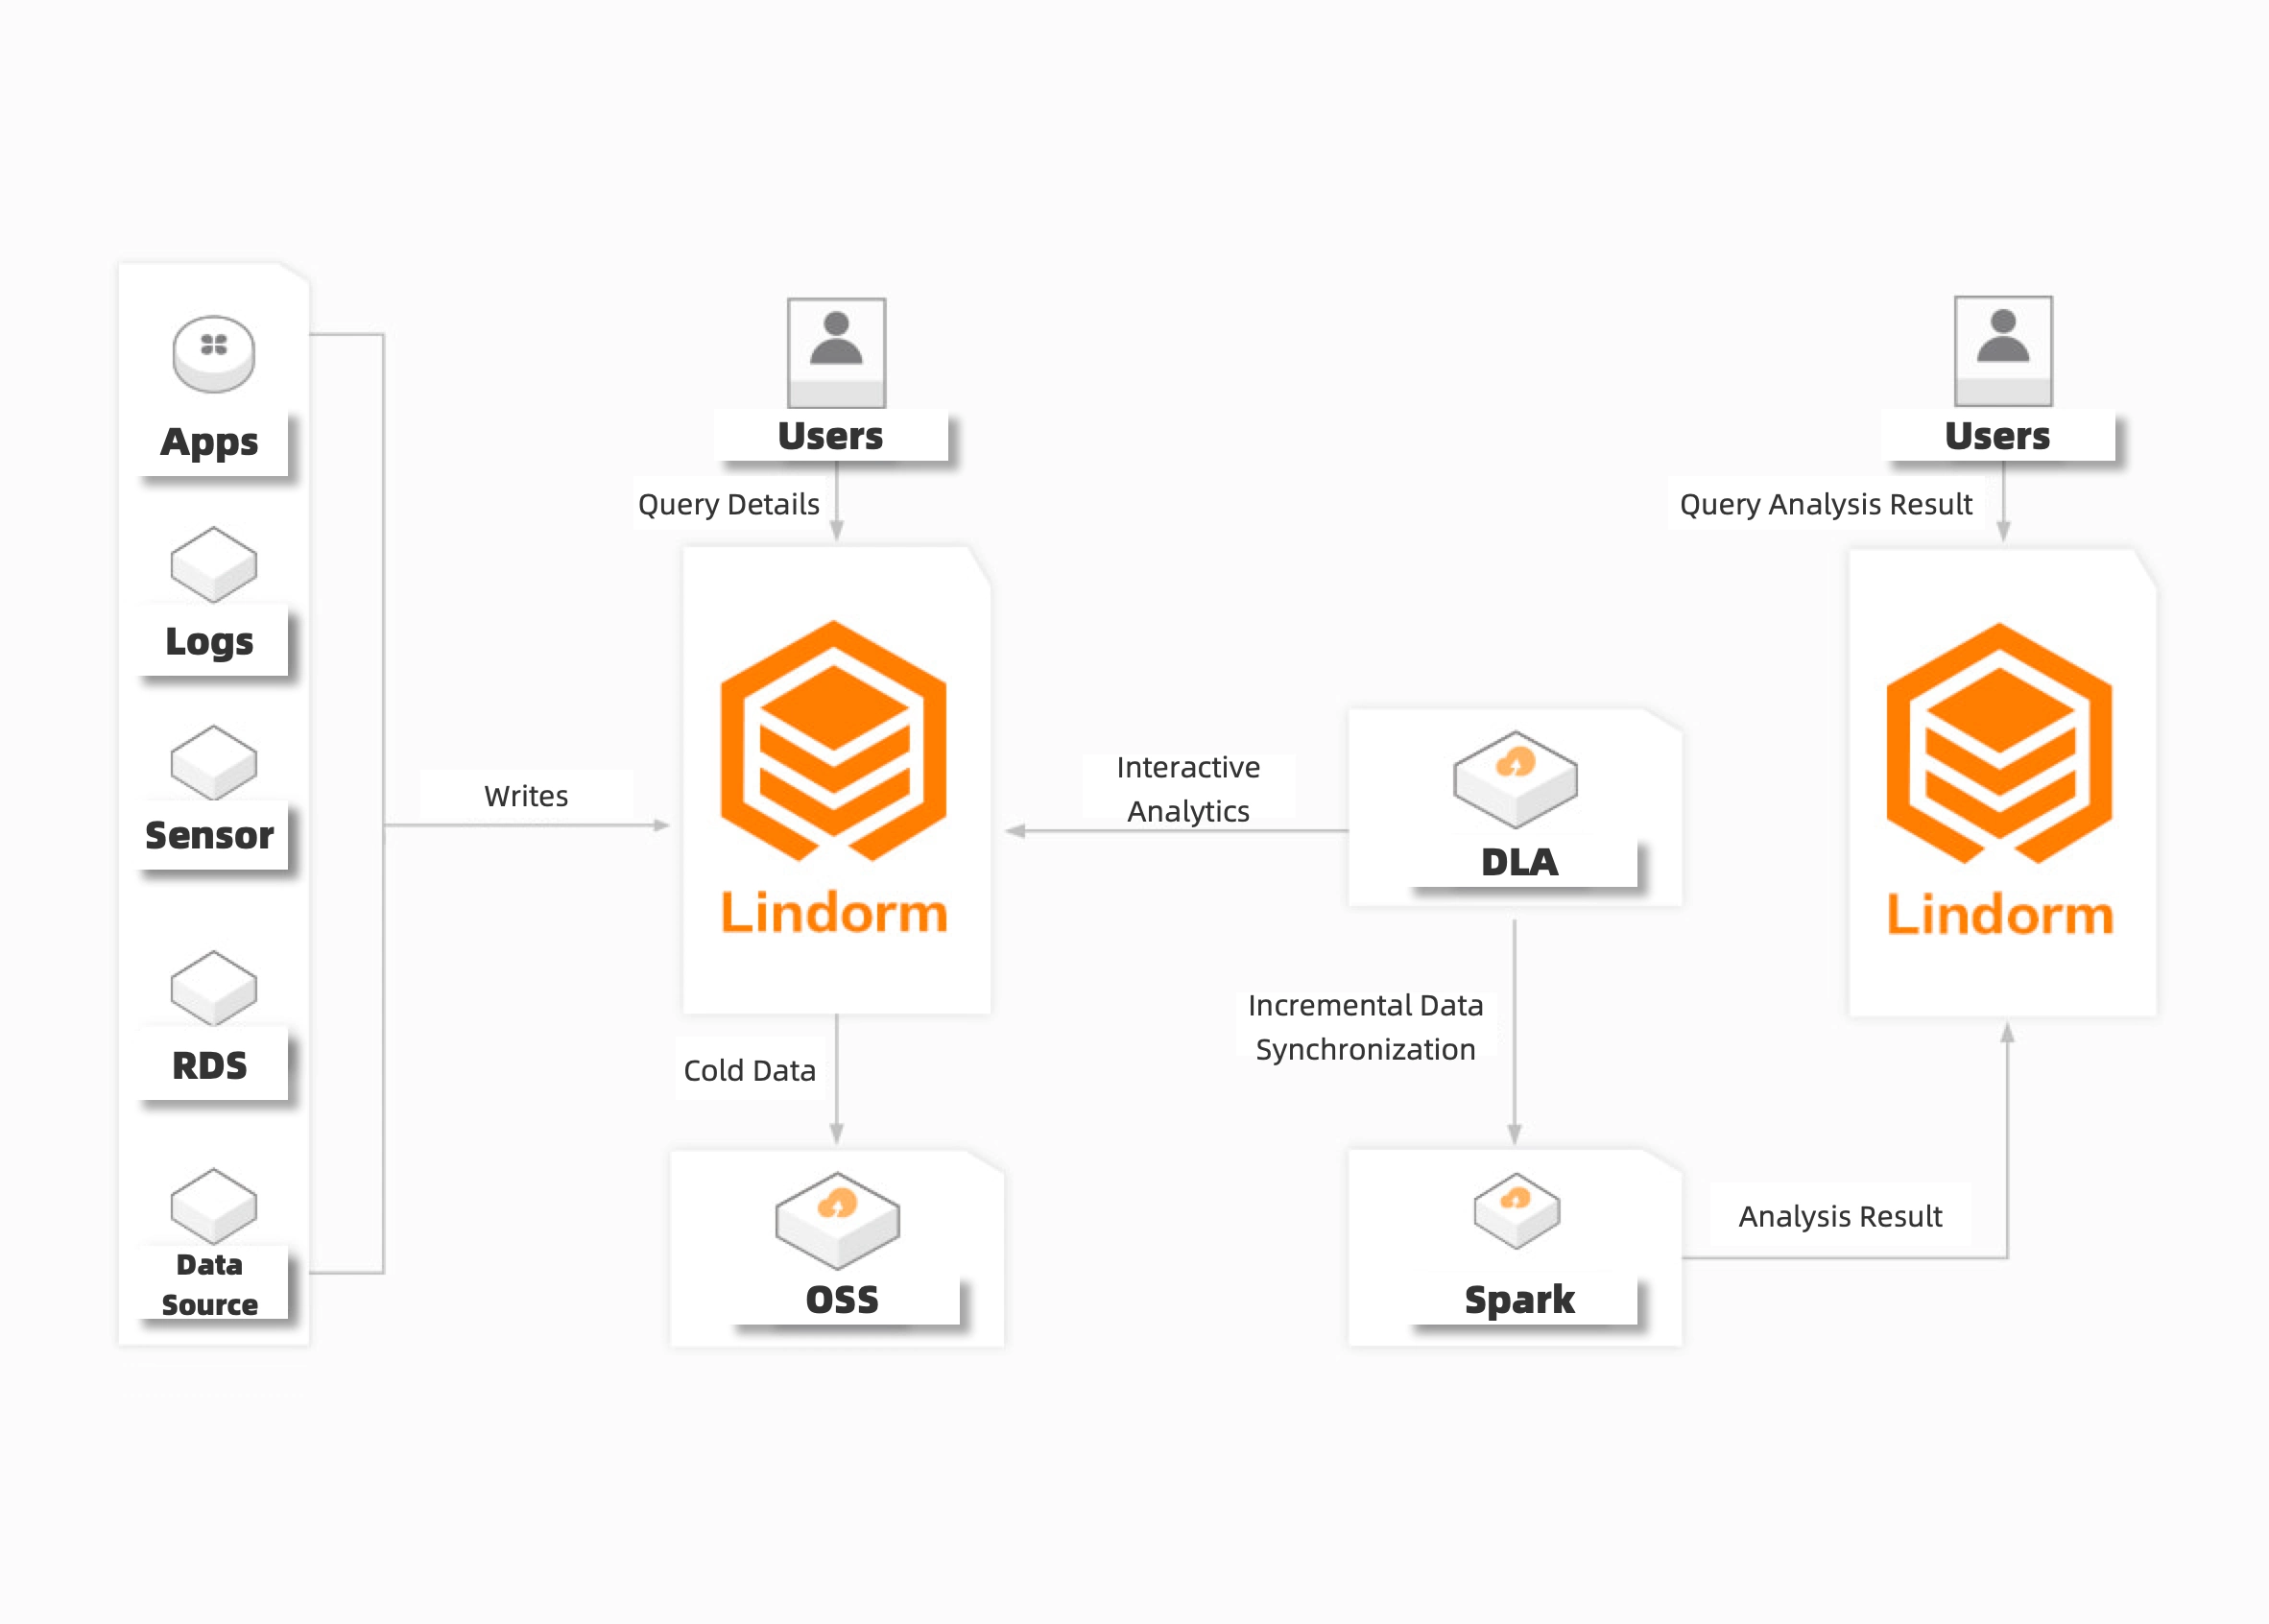
Stockage et analyse économiques pour de grands volumes de données
Lindorm vous permet de stocker de grandes quantités de données à faible coût, d'importer plusieurs jeux de données simultanément et d'interroger les données en temps réel. Vous pouvez synchroniser les données complètes ou incrémentielles de manière efficace. Lindorm s'intègre aux plateformes de big data telles que Spark et MaxCompute, ce qui permet l'analyse hors ligne de volumes massifs de données.
Avantages
-
Rentabilité
Prend en charge des taux de compression élevés, la séparation des données chaudes et froides et diverses spécifications.
-
Tunnel de données
Transmission de données par tunnel : Lindorm vous permet d’utiliser Lindorm Tunnel Service (LTS) pour synchroniser les données entre Lindorm et des systèmes tiers de manière simple et efficace.
-
Import rapide
Vous permet d’importer de grands volumes de données vers Lindorm via BulkLoad. La transmission de données est ainsi plus rapide qu’avec les méthodes traditionnelles.
-
Haute simultanéité
Offre une mise à l’échelle horizontale pour atteindre des dizaines de millions de QPS.
-
Évolutivité
Lindorm utilise une architecture à stockage et calcul découplés. Cela vous permet de faire évoluer les clusters et d’étendre le stockage.
Contacter les ventes
Notre équipe commerciale mondiale est à votre disposition pour vous accompagner sur divers sujets et vous aider à démarrer avec Alibaba Cloud.

