
IA et Machine Learning sur Kubernetes
Cloud-native AI fournit un ensemble de fonctionnalités et de services essentiels pour vous aider à créer une plateforme d'IA, accélérer vos charges de travail d'IA et simplifier les opérations MLOps.
Évolutivité des ressources
Améliore l'utilisation des GPU et CPU et renforce l'évolutivité des ressources hétérogènes.
Ordonnancement efficace
Ordonnance efficacement les tâches d'IA et de big data, et fournit une prise en charge de bout en bout pour l'ensemble du processus de production d'IA.
Accès accéléré aux données
Améliore les performances d'accès aux données et intègre des sources de données hétérogènes.
Observabilité
Prend en charge différentes méthodes d'observation des tâches, des quotas utilisateur et des ressources.
Flexibilité et extensibilité
Vous permet de créer une plateforme Cloud-native AI personnalisée en modifiant l'architecture extensible basée sur des composants.
Kubernetes standard
Fonctionne sur Kubernetes standard et est compatible avec les clouds publics, Apsara Stack, les clouds hybrides et les clusters ACK en périphérie.
Fonctionnalités
Utilisation efficace des ressources hétérogènes
Prend en charge l'ordonnancement GPU, le partage de GPU et l'isolation mémoire. Vous pouvez configurer différentes stratégies d'allocation de GPU et surveiller la consommation des ressources GPU selon plusieurs dimensions.
Performances d'accès aux données améliorées
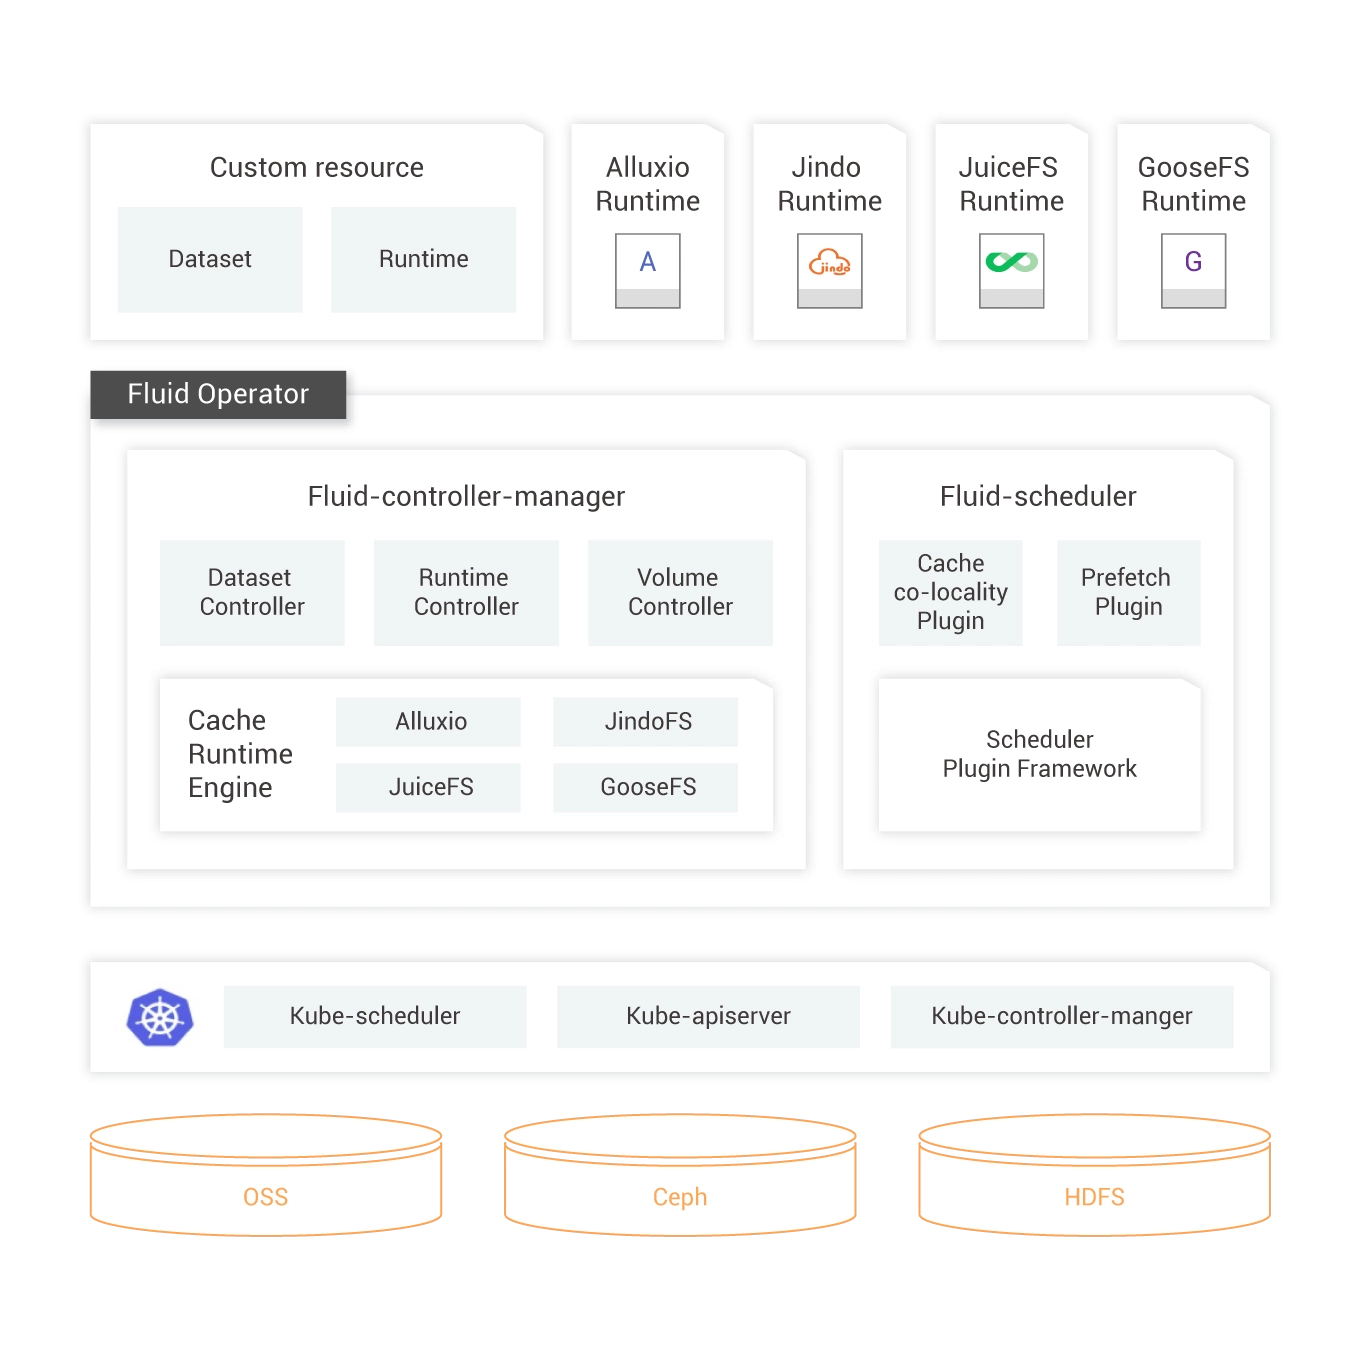
Sépare le calcul et le stockage. Fluid abstrait les données pour les applications Cloud-native AI et big data afin d'accélérer l'accès aux données. Fluid renforce également l'isolation de sécurité des données et élimine les silos de données causés par les différents types de stockage.
Ordonnancement des tâches d'IA
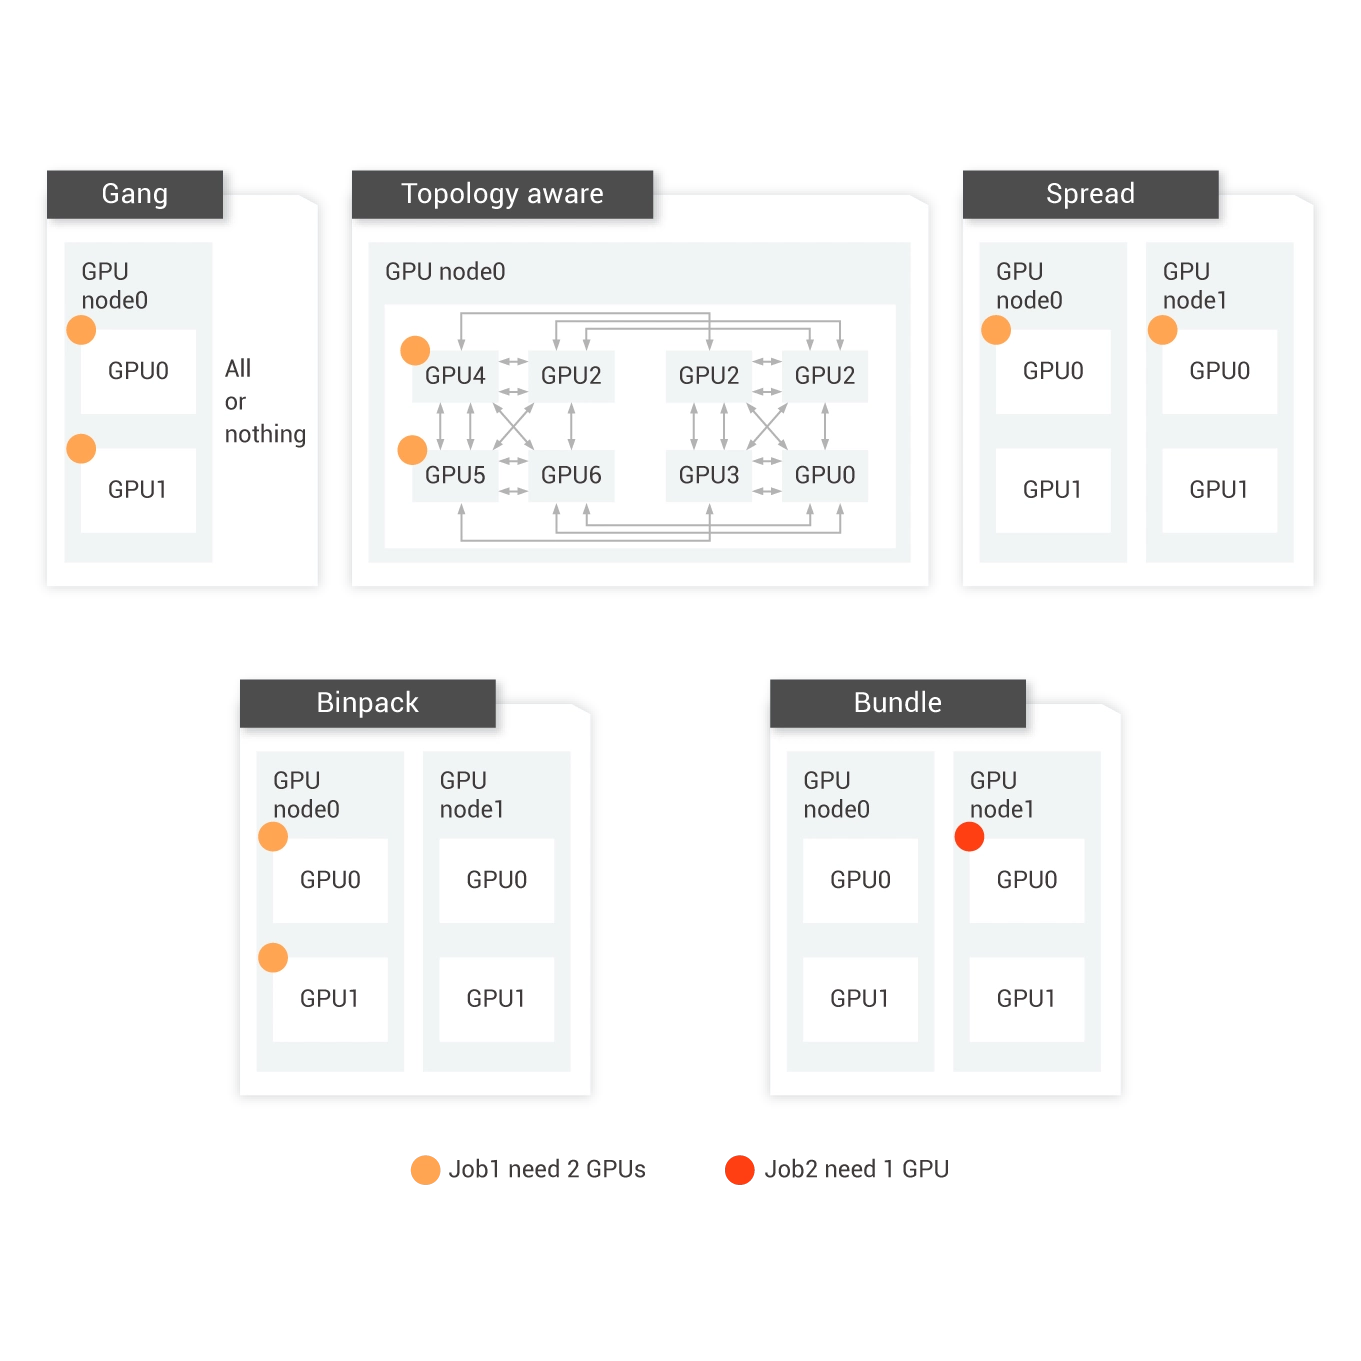
Prend en charge différentes stratégies d'ordonnancement (telles que le gang scheduling, le capacity scheduling et le binpack scheduling) pour répondre aux exigences des tâches d'IA et améliorer l'utilisation des ressources du cluster.
Mise à l'échelle automatique des ressources hétérogènes
Effectue un transfert de charge intelligent pour éviter le gaspillage de ressources cloud. Cloud-native AI prend également en charge l'entraînement élastique de modèles et l'inférence basée sur les modèles.
Observabilité des tâches, utilisateurs et ressources du cluster
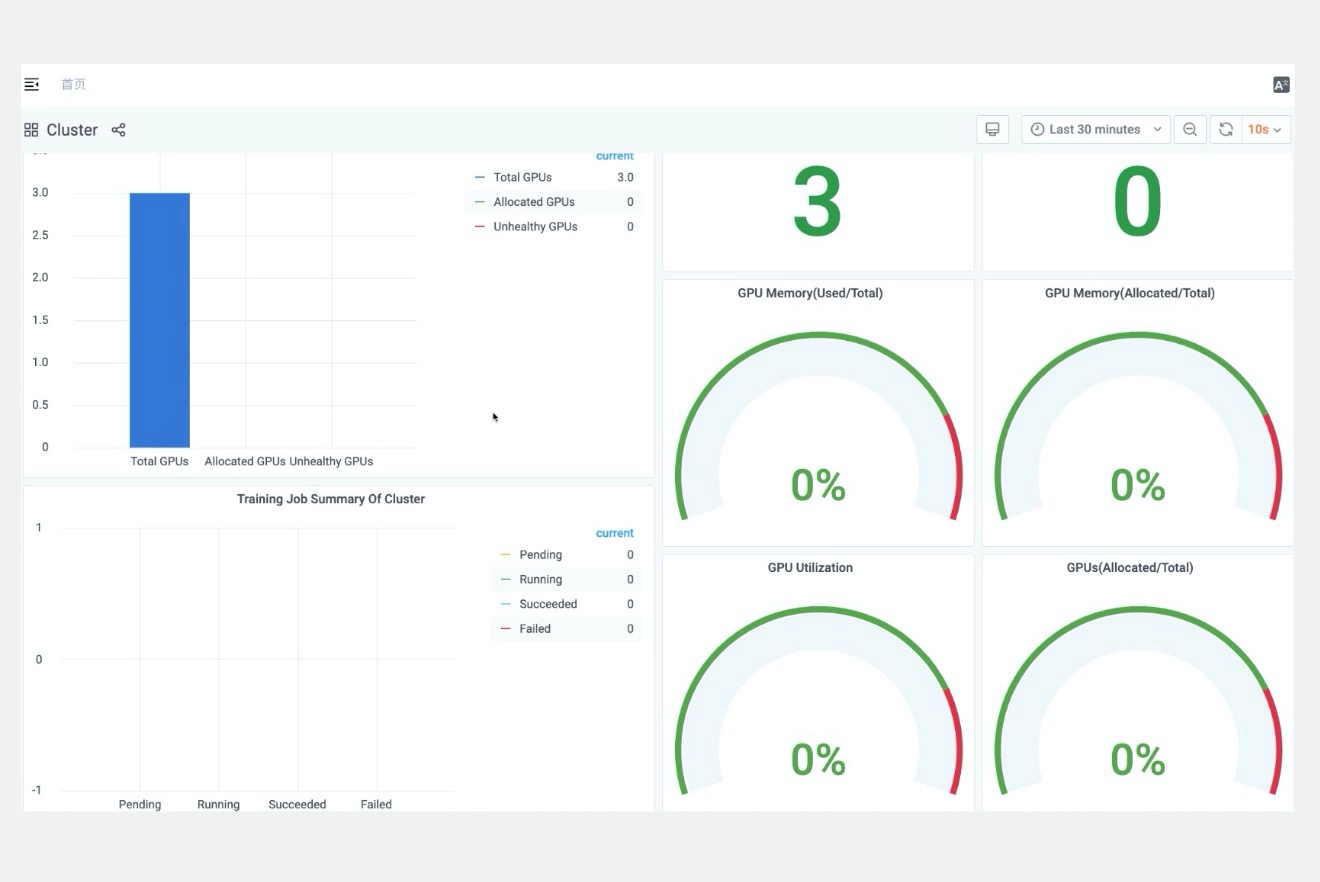
Fournit des tableaux de bord de surveillance pour les tâches, les quotas utilisateur et les ressources du cluster afin de vous aider à évaluer les entrées et les sorties.
Scénarios

Avantages
-
Allocation des ressources par groupes de projets
Vous pouvez répartir les membres d'un projet en groupes isolés. Vous pouvez ensuite allouer et isoler les ressources par groupe ou gérer les permissions des différents groupes.
-
Isolation et partage entre utilisateurs
Vous pouvez allouer les ressources du cluster à des groupes d'utilisateurs en fonction de vos besoins métier. Vous pouvez également gérer les permissions des utilisateurs au sein de chaque groupe, notamment les droits de lecture et d'écriture sur les tâches, ainsi que les droits d'accès des tâches aux données.
-
Quotas élastiques
Vous pouvez utiliser des groupes de quotas élastiques pour le capacity scheduling afin de partager les ressources et de les allouer de manière appropriée aux utilisateurs. Cette approche améliore le taux d'utilisation global des ressources des clusters.
Avantages
-
Abstraction native des jeux de données
Cloud-native AI encapsule les fonctionnalités fondamentales requises par les applications gourmandes en données. Cela permet un accès efficace aux données et réduit les coûts de gestion des données hétérogènes.
-
Préchargement et accélération des données dans le cloud
Fluid s'appuie sur des moteurs de cache distribués pour prendre en charge le préchargement et l'accélération des données dans le cloud. Cela garantit l'observabilité, la portabilité et la scalabilité horizontale automatique des données en cache.
-
Orchestration collaborative des données et des applications
Lors de l'ordonnancement des applications et des données dans le cloud, vous pouvez coordonner leur orchestration en fonction de leurs caractéristiques et de leur emplacement afin d'améliorer les performances globales.
-
Gestion des namespaces
Vous pouvez accéder simultanément aux données de plusieurs sources au sein d'un même jeu de données. Les sources prises en charge incluent Object Storage Service (OSS), Hadoop Distributed File System (HDFS), Ceph et d'autres services de stockage. Cette fonctionnalité est adaptée aux scénarios de cloud hybride.
-
Gestion des sources de données hétérogènes
Vous pouvez accéder simultanément aux données de plusieurs sources au sein d'un même jeu de données. Les sources prises en charge incluent Object Storage Service (OSS), Hadoop Distributed File System (HDFS), Ceph et d'autres services de stockage. Cette fonctionnalité est adaptée aux scénarios de cloud hybride.
Avantages
-
Partage et ordonnancement GPU
Vous pouvez exécuter plusieurs conteneurs sur un même GPU grâce au partage et à l'ordonnancement GPU.
-
Ordonnancement GPU par topologie
Vous pouvez sélectionner une combinaison de GPU adaptée et atteindre une vitesse d'entraînement optimale lors de l'ordonnancement GPU.
-
Binpack Scheduling
Les tâches sont d'abord allouées à un seul nœud. Lorsque ce nœud ne dispose pas de ressources suffisantes, elles sont réparties sur un autre nœud. Cette approche réduit les transmissions de données entre nœuds et évite la fragmentation des ressources.
-
Gang Scheduling
Les ressources ne sont allouées à une tâche que lorsque toutes ses sous-tâches disposent de ressources suffisantes. Ce mécanisme évite les blocages où les tâches volumineuses accaparent les ressources des tâches plus petites.
Avantages
-
Arena AI Toolkit
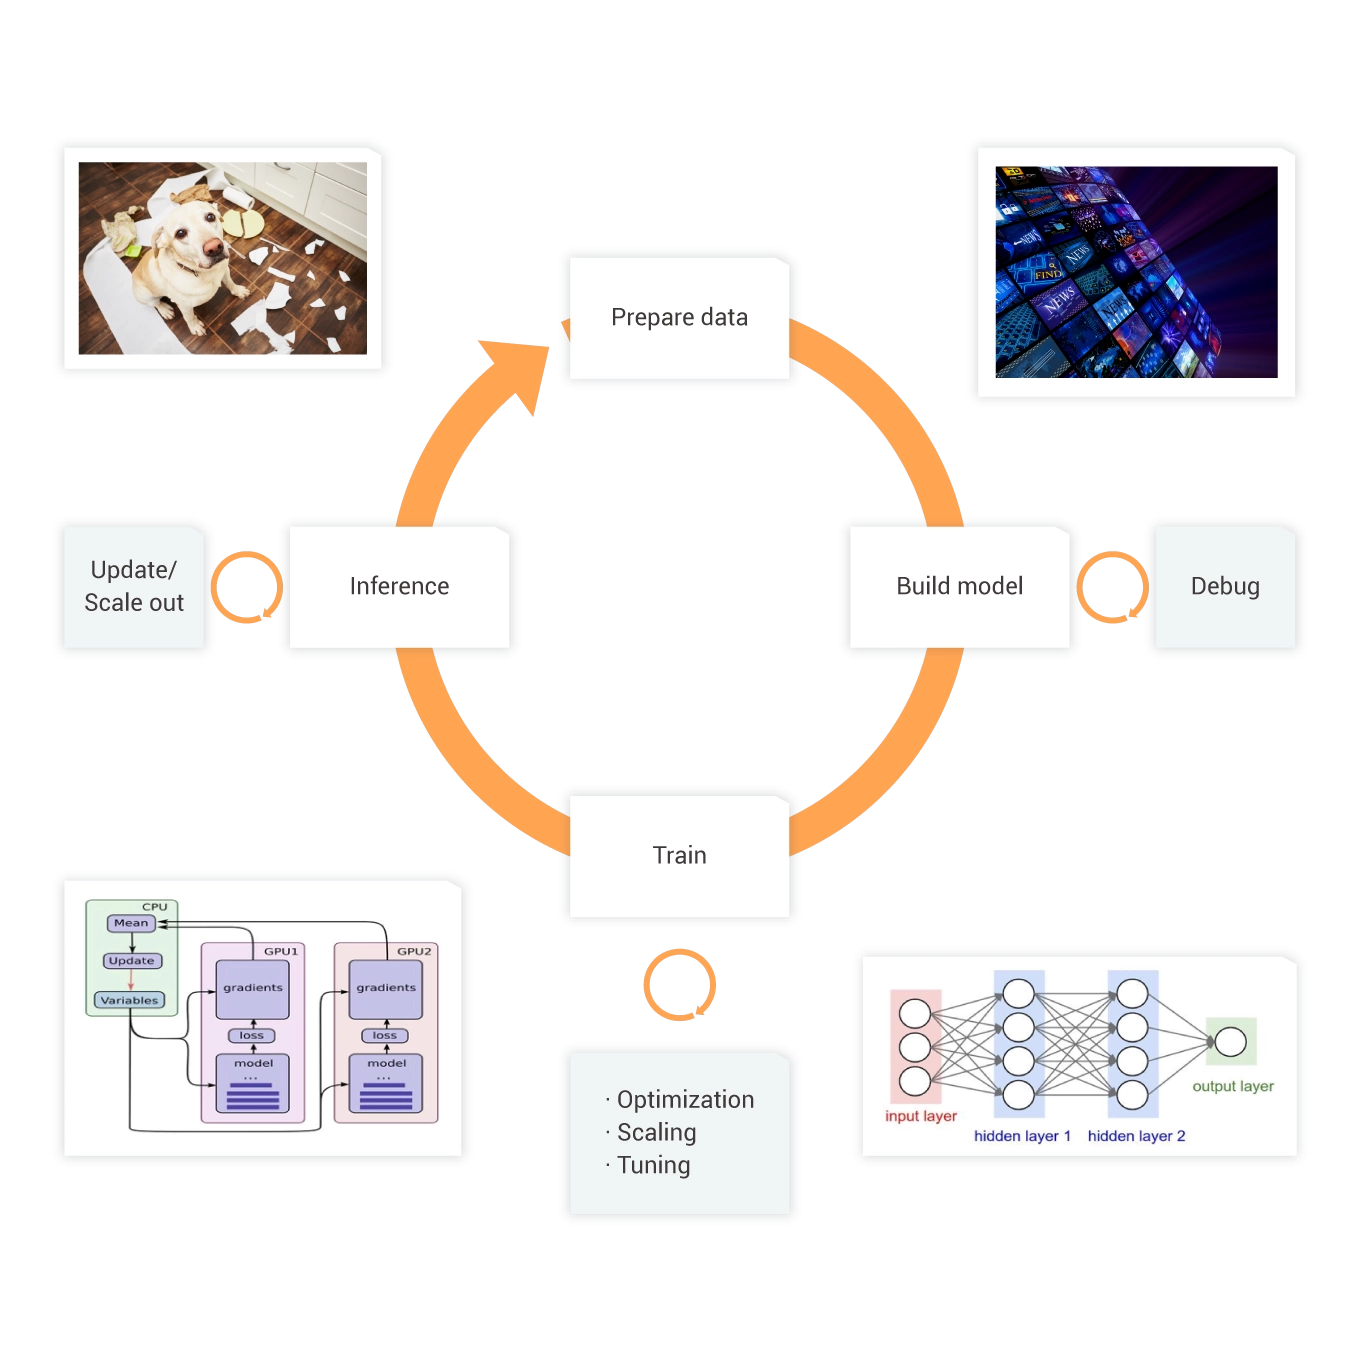
Les interfaces en ligne de commande et les SDK pour Go, Java et Python sont compatibles avec les ressources sous-jacentes hétérogènes. Vous pouvez ainsi gérer vos environnements, planifier des tâches, allouer des GPU et surveiller les ressources de manière simplifiée.
-
Le toolkit est compatible avec divers frameworks de deep learning tels que TensorFlow, PyTorch, Caffe, Message Passing Interface (MPI) et Horovod. Il couvre l'ensemble du processus MLOps (Machine Learning Model Operationalization Management), incluant la gestion des jeux de données d'entraînement, la gestion des tâches IA, le développement de modèles, l'entraînement distribué, l'évaluation et la mise en production des modèles d'inférence.
-
La console R&D fournit un environnement de développement d'algorithmes à la demande dans lequel vous pouvez effectuer des opérations de gestion tout au long du cycle de vie R&D. Ces opérations incluent la gestion des notebooks, la gestion des tâches IA, la gestion des modèles et la mise en production des modèles.
Avantages
-
Tableaux de bord d'utilisation GPU en temps réel
Surveillez l'utilisation des ressources en temps réel selon de multiples dimensions.
-
Gestion et accélération des jeux de données
Accélérez l'accès à vos jeux de données existants en un clic pour gagner en efficacité.
-
Gestion des utilisateurs et groupes
Vous pouvez créer des utilisateurs et des groupes d'utilisateurs par projet, et gérer les permissions et les quotas de manière granulaire.
-
Gestion des quotas élastiques
Le capacity scheduling permet aux groupes d'utilisateurs de partager dynamiquement les ressources.

