Alibaba Cloud Elasticsearch に関するよくある質問への回答です。クラスターの購入、設定、アクセス、クエリ、書き込み、プラグイン、形態素解析、ログ、再起動、クラスターの状態、バックアップ、モニタリングなどが含まれます。
よくある質問
インスタンスの購入と解約
機能に関するよくある質問
データの移行と同期
クラスターの再起動
クラスターの負荷と状態
クラスターのクエリと書き込み
クラスターの設定と変更
クラスターをアップグレードすると、メッセージ
UpgradeVersionMustFromConsoleが返されます。どうすればよいですか。クラスターの YML 設定ファイルで
http.max_content_lengthとdiscovery.zen.ping_timeoutの値を調整できますか?クラスターをアップグレードする際に、クラスターが異常であるというメッセージが表示されるが、クラスターの状態は green の場合の対処法
クラスターのデータノードをスケールインする際に、「The number of reserved nodes must be greater than 2」というエラーが報告された場合の対処法
auto_expand_replicasを使用するインデックスが原因でデータ移行またはノードのスケールインが失敗する場合、どうすればよいですか?
プラグイン、形態素解析、シノニム
ログ
データのバックアップと復元
クラスターのモニタリングとアラート
クラスターへのアクセス
インデックス作成
インスタンスの購入と解約
クラスター設定の誤り
クラスターの設定が要件を満たさない場合は、以下の表を参照して解決策を見つけてください。
解決策としてクラスターの登録解除が必要な場合は、まずデータをバックアップしてください (「手動バックアップと復元」をご参照ください)。登録を解除すると、データは削除され、回復できなくなります。
パラメーター | ソリューション |
課金方法 | 従量課金クラスターを購入した場合、サブスクリプション課金に切り替えることができます。「クラスターの課金方法を従量課金からサブスクリプションに変更する」をご参照ください。 |
バージョン | クラスターのバージョンは、以下の条件でのみ変更できます。
クラスターのバージョンをアップグレードするには、「クラスターのバージョンをアップグレードする」をご参照ください。上記以外のバージョン変更の場合は、クラスターの登録を解除し、新しいものを購入してください。 |
リージョン | この設定項目は変更できません。クラスターの登録を解除し、新しいものを購入する必要があります。 |
ゾーン | クラスターを別のゾーンに移行できます。「ゾーン内の Elasticsearch ノードを移行するか、Elasticsearch クラスターのデプロイモードをアップグレードする」をご参照ください。 説明 ゾーンを移行する前に、ご利用の Elasticsearch クラスターがアクティブ状態であることを確認してください。 |
ゾーン数 | この設定項目は変更できません。クラスターの登録を解除し、新しいものを購入する必要があります。 |
インスタンスの仕様 | この設定は変更できます。「クラスター設定のアップグレード」をご参照ください。 |
ストレージタイプ | この設定は変更できます。「クラスター設定のアップグレード」をご参照ください。 |
クラウドディスク暗号化 | この設定項目は変更できません。クラスターの登録を解除し、新しいものを購入する必要があります。 |
ノードあたりのストレージ領域 | この設定は変更できます。「クラスター設定のアップグレード」をご参照ください。 |
データノード数 | この設定は変更できます。「クラスター設定のアップグレード」をご参照ください。 |
ネットワークタイプ、VPC、vSwitch | これらの設定項目は変更できません。クラスターの登録を解除し、新しいものを購入する必要があります。 説明 Elasticsearch クラスターは VPC ネットワークタイプのみをサポートします。 |
ユーザー名 | デフォルトの管理者ユーザー名 elastic は変更できません。「Elasticsearch X-Pack ロールでアクセスの制御を管理する」を通じて、新しいユーザーを作成し、権限を割り当ててください。 |
パスワード | この設定は変更できます。「Elasticsearch クラスターのパスワードをリセットする」をご参照ください。 |
この表に記載されていない設定項目については、「クラスター設定のアップグレード」および「クラスターのダウングレード」のドキュメントを参照して、変更可能かどうかを確認してください。
購入ページのバージョンと Elasticsearch のバージョンのマッピング
購入ページのバージョン | 具体的なバージョン |
8.15 | 8.15.1 |
8.13 | 8.13.4 |
8.9 | 8.9.1 |
8.5 | 8.5.1 |
7.16 | 7.16.2 |
7.10 | 7.10.0 |
7.7 | 7.7.1 |
6.8 | 6.8.6 |
6.7 | 6.7.0 |
6.3 | 6.3.2 |
5.6 | 5.6.16 |
5.5 | 5.5.3 |
クラスターを購入する際は、既存のセルフマネージドクラスターに近いバージョンを選択してください。既存のクラスターがない場合は、最新バージョンを選択してください。
Elasticsearch 購入時に利用可能な VPC がない
「RAM ユーザーの詳細を表示する」を参照して、RAM ユーザーが VPC をリストする権限を持っているか確認してください。ユーザーがこの権限を持っていない場合は、「カスタムポリシーを作成する」を参照して権限を付与してください。
エラー:「vSwitch: may not be empty」
このエラーは、選択したゾーンに vSwitch が存在しないことを意味します。クラスター設定ページで選択したゾーンを確認し、VPC コンソールでそのゾーンに vSwitch が存在するかどうかを確認してください。存在しない場合は、作成してください。「IPv4 CIDR ブロックを持つ VPC を作成する」をご参照ください。
Elasticsearch クラスターを解約して新しいものを購入した場合、アクセスエンドポイントは変更されるか
はい。サービスの中断を避けるため、元のインスタンスの登録を解除する前に、クライアントコードを新しいエンドポイントで更新してください。
Elasticsearch クラスターのリリースまたは登録解除
従量課金クラスターまたは期限切れのサブスクリプションクラスターをリリースするには、「クラスターをリリースする」をご参照ください。
期限切れでないサブスクリプションクラスターの登録を解除するには:
Alibaba Cloud 管理コンソールにログインします。上部のナビゲーションバーで、 を選択します。[課金管理] コンソールの左側のナビゲーションウィンドウで、[登録解除] をクリックします。[登録解除] ページで、クラスターの登録解除または注文のキャンセルを実行します。詳細については、「リソースの登録解除方法」をご参照ください。
シングルノードの Elasticsearch クラスターは購入できるか
いいえ。最低 2 つのデータノードが必要です。「購入ページのパラメーター」をご参照ください。
インスタンス作成時のリソース不足
容量不足によりインスタンスの作成が失敗した場合は、以下のいずれかの解決策を試してください。
別のリージョンを選択する。
別のゾーンを選択する。ゾーンを切り替える前に、宛先ゾーンで vSwitch が利用可能であることを確認してください。そのゾーンに vSwitch が存在しない場合は、VPC コンソールで作成してください。
異なるリソース設定を選択する。
それでもリソースが利用できない場合は、後でもう一度試してください。リソースの在庫は動的であり、Alibaba Cloud は継続的にリソースを補充しています。
既存の Elasticsearch クラスターの仕様をアップグレードする際にリソースが利用できない場合は、各ノードをリソースが十分な別のゾーンに移行してから、アップグレードを再試行してください。同じリージョンおよび VPC の異なるゾーンにある Elasticsearch クラスターは、内部ネットワークを介して通信できます。クロスゾーンデプロイとゾーン移行の手順については、「クロス AZ デプロイと操作」をご参照ください。
1 vCPU、2 GiB データノードのアップグレード
Alibaba Cloud Elasticsearch は、パフォーマンスの安定性に関する懸念から、2021 年 5 月に 1 vCPU、2 GiB のデータノードの販売を停止しました。既存のノードは影響を受けませんが、学習用途にのみ適しており、本番環境には適さず、SLA の対象外です。できるだけ早くより高い仕様にアップグレードしてください。「クラスター設定のアップグレード」をご参照ください。
Elasticsearch クラスターの初期化がスタックする
初期化時間は、クラスターの仕様、データ構造、サイズによって異なります。このプロセスには数時間かかることがあります。
新しく購入したクラスターは、クラスターが「アクティブ化中」状態の間は内部エンドポイントを表示しません。内部エンドポイントは、クラスターが作成された後に利用可能になります。
変更に Elasticsearch クラスターの再起動が含まれる場合、再起動の所要時間はインデックスデータ、クラスターサイズ、再起動方法によって異なります。通常、数時間かかります。詳細については、「クラスターまたはノードを再起動する」をご参照ください。
タスクリストで変更の進捗を監視して、クラスターの作成または再起動が正常に進行しているかどうかを判断できます。変更の進捗が長期間変わらない場合は、「インスタンスタスクの進捗を表示する」を参照して問題をトラブルシューティングしてください。
Kibana を別途購入する必要があるか
いいえ。各 Elasticsearch クラスターにはデフォルトで Kibana ノードが含まれており、無効にすることはできません。、その仕様を選択できます。詳細な手順については、「Alibaba Cloud Elasticsearch クラスターを作成する」をご参照ください。
安定性のために、少なくとも 2 vCPU と 4 GiB のメモリを持つ Kibana ノードを選択してください。1 vCPU、2 GiB のオプションは無料ですが、テスト用途にのみ適しています。
作成したインスタンスが見つからない
Elasticsearch コンソールの上部にあるリージョンセレクターで正しいリージョンを選択していることを確認してください。リージョンが正しいのにクラスターが表示されない場合は、以下の方法を試してください。
ブラウザのキャッシュをクリアし、Alibaba Cloud アカウントに再度ログインします。ログインセッションの有効期限が切れている場合は、再度ログインして復元する必要があります。
別のネットワークを試してください。
[課金管理] コンソールの [注文管理] ページに移動し、注文を Alibaba Cloud Elasticsearch でフィルタリングします。注文状況を確認して、クラスターが更新されなかったためにリリースされたかどうかを確認します。クラスターはサービス終了後 7 日でリリースされます。一度リリースされると、そのデータは完全に削除され、更新によって回復することはできません。新しいクラスターを作成してください。
専用マスターノードとコーディネーティングノードを購入するタイミング
専用マスターノードは、インデックスの作成または削除、クラスター内のノードの追跡、どのシャードをどのノードに割り当てるかの決定など、クラスター全体の操作を担当します。安定したマスターノードは、クラスターの健全性にとって不可欠です。以下のシナリオでは、専用マスターノードを購入する必要があります。
マスターノードとしても機能するデータノードの負荷が高い場合。
クラスターが書き込み集中型のワークロードを処理する場合。
高いクラスターの安定性は重大です。
コーディネーティングノードは、受信したクエリおよび書き込みリクエストを処理し、リクエストを適切なデータノードに転送し、結果をマージします。クラスターがリソースを大量に消費する集約クエリを頻繁に実行する場合は、専用のコーディネーティングノードを購入してください。一般的に、コーディネーティングノードとデータノードの比率を 1:5 (データノード 5 台ごとにコーディネーティングノード 1 台) に保ち、最低 2 台とします。コーディネーティングノードの仕様は、データノードの仕様と一致させる必要があります。より詳細なガイドについては、「仕様と容量の評価」をご参照ください。
デフォルトのユーザー名
デフォルトのユーザー名は elastic です。カスタムユーザーを作成することもできます。「Elasticsearch X-Pack ロールでアクセスの制御を管理する」をご参照ください。
機能に関するよくある質問
バージョンのアップグレードとダウングレード
インプレースアップグレードは、特定のバージョンパス (5.5 から 5.6、5.6 から 6.3、6.3 から 6.7) でのみ利用可能です。
その他のアップグレードパスやダウングレードの場合は、新しいクラスターを作成し、データを手動で移行する必要があります。これには、ターゲットバージョンの新しいクラスターを購入し、元のクラスターからデータを移行した後、元のクラスターの登録を解除またはリリースする作業が含まれます。
Alibaba Cloud Elasticsearch の無料トライアルクラスターは、バージョン 8.5 および 8.9 でのみ利用可能であり、作成後に変更することはできません。
インプレースでのバージョンアップグレードについては、「クラスターのバージョンをアップグレードする」をご参照ください。
新しいクラスターを作成するには、「Alibaba Cloud Elasticsearch クラスターを作成する」をご参照ください。
Alibaba Cloud Elasticsearch クラスター間のデータ移行については、「Alibaba Cloud Elasticsearch クラスター間の移行」をご参照ください。
期限切れでないサブスクリプションクラスターの登録を解除するには、「登録解除と返金ポリシー」をご参照ください。従量課金クラスターをリリースするには、「クラスターをリリースする」をご参照ください。
バージョンをダウングレードする際は、以下の制限にご注意ください。
Object Storage Service (OSS) のスナップショットは、新しい Elasticsearch バージョンから古い Elasticsearch バージョンに復元することはできません。
Logstash を使用してデータを移行する場合、Logstash のバージョンが宛先クラスターの Elasticsearch バージョンと互換性があることを確認してください。Alibaba Cloud Logstash はバージョン 8.11、7.4、6.7 をサポートしています。
Kibana のバージョンはクラスターの Elasticsearch バージョンと一致しており、個別にダウングレードすることはできません。
SSH 経由で Elasticsearch クラスターにログインして設定を変更できるか
いいえ。Elasticsearch は SSH アクセスをサポートしていません。クラスター設定を変更するには、「クラスター設定の概要」をご参照ください。
Logstash 6.7 は Elasticsearch 6.3 と互換性があるか
はい、互換性があります。「製品の互換性」をご参照ください。
データソースとしての Elasticsearch のサポート
Elasticsearch クラスターのパブリックホワイトリストにQuick BI の IP アドレスを追加することで、パブリックネットワーク経由で Quick BI を Elasticsearch に接続できます。
スコアリングプラグインのサポート
Elasticsearch は、インデックス用のトークナイザーの作成とスコアによるソートをサポートしています。「クイックスタート:インスタンス作成からデータ検索まで」をご参照ください。
Elasticsearch は LDAP 機能をサポートしているか
はい。まず、同じバージョンのオンプレミス Elasticsearch クラスターをデプロイしてテストします。テストに合格したら、コンソールで LDAP テンプレートを設定します。「LDAP 認証と X-Pack を統合するためのベストプラクティス」をご参照ください。
Elasticsearch は Java SDK を提供しているか
はい。各バージョンには独自の SDK があります。「Java API」をご参照ください。
カーネルバージョン
デフォルトでは、Elasticsearch クラスターは最新のカーネルバージョンを使用します。利用可能なバージョンは「カーネルバージョンのリリースノート」に記載されています。クラスターが最新のカーネルバージョンを使用していない場合、クラスターの[基本情報] ページに 新しいカーネルパッチが利用可能です。 というメッセージが表示されます。メッセージをクリックすると、クラスターの現在のカーネルバージョンが表示されます。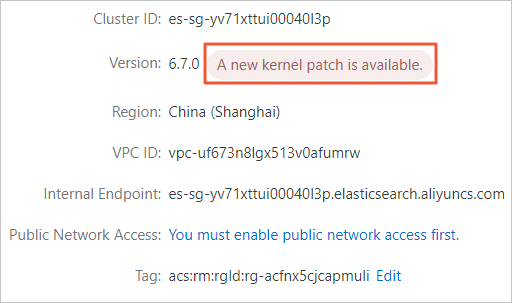
Elasticsearch クラスターの強制再起動
Elasticsearch クラスターが異常な状態 (イエローまたはレッド状態) の場合、標準の再起動は実行できません。代わりに、強制再起動を実行する必要があります。これは、サービスの不安定化、データ損失、または読み書きの失敗を引き起こす可能性のある高リスクな操作です。注意して進めてください。
Log4j 2 の修正を確認する
クラスターの再起動が成功すると、脆弱性が修正されたことが確認されます。「[脆弱性アラート] Apache Log4j 2 リモートコード実行の脆弱性」をご参照ください。
Log4j2 の脆弱性を修正するために Elasticsearch クラスターをアップグレードする必要があるか
いいえ。手順に従うだけで十分です。
クロスリージョンの Elasticsearch インスタンス間のプライベートネットワーク通信
異なるリージョンにある Elasticsearch インスタンス間でプライベートネットワーク通信を有効にするには、以下のいずれかの方法を使用します。
Elasticsearch クラスター間のデータ移行
移行方法はシナリオ (Alibaba Cloud クラスター間、またはセルフマネージド/サードパーティクラスターから) によって異なります。「移行方法の選択」をご参照ください。
HTTPS 用のコーディネーティングノード
以下の Alibaba Cloud Elasticsearch バージョンでは、HTTPS プロトコルを有効にするためにコーディネーティングノードを購入する必要はありません。クラスターに既にコーディネーティングノードがある場合は、それらを無効にできます。
バージョン 7.16 以降。
他のすべてのバージョンでは、HTTPS プロトコルを有効にするにはコーディネーティングノードが必要です。一度購入すると、これらのノードを無効にしたり削除したりすることはできません。
Alibaba Cloud Elasticsearch は、HTTPS が有効になった後、定期的に証明書を更新します。バージョン 7.10 以前はデータノードでのローリング証明書更新をサポートしていないため、更新中のサービスへの影響を最小限に抑えるために、証明書はコーディネーティングノードにデプロイされます。クラスターにコーディネーティングノードがない場合、HTTPS を有効にする際にシステムから購入を促されます。「HTTPS プロトコルを使用する」をご参照ください。
ノードあたりの最大シャード数
Elasticsearch 7.x では、単一ノードは最大 1,000 シャードをサポートします。他のバージョンには制限はありません。クラスターの仕様に基づいてノードあたりのシャードを設定してください。「仕様とストレージ容量の評価」および「シャードのサイズ設定」をご参照ください。
max_shards_per_node パラメーターを使用して、ノードあたりの最大シャード数を一時的に変更するには、次のコマンドを実行します。
PUT /_cluster/settings
{
   "transient": {
      "cluster": {
        "max_shards_per_node":10000
      }
   }
}長期的な解決策としてこのパラメーターに大きな値を設定することは避けてください。代わりに、ノードを追加するか、クラスター内のシャード数を減らしてください。クラスターの安定性を維持し、高負荷を防ぐために、シャードを適切に計画してください。
.monitoring-es インデックス
デフォルトでは、X-Pack モニタリングコンポーネントは 10 秒ごとにクラスターデータを収集し、.monitoring-* というプレフィックスを持つインデックスに保存します。たとえば、バージョン 6.x のインスタンスでは、.monitoring-es-6-* と .monitoring-kibana-6-* という 2 つのプライマリインデックスタイプが作成され、毎日ロールオーバーされます。データは .monitoring-es-6- というプレフィックスと現在の日付のサフィックスを持つインデックスに保存されます。
.monitoring-es-6-* インデックスは、主にクラスターの状態、クラスターの統計、ノードの統計、インデックスの統計を保存するため、かなりのディスク領域を消費します。「Elasticsearch クラスターのモニタリングを設定する」をご参照ください。
データディスクの暗号化アルゴリズム
Elasticsearch のディスク暗号化は、AES-256 と Key Management Service (KMS) を使用してクラウドディスクを暗号化します。「ディスク暗号化」をご参照ください。
ポート 9300 のサポート
Alibaba Cloud Elasticsearch 5.x はポート 9300 (TCP) と 9200 (HTTP/HTTPS) の両方をサポートしていますが、それ以降のバージョンはポート 9200 のみをサポートしています。
Alibaba Cloud Elasticsearch 6.0 以降のインスタンスは、Transport Client でのポート 9300 への接続をサポートしていません。ポート 9300 にアクセスするには、5.x のインスタンスを購入する必要があります。
データの移行と同期
MongoDB から Alibaba Cloud Elasticsearch への同期
Monstache を使用して、ApsaraDB for MongoDB から Alibaba Cloud Elasticsearch にリアルタイムでデータを同期します。「Monstache を使用して MongoDB から Elasticsearch にリアルタイムでデータを同期する」をご参照ください。
インスタンスの再起動
クラスターとノードの再起動時間
再起動時間は、クラスターの仕様、データ構造、データ量によって異なります。通常、数時間かかります。「クラスターまたはノードを再起動する」をご参照ください。
パブリックアクセスの有効化または無効化はクラスターの再起動をトリガーするか
いいえ。この操作は有効になる際にクラスターの状態を一時的に変更しますが、通常の操作には影響しません。
クラスターのアクセスパスワードの変更はクラスターの再起動をトリガーするか
いいえ。パスワードの変更は、再起動ではなくクラスターの再読み込みをトリガーします。「Elasticsearch クラスターのパスワードをリセットする」をご参照ください。
インデックスにレプリカがない場合、クラスターの再起動に影響するか
はい。レプリカがない場合、再起動中にサービスの中断が発生する可能性があります。負荷が低く、レプリカシャードがあり、オフピーク時に再起動する場合、サービスは通常利用可能です。ただし、高い同時実行性、強制再起動、重いワークロード、またはインデックスにレプリカがない場合には、タイムアウトが発生する可能性があります。クライアントにリトライメカニズムを設定し、オフピーク時に再起動してください。
ノードロールまたは単一ノードの再起動
ノードロールの再起動
インスタンスの 基本情報 ページで 再起動 をクリックし、操作タイプ を ノードのロール に設定し、対応するノードロールを選択します。「クラスターまたはノードを再起動する」をご参照ください。
単一ノードの再起動
単一ノードは、以下のいずれかの方法で再起動できます。
インスタンスの 基本情報 ページで 再起動 をクリックします。表示されるダイアログボックスで、操作タイプ を ノード に設定し、再起動したいノードを選択します。「クラスターまたはノードを再起動する」をご参照ください。
基本情報 ページで、ノード可視化 セクションを見つけ、再起動したいノードにカーソルを合わせ、ポップアップで 再起動 をクリックします。「クラスターの状態とノード情報」をご参照ください。
スタックしたインスタンスの再起動
「インスタンスタスクの進捗を表示する」でインスタンス変更タスクの詳細を確認してください。バージョン 7.16 を実行していないインスタンスの場合、再起動には数時間かかることがあります。進捗が長期間変わらない場合は、以下の表のトラブルシューティング手順に従ってください。
考えられる原因 | ソリューション |
プラグインの問題でノードが起動しない。 | プラグインを削除する。 |
ディスク使用率が高いため、シャードの割り当てに失敗する。 説明 クラスターのモニタリングページでディスク使用率を確認してください。「メトリックと例外処理」をご参照ください。 | インデックスを削除するか、一時的にレプリカシャードの数を 0 に設定する。 |
クラスターパラメーターの設定ミスにより、シャードの割り当てに失敗する。 |
|
レプリカシャードの数がノードの数より多い。 | レプリカシャードの数を調整する。 |
仕様が不十分なため、クラスターがメモリ不足 (OOM) になる。 |
Elasticsearch ノードの定期的な再起動
ノードの定期的な再起動はサポートされていません。回避策として、自分で設定した定期タスクから RestartInstance API を呼び出してください。
クラスターの負荷または状態の異常
ノード負荷の不均衡
この問題は、不適切なシャード設定、不均一なセグメントサイズ、ホットデータとコールドデータの要件、Service Load Balancer (SLB) やマルチ AZ デプロイに関連する未解放の接続保持など、いくつかの要因によって引き起こされるクラスター負荷の不均衡に起因します。シナリオに基づいてトラブルシューティングを行ってください。「クラスター負荷の不均衡に関する分析方法とソリューション」をご参照ください。
問題をトラブルシューティングする前に、クラスターの仕様を確認してください。クラスターが 1 vCPU と 2 GiB のメモリを持つノードを使用している場合は、ノードを 2 vCPU と 4 GiB のメモリ以上にアップグレードしてください。「クラスター設定のアップグレード」をご参照ください。
1 vCPU と 2 GiB のメモリを持つノードは学習専用であり、本番環境用ではありません。SLA の対象外です。これらの仕様は安定性が限られており、現在は購入できません。既存の 1 vCPU、2 GiB のノードはできるだけ早くアップグレードしてください。
テスト環境には 2 vCPU と 4 GiB のメモリを持つノードを使用してください。本番環境には、より高い仕様を使用してください。
Elasticsearch クラスターの状態がイエローの場合の解決策
原因
インデックスに設定されたレプリカ数が、利用可能なノード数から 1 を引いた数を超えると、Elasticsearch クラスターはイエロー状態になります。この状態では、Elasticsearch はすべてのレプリカシャードを割り当てることができません。
ソリューション
GET _cat/indices?vコマンドを実行してシャードの分散を表示し、イエロー状態のインデックスを特定して、そのレプリカ数を 0 に設定します。クラスターの状態がグリーンに戻った後、インデックスの元のレプリカ数を復元します。警告レプリカ数を 0 に設定すると、ノードがオフラインになった場合にデータが失われる可能性があるため、注意して進めてください。クラスターの状態がグリーンに戻った後 (約 1 分後)、できるだけ早く元のレプリカ数を復元してください。
PUT test/_settings
{
  "index" : {
    "number_of_replicas":"0"
  }
}
クラスターの状態がレッドの場合のトラブルシューティング
プライマリシャードをホストしているノードが利用できなくなり、シャードが割り当てられなくなると、クラスターの状態はレッドになります。GET /_cat/indices?v コマンドを実行してシャードの分散を表示し、レッド状態のインデックスを特定します。以下の表を使用して問題をトラブルシューティングしてください。
原因 | ソリューション |
負荷の不均衡により、クラスターリソースが不足する。 | プライマリシャードとレプリカシャードの合計数がデータノード数の倍数になるように調整します。「不均等に分散したシャードを再分散する方法」をご参照ください。 |
クラスターに不要なインデックスデータが含まれている。 | 不要なインデックスデータ、特に .monitoring で始まるモニタリングインデックスを定期的にクリーンアップします。「モニタリングインデックスを設定する」をご参照ください。 |
シャードが未割り当てである。 |
|
高いキャッシュ使用量がリソースを消費している。 |
|
アップグレードなどのクラスター設定変更が進行中である。 | 現在の変更を中断し、アップグレードページで [強制更新] を選択します。「クラスター設定のアップグレード」をご参照ください。 |
1 vCPU と 2 GiB、または 2 vCPU と 4 GiB などの低いインスタンス仕様により、リソースが不足する。 | 説明
|
ディスク使用率が 85% を超える。 | 不要な履歴データを削除するか、ディスク容量を拡張します。「高いクラスターディスク使用率と読み取り専用の問題のトラブルシューティングと解決」をご参照ください。 |
高いクラスター CPU 使用率
以下の表に、一般的な原因と解決策を示します。
原因 | ソリューション |
書き込みまたはクエリの QPS の増加が CPU 使用率を増加させることが示されている。 | 同時書き込みを減らし、書き込みとクエリの QPS を下げるか、クラスターをスケールアップまたはスケールアウトします。本番環境でストレステストを実行して、適切な仕様を決定してください。 |
インデックスキャッシュからの高いリソース消費。 |
|
クラスターの仕様が低すぎる。 | |
負荷の不均衡による単一ノードの高い CPU 使用率。 | プライマリシャードとレプリカシャードの合計数をデータノード数の倍数に設定して、シャードの負荷を最適化します。「不均等に分散したシャードを再分散する方法」をご参照ください。 |
Elasticsearch クラスターの高いディスク使用率への対処
DELETE /<index_name> コマンドを実行して不要なインデックスを削除します。ディスク使用率が 75% を下回ったら、コンソールでクラスター設定をアップグレードします。単一ノードのディスク使用率が高すぎる場合は、シャードの分散を最適化します。「不均等に分散したシャードを再分散する方法」をご参照ください。
高いディスク使用率がクラスターに影響を与えないように、モニタリングとアラートを有効にしてください。「メトリックと例外処理」をご参照ください。クラスターへの影響は、ディスク使用率のしきい値によって異なります。
85% を超える:システムは影響を受けるノードに新しいシャードを割り当てなくなります。
90% を超える:Elasticsearch は、影響を受けるノードからディスク使用率の低い他のデータノードにシャードを移動しようとします。
95% を超える:システムはクラスター内のすべてのインデックスに read_only_allow_delete ブロックを適用します。これにより、書き込み操作が防止されます。インデックスからの読み取りまたは削除のみが可能です。
Elasticsearch の高いメモリ使用量への対処
以下の表に、一般的な原因とその解決策を示します。
原因 | ソリューション |
高いクラスターキャッシュ使用量。 |
|
高いクエリおよび書き込みスループット。 | 読み書き操作を停止し、クラスター速度制限プラグイン (aliyun-qos) で速度制限を有効にします。 |
不要なインデックスがメモリを消費している。 | 不要なインデックス、特に.monitoring-* というプレフィックスを持つインデックスを削除します。モニタリングログを設定することで保持期間を設定します。 |
不均等なシャード分散が単一ノードの高いメモリ使用量を引き起こす。 | プライマリシャードとレプリカシャードの合計数をデータノード数の倍数に設定して、シャードの負荷を最適化します。「不均等に分散したシャードを再分散する方法」をご参照ください。 |
高価なクエリや異常なクエリ (アプリケーションからの特殊文字の長い文字列を含むクエリなど)。 |
|
不均等なシャードの再分散
負荷を均等に分散し、過負荷のノードを防ぐために、プライマリシャードとレプリカシャードの合計数がクラスター内のデータノード数の倍数になるようにシャードを計画してください。
クラスターに 3 つのデータノードがある場合、プライマリシャードの数を 3、レプリカの数を 1 に設定して、合計 6 シャードにすることができます。
クラスターに 8 つのデータノードがある場合、プライマリシャードの数を 4、レプリカの数を 1 に設定して、合計 8 シャードにすることができます。または、プライマリシャードの数を 8、レプリカの数を 1 に設定して、合計 16 シャードにすることもできます。
シャード数を調整した後、オフピーク時にデータをインデックスの再作成して変更を適用してください。レプリカシャードの数が多いほど、クラスターの可用性とクエリパフォーマンスが向上しますが、メモリ消費も増加します。
シャードのサイズと数は、Elasticsearch クラスターの安定性とパフォーマンスに影響を与える重要な要素です。Elasticsearch クラスター内のすべてのインデックスには、適切なシャード計画が必要です。この計画は、不明確なビジネス要件から生じることが多い、大きすぎるシャードによるパフォーマンスの低下を防ぐのに役立ちます。シャード計画の推奨事項については、「シャードの評価」をご参照ください。
不均等なシャード分散は、クラスター負荷の不均衡につながります。この問題は、以下の方法で確認できます。
メトリックの意味と異常処理の提案。ノードの CPU、メモリ、またはディスクの負荷が一貫して高い場合、それは不均等なシャード分散を示しています。
GET _cat/shards?vコマンドを実行して、インデックスのシャード情報を表示します。インデックスのシャードが同じ高負荷ノードに多数存在する場合、分散は不均等です。
異常なクラスター負荷または java.lang.StackOverflowError
このエラーは Lucene のスタックオーバーフローを示し、正規表現またはあいまい一致を使用するクエリによって引き起こされます。この問題は Elasticsearch 6.0 以降で修正されています。これを解決するには、クラスターのバージョンをアップグレードするか、クエリ文を最適化してください。「クラスター全体の java.lang.StackOverflowError」をご参照ください。
JVM ヒープメモリの確認
GET _nodes/stats/jvm?pretty を実行します。デフォルトでは、ヒープメモリはクラスターメモリの半分です。この設定は変更できません。
Elasticsearch クラスターで強制マージを実行すると、サービス停止やノードのメモリ不足 (OOM) エラーが発生する可能性があるか
強制マージ自体がクラスターの停止を引き起こすことはなく、マージ中もインデックスはクエリに利用できます。ただし、マージは大量の I/O および CPU リソースを消費します。クラスターの負荷がすでに限界に近い場合、強制マージはパフォーマンスの変動を引き起こし、深刻な場合にはノードのメモリ不足 (OOM) エラーが発生してクラスターの安定性に影響を与える可能性があります。強制マージを実行する前に、モニタリングページでコンピューティングユニット (CU) の使用量を確認してください。クラスターに十分なリソースの余裕がない場合は、リスクを軽減するために一時的に CU の仕様を上げてください。
クラスターのクエリと書き込み
キューサイズの調整
キューサイズを調整するには、YML パラメーター設定で thread_pool.write.queue_size パラメーターを指定します (YML パラメーターの設定)。調整を行う前に、GET /_cat/thread_pool?v を実行してキューの使用量を確認してください。
バージョン 6.0 より前の Elasticsearch クラスターでは、thread_pool.index.queue_size パラメーターを使用してください。
時間範囲によるデータのクエリまたはエクスポート
特定の時間範囲のデータをクエリするには、範囲クエリを使用します。
特定の時間範囲のデータをエクスポートするには、Logstash でフィルタリングします。「Logstash 設定ファイル」をご参照ください。
Elasticsearch の一括挿入操作におけるドキュメント数に制限はあるか
はい。単一の一括リクエストのデフォルトの最大ペイロードは 100 MB です (HTTP 設定)。合計サイズは、ドキュメント数だけでなく、ドキュメントのサイズと複雑さにも依存します。ドキュメントが大きい場合は、バッチあたりの数を減らしてください。5〜15 MB のバッチから始めて、徐々に増やしてください。「一括リクエストの使用とサイズ設定」をご参照ください。
Elasticsearch クエリ結果の時間差への対処
デフォルトでは、Elasticsearch は日付を協定世界時 (UTC) で保存します。タイムゾーンの違いを処理するには、以下のいずれかの方法を使用します。
日付タイプのデータをクエリする際に、time_zone パラメーターを含めます。または、時間データをタイムスタンプとして保存します。「<field> のパラメーター」をご参照ください。
時間データを書き込む際にタイムゾーンオフセットを含めます。例:
"time" : "2022-07-15T12:58:17.136+0800"(UTC + 08:00)。Kibana を使用してデータを表示します。Kibana はブラウザのタイムゾーンを検出し、表示用に UTC 時間を自動的に変換します。「Kibana に表示されるデータのタイムゾーンを調整する方法」をご参照ください。
Logstash を使用してデータを同期し、8 時間の時間差が発生した場合は、パイプライン設定で手動で時間を調整できます。たとえば、次のフィルターを使用します:
filter{ ruby{ code => "event.set('update_time', event.get('update_time').time.localtime + 8*60*60)" } }。
Elasticsearch クエリの遅延またはタイムアウト
コンソールのスロークエリログを確認し、メトリックの定義とトラブルシューティングの提案を使用して原因を特定します。一般的な原因と解決策:
原因 | ソリューション |
|
|
クラスターリソースの不足。 | 集約、用語クエリ、 説明
|
「Data too large」エラーの解決
原因
このエラーは、高い書き込みスループットがサーキットブレーカーをトリガーしたときに発生し、クラスターが書き込みリクエストの量を処理するのに十分なリソースがないことを示します。
ソリューション
重要これらの操作を実行できない場合は、すべてのクエリおよび書き込みリクエストを停止し、クラスターを強制的に再起動してください。クラスターが正常な状態に戻った後、以下の手順に従ってください。
POST /<index_name>/_cache/clear?fielddata=trueコマンドを実行してインデックスキャッシュをクリアします。問題が解決しない場合は、次のステップに進みます。GET /_cat/indices?vコマンドを実行して、シャードが不均等に分散しているかどうかを確認します。「不均等に分散したシャードを再分散する方法」をご参照ください。問題が解決しない場合は、次のステップに進みます。同時書き込みを減らし、不要なインデックスを削除してリソースを解放し、Kibana モニタリングの使用を最小限に抑えます。
Kibana モニタリングを無効にするには、次のコマンドを実行します。
PUT _cluster/settings
{
	"persistent": {
		"xpack.monitoring.collection.enabled": false
	}
}
問題が解決しない場合は、次のステップに進みます。
クラスターの設定をアップグレードして、その容量を増やします。
インデックスの一括削除
インデックスを一括で削除するには、YML パラメーターを設定します。削除する時にインデックス名の指定 パラメーターを ワイルドカードを使用して指定 に設定し、クラスターを再起動します。再起動後、ワイルドカードを使用してインデックスを一括で削除できます。「YML パラメーターの設定」をご参照ください。
削除されたインデックスは回復できません。この設定は注意して使用してください。
「index uuid conflicted」エラー
これは既知の問題です。解決するには、インスタンスのカーネルバージョンを 1.5.0 以降にアップグレードしてください。手順については、「クラスターのバージョンをアップグレードする」をご参照ください。
index.max_result_window の変更
Elasticsearch では、index.max_result_window パラメーターのデフォルト値は 10000 です。このパラメーターは、ページングクエリで返されるドキュメントの最大数 (from + size) を定義します。この値を超える数のドキュメントをクエリすると、次のエラーが返されます:Result window is too large, from + size must be less than or equal to: [10000]。
一部のディープページング検索シナリオでは、このパラメーター値を増やす必要がある場合があります。次のコマンドを実行して、特定のニーズに基づいて index.max_result_window の値を変更できます。例の値は参考用です。コマンドを実行すると、ES クラスターを再起動してもこの設定は保持されます。
PUT /my_index/_settings
{
  "index": {
    "max_result_window": 50000
  }
}ディープページングに from と size を使用すると、大量の CPU とメモリを消費する可能性があるため、避けてください。ディープページングシナリオでは、代わりに scroll または search after 機能を使用してください。
「more than 1 type」エラーの解決
このエラーは、更新操作で元の index とは異なる type が使用されたことを示します。Elasticsearch では、index ごとに 1 つの type のみが許可されています。更新操作で、元の index と同じ type が使用されていることを確認してください。
Elasticsearch はバージョン 7.0 以降でマッピングタイプを削除しました。すべてのインデックスは現在、単一のタイプ _doc を使用しています。
インデックス内のドキュメントのクエリ
Kibana コンソールにログインし、次のリクエストを実行してドキュメントを表示します。
GET _search
{
   "query": {
   "match_all": {}
  }
}
または、Kibana の Discover ページを使用します。このページを使用するには、まずインデックスパターンを作成する必要があります。詳細な手順については、「Kibana ガイド」をご参照ください。
ドキュメントを挿入した後、すぐに更新するとレコードが見つからないという 404 エラーで失敗します。どうすればよいですか?
Elasticsearch では、新しく書き込まれたドキュメントは、検索および更新操作ですぐには表示されません。各インデックスには、最近書き込まれたドキュメントを表示可能にするためにインデックスがリフレッシュされる頻度を制御する refresh_interval 設定があります。ドキュメントを挿入してすぐに更新しようとすると、ドキュメントがまだ表示可能なインデックスセグメントにリフレッシュされていないため、更新リクエストは 404 エラーで拒否される可能性があります。
この問題を解決するには:
アプリケーション層で、ドキュメントを挿入してから更新するまでの間に短い遅延を追加し、次のリフレッシュサイクル後にドキュメントが表示されるようにします。
ターゲットインデックスの
refresh_interval設定を確認して、設定した値が有効になっていることを確認します。次のコマンドを実行して現在の設定をクエリできます:GET /<index_name>/_settings/index.refresh_interval。
設定された refresh_interval 値が期待するものと一致しない場合は、再設定して変更を確認します。
PUT /<index_name>/_settings
{
  "index": {
    "refresh_interval": "5s"
  }
}
クラスターの設定と変更
クラスターのリソース、仕様、シャードの計画
Elasticsearch インスタンスの設定パラメーター
インスタンスの [基本情報] ページでパラメーターを表示できます。「インスタンスの基本情報を表示する」をご参照ください。
Transport Client を使用して Elasticsearch インスタンスにアクセスする場合、cluster.name をインスタンス ID に設定します。「Transport Client (5.x)」をご参照ください。
クラスター設定変更の影響
クラスター設定を変更すると、ローリングリスタートがトリガーされます。クラスターが正常 (グリーン) で、各インデックスに少なくとも 1 つのレプリカがあり、リソース使用率が中程度であれば、サービスは通常利用可能です。[クラスターモニタリング] ページでメトリックを確認してください。ノードの CPU が約 80%、ヒープメモリが約 50%、load_1m がデータノードの vCPU 数より低い場合、サービスは中断されない可能性が高いです。変更はオフピーク時に実行してください。
ノード数が変更された後、クラスターは自動的にシャードを再分散するか
はい。データノードの数が変更されると、クラスターは自動的にシャードを再割り当てします。ただし、この自動再割り当ては、完全に均等なデータ分散を保証するものではありません。インデックスサイズ、シャード数、ノード数などの要因により、再割り当て後もデータがシャード間で不均衡なままである可能性があります。不均等なシャード割り当てのトラブルシューティングと解決については、「クラスター負荷の不均衡に関する分析と解決策」をご参照ください。
Elasticsearch はクラウドディスクタイプの変更をサポートしているか
はい。クラウドディスクタイプをアップグレードまたはダウングレードできます。パフォーマンス層は、高い順に ESSD、標準 SSD、ウルトラディスクです。
他のノードタイプをコールドノードに変換できるか
いいえ。この操作はクラスターを不安定にする可能性があります。「Elasticsearch 5.x の「ホットウォーム」アーキテクチャ」をご参照ください。
クラスターの仕様をアップグレードした後、設定をダウングレードできるか。できる場合、その方法は?
はい。手順については、「クラスターのデータノードをスケールインする」または「クラスターをダウングレードする」をご参照ください。
一時的なトラフィック急増への対処
一時的なトラフィック急増に対処するには、まずクラスターをスケールアウト (クラスター設定のアップグレード) し、次にスケールイン (クラスターのデータノードをスケールインする) します。データノードのスケールアウトとスケールインの両方で、クラスターの再起動が必要です。再起動する前に、次の点に注意してください。
インスタンスがアクティブ状態 (グリーン) であることを確認してください。
各インデックスに少なくとも 1 つのレプリカシャードがあり、リソース使用量が過剰でないことを確認してください。これらのメトリックは [クラスターモニタリング] ページで表示できます。たとえば、NodeCPUUtilization は約 80%、NodeHeapMemoryUtilization は約 50%、NodeLoad_1m はデータノードの vCPU 数より低い必要があります。
「UpgradeVersionMustFromConsole」エラー
このエラーは、要求されたバージョンアップグレードがサポートされていないことを示します。Alibaba Cloud Elasticsearch は、5.5.3 から 5.6.16、5.6.16 から 6.3.2、6.3.2 から 6.7.0 のバージョンパスに沿った直接アップグレードのみをサポートしています。
Elasticsearch のアップグレード時間
アップグレード時間は、クラスターのデータ量、データ構造、仕様によって異なります。一般的なアップグレードには約 1 時間かかります。
Elasticsearch バージョンアップグレードの影響
アップグレード中、クラスターは読み書き可能ですが、他の変更は許可されません。オフピーク時にアップグレードしてください。「クラスターのバージョンをアップグレードする」をご参照ください。
設定のアップグレードの失敗またはタイムアウト
最も一般的な原因は、クラスターの状態が異常であることです。すべてのクエリと書き込みを停止し、「高負荷により Elasticsearch クラスターの状態がレッドになった場合の対処法」に従って解決してください。回復後、アップグレードを再試行してください。または、強制更新を実行してヘルスチェックをバイパスすることもできますが、これはサービスを中断する可能性があるため、注意して進めてください。
他の理由で設定のアップグレードが失敗した場合は、エラーメッセージに基づいて問題をトラブルシューティングし、解決してください。
クラスターの再設定の失敗
この問題をトラブルシューティングするには、以下を確認してください。
クラスター内のノードがローカルディスクを使用しているかどうかを確認します。ローカルディスクを使用するノードでは、設定変更はサポートされていません。インスタンスタイプをアップグレードするには、まずディスクタイプをクラウドディスクに切り替える必要があります。
コンソールで容量不足が報告された場合は、別のゾーンで設定変更を試すか、現在のゾーンで他のユーザーがインスタンスをリリースするのを待ちます。
コンソールでクラスターの状態が異常であると報告された場合は、
close状態のインデックスがないか確認し、一時的にその状態をopenに設定します。クラスターの状態がredの場合は、オフラインノードや未割り当てシャードなどの問題がないか確認します。続行するには、これらのクラスターの問題を解決する必要があります。クラスターをダウングレードする前に、次の条件を満たしていることを確認してください。
ターゲットインスタンスタイプでは、vCPU 数とメモリサイズの両方が現在の仕様の少なくとも 50% である必要があります。1 vCPU と 2 GiB のメモリ、2 vCPU と 2 GiB のメモリ、2 vCPU と 4 GiB のメモリ、4 vCPU と 4 GiB のメモリのインスタンスタイプにダウングレードすることはできません。
説明2 vCPU と 4 GiB のメモリ、または 4 vCPU と 4 GiB のメモリのインスタンスタイプにダウングレードする必要がある場合は、ターゲット仕様で新しいインスタンスを作成します。次に、Logstash などを使用して、元のインスタンスから新しいインスタンスにデータを移行します。
クラスターの負荷は、必要な条件を満たしている必要があります。「クラスターをダウングレードする」をご参照ください。
ダウングレード中にディスク容量を減らすことはできません。
http.max_content_length と discovery.zen.ping_timeout の設定
いいえ。Alibaba Cloud Elasticsearch が提供するパラメーターのみを設定できます。「YML パラメーターの設定」をご参照ください。
通常、次のパラメーターを変更する必要はありません:discovery.zen.ping_timeout、discovery.zen.fd.ping_timeout、discovery.zen.fd.ping_interval、discovery.zen.fd.ping_retries。
Elasticsearch クラスターの VPC を切り替えることはできるか
いいえ。Elasticsearch クラスターの VPC を切り替えるには、ターゲット VPC で新しいクラスターを購入し、データを移行してから、元のクラスターをリリースする必要があります。
Elasticsearch クラスターのクラウドディスクタイプを変更するとデータ損失が発生するか
いいえ、既存のデータは失われません。ただし、アップグレード中に書き込まれた新しいデータは失われる可能性があります。アップグレードはオフピーク時に行うか、書き込み操作を停止してから行ってください。「クラスター設定のアップグレード」をご参照ください。
アップグレード中にクラスターの状態がグリーンなのに異常と表示される
クラスターに閉じられたインデックスが含まれている可能性があります。POST /<index_name>/_open コマンドを実行して、影響を受けるインデックスを開きます。「クラスター設定のアップグレード」をご参照ください。
データ移行を避けるために Elasticsearch クラスターの CPU のみをアップグレードできるか
いいえ。vCPU のアップグレードまたはダウングレードはブルーグリーンアップデートをトリガーし、ノードの IP アドレスを変更し、元のノードから新しいノードにデータを移行します。
ESSD のパフォーマンスレベルをアップグレードした場合 (例:PL1 から PL2 へ)、I/O ボトルネックはすぐに解消されますか?また、有効になるまでにどのくらい時間がかかりますか?
ESSD のパフォーマンスレベル (PL) をアップグレードすると、クラスターで利用可能な IOPS が増加しますが、変更はすぐには有効になりません。アップグレードには、基盤となるデータを新しいパフォーマンスレベルをサポートするストレージに移行する作業が含まれます。
変更が有効になるまでの固定された期間はありません。実際の時間は、データ量、現在のインスタンスの状態、使用される変更方法などの要因によって異なります。ブルーグリーンアップデートなどの一部のパスは、ノードが再作成され、データが元のノードから新しいノードに移行されるため、時間がかかります。
進捗を追跡し、結果を確認するには:
Elasticsearch コンソールのインスタンスの設定変更ページで移行の進捗を表示します。
アップグレードが完了したら、クラスター診断機能を使用して I/O ボトルネックが改善されたかどうかを確認します。詳細については、「Elasticsearch クラスターで診断を実行する」をご参照ください。
Elasticsearch が I/O ボトルネックを経験した場合、データノードをスケールアウトするか、ディスクタイプをアップグレードするべきですか?
どちらのオプションも効果的です。ボトルネックの原因に基づいて選択してください。
データノードのスケールアウト:シャードが不均等に分散している場合や、単一ノードの負荷が高い場合に適しています。クラスター設定をアップグレードしてデータノードを追加し、シャードをより多くのノードに再分散して、単一ノードの負荷を軽減できます。
ディスクタイプのアップグレード:単一ディスクの IOPS またはスループットが不十分な場合に適しています。クラウドディスクタイプを、例えば標準クラウドディスクから標準 SSD や ESSD にアップグレードして、ノードあたりの利用可能な IOPS とスループットを増やすことができます。
どちらのオプションを選択するにしても、シャードがデータノード間で均等に分散されていることを確認してください。不均等なシャード分散はホットスポットを作成し、スケールアウトやディスクタイプのアップグレード後でも実際のパフォーマンス向上を制限する可能性があります。
コールドデータノードのダウングレード制限
クラスターのダウングレードにはいくつかの制限があります。たとえば、ターゲットの仕様は現在の vCPU とメモリの少なくとも 50% を持っている必要があります。1 vCPU/2 GiB、2 vCPU/2 GiB、4 vCPU/4 GiB、または 2 vCPU/4 GiB にダウングレードすることはできません。「クラスターをダウングレードする」をご参照ください。
クラスターがダウングレード要件を満たさない場合は、新しいインスタンスを作成し、データを移行してから、元のクラスターをリリースできます。データ移行ソリューションについては、「移行方法の選択」をご参照ください。
リソース不足または異常なシャード割り当てエラー
考えられる原因 | ソリューション |
クラスターリソースの不足。 スケールイン後、クラスターの残りのリソース (ディスク、メモリ、vCPU) が現在のデータ量やワークロードをサポートするのに不十分な場合があります。 |
|
異常なシャード割り当て。 設計上、Elasticsearch は同じシャードの複数のレプリカを単一のデータノードに割り当てません。スケールイン中に、インデックスのレプリカ数が残りのデータノード数以上である場合、これらのレプリカは割り当てられず、シャード割り当てエラーが発生します。 |
|
データノードのスケールイン時のエラー
クラスター診断機能を使用してクラスターの健全性を確認し、診断結果に基づいてエラーを解決します。「Elasticsearch クラスターで診断を実行する」をご参照ください。
「予約済みノードは 2 より大きい必要があります」エラー
クラスターの信頼性を確保するためには、少なくとも 2 つのデータノードを予約する必要があります。マルチゾーンクラスターの場合は、各ゾーンに少なくとも 2 つのノードを保持し、すべてのゾーンでノード数を等しく保つ必要もあります。これらの要件を満たせない場合は、スケールダウンまたは移行する別のノードを選択するか、クラスター設定をアップグレードする必要があります。
データノードのスケールイン中のクラスター設定エラー
GET _cluster/settings コマンドを実行してクラスター設定を確認します。データ分散を無効にする設定を探します:"cluster.routing.allocation.enable" : "none"。この設定が存在する場合は、一時的に "cluster.routing.allocation.enable" : "all" に変更します。この変更が他の操作に影響する場合は、スケールイン後に設定を元に戻します。
auto_expand_replicas によって引き起こされる障害のトラブルシューティング
原因
X-Pack アクセス制御機能を使用すると、この問題が発生する可能性があります。以前の Elasticsearch バージョンでは、この機能はデフォルトで .security インデックスに
"index.auto_expand_replicas" : "0-all"設定を適用します。この設定は、データ移行またはノードのスケールイン操作の失敗につながります。ソリューション
インデックス設定を確認します。
GET .security/_settingsコマンドは次のような結果を返します。
{
  ".security-6" : {
    "settings" : {
      "index" : {
        "number_of_shards" : "1",
        "auto_expand_replicas" : "0-all",
        "provided_name" : ".security-6",
        "format" : "6",
        "creation_date" : "1555142250367",
        "priority" : "1000",
        "number_of_replicas" : "9",
        "uuid" : "9t2hotc7S5OpPuKEIJ****",
        "version" : {
          "created" : "6070099"
        }
      }
    }
  }
}
次のいずれかの方法で設定を変更します。
方法 1
PUT .security/_settings
{
  "index" : {
    "auto_expand_replicas" : "0-1"
  }
}
方法 2
PUT .security/_settings { "index" : { "auto_expand_replicas" : "false", "number_of_replicas" : "1" } }重要number_of_replicas パラメーターは、インデックス内の各プライマリシャードのレプリカ数を設定します。ビジネス要件に基づいてこのパラメーターを設定し、値が少なくとも 1 であり、利用可能なデータノード数を超えないようにしてください。
Elasticsearch キャッシュのクリア
キャッシュをクリアするには、Kibana コンソールにログインし、次のいずれかのコマンドを実行します。
特定のインデックスのキャッシュをクリアする
POST /<index_name>/_cache/clear?fielddata=trueすべてのキャッシュをクリアする
POST /_cache/clear
Elasticsearch クラスターゾーンの変更
「ゾーン内の Elasticsearch ノードを移行するか、Elasticsearch クラスターのデプロイモードをアップグレードする」をご参照ください。
ディスクを個別にスケーリングできるか
はい。「クラスター設定のアップグレード」をご参照ください。
スケーリングはローリングリスタートをトリガーします。オフピーク時にスケーリングしてください。
JVM パラメーターの変更
Alibaba Cloud Elasticsearch は、Elasticsearch が推奨する JVM パラメーターを使用します。これらのパラメーターは直接変更できません。デフォルトでは、JVM ヒープサイズはクラスターメモリの 50% で、最大 32 GB です。「ヒープサイズ設定」をご参照ください。
Alibaba Cloud Elasticsearch はダウンタイムを伴うアップグレードをサポートしているか
Alibaba Cloud Elasticsearch は、従来の意味でのダウンタイムを伴うアップグレードをサポートしていません。標準のアップグレードが実行される前に、システムはクラスターの状態がグリーンであり、負荷が正常であることを確認します。このチェックに失敗したアップグレードは続行できません。
クラスターが異常であるか、標準のチェックに合格できないが、緊急にサービスを復旧する必要がある場合は、「クラスター設定のアップグレード」に従ってアップグレードページを開き、[強制更新] を選択します。このモードは、クラスターの健全性状態を無視し、一部のヘルスチェックをスキップして、クラスターが異常な状態でアップグレードを実行します。このプロセスはノードの再起動やサービスの中断を引き起こす可能性があるため、注意して進めてください。
アップグレード中にコンソールに表示される追加のノードとは何ですか?
アップグレード中、特にブルーグリーンアップデート中に、コンソールのインスタンスリストに、インスタンスの仕様が示すよりも多くのノードが一時的に表示されることがあります。これらの追加ノードは、基盤となる更新メカニズムによって作成される一時的なノードです。これらは購入したデータノードではなく、料金は発生しません。変更が進行中のみ存在し、変更が完了すると自動的に削除されます。元のデータノードの数を変更したり、ビジネスロジックに影響を与えたりすることはありません。
プラグイン、形態素解析、シノニム
IK アナライザー辞書のカスタマイズ
IK 分析プラグインのコールドまたはホットアップデート機能を使用して、辞書の内容を追加または削除できます。「IK 分析プラグイン (analysis-ik) を使用する」をご参照ください。
IK 分析プラグイン:「ik startOffset」エラー
このエラーは Elasticsearch 6.7 のバグによって引き起こされ、クラスターの再起動が必要です。「クラスターまたはノードを再起動する」をご参照ください。
ローカルの IK 辞書ファイルが失われた場合、クラスター管理ページから取得できるか
いいえ。ファイルを取得することはできません。クラスター管理ページでは辞書ファイルの削除または更新のみが可能です。公式のメイン辞書とストップワードファイルをダウンロードし、その内容をシステム辞書の用語に置き換えてアップロードしてください。
IK 辞書の変更を既存のデータに適用する
インデックスが IK トークンを使用している場合、コールドまたはホットアップデートによる辞書の変更は新しいデータにのみ適用されます。既存のデータに変更を適用するには、インデックスを再作成してください。「YML パラメーターの設定」をご参照ください。
フル GC の標準値
フル GC (ヒープ全体をクリーンアップする) が問題であるかどうかを判断するには、サービスレイテンシーを分析し、現在のパフォーマンスを過去のベースラインと比較します。CMS コレクターは、メモリ使用量が 75% に達するとガベージコレクションを開始し、トラフィックのバーストに備えて余裕を残します。
未使用の組み込みプラグインのアンインストール
組み込みプラグインの [操作] 列に [アンインストール] が表示されている場合は、アンインストールできます。手順については、「組み込みプラグインのインストールまたはアンインストール」をご参照ください。
Alibaba Cloud Elasticsearch IK 分析プラグインの辞書は、オープンソースの IK プラグインの辞書と同じか
はい。Alibaba Cloud Elasticsearch IK 分析プラグインには、オープンソースバージョンと同じ組み込み辞書が含まれています。「Elasticsearch の IK 分析」をご参照ください。
カスタムプラグインは、例えば GitHub から辞書ファイルを読み込むなど、外部ネットワークにアクセスできるか
いいえ、カスタムプラグインは外部ネットワークにアクセスできません。外部ファイルにアクセスするには、Object Storage Service (OSS) にアップロードし、そこから読み取ります。
カスタムプラグインはホットアップデートをサポートしているか
いいえ。ホットアップデートを実装するには、IK 分析プラグインの方法を参照してください。「Elasticsearch の IK 分析」をご参照ください。
Analysis-aliws の設定とファイル形式
詳細な設定手順については、「analysis-aliws プラグインを使用する」をご参照ください。
辞書ファイルは次の要件を満たす必要があります。
名前:ファイル名は
aliws_ext_dict.txtである必要があります。ファイル形式:ファイルは UTF-8 である必要があります。
内容:各行には、先頭または末尾に空白のない単一の単語が含まれている必要があります。各行は UNIX または Linux の改行 (
\n) で終わる必要があります。Windows で辞書ファイルを作成した場合は、アップロードする前に Linux マシンでdos2unixなどのツールを使用して変換する必要があります。
シノニム、IK トークン、AliNLP トークン
タイプ | 使用法 | 説明 | ファイルタイプ | トークナイザーまたはアナライザー |
シノニム | [クラスター設定] モジュールでシノニムファイルをアップロードします。 | ファイルでシノニムを定義すると、ある用語のクエリがその同義語を含むドキュメントにも一致するようになります。 | UTF-8 エンコードの TXT ファイル | カスタムアナライザーで使用されます。 |
IK トークン |
| 文章は main.dic ファイルに基づいてセグメント化されます。クエリを実行すると、クエリ内容にセグメント化された単語のいずれかが含まれている場合、その文章が検索結果で返されます。このプロセスでは、ストップワードファイル stop.dic も使用されます。セグメント化後、stop.dic ファイルで見つかった単語はフィルタリングされます。対応する辞書は公式ドキュメントで確認できます。 | UTF-8 エンコードの DIC ファイル | トークナイザー:
|
AliNLP トークン |
| IK 形態素解析に似ていますが、別のストップワードファイルは使用しません。ストップワードはメイン辞書 |
|
|
IK 分析モードの設定
Alibaba Cloud Elasticsearch には IK アナライザープラグインがプリインストールされており、アンインストールすることはできません。デフォルトの辞書にコールドおよびホットアップデートを適用し、インデックスマッピングを作成する際に使用します。「IK アナライザープラグイン (analysis-ik) を使用する」をご参照ください。
組み込みの中国語トークナイザー
Alibaba Cloud Elasticsearch は、組み込みの中国語トークナイザー analysis-ik と analysis-aliws をサポートしています。対応する辞書を設定した後に使用できます。
OSS を使用して辞書ファイルをホットアップデートする場合、OSS の辞書ファイルの内容が変更されると Elasticsearch は自動的に更新されるか
いいえ。Alibaba Cloud Elasticsearch は現在、OSS からの辞書ファイルのホットアップデートをサポートしていません。OSS の辞書ファイルが変更された後、変更を適用するには手動でアップロードして設定する必要があります。さらに、IK アナライザー、シノニム、または AliNLP アナライザーで設定されたインデックスの場合、更新された辞書は新しいデータにのみ影響します。すべての既存のデータに変更を適用するには、インデックスを再作成する必要があります。
Alibaba Cloud Elasticsearch が使用する IK アナライザーはリモート辞書をサポートしているか
いいえ。Alibaba Cloud Elasticsearch IK アナライザーは辞書のアップロードと更新をサポートしています。「IK アナライザープラグイン (analysis-ik) を使用する」をご参照ください。リモート辞書および IKAnalyzer.cfg.xml などの関連設定はサポートされていません。
Elasticsearch 7.10 用のベクトル検索プラグイン (aliyun-knn) のインストール
Alibaba Cloud Elasticsearch 7.10 クラスターでは、ベクトル検索プラグインは apack プラグインに統合されており、デフォルトでインストールされています。ベクトル検索プラグインを管理するには、「apack 物理レプリケーション機能を使用する」をご参照ください。他のバージョンについては、「aliyun-knn ベクトル検索プラグインを使用する」をご参照ください。
クラスターのカーネルバージョンが 1.4.0 以降の場合、apack プラグインはすでに最新です。GET _cat/plugins?v コマンドを実行してプラグインのバージョンを確認できます。
再起動がサービスに与える影響
通常、クラスターの負荷が低く、インデックスにレプリカがある場合、クラスターは再起動中もトラフィックを処理し続けます。ただし、高い同時実行性の強制再起動、負荷の高いクラスター、レプリカシャードがない場合、または重いワークロード下では、タイムアウトが発生する可能性があります。クライアントにリトライメカニズムを実装し、オフピーク時に再起動してください。
ログに関するよくある質問
Elasticsearch の .security ログに保持期間を設定できるか
はい。インデックスライフサイクル管理 (ILM) を使用して保持期間を設定します。「インデックスライフサイクル管理で Heartbeat データを管理する」をご参照ください。
.security インデックスには elastic アカウント情報が保存されます。これらのインデックスを定期的に削除すると、Elasticsearch クラスターの Kibana コンソールへのアラート通知ができなくなる可能性があります。
Elasticsearch ログをオンプレミスに保存する
ListSearchLog API を使用してクラスターログを取得し、オンプレミスに保存します。
Elasticsearch ログの表示
スローログを設定し、時間しきい値を下げます。「ログのクエリ」をご参照ください。
スローログの設定と表示
デフォルトでは、Elasticsearch クラスターは 5〜10 秒かかる読み書き操作をスローログとして記録します。より多くのログをキャプチャするには、Kibana コンソールにログインし、コマンドを実行して時間しきい値を下げます。「関連ドキュメント」をご参照ください。
スローログのフォーマットは変更できません。
スローログをプログラムで取得する
ListSearchLog API を呼び出して、スローログをプログラムで取得します。
Elasticsearch クラスターのクライアントを見つける
Elasticsearch クラスターのアクセスログまたは監査ログを表示できます。
作成、削除、更新、クエリなどのクラスター操作を追跡するには、監査ログを有効にします。
要求されたノードとその IP アドレス、bodySize、リクエスト内容、リクエスト時間、クライアント IP アドレス、URI などのリクエスト詳細を表示するには、アクセスログを有効にします。
制限事項、注意事項、およびこれらのログを有効にする方法については、「ログのクエリ」をご参照ください。
バックアップと復元
異なるバージョン間でのスナップショットの復元
自動バックアップでは、スナップショットを元のクラスターにのみ復元するか、クラスター間スナップショット復元機能を使用できます。「自動バックアップと復元」および「OSS バケットを使用したクラスター間バックアップと復元」をご参照ください。
手動バックアップでは、スナップショットを他の Elasticsearch クラスターに復元できます。互換性の問題を避けるために、同じバージョンのクラスター間で復元してください。「手動バックアップと復元」をご参照ください。
バージョンアップグレードのためのバックアップ中のクラスター状態の異常
クラスターの状態が異常な場合、スナップショットバックアップを作成できません。まずクラスターの状態を green に復元してください。
OSS バケットが設定されていない自動バックアップ
Alibaba Cloud Elasticsearch は、デフォルトでクラスター用の OSS バケットを提供します。自動スナップショットを表示するには、Kibana コンソールにログインし、GET _snapshot/aliyun_auto_snapshot/_all コマンドを実行します。
POST /_cluster/reroute?retry_failed=true コマンドが失敗した場合のスナップショット復元中のシャード障害
スナップショットからデータを復元する際に、次のようなエラーが発生することがあります。
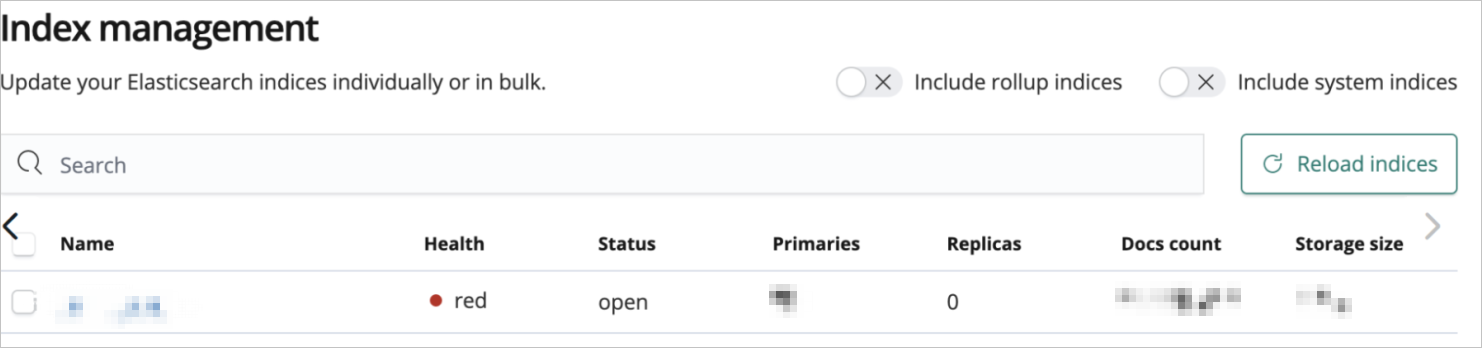
この問題を解決するには、問題のあるインデックスを削除し、_restore API を呼び出して復元します。復元コマンドに max_restore_bytes_per_sec パラメーターを追加して、各ノードの復元速度を制限します。デフォルト値は 1 秒あたり 40 MB です。
POST /_snapshot/aliyun_snapshot_from_instanceId/es-cn-instanceId_datetime/_restore
{
    "indices": "myIndex",
    "settings": {
    "max_restore_bytes_per_sec" : "150mb"
    }
}その他の関連パラメーターは次のとおりです。
compress:データ圧縮を有効にするかどうかを指定します。デフォルト値は true です。
max_snapshot_bytes_per_sec:ノードあたりのスナップショット速度を指定します。デフォルト値は 1 秒あたり 40 MB です。
データをローカルマシンにエクスポートする
Elasticsearch クラスターから OSS にデータをバックアップし、OSS コンソールのオブジェクトのダウンロード機能を使用してバックアップをローカルにダウンロードします。
クラスター間でスナップショットを復元する
クラスター間スナップショット復元の具体的な手順、制限、注意事項については、「クラスター間 OSS リポジトリでデータをバックアップおよび復元する」をご参照ください。同じアカウント内でのクロスリージョンデータ移行については、インデックスデータの手動スナップショットを作成し、スナップショットからデータを復元するために使用されるコマンドを使用できます。その他の移行方法については、「移行方法の選択」をご参照ください。
データバックアップオプション
データバックアップでは、利用可能なオプション、ユースケース、制限事項について説明しています。
クラスターのモニタリングとアラート
X-Pack Watcher アラートの設定
X-Pack Watcher からアラートを受信するように DingTalk または WeCom チャットボットを設定するには、「Watcher アラート用に DingTalk ロボットを設定する」および「X-Pack Watcher からのアラート通知を受信するように WeCom チャットボットを設定する」をご参照ください。
X-Pack Watcher は Elasticsearch ベースのモニタリングおよびアラートサービスです。Alibaba Cloud Elasticsearch と統合して、特定の条件が満たされたときにアクションをトリガーできます。たとえば、「logs」インデックスに「error」ログが表示されたときに自動的に DingTalk メッセージを送信するルールを設定できます。
GC メモリ割り当て失敗への対処
考えられる原因には、高いクラスター負荷、高いクエリ QPS、または大量の書き込みボリュームがあります。
高いクラスター負荷:「高いクラスターディスク使用率と読み取り専用の問題のトラブルシューティングと解決」をご参照ください。
高いクエリ QPS または大量の書き込みボリューム:クラスター速度制限プラグイン (aliyun-qos) で読み書きの速度制限を有効にします。
説明画像検索には、ベクトル検索プラグイン (aliyun-knn) をインストールし、「ベクトル検索プラグイン (aliyun-knn) を使用する」で説明されているようにクラスターとインデックスを計画してください。
クラスター状態メトリック値
クラスター状態メトリックは、クラスターの健全性を示します。値 0.00 は正常を意味します。「メトリックと例外処理」をご参照ください。
値 | 説明 |
0.00 | クラスターは正常な状態です。 |
1.00 | 1 つ以上のインデックスに未割り当てのレプリカシャードがある場合、クラスターは準正常な状態です。クラスターは引き続きサービスを提供できます。 |
2.00 | 1 つ以上のインデックスに未割り当てのプライマリシャードがある場合、クラスターは異常な状態です。クラスターはサービスを提供できません。できるだけ早くクラスターを正常な状態に復元してください。 |
Elasticsearch のディスク使用率
コンソールまたは Kibana の X-Pack モニタリングでディスク使用率を表示します。「メトリックと例外処理」および「モニタリングインデックスを設定する」をご参照ください。
CMS GC の「promotion failed」エラー
Alibaba Cloud Elasticsearch で CMS ガベージコレクターを使用しているときに、このエラーが発生することがあります。これは通常、旧世代の領域が不足しているため、オブジェクトの昇格に失敗したことを示します。この問題を解決するには、以下を検討してください。
モニタリングとログ分析
GC ログで頻繁な CMS GC またはフル GC 操作を確認し、
CMS GC promotion failedエラーが旧世代の領域不足によって引き起こされているかどうかを判断します。Alibaba Cloud Elasticsearch コンソールの [ログクエリ] ページにログインし、
promotion failedを含むログを検索して根本原因を見つけます。
ヒープメモリとガベージコレクターの設定を調整する
Elasticsearch のバージョンが 6.7.0 以降で、各データノードに 32 GB 以上のメモリがある場合は、パフォーマンス向上のためにガベージコレクターを G1 に切り替えることを検討してください。
クラスターのリソース使用量とビジネス要件に基づいて、インスタンスメモリを増やすかどうかを評価します。
チューニングの提案
メモリ関連の問題が解決しない場合は、インデックスデータ量、クエリ負荷、クラスターリソース設定を評価してください。必要に応じて、Alibaba Cloud のテクニカルサポートに連絡して、専門的なチューニングガイダンスを受けてください。
よくある質問:クラスターへのアクセス
クライアント接続とオープンソースの比較
Alibaba Cloud Elasticsearch クラスターに接続するには、その内部またはパブリックエンドポイントを使用します。これは、オープンソースクラスターのアドレスに相当します。「クライアントを使用して Alibaba Cloud Elasticsearch クラスターにアクセスする」をご参照ください。
クライアントで Elasticsearch クラスターにアクセスする際に、基本認証を無効にできるか
いいえ、基本認証を無効にすることはできません。これは、すべての Elasticsearch クラスターに含まれる X-Pack が提供する Kibana 認証メカニズムです。
Alibaba Cloud ECS インスタンスと Elasticsearch クラスターが同じ VPC 内で異なるゾーンにある場合、ECS インスタンスはプライベートネットワーク経由で Elasticsearch クラスターにアクセスできるか
はい。ECS インスタンスは、同じ VPC 内にある限り、内部ネットワーク経由で Elasticsearch クラスターにアクセスできます。
IP アドレスホワイトリストの設定
パブリックネットワークまたは VPC から Alibaba Cloud Elasticsearch インスタンスにアクセスするには、クライアントの IP アドレスをインスタンスのパブリックまたは VPC IP アドレスホワイトリストに追加します。「インスタンスの IP アドレスホワイトリストを設定する」をご参照ください。次の点に注意してください。
パブリック IP アドレスホワイトリストを設定する前に、デフォルトで無効になっているパブリックネットワークアクセスを有効にする必要があります。
IP アドレスホワイトリストには、最大 50 個の IP アドレスまたは CIDR ブロックを含めることができます。
エントリを CIDR ブロックとして指定する場合、エントリの IP アドレス部分はサブネットのネットワークアドレスである必要があります。
同じホワイトリスト内で 0.0.0.0/0 を他の特定の IP アドレスまたは CIDR ブロックと組み合わせることはできません。組み合わせると、システムはエラーを返します。テスト目的では、0.0.0.0/0 の代わりに特定の IP アドレスまたは CIDR ブロックを設定してください。
インターネットから Elasticsearch クラスターに接続する
インターネットから Elasticsearch クラスターに接続するには、そのパブリックエンドポイントを使用し、IP アドレスホワイトリストを設定します。また、ドメイン名、ユーザー名、パスワードも設定する必要があります。「クライアントを使用して Alibaba Cloud Elasticsearch クラスターにアクセスする」をご参照ください。
Elasticsearch にアクセスできない:接続が拒否されました
以下の表に、考えられる原因と解決策を示します。
原因 | ソリューション |
パブリックアクセスの接続性の問題 | Elasticsearch クラスターにパブリックエンドポイントを使用してアクセスする場合は、次の手順に従います。
|
プライベートアクセスの接続性の問題 | Elasticsearch クラスターに内部エンドポイントを使用してアクセスする場合は、次の手順に従います。
|
クラスターの健全性が低い | ネットワークが到達可能であるにもかかわらず Elasticsearch クラスターにアクセスできない場合は、クラスターの健全性を確認し、次の方法で問題を解決します。
|
パスワードのリセットと Elasticsearch へのアクセス
コンソールで elastic アカウントのパスワードをリセットした場合、影響を受けるのはそのアカウントのアクセスのみです。代わりに、アプリケーションコードで必要な権限を持つカスタムアカウントを使用してください。「Elasticsearch X-Pack ロールでアクセスの制御を管理する」をご参照ください。
パスワードを変更しても、インスタンスの再起動はトリガーされません。
Elasticsearch-Head 5.0.0 での接続失敗の解決
この問題は通常、Google Chrome が適用するオリジン間リソース共有 (CORS) ポリシーによって引き起こされます。macOS でこの問題を解決するには、次の手順に従います。
空のフォルダを作成します。
ターミナルを開き、次のコマンドを実行します。
open -n /Applications/Google\ Chrome.app --args --disable-web-security --user-data-dir=/path/to/your/empty/folder
Elasticsearch-Head は 5.x 以降のバージョンではメンテナンスされていません。代わりに Cerebro を使用してください。
インデックスに関するよくある質問
インデックスを閉じる方法
閉じた Elasticsearch インデックスに対してクエリや書き込みはできません。
POST /<index_name>/_open # インデックスを開く
POST /<index_name>/_close # インデックスを閉じる