Conceitos principais envolvidos no desenvolvimento com os módulos do DataWorks, incluindo Data Integration, Data Modeling, DataStudio, DataAnalysis e DataService Studio.
Conceitos gerais
Workspace
O workspace é a unidade fundamental para gerenciar tarefas e membros, além de atribuir funções e permissões no DataWorks. Um administrador de workspace pode adicionar membros e conceder a eles funções como Administrator, Developer, O&M, Deploy, Security Administrator ou Visitor, viabilizando a colaboração entre múltiplas funções.
Recomendamos organizar os workspaces por departamento ou unidade de negócio.
Resource group
Um DataWorks resource group fornece os recursos de computação exigidos por todos os módulos funcionais do DataWorks. Seu status influencia a estabilidade dos recursos, enquanto sua cota impacta o desempenho das tarefas e dos serviços.
Os resource groups do DataWorks são diferentes dos grupos de recursos da sua conta Alibaba Cloud. Um grupo de recursos da Alibaba Cloud ajuda você a gerenciar e autorizar recursos dentro da sua conta. Já um resource group do DataWorks destina-se especificamente à execução de tarefas.
No DataWorks, salvo quando indicado como legacy resource group, um resource group refere-se a um serverless resource group, e seu tipo de uso é General-purpose.
Um serverless resource group pode ser usado para Data Integration, agendamento de dados e DataService Studio.
Modo básico e modo padrão
O DataWorks oferece dois modos de workspace para atender a diferentes requisitos de segurança: basic mode and standard mode. No modo padrão, um workspace do DataWorks corresponde a duas fontes de dados, o que permite isolar os dados entre os ambientes de desenvolvimento e produção.
Recurso de computação
Um recurso de computação é uma instância de recurso que um motor de computação utiliza para executar tarefas de processamento e análise de dados, como um projeto MaxCompute (grupo de cotas) ou uma instância Hologres.
É possível adicionar vários tipos de recursos de computação a um workspace. Após bind a computing resource, você pode desenvolver e agendar tarefas que o utilizem dentro desse workspace.
Data Integration
-
Fonte de dados
Uma DataWorks data source estabelece conexão com um serviço de armazenamento de dados. Antes de configurar uma tarefa de sincronização, adicione as fontes de dados de origem e de destino. Em seguida, selecione-as para especificar de quais bancos de dados ler e para quais gravar. Várias instâncias de fonte de dados podem ser adicionadas a um único workspace.
-
Sincronização de dados
O recurso data synchronization do Data Integration sincroniza dados estruturados (por exemplo, RDS e DRDS), semiestruturados e não estruturados (por exemplo, OSS e TXT), desde que os dados possam ser abstraídos em uma tabela bidimensional lógica. Dados totalmente não estruturados, como arquivos MP3 armazenados no OSS, não são suportados. Os métodos de sincronização incluem sincronização offline, em tempo real, completa ou incremental para tabelas individuais ou bancos de dados inteiros. Tarefas de sincronização serverless também são suportadas, eliminando a necessidade de um resource group.
Data Modeling
-
Modelagem de dados
À medida que os negócios crescem, os dados corporativos aumentam exponencialmente, gerando conjuntos de dados grandes e complexos com padrões inconsistentes. O serviço DataWorks Data Modeling oferece uma abordagem estruturada para gerenciar esses conjuntos de dados e ajuda as empresas a extrair mais valor das suas informações.
-
Modelagem reversa
O Reverse modeling gera modelos lógicos a partir de tabelas físicas existentes, permitindo criar modelos rapidamente sem esforço manual.
-
Espaço de modelagem
Um modeling space permite compartilhar ferramentas de modelagem de dados entre múltiplos workspaces do DataWorks. Esse recurso é útil quando é necessário reutilizar um único plano de data warehouse em um sistema de dados complexo, viabilizando o planejamento unificado do data warehouse, a modelagem dimensional e a definição de métricas em toda a arquitetura de dados.
-
Tabela de dimensão
Com base no plano de domínio de dados do seu negócio, é possível extrair dimensões potenciais para análise de dados e armazenar essas dimensões e seus atributos em uma dimension table. Por exemplo, na análise de negócios de e-commerce, as dimensões disponíveis e seus atributos podem incluir a dimensão de pedido (com atributos como ID do pedido, hora de criação, ID do comprador e ID do vendedor), a dimensão de usuário (gênero, data de nascimento) e a dimensão de produto (ID do produto, nome, data de lançamento). Crie tabelas de dimensão para pedidos, usuários e produtos, onde os atributos de dimensão são registrados como campos na tabela.
-
Tabela fato
Seguindo o planejamento do processo de negócio, analise os dados reais gerados em cada processo e armazene esses campos de dados em uma fact table. Por exemplo, para o processo de realização de pedido, crie uma tabela fato de pedidos para registrar campos como ID do pedido, hora de criação, ID do produto, quantidade e valor. Em seguida, implante essas tabelas fato em um data warehouse e use ETL para agregar e armazenar dados reais conforme a definição da tabela fato, tornando-os acessíveis para análise de negócios.
-
Tabela agregada
Uma aggregate table organiza dados estatísticos de múltiplas métricas derivadas dentro de um domínio de dados que compartilham o mesmo período e as mesmas dimensões. Representa um resumo altamente abstraído das operações de negócio e serve de base para consultas de negócios, análises OLAP e distribuição de dados subsequentes.
-
Tabela de aplicação
Uma application table é projetada para cenários de negócios específicos e organiza dados estatísticos de múltiplas métricas atômicas, métricas derivadas ou granularidades estatísticas que compartilham o mesmo período e as mesmas dimensões. Fornece uma base para consultas de negócios, análises OLAP e distribuição de dados subsequentes.
-
Data mart
Um data mart é uma forma de organizar dados baseada em categorias de negócio e adaptada para cenários de aplicação ou produtos específicos. Geralmente está localizado na camada de aplicação do data warehouse e depende de dados integrados provenientes da camada comum.
-
Planejamento do data warehouse
Ao usar o DataWorks para modelagem de dados, arquitetos de data warehouse ou membros da equipe de modelagem podem utilizar a página data warehouse planning para projetar camadas de dados, categorias de negócio, domínios de dados, processos de negócio, data marts e áreas temáticas. Após a conclusão do design, os designers de modelos podem usar esses elementos planejados para gerenciar as camadas e os domínios dos modelos que constroem.
Data Import Layer: Essa camada ingere dados brutos de fontes como bancos de dados, logs e mensagens. Os dados de origem são carregados na camada ODS após uma série de operações ETL. Esta camada armazena apenas tabelas ODS.
Common Layer: Essa camada processa e integra dados comuns da camada de origem, estabelece métricas e dimensões unificadas e constrói dados fato detalhados reutilizáveis e dados de resumo para análise e estatísticas. Pode conter tabelas fato, tabelas de dimensão e tabelas de resumo.
Application Layer: Obtém dados processados e integrados da camada pública para realizar estatísticas de dados personalizadas para cenários de aplicação específicos ou produtos designados, de acordo com os requisitos reais da aplicação. Pode conter tabelas de aplicação e tabelas de dimensão.
-
Camada de dados
O recurso data layer do DataWorks cria cinco camadas padrão: a camada Operational Data Store (ODS), a camada Dimension (DIM), a camada Data Warehouse Detail (DWD), a camada Data Warehouse Summary (DWS) e a camada Application Data Service (ADS). A função de cada camada é descrita a seguir:
-
ODS (Operational Data Store)
A camada ODS recebe e processa dados brutos que precisam ser armazenados no sistema de data warehouse. Sua estrutura de tabela é consistente com a estrutura de tabela no sistema de dados de origem e serve como área de preparação de dados para o data warehouse.
-
DWD (Data Warehouse Detail)
A camada DWD constrói modelos de dados com base em eventos de atividades de negócio e é usada para criar as tabelas fato com maior granularidade. Conforme os padrões de uso dos dados, é possível desnormalizar adicionando adequadamente campos de atributos de dimensão-chave redundantes às tabelas fato, criando tabelas largas. Isso reduz joins entre tabelas fato e tabelas de dimensão, melhorando a usabilidade.
-
DWS (Data Warehouse Summary)
A camada DWS constrói modelos de dados analisando objetos temáticos. Com base nos requisitos de métricas das aplicações e produtos upstream, cria tabelas fato de resumo com granularidade pública.
-
ADS (Application Data Service)
A camada ADS armazena dados de métricas estatísticas personalizadas para produtos de dados e gera diversos relatórios.
-
DIM (Dimension)
A camada DIM utiliza dimensões para construir modelos de dados. Pode armazenar tabelas de dimensão para modelos lógicos com base nas necessidades do negócio ou armazenar definições de dimensão para modelos conceituais. Ao definir dimensões, determinar chaves primárias, adicionar atributos de dimensão e associar diferentes dimensões, é possível construir tabelas de dimensão analíticas consistentes para toda a empresa, o que reduz inconsistências nos padrões e algoritmos de cálculo de dados.
-
-
Área temática
Uma subject area particiona um data mart sob uma perspectiva analítica e geralmente consiste em uma coleção de assuntos de dados estreitamente relacionados. Agrupe esses assuntos em diferentes áreas temáticas com base no foco do negócio. Por exemplo, o setor de e-commerce é tipicamente dividido nas áreas temáticas de transações, membros e produtos.
-
Domínio de dados
Um data domain é uma coleção de assuntos de dados estreitamente relacionados. Trata-se de um agrupamento lógico de dados de negócio com base em dimensões como categoria de negócio, fonte de dados ou finalidade dos dados, reunindo informações semelhantes para facilitar a recuperação rápida. Os critérios de classificação variam conforme a finalidade dos dados. Por exemplo, o setor de e-commerce é tipicamente dividido nos domínios de dados de transações, membros e produtos.
-
Processo de negócio
Um business process é uma atividade de negócio executada por uma empresa dentro de um domínio de dados específico e constitui o sujeito lógico a ser analisado na modelagem de dados. Por exemplo, o domínio de transações pode incluir processos de negócio como adicionar ao carrinho, realizar pedido e efetuar pagamento.
-
Métrica composta
Uma métrica derivada fornece estatísticas sobre o volume de uma atividade de negócio em um determinado período, mas não suporta análise comparativa, como o cálculo de taxas de crescimento ou diferenças entre períodos. Por exemplo, não é possível calcular a taxa de crescimento semana a semana de uma atividade de negócio com esse recurso. Para resolver isso, o DataWorks oferece o composite metric, calculado a partir de métricas derivadas por meio de regras operacionais, permitindo definir métricas de negócio com maior flexibilidade e granularidade.
-
Métrica de dados
O Data Modeling do DataWorks oferece o recurso de métrica de dados para estabelecer um sistema de métricas unificado.
Uma metric system é composta por uma métrica atômica, um modificador, um período e uma métrica derivada.
Métrica atômica: Uma medição baseada em um processo de negócio específico, como "valor do pagamento" no processo de negócio "pagamento de pedido".
Modificador: Uma restrição que limita o escopo de negócio de uma métrica, como limitar o escopo estatístico de "valor do pagamento" a "produtos materno-infantis".
Período: O intervalo de tempo ou ponto no tempo para as estatísticas de uma métrica, como definir o período de "valor do pagamento" como "últimos 7 dias".
Métrica derivada: Uma combinação de uma métrica atômica, modificadores e um período. Por exemplo, "valor do pagamento de produtos materno-infantis nos últimos 7 dias".
-
Tabela de consulta
Uma lookup table define o intervalo de valores para um padrão de campo. Nela, especifique o conteúdo e o intervalo de dados que um padrão de campo pode aceitar. Por exemplo, o conteúdo da tabela de consulta para o padrão de campo de gênero deve ser masculino ou feminino.
-
Padrão de campo
Um field standard é um critério de dados usado para gerenciar uniformemente dados com o mesmo significado, mas com nomes de campo diferentes. Um padrão de campo pode definir o intervalo de valores, a unidade de medida e outras propriedades de um campo. Quando um padrão de campo é alterado, é possível localizar ou modificar rapidamente as tabelas correspondentes, o que melhora consideravelmente a eficiência e a precisão da aplicação.
DataStudio
-
Nó
O módulo DataStudio do DataWorks oferece diversos tipos de nós, incluindo nós do Data Integration para sincronização de dados, nós de motor de computação para limpeza de dados (como ODPS SQL, Hologres SQL e EMR Hive) e nós de uso geral para processamento de lógica complexa em motores de computação (como nós virtuais para gerenciar múltiplos nós e nós do-while para execução de código em loop). Combine esses nós para atender às suas diferentes necessidades de processamento de dados.
-
Workflow
Um workflow é uma forma centrada no negócio de organizar o desenvolvimento de código e melhorar a eficiência do gerenciamento de tarefas.
Os workflows ajudam a organizar o código sob uma perspectiva de negócio:
Suporta organização de código por tipo de tarefa.
Suporta subdiretórios em múltiplos níveis (até quatro níveis recomendados).
Permite visualizar e otimizar o workflow completo sob a perspectiva do negócio.
Suporta a organização de implantação e O&M com base em workflows.
Disponibiliza um painel de workflow para auxiliar no desenvolvimento com maior eficiência.
-
Auto triggered workflow
Um auto triggered workflow oferece uma interface de desenvolvimento DAG visual e orientada ao negócio. Integre nós de subtarefa via arrastar e soltar, estabeleça dependências entre tarefas e construa pipelines de processamento de dados para gerenciar projetos de tarefas complexos com eficiência.
-
Notebook
O notebook do DataWorks oferece um ambiente de desenvolvimento interativo para exploração de dados, análise e desenvolvimento de modelos de IA, integrando código (como SQL e Python), texto, resultados de execução e gráficos de visualização.
-
Componente SQL
Disponível apenas para MaxCompute, abstraia lógica comum em SQL em um SQL script template para melhorar a reutilização de código.
O processo de tratamento de código SQL geralmente envolve importar uma ou mais tabelas de origem e processá-las por meio de operações de filtragem, junção e agregação para produzir uma nova tabela destino exigida pelo negócio. Um SQL script template é um modelo procedural para código SQL com múltiplos parâmetros de entrada e saída.
-
Dependência de agendamento
Uma scheduling dependency entre tarefas define a ordem em que elas são executadas. Se o nó B só pode ser executado após o nó A, então A é uma dependência upstream de B, e B depende de A. Em um Grafo Acíclico Dirigido (DAG), as dependências são representadas por setas entre os nós.
-
Timestamp de dados
Um timestamp de dados geralmente se refere à data diretamente associada a uma atividade de negócio, refletindo o momento real em que os dados de negócio foram gerados. Esse conceito é especialmente importante em cenários de computação offline. Por exemplo, no varejo, para calcular a receita de vendas do dia 10 de outubro de 2024, o cálculo normalmente é iniciado na madrugada do dia 11 de outubro de 2024. Os dados resultantes representam, de fato, a receita do dia 10 de outubro de 2024, que é o timestamp de dados.
-
Nome de saída
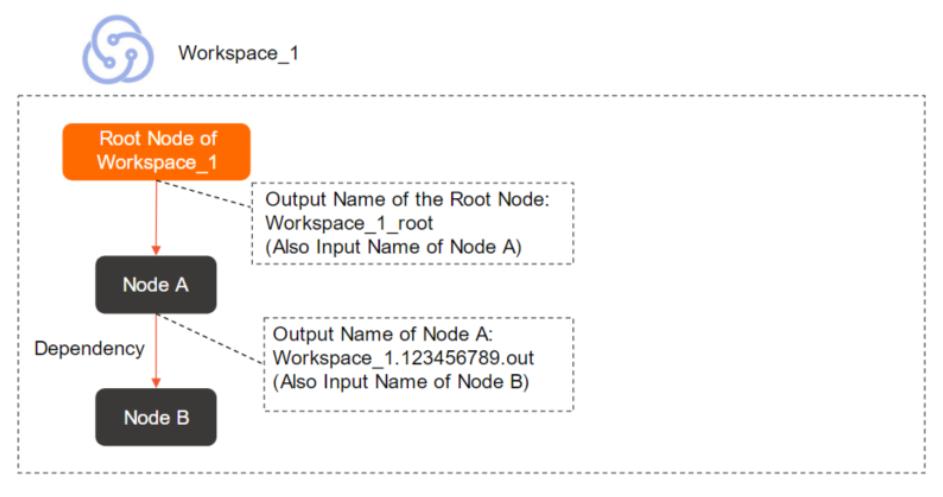
O output name é o nome do ponto de saída de uma tarefa. É uma entidade virtual usada para conectar tarefas upstream e downstream ao configurar dependências dentro de um único tenant (conta Alibaba Cloud).
Ao configurar dependências upstream e downstream para uma tarefa, utilize o nome de saída, e não o nome do nó ou o ID do nó. Uma vez definido, o nome de saída da tarefa também serve como nome de entrada para seus nós downstream.
 Nota
O nome de saída serve como identificador único de uma tarefa dentro de um tenant. O nome de saída padrão de cada nó é
WorkspaceName.SystemGenerated9DigitNumber.out. É possível adicionar um nome de saída personalizado a uma tarefa, mas deve-se garantir que ele seja único dentro do tenant. -
Nome da tabela de saída
O nome da tabela de saída deve corresponder à tabela produzida pela tarefa atual. Preencher corretamente esse nome facilita que tarefas downstream confirmem que os dados provêm da tabela upstream esperada ao configurar dependências. Não é recomendado modificar manualmente um nome de tabela de saída gerado automaticamente. O nome da tabela de saída serve apenas como identificador; modificá-lo não afeta o nome real da tabela produzida pelo script SQL, que é determinado pela lógica SQL.
NotaO Output Name de um nó deve ser globalmente único, enquanto o Output Table Name não possui essa restrição.
-
Parâmetro de agendamento
Um scheduling parameter é uma variável no código que recebe um valor dinamicamente em tempo de execução. Quando o código precisa de informações do ambiente de execução, como data ou hora, atribua valores com base nas definições de parâmetros de agendamento no sistema de agendamento do DataWorks.
-
Catálogo de dados
Um data catalog é uma lista ou mapa estruturado de todos os ativos de dados de uma organização, incluindo bancos de dados, tabelas e arquivos. No DataWorks, o catálogo de dados registra os metadados desses ativos.
-
Recursos de computação, fontes de dados e catálogos de dados
Esses três são objetos independentes, mas relacionados. As relações entre eles são as seguintes:
Ao vincular um recurso de computação, uma fonte de dados e um catálogo de dados podem ser criados em associação.
Ao criar uma fonte de dados, um catálogo de dados pode ser criado em associação.
Ao criar um catálogo de dados, não é possível criar uma fonte de dados ou um recurso de computação em associação.
Operation Center
-
Horário de agendamento
O horário de execução esperado para uma tarefa disparada automaticamente, que pode ser definido ao minuto.
ImportanteVários fatores podem afetar a execução de uma tarefa, o que significa que ela não necessariamente será executada imediatamente quando o horário agendado for atingido. Antes de executar uma tarefa, o DataWorks verifica se as tarefas upstream foram concluídas com sucesso, se o horário agendado foi atingido e se os recursos de agendamento são suficientes. A tarefa só começa a ser executada quando todas essas condições são atendidas.
-
Timestamp de dados
Um timestamp de dados geralmente se refere à data diretamente associada a uma atividade de negócio, refletindo o momento real em que os dados de negócio foram gerados. Esse conceito é especialmente importante em cenários de computação offline. Por exemplo, no varejo, para calcular a receita de vendas do dia 10 de outubro de 2024, o cálculo normalmente é iniciado na madrugada do dia 11 de outubro de 2024. Os dados resultantes representam, de fato, a receita do dia 10 de outubro de 2024, que é o timestamp de dados.
-
Tarefa disparada automaticamente
Uma auto triggered task é uma tarefa acionada automaticamente pelo sistema de agendamento com base em um cronograma definido pelo usuário. Na lista de tarefas disparadas automaticamente do Operation Center, execute uma série de operações de O&M e gerenciamento, como visualizar o DAG, executar testes, realizar reprocessamento de dados e alterar o responsável pela tarefa.
-
Instância disparada automaticamente
Uma auto triggered instance é uma instância de tarefa gerada automaticamente para execução com base na configuração de agendamento de uma tarefa disparada automaticamente. Por exemplo, se uma tarefa está configurada para ser executada a cada hora, a plataforma gera 24 instâncias de tarefa em um dia, com uma instância disparada automaticamente a cada hora. Somente instâncias possuem informações como status de execução. Na lista de instâncias disparadas automaticamente do Operation Center, execute uma série de operações de O&M em uma instância, como encerrar, definir como bem-sucedida e reexecutar.
-
Reprocessamento de dados
O DataWorks gera automaticamente uma instância de data backfill com base na tarefa e no intervalo de tempo especificados. O recurso de reprocessamento de dados é usado principalmente para reexecutar dados históricos e corrigir dados. Com esse recurso, recalcule dados de qualquer período passado ou futuro para garantir a completude e a precisão dos dados.
-
Baseline
Com base nas configurações definidas para uma baseline, como prioridade, prazo de conclusão comprometido e margem de alerta, o sistema monitora automaticamente todas as tarefas da baseline e emite avisos sobre riscos que possam afetar a entrega pontual das tarefas. Quanto maior o número que indica a prioridade da baseline, maior a prioridade. O DataWorks aloca mais recursos para tarefas em baselines de alta prioridade a fim de garantir seu prazo de entrega. A margem de alerta é reservada principalmente para o tratamento de exceções. O DataWorks calcula o horário de alerta subtraindo a margem de alerta do prazo de conclusão comprometido. Se uma tarefa não conseguir produzir resultado dentro do horário de alerta, a plataforma emite prontamente um alerta para informar as partes de negócio envolvidas sobre o risco.
Data Governance Center
-
Pontuação de saúde
Uma health score é uma métrica abrangente que varia de 0 a 100 e mede a saúde dos ativos de dados com base em itens de governança. Reflete a eficácia da governança no nível de tenant, workspace ou individual em cinco dimensões: armazenamento, computação, P&D, qualidade e segurança.
-
Item de governança
Um governance item é um problema identificado em um ativo de dados que requer otimização ou resolução, abrangendo áreas como padrões de desenvolvimento, qualidade de dados, segurança e conformidade, e utilização de recursos. Os itens de governança são classificados como obrigatórios (ativados por padrão e não modificáveis) e opcionais (ativados conforme a necessidade). Por exemplo, tempos de execução de tarefas excessivamente longos, nós com erros consecutivos e nós folha não acessados são todos itens de governança.
-
Item de verificação
Um check item é um mecanismo proativo de governança que realiza pré-verificações em etapas importantes, como submissão e implantação de tarefas, para detectar possíveis problemas no código ou nos dados, como varreduras completas de tabelas ou ausência de configurações de dependência de agendamento. Quando conteúdo não conforme é detectado, o sistema gera um evento de item de verificação, intercepta automaticamente a ação e aplica os padrões de desenvolvimento.
-
Plano de governança de dados
Um data governance plan fornece modelos para diferentes cenários de governança. Orientado por metas de governança para um período específico, ajuda a selecionar itens de governança e verificação relevantes e a identificar objetos para otimização. Isso viabiliza o acompanhamento contínuo da eficácia da governança e impulsiona a equipe a alcançar as metas por meio de avaliação quantitativa.
-
Base de conhecimento
A knowledge base contém definições dos itens de verificação e governança integrados ao Data Governance Center. Auxilia os profissionais de governança a identificar rapidamente problemas específicos e oferece informações de referência e orientações práticas para a resolução de problemas.
Security Center
-
Permissão de dados
O Security Center oferece recursos detalhados para solicitação, aprovação e auditoria de permissões de dados, implementando controle de acesso com privilégio mínimo. Também é possível acompanhar facilmente o processo de aprovação de permissões em cada etapa. Para mais informações, consulte Data access control.
-
Segurança de conteúdo de dados
O Security Center oferece recursos como classificação e graduação de dados, identificação de dados sensíveis, auditoria de acesso a dados sensíveis e rastreabilidade da fonte de dados. Durante o tratamento de processos de negócio, identifica de forma rápida e oportuna dados com potenciais riscos de segurança, garantindo a segurança e a confiabilidade do conteúdo dos dados. Para mais informações, consulte Data Security Guard overview.
Data Quality
-
Monitoramento de qualidade
O Quality monitoring rastreia e detecta continuamente o status e as alterações de objetos de dados (como partições específicas de uma tabela particionada) para garantir que atendam aos requisitos de qualidade predefinidos. No DataWorks, configure o monitoramento de qualidade disparado por eventos de agendamento para realizar verificações automáticas de qualidade e enviar alertas às pessoas responsáveis.
-
Regra de qualidade
Uma quality rule é uma condição ou padrão lógico específico para avaliar se a qualidade dos dados atende aos requisitos esperados. Por exemplo, "A idade do cliente não pode ser menor que 0" são regras de qualidade. No DataWorks, configure diferentes regras de qualidade de forma flexível conforme as necessidades do negócio e aplique-as ao intervalo de dados correspondente para validação. Quando são encontrados dados que não atendem às expectativas da regra, o sistema os identifica automaticamente e emite um alerta de qualidade.
-
Modelo de regra
Um rule template é uma regra de qualidade de amostra com lógica de validação predefinida. Use-o diretamente ou modifique os limiares de validação conforme necessário para criar regras de qualidade que atendam aos seus requisitos. O DataWorks oferece diversos tipos de modelos de regra e também suporta a criação de novos modelos via SQL personalizado:
Regras de modelo do sistema: Crie regras usando o built-in rule templates fornecido pelo DataWorks.
Regras de modelo personalizado: Quando os modelos de regra integrados não atendem às suas necessidades de monitoramento da qualidade de dados em expressões de partição, utilize o custom rule templates. Salve regras personalizadas utilizadas com frequência como modelos de regra para facilitar a reutilização.
Data Security Guard
-
Classificação e graduação de dados
Data classification and grading: Classifica os dados atuais em níveis de sensibilidade com base em seu valor, sensibilidade do conteúdo, impacto e escopo de distribuição. Diferentes níveis de sensibilidade possuem diferentes princípios de controle e requisitos de desenvolvimento de dados.
-
Regra de identificação de dados sensíveis
Sensitive data identification rule: Com base na origem e na finalidade dos dados, defina categorias de dados e configure tipos de campos sensíveis para identificar dados sensíveis no workspace atual. O DataWorks fornece categorias de dados e regras de identificação integradas, que também podem ser personalizadas conforme a necessidade.
-
Regra de mascaramento de dados
As Data masking rules configuram o mascaramento para dados sensíveis identificados. Dependendo dos requisitos de controle do negócio, os controles de mascaramento de dados variam para diferentes níveis de sensibilidade.
-
Regra de identificação de riscos
As Risk identification rules utilizam tecnologia de análise inteligente para descobrir proativamente operações de risco e emitir alertas. Isso auxilia na realização de um gerenciamento de riscos mais abrangente, identificando e evitando riscos de forma eficaz.
Data Map
-
Metadados
Metadata são dados que descrevem outros dados. Podem especificar os atributos de um dado (nome, tamanho, tipo de dado), sua estrutura (campos, tipos, comprimentos) ou informações relacionadas (localização, proprietário, tarefa de saída, permissões de acesso).
-
Linhagem de dados
A Data lineage descreve as relações formadas à medida que os dados são processados e transformados, mostrando todo o ciclo de vida dos dados desde a criação, passando pelo processamento, até o consumo. Na plataforma DataWorks, a linhagem de dados é visualizada para ajudar os usuários a localizar problemas rapidamente e avaliar o impacto de alterações em uma tabela ou campo.
-
Álbum de dados
Um data album é uma forma de organizar e gerenciar categorias de tabelas de dados sob uma perspectiva de negócio. Adicione tabelas especificadas e outros ativos a um álbum alvo para recuperação e localização rápidas e fáceis.
DataAnalysis
-
Consulta SQL
O SQL query (legacy) utiliza instruções SQL padrão para consultar e analisar dados de diversas fontes de dados. Para mais informações, consulte SQL query (legacy).
-
Workbook
Um workbook é uma ferramenta para edição e gerenciamento online de tabelas de dados. Suporta a importação de dados de resultados de consulta SQL ou arquivos locais para um workbook alvo para revisão, análise e visualização posteriores. Também suporta exportação, download e compartilhamento de dados do workbook, atendendo de forma flexível às necessidades diárias de análise de dados. Para mais informações, consulte Create and manage a workbook.
-
Insights de dados
O Data insight suporta exploração e visualização de dados. Use-o para compreender a distribuição dos dados, criar cards de dados e combiná-los em relatórios de dados. Os resultados de insights de dados podem ser compartilhados como relatórios extensos e utilizam tecnologia de IA para auxiliar na análise de dados, ajudando a interpretar dados complexos e a embasar decisões de negócio.
DataService Studio
-
API
Uma API (Application Programming Interface) no DataService Studio permite que desenvolvedores criem rapidamente APIs de dados com base em diversas fontes de dados. Essas APIs podem ser chamadas em aplicações de negócio, softwares, sistemas e relatórios para recuperar e consumir dados.
-
Função
Uma function atua como filtro para uma API de dados. Quando usada como pré-filtro, processa os parâmetros da requisição, por exemplo, alterando ou atribuindo seus valores. Como pós-filtro, processa os resultados retornados, como alterar a estrutura dos dados ou adicionar conteúdo.
-
Push de dados
O DataWorks oferece um serviço de data push que permite criar tarefas de push. Dentro de uma tarefa, escreva código SQL para consultas de tabela única ou múltipla a fim de definir o escopo dos dados e organizar o conteúdo da mensagem de push usando texto rico ou tabelas. Ao configurar um ciclo e horário de agendamento, envie dados periodicamente para um webhook de destino.
Open Platform
-
OpenAPI
O Open Platform do DataWorks oferece capacidades de OpenAPI, permitindo chamar operações de API do DataWorks para integrar e interagir entre suas aplicações e o DataWorks.
-
OpenEvent
O OpenEvent do DataWorks entrega notificações de mudança de status como mensagens de evento que os usuários podem assinar e responder com ações personalizadas. Por exemplo, assine eventos de alteração de tabela por meio do OpenEvent para monitoramento em tempo real de tabelas principais, ou assine eventos de alteração de tarefas para monitoramento personalizado de tarefas.
-
Extensions
As Extensions do DataWorks são plug-ins que, em combinação com o OpenAPI e o OpenEvent, permitem aplicar lógica personalizada às ações dos usuários no DataWorks e implementar controles comportamentais como interceptação e bloqueio. Por exemplo, desenvolva uma extensão de controle de alteração de tarefas para implementar um fluxo de implantação de tarefas personalizado.