Lanskap Data Pelatihan LLM yang Terus Berkembang
Oleh Farruh
Pendahuluan
Himpunan data adalah sumber vital kecerdasan buatan, terutama dalam melatih model bahasa besar (LLM) yang mendukung semuanya dari chatbot hingga pembuat konten. Himpunan data ini menjadi fondasi tempat model AI mempelajari dan mengembangkan kemampuannya. Namun, seiring meningkatnya permintaan atas sistem AI yang lebih canggih, kebutuhan terhadap himpunan data berkualitas tinggi, beragam, dan luas pun meningkat. Artikel ini membahas sejarah penggunaan himpunan data, jenis data yang diperlukan di berbagai tahap pelatihan LLM, dan tantangan yang dihadapi dalam mencari sumber dan memanfaatkan himpunan data tersebut.
Sejarah Singkat Penggunaan Himpunan Data di AI
Pada masa-masa awal riset AI, himpunan data dikurasi dengan cermat dari berbagai sumber, seperti ensiklopedia, transkrip parlementer, rekaman panggilan telepon, dan ramalan cuaca. Setiap himpunan data disesuaikan untuk menangani tugas khusus, dengan memastikan relevansi dan kualitas. Namun, dengan kedatangan transformer pada 2017—arsitektur jaringan neural yang penting bagi model bahasa modern—fokus pun beralih ke volume saja, yang menandai perubahan signifikan dalam pendekatan riset AI. Peneliti menyadari bahwa performa LLM meningkat secara signifikan dengan model dan himpunan data yang lebih besar, yang menyebabkan scraping data yang sembarangan dari internet.
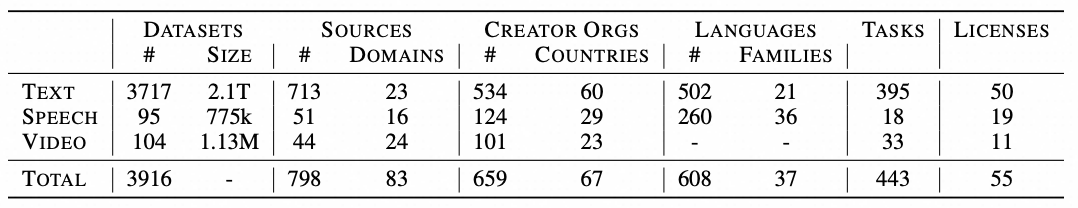
Hingga 2018, internet menjadi sumber dominan untuk semua jenis data, termasuk audio, gambar, dan video. Tren ini terus berlanjut, menghasilkan celah yang signifikan antara data bersumber internet dan himpunan data yang dikurasi secara manual. Permintaan untuk skala juga mengarah kepada penggunaan luas data sintetis—data yang dihasilkan oleh algoritma, bukan dikumpulkan dari interaksi dunia nyata.
Jenis Data yang Diperlukan untuk Pelatihan LLM
Pra-pelatihan
Pra-pelatihan adalah fase awal, tempat model ini diperkenalkan dengan sejumlah besar data teks untuk mempelajari pola dan struktur bahasa umum. Selama tahap ini, model ini memerlukan:
- Sumber Teks yang Beragam: Data harus berasal dari berbagai topik dan bahasa untuk memastikan pemahaman yang luas, faktor penting dalam pengembangan model AI.
- Volume Tinggi: Miliaran token diperlukan untuk melatih model secara efektif.
- Kontrol Kualitas: Walaupun kuantitas sangat penting, mempertahankan tingkat kualitas dasar sama pentingnya karena membantu mencegah model belajar dari informasi yang salah atau bias. Sumber sering kali mencakup halaman web, buku, artikel, dan teks lainnya yang tersedia secara publik.
Namun, pertimbangan etika muncul saat menggunakan materi hak cipta tanpa izin.
Pra-pelatihan Kontinu
Pra-pelatihan kontinu mencakup pembaruan model dengan data baru agar tetap terkini dan meningkatkan basis pengetahuannya. Tahap ini memerlukan:
- Data Terbaru: Untuk memadukan informasi dan tren terbaru.
- DataSpesifik Domain: Tergantung kebutuhan industri, himpunan data khusus (misalnya, jurnal medis untuk aplikasi perawatan kesehatan) mungkin diperlukan.
Penyempurnaan
Penyempurnaan menyesuaikan model yang telah terlatih untuk tugas atau domain tertentu. Biasanya menggunakan himpunan data yang lebih kecil, lebih ditargetkan, diberi label dengan cermat, dan terkurasi. Contohnya:
- Data Spesifik Tugas: Analisis sentimen mungkin memerlukan tinjauan beranotasi, sementara sistem penjawab pertanyaan perlu sepasang pertanyaan dan jawaban.
- Adaptasi Domain: Dokumen hukum, makalah ilmiah, atau manual teknis untuk aplikasi khusus.
Berikut adalah contoh himpunan data dan metode yang digunakan dalam proses ini.
Contoh Himpunan Data Penyempurnaan
- Data Spesifik Tugas: Untuk analisis sentimen, _Stanford Sentiment Treebank (SST-2) _adalah himpunan data yang banyak digunakan yang berisi ulasan film beranotasi yang diberi label positif atau negatif. Demikian pula, sistem penjawab pertanyaan sering menggunakan _Stanford Question Answering Dataset (SQuAD)_, yang memasangkan pertanyaan dengan jawaban berbasis konteks.
- Adaptasi Domain: Aplikasi hukum menggunakan _CaseLaw Corpus_, kumpulan putusan pengadilan beranotasi, sementara model medis dapat menggunakan _PubMed Abstracts _untuk analisis literatur ilmiah.
Metode Penyempurnaan Utama
- Parameter-Effisicent Fine-Tuning (PEFT): Teknik PEFT, seperti LoRA (Low-Rank Adaptation) atau Adapter Layers, hanya memperbarui parameter subset kecil dari parameter model, yang mengurangi biaya komputasi sambil tetap mempertahankan performa. Misalnya, LoRA membekukan bobot model asli dan menambahkan matriks peringkat rendah dapat dilatih untuk lapisan tertentu.
- Penyempurnaan Instruksi: Metode ini melibatkan pelatihan model tentang instruksi spesifik tugas dipasangkan dengan contoh input-ouput. Misalnya, sebuah model yang disempurnakan terhadap instruksi seperti _"Kelompokkan sentimen ulasan ini:[teks]" _belajar mengikuti perintah eksplisit, yang meningkatkan kegunaan dalam aplikasi dunia nyata
- Alih Pembelajaran: Model yang telah terlatih sebelumnya disesuaikan dengan domain baru dengan menyempurnakan korpora spesifik domain. Misalnya, LLM tujuan umum dapat sempurnakan terkait laporan keuangan dari _Arsip EDGAR SEC _untuk mengkhususkan diri dalam analisis pasar stok.
Dengan menggabungkan himpunan data yang dikurasi dengan metode canggih seperti PEFT, peneliti dan pengembang dapat mengoptimalkan LLM untuk aplikasi ceruk selagi menangani kendala sumber daya dan tantangan skalabilitas
Pembelajaran Penguatan
Pembelajaran penguatan dari umpan balik manusia (RLHF) mencakup pelatihan model untuk menyelaraskan dengan preferensi manusia secara lebih baik. Tahap ini memerlukan:
- Umpan Balik Manusia: Peringkat atau koreksi yang disediakan oleh manusia untuk memandu perilaku model.
- Data Interaktif: Interaksi real-time tempat model menerima umpan balik langsung.
Berikut adalah contoh himpunan data dan metode yang menjadi inti RLHF.
Contoh Himpunan Data RLHF
Himpunan Data Preferensi: RLHF dimulai dengan mengumpulkan data preferensi berlabel manusia, dengan output model yang diberi peringkat atau nilai oleh manusia. Misalnya, eksperimen RLHF awal di OpenAI menggunakan himpunan data tempat anotator membandingkan beberapa respons yang dihasilkan model terhadap prompt yang sama, memberi label respons mana yang lebih membantu, jujur, atau selaras dengan pedoman etika. Himpunan data ini sering menyertakan contoh yang diberi nuansa, seperti membedakan antara jawaban faktual dan bias dalam topik sensitif seperti politik atau perawatan kesehatan.
Metode RLHF Utama
- Pelatihan Model Hadiah: Model hadiah dilatih tentang data preferensi manusia untuk memprediksi output mana yang lebih dipilih manusia. Model ini bertindak sebagai proksi bagi penilaian manusia selama pembelajaran penguatan. Contohnya, seri Qwen Alibaba Cloud menggunakan model hadiah untuk menyelesaikan output merugikan atau tidak aman sekaligus memberikan kejelasan dan keterpaduan.
- Proximal Policy Optimization (PPO): PPO adalah algoritma pembelajaran penguatan yang menyempurnakan kebijakan LLM (pembuatan output) untuk memaksimalkan hadiah dari model hadiah terlatih. Metode ini memastikan pembaruan yang stabil, mencegah penyimpangan drastis dari perilaku yang diinginkan. Contohnya, PPO digunakan untuk memperhalus respons chatbot secara berulang dalam sistem seperti Qwen.
- Loop Umpan Balik Interaktif: Umpan balik manusia real-time terintegrasi ke dalam jalur pelatihan. Contohnya, asisten AI seperti Gemini dari Google mungkin menyebarkan versi beta untuk mengumpulkan peringkat pengguna (misalnya, jempol atas/bawah) terhadap respons, yang umpankan kembali ke dalam jalur RLHF untuk meningkatkan output pada masa mendatang.
- Pemfilteran Keamanan Kritis: Himpunan data khusus berfokus pada skenario risiko tinggi, seperti saran medis atau pertanyaan hukum, yang memiliki konsekuensi serius jika terjadi kesalahan. Himpunan data ini sering kali melibatkan para ahli domain yang memberi anotasi terhadap output untuk akurasi dan keamanan, memastikan model tersebut mematuhi pedoman yang ketat.
Tantangan dalam Himpunan Data RLHF
- Skalabilitas Umpan Balik Manusia: Mengumpulkan preferensi data kualitas tinggi memerlukan tenaga kerja yang intensif dan mahal. Menskalakan proses ini membutuhkan otomatisasi penyeimbang (misalnya, umpan balik sintetis) dengan pengawasan manusia untuk menghindari bias.
- Bias Budaya dan Etika: Himpunan data preferensi sering kali mencerminkan nilai anotator dari wilayah tertentu (misalnya, sudut pandang yang berpusat ke Barat), yang riskan menghasilkan output bias dalam aplikasi global.
Dengan menggabungkan himpunan data preferensi, pemodelan hadiah, dan umpan balik manusia berulang, RLHF memastikan LLM berkembang dari pembuat teks generik menjadi sistem yang memprioritaskan keamanan, relevansi, dan penyelarasan manusia.
Tantangan dalam Mencari Sumber Data
Kehabisan Data yang Tersedia
Salah satu masalah yang paling menekan hari ini adalah kehabisan data tekstual yang mudah tersedia. Pemain teknologi besar dilaporkan telah mengindeks hampir semua data teks dari web terbuka dan gelap, termasuk buku bajakan, subtitel film, pesan pribadi, dan postingan media sosial. Dengan lebih sedikit sumber baru untuk dimanfaatkan, industri ini mengalami hambatan dalam kemajuan lebih lanjut.
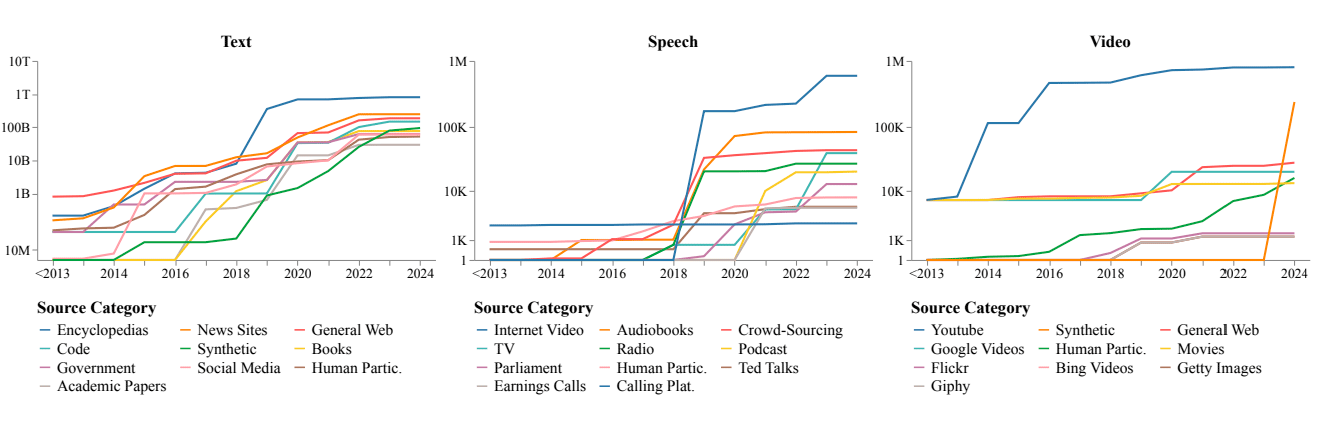
Jumlah data kumulatif (dalam skala logaritmik untuk teks, dalam jam untuk ucapan/video) dari setiap kategori sumber, di seluruh modalitas. Kategori sumber dalam legenda disusun urutan menurun berdasarkan kuantitas.
Asimetri Budaya
Sebagian besar himpunan data berasal dari Eropa dan Amerika Utara, yang mencerminkan pandangan dunia yang berpusat ke Barat. Kurang dari 4% himpunan data yang dianalisis berasal dari Afrika, yang menyoroti imbangan budaya yang signifikan. Bias ini dapat menyebabkan persepsi miring dan memperkuat stereotip, terutama dalam model multimodal yang menghasilkan gambar dan video.
Sentralisasi Kekuatan
Perusahaan besar mendominasi akuisisi dan kontrol terhadap himpunan data yang berpengaruh. Platform seperti YouTube menyediakan lebih dari 70% data video yang digunakan dalam pelatihan AI, yang berkonsentrasi pada daya luar biasa yang dimiliki beberapa entitas. Sentralisasi ini menghambat inovasi dan menciptakan kendala bagi pemain yang lebih kecil yang kurang memiliki akses ke sumber daya ini.
Pengumpulan Himpunan Data
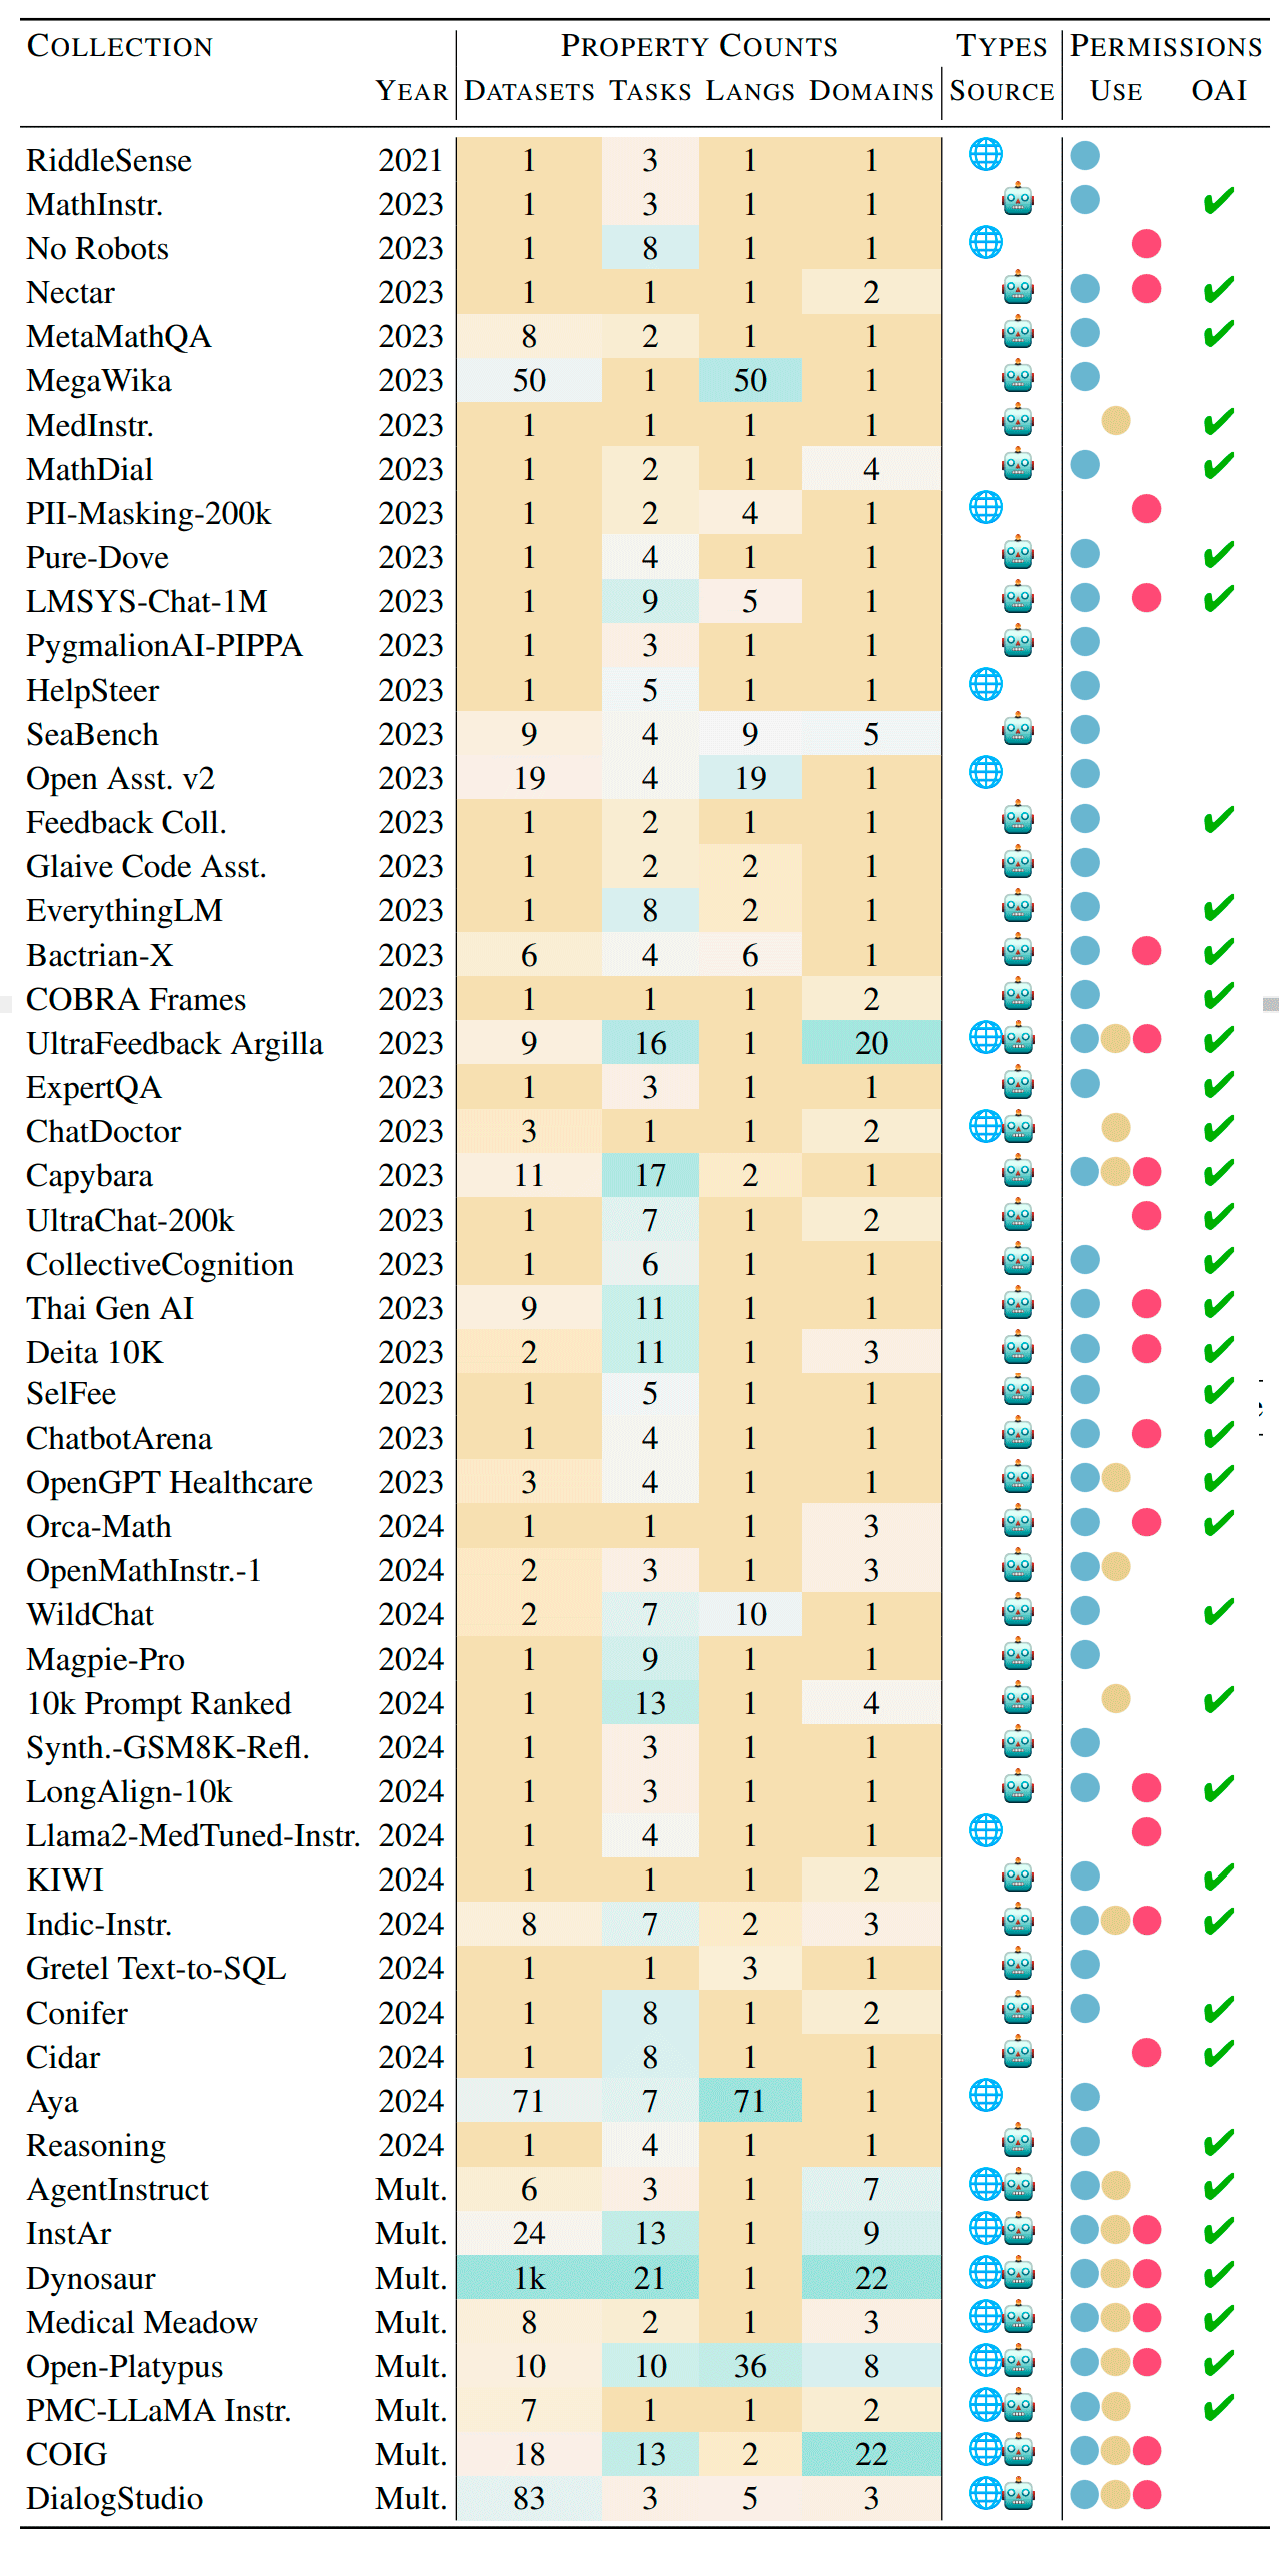
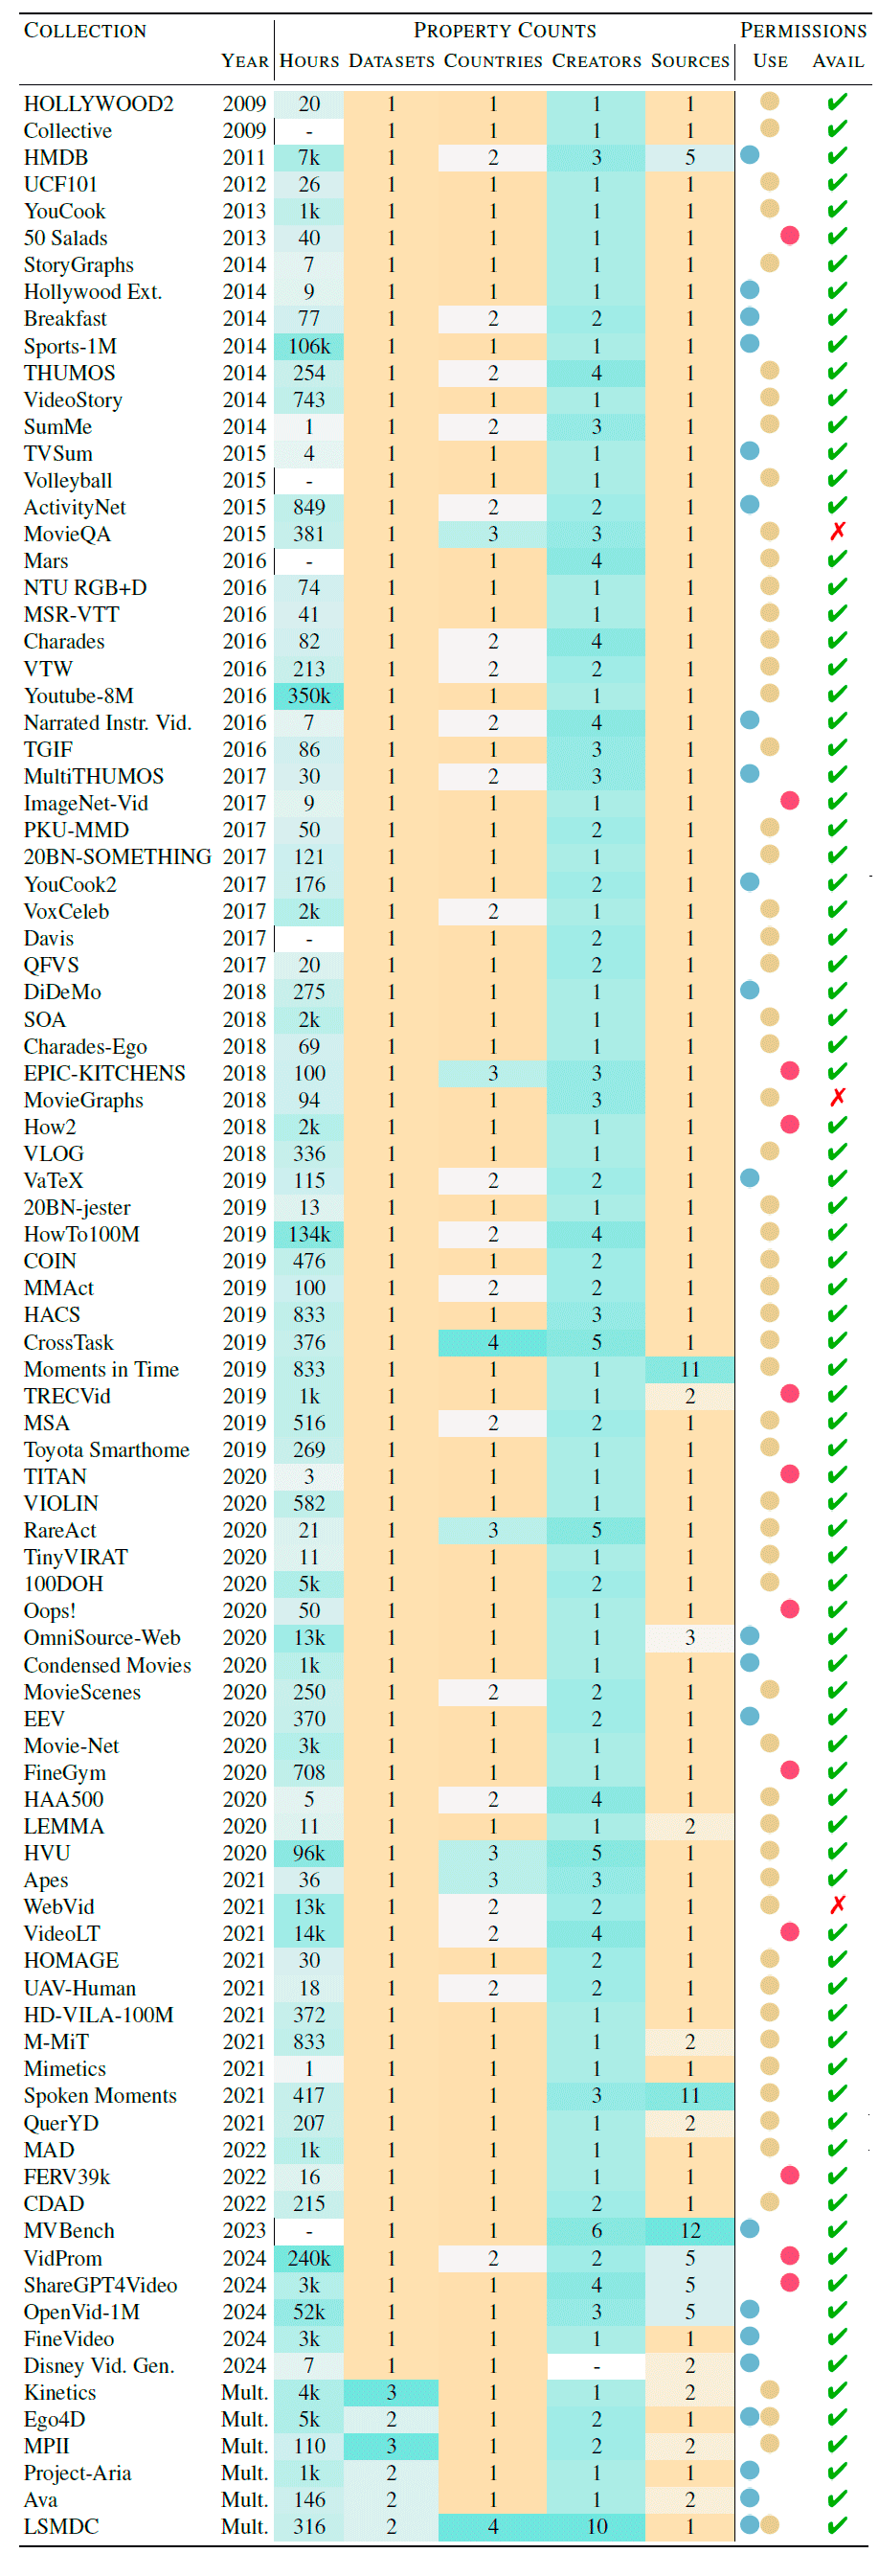
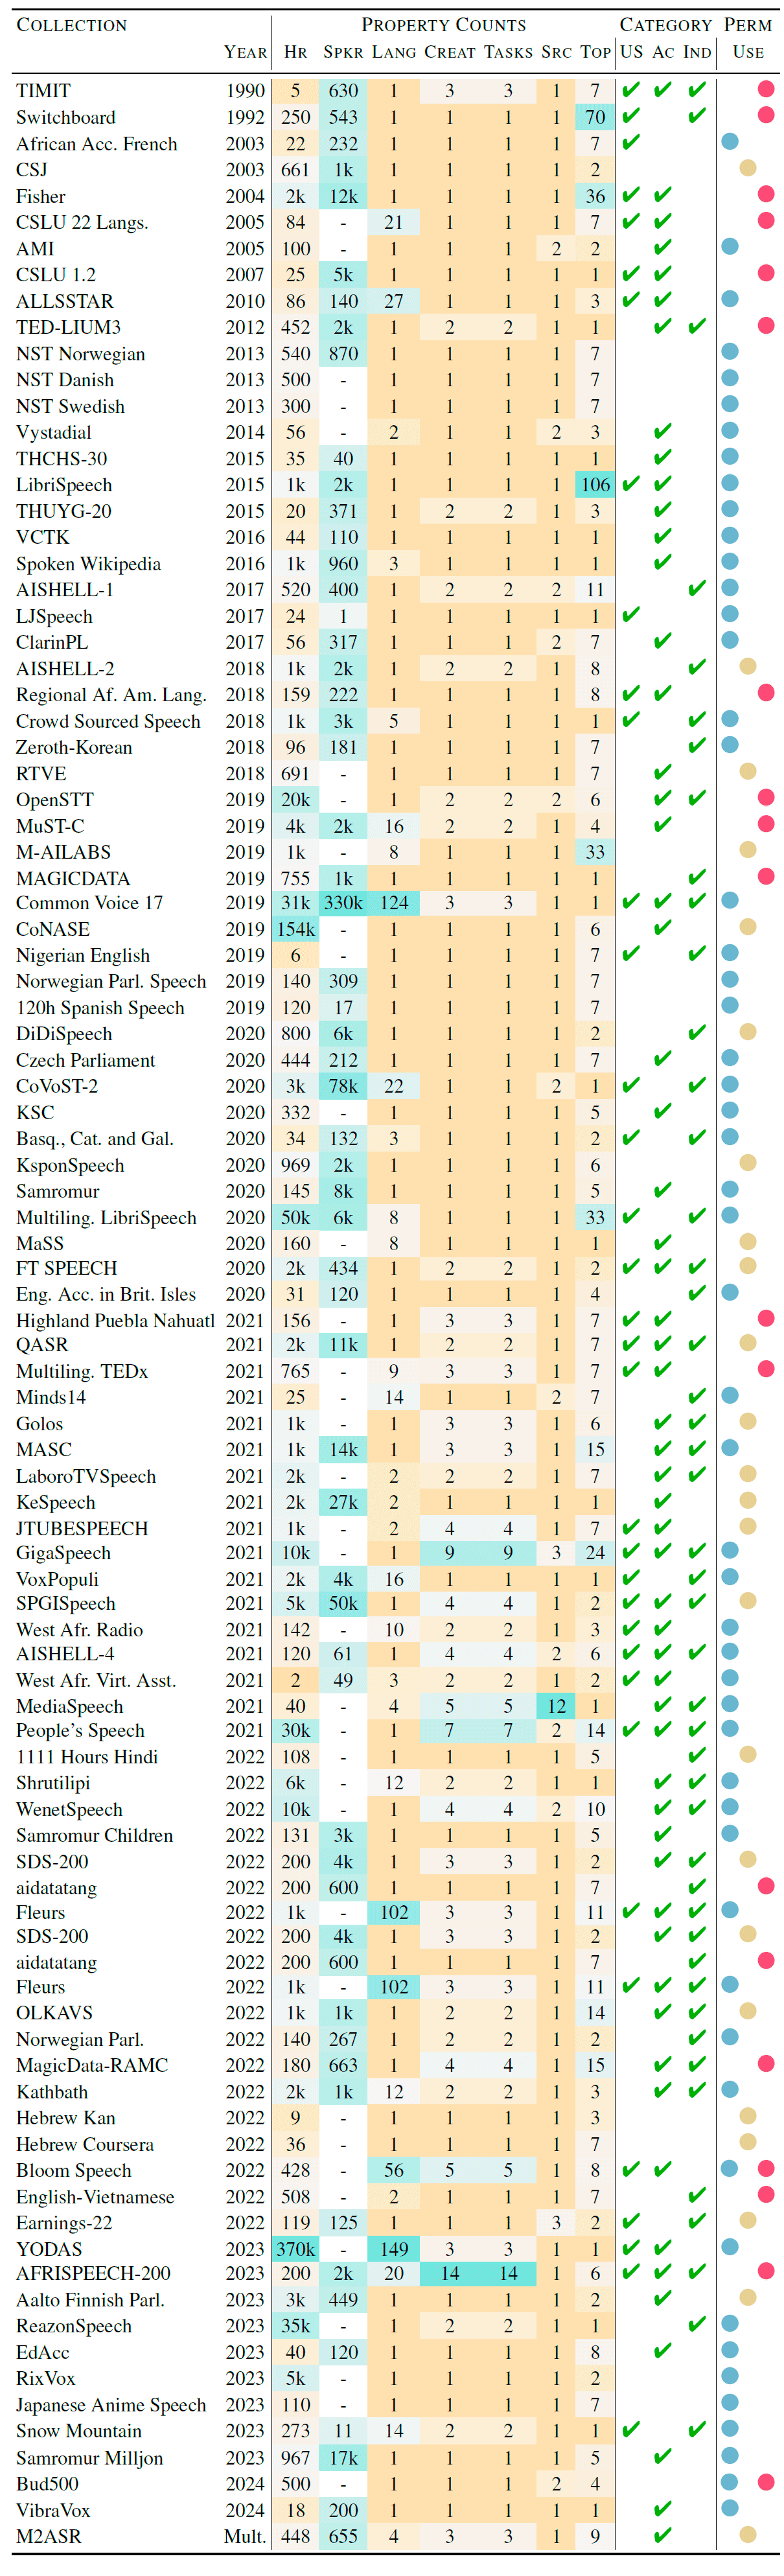
Tabel berikut menunjukkan sumber pengumpulan teks. Properti mencakup jumlah himpunan data, tugas, bahasa, dan domain teks. Kolom Sumber menunjukkan is dari kumpulan : teks yang dibuat manusia di web, output model bahasa, atau keduanya. Kolom akhir menunjukkan status lisensi kumpulan tersebut: biru untuk penggunaan komersial, merah untuk penelitian non-komersial dan akademis, serta kuning untuk lisensi yang tidak jelas. Terakhir, kolom OAI menunjukkan kumpulan yang mencakup pembuatan model OpenAI. Himpunan data tersebut diurutkan secara kronologi untuk menekankan tren seiring waktu. Sumber di sini
Kumpulan data teks:
Kumpulan data video:
Kumpulan data audio:
Solusi dan Arah Masa Depan
Memanfaatkan Sumber Data yang Belum Terpakai
Walaupun data yang mudah diakses jelas mulai habis, masih banyak sumber yang belum terpakai:
- Data Arsip: Perpustakaan, terbitan berkala, dan catatan historis menawarkan konten yang kaya, dan belum dijelajahi.
- Data Perusahaan: Perusahaan memiliki data besar data yang tidak terpakai, seperti telemetri peralatan, laporan meteorologi, catatan sistem, dan statistik pemasaran.
LLM canggih dapat membantu menyusun dan memanfaatkan himpunan data laten ini untuk pelatihan pada masa depan.
Pembelajaran Gabungan
Pembelajaran gabungan memungkinkan model dilatih tentang data sensitif tanpa memindahkannya ke luar lingkungan yang aman. Metode ini sangat tepat untuk industri yang menangani informasi rahasia, seperti perawatan kesehatan, keuangan, dan telekomunikasi. Dengan menyimpan data di lokal, pembelajaran gabungan memastikan privasi selagi memungkinkan peningkatan model kolaboratif.
Data Sintetis dan Augmentasi
Pembuatan data sintetis dan augmentasi data menghadirkan jalan untuk memperluas himpunan data pelatihan:
- Data Sintetis: Dibuat oleh algoritma, data sintetis dapat mengisi celah dalam data dunia nyata tetapi harus ditangani dengan hati-hati untuk menghindari kesalahan penggabungan.
- Augmentasi Data: Memodifikasi data yang ada melalui teknik seperti membalik gambar, mengubah warna, atau menyesuaikan kontras mempertahankan realisme selagi meningkatkan keragaman.
Kesimpulan
Karena bidang AI terus berkembang, peran himpunan data pun tetap sangat penting. Walaupun kehabisan data yang mudah tersedia menimbulkan tantangan, sangat penting bahwa kita, sebagai peneliti dan peminat AI, sadar dan bertanggung jawab untuk menangani masalah asimetri dan sentralisasi budaya. Solusi inovatif seperti memanfaatkan sumber yang belum digunakan, pembelajaran gabungan, dan pembuatan data sintetis menawarkan jalan untuk maju. Dengan menggabungkan strategi ini, kita dapat memastikan pengembangan AI yang merata dan beragam, membangun jalan menuju sistem kecerdasan buatan yang lebih canggih dan inklusif.
Artikel ini diterjemahkan dari bahasa Inggris. Lihat artikel aslinya di sini.
Read previous post:
Read next post:
-

-
Regional Content Hub
144 posts | 4 followers
Follow
Comments
-
-
Regional Content Hub
144 posts | 4 followers
Follow
Related Products
-
 Qwen
Full-range, open-source, multimodal, and multi-functional
Learn More -
 Token Plan
Build more, spend less. One plan, every modality.
Learn More -
Alibaba Cloud Model Studio
A one-stop generative AI platform to build intelligent applications that understand your business, based on Qwen model series such as Qwen-Max and other popular models
Learn More -
 Qoder
From Assisted to Autonomous — Adapting to Every Programming Need
Learn More
More Posts by Regional Content Hub
- ให้พื้นที่ทำงานชั่วคราวกับ AI เอเจนต์ของคุณด้วย Alibaba Cloud AgentRun
- Alibaba Cloud AgentRun으로 AI 에이전트에 일회용 워크스페이스 제공
- Alibaba Cloud AgentRun で AI エージェントに使い捨てワークスペースを与える
- Beri Agen AI Anda Ruang Kerja Sekali Pakai dengan Alibaba Cloud AgentRun
- Cung cấp không gian làm việc dùng một lần cho tác nhân AI của bạn với Alibaba Cloud AgentRun
- DeepSeek V4-Flash dalam Skala Besar: Panduan Deployment Berbasis Benchmark
- 大規模な DeepSeek V4-Flash の活用:ベンチマーク主導のデプロイガイド
- 대규모 DeepSeek V4-Flash: 벤치마크 기반 배포 가이드
- Alibaba Cloud ECS 上で Telegram 連携機能付きの OpenClaw をデプロイする
- Alibaba Cloud ECS에 Telegram 통합 기능을 갖춘 OpenClaw 배포