การเรียนรู้การฝังข้อความและการจัดอันดับใหม่ด้วย Qwen3
สร้างโดย Wan
ส่วนที่ 1: ภัยร้ายสามประการ: การฝัง การจัดอันดับใหม่ และการปรับใช้
1.1 ข้อมูลเบื้องต้นเกี่ยวกับการฝัง การจัดอันดับใหม่ และโมเดล Qwen3
ข้อมูลเบื้องต้นเกี่ยวกับการฝังและการจัดอันดับใหม่
การฝังข้อความและการจัดอันดับใหม่เป็นเทคโนโลยีพื้นฐานในการประมวลผลภาษาธรรมชาติ (NLP) ที่ขับเคลื่อนเครื่องมือค้นหาสมัยใหม่ ระบบแนะนำ การสร้างเสริมการดึงข้อมูล (RAG) และแม้แต่ Agentic AI
- การฝังข้อความ:
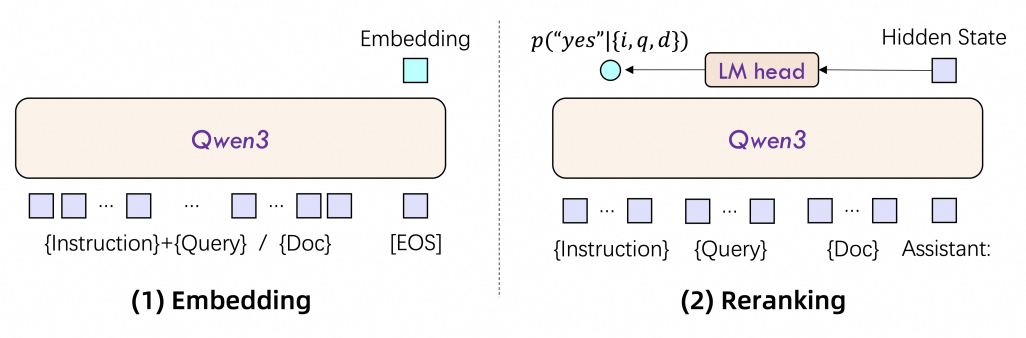
การฝังข้อความจะแปลงข้อความที่ไม่มีโครงสร้างเป็นเวกเตอร์ตัวเลขที่มีการเกาะกลุ่มกัน (เช่น อาร์เรย์ตัวเลข) ที่เก็บความหมายเชิงอรรถศาสตร์ เวกเตอร์เหล่านี้ช่วยให้เครื่องสามารถวัดความคล้ายคลึงกันระหว่างข้อความ รองรับงานต่าง ๆ เช่นการค้นหาเชิงความหมาย การจัดกลุ่ม และการจัดหมวดหมู่ ตัวอย่างเช่น คิวรี เช่น_"LLM ที่ดีที่สุดสำหรับอุตสาหกรรมการเงิน"_สามารถจับคู่กับคำอธิบายหรือบทความของ LLM (โมเดลภาษาขนาดใหญ่) ที่สอดคล้องกับเจตนา
- การจัดอันดับใหม่:
การจัดอันดับใหม่จะปรับแต่งผลลัพธ์ของขั้นตอนการดึงข้อมูลเบื้องต้นโดยการจัดเรียงตัวเลือกใหม่อีกครั้งตามคะแนนความเกี่ยวข้องที่ปรับให้ละเอียดยิ่งขึ้น ในขณะที่โมเดลการฝังจะดึงการจับคู่ในวงกว้างกว่า ตัวจัดอันดับใหม่จะให้ลำดับความสำคัญของผลลัพธ์ที่เกี่ยวข้องกับบริบทมากที่สุดมาเป็นอันดับแรก ตัวอย่างเช่น เครื่องมือค้นหาอาจดึงข้อมูลเอกสาร 100 รายการแรกขึ้นมาโดยใช้การฝัง แล้วจึงใช้ตัวจัดอันดับใหม่เพื่อเลือกรายการที่เกี่ยวข้องมากที่สุด 10 อันดับแรก
การนำไปใช้หลัก:
- การค้นหาบนเว็บและระบบการแนะนำ
- การวิเคราะห์เอกสารทางกฎหมายและการตรวจสอบการปฏิบัติตามกฎระเบียบ
- การวิจัยด้านสุขภาพ (เช่น การค้นหาการทดลองทางคลินิกสำหรับยา)
- การประเมินความเสี่ยงทางการเงิน (เช่น การวิเคราะห์การสมัครขอสินเชื่อ)
โมเดลการฝังและการจัดอันดับใหม่ของ Qwen3
ซีรีส์การฝังของ Qwen3 สร้างขึ้นบนโมเดล Qwen3โดยแสดงถึงการก้าวกระโดดในการเรียนรู้การแทนที่ข้อความ โดยประกอบด้วยโมเดลการฝัง (สำหรับการทำให้ข้อความอยู่ในรูปแบบเวกเตอร์) และโมเดลการจัดอันดับใหม่ (สำหรับการปรับแต่งผลลัพธ์การค้นหา) ด้วยพารามิเตอร์ขนาด 0.6B, 4B และ 8B
ฟีเจอร์หลัก
1. ความสามารถที่หลากหลายเป็นพิเศษ:
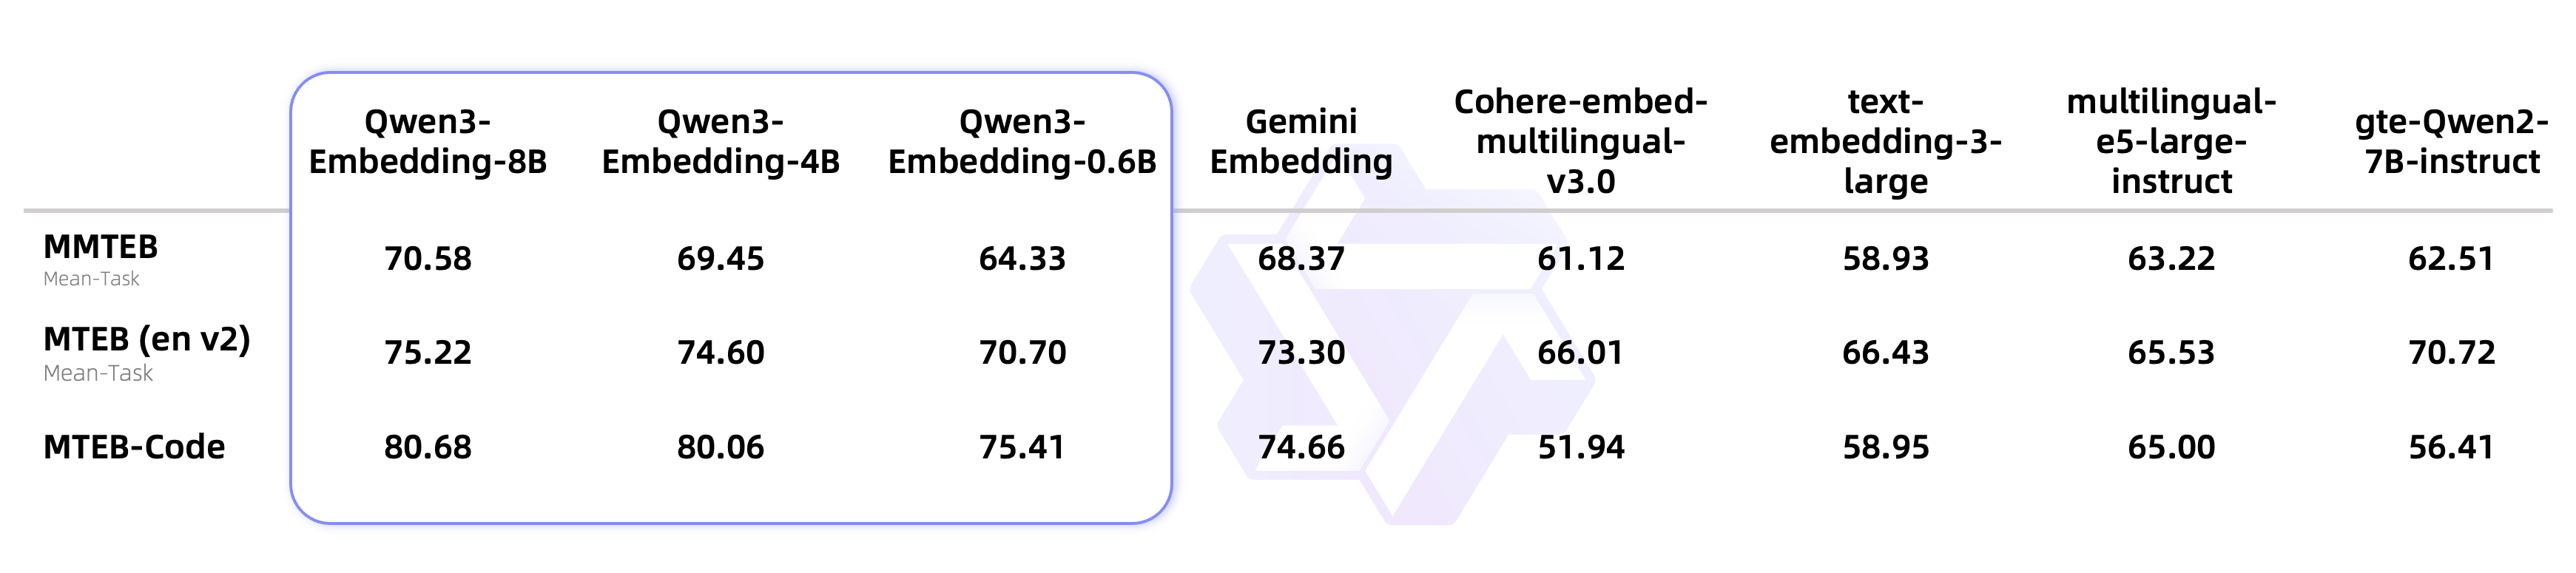
- ผลลัพธ์ที่ล้ำสมัยเกี่ยวกับเกณฑ์มาตรฐาน เช่น MTEB (เกณฑ์มาตรฐานการฝังข้อความหลายภาษา) และ MTEB-Code
- มีประสิทธิภาพในการดึงข้อมูลข้ามภาษาและโค้ด (เช่น การค้นหาที่เก็บของ GitHub สำหรับฟังก์ชัน Python)
2. ความยืดหยุ่นที่ครอบคลุม:
- ขนาดโมเดล: 0.6B (ไม่กินพื้นที่) 4B (สมดุล) และ8B (ประสิทธิภาพสูง)
- ขนาดที่ปรับแต่งได้: ความยาวเวกเตอร์ตัวแปร (เช่น 1024D สำหรับ Qwen3-Embedding-0.6B 4096D สำหรับ Qwen3-Embedding-8B)
- ความเข้าใจในคำสั่ง: คำสั่งเฉพาะงาน (เช่น _"จากคำถาม ข้อเท็จจริง และบริบทต่อไปนี้ ให้ดึงคำตอบที่ถูกต้องมา"_)
3. ความเชี่ยวชาญหลายภาษา:
- รองรับภาษามากกว่า 100 ภาษา รวมถึงภาษาโปรแกรม (Python, Java, C ++ ฯลฯ)
- การจัดการงานข้ามภาษา (เช่น การคิวรีเป็นภาษาอังกฤษและการดึงข้อมูลเอกสารภาษาฝรั่งเศส)
ผลการประเมิน
ผลการประเมินสำหรับโมเดลการจัดอันดับใหม่:
ผลการประเมินสำหรับโมเดลการจัดอันดับใหม่:
| โมเดล | พารามิเตอร์ | MTEB-R | CMTEB-R | MMTEB-R | MLDR | MTEB-Code | FollowIR |
|---|---|---|---|---|---|---|---|
| Qwen3-Embedding-0.6B | 0.6B | 61.82 | 71.02 | 64.64 | 50.26 | 75.41 | 5.09 |
| Jina-multilingual-reranker-v2-base | 0.3B | 58.22 | 63.37 | 63.73 | 39.66 | 58.98 | -0.68 |
| gte-multilingual-reranker-base | 0.3B | 59.51 | 74.08 | 59.44 | 66.33 | 54.18 | -1.64 |
| BGE-reranker-v2-m3 | 0.6B | 57.03 | 72.16 | 58.36 | 59.51 | 41.38 | -0.01 |
| Qwen3-Reranker-0.6B | 0.6B | 65.80 | 71.31 | 66.36 | 67.28 | 73.42 | 5.41 |
| Qwen3-Reranker-4B | 4B | 69.76 | 75.94 | 72.74 | 69.97 | 81.20 | 14.84 |
| Qwen3-Reranker-8B | 8B | 69.02 | 77.45 | 72.94 | 70.19 | 81.22 | 8.05 |
ข้อดี
-
ประสิทธิภาพ
- คะแนน Qwen3-Embedding-8B 70.58 บน MTEB Multilingual มีประสิทธิภาพเหนือกว่า Gemini-Embedding ของ Google
- Qwen3-Reranker-8B เพิ่มความแม่นยำในการจัดอันดับขึ้น 3.0 คะแนนซึ่งมากกว่าตัวจัดอันดับใหม่ที่มีเล็กกว่า
-
ประสิทธิผล:
- โมเดลที่เล็กกว่า (เช่น 0.6B) สร้างสมดุลระหว่างความเร็วและความแม่นยำในสภาพแวดล้อมที่มีทรัพยากรจำกัด
-
การปรับแต่ง:
- ผู้ใช้สามารถปรับแต่งเทมเพลตคำสั่งสำหรับงานเฉพาะโดเมน (เช่น การวิเคราะห์สัญญาทางกฎหมาย) ได้
ข้อเสีย
-
ข้อกำหนดด้านทรัพยากร:
- โมเดลที่ใหญ่กว่า (เช่น 8B) ต้องการหน่วยความจำ GPU จำนวนมาก (เช่น 8X A100s NVIDIA สำหรับการฝึก)
-
เวลาหน่วง:
- ตัวจัดอันใหม่ประสิทธิภาพสูงอาจทำให้เกิดความล่าช้าในแอปพลิเคชันแบบเรียลไทม์ (เช่น แชทบอทสด)
ข้อกำหนดทางเทคนิค
ภาพรวมของโมเดล:
| ประเภทโมเดล | โมเดล | ขนาด | ชั้น | ลำดับความยาว | ขนาดการฝัง | การรองรับ MRL | ความเข้าใจในคำสั่ง |
|---|---|---|---|---|---|---|---|
| การฝังข้อความ | Qwen3-Embedding-0.6B | 0.6B | 28 | 32K | 1024 | ใช่ | ใช่ |
| Qwen3-Embedding-4B | 4B | 36 | 32K | 2560 | ใช่ | ใช่ | |
| Qwen3-Embedding-8B | 8B | 36 | 32K | 4096 | ใช่ | ใช่ | |
| การจัดอันดับข้อความใหม่ | Qwen3-Reranker-0.6B | 0.6B | 28 | 32K | - | - | ใช่ |
| Qwen3-Reranker-4B | 4B | 36 | 32K | - | - | ใช่ | |
| Qwen3-Reranker-8B | 8B | 36 | 32K | - | - | ใช่ |
หมายเหตุ:“การรองรับ MRL” ระบุว่าโมเดลการฝังรองรับขนาดที่กำหนดเองสำหรับการฝังขั้นสุดท้ายหรือไม่ “ความเข้าใจในคำสั่ง" ตั้งข้อสังเกตว่ารูปแบบการฝังหรือการจัดอันดับใหม่รองรับการปรับแต่งคำสั่งที่ป้อนสำหรับงานที่แตกต่างกันหรือไม่
1.2. การปรับใช้และเรียกใช้โมเดลการฝังบน Alibaba Cloud
การปรับใช้ Qwen3 บน PAI-EAS และการใช้ไลบรารีที่เข้ากันได้กับ OpenAI
Alibaba Cloud มีวิธีการหลักสองวิธีในการเรียกใช้โมเดลการฝัง:
- Model Studio: แพลตฟอร์มที่ไม่ต้องเขียนโค้ดซึ่งนำเสนอโมเดลพร้อมใช้งาน เช่น text-embedding-v3 (เหมาะสำหรับการใช้งานอย่างรวดเร็ว) ไปที่ Alibaba Cloud Model Studio หากต้องการทราบรายละเอียดเพิ่มเติม
- PAI-EAS: บริการที่มีการจัดการสำหรับการปรับใช้โมเดลที่กำหนดเอง เช่น Qwen3-Embedding-8B (สำหรับการปรับแต่งขั้นสูง) ไปที่ PAI – Platform for AI หากต้องการทราบรายละเอียดเพิ่มเติม
วิธีที่ 1: การใช้ Model Studio สำหรับฝังข้อความ
Model Studio ของ Alibaba Cloud ลดความยุ่งยากในการเข้าถึงโมเดลโอเพนซอร์สที่ฝึกไว้ล่วงหน้าอันเป็นกรรมสิทธิ์ รวมถึง text-embedding-v3 โดยไม่จำเป็นต้องมีการปรับใช้หรือการจัดการโครงสร้างพื้นฐาน
คำแนะนำทีละขั้นตอนในการเรียกใช้ text-embedding-v3
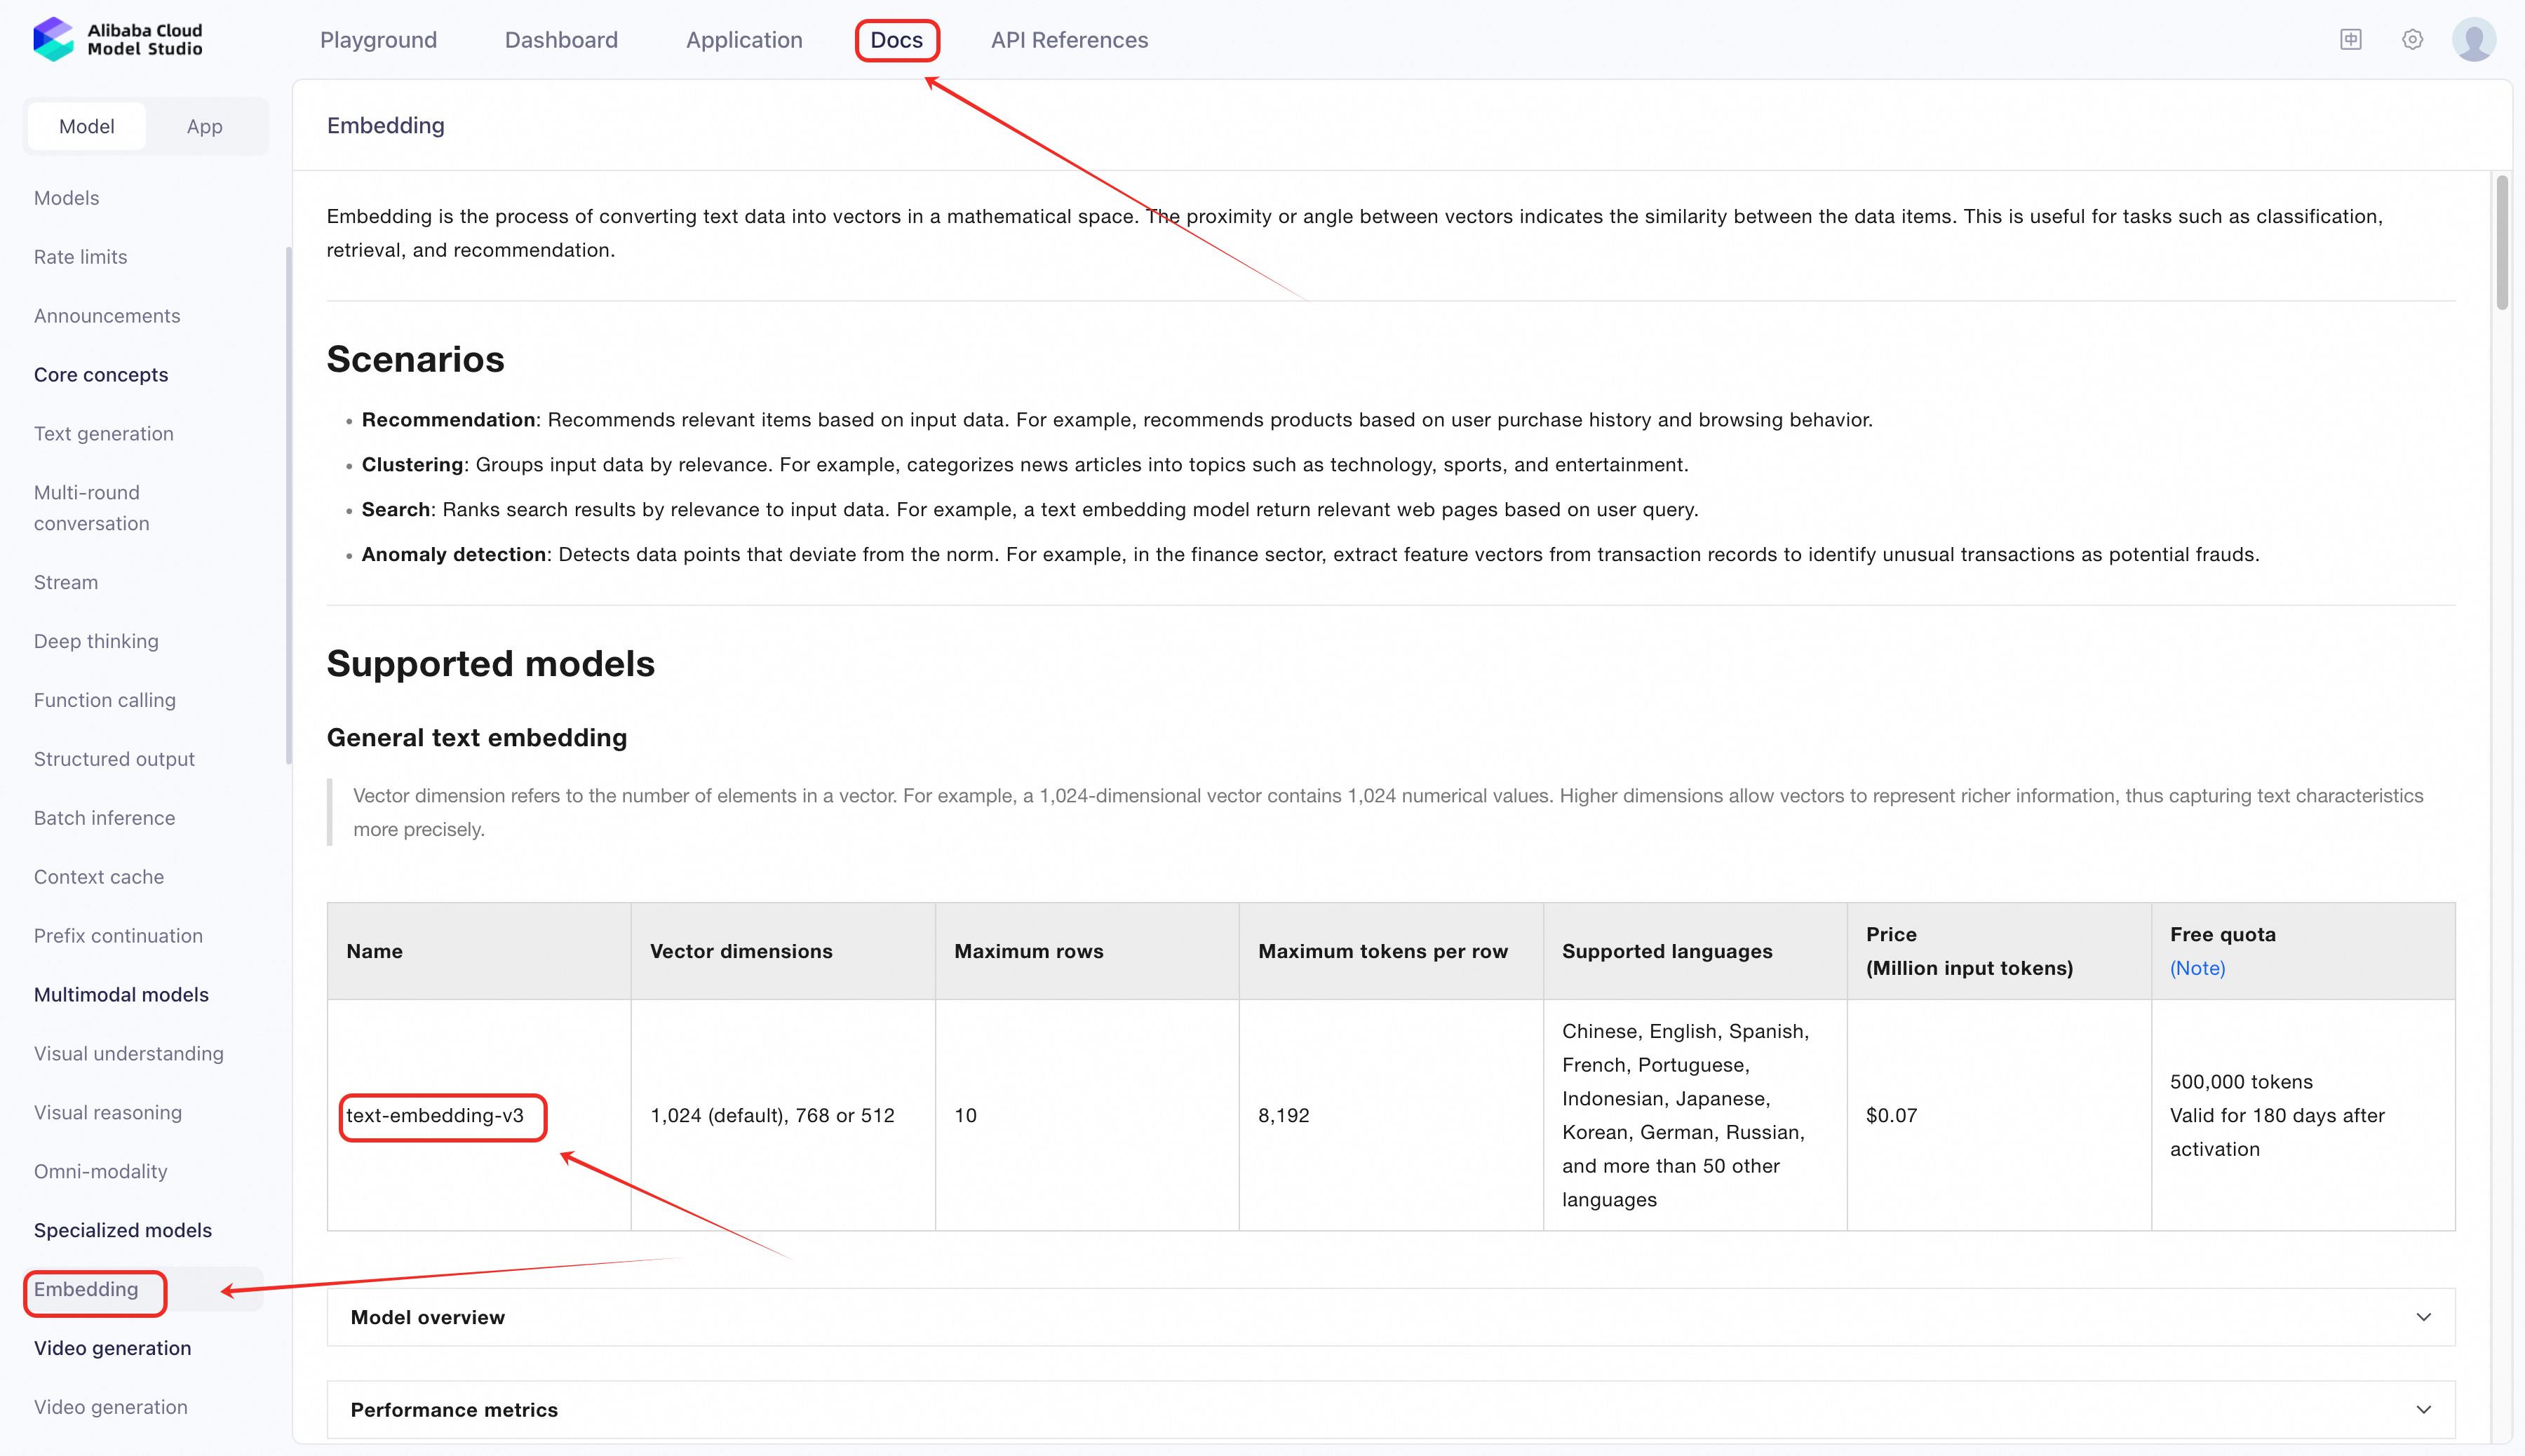
1. เข้าถึง Model Studio:
- ไปที่ Alibaba Cloud Model Studio Console
- คลิกแท็บ "เอกสาร" ในแถบนำทางด้านบน (เน้นไว้ด้วยสีแดงในภาพ)
- คลิก "การฝัง" (เน้นไว้ด้วยสีแดงในภาพ) นี่จะแสดงเอกสารที่เกี่ยวข้องกับการฝัง
2. เรียกใช้โมเดลผ่าน API ที่เข้ากันได้กับ OpenAI:
- เมื่อเลือกแล้ว ให้ไปยังแท็บ "รายละเอียด API" เพื่อรับข้อมูลประจำตัวของอุปกรณ์ปลายทางและการตรวจสอบความถูกต้อง
- รูปแบบคำขอตัวอย่างสำหรับการสร้างการฝัง:
นำเข้า os
จาก openai นำเข้า OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),  # แทนที่ด้วย API Key ของคุณหากคุณไม่ได้กำหนดค่าตัวแปรสภาพแวดล้อม
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"  # base_url สำหรับ Model Studio
)

completion = client.embeddings.create(
    model="text-embedding-v3",
    input='คุณภาพของเสื้อผ้าดีมาก สวยมาก คุ้มค่ากับการรอคอย ฉันชอบ และจะซื้อที่นี่อีกแน่นอน',
    dimensions=1024,
    encoding_format="float"
)

print(completion.model_dump_json())
ข้อดีของ Model Studio
- ไม่จำเป็นต้องมีการปรับใช้: ใช้โมเดลที่ฝึกไว้ล่วงหน้าได้ทันที
- ความสามารถในการปรับขนาด: การกำหนดราคาแบบจ่ายตามที่ใช้งานจริงพร้อมการปรับขนาดอัตโนมัติ
- ใช้งานง่าย: เหมาะสำหรับนักพัฒนาที่ไม่คุ้นเคยกับการตั้งค่าโครงสร้างพื้นฐาน
วิธีที่ 2: การปรับใช้โมเดลการฝัง Qwen3 บน PAI-EAS
ในส่วนของกรณีการใช้งานขั้นสูงที่จำเป็นต้องมีการปรับแต่ง (เช่น การปรับแต่งอย่างละเอียดเฉพาะโดเมน) ปรับใช้ Qwen3-Embedding-8B หรือตัวแปร Qwen3 อื่นๆ บนPAI-EAS (บริการเร่งความเร็วที่ยืดหยุ่น) ด้านล่างนี้เป็นคู่มือทีละขั้นตอนตามเครื่องมือและอินเทอร์เฟซ PAI ล่าสุด:
การปรับใช้ทีละขั้นตอนในการเริ่มต้นใช้งานด่วน
1. ลงชื่อเข้าใช้คอนโซล PAI
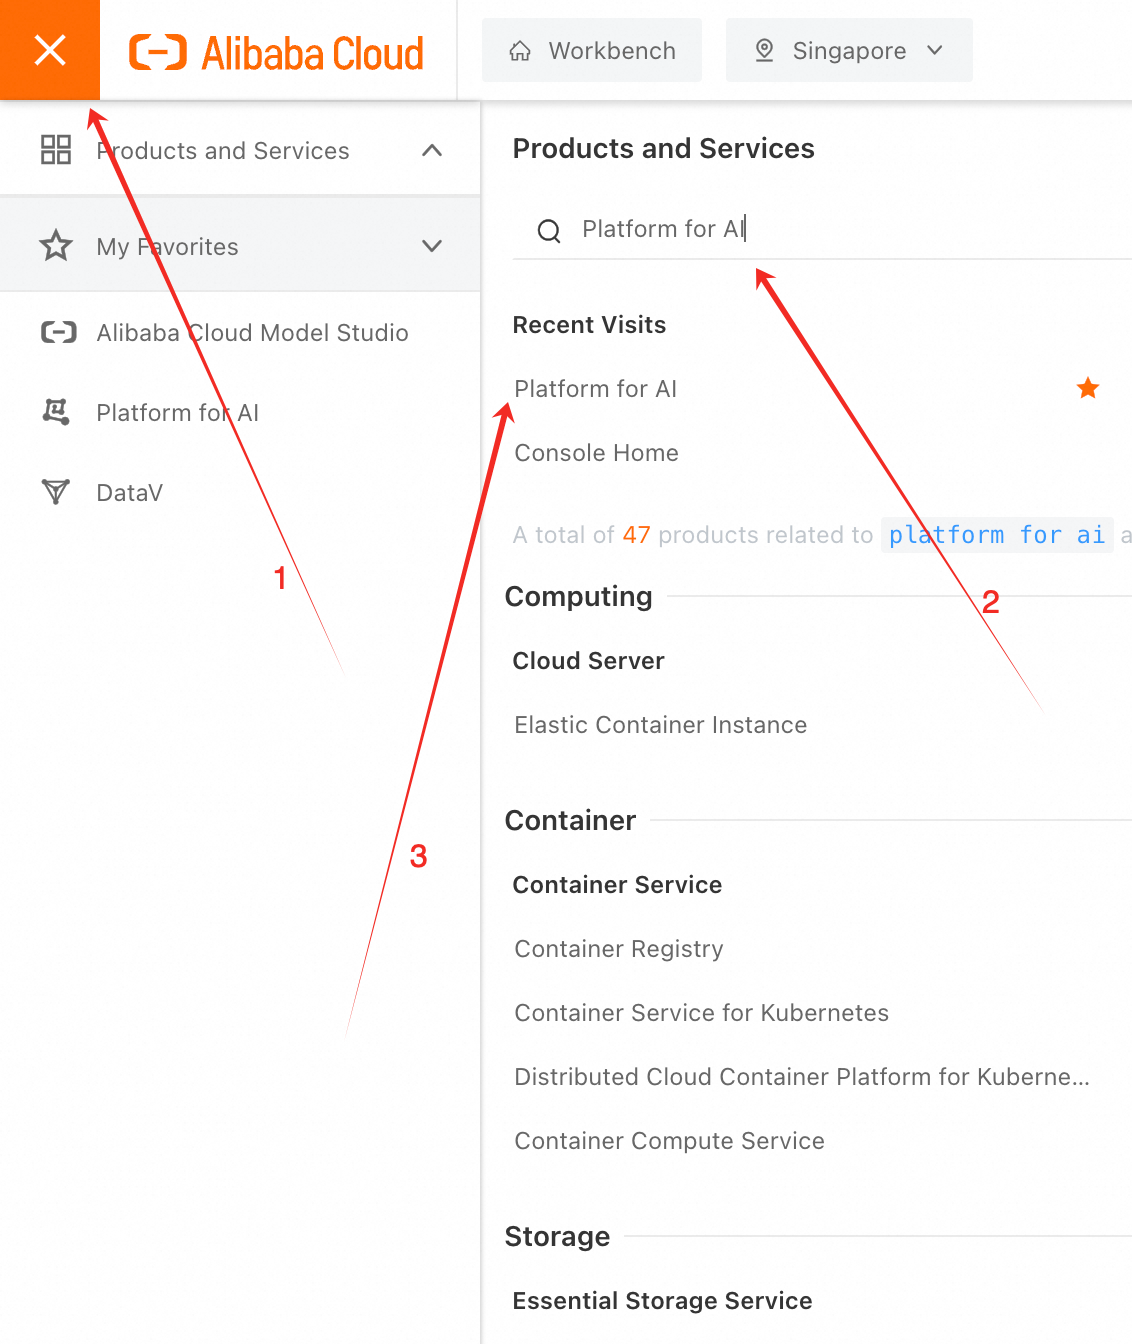
2. เลือก พื้นที่ทำงาน และเลือก _การเริ่มต้นใช้งานด่วน >แกลเลอรีโมเดล > NLP > การฝัง_ หาหรือค้นหาโมเดล Qwen3-Embedding
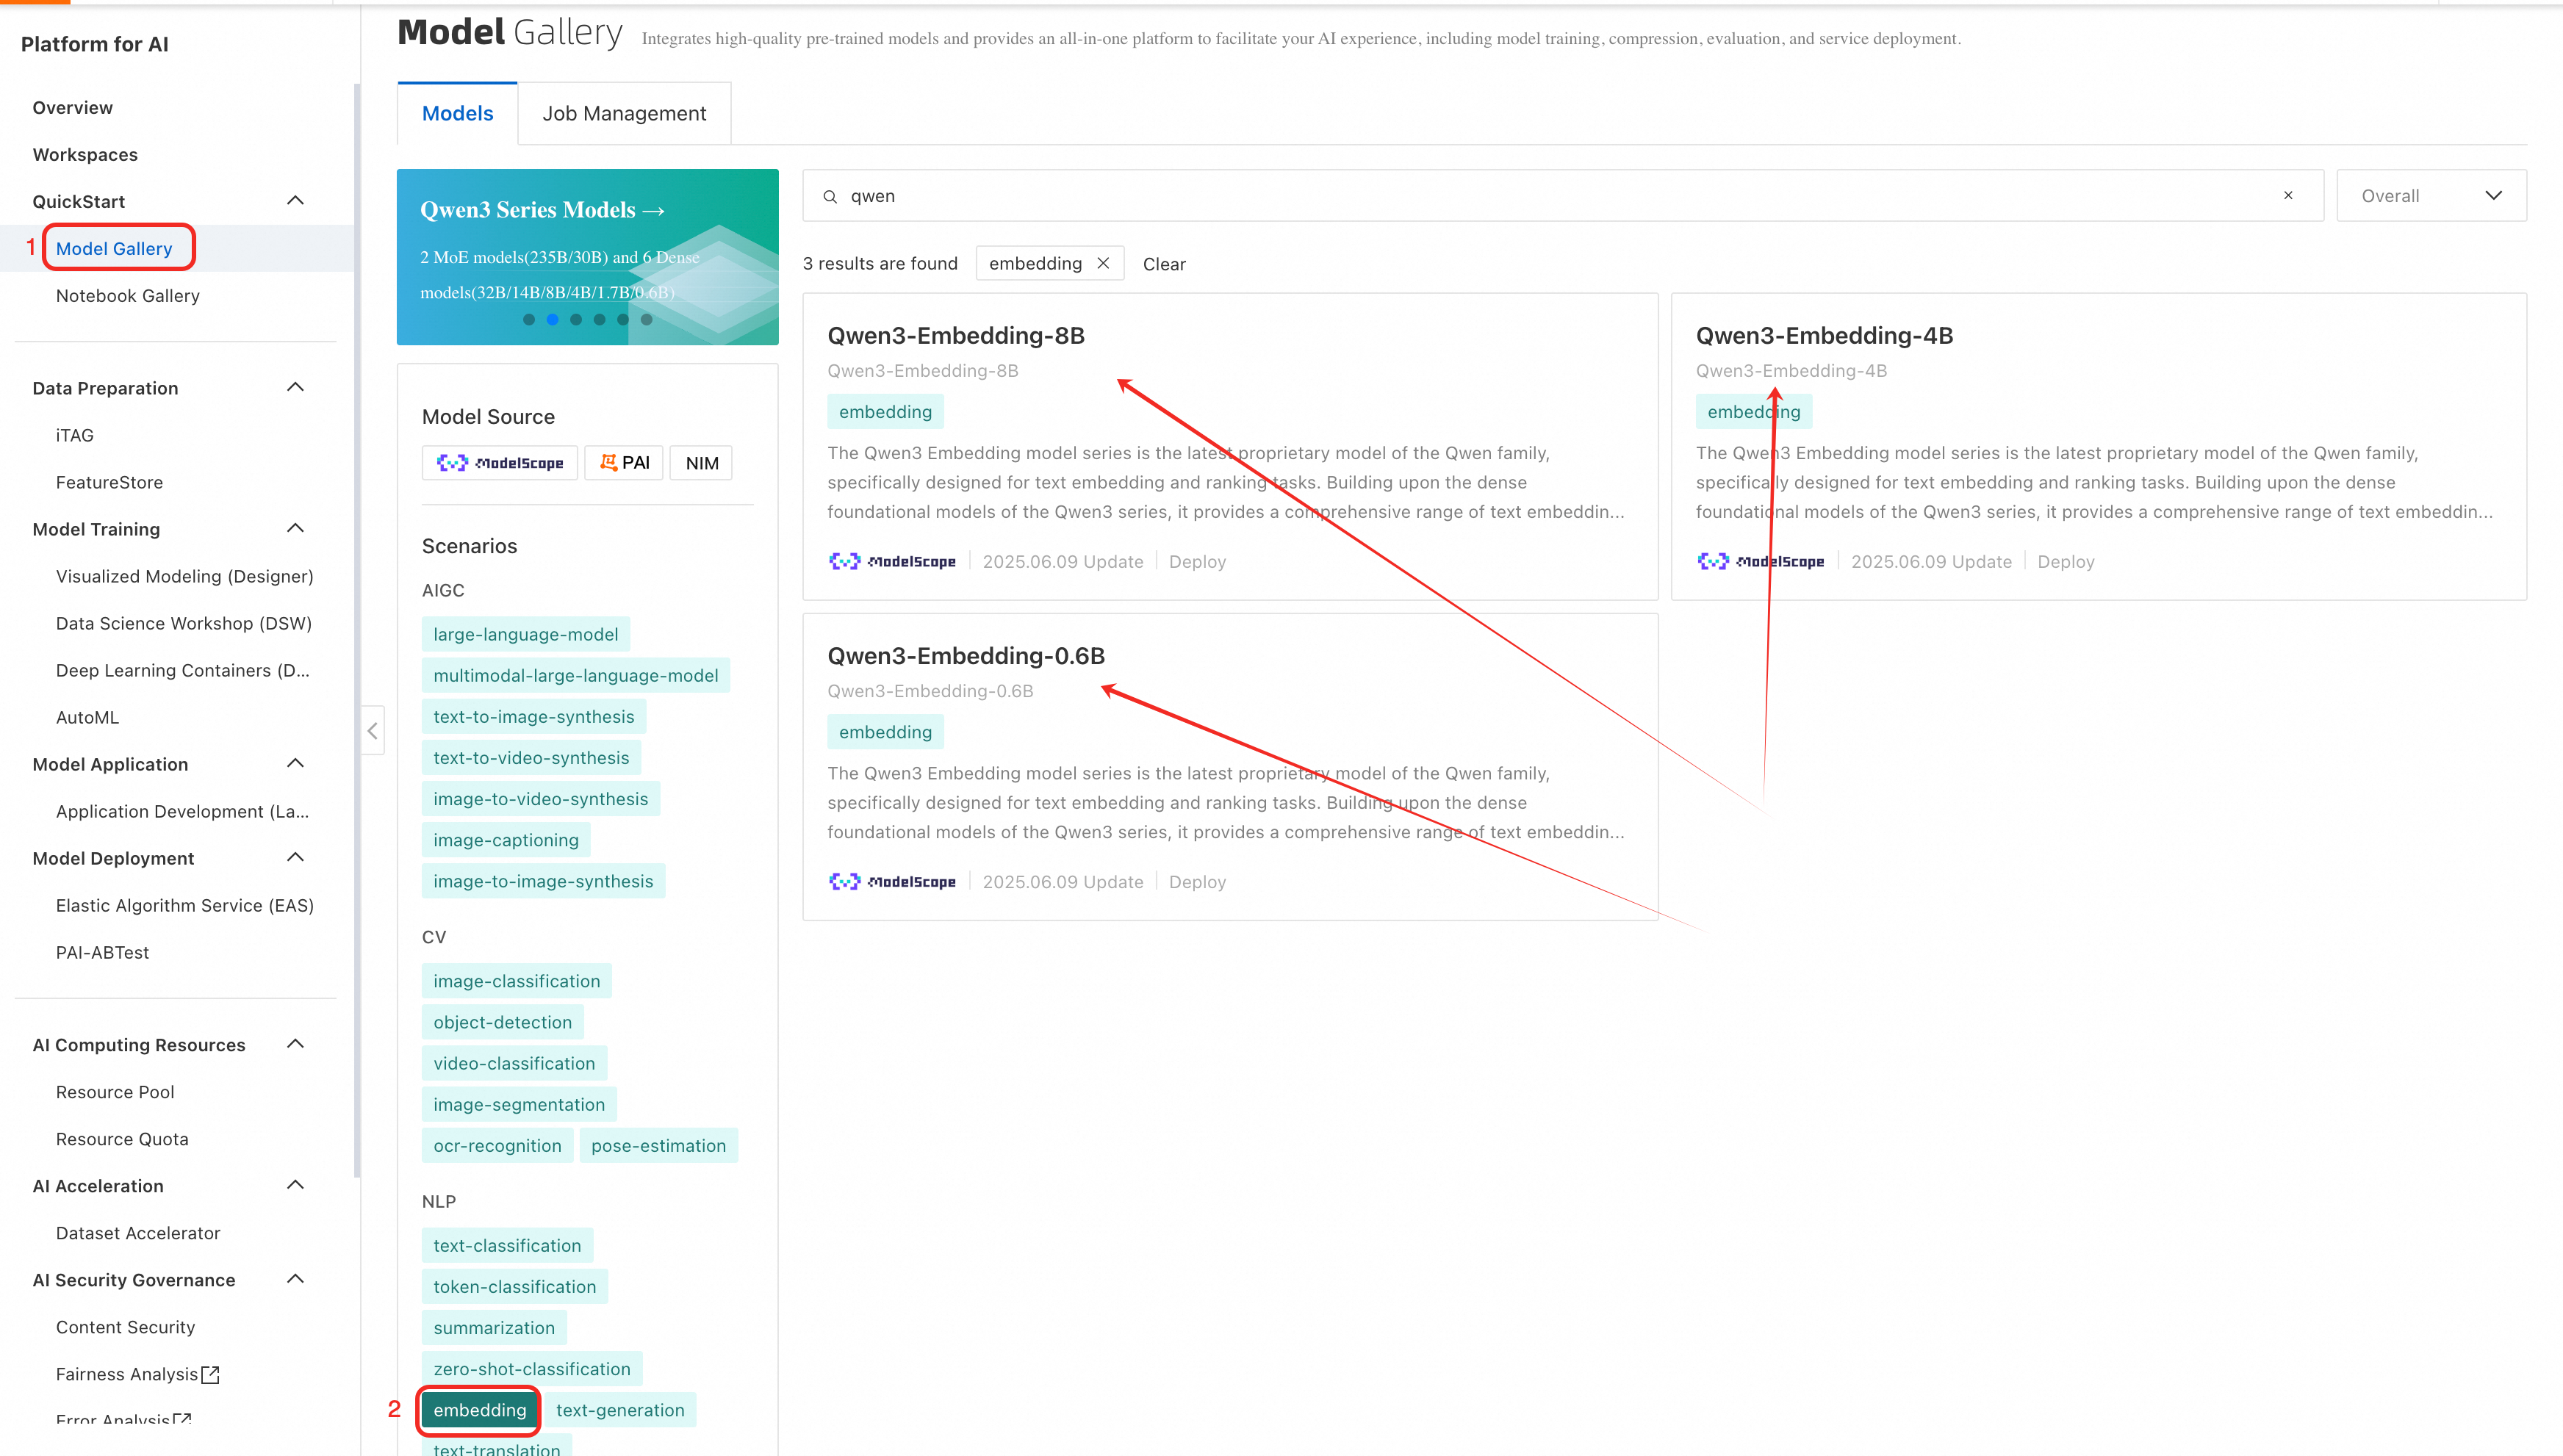
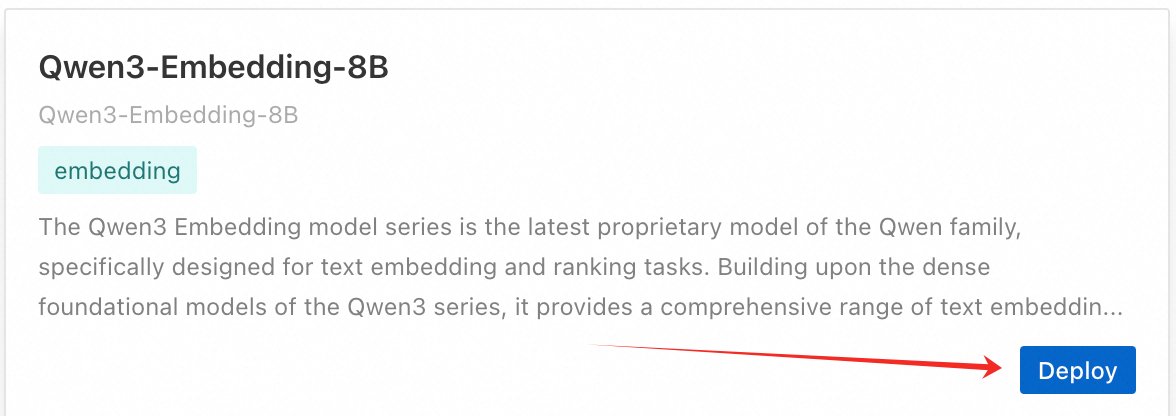
3. คลิกข้อความ ปรับใช้ ถัดจากโมเดลที่ต้องการ (เช่น Qwen3-Embedding-8B)
4. กำหนดค่าประเภทอินสแตนซ์ การปรับขนาดอัตโนมัติ และพารามิเตอร์อื่นๆ
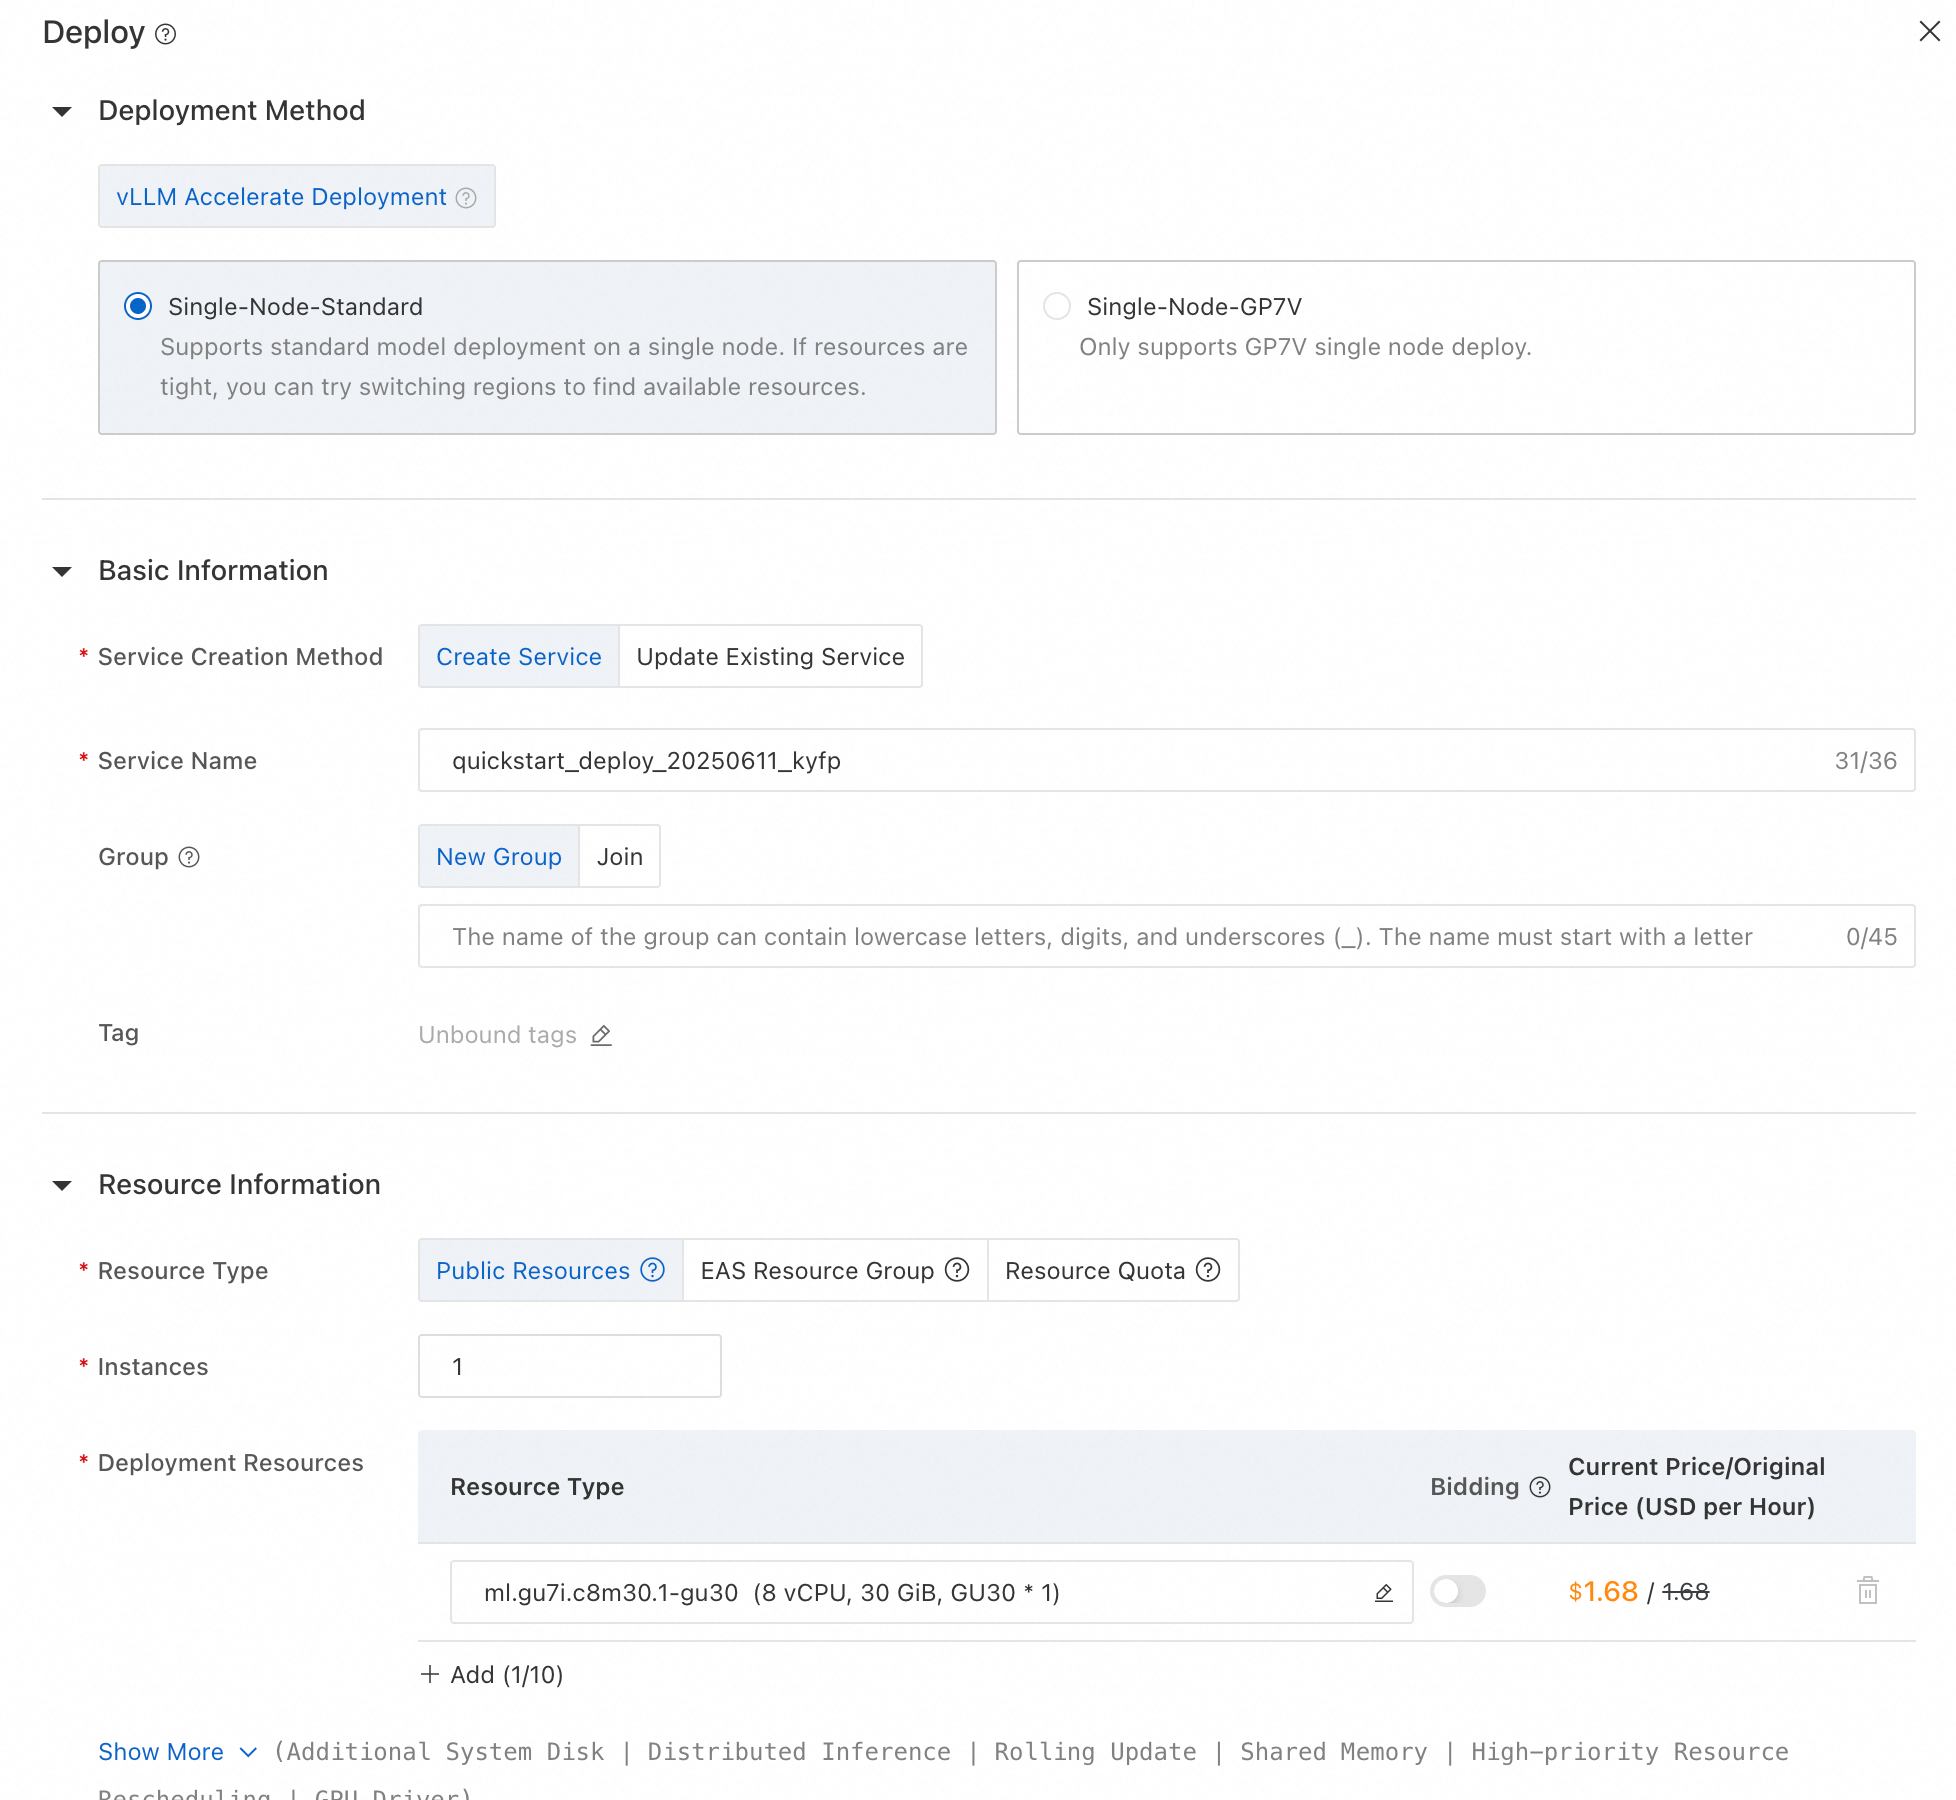
5. เพื่อเข้าถึงโมเดลที่ปรับใช้ล่าสุด ให้ไปยังส่วนการปรับใช้โมเดลและเลือกบบริการอัลกอริทึมที่ยืดหยุ่น (EAS) เมื่อ "สถานะการบริการ" คือ "กำลังดำเนินการ" คุณจะสามารถเริ่มใช้โมเดลได้
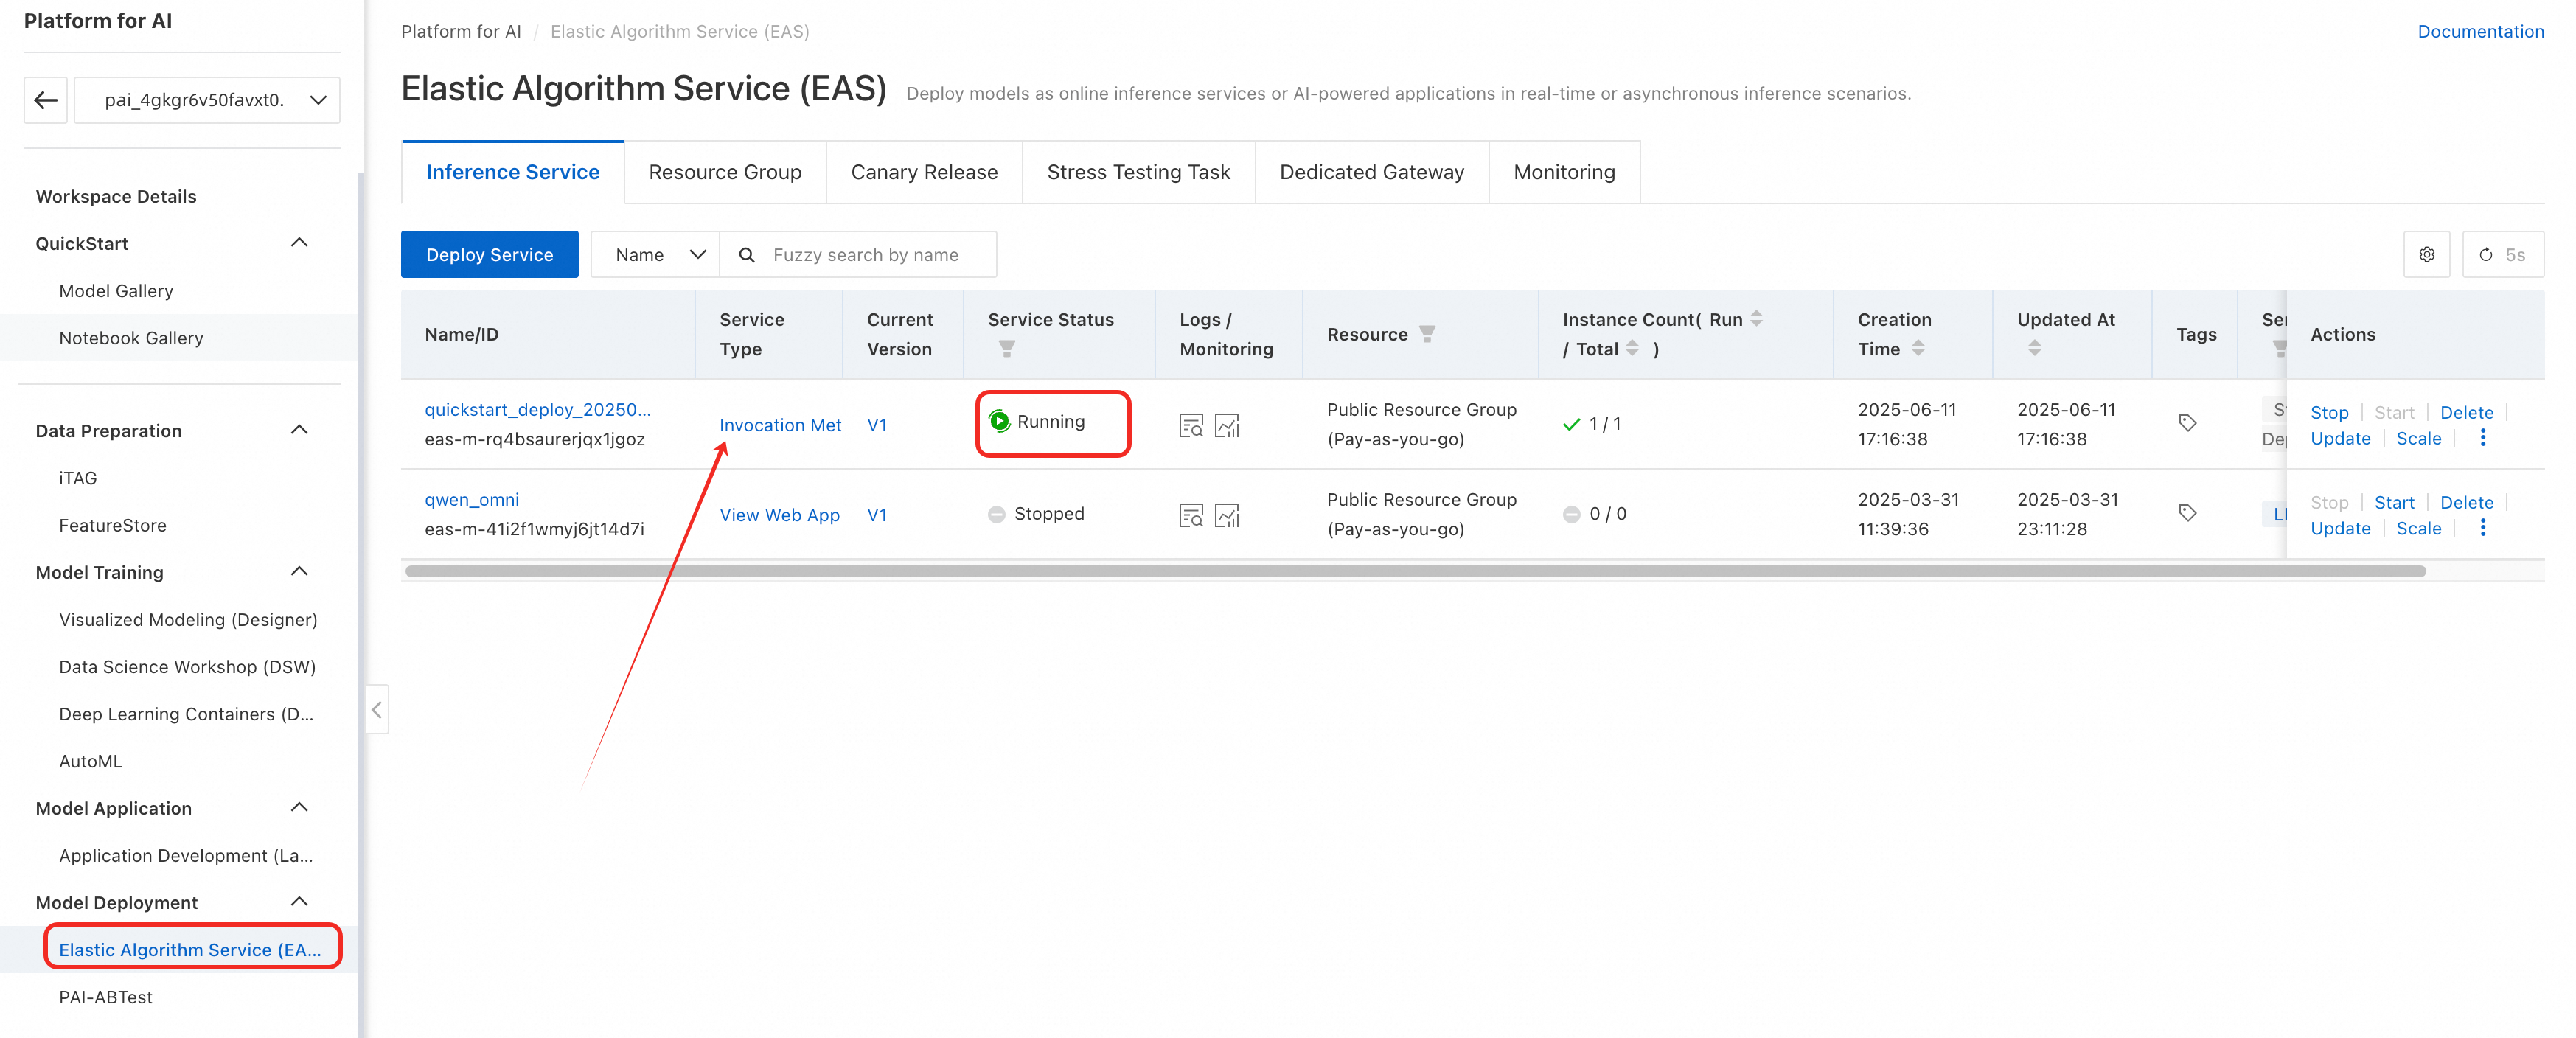
6. คลิกวิธีการเรียกใช้และคัดลอกปลายทาง API ที่สร้างขึ้นสำหรับการผสานรวม
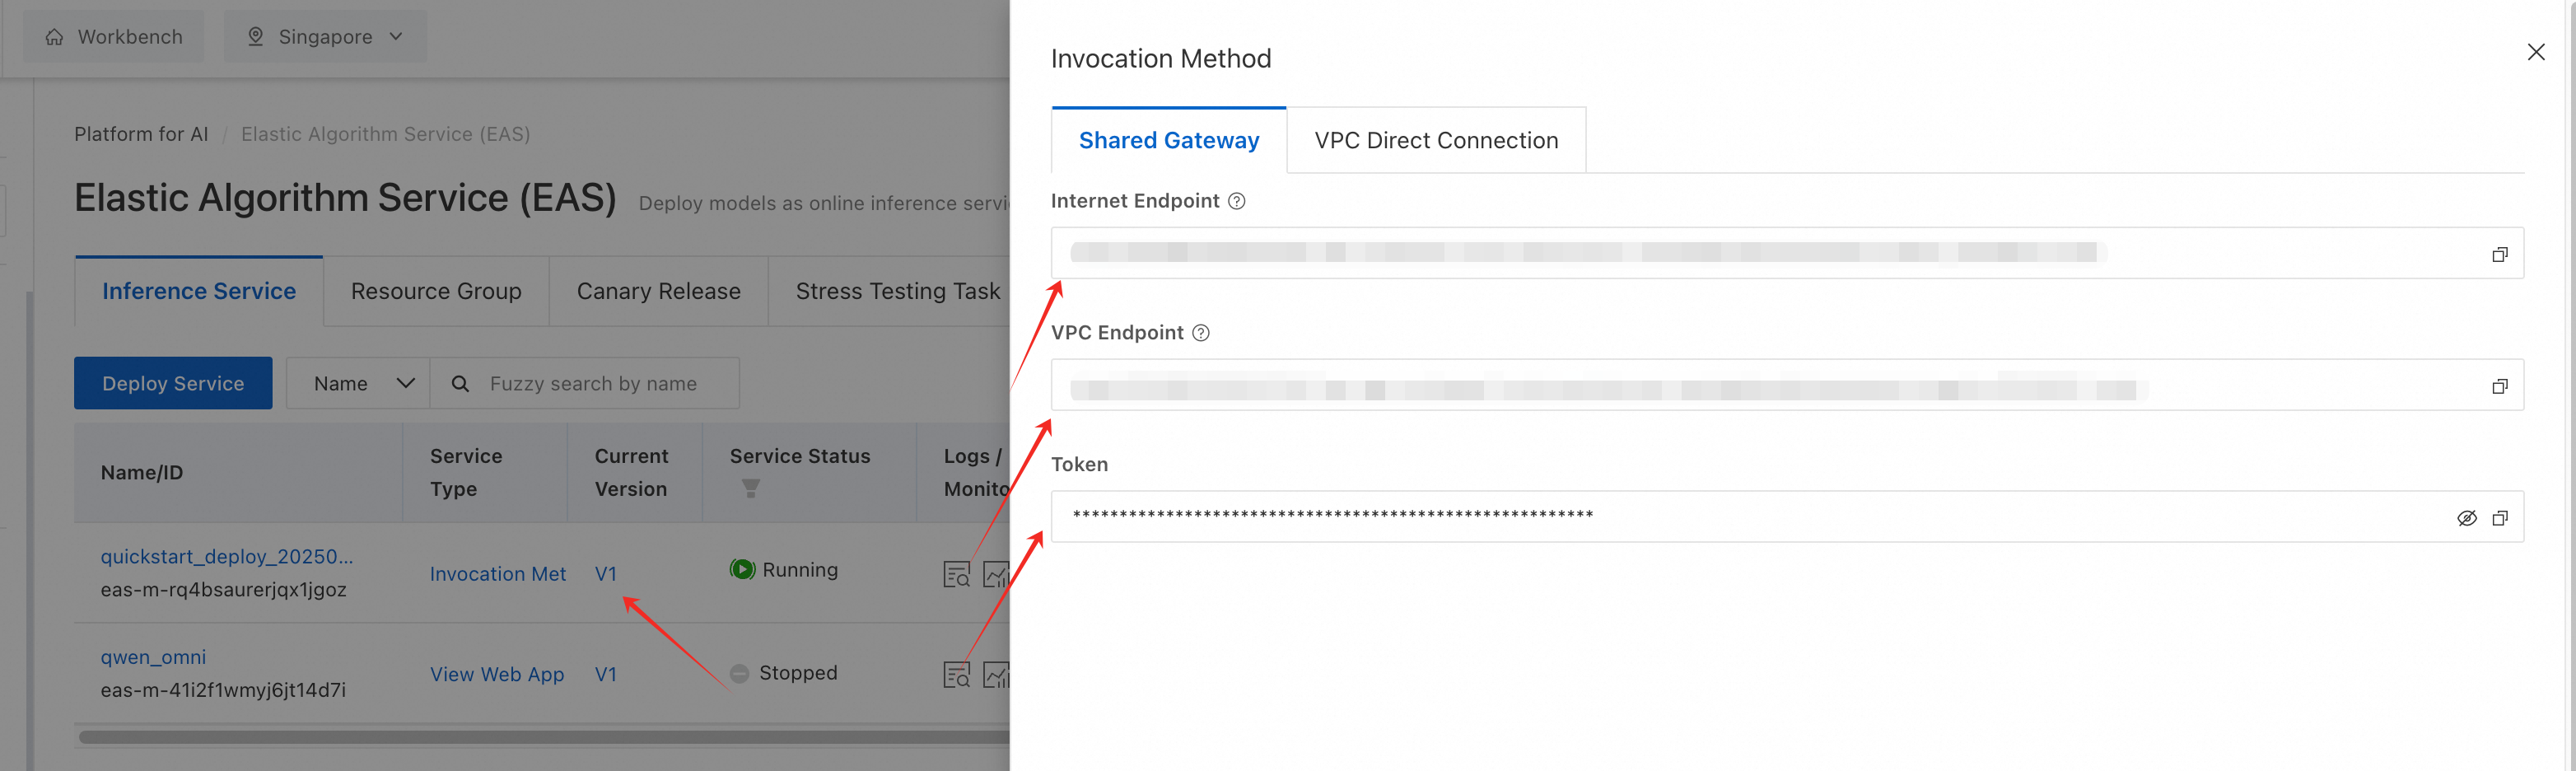
เวิร์กโฟลว์ที่คล่องตัวนี้ช่วยให้มั่นใจว่าจะสามารถปรับใช้ได้อย่างรวดเร็วในขณะที่ยังคงความยืดหยุ่นในการปรับแต่งขั้นสูง
ส่งคำขอผ่าน API ที่เข้ากันได้กับ OpenAI
PAI-EAS รองรับรูปแบบ API ของ OpenAI ตั้งแต่ต้น ทำให้สามารถผสานรวมเข้ากับเครื่องมือต่าง ๆ เช่น LangChain หรือ OpenAI:
จาก openai นำเข้า OpenAI

# เริ่มต้นไคลเอ็นต์ด้วยจุดปลายทาง PAI-EAS
client = OpenAI(
    base_url="https://<pai-eas-endpoint>/v1",
    api_key="<your-pai-api-key>"
)

# Generate embeddings
embedding = client.embeddings.create(
    input="ฉันควรเลือก LLM ที่ดีที่สุดสำหรับอุตสาหกรรมการเงินอย่างไร?",
    model="qwen3-embedding-8b"
)
print(embedding.data[0].embedding)  # Outputs a 4096D vector

# จัดอันดับผลลัพธ์การค้นหา
rerank = client.rerank.create(
    query="Renewable energy solutions",
    documents=[
        "การนำพลังงานแสงอาทิตย์มาใช้เพิ่มขึ้น 30% ในปี 2024",
        "พลังงานลมเผชิญกับความท้าทายในเขตเมือง",
        "เซลล์เชื้อเพลิงไฮโดรเจนให้ระบบขนส่งที่ไม่ปล่อยมลพิษ"
    ],
    model="qwen3-reranker-4b"
)
print(rerank.results)  # ส่งคืนคะแนนความเกี่ยวข้อง
1. การโทร API โดยตรง (ไม่บังคับ)
สำหรับการควบคุมระดับต่ำ ส่งคำขอ HTTP ดิบ:
นำเข้าคำขอ

# คำขอตัวอย่าง
url = "<pai-eas-endpoint>/v1/embeddings"
headers = {"Authorization": "Bearer <your-api-key>"}
payload = {
    "input": ["การคำนวณเชิงควอนตัมจะปฏิวัติวงการการเข้ารหัสข้อมูล"],
    "model": "qwen3-embedding-8b"
}
response = requests.post(url, headers=headers, json=payload)
print(response.json())
ข้อดีของ PAI-EAS
- การปรับใช้โดเมน: โมเดล Qwen3 ที่ปรับแต่งอย่างละเอียดสำหรับงานเฉพาะกลุ่ม (เช่น การวิเคราะห์ความเสี่ยงทางการเงิน)
- ความสามารถในการปรับขนาด: ปรับขนาดอัตโนมัติสำหรับปริมาณการรับส่งข้อมูลที่เพิ่มขึ้นโดยไม่มีการแทรกแซงด้วยตนเอง
- ความคุ้มค่าใช้จ่าย: โมเดลที่เล็กกว่า (เช่น Qwen3-Embedding-0.6B) สำหรับปริมาณงานไม่มาก
- ระบบนิเวศรวมศูนย์: แกลเลอรีโมเดลของ PAI, SDK และ EAS สำหรับ MLOps ครบวงจร
วิธีเลือก (Model Studio หรือ PAI-EAS?)
| กรณีการใช้งาน | Model Studio | PAI-EAS |
|---|---|---|
| การสร้างต้นแบบอย่างรวดเร็ว | ✅ ไม่ต้องเขียนโค้ด เข้าใช้งานได้ทันที | ❌ ต้องมีการตั้งค่าการปรับใช้ |
| การปรับแต่งเฉพาะโดเมน | ❌ จำกัดไว้เพียงโมเดลที่ฝึกไว้ล่วงหน้า | ✅ รองรับการปรับแต่งอย่างละเอียดและโมเดลที่กำหนดเอง |
| คุ้มค่าใช้จ่าย | ✅ การกำหนดราคาแบบจ่ายตามโทเค็น | ✅ การกำหนดราคาของอินสแตนซ์ GPU ที่ยืดหยุ่น |
| การผสานรวมเข้ากับ OpenAI SDK | ✅ การรองรับ API-ที่เข้ากันได้กับ OpenAI | ✅ การรองรับ API-ที่เข้ากันได้กับ OpenAI |
ขั้นตอนถัดไป
- Model Studio: สำรวจโมเดลการฝังข้อความ
- PAI – แพลตฟอร์มสำหรับ AI: เรียนรู้เพิ่มเติมเกี่ยวกับการเริ่มต้นใช้งานด่วนผ่านเอกสาร PAI
- เริ่มต้นด้วย Alibaba Cloud:เริ่มเส้นทาง AI หลากหลายรูปของคุณที่นี่[](about:blank)หรือติดต่อ Alibaba Cloud
สรุป
โมเดลการฝังและการจัดอันดับใหม่ของ Qwen3 ให้ความยืดหยุ่นและประสิทธิภาพที่ไม่มีใครเทียบได้ในอุตสาหกรรมต่างๆ คุณสามารถปรับใช้และปรับแต่งโมเดลเหล่านี้อย่างละเอียดเพื่อแก้ไขปัญหาความท้าทายเฉพาะโดเมน นับตั้งแต่การวิเคราะห์ความเสี่ยงทางการเงินไปจนถึงการวิจัยทางการแพทย์โดยใช้ประโยชน์จากระบบนิเวศ PAI ของ Alibaba Cloud การทำงานในอนาคตรวมถึงการขยายขีดความสามารถหลายรูปแบบ (เช่น การดึงข้อมูลภาพและข้อความระหว่างรูปแบบต่าง ๆ) และการเพิ่มประสิทธิภาพสำหรับอุปกรณ์ปลายทาง
ส่วนที่ 2: การปรับแต่ง Qwen3 อย่างละเอียดบน PAI-Lingjun และกรณีการใช้งานในอุตสาหกรรม
2.1. การปรับแต่งโมเดล Qwen3 การฝัง และตัวจัดอันดับใหม่อย่างละเอียด: การปลดล็อกความเชี่ยวชาญเฉพาะโดเมน
ในโลกของ AI นั้น รูปแบบเดียวไม่ได้ใช้ได้กับทุกกรณี ในขณะที่โมเดลการฝังและการจัดอันดับใหม่ของ Qwen3 ได้รับการฝึกไว้ล่วงหน้าเพื่อฝึกงานทั่วไปจนเชี่ยวชาญ นับตั้งแต่การทำความเข้าใจข้อความหลายภาษาไปจนถึงการดึงข้อมูลโค้ด ศักยภาพที่แท้จริงของโมเดลจะแสดงให้เห็นเมื่อปรับแต่งให้เข้ากับโดเมน เช่น การเงิน การดูแลสุขภาพ หรือกฎหมาย นี่คือจุดที่ PAI-Lingjun แพลตฟอร์มการฝึกขนาดใหญ่ของ Alibaba Cloud จะเข้ามาเป็นตัวเร่งปฏิกิริยาในการเปลี่ยนแปลง
ความจำเป็นในการปรับแต่ง
ลองนึกภาพนักวิจัยด้านเภสัชกรรมคัดกรองการทดลองทางคลินิกหลายล้านครั้งเพื่อค้นหาโรคหายากที่ตรงกัน หรือทนายความไล่ดูสัญญาหลายพันฉบับเพื่อหาข้อกฎหมายข้อใดข้อหนึ่งโดยเฉพาะ โมเดลทั่วไป แม้จะมีประสิทธิภาพ แต่ก็มักจะพลาดรายละเอียดปลีกย่อยของภาษาเฉพาะโดเมน เช่น “EBITDA” “กล้ามเนื้อหัวใจตาย ”หรือ “เหตุสุดวิสัย ”ที่ต้องการความถูกต้องแม่นยำ การปรับแต่งช่องว่างนี้ช่วยปรับสถาปัตยกรรมของ Qwen3 ให้เข้าใจถึงความแตกต่างในรายละเอียดปลีกย่อยของงานเฉพาะทาง นับตั้งแต่การค้นพบยาไปจนถึงการประเมินความเสี่ยงทางการเงิน
Pai-Lingjun: กลไกที่อยู่เบื้องหลังความแม่นยำ
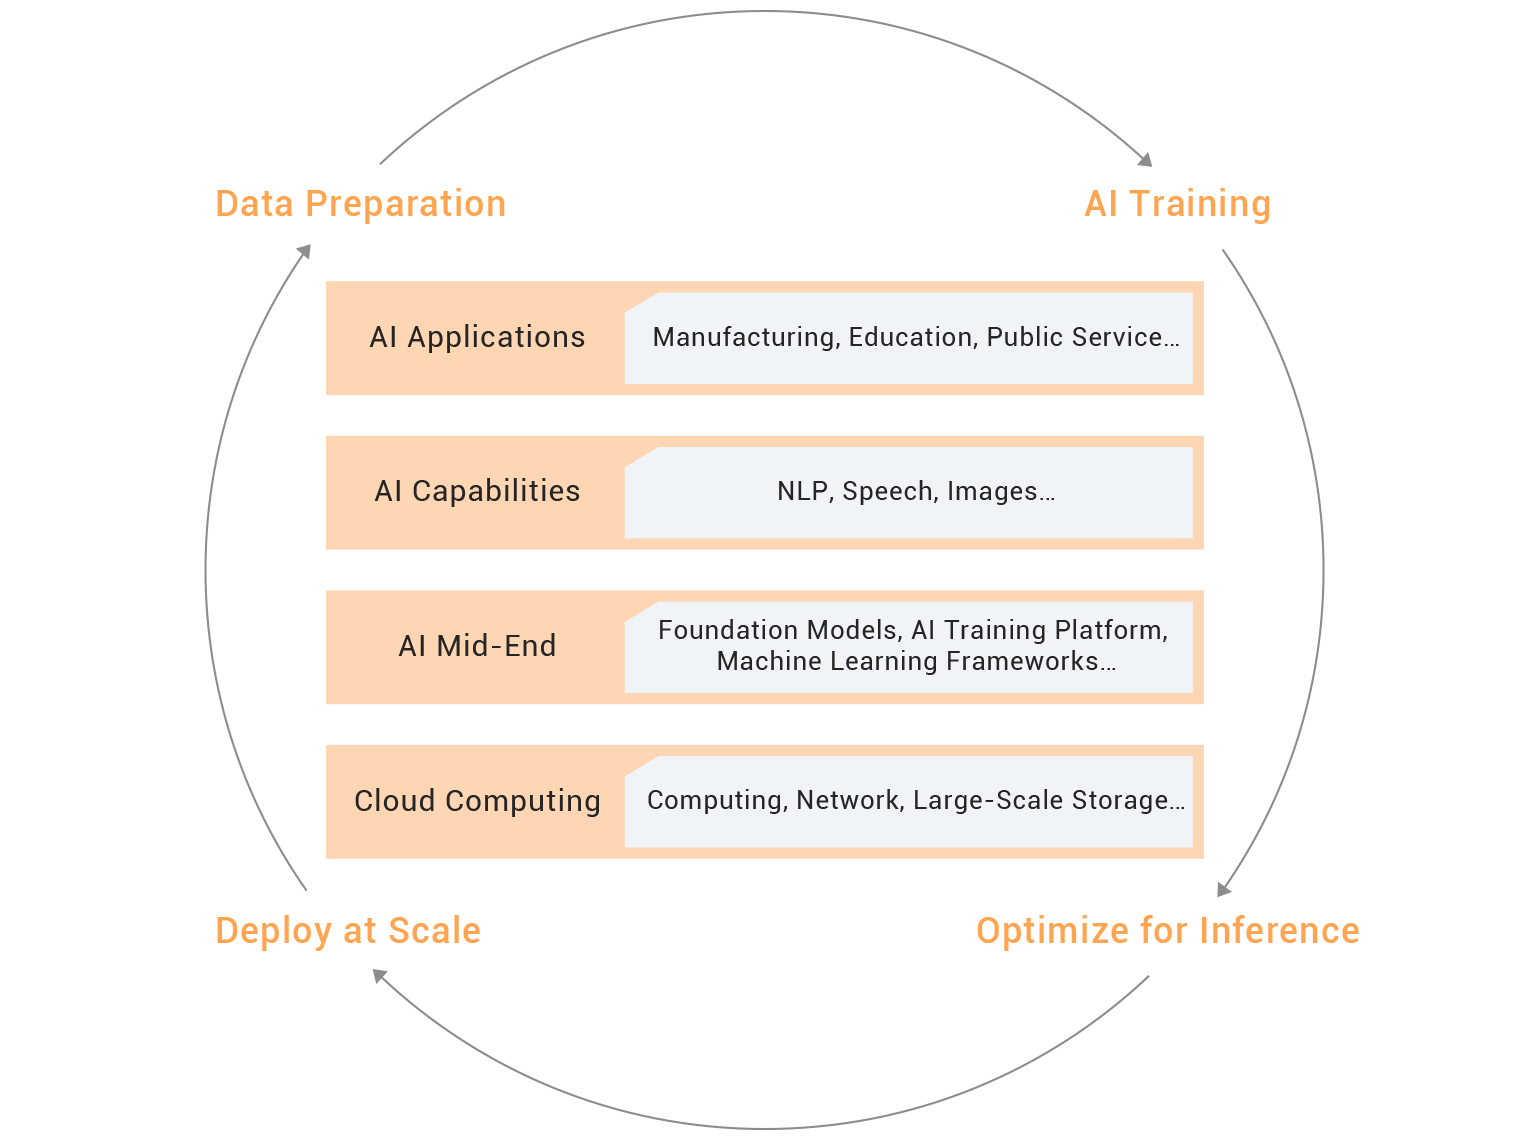
Pai-Lingjun เป็นเครื่องทรงพลังที่ออกแบบมาเพื่อจัดการกับความต้องการทางการคำนวณของการปรับแต่งโมเดล Qwen3 ด้วยการรองรับการฝึกแบบกระจายทั่ว GPU/TPU ทำให้องค์กรสามารถปรับขนาดจากโมเดลพารามิเตอร์ 0.6B ไปจนถึง 8B ได้สร้างความมั่นใจว่าโดเมนที่ซับซ้อนที่สุดจะสามารถค้นหาความสมดุลในอุดมคติระหว่างความเร็วและความแม่นยำได้
องค์ประกอบหลักของเวิร์กโฟลว์:
- ข้อมูลในฐานะรากฐาน: ความสำเร็จเฉพาะโดเมนเริ่มต้นด้วยข้อมูลที่คัดสรรไว้แล้ว สำหรับการเงิน นี่อาจหมายถึงการยื่น SEC สำหรับการดูแลสุขภาพ นี่คือบันทึกทางคลินิกและเอกสารการวิจัย ยิ่งชุดข้อมูลมีความสมบูรณ์มากเท่าไหร่ ความเข้าใจของโมเดลก็จะยิ่งลึกซึ้งมากขึ้นเท่านั้น
- ความฉลาดเชิงสังเคราะห์: ความสามารถในการสร้างข้อความของ Qwen3 สร้างข้อมูลสังเคราะห์ในระดับ 150 ล้านคู่ข้อความระหว่างภาษาต่าง ๆ โดยเติมช่องว่างที่มีข้อมูลที่มีป้ายกำกับไม่เพียงพอ
- ความเชี่ยวชาญในการจัดรูปแบบ: การฝึกจะขยายออกไปเป็นระยะต่าง ๆ ขั้นแรก การฝึกล่วงหน้าที่ได้รับการดูแลอย่างหลวม ๆ จะสร้างรากฐานกว้าง ๆ จากนั้นข้อมูลที่มีป้ายกำกับคุณภาพสูงจะทำให้โฟกัสได้มากขึ้น ในที่สุด การผสานโมเดลจะรวมจุดเช็คพอยต์เข้าด้วยกัน ซึ่งช่วยเพิ่มความแข็งแกร่ง เช่น ตัวนำซิมโฟนีเครื่องมือที่สอดประสานกัน
ศาสตร์ของการฝึก: ซิมโฟนีหลายขั้นตอน
1. การฝึกล่วงหน้าที่ได้รับการดูแลอย่างหลวม ๆ:
ในที่นี้ Qwen3 เรียนรู้จังหวะของโดเมน ด้วยการสร้างข้อมูลสังเคราะห์ เช่น การสร้างคิวรีสำหรับการสมัครขอสินเชื่อหรือการเลียนแบบศัพท์แสงทางกฎหมาย ก็จะสร้างโครงสร้างความเข้าใจ แม้กระทั่งในสถานการณ์ที่มีทรัพยากรต่ำ
2. การปรับแต่งอย่างละเอียดที่ได้รับการดูแล:
โมเดลนี้จะฝึกฝนความเชี่ยวชาญด้วยข้อมูลที่คัดสรรแล้ว ธนาคารอาจฝึกเอกสารทางการเงิน 12 ล้านฉบับ โดยสอนให้สังเกตสัญญาณเตือนในการสมัครขอสินเชื่อด้วยความแม่นยำอย่างยิ่งยวด
3. การผสานรวมโมเดล:
การเคลื่อนที่แบบเส้นโค้งระหว่างเวกเตอร์บนทรงกลม (SLERP) ผสานจุดเช็คพอยต์ โดยสร้างสมดุลระหว่างการทำให้เป็นลักษณะทั่วไปและเฉพาะทาง เช่นเดียวกันกับการผสมสีบนจานสี ผลลัพธ์? โมเดลที่เติบโตได้ทั้งความกว้างและความลึก
ความสมจริงของทรัพยากร: ขับเคลื่อนการเปลี่ยนแปลง
การปรับแต่ง Qwen3-Embedding-8B อย่างละเอียดไม่ได้มีไว้สำหรับคนใจไม่กล้า ต้องใช้ NVIDIA A100 GPU จำนวน 8 ตัวและเวลาฝึก 3-5 วัน อย่างไรก็ตาม ผลลัพธ์ที่ได้นั้นถือว่ามากมายมหาศาล: ความแม่นยำในการดึงข้อมูลจะก้าวกระโดดจาก 72% ไปเป็น 89% และความครอบคลุมโดเมนก็พุ่งสูงขึ้นถึง 93% โมเดลที่เล็กกว่า เช่น Qwen3-Reranker-0.6B ให้ความคล่องตัวในการให้คะแนนในแบบเรียลไทม์เพื่อพิสูจน์ว่าประสิทธิภาพนั้นไม่ได้เกี่ยวกับขนาดเสมอไป
| จำนวนพารามิเตอร์โมเดล | ทรัพยากรการฝึกพารามิเตอร์เต็มรูปแบบ | ทรัพยากรการอนุมานขั้นต่ำ | ความเท่าเทียมของโมเดลสำหรับการฝึกอบรมที่ใช้เมกะทรอน |
|---|---|---|---|
| 7 พันล้าน | gu7xf GPU จำนวน 8 ตัวหรือ gu7ef GPU จำนวน 8 ตัว | NVIDIA V100 GPU จำนวนหนึ่งตัง (หน่วยความจำ 32 GB) หรือ NVIDIA A10 GPU จำนวนหนึ่งตัว (หน่วยความจำ 24 GB) | TP1 และ PP1 |
| 14 พันล้าน | gu7xf GPU จำนวน 8 ตัวหรือ gu7ef GPU จำนวน 8 ตัว | NVIDIA V100 GPU จำนวนสองตัง (หน่วยความจำ 32 GB) หรือ NVIDIA A10 GPU จำนวนสองตัว (หน่วยความจำ 24 GB) | TP2 และ PP1 |
| 72 พันล้าน | เซิร์ฟเวอร์สี่ตัว โดยแต่ละตัวมี gu7xf GPU จำนวนแปดตัวหรือ gu7ef GPU จำนวนแปดตัว | NVIDIA V100 GPU จำนวนหกตัง (หน่วยความจำ 32 GB) หรือ gu7xf GPU จำนวนสองตัว | TP8 และ PP2 |
2.2. กรณีการใช้งานในอุตสาหกรรม: การเปลี่ยนแปลง AI ในทุกกลุ่มเฉพาะด้าน
1. การดูแลสุขภาพ: การเร่งการวิจัยทางการแพทย์
- ความท้าทาย: นักวิจัยต้องพยายามอย่างมากในการค้นหาการทดลองทางคลินิกสำหรับโรคหายาก เช่น โรคซิสติกไฟโบรซิส
-
โซลูชัน:
- ดัชนีสรุปย่อ PubMed และเปเปอร์ arXiv โดยใช้ Qwen3-Embedding
- ปรับใช้ Qwen3-Reranker เพื่อจัดลำดับความสำคัญของการทดลองที่ตรงกับจีโนไทป์ของผู้ป่วย
2. กฎหมาย: การปฏิวัติการวิเคราะห์สัญญา
- ความท้าทาย: บริษัทกฎหมายจำเป็นต้องระบุข้อกฎหมายต่าง ๆ เช่น "สัญญาห้ามทำงานกับคู่แข่ง" ในสัญญา
-
โซลูชัน:
- ปรับแต่ง Qwen3 อย่างละเอียดในองค์กรทางกฎหมาย (เช่น การยื่น SEC, คำวินิจฉัยของศาล)
- ใช้ตัวจัดอันดับใหม่เพื่อเน้นข้อกฎหมายที่เกี่ยวข้องกับการควบรวมและการซื้อกิจการ
3. อีคอมเมิร์ซ: การค้นหาผลิตภัณฑ์ที่มีความเป็นส่วนตัวสูง
- ความท้าทาย: ผู้ใช้ที่กำลังค้นหา "หูฟังบลูทูธไร้สาย" ได้รับผลลัพธ์ที่ไม่เกี่ยวข้อง
-
โซลูชัน:
- ฝึก Qwen3-Embedding เกี่ยวกับแคตตาล็อกผลิตภัณฑ์และรีวิวของลูกค้า
- ใช้ตัวจัดอันดับใหม่เพื่อเพิ่มรายการด้วยฟีเจอร์การจับคู่ (เช่น การตัดเสียงรบกวน)
4. การเงิน: การประเมินความเสี่ยงที่แม่นยำ
- ความท้าทาย: ธนาคารต้องระบุการสมัครขอสินเชื่อที่มีความเสี่ยงสูงซึ่งมีสัญญาณเตือน (เช่น ประวัติการผิดชำระ)
-
โซลูชัน:
- ปรับใช้ Qwen3-Embedding เพื่อแปลงแอปพลิเคชันให้เป็นข้อมูลเวกเตอร์
- ใช้ Qwen3-Reranker เพื่อให้คะแนนปัจจัยความเสี่ยงกับแนวทางการกำกับดูแล
5. เคมี: การค้นพบยารุ่นใหม่
- ความท้าทาย: นักวิทยาศาสตร์ต้องหาโมเลกุลที่คล้ายกับสารประกอบเป้าหมาย
-
โซลูชัน:
- ฝึก Qwen3 เกี่ยวกับสิทธิบัตรทางเคมีและข้อมูล PubChem
- ฝังโครงสร้างโมเลกุล (เช่น สตริง SMILES) สำหรับการค้นหาความคล้ายคลึงกัน
2.3. พร้อมที่จะสร้าง AI เฉพาะโดเมนของคุณหรือยัง
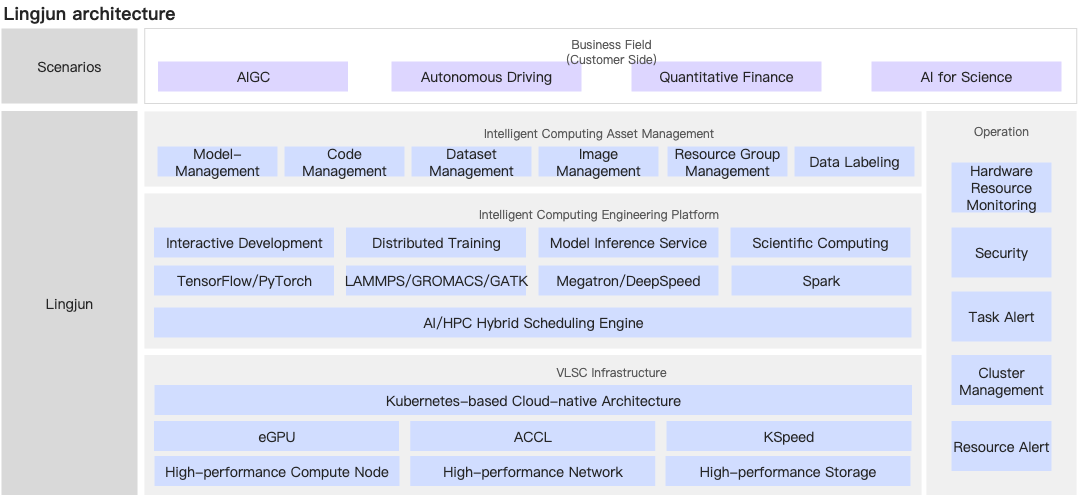
ด้วย Pai-Lingjun และ Qwen3 พลังในการเปลี่ยนอุตสาหกรรมที่ปลายนิ้วของคุณ ไม่ว่าคุณจะปรับโมเดลความเสี่ยงด้านการเงินให้เหมาะสมที่สุดหรือเร่งความก้าวหน้าทางการแพทย์ ความสามารถในการฝังและการจัดอันดับใหม่ของ Qwen3 จะให้ความแม่นยำที่ไม่มีใครเทียบได้ มากำหนดสิ่งที่เป็นไปได้ใหม่อีกครั้งร่วมกัน
มีคำถามใช่ไหม ติดต่อทีมของเราเพื่อสำรวจ PAI-Lingjun เพื่อเริ่มการทดลองใช้งานฟรีของคุณในวันนี้!
สรุป: โดเมนของคุณ ความเชี่ยวชาญของเรา
การปรับแต่ง Qwen3 อย่างละเอียดไม่ได้เป็นเพียงกระบวนการทางเทคนิคเท่านั้น แต่เป็นการก้าวกระโดดเชิงกลยุทธ์ ไม่ว่าคุณกำลังปฏิวัติวงการทางการเงิน การดูแลสุขภาพ หรือวัสดุศาสตร์, PAI-Lingjun พร้อมช่วยให้คุณปลดล็อก AI อย่างเต็มศักยภาพ
ส่วนที่ 3: กลยุทธ์การปรับใช้ขั้นสูงและเทคนิคการปรับให้เหมาะสม
3.1. ทิศทางในอนาคตสำหรับโมเดลการฝัง Qwen3
ซีรีส์การฝัง Qwen3 แสดงถึงการก้าวกระโดดอย่างมากในการเรียนรู้การแสดงข้อความ อย่างไรก็ตาม ความก้าวหน้าอย่างต่อเนื่องในโมเดลภาษาขนาดใหญ่ (LLM) เปิดพรมแดนใหม่ ด้านล่างเป็นส่วนสำคัญของการมุ่งเน้นสำหรับการพัฒนาในอนาคต โดยเน้นการฝังโดยคำนึงถึงความเข้าใจในคำสั่งและ MRL (การเรียนรู้ตัวแทน Matryoshka):
1. การฝังโดยคำนึงถึงความเข้าใจในคำสั่ง
โมเดลดั้งเดิมจำเป็นต้องมีการฝึกใหม่เพื่อปรับให้เข้ากับงานใหม่ แต่สถาปัตยกรรมที่คำนึงถึงคำสั่งของ Qwen3 ช่วยให้สามารถปรับใช้ได้แบบไดนามิกผ่านพรอมต์เฉพาะงาน นี่จะช่วยลดความจำเป็นในการปรับแต่งอย่างละเอียดเฉพาะโดเมน ลดค่าใช้จ่ายและความซับซ้อน
แนวคิดหลัก:
- การออกแบบโดยคำนึงถึงความเข้าใจในคำสั่ง:
โมเดลการฝัง Qwen3 จะยอมรับคำสั่งที่ชัดเจนเป็นข้อมูลอินพุต ช่วยแนะนำโมเดลเพื่อสร้างการฝังที่ปรับแต่งให้เหมาะกับงานที่เฉพาะเจาะจง ตัวอย่างเช่น:
def get_detailed_instruct(task_description: str, query: str) -> str:
    return f'Instruct: {task_description}\nQuery: {query}'

# ตัวอย่าง: ทำเครื่องหมายการสมัครขอสินเชื่อที่มีปัจจัยเสี่ยงทางภูมิรัฐศาสตร์
task = "ระบุการสมัครขอสินเชื่อที่มีปัจจัยเสี่ยงทางภูมิรัฐศาสตร์"
query = "การสมัครขอสินเชื่อสำหรับบริษัทเทคโนโลยีในภูมิภาคเอเชียตะวันออกเฉียงใต้"
input_text = get_detailed_instruct(task, query)
วิธีนี้จะฝังคำสั่งลงในบริบทข้อมูลอินพุตเพื่อให้แน่ใจว่าโมเดลจะเน้นไปที่ความแตกต่างในรายละเอียดเฉพาะโดเมน (เช่น "ความเสี่ยงทางภูมิรัฐศาสตร์") โดยไม่ต้องมีการฝึกใหม่
- การปรับใช้ในไม่กี่ตัวอย่าง:
ด้วยการผนวกคำสั่งเฉพาะงานลงในคิวรี Qwen3 สามารถปรับให้เข้ากับโดเมนใหม่ด้วยข้อมูลที่มีป้ายกำกับในจำนวนที่น้อยที่สุดได้ ตัวอย่างเช่น ตัวจัดอันดับเคมีใหม่สามารถจัดลำดับความสำคัญของโมเลกุลที่เกี่ยวข้องกับเป้าหมายของยาที่เฉพาะเจาะจงโดยรวมถึงคำสั่ง เช่น:
task = "ค้นหาโมเลกุลที่คล้ายกับแอสไพรินเพื่อใช้ต้านการอักเสบ"
query = "C1CC(=O)NC(=O)C1"  # สตริง SMILES ของ Aspirin
2. MRL (การเรียนรู้ตัวแทน Matryoshka)
MRL ช่วยให้สามารถปรับขนาดการฝังแบบไดนามิกระหว่างการอนุมานได้ ซึ่งให้ความยืดหยุ่นโดยไม่ต้องมีการฝึกใหม่ นวัตกรรมนี้ช่วยให้โมเดลเดียวสามารถให้บริการได้หลายสถานการณ์ (เช่น อุปกรณ์ที่มีน้ำหนักเบากับเซิร์ฟเวอร์ที่มีความแม่นยำสูง)
วิธีการทำงานของ MRL:
- ขนาดเอาต์พุตตัวแปร:
โมเดลการฝัง Qwen3 จะสร้างการฝังด้วยขนาดที่สามารถปรับแต่งได้ (เช่น 1024D 2560D หรือ 4096D)
- การปรับแบบไดนามิก:
ระหว่างการอนุมาน คุณสามารถระบุขนาดที่ต้องการผ่านพารามิเตอร์ output_dimension:
# สร้างเวกเตอร์ 2560D สำหรับการวิเคราะห์ความเสี่ยงทางการเงิน
embeddings = model.encode(queries, output_dimension=2560)
ข้อดีของ MRL:
- ประสิทธิภาพของทรัพยากร: การฝังที่มีขนาดเล็กกว่า (เช่น 1024D) สำหรับอุปกรณ์ปลายทางและขนาดที่ใหญ่กว่า (เช่น 4096D) สำหรับการใช้ระดับเซิร์ฟเวอร์
- ความสามารถในการปรับขนาด: สามารถนำโมเดลเดียวมาปรับใช้ในกรณีการใช้งานที่หลากหลาย (เช่น การค้นหาเชิงอรรถศาสตร์และความคล้ายคลึงกันในระดับโมเลกุล)
- การพร้อมรับอนาคต: การปรับให้เข้ากับข้อกำหนดที่พัฒนาได้ง่าย ๆ (เช่น การเพิ่มขนาดตามที่ฮาร์ดแวร์ที่ดีขึ้น)
ตัวอย่าง: MRL ในการดูแลสุขภาพ
นักวิจัยด้านยาสามารถสร้างการฝัง 4096D สำหรับการคัดกรองโมเลกุลที่แม่นยำแต่เปลี่ยนเป็น 1024D สำหรับการคลัสเตอร์ระเบียนผู้ป่วยแบบเรียลไทม์:
# การฝังโมเลกุลที่มีความแม่นยำสูง
molecule_embedding = model.encode("C1CC(=O)NC(=O)C1", output_dimension=4096)

# การคลัสเตอร์ระเบียนผู้ป่วยที่ไม่กินพื้นที่มาก
patient_notes_embedding = model.encode("Patient presents with chest pain", output_dimension=1024)
3.2. เทคนิคการปรับให้เหมาะสมสำหรับงานเฉพาะอุตสาหกรรม
1. การประเมินความเสี่ยงทางการเงิน
• ความท้าทาย: การจัดลำดับความสำคัญของการสมัครขอสินเชื่อที่มีสัญญาณเตือน (เช่น ประวัติการผิดชำระ)
• โซลูชัน:
- การฝังโดยคำนึงถึงความเข้าใจในคำสั่ง: ผนวกคำสั่งเฉพาะงานเข้ากับคิวรี
task = "ระบุสินเชื่อที่มีความเสี่ยงในการผิดนัดชำระ"
query = "การสมัครขอสินเชื่อเพื่อธุรกิจสตาร์ทอัพด้านเทคโนโลยีในอินเดีย"
input_text = get_detailed_instruct(task, query) - MRL สำหรับความสามารถในการขยายขนาด: ใช้การฝัง 1024D สำหรับการให้คะแนนแบบเรียลไทม์และ 2560D สำหรับการวิเคราะห์เชิงลึก
• ตัวชี้วัดประสิทธิภาพ:
| ตัวชี้วัด | เบสไลน์ | หลังการเพิ่มประสิทธิภาพ |
|---|---|---|
| ความแม่นยำในการดึงข้อมูล | 72% | 89% |
| ความแม่นยำในการจัดอันดับใหม่@10 | 65% | 84% |
2. การคลัสเตอร์เอกสารด้านการดูแลสุขภาพ
- ความท้าทาย: การจัดกลุ่มบันทึกทางคลินิกเป็นหมวดหมู่ (เช่น การวินิจฉัย แผนการรักษา)
-
โซลูชัน:
- การฝังโดยคำนึงถึงความเข้าใจในคำสั่ง: ใช้คำสั่ง เช่น "คลัสเตอร์ระเบียนผู้ป่วยตามความรุนแรงของโรค"
- MRL สำหรับขนาด: สร้างการฝัง 256D สำหรับการคลัสเตอร์และ 4096D อย่างรวดเร็วเพื่อการวิเคราะห์อย่างละเอียด
- โค้ดสำเร็จรูป:
# สร้างการฝังบันทึกทางคลินิก
embeddings = model.encode(clinical_notes, output_dimension=256)

# คลัสเตอร์บันทึกด้วย HDBSCAN
clusterer = HDBSCAN(min_cluster_size=50)
labels = clusterer.fit_predict(embeddings)
3. การดึงข้อมูลโค้ดในวิศวกรรมซอฟต์แวร์
- ความท้าทาย: การค้นหาที่เก็บ GitHub โดยใช้อัลกอริทึมเฉพาะ (เช่น เส้นทางที่สั้นที่สุดของ Dijkstra)
-
โซลูชัน:
- การฝังโดยคำนึงถึงความเข้าใจในคำสั่ง: ประกอบด้วยคำสั่ง เช่น "จัดลำดับความสำคัญการใช้งาน Python ของอัลกอริทึมของ Dijkstra"
- MRL เพื่อประสิทธิภาพ: ใช้การฝัง 1024D เพื่อการค้นหาและ 4096D อย่างรวดเร็วเพื่อความแม่นยำ
- ผลลัพธ์เกณฑ์มาตรฐาน:
| โมเดล | คะแนน MTEB-Code | เวลาแฝงของคิวรี (มิลลิวินาที) |
|---|---|---|
| Qwen3-Embedding-8B | 80.68 | 150 |
| Qwen3-Embedding-8B (MRL) | 85.21 (4096D) | 160 (ความแม่นยำสูงกว่า) |
ทำไมความเข้าใจในคำสั่งและ MRL มีประสิทธิภาพสูงกว่าการปรับแต่งอย่างละเอียด
1. การฝังโดยคำนึงถึงความเข้าใจในคำสั่ง: การปรับใช้แบบไดนามิกโดยไม่ต้องมีการฝึกใหม่
- ปัญหา: การปรับแต่งอย่างละเอียดแบบดั้งเดิมต้องมีการฝึกใหม่สำหรับแต่ละโดเมน ซึ่งใช้เวลานานและใช้ทรัพยากรมาก
-
โซลูชัน: การออกแบบโดยคำนึงถึงความเข้าใจในคำสั่งของ Qwen3 ช่วยให้นักพัฒนาสามารถกำหนดคำแนะนำเฉพาะงานได้ในเวลาที่อนุมาน
- กฎหมาย: "เน้นข้อกฎหมายที่เกี่ยวข้องกับสัญญาห้ามทำงานกับคู่แข่ง"
- อีคอมเมิร์ซ: "บูสต์สินค้าที่มีคุณสมบัติการตัดเสียงรบกวน"
-
ข้อดี:
- การปรับใช้โดยไม่จำเป็นต้องมีตัวอย่าง: ไม่จำเป็นต้องมีข้อมูลการฝึกเฉพาะโดเมน
- ประหยัดค่าใช้จ่าย: หลีกเลี่ยงค่าใช้จ่ายของโมเดลการฝึกใหม่สำหรับทุกกรณีการใช้งาน
2. MRL: ขนาดที่ยืดหยุ่นสำหรับทุกสถานการณ์
- ปัญหา: การฝังที่มีขนาดตายตัว (เช่น 768D) บังคับให้ต้องแลกความแม่นยำและประสิทธิภาพ
-
โซลูชัน: MRL อนุญาตให้มีการปรับขนาดแบบไดนามิก
- อุปกรณ์ปลายทาง: ใช้การฝัง1024D สำหรับการอนุมานหน่วยความจำที่รวดเร็วและต่ำ
- งานความแม่นยำสูง: เปลี่ยนเป็น4096D สำหรับงานที่ซับซ้อน เช่น การค้นพบยา
-
ข้อดี:
- โมเดลเดียว หลายกรณีการใช้งาน: ขจัดความจำเป็นในการใช้หลายโมเดล
- การพร้อมรับอนาคต: ปรับขนาดตามฮาร์ดแวร์ที่พัฒนาไปโดยไม่ต้องฝึกใหม่
สรุป: ความเข้าใจในคำสั่งและ MRL — กระบวนทัศน์ใหม่
โมเดลการฝัง Qwen3 กำหนดความยืดหยุ่นใหม่โดยการรวมการฝังที่คำนึงถึงความเข้าใจในคำสั่งและการรองรับ MRL ไม่จำเป็นต้องปรับแต่งอย่างละเอียดเฉพาะโดเมน
- การฝังโดยคำนึงถึงความเข้าใจในคำสั่งช่วยให้นักพัฒนาสามารถปรับแต่งพฤติกรรมของโมเดลได้ผ่านพรอมต์เฉพาะงานซึ่งจะช่วยลดการพึ่งพาการฝึกใหม่
- การรองรับ MRL สามารถปรับขนาดได้แบบไดนามิก ทำให้มั่นใจได้ถึงประสิทธิภาพที่ดีที่สุดระหว่างการปรับใช้อุปกรณ์ปลายทางและระบบคลาวด์
โดยใช้ประโยชน์จากนวัตกรรมเหล่านี้ องค์กรสามารถ:
- ลดค่าใช้จ่าย: หลีกเลี่ยงรอบการปรับแต่งที่มีราคาแพง
- เร่งการปรับใช้: ปรับโมเดลให้เข้ากับโดเมนใหม่ในไม่กี่นาที ไม่ใช่เดือน
- ระบบพร้อมรับอนาคต: ปรับขนาดตามฮาร์ดแวร์ที่ปรับปรุงดีขึ้น
แหล่งอ้างอิง:
- รายงานทางเทคนิคของการฝัง Qwen3 (arXiv:2506.05176)
- เกณฑ์มาตรฐาน MTEB (Enevoldsen et al., 2025)
ที่เก็บโค้ด:
ติดต่อ: หากต้องการทำงานร่วมกันหรือสอบถาม โปรดติดต่อ Alibaba Cloud
สรุปสุดท้าย: เปิดเผยรหัสพันธุกรรมแห่งความหมาย
เป็นครั้งแรกในประวัติศาสตร์ที่เครื่องจักรสามารถถอดรหัสความสัมพันธ์ทางพันธุกรรมระหว่างบทกวีภาษาสันสกฤต ฟังก์ชัน Python และการวินิจฉัยทางการแพทย์ ความก้าวหน้าที่ทำให้ทุกคนสามารถเข้าถึงได้ผ่านนวัตกรรมโอเพนซอร์ส เช่นเดียวกับ การหาลำดับ DNA ที่ปฏิวัติวงการชีววิทยาโดยการเปิดเผยรหัสพันธุกรรมสากลของสิ่งมีชีวิต การฝัง Qwen3 เปลี่ยนโฉม AI โดยการทำแผนที่โครงสร้างโมเลกุลของความหมายในตัวเอง เทคโนโลยีนี้ก้าวข้ามภาษา วัฒนธรรม และระเบียบแบบแผน เผยให้เห็นถึงความเชื่อมโยงที่ซ่อนอยู่ซึ่งจะกำหนดวิธีการที่ระบบ AI ทำความเข้าใจและดึงข้อมูล
การเปลี่ยนกระบวนทัศน์ในการทำความเข้าใจ
การค้นหาด้วย AI แบบดั้งเดิมทำงานเหมือนหุ่นยนต์จับคู่คีย์เวิร์ด จำกัดการจับคู่ข้อความในระดับพื้นผิว อย่างไรก็ตาม การฝัง Qwen3 ทำหน้าที่เป็นเครื่องมือหาลำดับ DNA สำหรับภาษา โดยจับความสัมพันธ์เชิงอรรถศาสตร์ในเชิงลึกระหว่างแนวคิดในมากกว่า 250 ภาษาและกระบวนทัศน์การเขียนโปรแกรม ไม่ว่าจะเป็นการวิเคราะห์การวินิจฉัยทางการแพทย์ สัญญาทางกฎหมาย หรืออัลกอริทึมการคำนวณเชิงควอนตัม Qwen3 ถอดรหัสรหัสพันธุกรรมของความหมาย ทำให้เครื่องสามารถเข้าใจความแตกต่างในรายละเอียด บริบท และการเชื่อมโยงแบบสหวิทยาการ นี่ไม่ใช่แค่การปรับปรุงที่เพิ่มขึ้น แต่เป็นการเปลี่ยนกระบวนทัศน์
ความเชี่ยวชาญทางเทคนิคและกระบวนการประชาธิปไตยของโอเพนซอร์ส
ไปป์ไลน์การฝึกหลายขั้นตอนของการฝัง Qwen3 ผสมผสานการสร้างข้อมูลสังเคราะห์ การปรับแต่งอย่างละเอียดโดยมีการควบคุม และการผสานโมเดลเพื่อประสิทธิภาพที่ล้ำสมัย ด้วยคะแนนที่ 70.58 บน MTEB Multilingual และ 80.68 บน MTEB Code Qwen3 แซงหน้าบริษัทยักษ์ใหญ่ เช่น Gemini-Embedding ของ Google พิสูจน์ให้เห็นว่านวัตกรรมโอเพนซอร์สสามารถแซงหน้าระบบนิเวศแบบปิดได้ ด้วยการโอเพนซอร์สโมเดลภายใต้ใบอนุญาต Apache 2.0 Alibaba ช่วยให้สามารถเข้าถึง "รหัสพันธุกรรมของความหมาย" นี้ได้โดยช่วยให้นักพัฒนาทั่วโลกสามารถสร้างระบบที่ชาญฉลาดและใช้งานง่ายยิ่งขึ้นได้
เกินกว่าเกณฑ์มาตรฐาน: แรงกระเพื่อมในโลกแห่งความเป็นจริง
พลังที่แท้จริงของ Qwen3 ไม่ได้อยู่เพียงแค่ในรายละเอียดทางเทคนิคเท่านั้น แต่ยังรวมถึงความสามารถในการเชื่อมโยงโลกต่าง ๆ เข้าด้วยกัน:
- การดูแลสุขภาพ: การเร่งการค้นพบยาโดยเชื่อมโยงโครงสร้างโมเลกุลกับการทดลองทางคลินิก
- กฎหมาย: การวิเคราะห์ข้อกฎหมายอัตโนมัติในสัญญาหลายภาษา
- การเงิน: การระบุความเสี่ยงอย่างแม่นยำด้วยการแยกวิเคราะห์ข้อความกำกับดูแลทั่วโลก
- การศึกษา: การเชื่อมโยงความรู้สหวิทยาการเพื่อการเรียนรู้ส่วนบุคคล
- เคมี: การปฏิวัติวัสดุศาสตร์โดยการทำแผนที่คุณสมบัติโมเลกุล
สิ่งเหล่านี้ไม่ใช่สถานการณ์สมมติ แต่เป็นความจริงที่กำหนดโดยการเข้าใจความหมายในระดับพันธุกรรมของ Qwen3
อนาคต: จากรหัสพันธุกรรมไปจนถึงวิวัฒนาการที่ชาญฉลาด
ในขณะที่ AI วิวัฒนาการไป การฝัง Qwen3 จะกำหนดขั้นตอนสำหรับระบบหลากหลายรูปแบบที่ไม่ได้ถอดรหัสเพียงแค่ข้อความ แต่ยังรวมถึงภาพ เสียง และวิดีโอผ่านเลนส์พันธุกรรมเดียวกัน ลองจินตนาการถึง AI ที่เข้าใจเอกสารชีวการแพทย์ สร้างภาพการตีความหมายออกมาในรูปแบบจำลองโปรตีน 3 มิติ และสร้างรหัสเพื่อจำลองพฤติกรรม ทั้งหมดนี้ เกิดขึ้นผ่านการฝังแบบรวมศูนย์ระหว่างรูปแบบต่าง ๆ
นอกจากนี้ ประสิทธิภาพของ Qwen3 นับตั้งแต่โมเดล 0.6B น้ำหนักเบาไปจนถึงตัวแปร 8B ประสิทธิภาพสูง ทำให้มั่นใจได้ว่าสามารถปรับใช้ได้ทั้งอุปกรณ์ปลายทางและการใช้ระดับคลาวด์ อนาคตเป็นของระบบที่เรียนรู้เหมือนสิ่งมีชีวิต พัฒนาผ่านการสัมผัสกับระบบนิเวศของข้อมูลที่หลากหลาย การฝัง Qwen3 ไม่ได้เป็นเพียงเครื่องมือ แต่ยังเป็นพิมพ์เขียวสำหรับวิวัฒนาการนี้ด้วย
เข้าร่วมการปฏิวัติวงการ
รหัสพันธุกรรมของความหมายตอนนี้อยู่ใกล้แค่เอื้อม สำรวจโมเดลการฝัง Qwen3 และการจัดอันดับใหม่บน Hugging Face และ ModelScope ปรับใช้ผลิตภัณฑ์เหล่านี้บนระบบนิเวศ PAI ของ Alibaba Cloud หรือปรับแต่งโดเมนเหล่านั้นให้เหมาะสมกับโดเมนเฉพาะกลุ่มของคุณ ไม่ว่าคุณจะเป็นนักวิจัย นักพัฒนา หรือองค์กร ยุคของการทำความเข้าใจกับพันธุกรรมด้วย AI ก็เริ่มต้นขึ้นแล้วในวันนี้
_ติดต่อ_: หากต้องการทำงานร่วมกันหรือสอบถาม โปรดติดต่อ Alibaba Cloud
บทความนี้แปลจากภาษาอังกฤษ ดูบทความต้นฉบับได้ที่นี่
Read previous post:
Read next post:
-

-
Regional Content Hub
144 posts | 4 followers
Follow
Comments
-
-
Regional Content Hub
144 posts | 4 followers
Follow
Related Products
-
 Qwen
Full-range, open-source, multimodal, and multi-functional
Learn More -
 Alibaba Cloud Model Studio
A one-stop generative AI platform to build intelligent applications that understand your business, based on Qwen model series such as Qwen-Max and other popular models
Learn More -
Token Plan
Build more, spend less. One plan, every modality.
Learn More -
 Platform For AI
A platform that provides enterprise-level data modeling services based on machine learning algorithms to quickly meet your needs for data-driven operations.
Learn More
More Posts by Regional Content Hub
- ให้พื้นที่ทำงานชั่วคราวกับ AI เอเจนต์ของคุณด้วย Alibaba Cloud AgentRun
- Alibaba Cloud AgentRun으로 AI 에이전트에 일회용 워크스페이스 제공
- Alibaba Cloud AgentRun で AI エージェントに使い捨てワークスペースを与える
- Beri Agen AI Anda Ruang Kerja Sekali Pakai dengan Alibaba Cloud AgentRun
- Cung cấp không gian làm việc dùng một lần cho tác nhân AI của bạn với Alibaba Cloud AgentRun
- DeepSeek V4-Flash dalam Skala Besar: Panduan Deployment Berbasis Benchmark
- 大規模な DeepSeek V4-Flash の活用:ベンチマーク主導のデプロイガイド
- 대규모 DeepSeek V4-Flash: 벤치마크 기반 배포 가이드
- Alibaba Cloud ECS 上で Telegram 連携機能付きの OpenClaw をデプロイする
- Alibaba Cloud ECS에 Telegram 통합 기능을 갖춘 OpenClaw 배포