จากการทดลองทุกความเป็นไปได้สู่ความประณีต: วิวัฒนาการและอนาคตของโครงสร้างพื้นฐานการฝึก AI
โดย Farruh Kushnazarov
โลกได้เฝ้าดูด้วยความตื่นตาตื่นใจในขณะที่ปัญญาประดิษฐ์วิวัฒนาการขึ้นจากการศึกษาเฉพาะกลุ่มไปสู่ขุมพลังแห่งการเปลี่ยนแปลงที่เปลี่ยนโฉมอุตสาหกรรมต่างๆ หัวใจสำคัญของการปฏิวัติในครั้งนี้คือโมเดลพื้นฐาน ซึ่งเป็นเครือข่ายประสาทขนาดมหึมาที่แสดงให้เห็นถึงขีดความสามารถอันน่าทึ่งในด้านภาษา การให้เหตุผล และความคิดสร้างสรรค์ อย่างไรก็ตาม เรื่องราวความสำเร็จเหล่านี้มีความเชื่อมโยงกับเรื่องราวของโครงสร้างพื้นฐานที่ขับเคลื่อนสิ่งเหล่านี้อย่างแยกไม่ออก นี่เป็นเรื่องราวของการเติบโตอย่างก้าวกระโดดไปสู่การเผชิญหน้ากับข้อจำกัดทางกายภาพ และนวัตกรรมที่เกิดขึ้นอย่างไม่หยุดยั้งที่มีความจำเป็นในการสร้างรากฐานในด้านระบบการคำนวณสำหรับความสามารถในการคิดและเรียนรู้เจเนอเรชันถัดไป
บทความนี้จะสำรวจประวัติความเป็นมาอันน่าทึ่งของการฝึก AI ผ่าปัญหาทางตันสำคัญที่มีโอกาสขัดขวางความก้าวหน้า และเจาะลึกอนาคตของโครงสร้างพื้นฐานที่ได้รับการออกแบบมาเพื่อเอาชนะความท้าทายอันยิ่งใหญ่เหล่านี้
ส่วนที่ 1: การเดินหน้าครั้งใหญ่อย่างไม่หยุดยั้ง: ประวัติความเป็นมาของการฝึก AI
เส้นทางการเกิดโมเดลพารามิเตอร์นับล้านล้านรายการในปัจจุบันไม่ได้เกิดขึ้นอย่างต่อเนื่องเสมอ แต่เป็นการหาจุดสมดุลที่เกิดขึ้นเป็นช่วงๆ โดยที่การค้นพบครั้งยิ่งใหญ่ในด้านแนวคิดเกิดขึ้นได้ด้วยขุมพลังระบบการคำนวณระดับใหม่ เป็นเวลาหลายทศวรรษที่ศักยภาพของเครือข่ายประสาทถูกจำกัดด้วยข้อมูลและความสามารถในการประมวลผลที่จำกัด ทั้งหมดนี้ล้วนเปลี่ยนไปในปี 2012
AlexNet ถึงเวลาเฉิดฉาย: ก่อกำเนิดการเรียนรู้เชิงลึก
ในปี 2012 ผู้คนต่างเห็นพ้องต้องกันว่า ImageNet Large Scale Visual Recognition Challenge (ILSVRC) เป็นการ "ก่อกำเนิด" ของยุคสมัยแห่ง AI เครือข่ายประสาทเทียมแบบคอนโวลูชัน (CNN) ในเชิงลึกที่มีชื่อว่า AlexNet ได้รับการพัฒนาโดย Alex Krizhevsky, Ilya Sutskever และ Geoffrey Hinton ประสบความสำเร็จเป็นอย่างมาก [1] นี่ไม่ใช่แค่ชัยชนะ แต่ยังทำลายสถิติด้วยอัตราความผิดพลาดที่ 15.3% ถือเป็นการก้าวกระโดดครั้งใหญ่จาก 26.2% ในการป้อนข้อมูลที่ดีที่สุดครั้งถัดไป
ความสำเร็จของ AlexNet ไม่ได้เกิดจากสถาปัตยกรรมที่ไม่เคยมีมาก่อนเท่านั้น สิ่งที่สำคัญอย่างยิ่งก็คือนี่ถือเป็นหนึ่งในโมเดลรุ่นแรกๆ ที่ได้รับการฝึกบนหน่วยประมวลผลกราฟิก (GPU) ด้วยการใช้ประโยชน์จากขุมพลังการประมวลผลคู่ขนานของ Nvidia GTX 580 GPU สองตัว นักวิจัยจึงสามารถฝึกโมเดลที่มีพารามิเตอร์ 60 ล้านตัวในชุดข้อมูลรูปภาพ 1.2 ล้านรายการ ซึ่งเป็นขนาดที่ก่อนหน้านี้ไม่สามารถคิดว่าจะทำได้ ช่วงเวลานี้พิสูจน์ให้เห็นว่าด้วยข้อมูลและการประมวลผลที่เพียงพอ ไม่เพียงแต่จะสามารถทำการเรียนรู้เชิงลึกได้เท่านั้น แต่ยังเหนือกว่าวิธีการแบบดั้งเดิม และก่อให้เกิดเหตุการณ์สำคัญในการวิจัย AI ด้วย
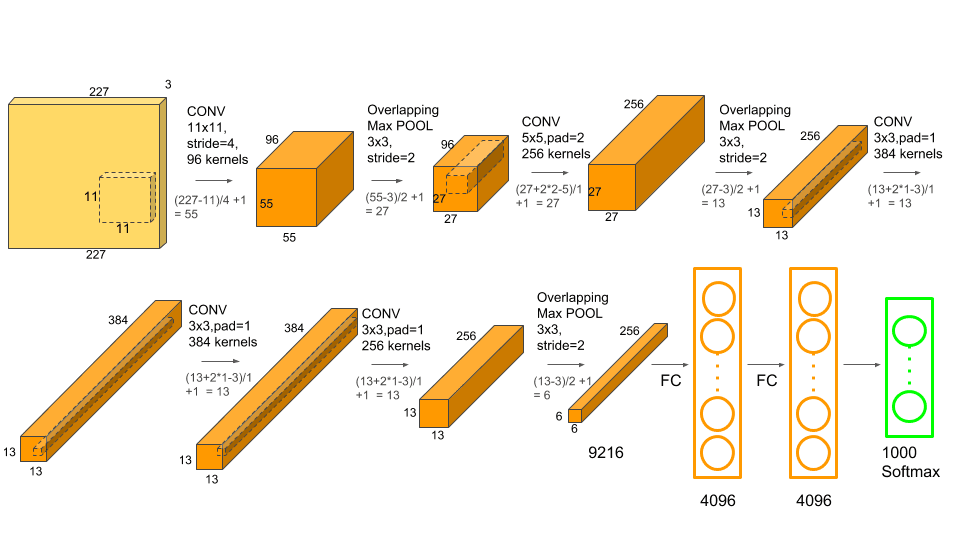
สถาปัตยกรรม AlexNet ซึ่งรวมเลเยอร์คอนโวลูชันเชิงลึกเข้ากับการประมวลผล GPU เพื่อให้ได้ประสิทธิภาพที่ก้าวล้ำ แหล่งที่มา: Krizhevsky et al., 2012.
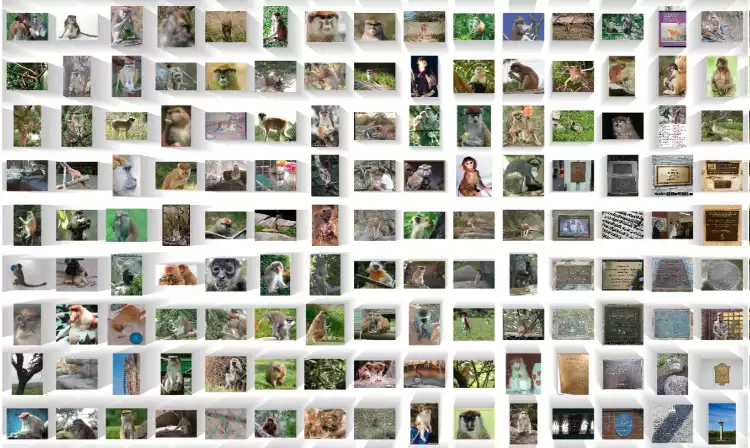
ตัวอย่างเล็กๆ ของรูปภาพที่มีป้ายกำกับนับล้านรูปภาพในชุดข้อมูล ImageNet ที่ขับเคลื่อนการปฏิวัติการเรียนรู้เชิงลึก แหล่งที่มา: ImageNet
การปฏิวัติตัวแปลง: สถาปัตยกรรมใหม่สำหรับการใช้ในวงกว้าง
ห้าปีต่อมา เกิดการเปลี่ยนแปลงที่เขย่าวงการขึ้นอีกครั้ง ในปี 2017 เอกสารจาก Google ที่มีชื่อว่า “Attention Is All You Need” ได้แนะนำการปฏิวัติตัวแปลง [2] การออกแบบใหม่นี้ละทิ้งโครงสร้างที่เกิดซ้ำๆ และซับซ้อนที่ใช้กันอย่างแพร่หลายในฟิลด์นี้ไปจนหมด โดยอาศัยกลไกที่เรียกว่า "การให้ความสนใจตัวเอง" แทน ซึ่งทำให้โมเดลสามารถชั่งน้ำหนักความสำคัญของคำต่างๆ ในลำดับอินพุตได้พร้อมกัน
นวัตกรรมที่สำคัญคือการประมวลผลคู่ขนาน ซึ่งแตกต่างจาก Recurrent Neural Networks (RNN) ที่ประมวลผลข้อมูลตามลำดับ ตัวแปลงสามารถประมวลผลทุกส่วนของอินพุตได้ในครั้งเดียว การเปลี่ยนแปลงทางสถาปัตยกรรมนี้เป็นการจับคู่ที่สมบูรณ์แบบสำหรับลักษณะคู่ขนานอย่างมากของ GPU ซึ่งปลดล็อคความสามารถในการฝึกโมเดลที่มีขนาดใหญ่มากขึ้นและซับซ้อนมากขึ้นด้วยความเร็วที่ไม่เคยมีมาก่อน ตัวแปลงกลายเป็นพิมพ์เขียวพื้นฐานสำหรับโมเดลภาษาขนาดใหญ่ (LLM) ที่ตามมาเกือบทั้งหมด รวมถึงซีรีย์ GPT
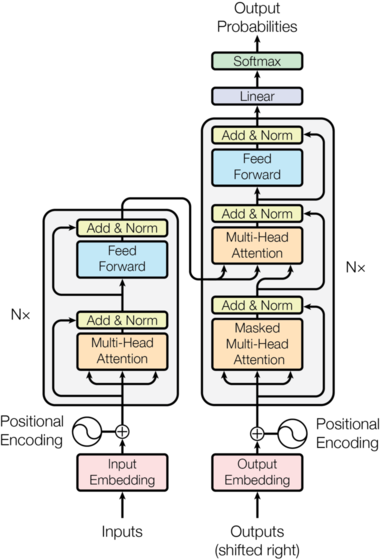
สถาปัตยกรรมหม้อแปลงเดิมที่แนะนำให้รู้จักในเอกสาร "Attention Is All You Need" แหล่งที่มา: Vaswani et al., 2017
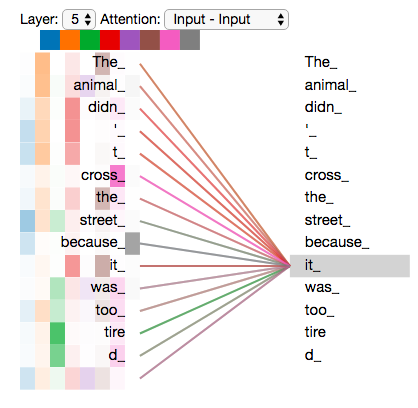
การแสดงภาพกลไกการให้ความสนใจตัวเองซึ่งช่วยให้โมเดลสามารถชั่งน้ำหนักความสำคัญของคำต่างๆ ในประโยคได้ แหล่งที่มา: Jay Alammar
ยุคโมเดลรากฐาน: การแข่งขันเชิงต่อสู้อย่างก้าวกระโดด
การนำตัวแปลงมาใช้กลายเป็นจุดเริ่มต้นการแข่งขันอาวุธเชิงระบบการคำนวณระดับโลก ขนาด ค่าใช้จ่าย และความซับซ้อนของโมเดล AI เริ่มเติบโตในอัตราก้าวกระโดด เทรนด์นี้ไม่ได้เป็นเพียงแค่บริษัทเดียวเท่านั้นแต่ด้วยการพัฒนาคู่ขนานทั่วโลก โดยที่มีซีรีย์ GPT ของ OpenAI เป็นตัวชูโรงที่โดดเด่นที่สุดในโลกตะวันตกและซีรีส์ Qwen (通义千问) ของ Alibaba ในโลกตะวันออก ทั้งสองได้ผลักดันขอบเขตในแง่ของขนาด แต่ด้วยปรัชญาที่แตกต่างกัน โดย GPT มุ่งเน้นไปที่ความสามารถที่ไม่เคยมีมาก่อน ส่วน Qwen เน้นแนวทางแบบโอเพนซอร์สและหลายภาษาที่แข็งแกร่ง
วิวัฒนาการสองทางนี้เน้นให้เห็นถึงแนวทางที่ทั่วโลกมุ่งไปสู่ AI ที่ทรงพลังและมีประสิทธิภาพมากขึ้น โดยที่การเปิดตัวโมเดลใหม่แต่ละรุ่นจะเป็นตัวกำหนดให้มาตรฐานสำหรับรุ่นถัดไปสูงยิ่งขึ้นไปอีก
| โมเดล | วันที่เผยแพร่ | พารามิเตอร์ | นวัตกรรมที่สำคัญ / จุดเน้น |
|---|---|---|---|
| GPT-1 | 2018 | 117 ล้าน | การฝึกล่วงหน้าโดยไม่มีการกำกับดูแล (OpenAI) |
| GPT-2 | 2019 | 1.5 พันล้าน | ความสามารถในการทำงานโดยไม่จำเป็นต้องให้ตัวอย่าง (OpenAI) |
| GPT-3 | 2020 | 175 พันล้าน | การเรียนรู้ในบริบทด้วยตัวอย่างจำนวนไม่มาก (OpenAI) |
| Qwen-7B | ส.ค. 2023 | 7 พันล้าน | ฐานหลายภาษาแบบโอเพนซอร์สที่แข็งแกร่ง (Alibaba) |
| GPT-4 | ก.ย. 2023 | ประมาณ 1.76 ล้านล้าน (MoE) | การให้เหตุผลขั้นสูง, สื่อหลากหลายรูปแบบ (OpenAI) |
| Qwen-72B | พ.ย. 2023 | 05-72 พันล้าน | ความยาวบริบท 32K, โอเพนซอร์ส (Alibaba) |
| Qwen2.5 | ก.ย. 2024 | สูงสุด 72 พันล้าน | ฝึกบนโทเค็น 18T, การเขียนโค้ด/คณิตศาสตร์ขั้นสูง (Alibaba) |
| Qwen3-Max | ก.ย. 2025 | ประมาณ 1 ล้านล้าน | โมเดลที่ใหญ่ที่สุดและมีความสามารถมากที่สุดของ Qwen (Alibaba) |
การเติบโตแบบก้าวกระโดดนี้ ซึ่งความต้องการการประมวลผลเพิ่มขึ้นเป็นสองเท่าทุกๆ ห้าถึงหกเดือน ได้ผลักดันการพัฒนา AI แนวหน้าให้กลายเป็นโดเมนที่เข้าถึงได้เฉพาะบริษัทขนาดยักษ์ใหญ่เพียงไม่กี่แห่งที่มีทุนในการสร้างและใช้งานซูเปอร์คอมพิวเตอร์ขนาดมหึมาเท่านั้น [5]
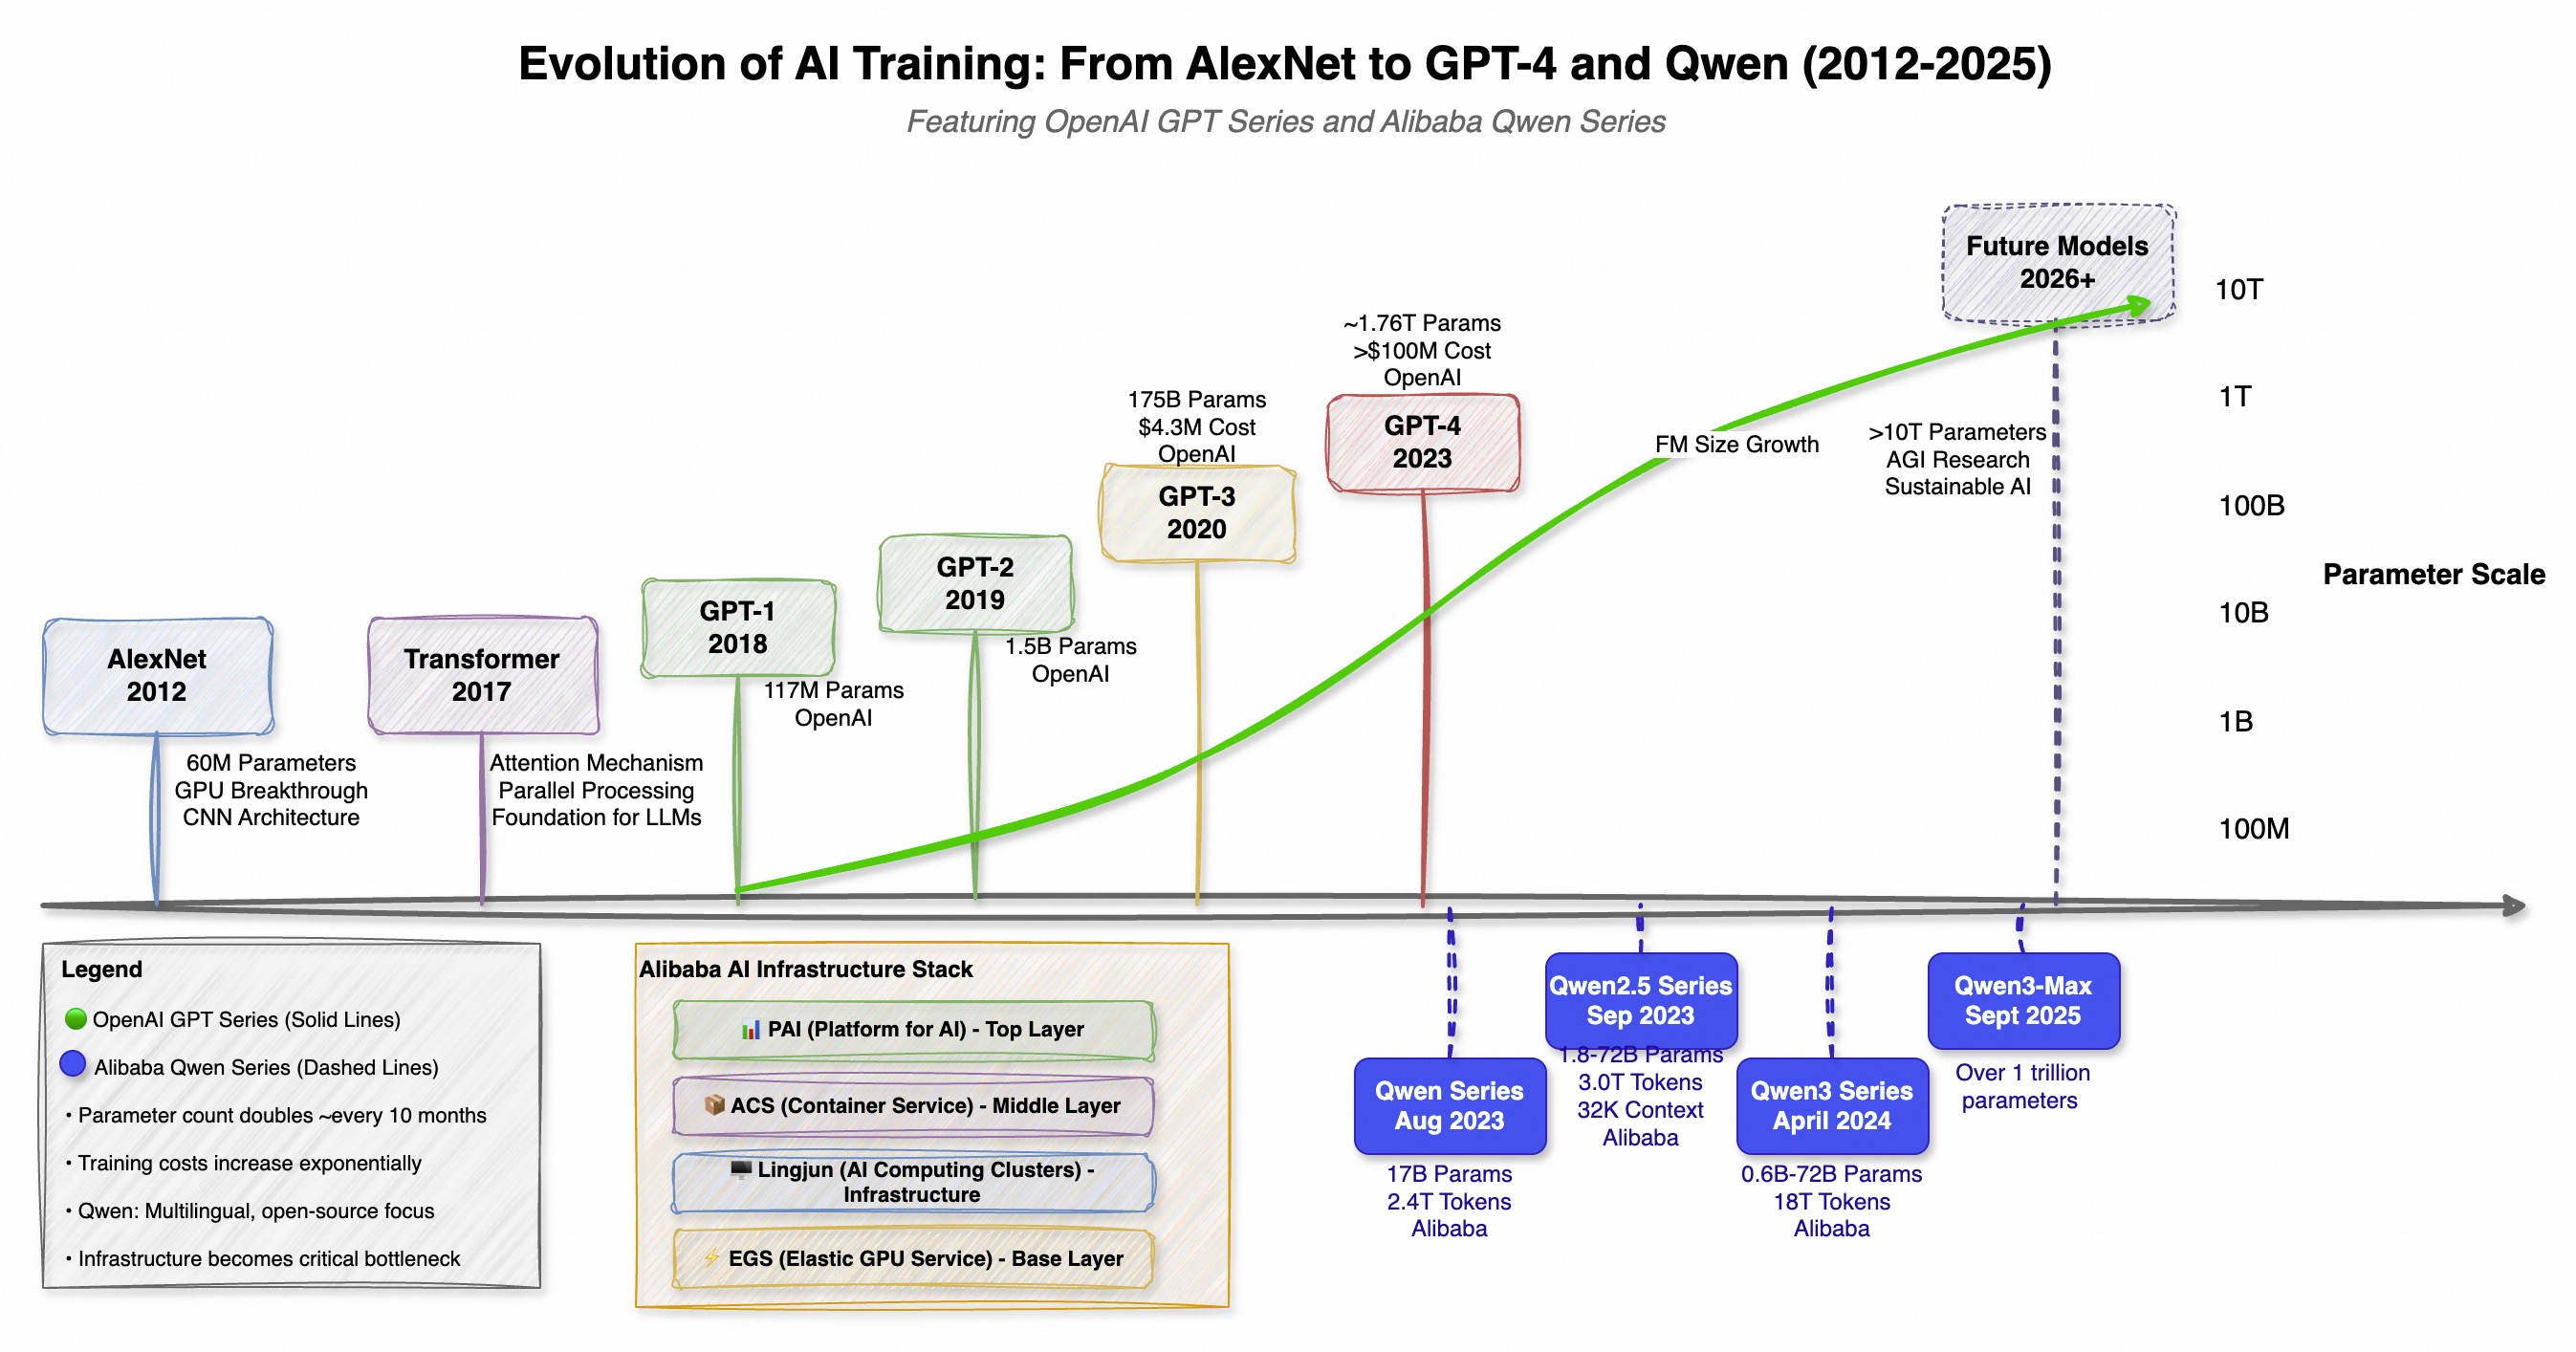
ไทม์ไลน์ที่แสดงให้เห็นวิวัฒนาการคู่ขนานของซีรีส์ GPT ของ OpenAI และซีรีส์ Qwen ของ Alibaba โดยเน้นที่การแข่งขันระดับโลกในการพัฒนาโมเดลพื้นฐาน
ส่วนที่ 2: จุดร้าวในรากฐาน: คอขวดของโครงสร้างพื้นฐาน AI สมัยใหม่
การแสวงหาขนาดอย่างไม่หยุดยั้งนี้ได้ผลักดันโครงสร้างพื้นฐานไปยังจุดขีดสุด การฝึกโมเดลพารามิเตอร์หนึ่งล้านล้านรายการไม่ใช่แค่เรื่องของการเพิ่ม GPU ให้มากขึ้น แต่มันเป็นความท้าทายทางวิศวกรรมที่ซับซ้อนซึ่งเต็มไปด้วยปัญหาคอขวดทางกายภาพและระบบ เป้าหมายหลักคือการทำให้โปรเซสเซอร์ราคาแพงทุกตัวถูกใช้งานอย่างเต็มที่ แต่ปัญหามากมายก็ยังคงขวางทางอยู่
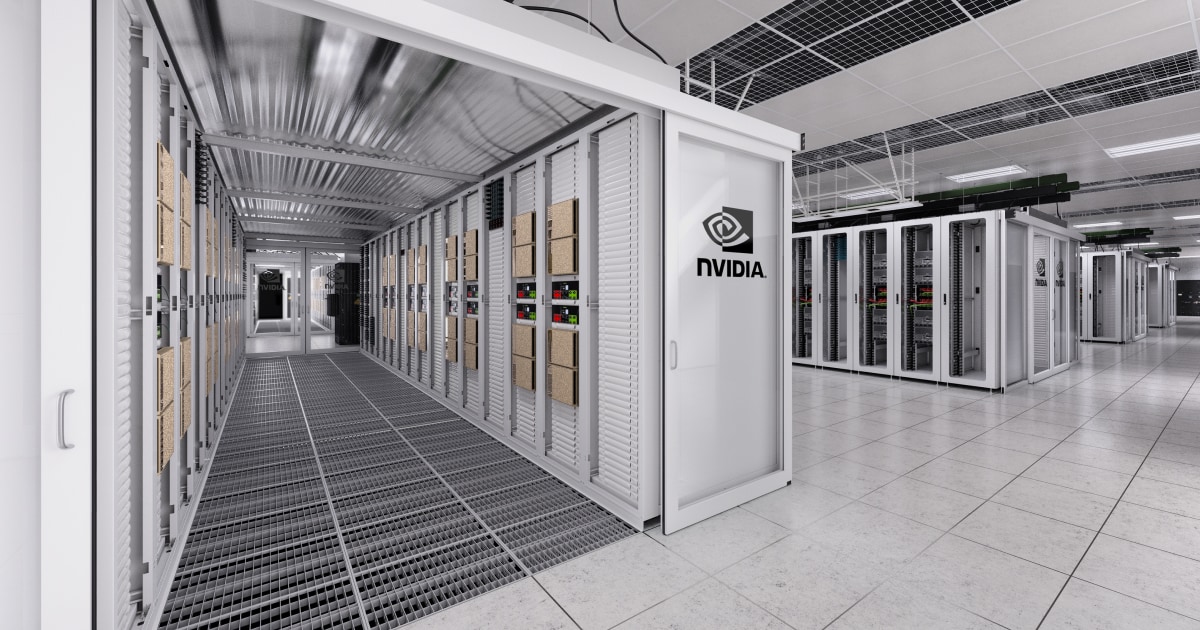
โรงงาน AI สมัยใหม่เป็นศูนย์ข้อมูลจำนวนมากที่มี GPU เชื่อมต่อกันหลายพันตัว แหล่งที่มา: NVIDIA
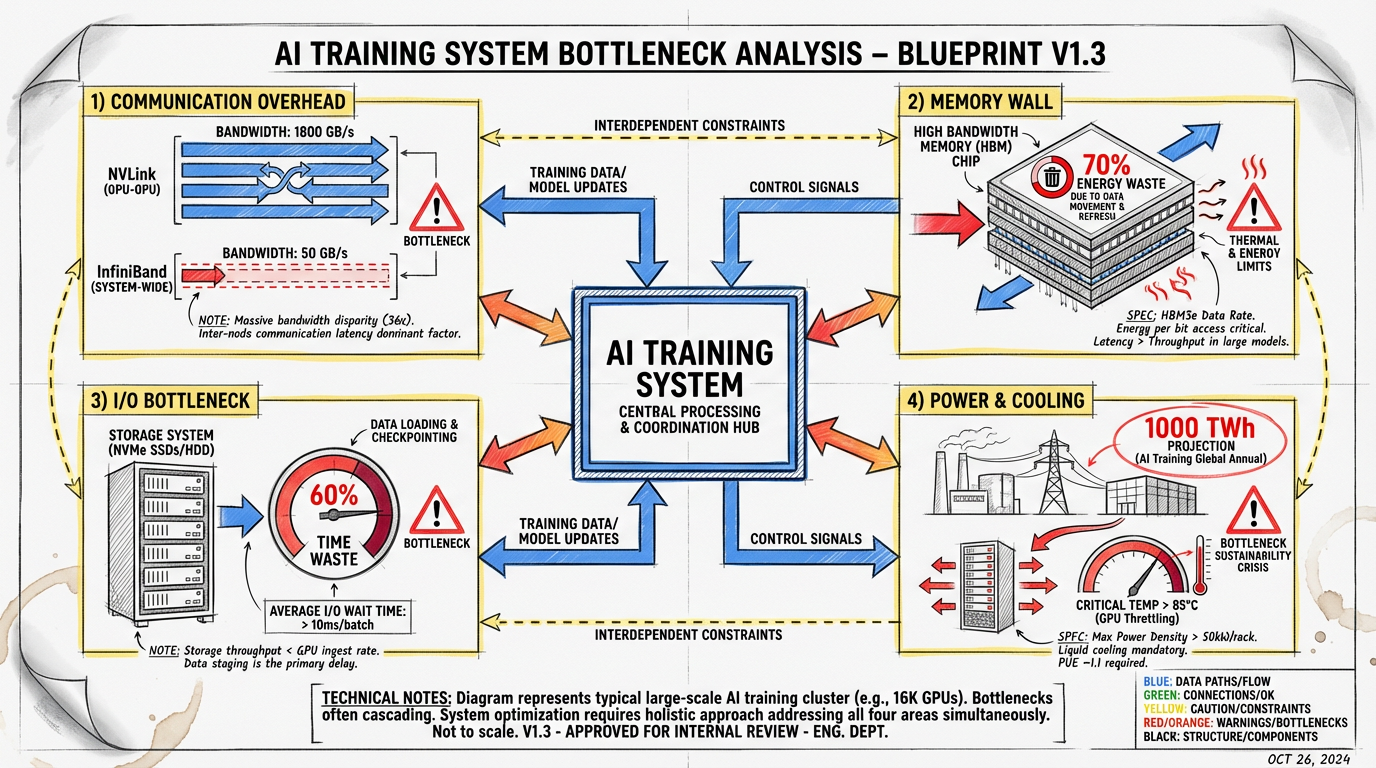
ค่าใช้จ่ายในการสื่อสาร
ในการฝึกแบบกระจายศูนย์ โมเดลจะถูกกระจายไปยัง GPU หลายพันตัว โดยแต่ละตัวจะทำงานบนชิ้นส่วนของปริศนาหนึ่งชิ้น ขั้นตอนที่สำคัญที่สุดและใช้เวลานานคือการซิงค์ไล่ระดับซึ่ง GPU ทั้งหมดต้องสื่อสารผลลัพธ์เพื่อตกลงกันในการปรับข้อมูลน้ำหนักของโมเดลครั้งต่อไป สิ่งนี้สร้างคอขวดการสื่อสารจำนวนมาก
- การสื่อสารภายในโหนด: ภายในเซิร์ฟเวอร์เดียว GPU จะเชื่อมต่อกันด้วยการเชื่อมต่อระหว่างกันความเร็วสูงเช่น NVLink ของ NVIDIA ซึ่งสามารถให้แบนด์วิดท์ได้ถึง 1,800 กิกะไบต์/วินาที [6] สิ่งนี้ช่วยให้การสื่อสารที่มีประสิทธิภาพระหว่าง GPU กลุ่มเล็กๆ (โดยทั่วไปอยู่ที่ 8 หรือ 16 ตัว)
- การสื่อสารระหว่างโหนด: ความท้าทายที่แท้จริงเกิดขึ้นเมื่อขยายขนาดไปใช้ GPU นับพันตัวในหลายเซิร์ฟเวอร์ โหนดเหล่านี้สื่อสารผ่านโครงสร้างเครือข่าย ซึ่งโดยทั่วไปจะใช้ InfiniBand หรืออีเธอร์เน็ตความเร็วสูง แม้ว่าจะมีความเร็ว 400Gbps แต่การสื่อสารนี้ก้เป็นนี้คำสั่งที่ช้ากว่าการสื่อสารภายในชิปและกลายเป็นปัจจัยจำกัดสำคัญ การออกแบบเครือข่ายแบบดั้งเดิมยังสามารถประสบกับปัญหา “การกระจายตัวของข้อมูลที่ไม่เสมอกัน” ซึ่งนำไปสู่การรับส่งข้อมูลล้นเกินที่ทำให้ประสิทธิภาพการทำงานแย่ลง [7]
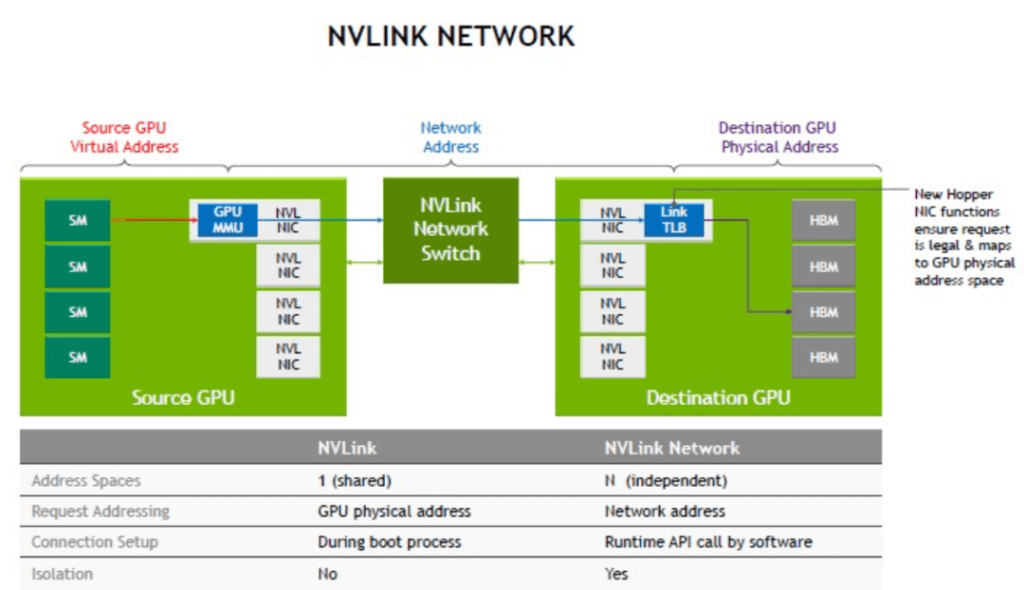
ไดอะแกรมเทคโนโลยี NVLink ของ NVIDIA ซึ่งให้การสื่อสารทางตรงความเร็วสูงระหว่าง GPU ภายในเซิร์ฟเวอร์ แหล่งที่มา: NVIDIA
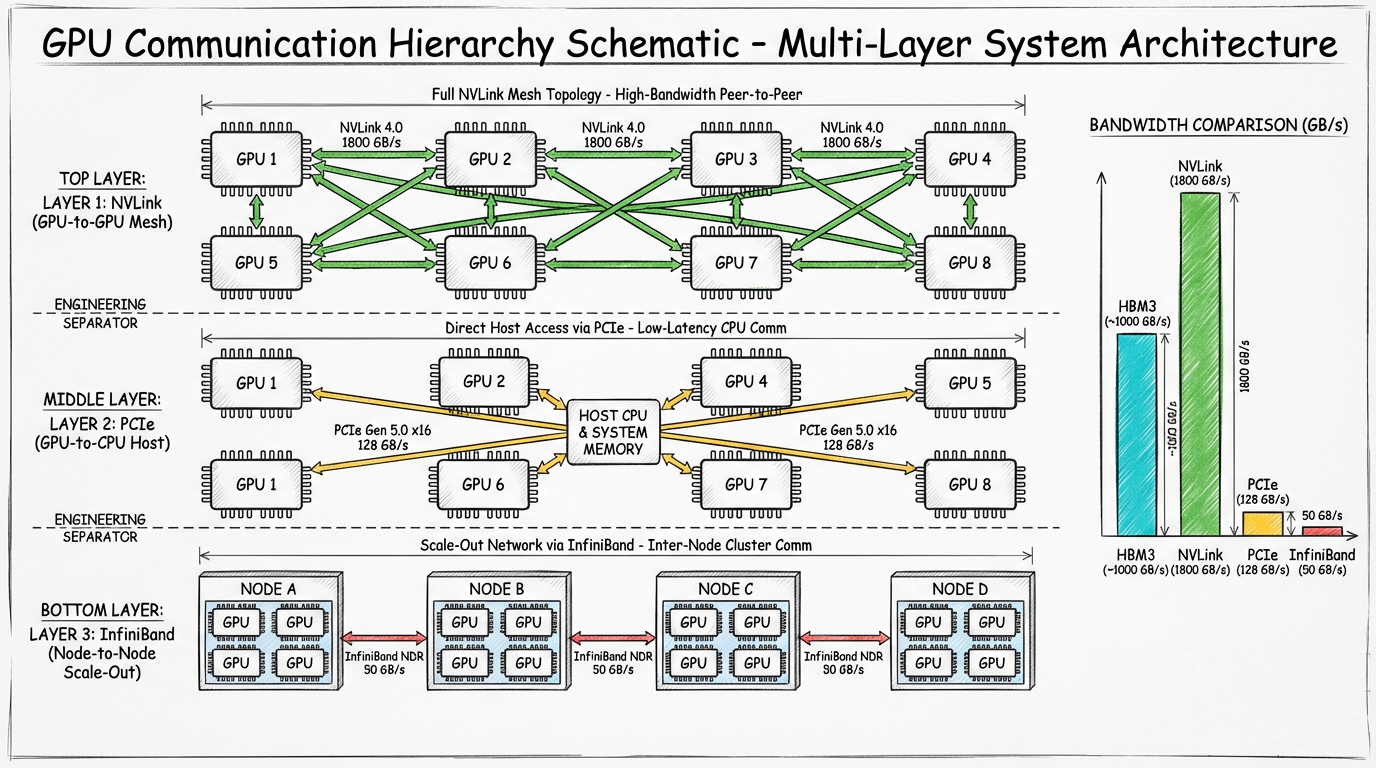
แผนผังแสดงปัญหาคอขวดการสื่อสารในระบบการฝึกแบบกระจายศูนย์ โดยที่ GPU สื่อสารกันเองและกับโครงสร้างเครือข่าย
กำแพงหน่วยความจำ
โมเดล AI สมัยใหม่เป็นส่วนที่ใช้หน่วยความจำอย่างมากมายมหาศาล พารามิเตอร์ สถานะตัวเพิ่มประสิทธิภาพ และการเปิดใช้งานระดับกลางสำหรับโมเดลพารามิเตอร์ล้านล้านรายการอาจต้องใช้พื้นที่จัดเก็บข้อมูลหลายเทราไบต์ ซึ่งเกินหน่วยความจำที่มีอยู่ใน GPU เดียว (โดยทั่วไปจะอยู่ที่ 80-120 GB) ไปอย่างมาก สิ่งนี้นำไปสู่ปัญหา "กำแพงหน่วยความจำ"
ข้อมูลจะต้องมีการสลับอย่างต่อเนื่องระหว่างหน่วยความจำแบนด์วิดท์สูง (HBM) ของ GPU และ RAM ของระบบที่ช้าลงหรือแม้แต่ที่จัดเก็บข้อมูลเครือข่าย การเคลื่อนข้อมูลนี้ไม่เพียงช้า แต่ยังใช้พลังงานอย่างหนักหน่วง เมื่ออ้างอิงจาก NVIDIA ในภาระงานทั่วไปของ GPU เพียงแค่ย้ายข้อมูลไปยังที่ต่างๆ ก็ใช้พลังงานมากถึง 70% แล้ว [8]
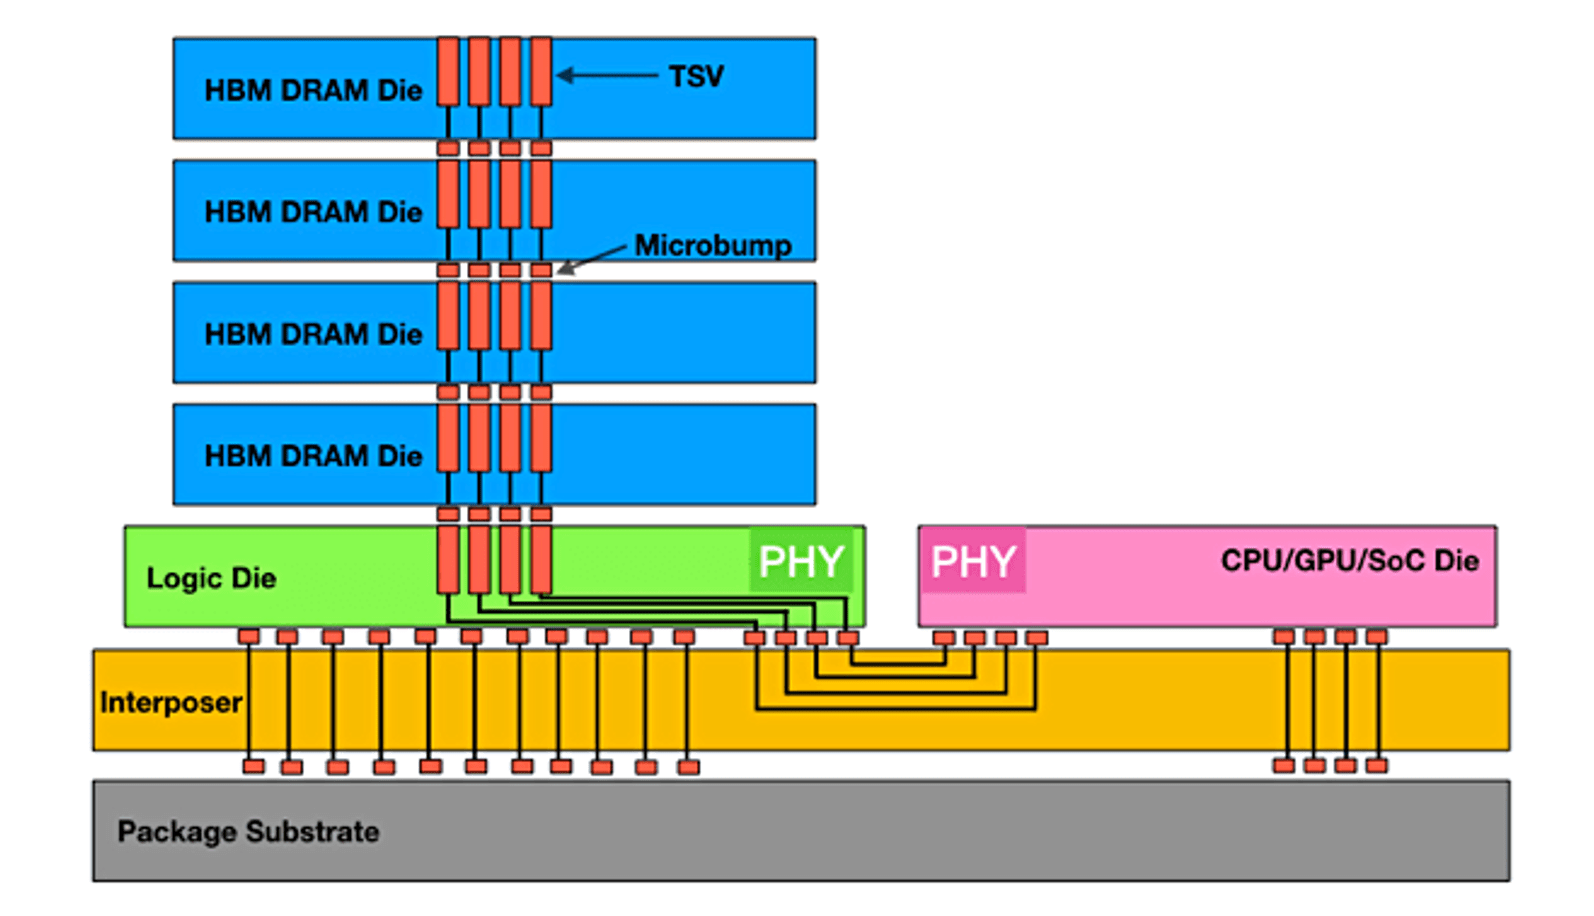
หน่วยความจำแบนด์วิดท์สูง (HBM) ซ้อนหน่วยความจำในแนวตั้งเพื่อให้ได้แบนด์วิดท์มหาศาลตามที่ GPU สมัยใหม่ต้องการ แต่ยังคงเป็นทรัพยากรที่มีจำกัดและมีราคาแพง แหล่งที่มา: Semiconductor Engineering
คอขวด I/O
ก่อนที่ GPU จะสามารถเริ่มการคำนวณได้ ก็ต้องมีข้อมูล ในสถานการณ์การฝึกขนาดใหญ่หลายๆ สถานการณ์ กระบวนการโหลดข้อมูลการฝึกจากที่เก็บข้อมูลไปยัง GPU อาจกลายเป็นจุดคอขวดหลักได้ ต้องใช้ระบบไฟล์คู่ขนานประสิทธิภาพสูงในการส่งข้อมูลในอัตราเทราไบต์ต่อวินาทีเพื่อป้อนข้อมูลให้กับ GPU นับหมื่นๆ ตัว หากไม่ได้ปรับไปป์ไลน์ข้อมูลให้เหมาะสมอย่างเต็มที่ GPU จะไม่เกิดการใช้งาน ทำให้เสียศักยภาพในระบบการคำนวณมูลค่านับล้านดอลลาร์ ในบางกรณี การโหลดข้อมูลสามารถกินเวลามากกว่า 60% ของการฝึกทั้งหมด ซึ่งจะลดประสิทธิภาพของคลัสเตอร์ทั้งหมดลงครึ่งหนึ่งอย่างเห็นได้ชัด [9]
พลังงานและการระบายความร้อน
พลังงานที่ใช้จริงซึ่งจำเป็นในการขับเคลื่อนโรงงาน AI เหล่านี้นั้นมหาศาลมาก การฝึกขนาดใหญ่เพียงครั้งเดียวก็สามารถใช้ไฟฟ้าได้มากเท่ากับเมืองเล็กๆ หนึ่งเมือง หน่วยงานด้านพลังงานระหว่างประเทศประมาณการว่าการใช้ไฟฟ้าของศูนย์ข้อมูลอาจเพิ่มขึ้นเป็นสองเท่าถึง 1,000 เทระวัตต์ต่อชั่วโมงภายในปี 2026 ซึ่งส่วนใหญ่เกิดขึ้นจาก AI [10] การใช้พลังงานอย่างเข้มข้นนี้ก่อให้เกิดความร้อนจำนวนมหาศาล ทำให้เกิดความท้าทายในการระบายความร้อนไปพร้อมๆ กัน การระบายความร้อนด้วยอากาศแบบเดิมเริ่มไม่เพียงพอ จึงผลักดันให้อุตสาหกรรมมุ่งหน้าไปสู่โซลูชันที่แปลกใหม่มากขึ้น เช่น การระบายความร้อนด้วยของเหลวและแบบจุ่มเพื่อจัดการกับความร้อนที่อัดแน่นในฮาร์ดแวร์ AI สมัยใหม่
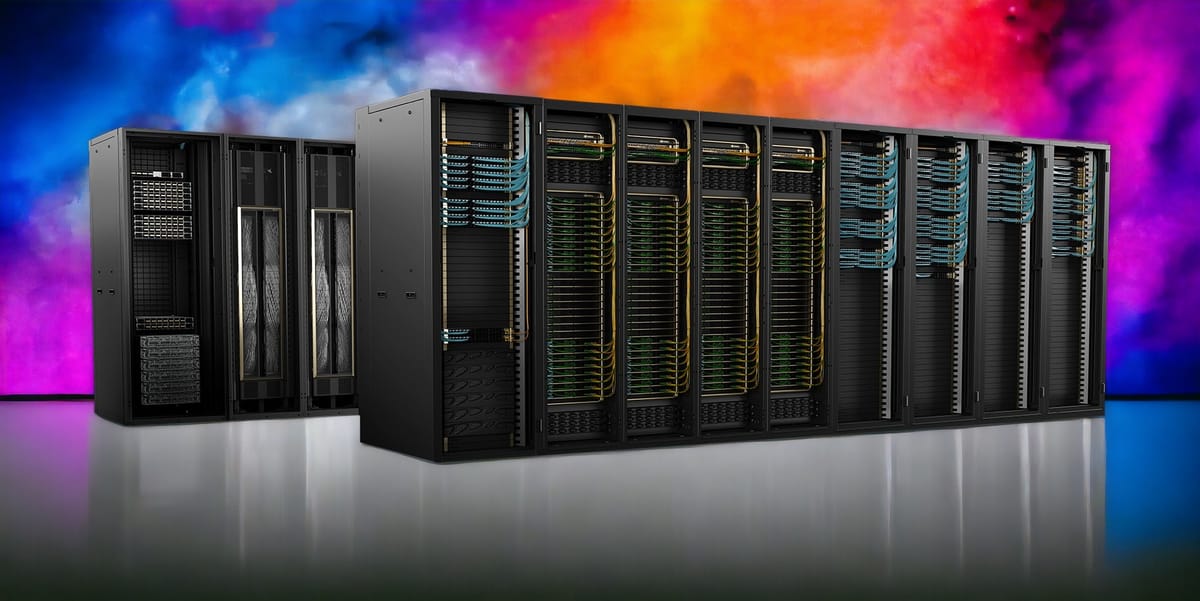
ชั้นวางเซิร์ฟเวอร์ GPU ที่แน่นขนัดก่อให้เกิดความร้อนมหาศาล ทำให้การระบายความร้อนกลายเป็นความท้าทายด้านโครงสร้างพื้นฐานที่สำคัญ แหล่งที่มา: AMAX
ส่วนที่ 3: การสร้างอนาคต: การเอาชนะอุปสรรคด้านโครงสร้างพื้นฐาน
อุตสาหกรรมกำลังจัดการกับปัญหาคอขวดเหล่านี้ด้วยวิธีการที่หลากหลายในนวัตกรรมด้านฮาร์ดแวร์ ซอฟต์แวร์ และสถาปัตยกรรมระบบ อนาคตของโครงสร้างพื้นฐาน AI ไม่ใช่แค่เกี่ยวกับชิปที่ทรงพลังมากขึ้นเท่านั้น แต่ยังเกี่ยวกับระบบที่ออกแบบร่วมกันแบบองค์รวมซึ่งทุกองค์ประกอบได้รับการปรับให้เหมาะสมกับประสิทธิภาพและการปรับขนาด
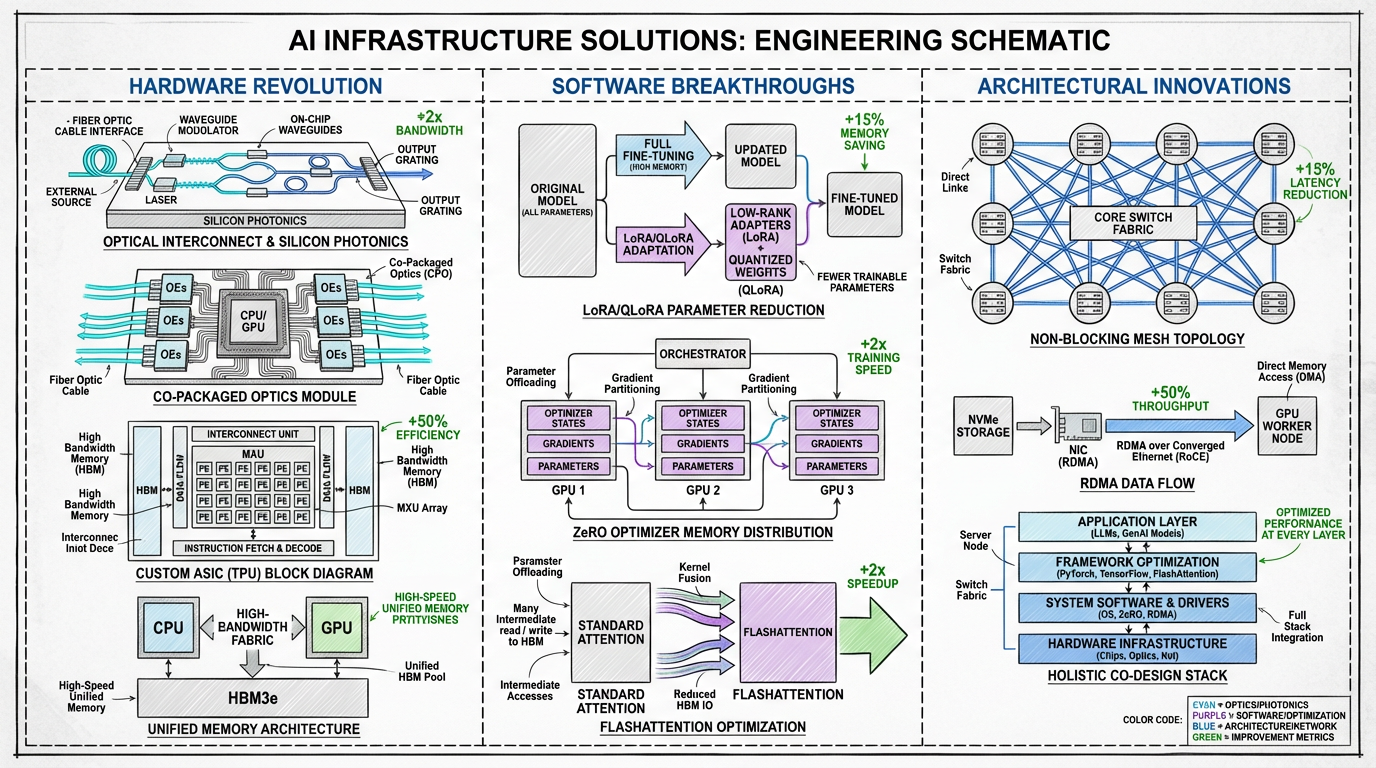
แผนผังแนวทางแก้ไขที่เสนอเพื่อเอาชนะปัญหาคอขวดด้านโครงสร้างพื้นฐาน
การปฏิวัติฮาร์ดแวร์: แสง การปรับแต่ง และการบูรณาการ
ระบบเชื่อมต่อแบบออปติคอล: การเปลี่ยนแปลงครั้งสำคัญที่สุดที่กำลังจะเกิดขึ้นคือการเปลี่ยนจากระบบเชื่อมต่อแบบไฟฟ้า (ทองแดง) ไปเป็นแบบออปติคัล (แบบใช้แสง) ซิลิคอนโฟโตนิกส์ทำให้มั่นใจได้ว่าจะส่งข้อมูลได้ในระดับเทระบิตต่อวินาทีโดยมีเวลาแฝงและการใช้พลังงานต่ำกว่าอย่างมาก ส่วนประกอบทางแสงแบบแพ็คเกจร่วมซึ่งรวม I/O แบบออปติคัลเข้ากับแพ็คเกจโปรเซสเซอร์โดยตรง จะช่วยขจัดความจำเป็นในการเชื่อมต่อไฟฟ้าที่ช้าและกินไฟมาก ช่วยแก้ไขปัญหาคอขวดการสื่อสารและพลังงานได้โดยตรง [11]
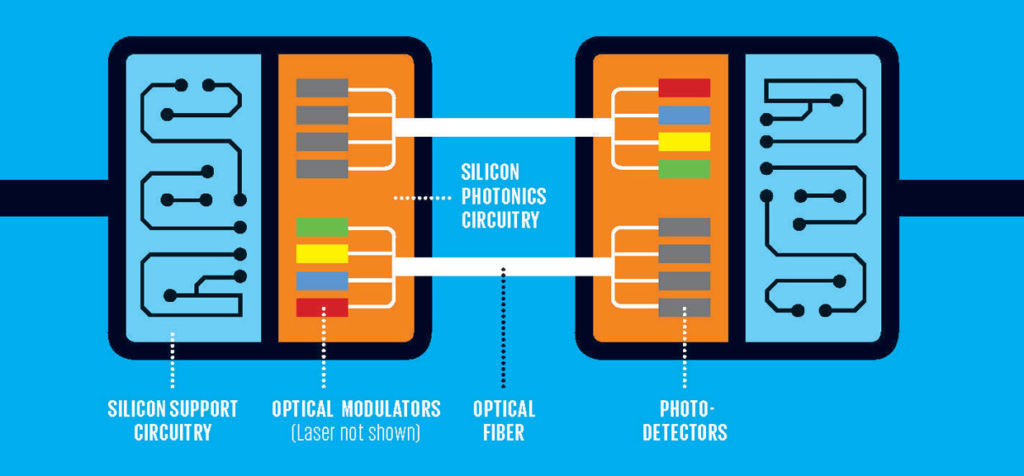
ซิลิคอนโฟโตนิกส์ใช้แสงในการส่งข้อมูล ซึ่งช่วยให้มีแบนด์วิดท์สูงขึ้นอย่างมากและใช้พลังงานน้อยลงเมื่อเทียบกับสายทองแดงแบบดั้งเดิม แหล่งที่มา: FindLight
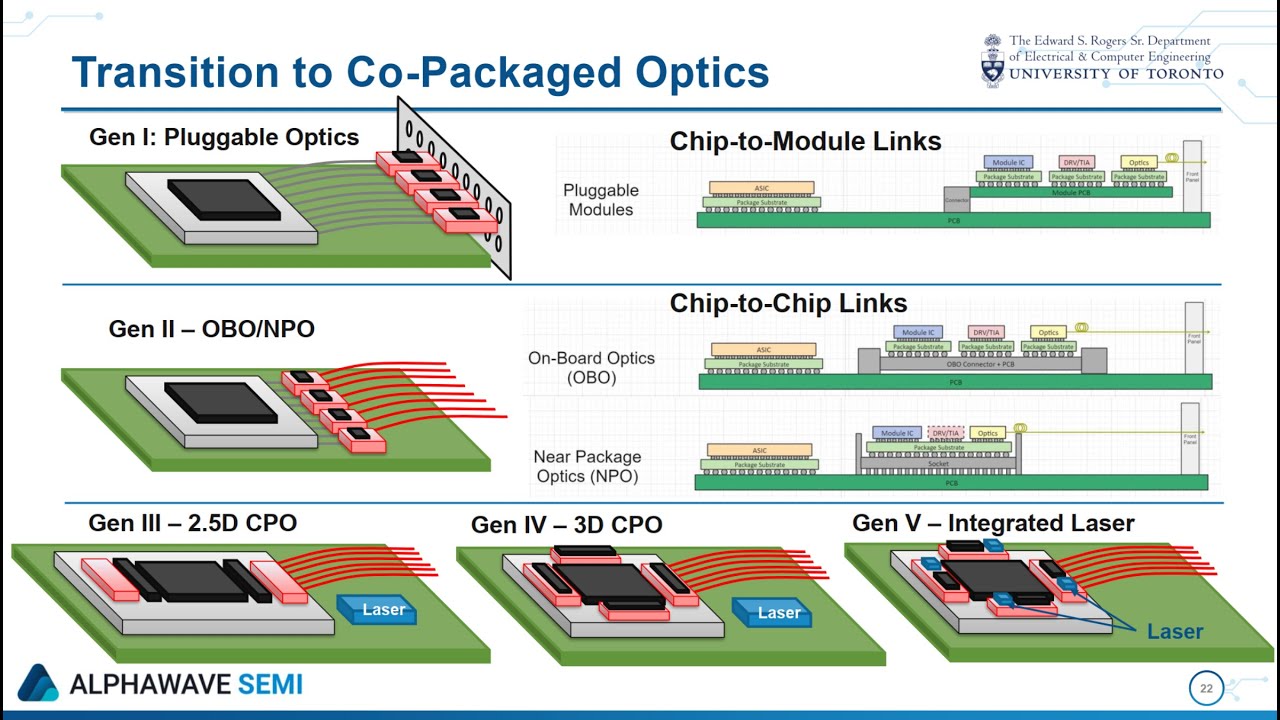
ส่วนประกอบทางแสงแบบแพ็คเกจร่วม (CPO) จะรวมตัวรับส่งสัญญาณออปติคัลเข้ากับชิปโปรเซสเซอร์โดยตรง ช่วยลดระยะทางการเดินทางของข้อมูลและเพิ่มประสิทธิภาพสูงสุด แหล่งที่มา: Anritsu
ตัวเร่งความเร็วเจเนอเรชันถัดไป: ในขณะที่ GPU ยังคงถือเป็นส่วนสำคัญ ฉากทัศน์ก็กำลังมีความหลากหลายมากขึ้น ASIC ที่กำหนดเอง (วงจรรวมเฉพาะแอปพลิเคชัน) เช่น TPU ของ Google และ MTIA ของ Meta ได้รับการออกแบบมาสำหรับภาระงาน AI เฉพาะ โดยให้ประสิทธิภาพและประสิทธิผลที่เหนือกว่าสำหรับงานเป้าหมาย แนวโน้มนี้ที่มีต่อตัวเร่งความเร็วเฉพาะโดเมนจะช่วยให้ได้โครงสร้างพื้นฐานที่ได้รับการปรับให้เหมาะสมมากขึ้นกว่า GPU ที่สร้างมาเพื่อรองรับทุกการใช้งาน
สถาปัตยกรรมหน่วยความจำแบบรวมศูนย์: เพื่อทำลายกำแพงหน่วยความจำ บริษัทกำลังพัฒนาชิปเซ็ตที่บูรณาการกันอย่างแนบแน่น Grace Hopper Superchip ของ NVIDIA เป็นต้น ได้รวม CPU และ GPU ไว้ในโมดูลเดียวที่มีการเชื่อมต่อระหว่างกันอย่างต่อเนื่องด้วยความเร็วสูง สิ่งนี้ช่วยให้โปรเซสเซอร์ทั้งสองสามารถใช้หน่วยความจำพูลเดียวร่วมกันและช่วยลดการเคลื่อนย้ายข้อมูลที่มีค่าใช้จ่ายสูงระหว่างโดเมนหน่วยความจำ CPU และ GPU
ความก้าวหน้าครั้งใหญ่ในซอฟต์แวร์และอัลกอริทึม
การปรับแต่งตามพารามิเตอร์และประสิทธิภาพ (PEFT): ไม่ใช่ทุกงานที่ต้องมีการฝึกโมเดลนับจากศูนย์มูลค่าหลายพันล้านดอลลาร์ เทคนิคต่างๆ เช่น LoRA (Low-Rank Adaptation) และ QLoRA ช่วยให้การปรับแต่งเป็นไปอย่างมีประสิทธิภาพโดยการอัปเดตพารามิเตอร์ของโมเดลเพียงเล็กน้อยเท่านั้น [12] สิ่งนี้ช่วยลดความต้องการในด้านการคำนวณและหน่วยความจำได้อย่างมาก ทำให้ผู้ใช้และองค์กรต่างๆ สามารถเข้าถึงการปรับโมเดลได้ในวงกว้างขึ้น
ตัวเพิ่มประสิทธิภาพและอัลกอริทึมขั้นสูง: นวัตกรรมซอฟต์แวร์กำลังมีบทบาทสำคัญในการปรับปรุงประสิทธิภาพ ZeRO (Zero Redundancy Optimizer) ของ Microsoft แบ่งเป็นพาร์ติชันสถานะของโมเดลทั่ว GPU ที่มีอยู่ ทำให้สามารถฝึกโมเดลขนาดโดยใช้หน่วยความจำต่ออุปกรณ์น้อยลงอย่างมาก [13] อัลกอริทึม เช่นFlashAttention ออกแบบกลไกการมุ่งความสนใจใหม่อีกครั้งเพื่อลดการอ่าน/เขียนหน่วยความจำ ซึ่งนำไปสู่การเพิ่มความเร็วและลดรอยเท้าของหน่วยความจำ
นวัตกรรมทางสถาปัตยกรรม: การเกิดขึ้นของ SuperNode
ซูเปอร์คอมพิวเตอร์ AI ที่สร้างขึ้นโดยเฉพาะกำลังผสานโซลูชันฮาร์ดแวร์และซอฟต์แวร์เหล่านี้เข้าเป็นองค์รวมที่เชื่อมโยงกัน แนวโน้มสำคัญในส่วนนี้คือการพัฒนาสถาปัตยกรรมซูเปอร์โหนดที่มีเป้าหมายเพื่อสร้างหน่วยการคำนวณที่ใหญ่ขึ้น ทรงพลังมากขึ้น และมีประสิทธิภาพมากขึ้น สถาปัตยกรรมเหล่านี้ได้คิดใหม่เกี่ยวกับแร็คเซิร์ฟเวอร์แบบเดิมเพื่อเพิ่มประสิทธิภาพสำหรับภาระงานเฉพาะของ AI
หนึ่งในตัวอย่างที่โดดเด่นคือแพลตฟอร์ม Lingjun ของ Alibaba Cloud ที่ใช้ประโยชน์จากการออกแบบซูเปอร์โหนด Panjiu AL128 สถาปัตยกรรมนี้แสดงให้เห็นถึงการเปลี่ยนแปลงไปสู่ระบบแบบโมดูลาร์และแยกส่วนมากขึ้น คุณสมบัติที่สำคัญ ได้แก่:
- การเชื่อมต่อเชิงตั้งฉาก: แทนที่จะเดินสายให้ซับซ้อน โหนด GPU และโหนดสวิตช์ความเร็วสูงจะถูกจัดเรียงในรูปแบบตั้งฉาก การออกแบบนี้ช่วยลดการสูญเสียสัญญาณสำหรับการเชื่อมต่อความเร็วสูง (สูงถึง 224 กิกะบิต/วินาที SerDes) และช่วยเพิ่มความน่าเชื่อถือและความสามารถในการให้บริการได้อย่างมาก [14]
- การออกแบบแยกส่วน:โหนด CPU โหนด GPU และระบบไฟฟ้าจะแยกส่วนกันเพื่อให้สามารถกำหนดค่าที่ยืดหยุ่นได้ (เช่น อัตราส่วนของ CPU ต่อ GPU ที่แตกต่างกัน) และการอัปเกรดอย่างอิสระ การสร้างโมดูลาร์นี้มีความสำคัญอย่างยิ่งต่อการปรับตัวให้เข้ากับฉากทัศน์ของฮาร์ดแวร์ที่เปลี่ยนแปลงไปอย่างรวดเร็ว
- การระบายความร้อนด้วยของเหลวและพลังงานความหนาแน่นสูง: แร็ค Panjiu AL128 ได้รับการออกแบบมาเพื่อรองรับพลังงานและความร้อนขีดสุด โดยมีความจุสูงสุด 350 กิโลวัตต์สำหรับพลังงานและ 500 กิโลวัตต์สำหรับการระบายความร้อน โดยใช้การระบายความร้อนด้วยของเหลวเพื่อจัดการความร้อนที่ออกมา 2 กิโลวัตต์ต่อ GPU [14]
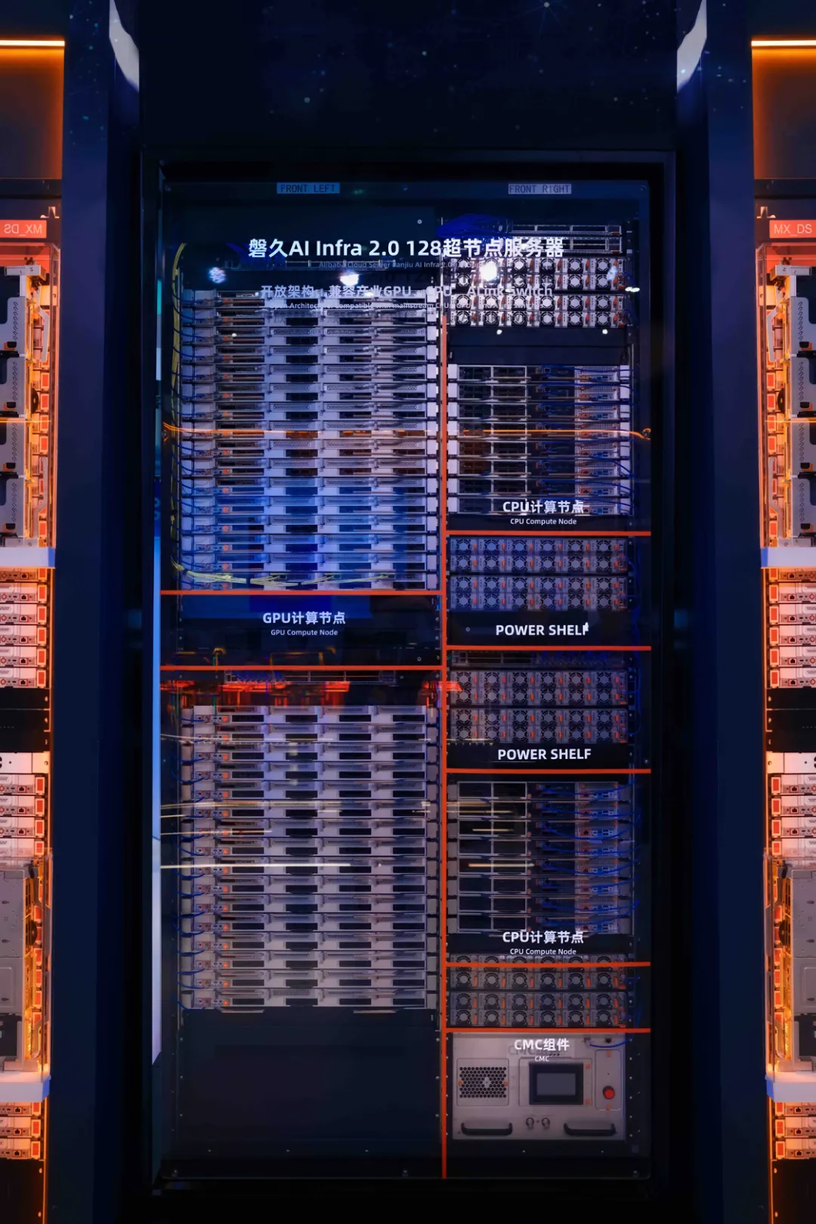
สถาปัตยกรรมซูเปอร์โหนด Panjiu AL128 ที่มีการออกแบบให้เชื่อมต่อระหว่างกันในแบบตั้งฉากและโมดูลแยกส่วนสำหรับ CPU, GPU และพลังงาน แหล่งที่มา: Alibaba Cloud
แม้ว่าระบบความหนาแน่นสูงที่มีการบูรณาการอย่างแน่นหนาดังกล่าวจะมีประสิทธิภาพที่เพิ่มขึ้นอย่างมาก (Alibaba อ้างว่าสามารถเพิ่มประสิทธิภาพการอนุมานได้ 50% เมื่อเทียบกับพลังการประมวลผลเท่ากัน) แต่ระบบเหล่านี้ก็ยังมีความท้าทายอยู่เช่นกัน ข้อดี ได้แก่ ประสิทธิภาพที่สูงขึ้น เวลาแฝงในการสื่อสารที่ลดลง และความสามารถในการปรับขนาดที่มากขึ้นภายในซูเปอร์โหนด อย่างไรก็ตามก็มีข้อเสีย ได้แก่ ความซับซ้อนที่เพิ่มขึ้น การพึ่งพาฮาร์ดแวร์ที่กำหนดเองและการเชื่อมต่อระหว่างกัน (เช่น UALink) และความต้องการการระบายความร้อนด้วยของเหลวที่ซับซ้อนและโครงสร้างพื้นฐานด้านพลังงานซึ่งอาจเพิ่มทุนและต้นทุนการดำเนินงานได้
นวัตกรรมทางสถาปัตยกรรมเหล่านี้ เมื่อผสานรวมกับเทคนิคอื่นๆ ก็กำลังสร้างพิมพ์เขียวใหม่สำหรับโรงงาน AI:
- โทโพโลยีเครือข่ายขั้นสูง: สถาปัตยกรรม เช่น ระนาบคู่ เครือข่ายไม่ปิดกั้นที่ใช้ในคลัสเตอร์สมัยใหม่บางคลัสเตอร์ได้รับการออกแบบมาเพื่อขจัดความแออัดของการรับส่งข้อมูลและแสดงให้เห็นถึงการปรับปรุงสมรรถนะการฝึกแบบครบวงจรที่ดีขึ้นถึง 15% [7]
- การโหลดข้อมูลอัจฉริยะล่วงหน้า: มีการพัฒนาระบบที่ใช้ RDMA (การเข้าถึงหน่วยความจำโดยตรงจากระยะไกล) เพื่อดึงข้อมูลการฝึกไปยังหน่วยความจำในล่วงหน้าก่อนที่จำเป็นจะต้องใช้ โดยแทบจะกำจัดปัญหาคอขวด I/O ไปได้ และเพิ่มการใช้ GPU ที่มีประสิทธิภาพได้เป็นสองเท่า [9]
- การออกแบบระบบแบบองค์รวม: อนาคตอยู่ที่การออกแบบร่วมกัน โดยที่สแต็กทั้งหมด นับตั้งแต่แอปพลิเคชันและเฟรมเวิร์ก AI ไปจนถึงเครือข่าย พื้นที่จัดเก็บ และซิลิกอนต่างก็ได้รับการออกแบบร่วมกันเพื่อให้ทำงานในรูปแบบเครื่องหน่วยเดียวที่มีประสิทธิภาพสูง
หากต้องการเจาะลึกทางเทคนิคเกี่ยวกับสถาปัตยกรรม Panjiu AL128 โปรดดูการวิเคราะห์โดยละเอียดและภาพรวมวิดีโอจาก Alibaba Cloud ที่นี่ และ ที่นี่
ข้อสรุป: ยุคใหม่ของโครงสร้างพื้นฐานอัจฉริยะ
ยุคแรกของการปฏิวัติ AI กำหนดโดยการปรับขนาดโดยทดลองทุกความเป็นไปได้ เพื่อให้ได้โมเดลที่มีขนาดใหญ่ขึ้น มีข้อมูลมากขึ้น และมีการประมวลผลที่มากขึ้น แม้ว่าขนาดจะเป็นสิ่งสำคัญอยู่เสมอ แต่ยุคถัดไปจะกำหนดโดยประสิทธิภาพและความประณีต อนาคตของ AI ไม่ใช่แค่การสร้างโมเดลที่ใหญ่ขึ้นเท่านั้น แต่ยังเกี่ยวกับการสร้างโครงสร้างพื้นฐานที่ฉลาดมากขึ้น ยั่งยืนมากขึ้น และเข้าถึงได้มากขึ้นเพื่อฝึกและใช้งาน
เส้นทางนับตั้งแต่การใช้งาน GPU ครั้งแรกของ AlexNet ไปจนถึงโรงงาน AI ที่ได้รับการออกแบบร่วมกันโดยใช้เทคโนโลยีออปติคัลแห่งอนาคตเป็นเครื่องพิสูจน์ถึงความก้าวหน้าอย่างไม่หยุดยั้งของนวัตกรรม การเอาชนะคอขวดการสื่อสาร หน่วยทรงจำ และขุมพลังเป็นความท้าทายอันยิ่งใหญ่ในช่วงเวลานี้ และการแก้ปัญหาที่ได้รับการพัฒนาในปัจจุบันจะเป็นรากฐานสำหรับปัญญาประดิษฐ์คลื่นลูกใหม่
ข้อมูลอ้างอิง
[1] Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). การจำแนกประเภท ImageNet ด้วยเครือข่ายประสาทเทียมแบบคอนโวลูชันเชิงลึก ความก้าวหน้าในระบบประมวลผลข้อมูลประสาท 25
[2] Vaswani, A., et al. (2017). ความเอาใจใส่คือสิ่งเดียวที่คุณต้องการ ความก้าวหน้าในระบบประมวลผลข้อมูลประสาท 30
[3] Visual Capitalist. (2023). พุ่งทะยาน: ต้นทุนการฝึกโมเดล AI ที่พุ่งสูงขึ้นตามกาลเวลา
[4] Forbes. (2024). ต้นทุนที่สูงลิ่วของการฝึกโมเดล AI
[5] R&D World. (2024). การบีบอัดข้อมูลอันยอดเยี่ยมของ AI: 20 แผนภูมิที่แสดงให้เห็นถึงช่องว่างที่หายไปแต่ยังคงมีต้นทุนที่พุ่งสูงขึ้น
[6] NVIDIA. (2024). NVIDIA GB200 NVL72.
[7] Zhai, E., et al. (2024). HPN: เครือข่ายประสิทธิภาพสูงแบบไม่ปิดกั้น ระนาบคู่ และไม่ขึ้นอยู่กับชั้นแอปพลิเคชัน สำหรับการฝึก AI ขนาดใหญ่ SIGCOMM 2024.
[8] Szasz, D. (2024). ทำความเข้าใจปัญหาคอขวดในการฝึก AI หลาย GPU Medium.
[9] Alibaba Cloud. (2024). คุณสมบัติของบริการการประมวลผลอัจฉริยะ PAI-Lingjun
[10] Forbes. (2025). ทำไมโครงสร้างพื้นฐานด้านออปติคัลจึงกลายเป็นแกนหลักของอนาคต AI
[11] Yole Group. (2023). ส่วนประกอบทางแสงแบบแพ็คเกจร่วมสำหรับศูนย์ข้อมูล 2023
[12] Dettmers, T., et al. (2023). QLoRA: การปรับแต่ง LLM เชิงปริมาณอย่างมีประสิทธิภาพ ความก้าวหน้าในระบบประมวลผลข้อมูลประสาท 36
[13] Microsoft Research. (2020). ZeRO และ DeepSpeed: การเพิ่มประสิทธิภาพระบบใหม่ช่วยให้สามารถฝึกโมเดลที่มีพารามิเตอร์มากกว่า 1 แสนล้านรายการได้
[14] Alibaba Cloud. (2025). การวิเคราะห์เชิงลึกของเซิร์ฟเวอร์ Alibaba Cloud Panjiu AL128 Supernode AI Servers และสถาปัตยกรรมการเชื่อมต่อระหว่างกัน Alibaba Cloud Blog.
[15] Alibaba Cloud. (2025). ภาพรวมวิดีโอเซิร์ฟเวอร์ Panjiu AL128 Supernode AI YouTube.
บทความนี้เป็นฉบับแปลมาจากต้นฉบับภาษาอังกฤษ หากต้องการดูเนื้อหาของแหล่งที่มา โปรดไปที่: https://www.alibabacloud.com/blog/from-brute-force-to-finesse-the-evolution-and-future-of-ai-training-infrastructure_602718
Read previous post:
Từ sức mạnh thô mộc đến sự tinh tế: Sự phát triển và tương lai của cơ sở hạ tầng đào tạo AI
Read next post:
Pembuatan Gambar dan Video dari Prompt Teks Menggunakan Model Wan 2.5 Preview dari Model Studio
-

-
Regional Content Hub
144 posts | 4 followers
Follow
Comments
-
-
Regional Content Hub
144 posts | 4 followers
Follow
Related Products
-
 Qwen
Full-range, open-source, multimodal, and multi-functional
Learn More -
 Alibaba Cloud Model Studio
A one-stop generative AI platform to build intelligent applications that understand your business, based on Qwen model series such as Qwen-Max and other popular models
Learn More -
Token Plan
Build more, spend less. One plan, every modality.
Learn More -
 QwenWork
 is dedicated to helping employees strengthen their professional competitiveness in the AI era and to enabling enterprises to improve organizational effectiveness.
Learn More
More Posts by Regional Content Hub
- ให้พื้นที่ทำงานชั่วคราวกับ AI เอเจนต์ของคุณด้วย Alibaba Cloud AgentRun
- Alibaba Cloud AgentRun으로 AI 에이전트에 일회용 워크스페이스 제공
- Alibaba Cloud AgentRun で AI エージェントに使い捨てワークスペースを与える
- Beri Agen AI Anda Ruang Kerja Sekali Pakai dengan Alibaba Cloud AgentRun
- Cung cấp không gian làm việc dùng một lần cho tác nhân AI của bạn với Alibaba Cloud AgentRun
- DeepSeek V4-Flash dalam Skala Besar: Panduan Deployment Berbasis Benchmark
- 大規模な DeepSeek V4-Flash の活用:ベンチマーク主導のデプロイガイド
- 대규모 DeepSeek V4-Flash: 벤치마크 기반 배포 가이드
- Alibaba Cloud ECS 上で Telegram 連携機能付きの OpenClaw をデプロイする
- Alibaba Cloud ECS에 Telegram 통합 기능을 갖춘 OpenClaw 배포