LangStudio は、フロー制御、LLM、エージェント、データ取得、ドキュメント解析、音声認識、Python スクリプティング向けの事前構築済みワークフローノードを提供します。
フロー制御
開始
アプリケーションフロー には、開始ノードを 1 つのみ含めることができます。
開始 ノードは、実行の開始位置を示し、アプリケーションフロー の入力パラメータを宣言します。
-
会話フローの場合、システムは会話履歴とユーザー入力という 2 つのデフォルトフィールドを提供します。必要に応じてカスタム変数を追加してください。ユーザーがアップロードしたファイルを受け入れるには、ファイルタイプの入力変数を定義してください。詳細については、「File type input and output」をご参照ください。

-
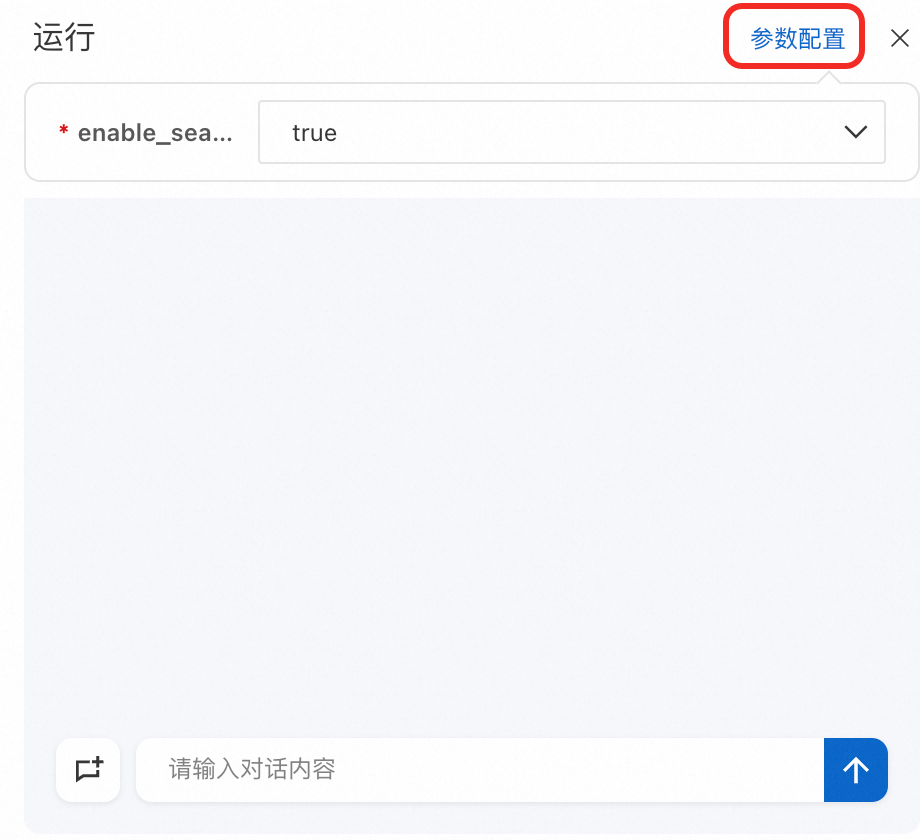
アプリケーションフローを実行する際は、会話パネルで現在の会話の入力パラメータを設定します。
条件分岐
このノードは、フロー制御のための if-else ロジックを実装します。条件を評価し、最初に一致するブランチ に実行を振り分けます。いずれの条件も true でない場合は、else ブランチ が実行されます。このノードを 変数集約ノードと組み合わせることで、異なるブランチからの結果を統合できます。
-
設定

-
入力
ブランチ条件を設定する際は、以下の点に注意してください。
-
各ブランチは実行パスを表します。最後のブランチは else ブランチであり、他の条件が一致しない場合に実行され、編集できません。
-
各ブランチには複数の条件を含めることができ、and/or ロジックで組み合わせることができます。
-
上流ノードからの出力、演算子 (
=、≠、空である、含まないなど) 、および値を確認し、正確で有効な条件を設定してください。
-
-
出力
このノードは出力を生成しません。
-
使用例
条件分岐ノードを下流ノードに接続すると、各ブランチに対応する接続ポートがあります。ブランチ条件が満たされると、システムはそのブランチ上の下流ノードを実行し、他のブランチはスキップします。アクティブなブランチからの実行結果を収集するには、変数集約ノードを使用してください。

変数集約
このノードは、異なるブランチからの出力結果を統合変数にマージします。条件分岐ノードまたはインテント認識ノードが実行されると、1 つのブランチのみが実行されます。このノードを使用することで、どのブランチが実行されたかに関係なく、下流ノードが単一の集約変数を参照できるようになり、冗長なロジックを防ぐことができます。
-
設定

-
入力
変数グループを設定する際は、以下の点に注意してください。
-
出力
ノードの出力変数は、設定されたグループによって異なります。複数のグループが存在する場合、ノードは各グループのキーと値のペアを出力します。キーはグループ名、値はそのグループからの最初の空でない変数です。
-
使用例
条件分岐ノードの使用例をご参照ください。
ループ
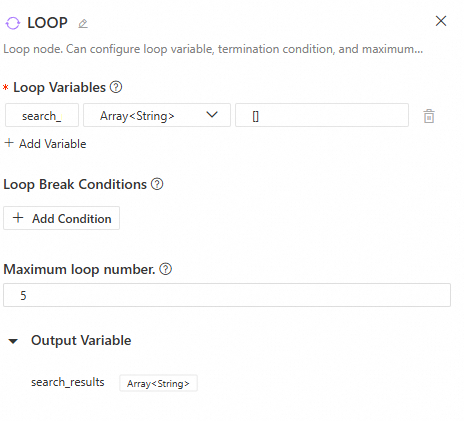
ループ ノードは、各反復が前回の結果に依存する反復タスクを実行します。ループは、終了条件 が満たされるか、最大反復回数 に達するまで継続します。ループノード内で、システムが ループ変数 に基づいて繰り返し実行するサブフローを設定します。
-
設定
-
入力
-
ループ変数:反復間でデータを受け渡します。ループ完了後も、その最終値は下流ノードで使用可能です。複数のループ変数を設定でき、その値は手動で入力するか、上流ノードの出力から選択できます。
-
ループ終了条件:ループ変数に基づいて終了条件を設定できます。指定されたループ変数が事前設定された条件を満たすと、ループは終了します。
-
最大反復回数:無限ループを防ぐために、ループ実行の最大回数を制限します。
-
-
出力
ノードの出力は、最終反復後のループ変数の値です。ループ変数は、変数代入ノードによってのみ更新できます。このノードがない場合、ループの出力は、反復回数に関係なく、初期入力と同じままになります。
-
関連ノード
ループ関連ノードは、ループ内でのみ使用できます。ループ内のノードの右側にある + アイコンをクリックして、以下の関連ノードを追加します。
-
ループ中断
ループを直ちに終了します。これは通常、条件分岐ノードの後に配置します。
-
変数代入
ループ内のノードの出力をループ変数に代入し、ループの状態を進めます。

-
直接出力
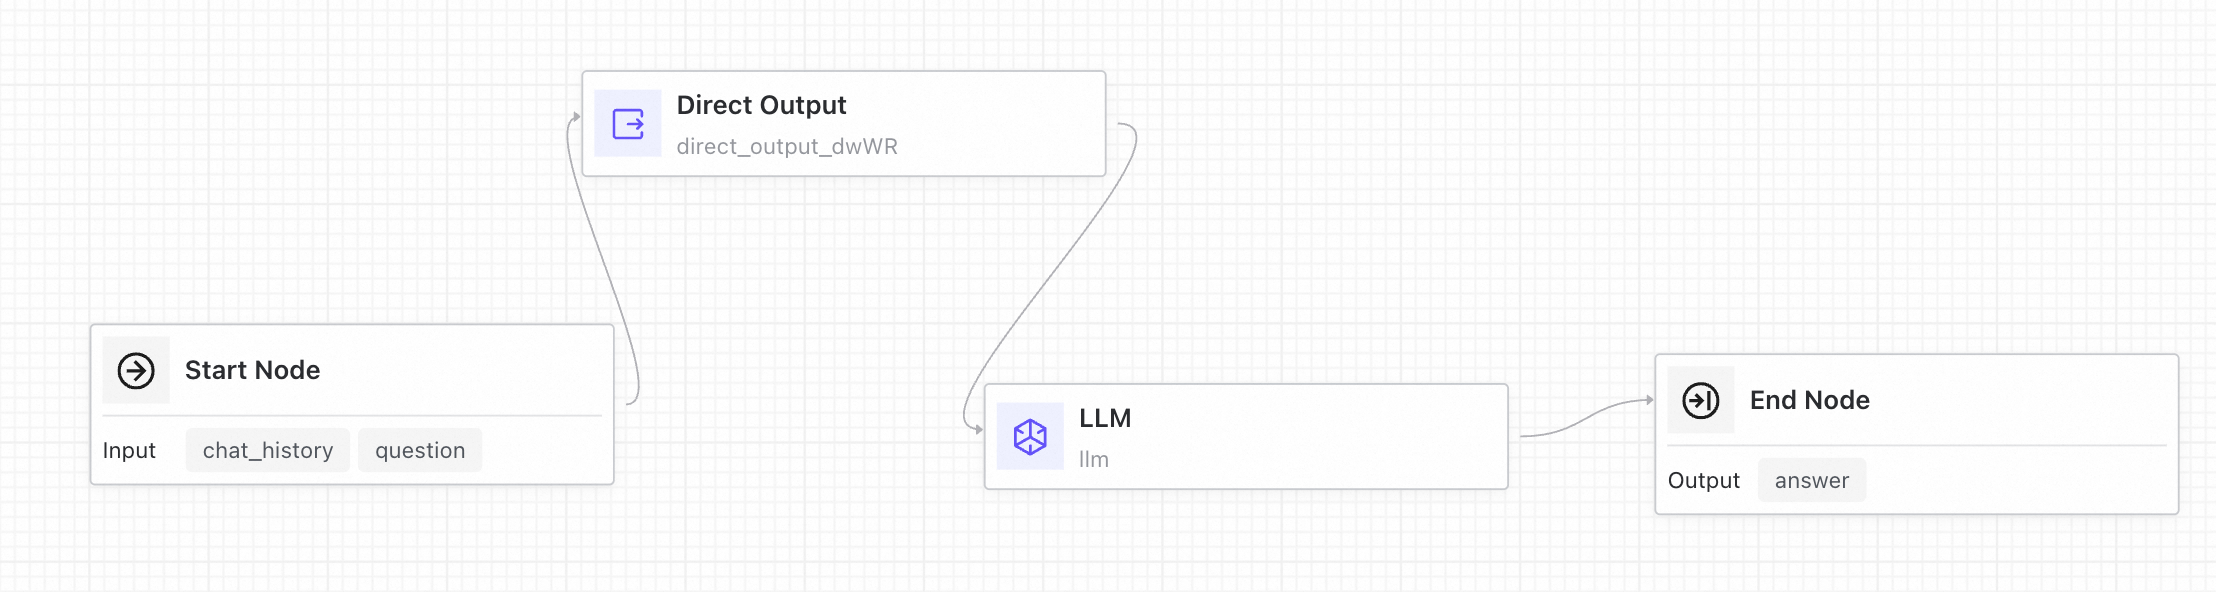
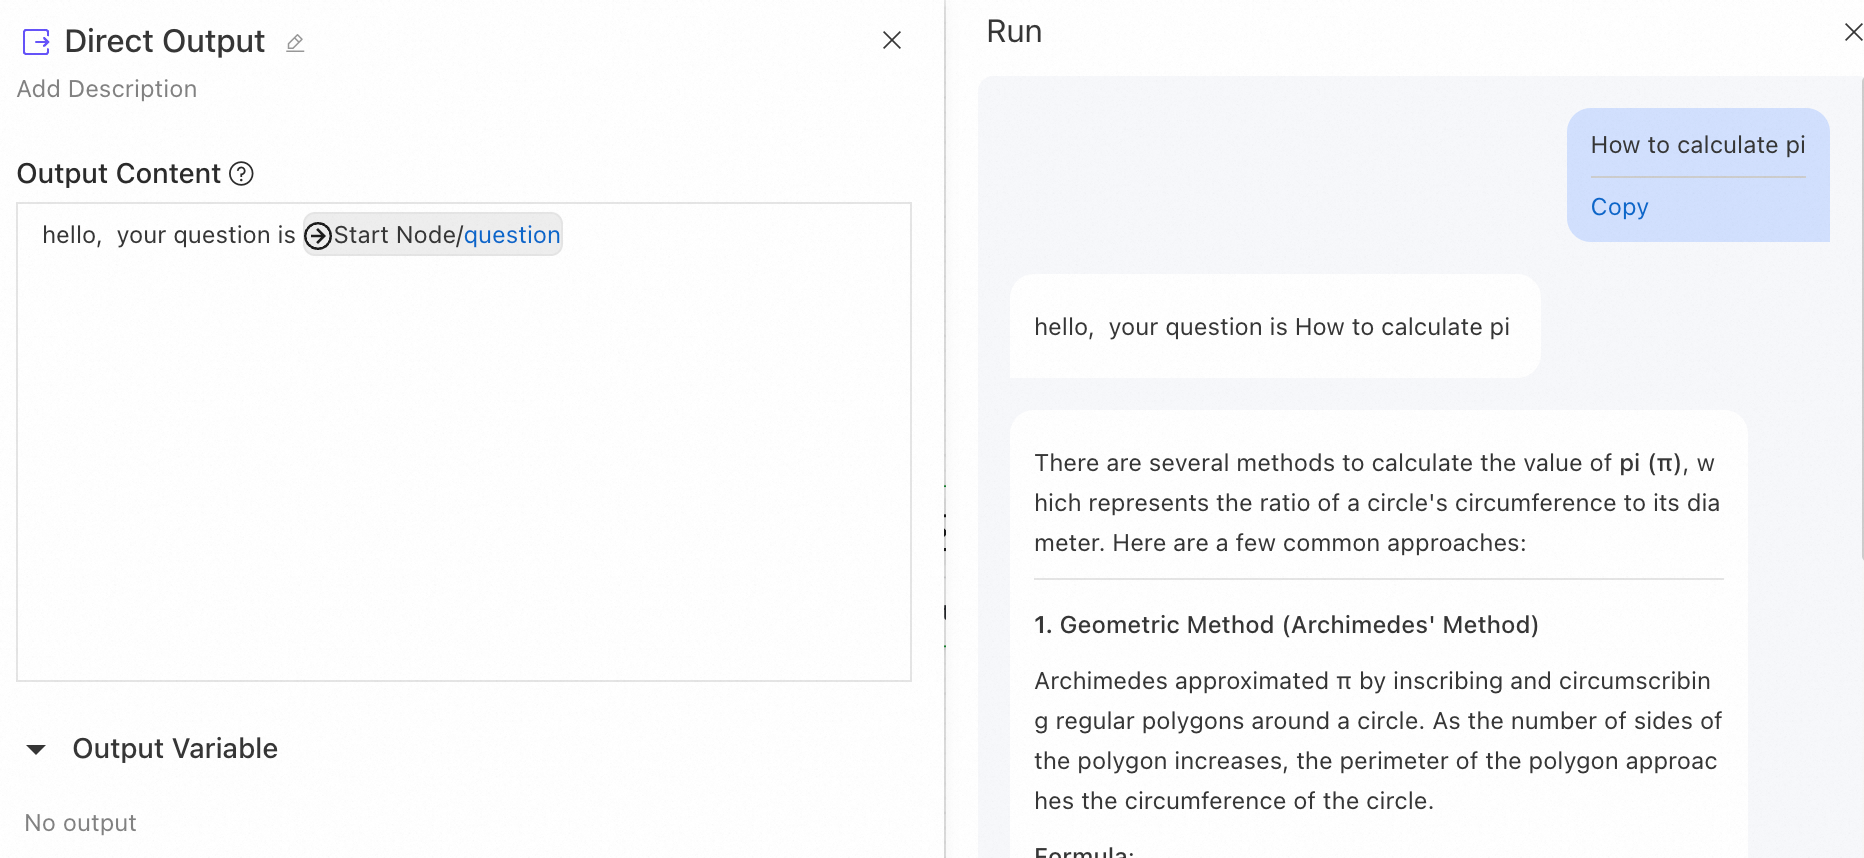
直接出力ノード は、出力テンプレートを使用して応答コンテンツを直接設定します。{{node.variable}} 構文を使用した上流ノード出力の参照と、ストリーミング出力をサポートします。
例:LLM ノードの前に 直接出力 ノードを追加して、メインタスクの処理中に「考え中...」などの初期メッセージをユーザーに送信します。
バッチ処理
バッチ処理ノードは、リストデータを並列に処理します。各リスト要素に同じサブフローを適用することで、効率を大幅に向上させます。各ステップが前のステップに依存する反復タスクの場合は、代わりにループノードを使用してください。
入力
-
入力リスト:処理するデータのリストです。ノードは各要素を独立したアイテムとしてサブフローに送信し、実行します。
-
出力フィールド:サブフロー内のノードから出力変数を選択し、各アイテムのタスクの結果として使用します。
-
並列数:オプション。同時に実行するタスクの数を制御します。デフォルトは 4 で、有効な範囲は 1 から 10 です。
出力
result:すべてのバッチタスクからの出力結果を含むリストで、入力リストと同じ順序で並びます。入力で指定された「出力フィールド」の実際の出力値を集約します。
関連ノード
バッチ開始
バッチ開始ノードは、バッチ処理サブフローのエントリポイントです。サブフロー内の後続ノードが参照できる以下の出力変数を提供します。
-
item:現在処理中のデータアイテムで、入力リスト内の要素に対応します。
-
index:入力リスト内の現在のデータアイテムのインデックス (0 から開始) 。
バッチ中断
バッチ中断ノードは、特定の条件が満たされたときに、現在のデータアイテムの処理を早期に終了するために使用します。
注:バッチ中断ノードは 現在の反復 のみを終了し、他のデータアイテムの処理には影響しません。
使用例
ドキュメントのバッチ解析とインテリジェント処理
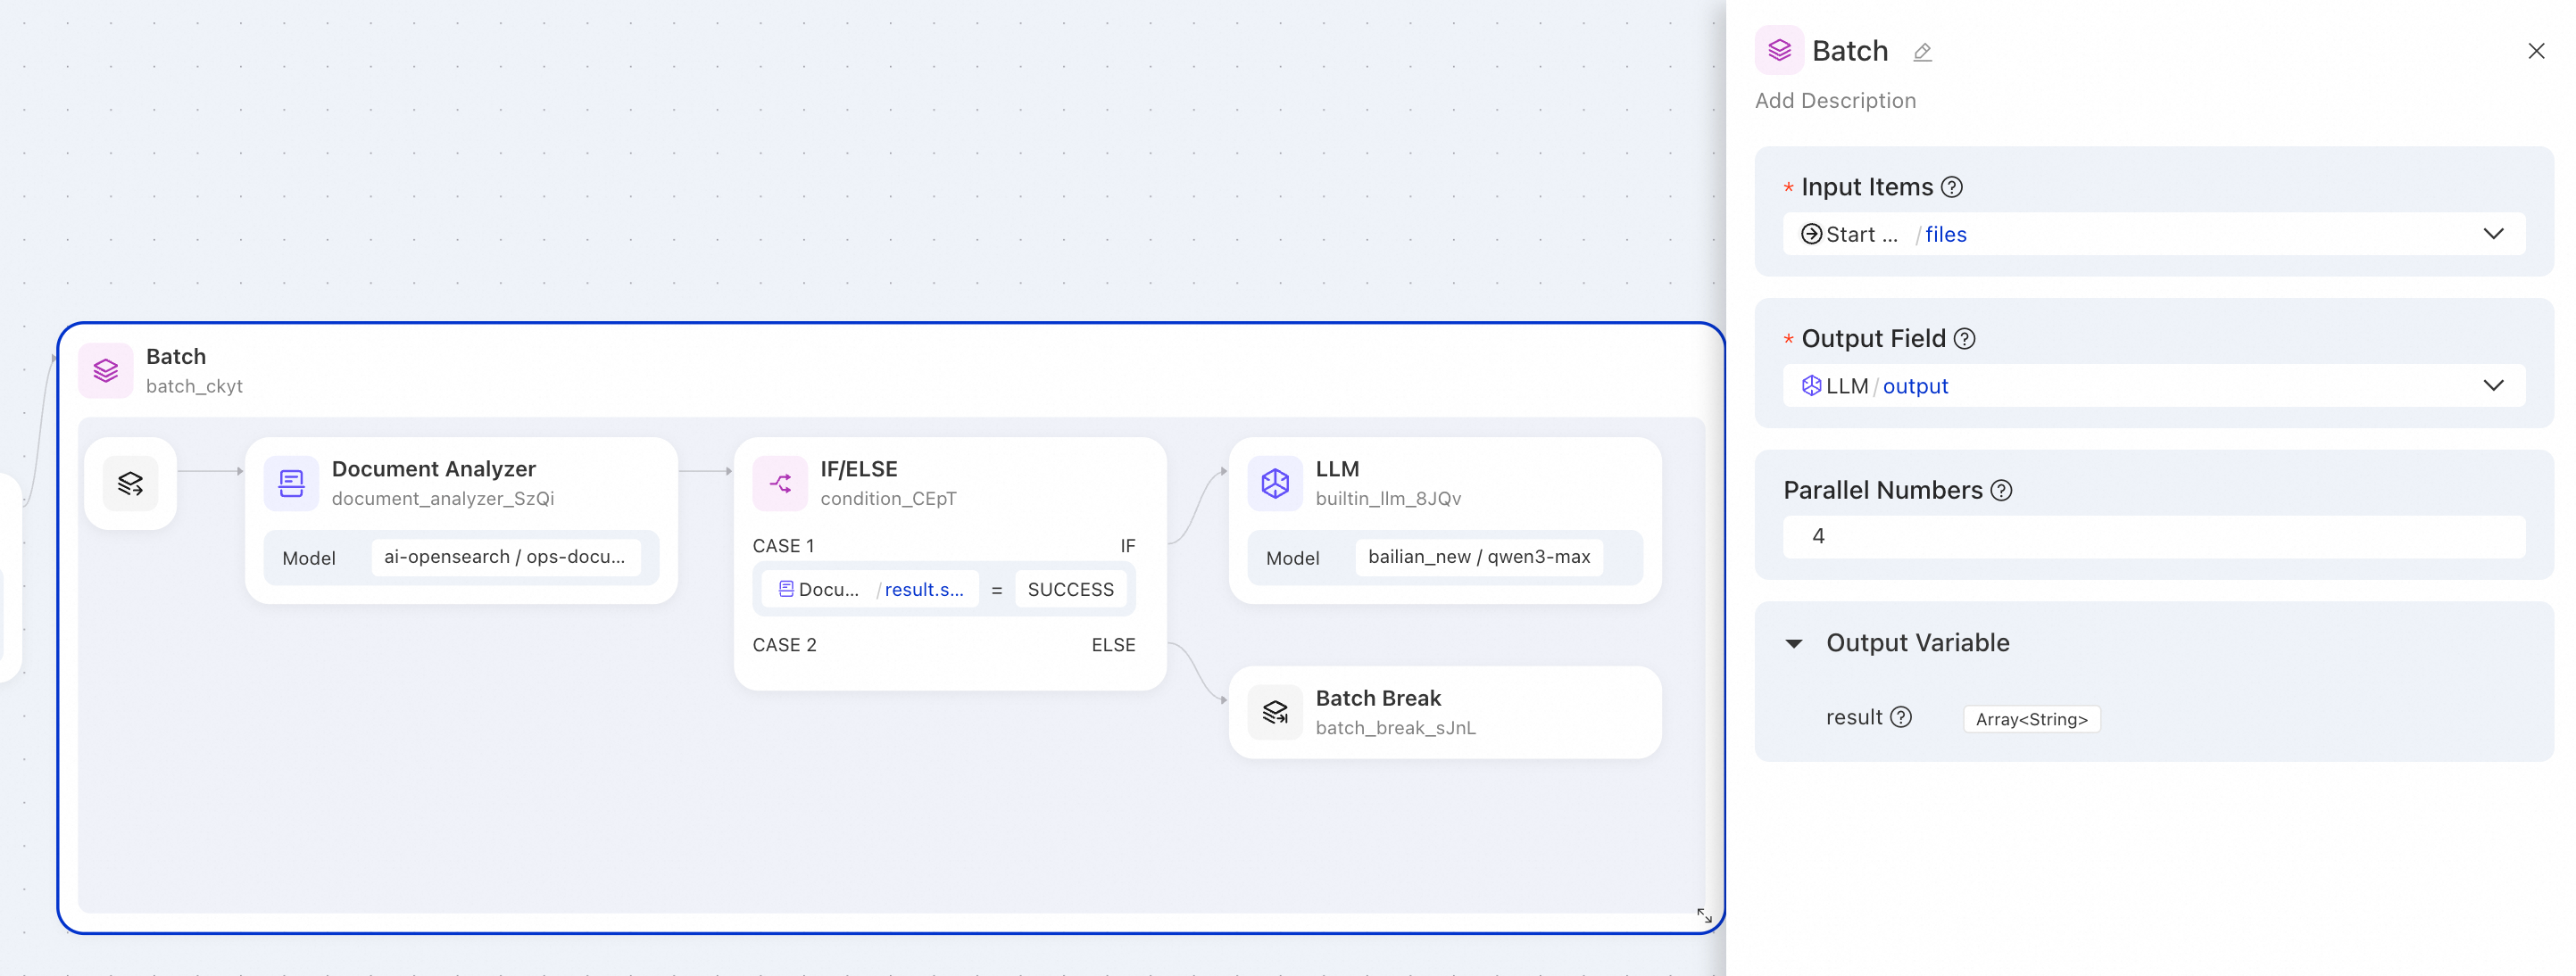
シナリオ:企業が複数のドキュメントファイルをバッチで解析し、正常に解析されたドキュメントに対して LLM を呼び出してコンテンツ処理を行い、解析に失敗したドキュメントは自動的にスキップする必要があります。
バッチ処理ノードの設定:
|
パラメータ |
値 |
説明 |
|
入力リスト |
|
上流の開始ノードからのファイルリスト出力を参照します。 |
|
出力フィールド |
|
LLM ノードの出力フィールドを、バッチ処理ノードの出力として選択します。 |
|
並列数 |
|
4 つのファイルを同時に処理します。 |
出力例:
{
  "result": [
    "これは製品XXのユーザーマニュアルで、製品の機能紹介やインストール手順などが含まれています...",
    "これはソフトウェアサービスの調達契約書で、契約期間は12ヶ月です...",
    null,
    "2026年1月15日付の付加価値税普通請求書..."
  ]
}注:出力の null 値は、ファイルの解析に失敗し、バッチ中断ノードが後続の処理をスキップしたことを示します。
注意事項
-
結果の順序保証:出力リストの順序は、入力リストの順序と一致します。
-
サブフローの柔軟性:サブフロー内では、異なるデータアイテムが異なる実行パスをトリガーする場合があります。
-
null 値の処理:アイテムの実行フローが早期に終了した場合、または出力が空の場合、出力リストの対応する位置は null になります。
終了
終了 ノードは、アプリケーションフロー の完了を示し、その出力パラメータを定義します。アプリケーションフロー には、終了ノードを 1 つのみ含めることができます。
-
出力パラメータの設定
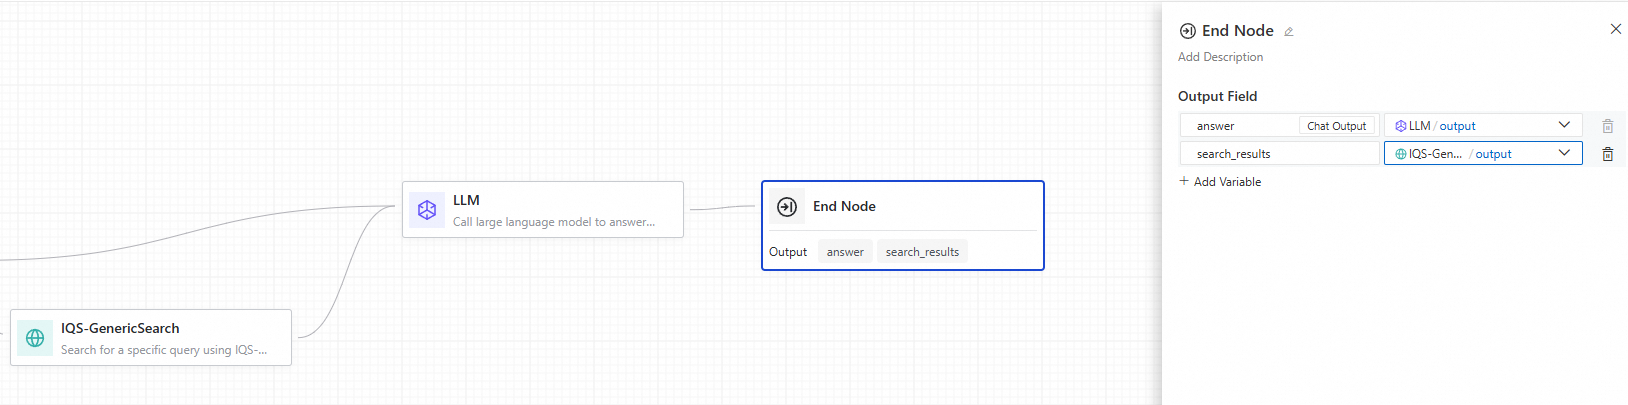
アプリケーションフローの出力は、任意の上流ノードの出力を参照できます。たとえば、以下のサンプルでは、アプリケーションフローの 'answer' 出力は LLM ノードの出力を使用し、'search_results' は検索ノードの出力を使用しています。
 説明
-
会話フローには、デフォルトの 'Chat' 出力フィールドがあり、これがアプリケーションフローの会話出力として機能します。
-
アプリケーションフローには、開始ノードと終了ノードを含める必要があります。それらの間に接続されたノードのみが実行されます。孤立したノードは無視されます。
-
AI 機能
LLM
LLM ノードは、テキスト生成、質問応答、複雑な入力処理といった自然言語タスクのために大規模言語モデルを呼び出す、アプリケーションフローの中核コンポーネントです。モデルパラメーターの調整、会話履歴の管理、プロンプトのカスタマイズを行うための設定オプションを提供します。
-
ユースケース
-
テキスト生成:トピックとキーワードに基づいてテキストコンテンツを生成します。
-
コンテンツ分類:メールの種類 (例:問い合わせ、苦情、スパム) を自動的に分類します。
-
テキスト翻訳:テキストを指定した言語に翻訳します。
-
RAG:取得した知識とモデルの推論を組み合わせてユーザーの質問に回答します。
-
-
設定

-
入力
-
モデル設定: ModelGallery からデプロイしたモデル、カスタムデプロイしたモデルサービス、および Dashscope や DeepSeek などのプロバイダーのモデルをサポートします。最適なパフォーマンスを得るには、高性能なモデルを選択してください。次のモデルパラメータを設定します:
-
temperature:通常は 0~1 の値で、出力のランダム性を制御します。0 に近いほど決定的な出力になり、1 に近いほど多様な結果になります。
-
Top P: Nucleus sampling のしきい値です。累積確率がしきい値 P を超える最小のトークン集合からモデルがサンプリングし、出力の多様性に影響します。
-
Top K:候補トークンを確率が高い上位 K 個に制限します。これによりランダム性が低下し、出力がよりフォーカスされます。また、Top P よりも直接的に創造性を制約します。
-
プレゼンスペナルティ:同一のエンティティや情報の繰り返しを抑制します。すでに生成されたテキストに含まれるトークンにペナルティを課します。値が大きいほど、繰り返しをより強く抑制します。
-
頻度ペナルティ:生成テキスト内での出現頻度に基づいてトークンにペナルティを課し、過度に頻出する単語やフレーズを抑制します。値が大きいほど語彙の多様性が高まります。
-
最大トークン数:1 回の実行あたりの最大出力長 (トークン数) です。値が小さいと出力が途中で切り捨てられる可能性があり、値が大きいとより長い応答が可能になります。
-
Seed:指定すると、モデルは決定的なサンプリングを試みます。同じ seed とパラメータでリクエストを繰り返すと同じ結果になるはずですが、完全な決定性は保証されません。変更の有無を監視するには、レスポンスパラメータの system_fingerprint を参照してください。
-
停止シーケンス:モデルに以降の出力生成を停止させるシーケンスを最大 4 つ指定します。モデルがこれらのいずれかのシーケンスに遭遇すると、トークン生成を停止します。返されるテキストには停止シーケンスは含まれません。
-
-
会話履歴:有効にすると、アプリケーションフローのチャット履歴がプロンプトに自動的に挿入されます。
-
入力変数:変数は、それ以前のすべてのノードの出力を参照できます。
-
プロンプト:プロンプトには、System (SYSTEM)、User (USER)、または Assistant (ASSISTANT) のカスタムコンテンツが含まれます。プロンプトは Jinja2 テンプレートであり、二重中かっこ
{{}}を使用して入力変数を参照できます。
-
-
出力
このノードのデフォルト出力は String ですが、JSON もサポートします。JSON 型の場合、カスタム出力変数をサポートし、モデルは変数名に基づいて出力を生成します。
-
ユースケース
インテント認識
インテント認識ノードは主にフロー制御に使用します。大規模言語モデルを使用して ユーザーのインテントを分析 し、その結果に基づいて対応するブランチに実行を振り分けます。マルチインテント設定と会話履歴をサポートします。
-
設定

-
入力
-
ユーザー入力:インテント認識に使用するユーザー入力を選択します。
-
マルチインテント設定:必要に応じてインテントを設定します。各インテントの説明を明確にし、異なるインテント間で意味の重複がないことを確認してください。最後のインテントはデフォルトで "Other" となり、他のインテントが該当しない場合に適用されます。このインテントは編集できません。
-
モデル設定:インテント認識用の大規模言語モデルを設定します。パフォーマンスを向上させるには、qwen-max など、より高性能なモデルを選択してください。
-
会話履歴:有効にすると、大規模言語モデルは推論中にアプリケーションフローのチャット履歴をプロンプトに自動的に挿入します。
-
追加プロンプト:このコンテンツはシステムプロンプトに追加され、モデルがより正確にインテント認識を実行できるようにします。
-
-
出力
このノードは出力を生成しません。
-
使用例
インテント認識ノードを下流ノードに接続すると、各インテントブランチに対応する接続ポートがノード上に表示されます。インテントが認識されると、そのブランチに接続された下流ノードが実行され、他のブランチ上のノードはスキップされます。その後、変数集約 ノードを使用して、各ブランチの実行結果を収集できます。

エージェント
エージェントノードを使用すると、大規模言語モデル (LLM) が計画を立て、ツールを選択し、自律的に実行できます。推論戦略とツール利用機能をサポートします。FunctionCalling と ReAct などの戦略を統合することで、実行時に モデルコンテキストプロトコル (MCP) に準拠したツールを LLM が自律的に呼び出し、マルチステップ推論を実現します。
ノードパラメータ
-
エージェント戦略:使用するエージェントの推論戦略を選択します。現在は、FunctionCalling と ReAct 戦略をサポートしています。
FunctionCalling
この機能は、OpenAI Chat API の構造化された
tool_calls定義 (JSON 形式) に基づき、大規模言語モデル (LLM) と外部ツールの連携を可能にします。LLM はユーザーの自然言語による指示を分析し、インテントを自動的に識別して適切なツールを選択し、パラメータを抽出します。その後、システムが該当ツールを呼び出し、その結果をモデルに返して追加の推論を行い、最終的な回答を生成します。ユースケースとメリット:
-
構造化された呼び出し、高い互換性:構造化データを使用してツール名と呼び出しパラメータを明確に定義するため、ツール呼び出しをサポートするすべてのモデルと互換性があります。
-
安定したパフォーマンス:天気の確認、情報検索、データクエリなど、目的が明確で手順が定義されたタスクに適しています。
ReAct
ReAct (Reasoning + Acting) は、プロンプトを使用してモデルが Thoughts と Actions を明示的に生成するように誘導し、マルチステップ推論とツール呼び出しのクローズドループを構築する柔軟な推論戦略です。この戦略は通常、呼び出しプロセスを自然言語で記述します。"Action=xxx, Action Input=xxx" などのテキストを出力してバックエンドのツール実行をトリガーし、その結果をモデルの推論チェーンに注入します。この方法では API レベルの
tool_callsを必要としないため、より汎用的なモデルやフレームワークに適しています。ユースケースとメリット:
-
推論能力の強化:モデルに段階的な思考を促し、各ステップで推論ロジックを明示的に表現させます。
-
戦略の透明性:デバッグ性と解釈性が求められるエージェントアプリケーションに最適です。
-
ツール呼び出しのサポートは不要:構造化出力をサポートしないモデルでも使用できます。
-
-
モデル設定:FunctionCalling 戦略では、ツール呼び出しをネイティブにサポートするモデルが必要です。ReAct 戦略にはこの制約はありませんが、推論能力が高いモデルを選択することを推奨します。
-
会話履歴:会話履歴を有効にすると、エージェントにコンテキストメモリが提供されます。システムは過去の会話メッセージをプロンプトに自動的に含めるため、エージェントは会話の前後関係を理解し、過去の内容を参照できます。たとえば、会話履歴が有効なエージェントは、ユーザーが情報を繰り返さなくても、代名詞 ("he" や "it" など) を解釈できます。
-
タスク計画:有効にすると、システムは組み込みの
write_todosツールをエージェントの利用可能なツールに自動的に追加します。複雑なユーザーの質問に対して、エージェントはwrite_todosツールを自動的に呼び出してタスクを計画し、ステップごとに実行します。また、最新の情報に基づいて計画を動的に更新します。 -
MCP ツールと非 MCP ツール:MCP ツールと非 MCP ツールの両方を設定できます。詳細については、「Configure tools for an Agent」をご参照ください。
-
プロンプト設定
-
入力変数:プロンプトでアプリケーションフローの上流ノードの変数を参照する場合は、現在のノードで対応する入力変数を定義し、その値を上流ノードの変数への参照として設定する必要があります。次の プロンプト セクションでは、二重中かっこ (
{{}}) で表される Jinja2 テンプレート構文を使用して、定義した入力変数を参照し、動的なデータ受け渡しを実現できます。 -
システムプロンプト:エージェントのタスク目標とコンテキストを指定し、応答生成を導くために必要な背景情報をモデルに提供します。ReAct 戦略では任意です。
-
ユーザープロンプト:ユーザーの入力またはクエリを受け取り、モデルの応答生成の基礎となります。
-
-
ループ回数:エージェントの最大実行サイクル数を 1~99 の範囲で設定します。エージェントは、次のいずれかの条件を満たすまでタスクを繰り返して応答を生成します:
-
LLM がツール呼び出しによって十分な情報を収集し、完全な結果を生成できると判断した場合。
-
設定した最大ループ回数に達した場合。
適切なループ回数を設定すると、応答の完全性と実行効率のバランスを取ることができます。 タスク計画 が有効な場合は、モデルが計画どおりにすべてのステップを十分に実行できるように、デフォルトの最大ループ回数を使用することを推奨します。
-
-
出力変数:
-
intermediate_steps:エージェントの実行における中間ステップを含む文字列です。
-
text:エージェントの最終出力を含む文字列です。
-
トレースとログ
アプリケーションフローページの右上にある [Run] をクリックすると、表示されるダイアログボックスの実行結果の下にトレースまたはログが表示されます。
-
中間出力の確認:ワークフロー内のエージェントノードの右上にある実行ステータスアイコンをクリックします。下部のドロワーで、出力内の
intermediate_stepsを確認して、エージェントの推論プロセスを確認します。 -
トレースの確認:現在の実行のトレース情報を確認し、各モデルリクエストのエージェントの入力と出力 (ツール呼び出しとリクエストパラメータを含む)、トークンコスト、および所要時間を把握できます。
-
ログの確認:アプリケーションフローでエラーが発生した場合 は、現在の実行ログを確認して、ノード実行プロセスの詳細を把握できます。
また、アプリケーションフローページの右上にある [Run] ボタンの右側のアイコンをクリックすると、実行履歴を確認できます。特定の実行レコードを選択して、そのトレースまたはログを確認します。
ドキュメント解析
システムの組み込みインテリジェントドキュメントパーサーと、AI Search Open Platform のドキュメント解析サービスの使用をサポートします。
-
組み込みパーサー:ドキュメントから構造化コンテンツとメタデータを抽出します。PDF、DOCX、PPTX、TXT、HTML、CSV、XLSX、XLS、JSONL、MD など、主要なドキュメント形式をサポートします。
-
AI Search Open Platform:高精度の構造化ドキュメント解析を実現し、タイトルや段落などの論理階層情報に加えて、テキスト、表、画像などのコンテンツ抽出をサポートします。これにより、ドキュメント抽出の有効性と精度が向上します。事前に AI Search Open Platform のモデルサービス接続を設定する必要があります。サポートされるファイル形式は PDF、DOCX、PPTX、TXT、HTML です。
このツールは RAG、要約、質問応答のシナリオをサポートします。設定画面は次のとおりです: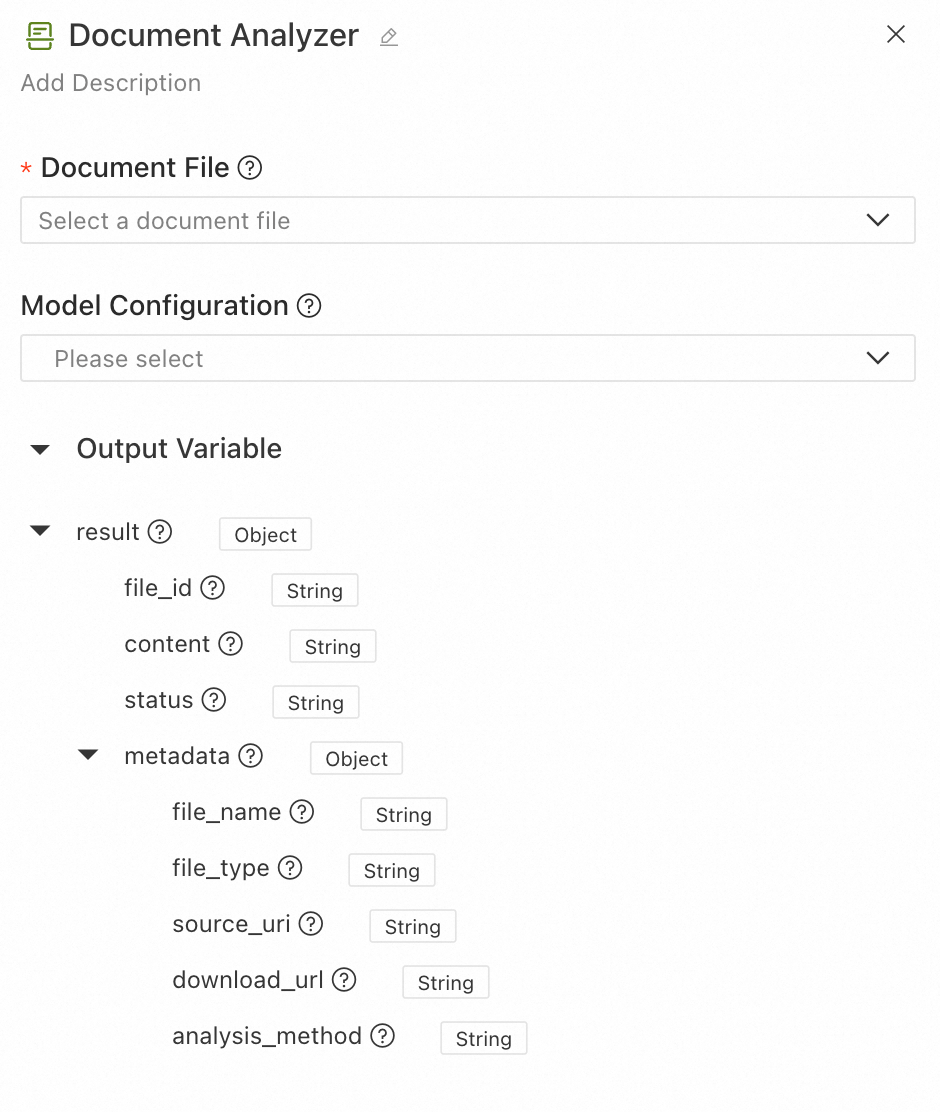
-
ドキュメントファイル:解析するドキュメントファイルです。上流ノードからファイルタイプのフィールドを選択します。
-
モデル設定:(任意) LangStudio で作成済みの AI Search Open Platform モデルサービス接続を選択します。設定しない場合、システムはデフォルトで組み込みの基本解析方法を使用します。
-
出力:
-
file_id:入力ファイルの一意の識別子です。
-
content:解析済みの構造化テキストコンテンツです。タイトルや段落などの階層情報を含みます。
-
status:解析ステータスです。SUCCESS または FAIL になります。
-
metadata:ドキュメントのメタデータと解析の詳細です。
-
file_name:ファイル名です。
-
file_type:ファイルタイプです。
-
source_uri:ファイルの元の URI です。
-
download_url:ファイルをダウンロードできる URL です。
-
analysis_method:使用した解析方法です。"opensearch" は AI Search Open Platform を使用した構造化解析を示し、"builtin" は組み込みの基本解析方法の使用を示します。
-
-
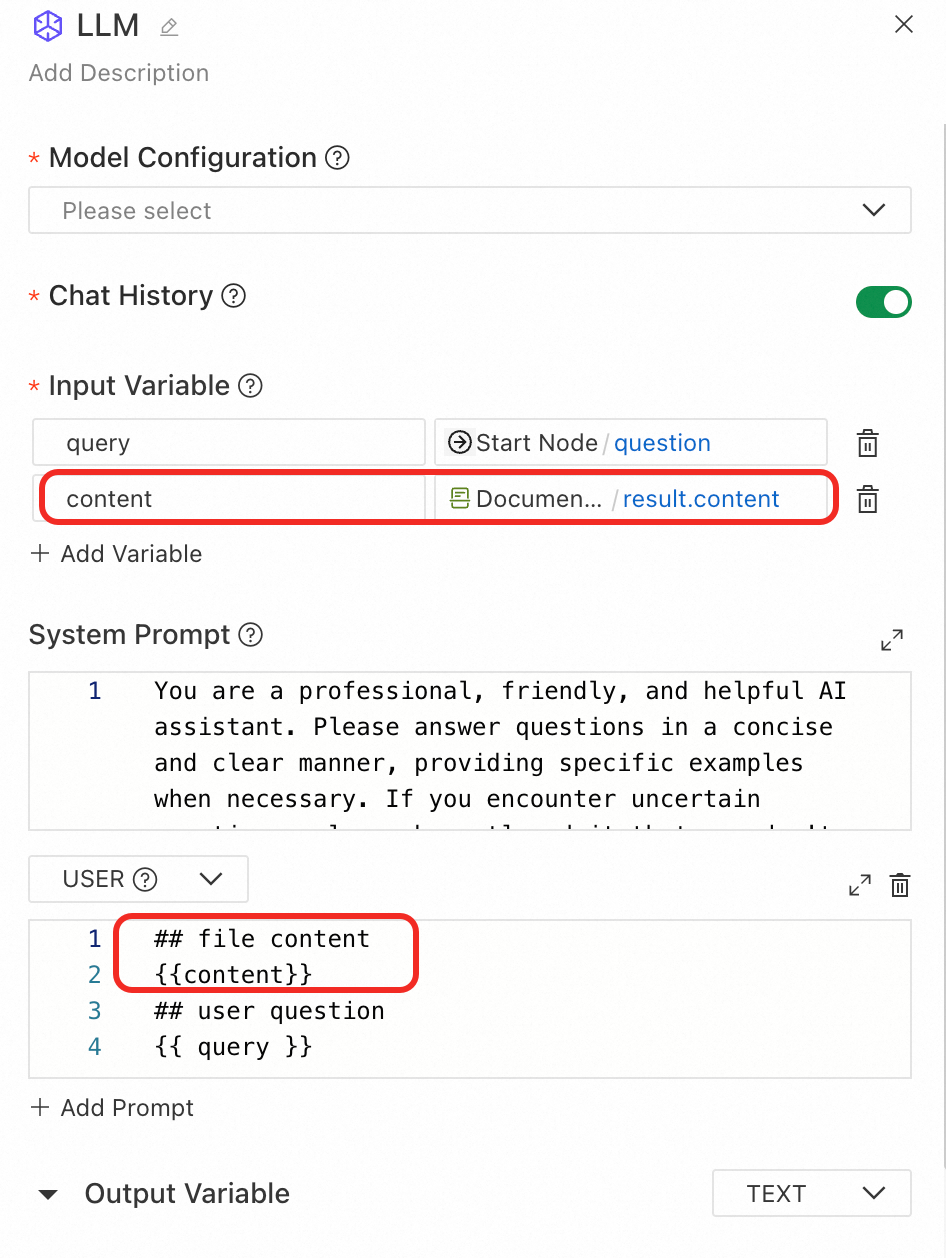
下流での使用例:下流ノードでは、必要に応じてドキュメント解析ノードの結果フィールドを参照します。LLM ノードでドキュメント解析結果を使用する場合は、次の例のように、解析済みコンテンツをユーザープロンプトに含めることができます:
音声認識
音声認識ノード を使用して、音声ファイルまたは動画ファイルをテキストに変換します。複数の音声形式と音声言語の認識をサポートします。
入力
-
モデル設定:音声認識モデルを設定します。Alibaba Cloud Model Studio が提供する音声認識サービスを現在サポートしています。認識精度の向上と多言語サポートのため、
paraformer-v2の使用を推奨します。 -
音声/動画ファイル:認識する音声ファイルまたは動画ファイルを選択します。サポートされる形式については、「File type input and output」をご参照ください。
-
認識言語:音声認識の言語を指定します。サポートされる言語は、中国語、英語、日本語、広東語、韓国語、ドイツ語、フランス語、ロシア語、または自動検出です。注:この機能は
paraformer-v2モデルでのみサポートされます。他のモデルでは、デフォルトで自動検出が使用されます。
出力
-
file_id:入力ファイルの一意の識別子です。
-
status:認識ステータスです。指定可能な値は
SUCCESSまたはFAILです。 -
content:文字起こしされたテキストコンテンツです。
-
segments:タイムスタンプ、テキストフラグメントなどの詳細を含む、文の断片情報のリストです。
-
metadata:次の情報を含むファイルのメタデータです:
-
file_name:ファイル名です。
-
file_type:ファイルタイプです。
-
source_uri:ファイルの URI です。
-
download_url:ファイルのダウンロード URL です。
-
データ取得
以下のノードを設定するには、「データ取得ノード」をご参照ください。
-
ナレッジベース取得
-
Alibaba Cloud IQS - Web 検索
-
SerpAPI - 汎用検索
-
HTTP リクエスト
データ処理
Python 開発 (Python)
アプリケーションフローは、複雑なデータ処理のためのカスタム Python コードを含むノードをサポートします。これらのノードは、ストリーミング入出力に対応しています。設定ページは次のとおりです。

Python コードを入力するだけです。入力と出力はコードから自動的に解析されます。次の点に注意してください。
-
エントリ関数は、ノードとして読み込まれるには、
@toolデコレーターで修飾する必要があります。説明Python ノードのストリーミング入力を有効にするには、
@tool(properties={"streaming_pass_through": True})を設定する必要があります。そうしないと、LLM などからの Python ノードへの入力は、ストリームではなく完全な出力テキストになります。 -
この関数は、int、float、bool、str、dict、TypedDict、dataclass (出力のみ)、list、および File の入出力タイプに対応しています。
-
エントリ関数のパラメーターは、ノードの入力として動的に解析されます。出力は
output辞書に格納され、他のノードから参照できます。重要Python ノードの入出力パラメーターの自動解析は、ランタイムに依存します。ランタイムが起動していない場合、ノードの入出力情報を設定することはできません。
-
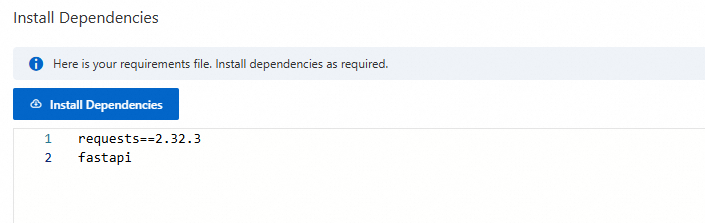
Python コードで依存関係が必要な場合は、キャンバスの右上隅にある [Install Dependencies] を選択し、必要なパッケージを入力します。
requirements.txtファイルはアプリケーションフローと共に保存されます。依存関係は、ランタイムを起動するか、サービスをデプロイするときにインストールされます。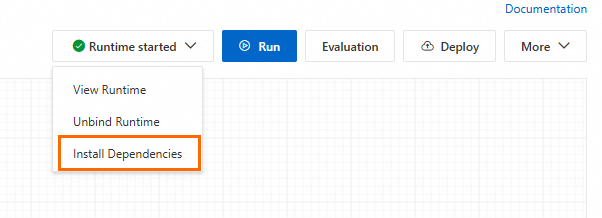
ユースケース 1:コードエリアに次のコードを入力します。コードはノードの入力と出力にマッピングされます。
from langstudio.core import tool
from dataclasses import dataclass

@dataclass
class Result:
    output1: str
    output2: int

@tool
def invoke(foo: str, bar: int) -> Result:
    return Result(
        output1="hello" + foo,
        output2=bar + 10
    )

ユースケース 2:ストリーミング入出力。Python ノードを使用して、思考プロセスを含む LLM またはエージェントノードからのテキストストリームをトリミングします。<think>\n\n</think> セクション内のコンテンツを破棄することで、最終的な結果のテキストストリームを取得できます。以下はその例です。
import re
from typing import Iterator
from langstudio.core import tool

@tool(properties={"streaming_pass_through": True})
def strip_think(
    stream: Iterator[str],
) -> Iterator[str]:  # 入力はストリーミング文字列イテレータ、出力はフィルタリングされたストリーミング文字列イテレータです。
    # <think>\n...\n</think> 構造に一致し、閉じタグの後のテキストをキャプチャします。
    pattern = re.compile(r"<think>\n[\s\S]*\n</think>(.*)")
    in_thinking = True  # 現在の位置が <think> ブロック内にあるかどうかを示すフラグ。
    think_buf = ""      # 未処理のコンテンツを格納するバッファー。

    for chunk in stream:
        if in_thinking:
            think_buf += chunk
            m = pattern.search(think_buf)  # バッファーに完全な思考ブロックが含まれているかどうかを確認します。
            if m:
                in_thinking = False
                result_part = m.groups()[0]
                if result_part:
                    yield result_part  # 結果のテキストが存在する場合、すぐに yield します。
        else:
            yield chunk  # 思考ブロックを抜けた後、後続のすべてのチャンクを直接 yield します。
テンプレート変換
テンプレート変換ツールは Jinja2 テンプレート構文を使用し、柔軟なテキストフォーマットとデータ変換を実現します。
入力
変換モードは、Jinja2 モードとノード参照モードに対応しています。
-
Jinja2 モード:完全な Jinja2 テンプレート構文を使用して出力形式をカスタマイズします。このモードは、複雑な構造化出力、条件付きロジック、およびループによるレンダリングに適しています。
-
テンプレート変数:テンプレートで使用される変数を定義します。
重要変数名を
items、keys、valuesのような Python の組み込みメソッド名にすることはできません。item_listやproduct_listのような特定のフィールド名を使用してください。 -
テンプレートコンテンツ:Jinja2 構文で書かれたテンプレート文字列です。変数置換
{{ variable }}、ループ{% for %}、条件文{% if %}、フィルター{{ value | filter }}を含む完全な構文をサポートしています。重要テンプレートで参照されるすべての変数は、変数リストで定義する必要があります。そうしないと、エラーが発生します。
-
-
ノード参照モード:上流ノードの出力を直接参照し、自動的に文字列に連結します。このモードは、単純なテキストの組み合わせに適しています。
-
テンプレートコンテンツ:上流ノードの出力フィールドを選択します。システムは選択したフィールドを順に自動的に連結します。
-
出力
output:テンプレートがレンダリングされた後のテキスト結果です。注:入力および出力テンプレートのコンテンツ長は、それぞれ 100,000 文字に制限されています。この制限を超えるコンテンツは切り捨てられます。
使用例
例 1:注文確認メールの生成
変数の設定:
|
変数名 |
変数値 |
|
customer_name |
|
|
order_id |
|
|
products |
|
|
total |
|
テンプレートコンテンツ:
{{ customer_name }} 様

ご注文 {{ order_id }} が確定いたしました。詳細は以下の通りです:

{% for product in products %}
- {{ product.name }}: ¥{{ product.price }}
{% endfor %}

合計: ¥{{ total }}

ご購入いただきありがとうございます!
出力結果:
田中一郎 様

ご注文 ORD-2025-001 が確定いたしました。詳細は以下の通りです:

- ノートパソコン: ¥8999
- ワイヤレスマウス: ¥199

合計: ¥9198

ご購入いただきありがとうございます!
例 2:ナレッジベース取得結果のフォーマット
変数の設定:
|
変数名 |
変数値 |
|
chunks |
|
テンプレートコンテンツ:
{% for chunk in chunks %}
### 関連性: {{ "%.2f" % chunk.score }}
#### {{ chunk.title }}
{{ chunk.content }}
---
{% endfor %}
出力結果:
### 関連性: 0.95
#### 製品紹介
これは製品の詳細な紹介です...
---
リスト操作
リスト操作ツールを使用すると、さまざまなタイプのリストデータに対して柔軟なフィルタリングとソートを実行でき、きめ細かいデータ処理と選択を行えます。
入力
-
入力リスト:処理対象のリストデータ。文字列、数値、ブール値、ファイルオブジェクト、辞書など、任意のサブタイプに対応しています。
-
操作:順に実行される一連の操作です。フィルタリングとソートの2種類の操作に対応しています。
-
フィルター操作 (filter):フィルター操作は、入力リストのタイプに基づいて、異なるフィルタリング方法を動的に提供します。注:すべてのフィルター操作は、大文字と小文字を区別します。
フィルターキー
説明
適用範囲
インデックス
リスト内の要素の位置に基づいてフィルタリングします。
すべてのリストタイプに適用されます。
要素の値
要素自体の値に基づいてフィルタリングします。
すべてのリストタイプに適用されます。
カスタム属性
カスタム属性に基づいてフィルタリングします。
辞書のリストにのみ適用されます。
ファイル属性
ファイルの属性に基づいてフィルタリングします。
ファイルのリストにのみ適用されます。
-
ソート操作 (sort):ソート操作は、入力リストのタイプに基づいて、異なるソート方法を提供します。
ソートキー
説明
適用範囲
要素の値
要素自体の値に基づいてソートします。
文字列、数値、またはブール値のリストにのみ適用されます。
カスタム属性
カスタム属性に基づいてソートします。
辞書のリストにのみ適用されます。
ファイル属性
ファイルの属性に基づいてソートします。
ファイルのリストにのみ適用されます。利用可能な属性は、フィルター操作と同じです。
-
出力
-
result:処理後のリスト。
-
first_item:結果リストの最初の要素。リストが空の場合、値は
Noneです。 -
last_item:結果リストの最後の要素。リストが空の場合、値は
Noneです。
使用例
例 1:ファイル分類 - 画像ファイルをフィルタリングし、ファイル名の長さでソートして上位 3 件を取得
シナリオ:ユーザーがさまざまなファイルタイプが混在したリストをアップロードします。画像ファイルをフィルタリングし、ファイル名の長さでソートし、後続の画像認識処理のために上位 3 件のみを保持する必要があります。
操作設定:
操作 1 - フィルター (ファイルカテゴリによる):
  フィルターキー:item.category
  フィルター演算子:equals
  フィルター値:image

操作 2 - ソート (ファイル名の長さによる):
  ソートキー:item.file_name
  ソート順:asc

操作 3 - フィルター (上位 3 件を取得):
  フィルターキー:index
  フィルター演算子:less than
  フィルター値:3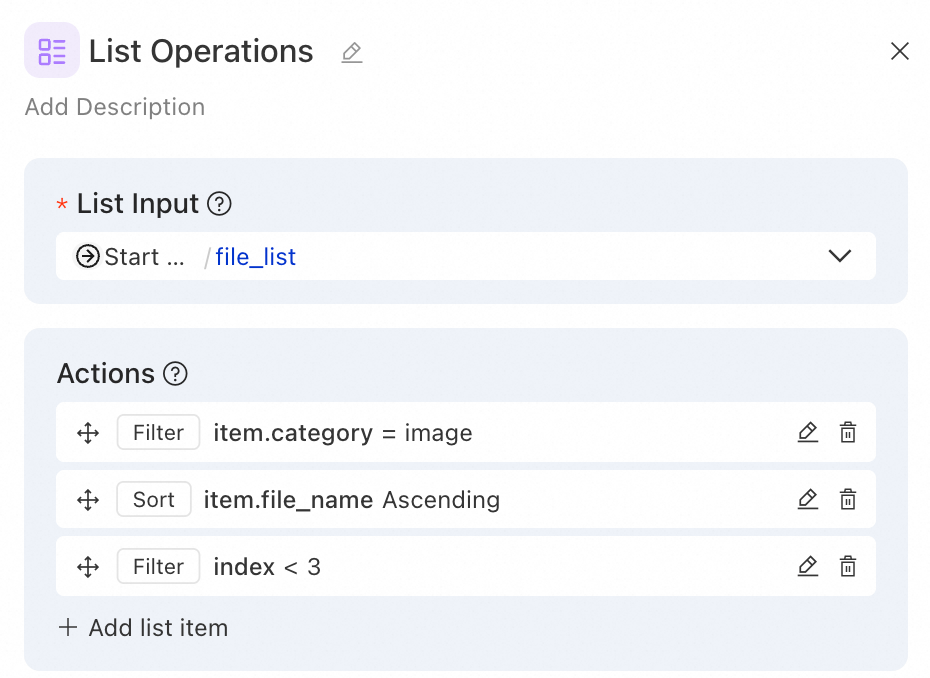
例 2:データ分析 - 高スコアのユーザーをフィルタリングし、上位 5 名を取得
シナリオ:ユーザー評価のリストから、スコアが 80 以上のユーザーをフィルタリングし、スコアの降順でソートして上位 5 名を取得します。
入力リスト:
[
  {"name": "佐藤 健", "score": 95, "department": "技術部"},
  {"name": "鈴木 一郎", "score": 72, "department": "マーケティング部"},
  {"name": "高橋 大輔", "score": 88, "department": "技術部"},
  {"name": "田中 誠", "score": 91, "department": "製品部"},
  {"name": "渡辺 徹", "score": 65, "department": "マーケティング部"},
  {"name": "伊藤 博", "score": 98, "department": "技術部"}
]
操作設定:
操作 1 - フィルター (高スコアのユーザー):
  フィルターキー:item.score
  フィルター演算子:greater than or equal to
  フィルター値:80

操作 2 - ソート (スコアの降順):
  ソートキー:item.score
  ソート順:desc

操作 3 - フィルター (上位 5 名を取得):
  フィルターキー:index
  フィルター演算子:less than
  フィルター値:5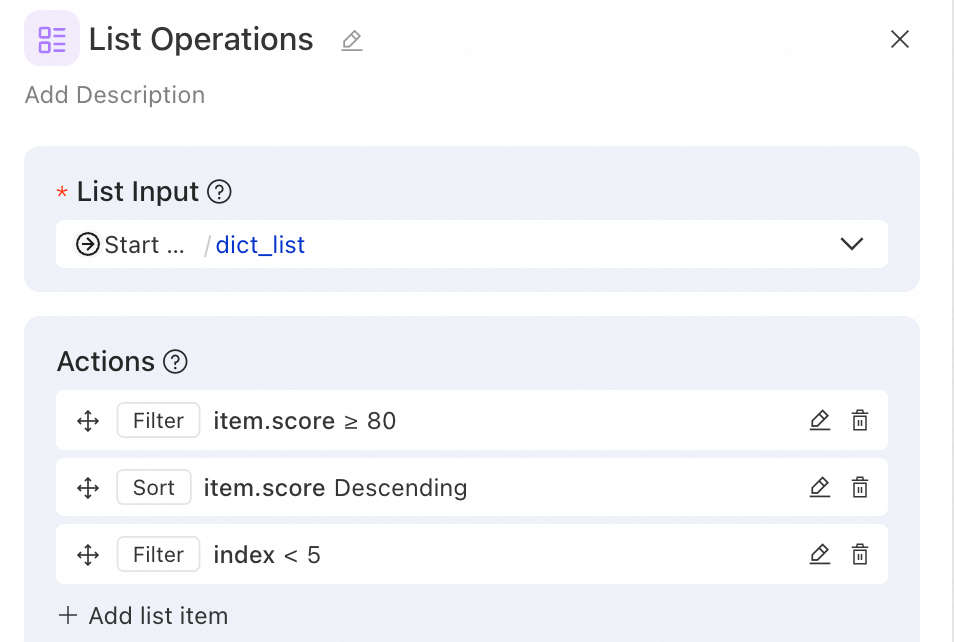
出力結果:
[
  {"name": "伊藤 博", "score": 98, "department": "技術部"},
  {"name": "佐藤 健", "score": 95, "department": "技術部"},
  {"name": "田中 誠", "score": 91, "department": "製品部"},
  {"name": "高橋 大輔", "score": 88, "department": "技術部"}
]
注意事項:
-
ツールの入力が Python ノードでカスタム定義された
list型の出力変数を参照する場合、Python ノードでリストの明確な要素型 (例:list[str]) を定義してください。これにより、リスト操作ノードでより正確な演算子マッチングが確保されます。