検索拡張生成 (RAG) は、大規模言語モデル (LLM) をプライベートナレッジベースに接続し、ドメイン固有のデータを用いて応答精度を向上させます。このガイドでは、LangStudio で RAG アプリケーションを開発してデプロイする手順を説明します。
背景情報
RAG モデルは、情報検索と生成 AI を組み合わせて、より正確で文脈に即した回答を提供します。金融や医療のように、正確な情報が重要な意思決定につながる分野では、従来の生成モデルでは必要なドメイン固有の知識が不足する場合があります。RAG は、モデルを外部ナレッジベースに接続することで、このギャップを埋めます。このガイドでは、Platform for AI (PAI) 上に構築した金融および医療向けの RAG ソリューションを説明します。
前提条件
LangStudio は、ベクトルデータベースとして Faiss と Milvus をサポートしています。Milvus を使用する場合は、最初に Milvus インスタンスを作成する必要があります。
説明Faiss はテスト環境に適しており、追加のデータベース設定は不要です。本番環境では、より大規模なデータをサポートする Milvus を使用してください。
RAG ナレッジベースのコーパスは、Object Storage Service (OSS) にアップロードする必要があります。次のサンプルコーパスが、金融および医療のユースケース向けに提供されています:
Financial News:PDF 形式のデータで、公開ニュース Web サイトのニュースレポートが含まれます。
Disease Introductions:CSV 形式のデータで、Wikipedia の疾患情報が含まれます。
1. (オプション) LLM と埋め込みモデルのデプロイ
RAG アプリケーションフローには、LLM サービスと埋め込みモデルサービスの両方が必要です。必要なサービスは、以下の説明に従って [Model Gallery] からデプロイできます。OpenAI API 互換のモデルサービスがすでにある場合は、この手順をスキップできます。
QuickStart > Model Gallery に移動し、次の 2 つのシナリオ向けにモデルをデプロイします。詳細については、「Model deployment and training」をご参照ください。
指示チューニング済みの LLM を選択してください。ベースモデルは、ユーザーの指示に確実に従うことができません。
[Scenario] で 大規模言語モデル を選択し、DeepSeek-R1-Distill-Qwen-7B をデプロイします。
[Scenario] で [embedding] を選択し、[bge-m3 general vector model] をデプロイします。
2. 接続の作成
このセクションの LLM および埋め込みモデルの接続は、[QuickStart] > [Model Gallery] からデプロイした Elastic Algorithm Service (EAS) サービスを使用します。その他の接続タイプについては、「Configure connections」をご参照ください。
2.1 LLM サービス接続の作成
LangStudio でワークスペースを選択し、サービス接続設定 > モデルサービス タブに移動して、接続の作成 をクリックし、汎用 LLM モデルサービス接続を作成します。
主要なパラメーター:
パラメーター | 説明 |
Model name | [Model Gallery] からモデルをデプロイした場合は、Model Gallery ページでモデルカードをクリックし、詳細ページでモデル名を確認します。詳細については、「Create a connection - Model Service」をご参照ください。 |
サービスプロバイダー |
|
2.2 埋め込みモデルサービス接続の作成
手順 2.1 と同じ手順に従って、汎用の埋め込みモデルサービス接続を作成します。
接続の作成 ページで、接続タイプを 汎用埋め込みモデルサービス接続 に設定し、サービスプロバイダーとして [PAI-EAS Model Service] タブを選択します。次のパラメーターを設定します:
EAS サービス:デプロイ済みの EAS 埋め込みモデルサービスインスタンスを選択します。
Model name:
defaultを入力します。base_url:EAS サービスのエンドポイントです。api_key:EAS サービスの API キーです。
2.3 ベクトルデータベース接続の作成
サービス接続設定 > データベース タブで 接続の作成 をクリックし、Milvus データベース接続を作成します。
主要なパラメーター:
パラメーター | 説明 |
| Milvus インスタンスのエンドポイントを 内部エンドポイントは、Alibaba Cloud コンソールの Milvus インスタンス詳細ページで確認できます。 |
| Milvus インスタンスのユーザー名とパスワード: |
| データベース名です。このトピックではデフォルトデータベース |
3. ナレッジベースインデックスの作成
ナレッジベースインデックスを作成します。LangStudio はコーパスをドキュメント解析し、チャンク化してベクトル化し、結果をベクトルデータベースに格納します。次の表は主要なパラメーターを示します。その他の設定については、「Manage knowledge bases」をご参照ください。
パラメーター | 説明 |
基本設定 | |
Data source OSS path | 前提条件 で説明した RAG ナレッジベースのコーパスの OSS パスに設定します。 |
Output OSS path | ドキュメント解析の中間結果とインデックスメタデータを格納するパスを指定します。 重要 ベクトルデータベースとして Faiss を使用する場合、アプリケーションフローは生成されたインデックスファイルを OSS に保存します。デフォルトでは、デフォルトの PAI ロール (ランタイムを開始する際に設定する [RAM ロール]) を使用すると、アプリケーションフローはワークスペースのデフォルトストレージバケットにアクセスできます。そのため、このパラメーターは、現在の ワークスペースのデフォルトストレージパスを含む OSS バケット内のディレクトリに設定することを推奨します。カスタムロールを使用する場合は、OSS アクセス権限を付与してください。AliyunOSSFullAccess 権限を推奨します。詳細については、「Manage permissions for a RAM role」をご参照ください。 |
埋め込みモデルとデータベース | |
Embedding type | 汎用埋め込みモデル を選択します。 |
Embedding connection | 手順 2.2 で作成した埋め込みモデルサービス接続を選択します。 |
Vector database type | [Vector database Milvus] を選択します。 |
Vector database connection | 手順 2.3 で作成した Milvus データベース接続を選択します。 |
Table name | このパラメーターには、「前提条件」で説明されているように、ご使用の Milvus データベースで作成したコレクションの名前を設定します。 |
VPC 設定 | |
VPC configuration | Milvus インスタンスの VPC と同一、または Milvus インスタンスの VPC と通信可能な VPC を選択します。 |
4. RAG アプリケーションフローの作成と実行
LangStudio に移動し、ワークスペースを選択します。次に [Application Flow] タブで [New Application Flow] をクリックして、RAG アプリケーションフローを作成します。
ランタイムを起動します。右上隅で ランタイムの作成 をクリックし、パラメーターを設定します。注意:Python ノードを解析したり、より多くのツールにアクセスしたりするには、ランタイムが実行中である必要があります。
主要なパラメーター:
VPC Configuration:前提条件 で Milvus インスタンスを作成した際に使用した VPC を選択するか、選択した VPC が Milvus インスタンスの VPC と通信可能であることを確認します。
アプリケーションフローを開発します。
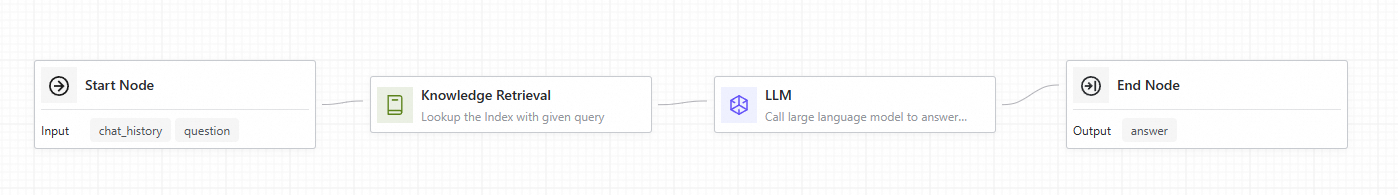
他のノードはデフォルト設定のままにするか、必要に応じて調整します。主要なノードは次のとおり設定します:
ナレッジ検索:ユーザーの質問に関連するテキストをナレッジベースから取得します。
Knowledge base index name:手順 3 で作成したナレッジベースインデックスを選択します。
トップ K:一致度が高い上位 K 件の結果を返します。
LLM ノード:取得したドキュメントをコンテキストとして使用し、ユーザーの質問とともに LLM に送信して応答を生成します。
Model configuration:手順 2.1 で作成した接続を選択します。
チャット履歴:チャット履歴を有効にし、過去の会話を入力変数として使用するかどうかを指定します。
各コンポーネントの詳細については、「Pre-built Component Library」をご参照ください。
フローをデバッグまたは実行します。右上隅で 実行 をクリックしてフローを実行します。一般的なランタイムの問題については、「FAQ」をご参照ください。
トレースを表示します。生成された回答の下にある トレースの表示 をクリックして、トレースの詳細またはトポロジーを表示します。
5. アプリケーションフローのデプロイ
アプリケーションフローの開発ページで、右上隅にある デプロイメント をクリックし、アプリケーションフローを EAS サービスとしてデプロイします。他のデプロイ設定はデフォルトのままにするか、必要に応じて調整します。次の主要なパラメーターを設定します:
Resource deployment > Instances:サービスインスタンス数を設定します。このデプロイはテスト目的のため、インスタンス数を 1 に設定します。本番環境では、単一障害点 (SPOF) のリスクを軽減するために、複数のサービスインスタンスを使用することを推奨します。
VPC > VPC:Milvus インスタンスが配置されている VPC を選択するか、選択した VPC が Milvus インスタンスの VPC と通信可能であることを確認します。
デプロイの詳細については、「Deploy an application flow」をご参照ください。
6. サービスの呼び出し
デプロイ後、PAI-EAS コンソールにリダイレクトされます。オンラインデバッグ タブで、リクエストを設定して送信します。リクエストボディのキーは、アプリケーションフローの "Start" ノードの "Dialogue input" パラメーターと一致している必要があります。このガイドでは、デフォルトのフィールド question を使用します。
リクエスト設定エリアで [POST] メソッドを選択し、リクエストボディを raw JSON として入力します。例:
{"question": "What is the share price of NVIDIA"}
[Send Request] をクリックします。右側の Response エリアに、ステータスコード 200 とともに、ナレッジベースインデックスを介して取得した株価情報を含む JSON レスポンスが返されます。
API を使用するなど、その他のサービス呼び出し方法については、「Call the service」をご参照ください。