AI Search Open Platform は、インテリジェント検索と検索拡張生成 (RAG) のシナリオ向けに、コンポーネント型のアルゴリズムサービスを提供します。ドキュメント解析、チャンキング、テキスト埋め込み、クエリ分析、検索、ソート、パフォーマンス評価、大規模言語モデル (LLM) による生成まで、パイプライン全体をカバーします。各ステージは独立した呼び出し可能なサービスとして公開しています。ユースケースに必要なコンポーネントのみを選択してください。
有効化は無料です。Alibaba Cloud の新規アカウントでは、アカウント内のすべての RAM ユーザーで共有できる 10 回の無料サービス呼び出しをご利用いただけます。無料呼び出しを使い切った後は、LLM サービスの実際の呼び出し量に基づいて課金されます。 今すぐ有効化
ユースケース
検索拡張生成 (RAG) と対話型検索
ナレッジベース、インテリジェントカスタマーサービスシステム、対話型検索アプリケーションを構築します。典型的なクエリ:「X を設定する手順は?」や「このドキュメントの要点を要約してください。」など。
-
インテリジェントカスタマーサービス
-
対話型検索
-
ナレッジグラフの強化
-
パーソナライズドレコメンデーション
詳細については、「Build a RAG-based conversational search application」をご参照ください。
マルチモーダル検索
意味理解と視覚認識を用いて、テキストと画像コンテンツを横断的に検索します。典型的なクエリ:画像ベースの検索、クロスモーダルなコンテンツ発見、OCR を活用したドキュメント検索。
-
E コマースと小売
-
ニュースコンテンツ
-
ゲーム
-
ヘルスケア
-
金融
詳細については、「Multi-modal search business development」をご参照ください。
仕組み
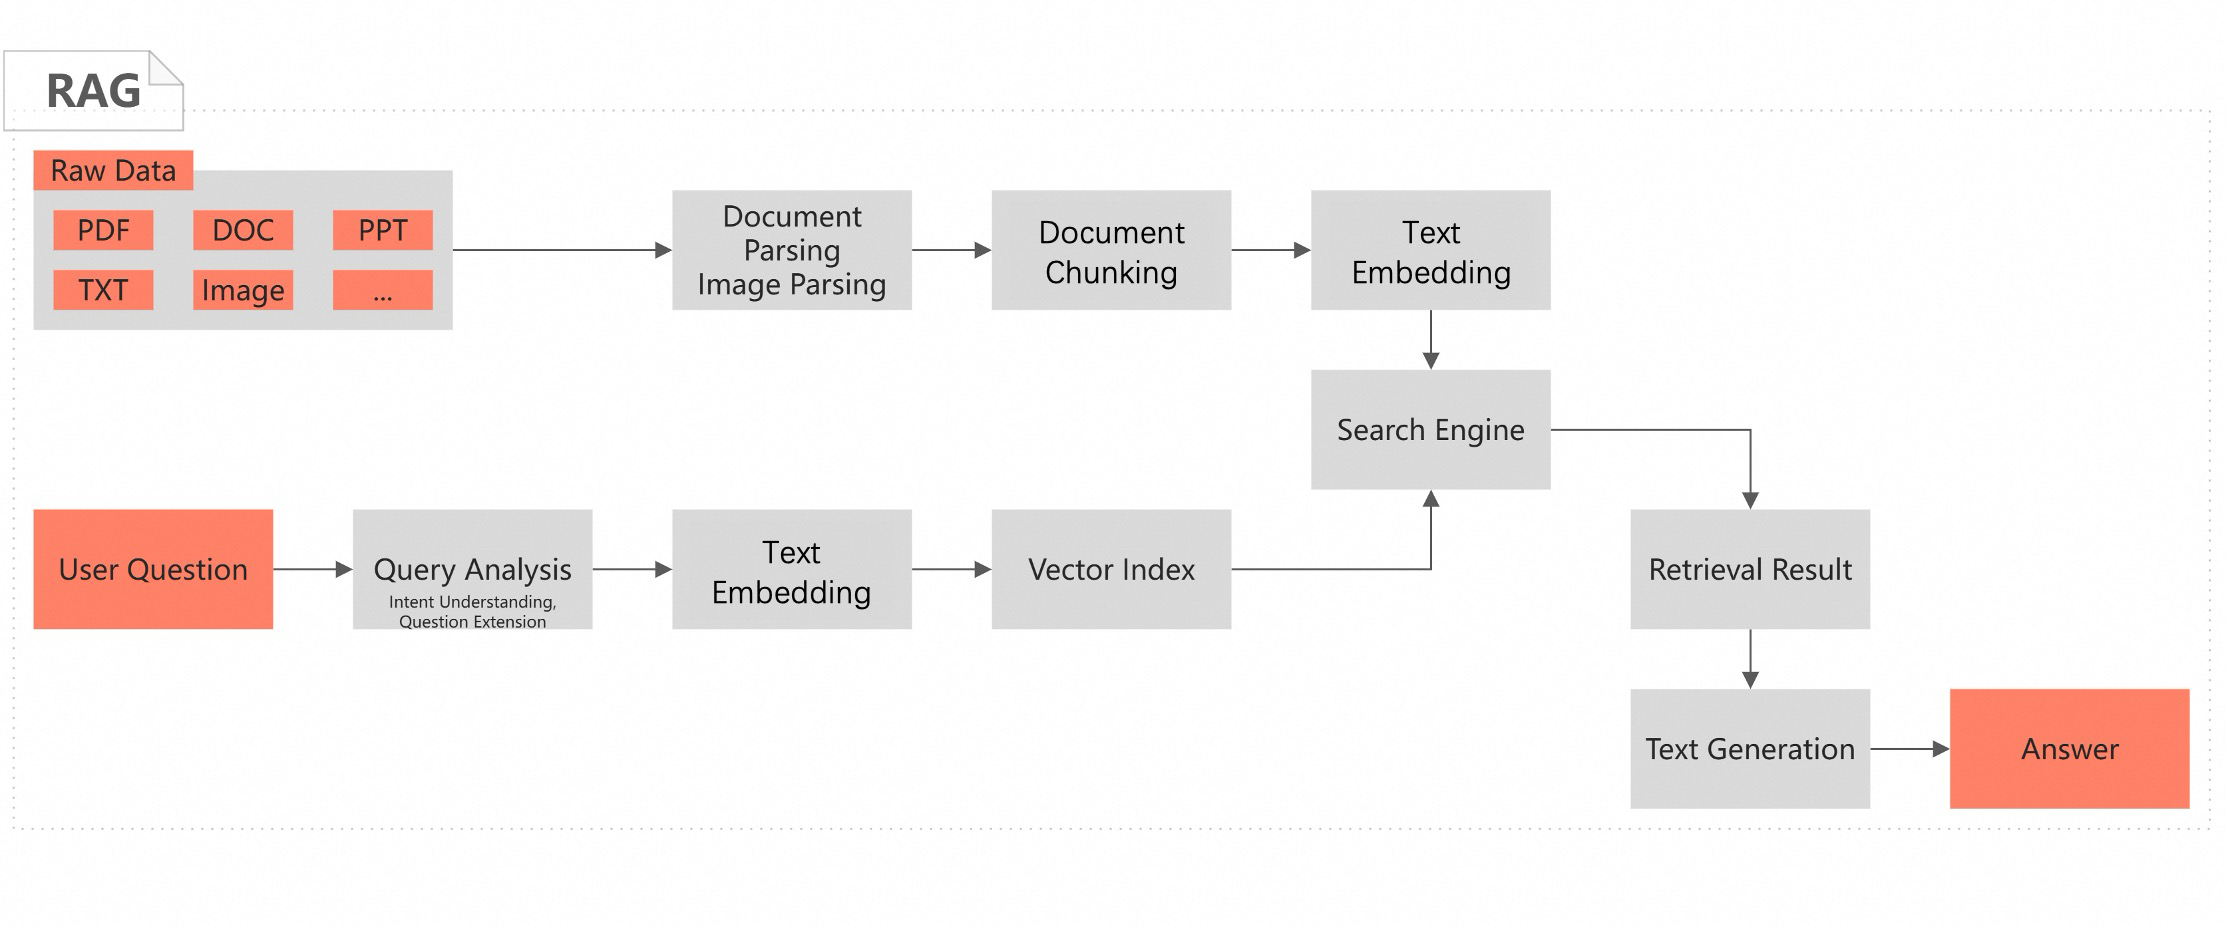
AI Search Open Platform は、モジュール型パイプラインでデータを処理します。各ステージは独立した呼び出し可能なサービスです:
-
ドキュメントの解析:PDF、DOC、HTML、TXT などの形式から、テキスト、表、画像、コードを抽出します。分単位の解析速度。
-
コンテンツのチャンキング:セマンティック情報と段落構造に基づいてドキュメントを分割します。生成されるチャンクツリーは、検索時のコンテキスト補完をサポートします。
-
テキストの埋め込み:多言語の埋め込みモデルを使用して、チャンクを密なベクトルまたは疎なベクトルに変換します。両方を組み合わせてハイブリッド検索を実現できます。
-
クエリの分析:大規模言語モデル (LLM) と自然言語処理 (NLP) の機能を使用して、ユーザーの意図を理解したり、類似質問を拡張したり、自然言語を SQL に変換したりします。
-
結果の検索:インデックス化されたデータに対して、ベクトル検索とテキスト検索を実行します。
-
ソートとランキング:クエリレベルおよびドキュメントレベルのソートを適用し、最も関連性の高いコンテンツを上位に表示します。
-
回答の生成:組み込みの LLM を使用して、検索結果に基づいた回答を生成します。
機能
ドキュメントコンテンツの解析
PDF、DOC、HTML、TXT などの形式を分単位の速度で解析します。レイアウトを識別し、論理構造 (タイトル、段落) を抽出し、テキスト、表、画像、コードなどのコンテンツ要素を特定します。ヘッダーとフッターを削除し、上付き文字と下付き文字を検出します。構造化された形式で出力します。
画像コンテンツの解析
マルチモーダルな LLM を使用して、アーキテクチャ図や分析チャートなどの画像コンテンツを解析します。光学文字認識 (OCR) をサポートし、画像からテキストを抽出して、画像検索や画像を利用した Q&A に利用できます。
ドキュメントのチャンキング
セマンティック情報、段落構造、および設定可能なルールに基づいてドキュメントを分割します。検索時のコンテキスト補完のためにチャンクツリーを生成します。
多言語埋め込みモデル
-
テキスト埋め込み:テキストを密なベクトルに変換します。複数のモデルが、言語、入力長、出力次元の違いに対応しています。検索、テキスト分類、関連度比較に使用できます。
-
スパース埋め込み:テキストを疎なベクトルに変換し、ストレージ使用量を抑えます。キーワードと高頻度語を捉えます。密なベクトルと組み合わせてハイブリッド検索を行うことで、検索パフォーマンスを向上できます。
-
埋め込みモデルのチューニング:検索品質に大きな影響を与えずにベクトル次元を削減するために、次元削減モデルをトレーニングします。
クエリ分析
LLM と NLP を使用してクエリを分析し、ユーザーの意図を理解したり、類似質問を拡張したり、自然言語を SQL に変換したりします。検索拡張生成 (RAG) シナリオにおける対話型検索の精度を向上させます。
検索エンジン
ベクトル検索エンジンとテキスト検索エンジンを提供します。ベクトルとテキストを保存し、インデックスを作成して、オンラインのベクトル検索とテキスト検索を実行します。これらのエンジンを AI Search Open Platform API と組み合わせることで、データの処理と検索をエンドツーエンドで実行できます。
ソート
検索拡張生成 (RAG) および検索シナリオにおいて、クエリレベルおよびドキュメントレベルのソートを適用し、最も関連性の高いコンテンツを上位に表示します。検索精度と LLM が生成する回答の品質を向上させます。
LLM によるテキスト生成
DeepSeek モデルの全シリーズ、Qwen シリーズ (Qwen-Turbo、Qwen-Plus、Qwen-Max) など、幅広いモデルを提供します。組み込みの OpenSearch-Qwen-Turbo モデルは qwen-turbo をベースとしており、教師ありファインチューニングにより検索拡張生成 (RAG) 機能を強化し、ハルシネーション率を低減させます。
メリット
-
エンドツーエンドのパイプラインで、組み立て不要:すべてのサービスは有効化後すぐに利用できます。検索または検索拡張生成 (RAG) のパイプラインの各ステージごとに個別ツールを統合する代わりに、解析、埋め込み、検索、ランキング、生成を単一のプラットフォームでカバーできます。
-
必要なものだけを呼び出し、不要なものは省略:開発者、エンタープライズ顧客、独立系ソフトウェアベンダー (ISV) は、個別の API 操作を呼び出すか、SDK を使用して任意のサービス群を統合できます。モジュール型設計により、アーキテクチャを使用するコンポーネントのみで構成できます。
-
検索最適化済みモデルをすぐに利用可能:AI Search Open Platform では、主要な基盤モデルの上に専用の AI 検索モデルをトレーニングできます。組み込みの OpenSearch-Qwen-Turbo モデルは検索拡張生成 (RAG) 向けに特化してファインチューニングされており、汎用モデルと比べてハルシネーションを低減させます。
-
実証済みの検索パターンに基づく設計:パイプライン設計には、インテリジェント検索と検索拡張生成 (RAG) における長年の知見が反映されています。ベストプラクティスが組み込まれているため、何が有効かを学ぶ時間を減らし、構築に集中できます。