Data Science Workshop (DSW) に関するよくある質問への回答を掲載しています。
まず PAI Agent に質問する
PAI コンソールの右上隅にある  アイコンをクリックして、PAI AI アシスタント (Agentic PAI) を起動します。Agentic PAI は、エンドツーエンドの PAI プロダクトのユーザーマニュアルと操作ガイドラインを提供します。DSW インスタンス、DLC タスク、および EAS サービスの O&M 診断をサポートし、障害の根本原因を自動的に特定し、トラブルシューティングの推奨事項を提供します。
インスタンスの起動
Q: DSW インスタンスの起動に失敗する
トラブルシューティング:インスタンス名をクリックし、イベント タブでエラーメッセージを確認します。
一般的なエラーと解決策:
その他の起動失敗の原因:
アカウントの滞納
アカウントが滞納している場合、DSW インスタンスの作成は失敗します。クーポンは滞納額の相殺には使用できません。請求とコストコンソールにログインして、アカウントの残高を確認してください。
Q: リソースクォータまたは計算リソースクォータが不足しています。どうすればよいですか?
一般的なエラーメッセージ:
"Your requested resource type [ecs.] is not enough currently" (在庫切れ)
"Your resource usage has exceeded the default limitation" (リージョンあたり 2 GPU の制限を超過)
"The cluster resources are fully utilized" (すべての計算リソースが使用中)
根本原因の分析:
共有リソースの不足
共有リソースは複数のユーザーによって使用されるため、ピーク時間帯には枯渇することがあります。
ハイエンドの GPU タイプは、より在庫切れになりやすいです。
各アカウントは、リージョンごとに 2 GPU に制限されています。
専用リソースクォータの枯渇
専用リソースクォータを購入しましたが、すべて使用済みです。
クォータの割り当てが不均一で、特定のワークスペースに十分なクォータがありません。
解決策:
リソースタイプの切り替え:現在の GPU タイプが在庫切れの場合、別のタイプを試してください。
リージョンの切り替え:PAI コンソールの左上にあるリージョンセレクターを使用して、別のリージョンを試してください。
GPU クォータの引き上げ:2 つ以上の共有 GPU カードを使用するには、チケットを送信してください。
専用リソースの購入:安定したリソースの可用性を確保するために、専用リソースクォータの購入を検討してください。詳細については、「汎用計算リソースの購入」および「リソースクォータの管理」をご参照ください。
Q: DSW インスタンスが保留中で、GPU リソースキャッシュのメッセージが表示されます。これはどういう意味ですか?
GPU リソースキャッシュのメッセージは、要求された GPU リソースが現在別のタスクによって占有されており、ご利用のインスタンスがリソースの解放を待ってキューに入っていることを意味します。待機中、システムはインスタンスの状態をキャッシュし (保留中と表示)、リソースが利用可能になるとインスタンスは自動的に再開します。
これは、ユーザーのエラーやシステムの障害を示すものではなく、プラットフォームのリソーススケジューリングメカニズムの正常な一部です。
Q: 特定の DSW インスタンスタイプの在庫や再入荷時間を確認するにはどうすればよいですか?
PAI-DSW コンソールでは、特定のリージョンにおける特定のインスタンスタイプ (例:
ecs.gn7iや A100) のリアルタイム在庫や正確な再入荷時間を直接照会することはできません。パブリックリソースは複数のユーザーで共有されており、在庫は動的に変化するため、正確な再入荷時間を提供することはできません。
インスタンスの作成時に「在庫切れ」またはリソース不足が報告された場合は、別のリージョンに切り替える、別の利用可能なインスタンスタイプを選択する、またはオフピーク時間帯に再試行してください。
リソースの可用性を保証するためには、専用リソースクォータの購入を検討してください。
Q: 作成後に DSW インスタンスのリソースタイプを変更できますか?
いいえ。リソースタイプの変更 (例:専用リソースからパブリックリソースへ、またはその逆) はサポートされていません。現在インスタンスが専用リソースを使用しているが、SSH 設定などパブリックリソースでのみ利用可能な機能が必要な場合は、代わりに proxyclient メソッドを使用してインスタンスにアクセスするか、要件を満たすパブリックリソースタイプで新しいインスタンスを作成してください。
Q: DSW は起動時に Python スクリプトを自動的に実行できますか?
DSW インスタンスを作成するとき、またはインスタンスの設定を変更するときに、カスタム起動スクリプト パラメーターを見つけて設定します。
このパラメーターを使用すると、インスタンスの起動中に環境をカスタマイズしたり、初期化タスクを実行したりできます。カスタムスクリプトは、イメージとリソースの準備が完了した後、JupyterLab、Code Server、およびその他の開発ツールが起動する前に実行されます。
タイムアウトは 3 分です:カスタムスクリプトはインスタンスの起動時間を延長します。イメージのダウンロードなどの長時間実行されるタスクをカスタムスクリプトで実行しないでください。
スクリプトのログは、インスタンスの起動後
/var/log/user-command/で利用できます。
Q: DSW ページが応答しない、または異常な動作をします。どうすればよいですか?
空白のページ、無限にロードされるノートブック、入力を受け付けないターミナル、または「504 Gateway Timeout」のようなブラウザエラーが表示される場合、問題は通常、ローカル環境またはインスタンスの状態に関連しています。以下を試してください:
ブラウザのキャッシュをクリアして再試行します。
ブラウザのシークレットモードまたはプライベートモードを使用します。
ネットワークを切り替えます (例:企業ネットワークからモバイルホットスポットへ)。これにより、ファイアウォールの制限を除外できます。
別のブラウザ (Chrome または Firefox) を試します。
504 タイムアウトエラーが表示された場合は、PAI コンソールから DSW インスタンスを停止して再起動します。ステータスが [実行中] に変わった後、インスタンスにアクセスします。
Q: クラウドディスクを使用する DSW インスタンスの停止、再起動、タイプ変更、またはイメージ変更によってデータは失われますか?
システムディスクとしてクラウドディスクを持つ DSW インスタンスには、共有リソースグループで作成されたインスタンス、およびシステムディスクタイプとして ディスク が選択されている汎用リソースインスタンスが含まれます。データ損失の動作は操作によって異なります:
インスタンスの停止:データが失われる可能性があります。クラウドディスクが拡張されておらず、インスタンスが 15 日以上停止している場合、データはクリアされ、回復できません。ディスクが拡張されているか、インスタンスが 15 日未満停止している場合、データは保持されます。
インスタンスの再起動:データ損失はありません。停止または再起動後、
pipを介してインストールされたすべてのパッケージ、コードファイル、およびシステムディスクに保存されているその他のデータは保持されます。インスタンスタイプの変更:データ損失はありません。リソース設定 (CPU、メモリ、GPU など) を変更しても、システムディスクのデータには影響しません。
インスタンスイメージの変更:データが部分的に失われる可能性があります。イメージを変更しても、マウントされたデータセットや Object Storage Service (OSS) ストレージには影響しませんが、システムディスクの内容がリセットされる場合があります。イメージを変更する前にデータをバックアップしてください。たとえば、データセットや OSS にコピーします。詳細については、「データセット、OSS、NAS、または CPFS のマウント」をご参照ください。
システムディスクタイプとして 一時ストレージ が選択されている汎用リソースインスタンスの場合、AI リソースグループに前払いのクラウドディスクがあるかどうかに関係なく、停止、再起動、タイプ変更、またはイメージ変更を行うと、システムディスクのデータは失われます。
Q: 15 日間非アクティブだったためにリリースされた共有リソースの DSW インスタンスからデータを回復できますか?
共有リソースグループで作成された DSW インスタンスの場合:システムディスクが拡張されておらず、停止後 15 日間連続してインスタンスが起動されていない場合、システムディスクは自動的にクリアされ、回復できません。
Q: DSW インスタンスの初回起動が、それ以降よりも遅いのはなぜですか?
初回起動では完全なイメージのプルが必要であり、イメージのサイズやネットワーク状況によっては 10 分以上かかることがあります。イメージがキャッシュされるため、それ以降の起動は速くなります。
起動時間が徐々に長くなっている場合は、保存されたカスタムイメージが大きくなりすぎている可能性があります。不要なファイルをクリーンアップしてイメージを再保存するか、軽量の公式イメージに切り替えてください。
インスタンスの停止、削除、およびリリース
Q: DSW インスタンスをリリースするにはどうすればよいですか?
DSW インスタンスリストの右側の操作列にある [停止] または [削除] アクションを使用します。
重要:システムディスクを拡張した場合、インスタンスが停止していてもストレージ料金が発生し続けます。DSW 関連のすべての課金を停止するには、インスタンスを削除してください。
Q: DSW インスタンスが見つかりません。どうすればよいですか?
別のリージョンまたはワークスペースに切り替えてみてください。
Q: 無料トライアルのクレジットパッケージをリリースするにはどうすればよいですか?
無料トライアルのクレジットパッケージは、リリースや停止の必要はありません。
Q: すべての DSW 課金を停止するにはどうすればよいですか?「停止」と「削除」の違いは何ですか?
停止:計算リソース (CPU/GPU) を解放し、コンピュート料金を一時停止します。注意:拡張されたシステムディスクは料金が発生し続けます。
削除:インスタンスとシステムディスクを含むすべてのリソースを完全に削除します。関連するすべての課金が完全に停止します。
選択の基準:
停止:一時的に作業を終えたが、将来の再起動のためにデータと環境を保持したい場合。
削除:インスタンスが不要になり、すべての課金を停止したい場合。続行する前にデータをバックアップしてください。
Q: DSW インスタンスが長時間「停止中」または「削除中」の状態です。何が起こっていますか?
DSW インスタンスを停止すると、システムは現在のコンテナの読み書きレイヤーを保存してイメージキャッシュを自動的に構築し、次回の起動を高速化します。これはシステム障害ではなく、想定される動作です。コンテナレイヤーに大量のデータが書き込まれた場合、キャッシュの構築には数分から数時間かかることがあります。
共有リソースグループで作成された DSW インスタンスは、「停止中」、「保存中」、または「削除中」の状態ではコンピュート料金は発生しません。
インスタンスの停止に時間がかかる一般的な原因は次のとおりです:
コンテナの読み書きレイヤーが大きい:これが最も一般的な原因です。多くのパッケージのインストール、モデルファイルのダウンロード、またはデータセットのシステムディスクへの保存はすべて、レイヤーサイズを増加させ、停止時間を延長します。
インスタンス内のプロセスが正常に終了しなかった。
メモリ使用量が高く、インスタンスがシャットダウンコマンドに応答できない。
停止を高速化するためのヒント:
停止する前に、[イメージの保存] 機能を使用して、保存する必要のない大きなファイルやディレクトリ (モデルファイルやデータセットなど) の除外パスを設定します。これにより、停止時間を大幅に短縮できます。詳細については、DSW インスタンスイメージの保存に関するトピックをご参照ください。
大きなデータはシステムディスクではなく、マウントされた OSS または NAS パスに保存します。これにより、コンテナの読み書きレイヤーのサイズが根本的に削減されます。
インスタンスが不要で、データの保持を気にしない場合は、[削除] してリソースをすぐに解放します。
停止に時間がかかりすぎる場合は、しばらくお待ちください。2 時間経っても完了しない場合は、テクニカルサポートにチケットを送信してください。
Q: DSW インスタンスを停止または削除した後、データとコードは失われますか?
データが保持されるかどうかは、操作とリソースグループのタイプによって異なります。
インスタンスの停止:
データの保持はリソースグループのタイプによって異なります。
システムディスクとしてクラウドディスクを持つインスタンス (ほとんどの従量課金タイプ、および ディスク が選択されている汎用リソースインスタンス):ディスクが拡張されておらず、インスタンスが 15 日以上停止している場合、データはクリアされ、回復できません。ディスクが拡張されているか、インスタンスが 15 日未満停止している場合、データは保持されます。
システムディスクとして 一時ストレージ を使用するインスタンス:データはエフェメラルストレージに保存されます。インスタンスを停止するとデータは削除され、回復できません。
インスタンスの削除:
すべてのシステムディスクデータは完全に消去され、回復できません。削除する前に、すべての重要なデータをバックアップしてください。
Q: 実行中の DSW インスタンスが自動的に停止したのはなぜですか?
インスタンスにはアイドル自動シャットダウンポリシーが設定されています。このポリシーはリソースを節約するために設計されており、無料トライアルインスタンスではデフォルトで有効になっています。
トリガー条件:CPU と GPU の使用率が両方とも、設定されたしきい値を 3 時間連続で下回った場合。
推奨事項:
手動で停止:リソースを確実に節約するには、使用していないときにインスタンスを手動で停止してください。自動シャットダウンポリシーが毎回トリガーされるとは限りません。
ポリシーの変更:長時間実行されるタスクの場合、このポリシーを変更または無効にします。手順:
ワークスペース詳細ページに移動し、ワークスペースの詳細 > スケジューリング設定 をクリックします。
DSW 設定セクションを見つけます。ここで DSW のシャットダウンポリシーと除外ポリシーを変更できます。たとえば、特定のインスタンスの自動シャットダウンを無効にするには、インスタンス名で除外ポリシーに追加します。
Q: すべての DSW インスタンスを停止または削除しましたが、まだ「実行中」と表示されたり、課金通知が届いたりします。なぜですか?
以下の一般的な原因を確認してください:
リソースパッケージとインスタンスを混同している可能性があります。表示されている「実行中」のステータスは、インスタンスではなくリソースパッケージ (例:「250 コンピュート時間/月」) を指している場合があります。リソースパッケージは、インスタンスの状態に関係なく、有効期間中アクティブなままです。
拡張されたシステムディスクがまだ課金されています。インスタンスを停止すると、コンピュート料金のみが一時停止されます。拡張されたシステムディスクは、ストレージ料金が発生し続けます。
課金が遅延しています。課金はリアルタイムではありません。午前中に発生した料金が、午後に請求書に表示されることがあります。
Q: API、Python コード、またはタスク後のトリガーを使用して DSW インスタンスを自動的に停止できますか?
以下の自動制御方法はサポートされていません:
DSW でトレーニングプロセスを開始したり、ECS などの外部環境から API 呼び出しを介してインスタンスの開始/停止を制御したりすること。
os.systemなどの Python コードを使用して、インスタンス内からシャットダウンコマンドを実行すること。タスク完了後にインスタンスが自動的に停止するように設定すること。
DSW は、CPU/GPU 使用率に基づいてアイドル状態を判断するアイドル自動シャットダウンポリシー (最小アイドル時間:1 時間) のみをサポートしています。このポリシーは 100% のトリガー信頼性を保証できません。予期しない料金を避けるために、タスクが完了したらインスタンスを手動で停止してください。
課金
Q: DSW インスタンスを停止した後も課金が続くのはなぜですか?
停止後の課金は、通常、以下のいずれかが原因です:
システムディスク拡張料金:インスタンス作成時にシステムディスクを拡張した場合、無料枠を超えるストレージ容量はインスタンスが停止していても課金が継続されます。これらの料金を停止するには、データをバックアップしてインスタンスを削除してください。
OSS ストレージ料金:インスタンスに OSS 標準ストレージ (ローカル冗長) や同様のリソースがマウントされていた場合、DSW インスタンスが停止した後もそれらのストレージコストは継続します。関連するストレージリソースを確認し、クリーンアップしてください。
課金の遅延:DSW の従量課金請求には 2〜3 時間の遅延があります。インスタンスを停止した直後に表示される料金は正常であり、継続的な課金を示すものではありません。
トラブルシューティングのヒント:異なるワークスペースとリージョンを切り替えて、実行中のすべてのインスタンスと関連するストレージリソースが停止またはリリースされていることを確認してください。
Q: DSW のパブリックネットワークアクセスに使用される NAT ゲートウェイと EIP はどのように課金されますか?
DSW のパブリックネットワークアクセスに必要な NAT ゲートウェイと Elastic IP (EIP) は、個別の課金が行われる独立したプロダクトであり、DSW インスタンスの料金には含まれていません。NAT ゲートウェイの価格はリージョンによって異なります。ご利用のリージョンの NAT ゲートウェイの価格ドキュメントを確認し、適切な低コストのプランを選択してください。パブリックネットワークアクセスの設定に関する詳細については、「インスタンス内のサービスにパブリックネットワーク経由でアクセスする」をご参照ください。
Q: PAI-DSW の代わりに GPU ECS インスタンスを使用できますか?
はい、PAI-DSW の代わりに GPU Elastic Compute Service (ECS) インスタンスを AI ワークロードに使用できます。
主な違い:ECS では、AI 開発環境を自分でセットアップする必要があります (ドライバー、フレームワークのインストールなど)。PAI-DSW は、構築済みのイメージとすぐに使える開発環境を提供し、セットアップの手間を削減します。
課金の考慮事項:ECS を使用する場合、インスタンスタイプ、パブリック帯域幅、クラウドディスクストレージ、NAT ゲートウェイはそれぞれ個別に課金されます。これは DSW の統合された課金モデルとは異なります。総コストを慎重に評価してください。
Q: PAI 節約プランは期限切れ後に手動でリリースする必要がありますか?
いいえ。PAI 節約プランは前払いの消費プロダクトであり、自動的に期限切れになります。手動でのリリースや削除は不要で、追加料金も発生しません。期限切れのリマインダーを受け取ったが、サービスが不要になった場合は、何もする必要はありません。PAI コンソールに使用しなくなった実行中の DSW インスタンスがまだある場合は、従量課金料金を避けるためにそれらを停止または削除してください。
Q: 節約プランまたは無料トライアルクォータが使い果たされたかどうかを確認するにはどうすればよいですか?
[請求とコストコンソール] にログインし、「マイサブスクリプション」に移動して、節約プランの残高と有効期限を確認します。残高が枯渇したか、プランが期限切れになった場合、共有 DSW リソースグループリソースのその後の使用は、標準の従量課金レートで請求されます。
Q: DSW はどのように課金されますか?インスタンスが実行中でコードを実行していない場合でも課金されるのはなぜですか?
DSW はサブスクリプションと従量課金の両方をサポートしています。課金の詳細については、「DSW 課金の概要」をご参照ください。
従量課金は、インスタンスの実行時間に基づいています。実行中のインスタンスは継続的に計算リソースを占有するため、ブラウザを開いているか、コンソールにログインしているか、コードを実行しているかに関係なく、インスタンスが [実行中] 状態になるとすぐに課金が開始されます。ブラウザを閉じたりログアウトしたりしても、インスタンスは停止しません。課金を停止するには、PAI コンソールに移動し、インスタンスを手動で停止または削除してください。
Q: DSW の請求書を表示するにはどうすればよいですか?
従量課金ユーザーは、請求とコストページに移動し、項目別の請求明細を表示できます。詳細については、「請求明細の表示」をご参照ください。
Q: すべての DSW 課金を完全に停止するにはどうすればよいですか?
すべての DSW 課金を完全に停止する最も確実な方法は、インスタンスを削除することです。削除する前にすべてのデータをバックアップしてください。インスタンスが削除されると、データは回復できません。
ワークスペースとリージョンを切り替えて、すべてのインスタンスが削除されていることを確認してください。
Q: 従量課金の DSW インスタンスを 1 時間未満使用した場合、料金はどのように計算されますか?
従量課金インスタンスは分単位で課金されます。数式は次のとおりです:料金 = (単価 ÷ 60) × 実際のサービス利用時間 (分)。
Q: DSW インスタンスを作成する際に「残高不足」エラーが表示されます。どうすればよいですか?
従量課金を有効にするには、アカウントに最低 100 元の現金残高が必要です。実際の料金は、管理されているプライマリアカウントのクォータから差し引かれます。
モデルのプル
Q: モデルのプルが失敗し、「Failed to pull image "crpi-****-vpc.cn-hangzhou.personal.cr.aliyuncs.com/apo/cat:full"」と表示される
プライベートイメージレジストリ URL を使用して DSW インスタンスを作成する場合、イメージアドレスを指定する際にレジストリのユーザー名とパスワードの両方を入力してください。
イメージ管理
Q: イメージ作成が「insufficient capacity of ephemeral storage」で失敗する
原因:イメージ作成プロセスでは、システムディスクの残りの空き領域が書き込みレイヤーのサイズより大きいかどうかを確認します。十分な領域がない場合、このエラーが発生します。
解決策:DSW ターミナルで df -h を実行してディスク使用状況を確認します。overlay の使用済み領域が /dev/vda4 の利用可能領域を超えていないことを確認してください。超えている場合は、イメージを保存する際に カスタム除外パス を設定して大きなファイルを除外します。
/mnt/workspace> df -h
Filesystem      Size  Used Avail Use% Mounted on
overlay          98G   82G   17G  84% /
tmpfs            64M     0   64M   0% /dev
tmpfs            16G     0   16G   0% /sys/fs/cgroup
/dev/vda4        99G   31G   68G  32% /tmp
/dev/vdb         98G   82G   17G  84% /mnt/workspace
overlay          99G   31G   68G  32% /etc/dsw
tmpfs            16G     0   16G   0% /dev/shm
/dev/vda3       8.8G  4.4G  4.0G  53% /usr/bin/nvidia-smi
tmpfs            16G   12K   16G   1% /proc/driver/nvidia
overlay          98G   82G   17G  84% /usr/lib/x86_64-linux-gnu/libcuda.so.465.19.01
devtmpfs         16G     0   16G   0% /dev/nvidia0
tmpfs            16G     0   16G   0% /proc/acpi
tmpfs            16G     0   16G   0% /sys/firmware
この例では、overlay は 82 GB を使用していますが、/dev/vda4 の空き領域は 68 GB です。overlay の使用量が /dev/vda4 の空き領域を超えているため、書き込みレイヤーのサイズを減らすためにカスタム除外パスを設定する必要があります。
Q: DSW で Docker イメージを使用するにはどうすればよいですか?
Docker イメージで DSW インスタンスを起動する:Docker イメージを Alibaba Cloud Container Registry (ACR) にプッシュし、PAI ワークスペースでカスタムイメージとして追加し、DSW インスタンスを作成する際に選択します。
Docker イメージを ACR にプッシュするには、「Personal Edition インスタンスでのイメージのプッシュとプル」をご参照ください。
PAI カスタムイメージを追加するには、「カスタムイメージ」をご参照ください。
現在の DSW 環境を他のインスタンスの起動やモデルのデプロイのためにイメージにパッケージ化するには、「DSW インスタンスイメージの作成」をご参照ください。
DSW クラウド IDE (ネストされたコンテナ) に Docker をインストールして使用する:この機能は、「Lingjun リソースグループ」または「汎用リソースグループ」から作成された DSW インスタンスでのみサポートされています。詳細については、「DockerBoard でサブコンテナを管理する」および「DSW で Docker を使用する」をご参照ください。
Q: DSW イメージの作成が失敗したりタイムアウトしたりするのはなぜですか?
イメージが大きすぎる:DSW で保存される単一のイメージレイヤーは 10 GiB を超えてはなりません。超えると、ビルドは失敗します。イメージサイズを小さくして再試行してください。
リージョンの不一致:DSW インスタンスと ACR インスタンスは同じリージョンにある必要があります。異なるリージョンにある場合、イメージ作成はターゲットレジストリを見つけられません。
システムディスク容量の不足:システムディスクの残りの空き領域が、イメージレイヤーに書き込まれるデータよりも少ない場合、「insufficient capacity of ephemeral storage」エラーが発生します。
ネットワークの問題:個人の ACR インスタンスでは、イメージはパブリックネットワーク経由でプッシュされます。大きなイメージは、ネットワークの不安定さや長い転送時間のためにタイムアウトすることがあります。DSW インスタンスと同じ VPC 内のエンタープライズ ACR インスタンスは、内部ネットワークプッシュをサポートしており、より高速で信頼性があります。
Q: 「イメージの保存」ボタンがグレーアウトしている、または保存時にイメージレジストリが見つからないのはなぜですか?
インスタンスの状態が間違っている:[イメージの保存] 機能は、[実行中] 状態のインスタンスでのみ利用可能です。インスタンスが停止しているか、他の状態にある場合、ボタンはグレーアウトしています。
前提条件が満たされていない、または設定が間違っている:
DSW インスタンスと同じリージョンに ACR インスタンスが既に存在し、その中に名前空間とイメージリポジトリが作成されている必要があります。
DSW インスタンスと ACR インスタンスがまったく同じリージョンにあることを確認してください。
Q: イメージ作成が失敗し、「Push image registry-vpc.cn-**.aliyuncs.com//lm-mirrors:** Failed: Push container failed, Container Name: dsw-notebook」と表示される
イメージを保存する際、単一のイメージレイヤーが 10 GiB を超えないようにしてください。超えるとビルドが失敗します。共有リソースグループの DSW インスタンスの場合、カスタム除外パスを設定して、最終的なイメージからファイルやディレクトリを除外します。または、ストレージパス (OSS パスなど) をマウントし、そこにデータを保存してイメージから除外します。
Q: エンタープライズ ACR へのイメージ作成が「Failed to login」で失敗します。どうすればよいですか?
このエラーは通常、ACR の権限が正しくないか、認証情報が無効であることが原因です。以下の手順でトラブルシューティングを行ってください:
一時的にイメージリポジトリのタイプを「パブリック」に変更して、再度テストします。
パブリックに切り替えた後にプッシュが成功した場合、問題は権限の問題です。プライベートリポジトリのアクセス制御ポリシーとアカウントの権限付与を確認し、修正してください。
パブリックリポジトリでも失敗する場合は、現在のアカウントが ACR インスタンスへの書き込みアクセス権を持っているかどうかを確認してください。
Q: イメージからインスタンスを再構築する際、元のインスタンスはどのように処理され、課金は継続されますか?
PAI-DSW インスタンスのシステムディスクは縮小をサポートしていません。設定を変更する必要がある場合 (例:ディスクの縮小)、まず元のインスタンスからカスタムイメージを作成する必要があります。
(推奨) イメージが作成された後、元のインスタンスを停止して、さらなるコンピュート料金の発生を避けます。
新しいイメージから新しいインスタンスを作成し、環境が期待どおりに動作することを確認した後、元のインスタンスをリリース (削除) して課金を完全に停止します。
Q: カスタムイメージには VS Code や Jupyter などの IDE パッケージを含める必要がありますか?
いいえ。カスタムイメージに VS Code や Jupyter などの IDE パッケージを含める必要はありません。これらがイメージにインストールされていなくても、DSW Web コンソールに組み込まれた IDE 環境は正常に動作します。
特定の IDE や依存関係をイメージにデフォルトでプリインストールしたい場合は、イメージを保存する前に関連するソフトウェアをイメージに追加するか、インスタンスの起動後に手動でインストールしてください。
システムディスクの拡張
Q: DSW インスタンスのシステムディスクはどのくらいの大きさですか?いっぱいになったらどうすればよいですか?
DSW インスタンスのファイルとデータはデフォルトでシステムディスクに保存され、無料のストレージクォータが提供されます。
無料クォータの確認
パブリックリソースグループで作成されたインスタンスには、100 GiB の無料クォータが含まれます。汎用計算リソースは、必要なリソース仕様を満たした後にのみ無料のシステムディスクを受け取ります。Lingjun AI コンピューティングリソースには無料のクラウドディスクは含まれません。正確な無料クォータを確認するには、インスタンス設定ページのシステムディスクオプションを確認してください:
インスタンスリストでインスタンス名をクリックします。
右上隅で 設定の変更 をクリックし、下にスクロールして システムディスク を見つけます。
システムディスク使用状況の確認
DSW インスタンス名をクリックし、[環境情報] セクションでシステムディスクの使用状況を確認します。
システムディスクがいっぱいになったときの拡張
システムディスクの使用量が無料クォータを超えた場合は、システムディスクを拡張するか、データセットをマウントします。
Q: 拡張後にシステムディスクを縮小できますか?
DSW のシステムディスクは拡張後に縮小することはできません。既存の DSW インスタンスが必要以上にシステムディスクを持っている場合で、重要なデータをバックアップしたい場合は、「データセット、OSS、NAS、または CPFS のマウント」を使用してデータを OSS にバックアップします。その後、インスタンスを削除して課金を停止し、適切なディスクサイズで新しいインスタンスを作成できます。
マウント設定
Q: DSW インスタンスで独自のファイルシステムをマウントして使用するにはどうすればよいですか?
インスタンス作成時に OSS、NAS、CPFS、または Lingjun CPFS をマウントし、その後 DSW ターミナルを使用してマウントディレクトリに移動し、ファイルにアクセスします。
DSW は、インスタンス作成時に同じリージョン内のファイルシステムのマウントのみをサポートしています。詳細については、「DSW インスタンスの作成」をご参照ください。
Q: NAS データセットを PAI-DSW にマウントすると「The specified MountTarget 3b79d4a2ac-xmk97.cn-shanghai.nas.aliyuncs.com is not in VPC vpc(VPC instance)」で失敗する
原因:NAS データセット作成時にマウントターゲットが設定されていました。
解決策:データセット作成時にマウントターゲットを空のままにします。
Q: ECS ベースの FTP サーバーへの NAS のマウントが「mount: wrong fs type, bad option, bad superblock」で失敗する
症状
[root@iZufxxx file]# sudo mount -t nfs -o vers=4.0  3f8axxx-lfc99.cn-shanghai.nas.aliyuncs.com:/ /usr/sftp/file
mount: wrong fs type, bad option, bad superblock on 3f8axxx-lfc99.cn-shanghai.nas.aliyuncs.com:/,
       missing codepage or helper program, or other error
       (for several filesystems (e.g. nfs, cifs) you might
       need a /sbin/mount.<type> helper program)

       In some cases useful info is found in syslog - try
       dmesg | tail or so.
[root@iZufxxx file]#
解決策
mountコマンドを実行する前に nfs-utils パッケージをインストールします。yum install nfs-utils
Q: OSS データセットをマウントした後、マウントディレクトリにアクセスすると「Input/output error」が返される
root@dsw-xxx:/mnt/workspace# cd /mnt
root@dsw-xxx:/mnt# ls -ll
total 9
drw-rw-r--  0   99   99  512 Jan  1  1970 data
drwxr-xr-x  5 root root 4096 Dec 13 02:42 systemDisk
drwxr-xr-x  5 root root 4096 Dec 13 02:42 workspace
root@dsw-xxx:/mnt# cd data
root@dsw-xxx:/mnt/data# ls -ll
ls: reading directory '.': Input/output error
total 0
root@dsw-xxx:/mnt/data#
このエラーは、ロールに OSS アクセス権限 (AliyunPAIDLCAccessingOSSRole) がないことが原因です。権限付与の手順については、「PAI サービスアカウントの権限付与」をご参照ください。
Q: Jindo で OSS データセットをマウントする際のメモリ不足 (OOM) リスクを軽減するにはどうすればよいですか?
OSS データセットをマウントした後、高度なパラメーターを設定して OOM リスクを軽減します:
オプション 1:メモリ最適化が含まれる Jindo 6.8.1 を使用します。
{
    "fs.jindo.fuse.pod.image.tag":"6.8.1"
}
オプション 2:ossfs を使用します。
タスクを送信する際に以下を指定します:
{
    "mountType": "ossfs"
}
OOM リスクをさらに軽減するには、
readdirplus最適化を無効にして、ディレクトリ内容をリスト表示する際のメタデータキャッシュ消費を減らします:{ "mountType": "ossfs", "fs.ossfs.args": "-oreaddirplus=false" }
Q: OSS を正常にマウントしましたが、JupyterLab のファイルブラウザに表示されないのはなぜですか?
DSW ファイルブラウザは、インスタンスの作業ディレクトリ (デフォルトでは /mnt/workspace) を表示します。OSS に指定したマウントパス (例:/mnt/data) はデフォルトの作業ディレクトリの外にあるため、ファイルリストには表示されません。
マウントされたファイルにアクセスするには:
コード経由でのアクセス:ファイルは正常にマウントされています。コード内で、完全なマウントパスを使用します。例:
open('/mnt/data/my_file.csv')。マウントポイントの変更:マウントパスを作業ディレクトリのサブディレクトリに設定します。例:
/mnt/workspace/my_oss_data。マウント後、my_oss_dataフォルダがファイルブラウザに表示されます。ターミナル経由でのアクセス:DSW ターミナルで
cd /mnt/dataを実行してマウントディレクトリに移動し、lsなどのコマンドを使用してファイルを表示および管理します。
Q: マウントされた OSS パスを使用すると、プログラムが「Transport endpoint is not connected」または「Input/output error」を返します
これらのエラーは、DSW インスタンスと OSS マウント間の接続が切断されたことを示します。一般的な原因とトラブルシューティング手順:
RAM ロールの権限:DSW インスタンスに設定された RAM ロールに OSS アクセス権限 (例:
AliyunPAIDLCAccessingOSSRole) があるか確認します。権限不足は OSS 読み取り失敗の一般的な原因です。マウントサービスリソースの不足:大量のランダム読み書きワークロードや多数の小さなファイルがある場合、
ossfsまたはJindoFuseプロセスがメモリ不足 (OOM) 状態によりクラッシュすることがあります。マウント設定の [高度な設定] で、メタデータキャッシュを無効にするか、メモリ割り当てを増やします。詳細については、「JindoFuse」をご参照ください。接続の復元:
起動時に設定されたマウントの場合、DSW インスタンスを再起動します。システムは自動的に再マウントします。
PAI SDK を使用して動的マウントコマンドを実行し、インスタンスを再起動せずにパスを再マウントします。
Q: DSW はどのストレージタイプをマウントできますか?Alibaba Cloud Drive や MaxCompute テーブルをマウントできますか?
DSW は、データセット作成または直接パスマウントを介して OSS、NAS、および CPFS をサポートしています。
Alibaba Cloud Drive はサポートされていません:DSW は個人の Alibaba Cloud Drive のマウントをサポートしていません。データは代わりに OSS に保存してください。
MaxCompute テーブルは直接マウントをサポートしていません:MaxCompute (旧 ODPS) テーブルデータはファイルシステムディレクトリとしてマウントできません。PAI SDK または API を使用して DSW コードからアクセスします。詳細については、「PyODPS で MaxCompute テーブルを読み書きする」をご参照ください。
Q: DSW インスタンスを停止または削除すると、コードとデータは失われますか?データを永続化および移行するにはどうすればよいですか?
DSW インスタンスのシステムディスクは一時ストレージです。パブリックリソースグループの場合、インスタンスが 15 日以上停止するとデータはクリアされます。専用リソースグループの場合、インスタンスが停止または削除されるとデータはクリアされます。
データとコードを永続化し、インスタンス間で移行するには、外部のマウントされたストレージを使用します。
永続化:すべての重要なデータ、コード、およびモデルをマウントされた OSS または NAS パスに保存します。DSW インスタンスが削除されても、アセットはご自身の OSS または NAS に安全に残ります。
移行:ある DSW インスタンスから別のインスタンスにデータを移動するには、新しいインスタンスに同じ OSS または NAS パスをマウントします。これが最も簡単な移行アプローチです。
Q: OSS を正常にマウントしましたが、作業ディレクトリのファイルが OSS に表示されません
デフォルトの OSS マウントパスは /mnt/data ですが、DSW のデフォルトの作業ディレクトリは /mnt/workspace です。作業ディレクトリのファイルは異なるパスにあるため、OSS には表示されません。作業ディレクトリから /mnt/data にファイルをコピーして、OSS で表示できるようにします:
cp -r /mnt/workspace/. /mnt/data/Q: /mnt/workspace からマウントされたデータセットディレクトリにすべてのデータをコピーするにはどうすればよいですか?
DSW インスタンスのターミナルで次のコマンドを実行します:
cp -r /mnt/workspace/ /mnt/data//mnt/data はデフォルトのデータセットマウントパスです。このコマンドは元のファイル構造と内容を保持します。コピー後、マウントステータスを確認し、OSS データを次のようにチェックします:
mount | grep ossデータの読み取り、アップロード、ダウンロード
Q: DSW を使用して OSS データを読み取るにはどうすればよいですか?
Python SDK または API を使用して OSS データを読み取ります。詳細については、「OSS のデータの読み書き」をご参照ください。
Q: フォルダをアップロードまたはダウンロードするにはどうすればよいですか?
DSW はフォルダの直接のアップロードまたはダウンロードをサポートしていません。まずフォルダをアーカイブファイルに圧縮してください。DSW ターミナルは、tar、gzip、unzip などの標準ツールを備えた Linux 環境を提供します。次の例では tar を使用します。
tar --versionを実行して tar がインストールされているか確認します。インストールされていない場合は、インストールします:# Debian ベースのシステム (例:Ubuntu) sudo apt install tar # Red Hat ベースのシステム (例:CentOS, Fedora) sudo yum install tarフォルダを圧縮または展開します:
# フォルダを圧縮する (/path/to/directory は圧縮するフォルダ)
tar -cvf archive_name.tar /path/to/directory

# フォルダを展開する
tar -xvf archive_name.tar
Q: 2 つの DSW インスタンス間でデータを転送または共有するにはどうすればよいですか?
2 つのアプローチが利用可能です:
データセット、OSS、NAS、または CPFS のマウント:両方のインスタンスに同じデータセットまたは OSS パスをマウントし、共有データをそこに保存します。
ファイルのアップロードとダウンロード:ソースインスタンスからデータをダウンロードし、ターゲットインスタンスにアップロードします。
Q: 「ダウンロード」をクリックしても効果がない、またはダウンロードが失敗する
これは通常、ネットワークの輻輳またはブラウザの問題が原因です。以下を試してください:
しばらく待ちます。大きなファイルは応答に時間がかかります。
別のブラウザに切り替えるか、ブラウザのプライベート (シークレット) モードを使用します。
200 MB を超えるファイルや不安定なネットワークの場合は、代わりにマウントされた OSS パス経由でダウンロードします。
Q: ファイル転送のステージングエリアの容量が不足しています
ファイル転送のステージングエリアの総容量は 10 GB です。ステージングエリア管理ページに移動し、ステージングエリアのファイルをクリアして空き容量を確保します。ページが更新されない場合は、ブラウザをリフレッシュしてみてください。
Q: アップロードが常にファイル転送のステージングエリアにリダイレクトされるのはなぜですか?
これは想定される動作です。アップロードの安定性と速度を確保するため、10 MB を超えるすべてのファイルは、インスタンスに保存される前に自動的にファイル転送のステージングエリアを経由します。
Q: ファイル転送のステージングエリア経由で大きなファイルをアップロードする際に、プログレスバーが動かなくなったり応答しなくなったりします。どうすればよいですか?
原因:これは通常、ローカルネットワーク環境が不安定なことが原因で、アップロードが止まり、プログレスバーが動かなくなり、時には転送失敗を引き起こすことがあります。
解決策:まずファイルを Object Storage Service (OSS) にアップロードし、その後 DSW インスタンスから OSS データをマウントまたは読み取ります。ガイダンスについては、「データソースのマウントと管理」をご参照ください。
Q: 大きなファイル (5 GB を超えるモデルなど) や大量のデータを DSW にアップロードするにはどうすればよいですか?
DSW インスタンスのシステムディスクは限定的で一時的なものです。大きなファイルを直接アップロードするのではなく、まずデータを Alibaba Cloud Object Storage Service (OSS) にアップロードし、その後 OSS を DSW インスタンスにマウントします。詳細については、「データセット、OSS、NAS、または CPFS のマウント」をご参照ください。
Q: DSW インスタンスの作成が FAIL_TO_INIT_DATASET エラーで失敗するのはなぜですか?
OSS マウントパスがディレクトリではなくファイルを指している場合、DSW はインスタンス作成段階でパスがディレクトリとして認識できないことを検出します。その結果、データセットの初期化を拒否し、FAIL_TO_INIT_DATASET エラーを返します。
これを解決するには、OSS のマウントパスと同じレベルに同じ名前のファイルが存在するかどうかを確認してください。存在する場合は、ファイルを削除するか、マウントディレクトリパスを変更して有効なディレクトリを指すようにし、その後インスタンスを再作成してください。
リモートインスタンス接続
Q: DSW インスタンスへの ProxyClient 接続が「client_loop: send disconnect: Broken pipe」で切断される
SSH 経由で DSW インスタンスに接続する際、アイドル状態の接続が切断され、次のプロンプトが表示されることがあります:
Welcome to PAI DSW!

(base) [root@dsw-367946-867cc4957c-phxnp ~]$FATA[0245] proxy-read:websocket: close 1006 (abnormal closure): unexpected EOF
client_loop: send disconnect: Broken pipeより信頼性の高い接続のためには、代わりに「リモート接続:直接 SSH 接続」を使用してください。
Q: VS Code 経由のリモート接続でローカルフォルダが開けない
これは通常、VS Code クライアントが原因です。代わりにローカルファイルをクラウドの DSW にアップロードしてください。手順については、「ファイルのアップロードとダウンロード」をご参照ください。
Q: SSH 直接接続の設定が「Failed to update private zone items: Failed to add zone」で失敗する
このエラーは、内部 DNS 名前解決サービスが有効になっていないことを示します。「Private DNS の有効化」の手順に従って有効にしてください。
Q: VS Code の DSW への接続が「the input device is not a TTY」で失敗する
このエラーは通常、SSH サーバーに TTY 設定がないことが原因です。修正するには:
DSW インスタンスのターミナルで、
/etc/ssh/sshd_configを編集し、PermitTTY yesが存在することを確認または追加します。ファイルを保存し、
sudo service ssh restartを実行して SSH サービスを再起動します。VS Code を使用して再接続します。
Q: 外部 IDE から直接 PAI GPU リソースを呼び出してコードを実行できますか?
いいえ。DSW と DLC の両方で、コードはクラウド環境で実行する必要があります。ローカルの外部 IDE から API 経由で直接 PAI GPU リソースを呼び出すことはサポートされていません。
SSH 直接接続を使用して、ローカル IDE (VS Code や PyCharm など) を DSW インスタンスに接続して開発を行うか、コードを DSW または DLC にアップロードして実行します。SSH 接続の手順については、このトピックの「リモートインスタンス接続」セクションをご参照ください。
その他のリモート接続の問題については、「よくある質問」をご参照ください。
ネットワークの問題
Q: ネットワークのダウンロード速度が遅すぎる
DSW および DLC インスタンスは、デフォルトで共有ゲートウェイを使用します。帯域幅制限により、大きなファイルのダウンロード速度が不十分になる場合があります。ダウンロード速度を向上させるには:
国内リソースの場合:インスタンスが実行されている VPC 用にパブリック NAT ゲートウェイを作成し、Elastic IP (EIP) をバインドし、SNAT を設定します。詳細については、「プライベートゲートウェイでインターネットアクセスを改善する」をご参照ください。
この方法を使用する場合、ワークスペースで DSW インスタンス : パブリックネットワークアクセス速度制限の有効化 トグルが有効になっているかどうかを確認します。確認するには:ワークスペース詳細ページ > [ワークスペースの設定] > [一般設定] に移動し、DSW インスタンス : パブリックネットワークアクセス速度制限の有効化 トグルを確認します。
海外リソースの場合:Global Accelerator (GA) を使用して海外のモデルやコンテナイメージをプルする。
または、リソースをローカルにダウンロードし、DSW インスタンスにアップロードするか、まず OSS にアップロードしてから DSW インスタンスにマウントします。
Q: DSW インスタンスにはパブリック IP アドレスがありますか?
DSW インスタンスには、デフォルトでパブリック IP アドレスはありません。インターネットにアクセスしたり、外部から DSW インスタンスへのアクセスを許可したりするには、NAT ゲートウェイを設定するか、Elastic IP (EIP) を使用します。詳細については、「ネットワーク設定」をご参照ください。
Q: NAT ゲートウェイ経由で DSW インスタンスを公開する場合、複数のサービスが同じパブリックポートを共有できますか?
API を公開するために [DSW カスタムサービス] を使用する場合、同じ NAT ゲートウェイを経由するすべてのカスタムサービスは、異なる DSW インスタンス間のサービスを含め、一意のパブリックポートを使用する必要があります。
Q: DSW インスタンスがインターネットにアクセスできないのはなぜですか?
DSW インスタンスは、デフォルトで パブリックゲートウェイ を使用してインターネットにアクセスします。インターネットアクセスが機能しない場合は、インスタンス設定ページで インターネットゲートウェイ が 非公開ゲートウェイ に設定されているかどうかを確認します。プライベートゲートウェイが選択されている場合は、Elastic IP (EIP) と SNAT エントリを設定する必要があります。詳細については、「プライベートゲートウェイでインターネットアクセスを改善する」をご参照ください。それ以外の場合は、パブリックゲートウェイに切り替えます。
Q: Hugging Face にアクセスすると「Network is unreachable」エラーが返される
DSW インスタンスから海外のモデル (huggingface.co のモデルなど) をプルすると、国境を越えるネットワーク制限により失敗することがあります。これを解決するには、Global Accelerator (GA) インスタンスを作成して、DSW インスタンスの国境を越えるネットワークアクセスを有効にします。詳細については、「海外リージョンからモデルまたはコンテナイメージをプルする」をご参照ください。
サードパーティライブラリのインストール
Q: DSW でサードパーティライブラリを使用するにはどうすればよいですか?
DSW はサードパーティライブラリのインストールをサポートしています。詳細については、「サードパーティライブラリの管理」をご参照ください。
Q: pip でインストールしたパッケージや作成したコードは、DSW インスタンスを停止すると失われますか?
いいえ、インスタンスがシステムディスクとしてクラウドディスクを使用している場合は失われません。ディスクデータ (/mnt/workspace および /root 環境を含む) は、インスタンスが停止しても保持されます。すべての環境とファイルは、インスタンスが再起動すると利用可能になります。データは、インスタンスが削除されたときにのみ完全に削除されます。
Q: インストールしたサードパーティパッケージが有効にならないのはなぜですか?
pip でパッケージをインストールした後、import がそれを見つけられない場合は、まずサービスまたはカーネルを再起動してください。エラーが続く場合は、アクティブな Python 環境を確認してください。DSW はデフォルトで Python 3 環境にパッケージをインストールします。別の環境にインストールするには、まずその環境に切り替えます:
# Python 2 環境にインストールする
source activate python2
pip install --user xxx

# TensorFlow 2.0 環境にインストールする
source activate tf2
pip install --user xxx
xxx をインストールするパッケージの名前に置き換えてください。
Q: DSW での pip install コマンドが依存関係の競合またはバージョンエラーで失敗する
これは通常、環境の非互換性が原因です。以下の順序でトラブルシューティングを行ってください:
イメージの切り替え (推奨):現在のインスタンスを停止し、新しい DSW インスタンスを作成して、別の公式イメージを選択します。たとえば、PyTorch 2.1 が機能しない場合は、PyTorch 2.3 イメージまたは、一般的に互換性が高い
modelscopeシリーズを試してください。特定のバージョンのインストール:パッケージのドキュメントで、ご利用の DSW 環境 (Python/CUDA バージョン) と互換性のあるバージョンを確認し、
pip install package_name==x.y.zを実行します。ダウンロードソースの切り替え:清華大学の PyPI ミラーなどのミラーを試してください:
pip install -i https://pypi.tuna.tsinghua.edu.cn/simple <yourLibraryName>。
専用イメージと汎用イメージの環境の違い:専用イメージ (isaaclab シリーズなど) は特定のシナリオに合わせてカスタマイズされており、ターミナルとノートブック環境の不整合、モジュールの欠落、またはコマンドの動作の違いを引き起こす可能性があります。このような問題が発生した場合は、ドキュメントで推奨されている汎用の公式イメージ (例:
modelscope:1.26.0-pytorch2.6.0-gpu-py311-cu124-ubuntu22.04) に切り替えてください。novnc プラグインのインストールが「exit status 100」で失敗する:このエラーは通常、turbovnc のバージョン競合が原因です。手動でのパッケージのスペックダウンによるシステムの不安定さを避けるため、現在のインスタンスを停止し、互換性のあるプリインストールされた依存関係を持つ公式イメージ (例:
modelscope:1.34.0-pytorch2.3.1tensorflow2.16.1-gpu-py311-cu121-ubuntu22.04) に切り替えてください。
Q: DSW ターミナルにライブラリをインストールしましたが、Jupyter Notebook でインポートできません
ターミナルと Jupyter が異なる Python 環境を使用している可能性があります。which python を実行して、どの Python 環境がアクティブかを確認するか、Notebook で直接ライブラリをインストールします。例:
!which python
/usr/local/bin/python

!pip install bottle
Looking in indexes: https://mirrors.aliyun.com/pypi/simple/
Collecting bottle
  Downloading https://mirrors.aliyun.com/pypi/packages/83/f6/b55...
                                            103.8/103.8 kB 6.7 ...
Installing collected packages: bottle
Successfully installed bottle-0.13.4
WARNING: Running pip as the 'root' user can result in broken per...

[notice] A new release of pip is available: 23.3.2 -> 25.1.1
[notice] To update, run: pip install --upgrade pip
Q: コードで CUDA ドライバーのバージョンが低すぎると表示されます。DSW で NVIDIA ドライバーを手動でアップグレードすべきですか?
ドライバーをアップグレードしないでください。DSW インスタンスのドライバーと CUDA はプリインストールされており、ロックされています。手動で変更すると、インスタンスが回復不能なほど破損する可能性があります。正しいアプローチは、DSW イメージを切り替えることです。現在のインスタンスを停止し、新しいインスタンスを作成して、より高い CUDA バージョンとドライバーを持つ公式イメージを選択します。
たとえば、公式イメージ modelscope:1.9.4-pytorch2.0.1tensorflow2.13.0-gpu-py38-cu118-ubuntu20.04 には CUDA 11.8 が含まれています (cu118 で示されます)。
Q: イメージは GPU をサポートしていますが、コードで GPU を使用できません (torch.cuda.is_available() が False を返します)
これはランタイムの呼び出しの問題であり、CUDA ドライバーのバージョンの非互換性ではありません。以下の手順でトラブルシューティングを行ってください:
コードロジックを確認し、モデルまたはテンソルが
.to('cuda')またはtorch.device('cuda')を使用して明示的に GPU デバイスをターゲットにしていることを確認します。ターミナルで
nvidia-smiを実行して、システムが GPU デバイスを検出していることを確認します。DSW インスタンスを再起動して、GPU リソースの割り当てをリセットします。
(Alibaba Cloud Linux 3 の場合) 上記の手順で問題が解決せず、システムが Alibaba Cloud Linux 3 の場合、systemd のバージョンの問題で cgroups が GPU デバイスを正しく割り当てられない可能性があります。ターミナルで
sudo yum upgrade systemdを実行して systemd をアップグレードし、インスタンスを再起動します。
Q: DSW インスタンス内で Docker を使用してアプリケーションをデプロイできますか?
Lingjun リソースの場合、チケットを送信して Docker 使用の許可リストに追加してもらいます。Lingjun 以外の DSW インスタンスの場合、インスタンスコンテナ内で Docker を実行することはサポートされていません。
Q: DSW インスタンスに unzip や 7z がありません。ファイルを展開するにはどうすればよいですか?
apt-get を使用してインストールします:
unzipのインストール:ターミナルでapt-get update && apt-get install -y unzipを実行し、unzip your_file.zipで展開します。p7zip(7z 用) のインストール:ターミナルでapt-get update && apt-get install -y p7zip-fullを実行し、7z x your_file.7zで展開します。
Q: パッケージのインストールがハングまたはタイムアウトする
インストールのハング、タイムアウト、または非常に遅い速度は、通常、ネットワークの問題が原因です。以下の手順でトラブルシューティングを行ってください:
ステップ 1:ネットワーク接続の確認
ターミナルで ping www.aliyun.com を実行してインターネットアクセスをテストします。ネットワークが到達不能な場合は、ステップ 2 に進みます。
ステップ 2:ゲートウェイ設定の確認
インスタンス設定ページで、インターネットゲートウェイ のタイプを確認します:
パブリックゲートウェイ:DSW はデフォルトで パブリックゲートウェイ を使用します。インスタンス設定ページでゲートウェイのタイプを確認してください。パブリックゲートウェイには帯域幅制限があり、大きなファイルには不十分な場合があります。プライベートゲートウェイへの切り替えを検討してください。
プライベートゲートウェイ:プライベートゲートウェイはより高速なネットワークを提供しますが、VPC に EIP と SNAT エントリが設定されたパブリック NAT ゲートウェイが必要です。これがないと、インスタンスはインターネットにアクセスできません。詳細については、「プライベートゲートウェイでインターネットアクセスを改善する」をご参照ください。
ステップ 3:pip ダウンロードソースの切り替え
DSW はデフォルトで Alibaba Cloud のミラーを使用しており、ピーク時やネットワークの変動時に遅くなることがあります。別の国内ミラーに切り替えてみてください:
# 清華大学ミラー (推奨)
pip install -i https://pypi.tuna.tsinghua.edu.cn/simple --trusted-host pypi.tuna.tsinghua.edu.cn <yourLibraryName>

# USTC ミラー
pip install -i https://pypi.mirrors.ustc.edu.cn/simple --trusted-host pypi.mirrors.ustc.edu.cn <yourLibraryName>

# Douban ミラー
pip install -i https://pypi.doubanio.com/simple --trusted-host pypi.doubanio.com <yourLibraryName>
デフォルトの pip ソースを永続的に変更するには、「pip ソースの表示または変更」をご参照ください。
ステップ 4:オフラインインストールの使用
ネットワークが利用できないか、非常に不安定な場合は、オフラインでパッケージをインストールします:
ネットワーク接続が良好なローカルマシンで、
.whlパッケージをダウンロードします:# ローカルマシンで実行 pip download <yourLibraryName> -d ./packages.whlファイルを DSW インスタンスにアップロードします。アップロードの手順については、「ファイルのアップロードとダウンロード」をご参照ください。DSW でオフラインでパッケージをインストールします:
pip install /path/to/your-package.whl
Q: DSW WebIDE で root アクセス権を取得するにはどうすればよいですか?
ほとんどの公式 DSW イメージは、デフォルトで root として実行されます。ターミナルのプロンプトが root@... と表示されている場合、すでに root として実行されています。pip からの「root として実行することは推奨されません」という警告は、安全に無視できます。イメージが root ログインを使用しない場合、それはイメージ固有の設定です。root アクセスをサポートするイメージに切り替えてください。
Q: DSW で X サーバーを起動するにはどうすればよいですか?
DSW は X サーバーの起動をサポートしていません。
モデルのデプロイ
Q: DSW で生成されたモデルをデプロイするにはどうすればよいですか?
EAS でデプロイ
モデルトレーニング完了後、PAI-EAS を使用してオンラインサービスとしてデプロイします。詳細については、「モデルをオンラインサービスとしてデプロイする」をご参照ください。
ローカルデプロイのためにモデルをダウンロード
DSW で生成されたモデルを右クリックして、ローカルマシンにダウンロードします。
インスタンスの実行
Q: ページをしばらく放置すると、再度ログインを求められるのはなぜですか?
セキュリティのため、DSW のログインセッションは 3 時間後に期限切れになります。期限切れ後は再度ログインする必要がありますが、実行中のタスクには影響しません。長時間実行されるタスクの場合は、DSW ターミナルで nohup コマンドを使用してバックグラウンドで実行し続けてください。
セッションのタイムアウト時間は現在設定できず、デフォルトで 3 時間です。そのため、セッションのタイムアウトを変更したり、切断時間を設定したりすることはできません。
Q: ブラウザを閉じたり、コンピュータをシャットダウンしたりした場合、DSW のトレーニングジョブは実行し続けますか?
はい。DSW インスタンスはクラウドで実行されるため、ローカルデバイスを閉じてもその状態には影響しません。ただし、一部のインスタンス、特に無料トライアルインスタンスでは、アイドル自動停止ポリシーが設定されている場合があります。CPU または GPU の使用率が一定期間しきい値を下回ると、システムはインスタンスをアイドル状態とみなし、自動的に停止してタスクを中断することがあります。
Q: DSW はモデル蒸留をサポートしていますか?
DSW はクラウドベースの開発環境を提供するだけで、ワンクリックのモデル蒸留機能は提供していません。ワンクリックでモデル蒸留を行いたい場合は、PAI モデルギャラリーを使用できます。詳細については、モデル蒸留をご参照ください。
Q: ターミナルでタブ補完やその他の bash 機能が利用できないのはなぜですか?
一部のイメージには使用制限があります。ターミナルで bash と入力して Enter キーを押し、bash 機能を有効にしてください。
# bash
root@dsw-xxx-rxdxg:/mnt/workspace# ls
demos  lingxitest.tar
root@dsw-xxx-rxdxg:/mnt/workspace#
Q: DSW インスタンスのタイプが要件を満たさない場合はどうすればよいですか?
次の手順でインスタンスタイプを更新します:
DSW インスタンスリストで、インスタンス名をクリックしてインスタンス詳細ページを開きます。
インスタンスの設定 タブで、設定の変更 をクリックします。
インスタンス設定の変更 パネルで、インスタンスタイプを更新します。
説明タイプを更新する際にインスタンスが実行中の場合、インスタンスはすぐに再起動します。続行する前に、インスタンス内のすべての作業を保存していることを確認してください。
Q: メモリ使用率が高いです。メモリを解放するにはどうすればよいですか?
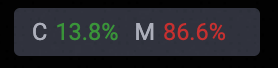 メモリ使用量が通常の操作に影響を与えている場合は、次のいずれかのアプローチを使用します:
メモリが高すぎてコマンドラインで対話できなくなった場合は、右上隅の インスタンスの停止 をクリックするか、DSW コンソールに戻ってインスタンスの横にある 停止 をクリックします。インスタンスが停止するのを待ってから、再度開きます。
まだコマンドラインで対話できる場合は、インスタンスのターミナルで
topコマンドを実行して、プロセスごとのメモリ使用状況を表示します。%MEMはメモリのパーセンテージを示し、PIDはプロセス ID を示します。top – 10:40:20 up 22 min, 0 users, load average: 0.95, 0.40, 0.15 Tasks: 21 total, 2 running, 19 sleeping, 0 stopped, 0 zombie %Cpu(s): 12.9 us, 0.6 sy, 0.0 ni, 86.4 id, 0.0 wa, 0.0 hi, 0.0 si, 0.0 st MiB Mem : 16000.0 total, 5889.6 free, 8838.5 used, 1271.9 buff/cache MiB Swap: 0.0 total, 0.0 free, 0.0 used. 5889.6 avail Mem PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND 360 root 20 0 8992776 8.0g 17096 R 100.0 51.1 2:12.54 python 207 root 20 0 11.2g 304160 50372 S 4.0 1.9 0:44.11 node 106 root 20 0 288712 104764 18316 S 1.0 0.6 0:03.11 jupyter-lab 122 root 20 0 638252 104652 32672 S 1.0 0.6 0:17.24 app 244 root 20 0 648536 54848 37924 S 0.3 0.3 0:01.22 node 1 root 20 0 10416 3828 3464 S 0.0 0.0 0:00.04 bash 90 root 20 0 15420 3856 2240 S 0.0 0.0 0:00.00 sshd 99 root 20 0 34500 25712 10688 S 0.0 0.2 0:00.48 supervisord 100 root 20 0 16280 8612 5140 S 0.0 0.1 0:00.01 supervisor_stdo 101 root 20 0 10420 3632 3300 S 0.0 0.0 0:00.00 launch_dswagent 102 root 20 0 10420 3724 3384 S 0.0 0.0 0:00.00 launch_jupyterl 103 root 20 0 10420 3628 3280 S 0.0 0.0 0:00.00 launch_code_ser 105 root 20 0 29632 28416 1668 S 0.0 0.2 0:01.51 app 154 root 20 0 721936 63232 37132 S 0.0 0.4 0:00.59 node 172 root 20 0 995584 131364 41032 S 0.0 0.8 0:05.36 node 218 root 20 0 848572 50384 37464 S 0.0 0.3 0:00.24 node 256 root 20 0 10684 4468 3768 S 0.0 0.0 0:00.00 bash 311 root 20 0 134328 50316 10432 S 0.0 0.3 0:00.93 python 312 root 20 0 138020 54140 11004 S 0.0 0.3 0:01.06 python 3670 root 20 0 10656 4368 3704 S 0.0 0.0 0:00.09 bash 3694 root 20 0 13224 3980 3400 R 0.0 0.0 0:00.08 topメモリ使用率の高いプロセスを終了するには、次を実行します:
kill PIDPIDを終了したいプロセス ID に置き換えます。コマンド実行後、メモリ使用率は低下するはずです。C 0.9% M 4.3%
Q: RuntimeError: CUDA error: too many resources requested for launch
原因:このエラーは、CUDA カーネルが利用可能なリソースよりも多くのリソースを要求していることを意味します。これは通常、GPU ハードウェアの制限に関連しています。
解決策:インスタンスを再起動し、プログラムを再実行します。エラーが続く場合は、より高性能な GPU インスタンスに切り替えます。
Q: DSW のメモリが不足した場合に仮想メモリを使用するためにスワップ領域を作成できますか?
DSW はコンテナとして実行され、以下の理由によりスワップ領域の作成や管理をサポートしていません:
権限の制限:コンテナはカーネルの権限が制限されており、スワップファイルをマウントできません。コンテナ内で root アクセス権を持っていても、ホストレベルのリソースポリシーをバイパスすることはできません。
プラットフォームポリシー:プラットフォームは、マルチテナント環境での安定性とセキュリティを確保するために、リソースを一元的に管理および制限します。
メモリが不足している場合は、コードを最適化するか、インスタンスタイプをスペックアップしてください。
Q: DSW インスタンス実行中にメモリ不足 (OOM) エラーが発生した場合のトラブルシューティングと解決方法は?
DSW インスタンスがメモリ不足 (OOM) エラーを報告したり、カーネルの OOM Killer がプロセスを終了させたりした場合、以下の順序でトラブルシューティングを行ってください:
[ターミナル] で
topを実行し、Mキーを押してプロセスをメモリ使用量でソートし、%MEM列を使用してメモリ使用量の多いプロセスとそのPID値を特定します。メモリ使用量の多いプロセスが不要であることを確認し、
kill -9 <PID>を実行して終了させます。<PID>を前のステップで特定したプロセス ID に置き換えます。メモリが枯渇してインスタンスがフリーズしたりコマンドを受け付けなくなったりした場合は、PAI コンソールを使用して [停止] し、再度起動します。インスタンスを停止してもデータは削除されません。
メモリが依然として不足している場合は、インスタンスタイプをスペックアップします。
ListEcsSpecsを呼び出して利用可能なインスタンスタイプを照会し、UpdateInstanceを呼び出してインスタンスタイプを変更します。または、DSW インスタンス詳細ページの インスタンスの設定 タブを開き、設定の変更 をクリックし、インスタンス設定の変更 パネルでインスタンスタイプを更新します。実行中のインスタンスの設定を変更する前に、インスタンスタイプを変更するとすぐに再起動されるため、作業を保存してください。バッチサイズを小さくする、勾配蓄積を使用して有効なバッチサイズを維持する、
delで不要な変数を削除する、gc.collect()を呼び出してメモリを再利用するなどして、コードのピークメモリ使用量を削減します。
Q: 複数の GPU カードの VRAM を組み合わせることはできますか?単一 GPU の VRAM の上限は?
いいえ、複数の GPU カード (例:2 x A10) の VRAM を単純に合計することはできません。GPU の VRAM は物理的に隔離されており、プログラムは 1 つの大きな結合プールではなく、複数の独立した VRAM 空間として認識します。
標準的なトレーニングモードでは、各 GPU はモデルパラメータ、勾配、およびオプティマイザーの状態の完全なセットを独立してロードする必要があります。したがって、ジョブが実行可能かどうかは、単一 GPU の VRAM の上限によって決まります。モデルが必要とする VRAM が単一 GPU の容量 (例:単一 A10 で 24 GB) を超える場合、複数の GPU カードが接続されていても、ジョブはメモリ不足 (CUDA out of memory) になります。
Q: DSW は GPU パススルー、nvidia-drm モジュールのロード、または P2P 通信の有効化をサポートしていますか?
DSW はこの分野で以下の制限があります:
DSW コンテナインスタンスは、
nvidia-drmカーネルモジュールのロードや GPU パススルーをサポートしていません。GPU リソースは--gpus=allを通じてのみマウントされます。GPU カード間の P2P 通信は、基盤となるハードウェアによって決まります。プラットフォームは、それを有効にするためのユーザーレベルのスイッチを提供していません。
nvidia-smiがNSを表示する場合、現在のハードウェアは P2P 通信をサポートしておらず、ソフトウェアで有効にすることはできません。PAI はマネージドサービスです。P2P 通信を有効にするためのカスタムドライバーやパッチのインストールはサポートしていません。GPU ドライバーと基盤となる通信機能は、プラットフォームによって一元的に管理されます。
Q: DSW の VS Code で Python コードに赤い波線が表示されます。どうすればよいですか?
構文が正しくても、DSW WebIDE (VS Code) で赤い波線が表示されることがあります。これは通常、クラウド IDE 環境固有の解析の問題です。問題を診断するには、次の手順に従ってください:
コードをローカルの VS Code エディターに切り取って貼り付け、そこでエラーが表示されるかどうかを確認します。これにより、問題がクラウド IDE 環境に固有のものかどうかが確認できます。
ローカルでのチェックがクリーンな場合は、コードを再度 DSW にアップロードまたは貼り付けます。
問題が解決せず、開発に影響を与えている場合は、PAI テクニカルサポートによるさらなる調査のためにチケットを送信してください。
Q: DSW インスタンスのリージョンを変更できますか?データは自動的に移行されますか?
DSW インスタンスはリージョンやアベイラビリティゾーンの変更をサポートしておらず、データは自動的に移行されません。
別のリージョンで DSW を使用するには、元のリージョンで現在のインスタンスからカスタムイメージを作成してデータをバックアップし、その後ターゲットリージョンでそのイメージから新しいインスタンスを作成します。
リソース不足によりインスタンスの作成が失敗した場合は、別のインスタンスタイプを試すか、リソースが利用可能になるのを待ちます。これはリージョンの変更を伴わず、データは失われません。
Q: DSW インスタンスを別のリージョンに切り替える際にデータを保持するにはどうすればよいですか?
アプローチはストレージのセットアップによって異なります:
外部ストレージなし (システムディスクのみ):バックアップなしで別のリージョンに新しいインスタンスを作成すると、データが失われます。まず元のリージョンで実行中のインスタンスからカスタムイメージを作成し、その後ターゲットリージョンでそのイメージから新しいインスタンスを作成して、環境とデータを復元します。
NAS/OSS ストレージのマウント:データはインスタンスとは独立して存在するため、イメージのバックアップは不要です。NAS/OSS のデータを直接ターゲットリージョンに移行します。
Q: PAI-DSW はワンクリックでのクロスリージョンワークスペース移行をサポートしていますか?
DSW はリージョン間のワンクリックインポートをサポートしていません。代替案として、ソースワークスペースからファイル転送ステージングエリアまたは OSS にファイルをアップロードし、その後ターゲットリージョンの DSW インスタンスでダウンロードまたはマウントします。