Generative AI บน Alibaba Cloud - ส่วนที่ 1: IaaS
โดย JV Roig
มีสามวิธีทั่วไปที่คุณสามารถปรับใช้และใช้บริการ Generative AI ใน Alibaba Cloud:
• IaaS (การให้บริการโครงสร้างพื้นฐาน)
• PaaS (การให้บริการแพลตฟอร์ม)
• MaaS (การให้บริการโมเดล)
ในส่วนที่ 1 นี้ จะพูดถึงวิธีการแรก: IaaS
การปรับใช้ IaaS GenAI – ข้อดีและข้อเสีย
ข้อดีหลักในการปรับใช้ IaaS คือ ทำให้คุณสามารถควบคุมสแต็กทั้งหมดได้ 100% ซึ่งรวมถึง:
• ระบบปฏิบัติการ
• ประเภทและขนาดของอินสแตนซ์
• ซอฟต์แวร์เซิร์ฟเวอร์ของ LLM (เช่น Hugging Face, vLLM, llama.cpp ฯลฯ)
• ตัวเลือกโมเดล (โมเดลใดก็ได้)
คุณยังสามารถควบคุมแอปพลิเคชันหรือซอฟต์แวร์อื่น ๆ ที่คุณต้องการให้อยู่ใน VM เดียวกันกับสแต็ก GenAI ของคุณได้อย่างง่ายดาย
นี่อาจฟังดูน่าทึ่ง (และเป็นอย่างนั้นจริง) แต่ดังคำกล่าวไว้ว่า: "พลังที่ยิ่งใหญ่มาพร้อมความรับผิดชอบอันใหญ่ยิ่ง"
จึงมีค่าใช้จ่ายในการจัดการที่เกี่ยวข้องกับการปรับใช้ IaaS มาก คุณต้องรับผิดชอบเรื่องต่าง ๆ มากมายที่รวมไปถึง:
• การแก้ไขและการบำรุงรักษาความปลอดภัยของ OS
• การแก้ไขและการบำรุงรักษาความปลอดภัยของซอฟต์แวร๋เซิร์ฟเวอร์ LLM
• โครงสร้างพื้นฐานการปรับขยายประสิทธิภาพและการกระจายงาน
หากคุณได้ลงทุนในวิธีเฉพาะสำหรับ Generative AI แล้ว (เช่น หากคุณและทีมของคุณเชี่ยวชาญในการปรับใช้ฟีเจอร์ของ Generative AI โดยใช้ llama.cpp แล้ว) การปรับใช้ IaaS GenAI จึงเหมาะสำหรับกรณีการใช้งานของคุณ คุณจะได้รับความยืดหยุ่น 100% ตามที่คุณต้องการโดยที่จะต้องจัดการกับสแต็กทั้งหมด
ตอนนี้ มาเริ่มที่การปรับใช้ Generative AI ผ่านวิธีการ IaaS กันเถอะ
ECS + GPU
บริการสำคัญของส่วนนี้คือการให้บริการ IaaS ระดับเรือธงของ Alibaba Cloud – Elastic Compute Service (ECS)
โดยเฉพาะอย่างยิ่ง เราจะใช้อินสแตนซ์ที่ขับเคลื่อนด้วย GPU เพื่อโฮสต์แพลตฟอร์ม OS และแพลตฟอร์ม Generative AI ที่ต้องการ
ตัวเลือกเทคโนโลยีที่สำคัญในบทช่วยสอนนี้ คือ:
• Ubuntu 22.04 LTS สำหรับระบบปฏิบัติการ (เพื่อให้เข้ากันได้ง่ายกับ NVIDIA CUDA)
• ใช้ llama.cpp เป็นซอฟต์แวร์เซิร์ฟเวอร์ LLM (ดูหน้า Github ของชุมชน: https://github.com/ggerganov/llama.cpp)
• ประเภทอินสแตนซ์ ECS ที่มี T4 GPU (P100, V100 หรือ A10 ใช้งานได้เช่นกันโดย T4 มีจำหน่ายในราคาถูก ขณะเดียวกันก็มีประสิทธิภาพเพียงพอสำหรับความต้องการของเราในบทช่วยสอนนี้)
มาเริ่มกันเถอะ!
ขั้นตอนที่ 1: การสร้างอินสแตนซ์ ECS
ในภาพรวมคอนโซล ECS ให้สร้างอินสแตนซ์ใหม่โดยคลิก สร้างอินสแตนซ์ ส่วนนี้คือที่ที่เราจะสร้างอินสแตนซ์ที่ขับเคลื่อนด้วย GPU ด้วย Ubuntu 22.04 LTS เป็นระบบปฏิบัติการ
ขั้นตอนทั่วไปมีดังนี้:
• เลือก จ่ายตามการใช้งาน เป็นวิธีการชำระเงิน
• เลือกภูมิภาคที่คุณต้องการ ในตัวอย่างนี้ฉันใช้ สิงคโปร์
• สำหรับเครือข่ายและโซน ให้เลือก VPC เริ่มต้น โซนที่ให้บริการ และ vSwitch เริ่มต้นในโซนดังกล่าว
• ใต้อินสแตนซ์และรูปภาพ คลิก อินสแตนซ์ทุกประเภท
• สำหรับสถาปัตยกรรม ให้คลิกที่กล่อง GPU/FPGA/ASIC เพื่อกรองอินสแตนซ์ให้แสดงเฉพาะที่มีตัวเร่งที่ต้องการเท่านั้น
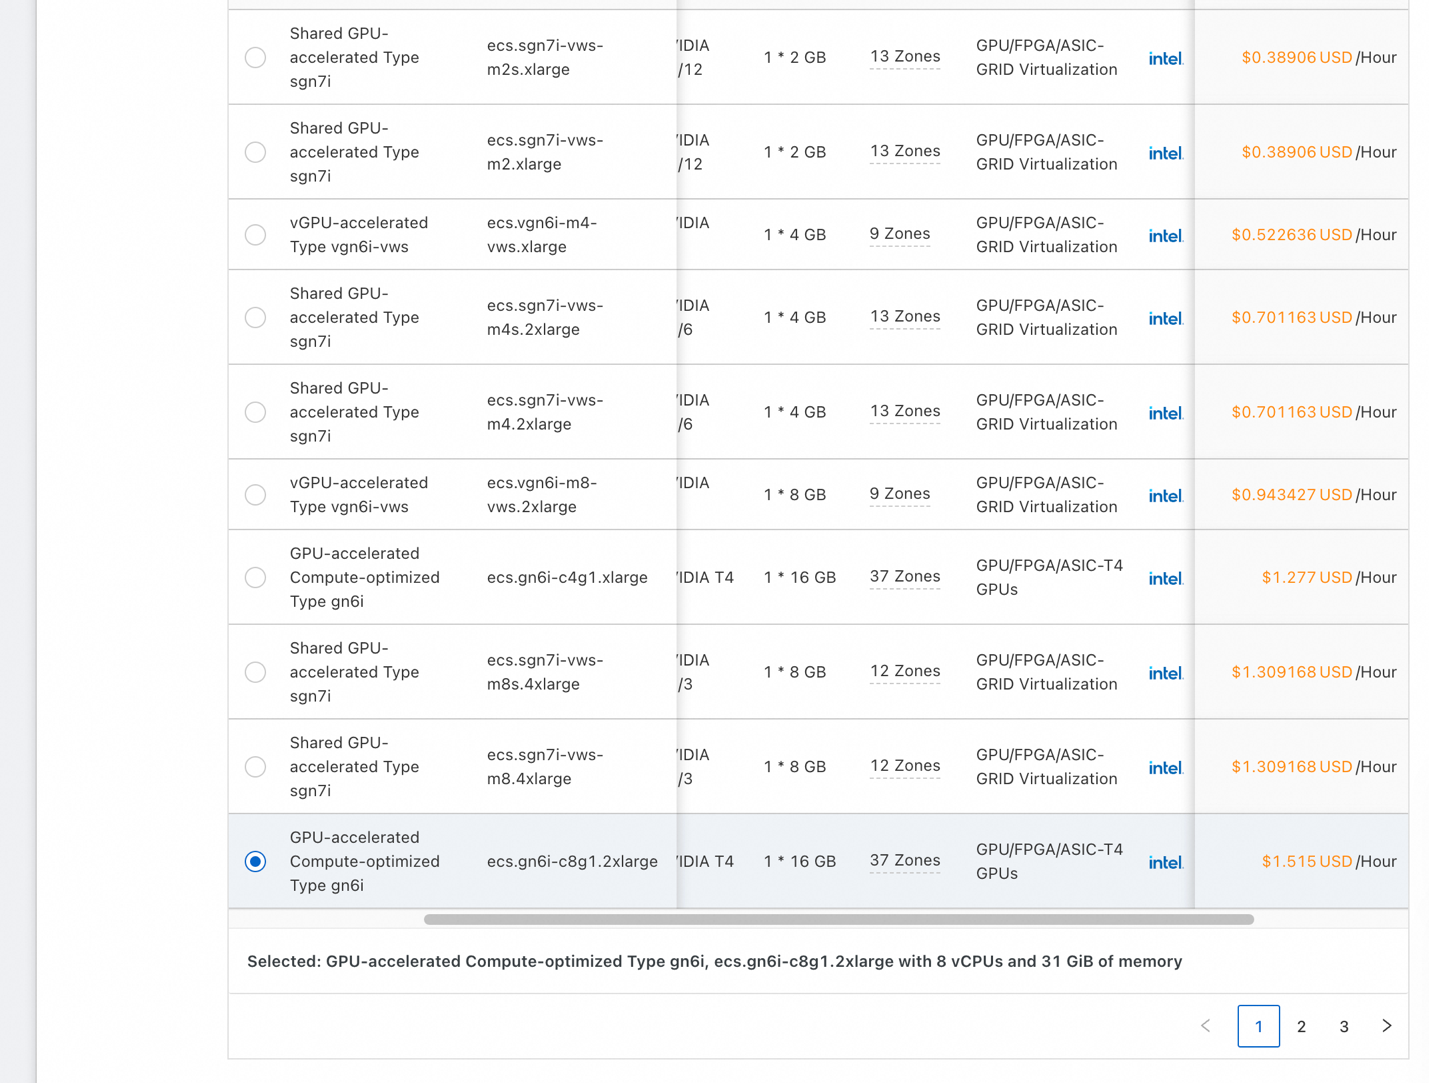
• คุณจะเห็นรายการที่คล้ายกับภาพหน้าจอด้านบน เลือกอินสแตนซ์ราคาถูกที่มี T4 เดียว (มี GPU RAM ขนาด 16GB) หรืออินสแตนซ์ใดก็ตามที่มีจำหน่ายในโซนที่คุณเลือก เพื่อให้แน่ใจว่าการสาธิตของเราใช้งานได้ ให้ใช้ GPU ที่มี GPU RAM อย่างน้อย 16GB
• แกนของ CPU มีจำนวน 8 คอร์หรือมากกว่า และระบบ RAM มีขนาด 16GB หรือสูงกว่า
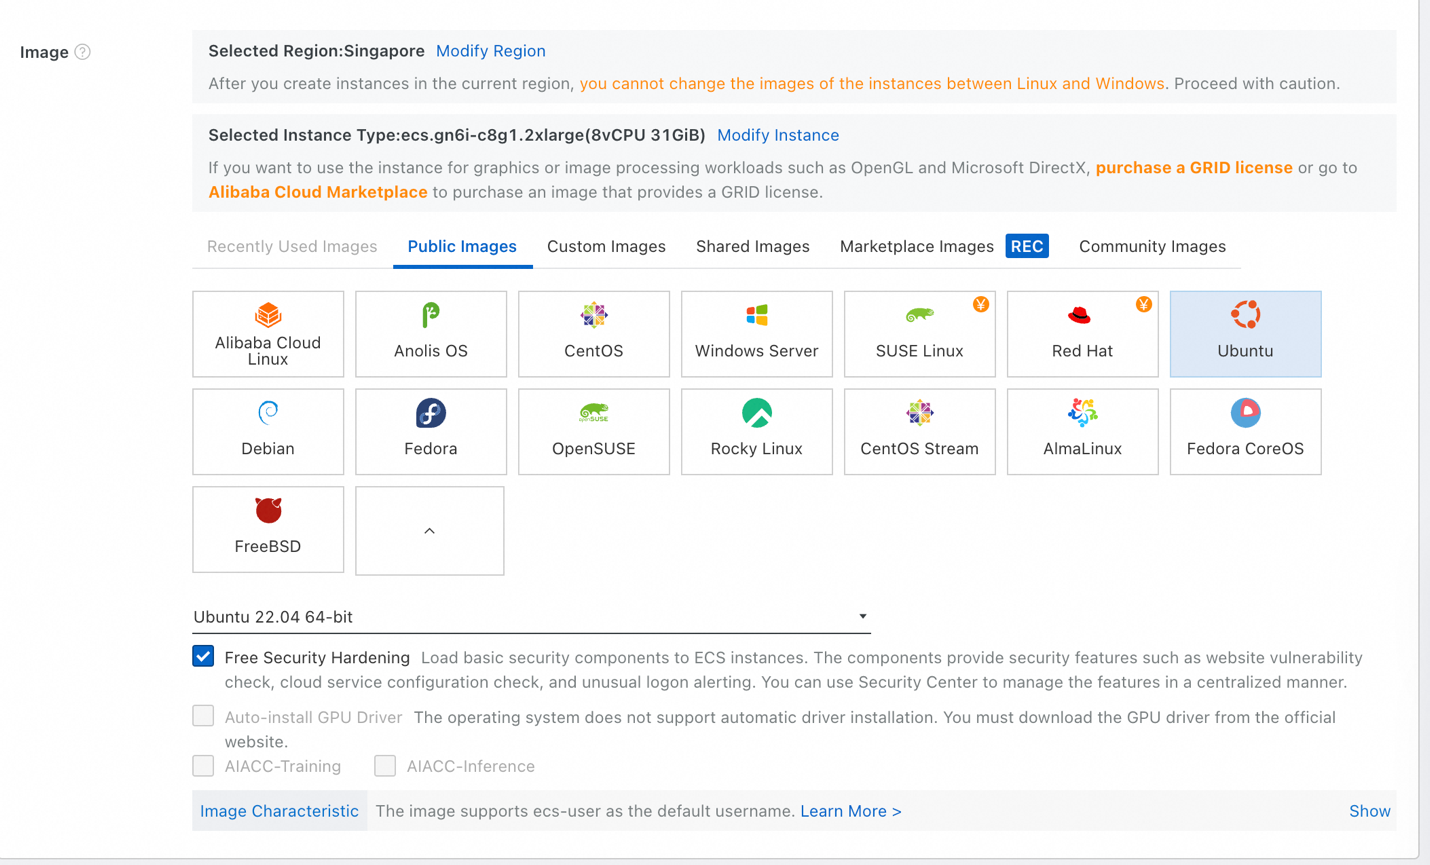
• สำหรับภาพ ให้เลือก รูปภาพสาธารณะ จากนั้นเลือก Ubuntu เลือก Ubuntu 22.04 64-bit ในรายการเวอร์ชันและตรวจสอบการเสริมความปลอดภัยฟรีอยู่เสมอ
• ภายใต้ พื้นที่จัดเก็บข้อมูล คุณอาจต้องใช้ จากบันทึกระบบ ที่มีขนาด 1TB หรือมากกว่า – เนื่องจาก LLM มีขนาดใหญ่ กำหนดขนาดให้เหมาะสม หากคุณไม่แน่ใจ ให้ใส่ 1024 GiB (1TB)
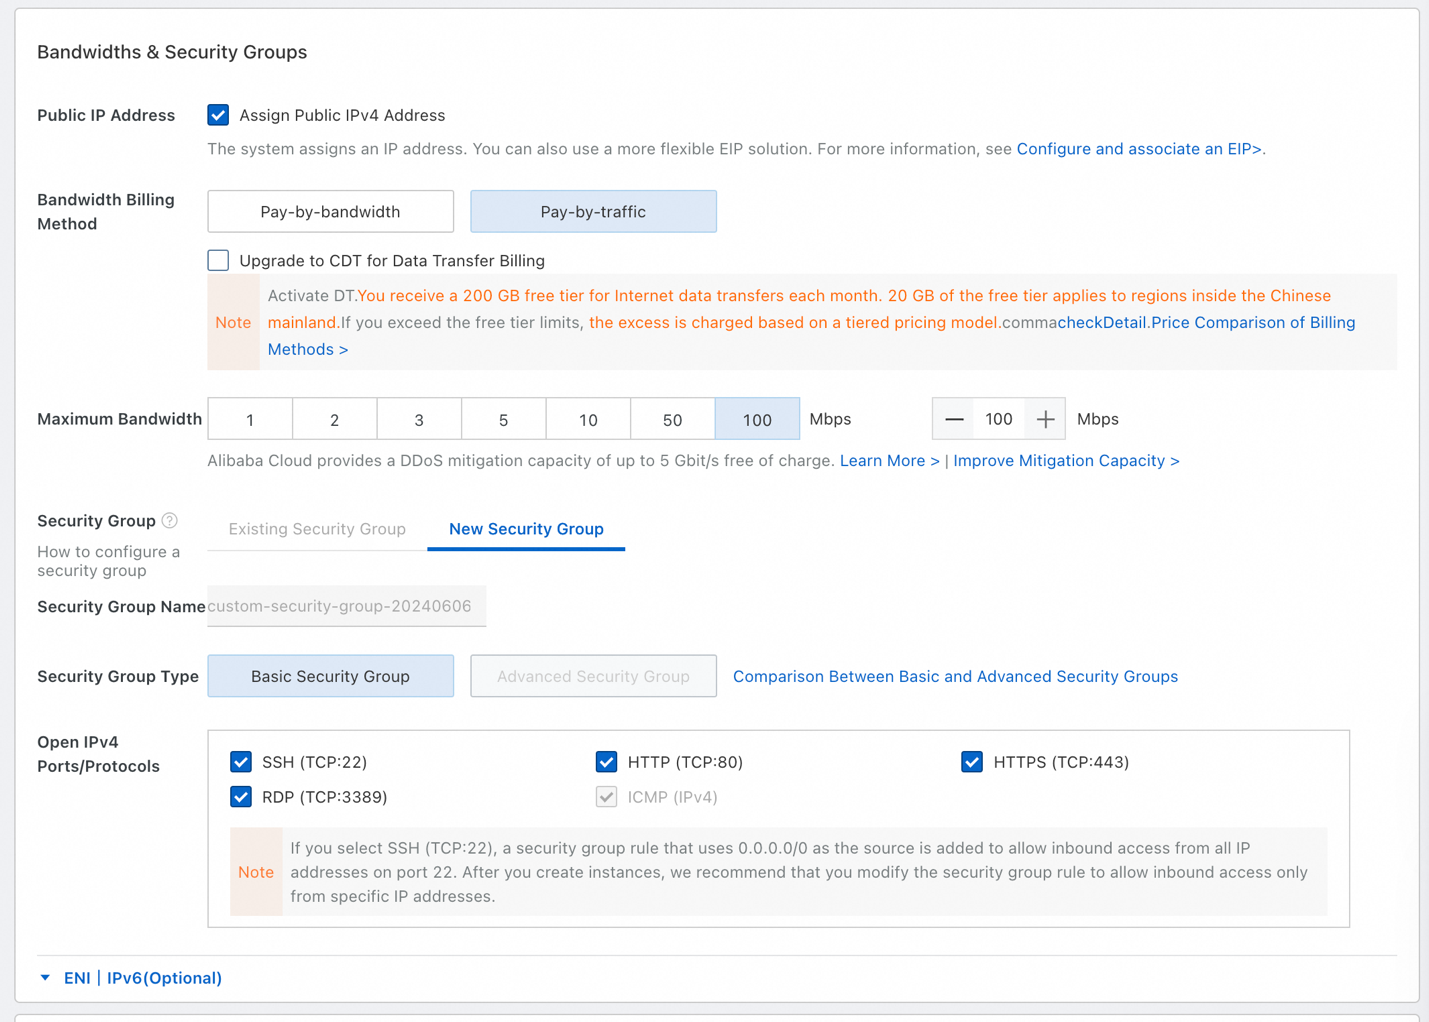
• สำหรับแบนด์วิดท์และกลุ่มความปลอดภัย โปรดตรวจสอบ กำหนดที่อยู่ IPv4 สาธารณะ
• เลือก จ่ายตามจำนวนผู้ใช้งาน และเลือก 100 Mbps เป็นแบนด์วิดท์สูงสุด เราจะดาวน์โหลดไฟล์ขนาดใหญ่บางไฟล์ (LLM มีขนาดใหญ่) ดังนั้นเราจะใช้แบนด์วิดท์ 100 Mbps
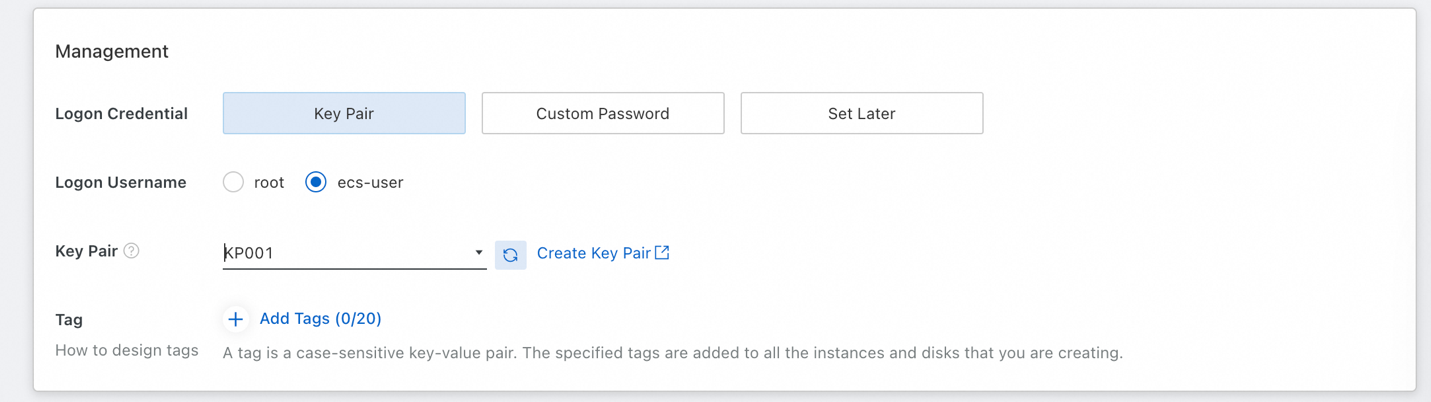
• เราจะต้องตั้งค่าคู่คีย์เพื่อให้สามารถ SSH เข้าไปในอินสแตนซ์ของเราได้ในภายหลัง เลือก ecs-user เป็นชื่อผู้ใช้เพื่อเข้าสู่ระบบ (เพื่อหลีกเลี่ยงการเช้าสู่ระบบในฐานะรูท)
• หากคุณยังไม่มีคู่คีย์ ให้คลิก สร้างคู่กุญแจ จากนั้นรีเฟรชรายการหลังจากที่ได้สร้างคู่คีย์แล้ว
• สุดท้าย ให้ยอมรับข้อกำหนดการให้บริการของ ECS ทางด้านขวาและคลิก สร้างคำสั่ง
ขั้นตอนที่ 2: การตั้งค่า Ubuntu และติดตั้งไดรเวอร์ NVIDIA และ CUDA
เมื่ออินสแตนซ์เริ่มทำงานแล้วในขณะนี้ ถึงเวลาที่จะเชื่อมต่อกับอินสแตนซ์เพื่อให้ตั้งค่าซอฟต์แวร์ที่จำเป็นได้
ในที่นี้ เราจะใช้การเชื่อมต่อระยะไกลของ Workbench ซึ่งเป็นฟีเจอร์เริ่มต้นใน ECS ที่ช่วยให้สามารถ SSH ไปยังอินสแตนซ์ของเราได้อย่างง่ายดายโดยใช้คู่คีย์ที่จัดไว้ จากนั้นเราจะอัปเดต OS ตรวจสอบว่าติดตั้ง Python แล้ว จากนั้นจึงติดตั้งไดรเวอร์ NVIDIA และ CUDA
• เพื่อเชื่อมต่อกับอินสแตนซ์ของเรา ให้ไปที่รายการอินสแตนซ์ (คอนโซล ECS -> อินสแตนซ์และรูปภาพ -> อินสแตนซ์)
• คุณจะพบอินสแตนซ์ที่เพิ่งเปิดใช้งานในรายการ ภายใต้คอลัมน์ การดำเนินการ คลิกตัวเลือก เชื่อมต่อ และเลือก เข้าสู่ระบบตอนนี้
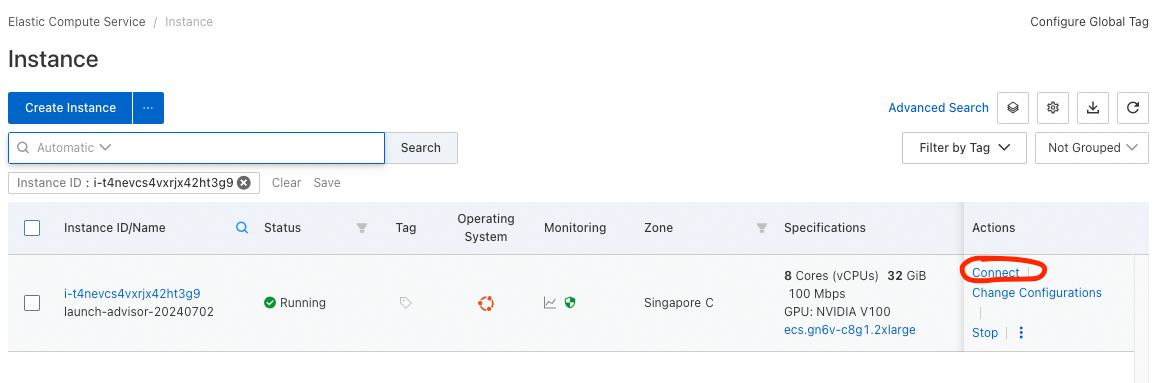
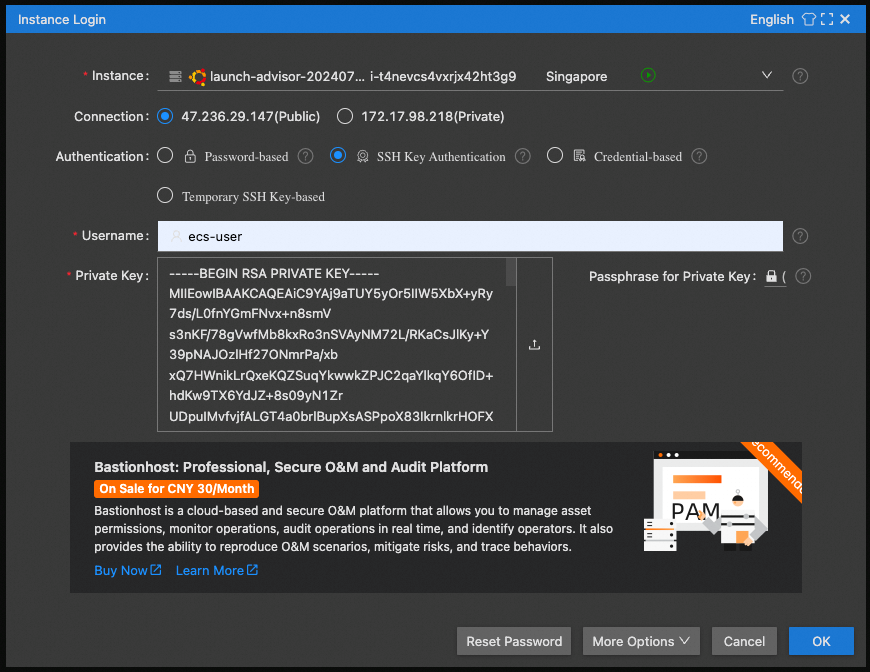
• เลือก IP สาธารณะ สำหรับการเชื่อมต่อ การยืนยันตัวตนด้วยคีย์ SSH และใช้ ecs-user เป็นชื่อผู้ใช้
• สำหรับคีย์ส่วนตัว ให้คลิกกล่องเพื่อเลือกกคีย์ส่วนตัวที่บันทึกไว้ของคุณ (คุณได้ทำการบันทึกไว้แล้วเมื่อสร้างคู่คีย์ของคุณ)
ยินดีด้วย! คุณอยู่ในหน้าต่าง SSH ที่สวยงามในเบราว์เซอร์และคุณสามารถเริ่มต้นกำหนดค่าซอฟต์แวร์ได้
ก่อนอื่นให้คุณอัปเดต OS ด้วยคำสั่งต่อไปนี้:
• sudo apt update
• sudo apt upgrade
ให้ตรวจสอบว่าติดตั้ง Python แล้ว ตรวจสอบเวอร์ชัน Python ด้วยคำสั่งต่อไปนี้:
• python3 --version
คุณควรเห็น Python 3.10.12 หรือที่คล้ายกัน
ส่วนที่ท้าทายที่สุดคือขั้นต่อไป: การติดตั้งไดรเวอร์ NVIDIA และ CUDA
1. ก่อนอื่นเราต้องใช้ส่วนหัวของ Linux เพื่อให้สามารถสร้างไดรเวอร์ได้:
sudo apt-get install linux-headers-$(uname -r)2. จากนั้นทำตามขั้นตอนต่อไปนี้: https://developer.nvidia.com/cuda-downloads?target_os=Linux&target_arch=x86_64&Distribution=Ubuntu&target_version=22.04&target_type=deb_local
เริ่มต้นด้วยคำสั่งตัวติดตั้งฐาน (ทีละตัว) จากนั้นคำสั่งตัวติดตั้งไดรเวอร์ (ใช้ legacy kernel module flavor)
หากคุณไม่ได้เลือกตัวเลือกแบนด์วิดท์สูงสุดในระหว่างการกำหนดค่าการเปิดตัวอินสแตนซ์ ECS ขั้นตอนนี้จะใช้เวลานานกว่าที่ควรจะเป็นมาก (GB ของการดาวน์โหลด NV)
3. หลังจากติดตั้งไดรเวอร์ให้เรียกใช้:
echo export PATH=/usr/local/cuda-12.5/bin${PATH:+:${PATH}} >> .bashrc4. รีบูตอินสแตนซ์ของคุณ (cmd: sudo reboot) และเชื่อมต่อใหม่อีกครั้ง
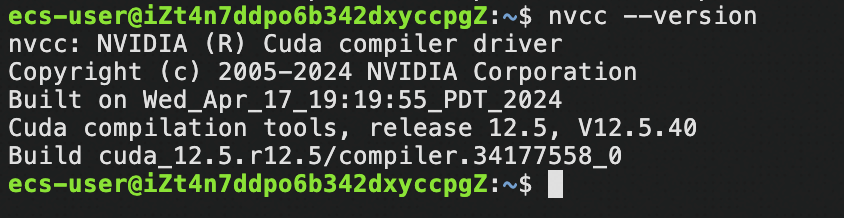
5. ตรวจสอบว่ามี CUDA:
nvcc –versionคุณควรเห็นสิ่งนี้:
6. ตรวจสอบว่ามีไดรเวอร์ NV:
nvidia-smiคุณควรเห็นสิ่งนี้:
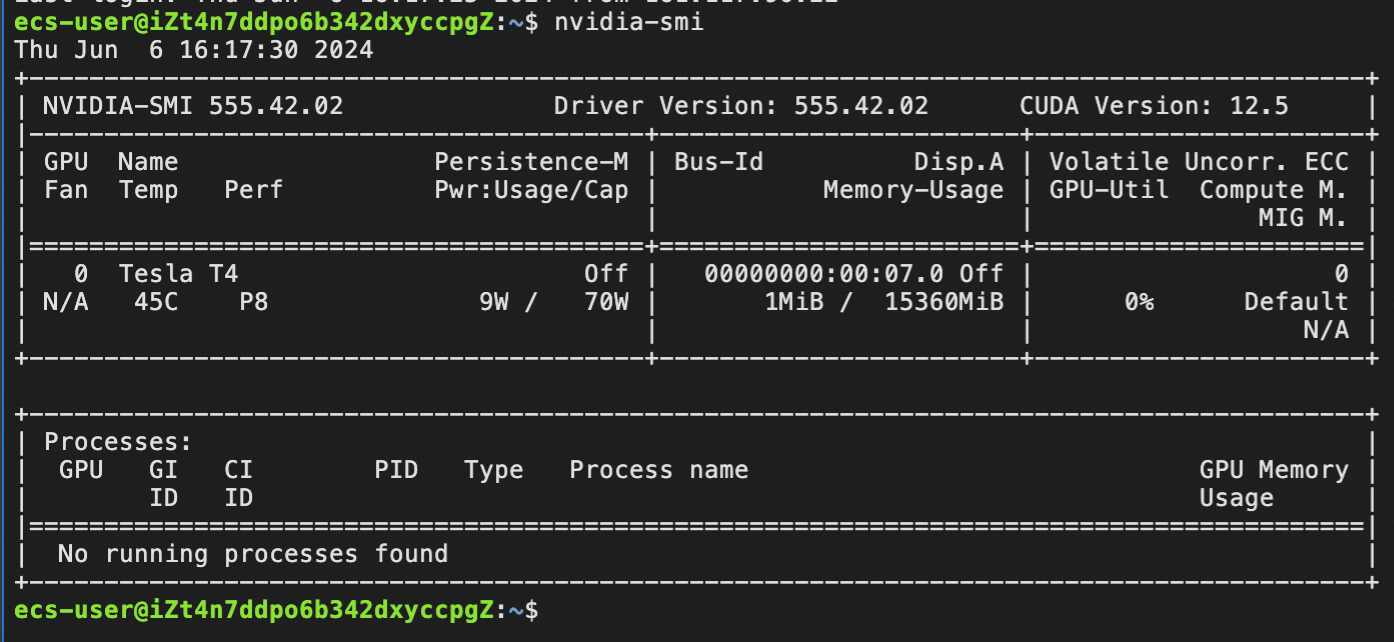
ยินดีด้วยที่มาถึงจุดนี้! คุณได้ติดตั้งไดรเวอร์ NVIDIA และ CUDA เรียบร้อยแล้ว – ตอนนี้คุณพร้อมที่จะใช้อินสแตนซ์สำหรับ Generative AI อย่างเต็มประสิทธิภาพ!
ขั้นตอนที่ 3: การติดตั้ง llama.cpp
สำหรับบทช่วยสอนนี้เราจะใช้โครงการชุมชนที่ได้รับความนิยมอย่างมาก – llama.cpp
1. ติดตั้ง llama.cpp
คำสั่งติดตั้ง:
git clone https://github.com/ggerganov/llama.cpp.git
cd llama.cpp
make -j 8 GGML_CUDA=1
    (make -j 8 หมายความว่าใช้ 8 เธรดในการรวบรวม  หากอินสแตนซ์ของคุณมีมากกว่า 8 vcore ให้เพิ่มจำนวนนี้เพื่อใช้ vcore ให้ได้มากที่สุดเท่าที่อินสแตนซ์ของคุณมี)
    (โปรดรอ กระบวนการนี้ใช้เวลาสักครู่)
2. ดาวน์โหลด LLM เพื่อทดสอบการติดตั้งของเรา:
cd models
wget https://huggingface.co/Qwen/Qwen1.5-7B-Chat-GGUF/resolve/main/qwen1_5-7b-chat-q4_k_m.gguf
3. อนุมานการทดสอบโดยใช้โมเดลที่เราดาวน์โหลด:
cd ..
./main -m models/qwen1_5-7b-chat-q4_k_m.gguf -p "คำถาม: โปรดอธิบายเกี่ยวกับ Alibaba Cloud ให้กับฉัน  ฉันเป็นผู้บริหารธุรกิจที่ไม่รู้ด้านเทคนิค  คำตอบ:" -ngl 999 -c 1000 -n 2000
เอาต์พุตควรเป็นดังนี้
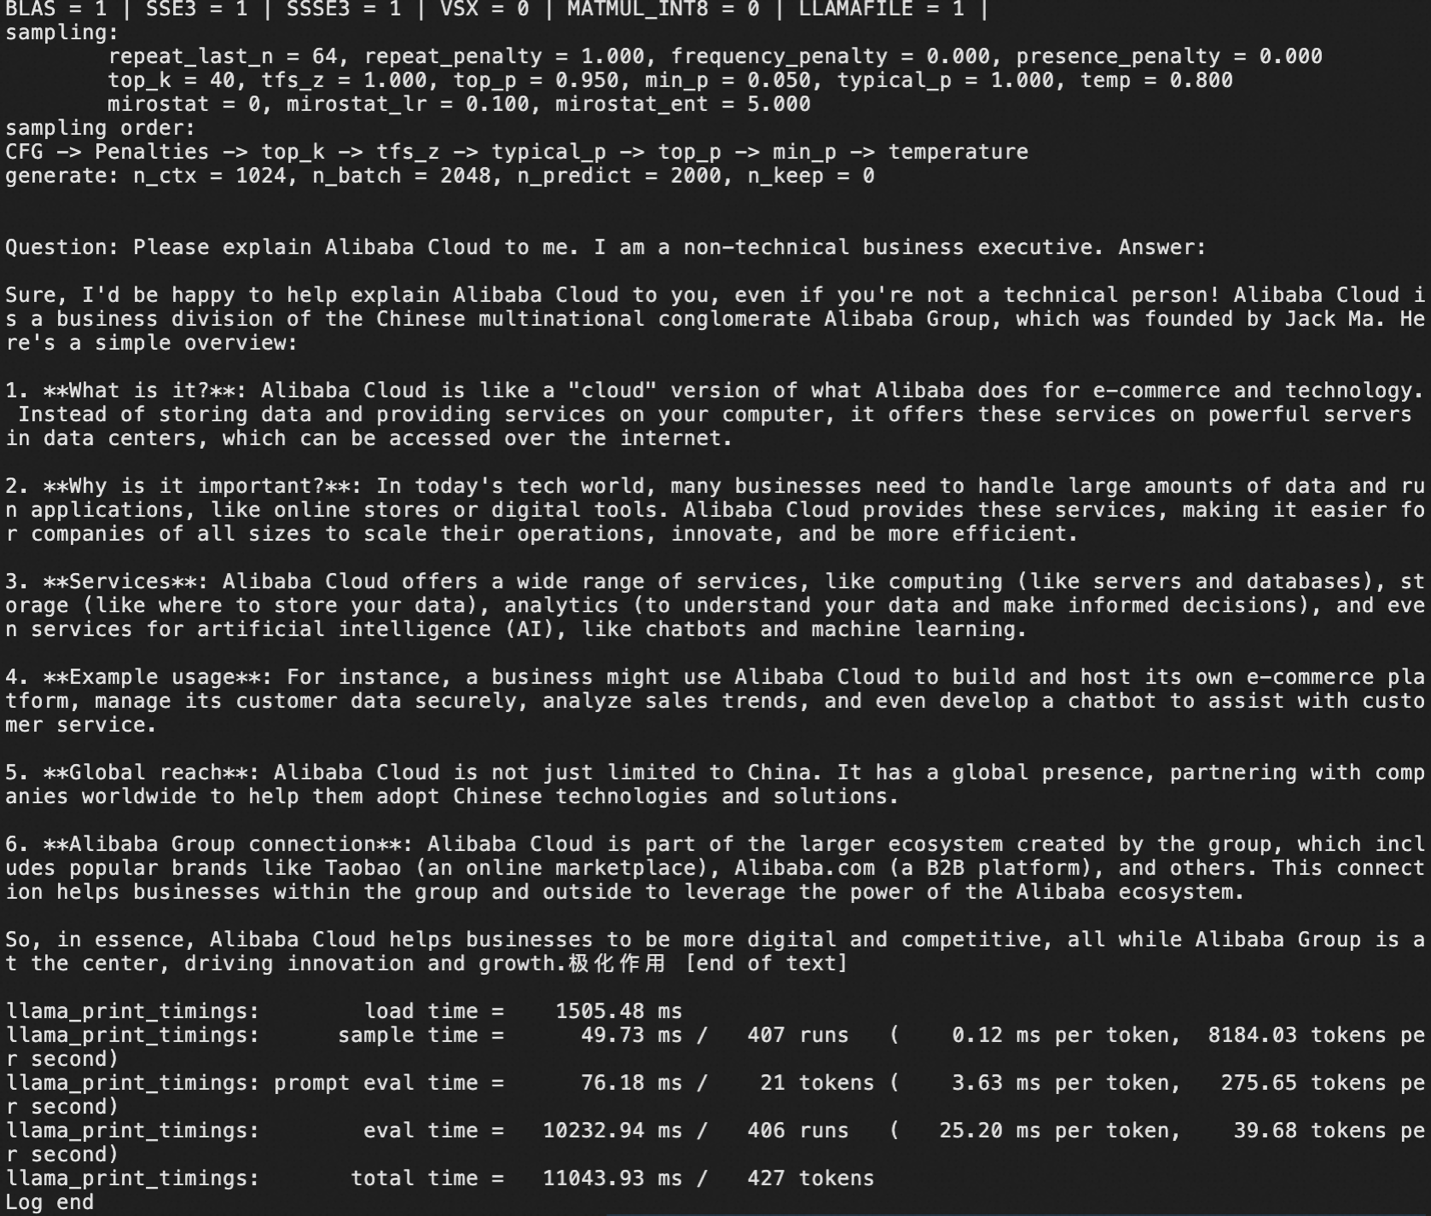
ในจุดนี้ เราดาวน์โหลดเวอร์ชันที่ลดขนาด (กล่าวคือ บีบอัด) ของ LLM ขนาดเล็ก, Qwen1.5 7B-chat ในรูปแบบ GGUF
หากคุณใช้ GGUF โมเดลเฉพาะอยู่แล้ว นี่เป็นเวลาที่จะต้องดาวน์โหลดโมเดลเหล่านั้นลงในอินสแตนซ์ของคุณเพื่อใช้งาน
ขั้นตอนที่ 4: การใช้เซิร์ฟเวอร์ llama.cpp
แน่นอนว่าเป้าหมายที่แท้จริงของการปรับใช้ GenAI คือการมีเซิร์ฟเวอร์ LLM ที่ให้การเข้าถึง API เพื่อให้แอปพลิเคชันของเราสามารถใช้ฟีเจอร์ Generative AI ได้
ในขั้นตอนที่ 3 เราได้ติดตั้ง llama.cpp ทำการดาวน์โหลดหนึ่งโมเดลหรือมากกว่าหนึ่งโมเดลขึ้นไป จากนั้นทำการอนุมานในพื้นที่
ขณะนี้ เราจะใช้ llama.cpp ในโหมดเซิร์ฟเวอร์:
./llama-server -m [เส้นทางโมเดล/ชื่อโมเดล.gguf] -ngl 999 --host 0.0.0.0 --port 8080 --api-key [คีย์ API ที่คุณต้องการ]หมายเหตุ: --port 8080 ระบุว่าพอร์ต 8080 ของ VM จะถูกใช้งานโดยเซิร์ฟเวอร์ เพื่อให้แน่ใจว่าแอปพลิเคชันของคุณสามารถเข้าถึงเซิร์ฟเวอร์ llama.cpp ได้ คุณต้องเพิ่มการเข้าถึง 8080 ในกลุ่มความปลอดภัยของ VM ของคุณหรือระบุหมายเลขพอร์ตอื่นที่คุณอนุญาตในกลุ่มความปลอดภัยของคุณแล้ว
ตัวเลือกอื่น:
-cb = เปิดใช้งานการแบทช์ต่อเนื่อง (แนะนำ)-fa = เปิดใช้งานการดึงความสนใจด้วยแฟลช (จำเป็นสำหรับ Qwen2 เป็นต้น)-np N = เปิดใช้งานสล็อต N แบบขนาน แยกขนาดบริบทสูงสุดโดย N เป็นผลลัพธ์ (ไม่แนะนำสำหรับโมเดลที่มีขนาดบริบทต่ำ) จะปรับปรุงประสบการณ์ของผู้ใช้สำหรับคำขอหลายรายการ
การแจ้งเตือน:
ให้ใช้เทมเพลตการแชทที่ถูกต้องสําหรับเซิร์ฟเวอร์ llama.cpp มิฉะนั้น LLM จะ "เห็น" ตัวคั่นแชทที่ไม่รู้จักและคิดว่าเป็นส่วนหนึ่งของเนื้อหา ส่งผลให้มีการสนทนาด้วยตัวเองและทำให้สูญเสียรอบ GPU ตัวอย่าง:
• สำหรับ llama2 ควรจะใช้ --chat-template llama2 ต่อท้ายการเรียกใช้เซิร์ฟเวอร์
• สำหรับ llama3 คือ llama3 openai-like คือ chatml
• ดู: https://github.com/ggerganov/llama.cpp/wiki/Templates-supported-by-llama_chat_apply_template
นี่คือตัวอย่างของการเรียกใช้เซิร์ฟเวอร์ที่เหมาะสมโดยใช้คำสั่ง 8B ของ Llama 3:
llama.cpp/llama-server -m LLMs/gguf/Meta-Llama-3-8B-Instruct-v2.Q5_K_M.gguf -ngl 999 -cb -np 3 --host 0.0.0.0 --port 8080 --api-key myapikey --chat-template llama3ในตัวอย่างด้านบน เราได้ระบุเทมเพลตการแชทที่ถูกต้องและใช้ -ngl 999 เพื่อแจ้งให้เซิร์ฟเวอร์กระจายทุกเลเยอร์ไปยัง GPU เพื่อประสิทธิภาพสูงสุด
ต่อไปนี้คือตัวอย่างโดยใช้ Qwen2:
llama.cpp/llama-server -m LLMs/gguf/qwen2-7b-instruct-q5_k_m.gguf -ngl 999 -fa -cb -np 3 --host 0.0.0.0 --port 8080 --api-key myapikeyในตัวอย่างด้านบนที่ใช้ Qwen2 บน llama.cpp เราใช้การดึงความสนใจด้วยแฟลชผ่านธง -fa (จำเป็นสำหรับ Qwen2) คุณไม่จำเป็นต้องระบุเทมเพลตการแชทเนื่องจากใช้เทมเพลตการตั้งค่าเริ่มต้นที่ llam.cpp รองรับ
เมื่อเซิร์ฟเวอร์ llama.cpp ของคุณพร้อมใช้งาน (อาจใช้เวลาสักครู่ในการเริ่มทำงานในครั้งแรกที่โหลดโมเดล ดังนั้นโปรดอดทน) สิ่งสุดท้ายที่ต้องทำคือการเข้าถึงเซิร์ฟเวอร์ API ผ่านโค้ด!
ขั้นตอนที่ 5: เข้าถึงเซิร์ฟเวอร์ llama.cpp โดยใช้ Python
เราต้องมี Python Library ของลูกค้า OpenAI ดังนั้นเราจะทำการติดตั้งเป็นอันดับแรกโดยใช้ pip:
pip install openaiนี่คือตัวอย่างโค้ด Python เพื่อเชื่อมต่อกับอินสแตนซ์ของคุณ:
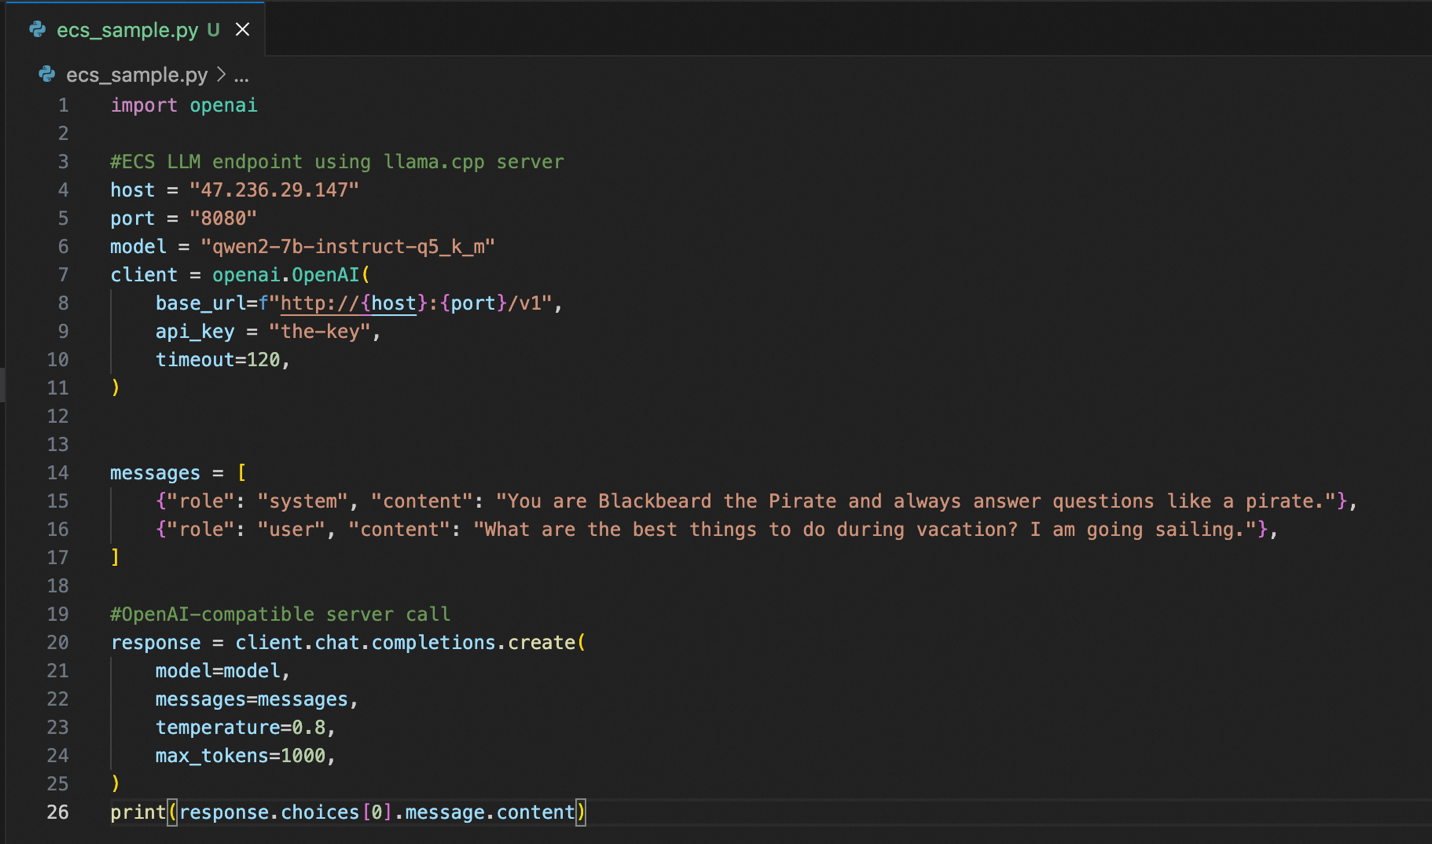
ความสวยงามของเซิร์ฟเวอร์ llama.cpp คือมีเซิร์ฟเวอร์ API ที่เข้ากันได้กับ OpenAI ซึ่งหมายความว่าหากคุณหรือทีมของคุณมีโค้ดจำนวนมากที่ใช้รูปแบบ OpenAI API การใช้อินสแตนซ์ของ Alibaba Cloud ที่ขับเคลื่อนโดย llama.cpp จะเป็นเรื่องง่าย นอกเหนือจากการกำหนดค่าโฮสต์ พอร์ตและคีย์ API ที่ถูกต้อง โค้ดที่มีอยู่ส่วนใหญ่จะไม่เปลี่ยนแปลงและใช้งานได้
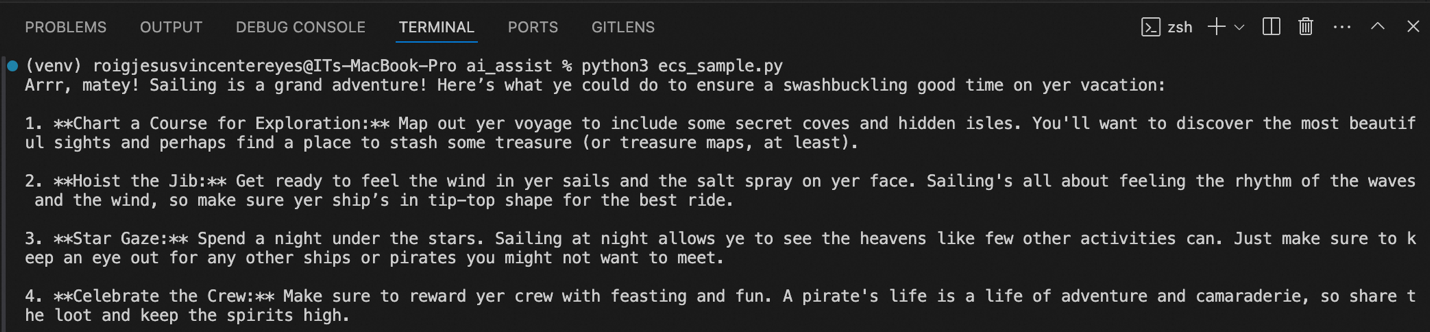
คุณสามารถดูตัวอย่างผลลัพธ์เมื่อฉันเรียกใช้โค้ดได้ที่ด้านบน ระบบทำตามคำสั่งที่ป้อน จึงตอบเหมือนกับเป็นโจรสลัด โดยให้คำแนะนำถึงกิจกรรมที่ฉันทำได้ขณะที่พักผ่อนและแล่นเรือ
สรุป
บทเรียนในส่วนที่ 1 ค่อนข้างยาวทีเดียว! เราได้สร้างอินสแตนซ์ ECS ติดตั้งไดรเวอร์ NVIDIA และ CUDA เพื่อที่จะได้ใช้ GPU ในอินสแตนซ์ของเรา จากนั้นเราได้ติดตั้งและกำหนดค่าเซิร์ฟเวอร์ llama.cpp ของเราเอง
ในตอนท้าย เรามีอินสแตนซ์แบบเฉพาะและเป็นส่วนตัวที่มีเซิร์ฟเวอร์ API ที่รองรับ OpenAI ช่วยให้สามารถรวมความสามารถของ Generative AI เข้ากับแอปพลิเคชันของเราได้อย่างง่ายดาย
ขั้นถัดไปในส่วนที่ 2: วิธีที่ง่ายดายและรวดเร็วยิ่งขึ้นในการปรับใช้ Generative AI ด้วยขั้นตอนที่น้อยลงและค่าใช้จ่ายในการจัดการที่ลดลง!
เกี่ยวกับผู้เขียน: JV เป็นสถาปนิกด้านโซลูชันระดับอาวุโสใน Alibaba Cloud PH และเป็นผู้นำด้านข้อมูลและกลยุทธ์ Generative AI ของทีม หากคุณคิดว่าสิ่งใดในบทความนี้เกี่ยวข้องกับปัญหาทางธุรกิจในปัจจุบันของคุณ โปรดติดต่อ JV ที่ jv.roig@alibaba-inc.com
บทความนี้แปลจากภาษาอังกฤษ ดูบทความต้นฉบับ ที่นี่
Read previous post:
Read next post:
-

-
Regional Content Hub
144 posts | 4 followers
Follow
Comments
-
-
Regional Content Hub
144 posts | 4 followers
Follow
Related Products
-
 ECS(Elastic Compute Service)
Elastic and secure virtual cloud servers to cater all your cloud hosting needs.
Learn More -
 Qwen
Full-range, open-source, multimodal, and multi-functional
Learn More -
 Wan3.0
Unleash Your Creativity Try Wan 3.0 now — longer narratives, greater control, endless creativity.
Learn More -
 Token Plan
Build more, spend less. One plan, every modality.
Learn More
More Posts by Regional Content Hub
- ให้พื้นที่ทำงานชั่วคราวกับ AI เอเจนต์ของคุณด้วย Alibaba Cloud AgentRun
- Alibaba Cloud AgentRun으로 AI 에이전트에 일회용 워크스페이스 제공
- Alibaba Cloud AgentRun で AI エージェントに使い捨てワークスペースを与える
- Beri Agen AI Anda Ruang Kerja Sekali Pakai dengan Alibaba Cloud AgentRun
- Cung cấp không gian làm việc dùng một lần cho tác nhân AI của bạn với Alibaba Cloud AgentRun
- DeepSeek V4-Flash dalam Skala Besar: Panduan Deployment Berbasis Benchmark
- 大規模な DeepSeek V4-Flash の活用:ベンチマーク主導のデプロイガイド
- 대규모 DeepSeek V4-Flash: 벤치마크 기반 배포 가이드
- Alibaba Cloud ECS 上で Telegram 連携機能付きの OpenClaw をデプロイする
- Alibaba Cloud ECS에 Telegram 통합 기능을 갖춘 OpenClaw 배포