Em uma arquitetura de Acesso Não Uniforme à Memória (NUMA), cargas de trabalho intensivas em GPU em nós com múltiplas GPUs sofrem quando CPUs e GPUs estão localizados em nós NUMA diferentes. O acesso à memória entre nós aumenta a latência, limita a largura de banda e reduz o throughput. O agendamento com reconhecimento de topologia NUMA do ACK aloca as CPUs e GPUs de um Pod no mesmo nó NUMA, eliminando tráfego desnecessário entre nós.
Como funciona
O nó NUMA é a unidade básica de um sistema NUMA. Um conjunto NUMA combina vários nós em um único nó worker para alocar recursos de forma eficiente e reduzir a contenção de memória do processador. Nós worker com oito GPUs geralmente possuem múltiplos nós NUMA. Sem a colocalização de CPU e GPU no mesmo nó NUMA, as aplicações enfrentam contenção de CPU e sobrecarga de comunicação entre nós NUMA.
O Kubernetes nativo utiliza as políticas de CPU e NUMA do kubelet para vinculação de recursos em um único nó, mas essa abordagem apresenta lacunas no nível do cluster:
Falta de visibilidade do agendador: O agendador não consegue avaliar os recursos NUMA restantes ao tomar decisões de posicionamento. Isso faz com que os Pods entrem em estados de
AdmissionErrore desestabiliza o cluster.Posicionamento incontrolável: As políticas de topologia são parâmetros de nível de nó, portanto não é possível usar afinidade de nó para controlar a colocalização em todo o cluster.
Inflexibilidade de política: Cada nó suporta apenas uma política de topologia, o que exige particionamento e rotulagem manuais do cluster, reduzindo a utilização geral dos recursos.
O ACK resolve essas limitações por meio do Scheduler Framework. Os componentes gputopo-device-plugin e ack-koordlet do ack-koordinator relatam a topologia de CPU e GPU de cada nó ao agendador, permitindo que você declare políticas de posicionamento NUMA no nível do Pod.

Pré-requisitos
Antes de começar, verifique se você possui:
Cluster:
Um cluster ACK Pro executando a versão 1.24 ou posterior. Para fazer upgrade, consulte Fazer upgrade de um cluster.
Nós:
Nós da família de instâncias sccgn7ex (clusters de supercomputação acelerados por GPU) ou nós Lingjun. Para detalhes sobre famílias de instâncias, consulte Famílias de instâncias. Para nós Lingjun, consulte Gerenciar clusters LINGJUN e nós Lingjun.
O rótulo
ack.node.gpu.schedule=topologyadicionado a cada nó onde você deseja ativar o agendamento de GPU com reconhecimento de topologia. Para obter instruções, consulte Ativar recursos de agendamento.
Componentes:
kube-scheduler versão 6.4.4 ou posterior. Para atualizar, acesse o console do ACK, clique em no nome do seu cluster e escolha Operations Management > Add-ons. Para mais informações, consulte kube-scheduler.
-
O add-on ack-koordinator (anteriormente ack-slo-manager) instalado com a seguinte configuração:
Clusters ACK Lingjun: Instale o ack-koordinator diretamente, sem configuração extra.
Clusters ACK Pro: Defina o campo
NodeTopologyReportno Feature GateagentFeaturescomotruedurante a instalação.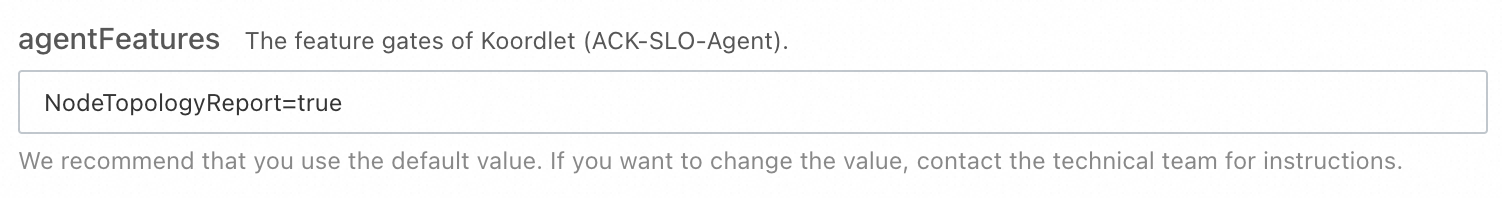
O add-on de relatório de topologia de GPU (gputopo-device-plugin) instalado. Este add-on coleta informações de topologia NUMA de GPU para CPU e as relata ao cluster. Para instruções de instalação, consulte Instalar o add-on de agendamento com reconhecimento de topologia de GPU.
Se você instalar o add-on de relatório de topologia de GPU antes do ack-koordinator, reinicie o add-on de relatório de topologia de GPU após a conclusão da instalação do ack-koordinator.
Limitações
Incompatibilidade:
Este recurso fornece agendamento unificado de afinidade NUMA para CPU e GPU. Ele é mutuamente exclusivo com as políticas de agendamento autônomas legadas. Não ative este recurso em cargas de trabalho que já utilizam agendamento de CPU com reconhecimento de topologia ou a versão autônoma legada do agendamento de GPU com reconhecimento de topologia.
Apenas a colocalização de CPU e GPU é suportada.
Requisitos de especificação de recursos:
As solicitações de CPU para todos os contêineres em um Pod devem ser números inteiros (unidade: núcleos), e as solicitações devem ser iguais aos limites.
Os recursos de GPU devem ser solicitados usando
aliyun.com/gpu, e nãonvidia.com/gpu. Apenas placas GPU inteiras são suportadas.
Faturamento
Este recurso requer o Cloud-Native AI Suite, que pode gerar taxas adicionais. Para detalhes, consulte Faturamento do Cloud-Native AI Suite.
Recursos do nó worker: o ack-koordinator executa como um componente autogerenciado nos nós worker e consome CPU e memória. Configure as solicitações de recursos para cada módulo durante a instalação.
Métricas de monitoramento do Prometheus: Se você selecionar Enable Prometheus Metrics for ACK-Koordinator durante a instalação e usar o Alibaba Cloud Prometheus, as métricas contam como métricas personalizadas e geram taxas baseadas no tamanho do cluster e na quantidade de aplicações. Antes de ativar esta opção, revise a documentação de faturamento do Prometheus para obter detalhes sobre cota gratuita e cobrança. Monitore o uso por meio das consultas de faturamento e uso.
Ativar o agendamento com reconhecimento de topologia NUMA
Adicione as seguintes anotações à especificação do seu Pod. Os comentários no YAML listam todos os valores válidos para cada campo.
apiVersion: v1
kind: Pod
metadata:
  name: example
  annotations:
    # Enables CPU binding. Only "required" is supported.
    cpuset-scheduler: required
    # numaTopologyPolicy controls placement scope:
    #   "SingleNUMANode" – all CPUs and GPUs on the same NUMA node (strict)
    #   "Restricted"     – all CPUs and GPUs within the same NUMA set (strict)
    #   "BestEffort"     – attempts same-node placement; falls back if unavailable
    # singleNUMANodeExclusive controls which NUMA node types are eligible:
    #   "Required" (default) – avoids NUMA nodes already used by pods with a different topology type
    #   "Preferred"          – no restriction on NUMA node type
    scheduling.alibabacloud.com/numa-topology-spec: |
      {
        "numaTopologyPolicy": "SingleNUMANode",
        "singleNUMANodeExclusive": "Preferred"
      }
spec:
  containers:
  - name: example
    image: ghcr.io/huggingface/text-generation-inference:1.4
    resources:
      limits:
        aliyun.com/gpu: '4'
        cpu: '24'
      requests:
        aliyun.com/gpu: '4'
        cpu: '24'
Política de posicionamento (numaTopologyPolicy)
O campo numaTopologyPolicy controla o escopo do posicionamento de CPU e GPU.
|
Valor |
Comportamento |
Quando a política não pode ser satisfeita |
|
|
Aloca todas as CPUs e GPUs no mesmo nó NUMA |
O Pod não é agendado |
|
|
Aloca todas as CPUs e GPUs dentro do mesmo conjunto NUMA (vários nós em um worker) |
O Pod não é agendado |
|
|
Tenta alocar CPUs e GPUs no mesmo nó NUMA |
Selecione o próximo melhor nó disponível |
Política de exclusividade (singleNUMANodeExclusive)
O campo singleNUMANodeExclusive controla quais tipos de nó NUMA o Pod pode utilizar.
Os nós NUMA são categorizados pela sua ocupação atual:
|
Tipo de nó NUMA |
Descrição |
|
|
Nenhum Pod em execução |
|
|
Apenas Pods vinculados a um único nó NUMA estão em execução |
|
|
Apenas Pods distribuídos por vários nós NUMA estão em execução |
|
Valor |
Regra de posicionamento |
|
|
Pods Single-NUMA só podem ser alocados em nós |
|
|
Sem restrição quanto ao tipo de nó NUMA |
Comparação de desempenho
O teste a seguir mede o tempo de carregamento do modelo antes e depois de ativar o agendamento com reconhecimento de topologia NUMA. O teste usa text-generation-inference para carregar um modelo em quatro placas GPU, com o NVIDIA Nsight Systems medindo a velocidade de carregamento da GPU.
Ambiente de teste: Nós Lingjun, text-generation-inference v1.4 (baixe), NVIDIA Nsight Systems (baixe)
Os resultados dos testes variam conforme a ferramenta e o ambiente. Os dados abaixo foram coletados usando o NVIDIA Nsight Systems; seus resultados podem ser diferentes.
O Deployment a seguir usa solicitações de recurso padrão nvidia.com/gpu, sem anotações NUMA.
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: tgi
  name: tgi-deployment-basic
  namespace: test
spec:
  replicas: 1
  selector:
    matchLabels:
      app: tgi
  template:
    metadata:
      labels:
        app: tgi
    spec:
      containers:
        - command:
            - sleep
            - 3600d
          image: ghcr.io/huggingface/text-generation-inference:1.4
          imagePullPolicy: IfNotPresent
          name: tgi
          ports:
            - containerPort: 80
              protocol: TCP
          resources:
            limits:
              cpu: '24'
              nvidia.com/gpu: '4'
            requests:
              cpu: '24'
              nvidia.com/gpu: '4'
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /llm
              name: volume-1710932083254
      restartPolicy: Always
      schedulerName: default-scheduler
      volumes:
        - name: volume-1710932083254
          persistentVolumeClaim:
            claimName: model
Tempo de carregamento do modelo: 15,9s

Com agendamento com reconhecimento de topologia
O Deployment a seguir adiciona anotações de topologia NUMA e altera a solicitação de recurso de GPU de nvidia.com/gpu para aliyun.com/gpu. Essa alteração permite que o agendador do ACK identifique e gerencie a afinidade NUMA entre GPU e CPU.
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: tgi-numa
  name: tgi-numa-deployment-basic
  namespace: yueming-test
spec:
  replicas: 1
  selector:
    matchLabels:
      app: tgi-numa
  template:
    metadata:
      annotations:
        cpuset-scheduler: required
        scheduling.alibabacloud.com/numa-topology-spec: |
          {
            "numaTopologyPolicy": "SingleNUMANode"
          }
      labels:
        app: tgi-numa
    spec:
      containers:
        - command:
            - sleep
            - 3600d
          image: ghcr.io/huggingface/text-generation-inference:1.4
          imagePullPolicy: IfNotPresent
          name: numa
          resources:
            limits:
              aliyun.com/gpu: '4'
              cpu: '24'
            requests:
              aliyun.com/gpu: '4'
              cpu: '24'
          volumeMounts:
            - mountPath: /llm
              name: volume-1710932083254
      restartPolicy: Always
      schedulerName: default-scheduler
      volumes:
        - name: volume-1710932083254
          persistentVolumeClaim:
            claimName: model
Tempo de carregamento do modelo: 5,4s — uma melhoria de 66% em relação à linha de base.

Próximos passos
Ativar aceleração de acesso à memória mais próxima para contêineres