Em instâncias multi-NUMA, cargas de trabalho colocalizadas podem esgotar a memória local e mover páginas de memória da aplicação para nós NUMA remotos. O acesso entre nós pelo barramento QuickPath Interconnect (QPI) é mais lento que o acesso local, o que reduz o throughput e aumenta a latência. O recurso de aceleração de acesso à memória próxima do ack-koordinator detecta páginas de memória remotas em tempo de execução e as migra de volta para o nó NUMA local sem interromper os serviços em execução.
Pré-requisitos
Antes de começar, verifique se você tem:
Um cluster ACK Pro executando Kubernetes 1.18 ou posterior. Para mais informações, consulte Crie um cluster gerenciado ACK.
Um cliente kubectl conectado ao cluster. Para mais informações, consulte Obter o arquivo kubeconfig de um cluster e usar kubectl para conectar-se ao cluster.
-
ack-koordinator (anteriormente ack-slo-manager) versão 1.2.0-ack1.2 ou posterior instalada. Para mais informações, consulte ack-koordinator (anteriormente ack-slo-manager).
NotaO ack-koordinator inclui todos os recursos do resource-controller. Se você usa atualmente o resource-controller, desinstale-o antes de instalar o ack-koordinator. Para mais informações, consulte Desinstalar resource-controller.
-
Instâncias Elastic Compute Service (ECS) de 5ª, 6ª, 7ª ou 8ª geração das famílias ecs.ebmc, ecs.ebmg, ecs.ebmgn, ecs.ebmr, ecs.ebmhfc ou ecs.scc, implantadas como instâncias multi-NUMA.
NotaEste recurso apresenta melhor desempenho em instâncias ECS de 8ª geração dos tipos ecs.ebmc8i.48xlarge, ecs.c8i.32xlarge e ecs.g8i.48xlarge. Para mais informações, consulte Famílias de instâncias ECS.
Aplicações implantadas em instâncias multi-NUMA com núcleos de CPU vinculados por meio de agendamento de CPU com reconhecimento de topologia. Para mais informações, consulte Ative agendamento de CPU com reconhecimento de topologia.
Faturamento
Não há cobrança para instalar ou usar o ack-koordinator. No entanto, os cenários a seguir podem gerar custos:
O ack-koordinator é um componente não gerenciado que consome recursos dos nós worker após a instalação. Especifique quantos recursos cada módulo solicita durante a instalação.
Por padrão, o ack-koordinator expõe métricas de monitoramento (como perfilamento de recursos e métricas de agendamento refinado) como métricas Prometheus. Se você ativar métricas Prometheus para o ack-koordinator e usar o Managed Service for Prometheus, essas métricas serão contabilizadas como métricas personalizadas e haverá cobrança. Antes de ativar, leia o tópico Faturamento do Managed Service for Prometheus para entender a cota gratuita e as regras de faturamento. Para mais informações, consulte Consultar a quantidade de dados observáveis e faturas.
Como funciona
Na arquitetura multi-NUMA, processos executados em um vCore de um nó NUMA podem precisar acessar memória em um nó NUMA remoto. Esse acesso entre nós trafega pelo barramento QPI e leva mais tempo que o acesso à memória local. Sob altas cargas de memória — por exemplo, quando cargas de trabalho colocalizadas no mesmo nó NUMA esgotam a memória local — as páginas de memória de uma aplicação podem ser movidas para um nó NUMA remoto, reduzindo a taxa de acerto de memória local e degradando o desempenho.
O ack-koordinator resolve esse desvio de memória em tempo de execução. Quando a localidade de memória está ativada para um pod, o agente koordlet em cada nó detecta quais páginas de memória do pod residem em nós NUMA remotos e as migra para o nó local. A migração é segura e não exige reinicialização do pod nem interrupção de tráfego.
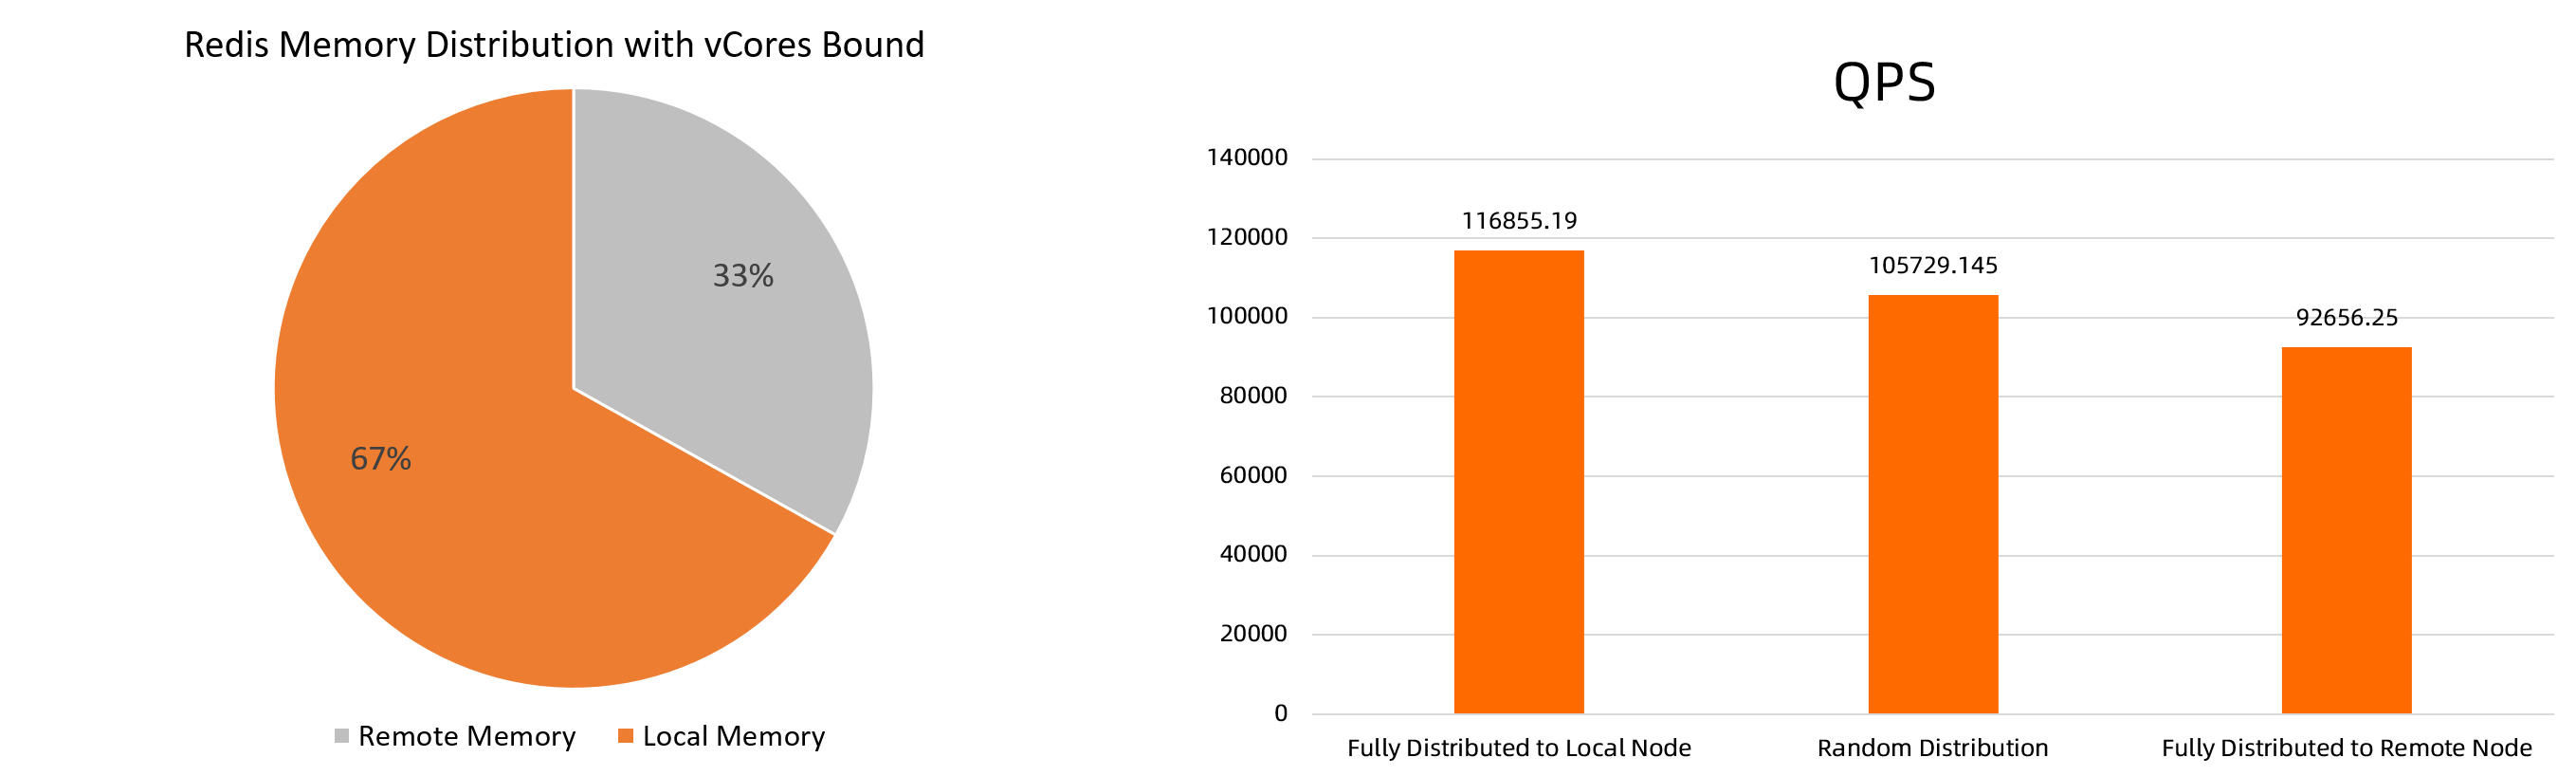
Benchmarks em uma instância ecs.ebmc8i.48xlarge executando Redis mostram que memória totalmente local entrega QPS 10,52% maior que memória distribuída aleatoriamente e QPS 26,12% maior que memória totalmente remota.
Os valores de benchmark são teóricos. Os resultados reais variam conforme o ambiente.
Casos de uso
O recurso de aceleração de acesso à memória próxima é adequado para:
Cargas de trabalho intensivas em memória — bancos de dados Redis em memória de grande escala e cargas similares em que a latência de acesso à memória afeta diretamente o throughput.
Instâncias ECS com DSA ativado — Instâncias ECS integradas ao Intel Data Streaming Accelerator (DSA) podem melhorar o desempenho do recurso e reduzir o consumo de CPU.
Limitações
O recurso é ignorado quando a instância usa arquitetura não NUMA ou quando o processo executa em todos os nós NUMA. Em ambos os casos, não há nó NUMA remoto de onde migrar.
Se um processo for encerrado durante a migração, a migração desse processo falhará. O ack-koordinator registra o ID do processo com falha no evento do pod e continua migrando os demais processos.
Ao usar aceleração periódica (
migrateIntervalMinutes > 0), um evento é registrado apenas quando a alteração na proporção de memória local ou no resultado da aceleração excede 10%.
Ative aceleração de acesso à memória próxima
Etapa 1: Ative o recurso
Dois métodos estão disponíveis. Use o método de anotação para direcionar pods individuais ou use o método ConfigMap para aplicar a configuração a todos os pods de uma determinada classe de qualidade de serviço (QoS).
Ative para um pod individual
Execute o comando a seguir para ativar a aceleração de acesso à memória próxima para um pod:
kubectl annotate pod <pod-name> koordinator.sh/memoryLocality='{"policy": "bestEffort"}' --overwriteO parâmetro policy aceita os seguintes valores:
|
Valor |
Comportamento |
|
|
Aciona uma migração imediata de páginas de memória de nós NUMA remotos para o nó NUMA local |
|
|
Desativa a aceleração de acesso à memória próxima |
Ative para todos os pods de uma classe QoS
-
Crie um arquivo chamado
ml-config.yamlcom o seguinte conteúdo:apiVersion: v1 data: resource-qos-config: |- { "clusterStrategy": { "lsClass": { "memoryLocality": { "policy": "bestEffort" } } } } kind: ConfigMap metadata: name: ack-slo-config namespace: kube-system -
Verifique se o ConfigMap
ack-slo-configjá existe no namespace kube-system:kubectl get cm ack-slo-config -n kube-system-
Se o ConfigMap não existir, crie-o:
kubectl apply -f ml-config.yaml -
Se o ConfigMap já existir, aplique patch nele para evitar sobrescrever configurações de QoS existentes:
kubectl patch cm -n kube-system ack-slo-config --patch "$(cat ml-config.yaml)"
-
Etapa 2: Verifique o recurso
Execute o comando a seguir para verificar os eventos do pod:
kubectl describe pod <pod-name>A tabela a seguir descreve os tipos de evento esperados e seus significados:
|
Tipo de evento |
Mensagem de exemplo |
Significado |
|
|
|
Migração bem-sucedida. O evento registra a direção da migração para cada contêiner e a proporção resultante de memória local. |
|
|
|
Um ou mais processos foram encerrados durante a migração. O evento registra o PID de cada processo com falha. Os contêineres restantes foram migrados com sucesso. |
|
|
|
Nenhum nó NUMA remoto foi encontrado. Isso ocorre em instâncias não NUMA ou quando o processo executa em todos os nós NUMA. Nenhuma ação é necessária. |
|
|
Mensagem de erro varia |
Ocorreu um erro inesperado. Verifique a mensagem de erro para obter detalhes. |
Etapa 3 (Opcional): Defina aceleração periódica
Por padrão, a anotação aciona uma única migração. Para executar migrações repetidamente em um cronograma, adicione o parâmetro migrateIntervalMinutes.
Antes de definir um intervalo recorrente, certifique-se de que a migração mais recente foi concluída. Um evento é registrado apenas quando a proporção de memória local ou o resultado da aceleração muda em mais de 10%.
kubectl annotate pod <pod-name> koordinator.sh/memoryLocality='{"policy": "bestEffort","migrateIntervalMinutes":10}' --overwriteO parâmetro migrateIntervalMinutes especifica o intervalo mínimo entre migrações, em minutos:
|
Valor |
Comportamento |
|
|
Aciona uma única migração imediata (igual a omitir o parâmetro) |
|
|
Aciona uma migração imediata e depois repete no intervalo especificado |
|
|
Desativa o recurso de aceleração de acesso à memória próxima |
Benchmark: impacto no desempenho do Redis
Esta seção descreve resultados de benchmark para os tipos de instância ecs.ebmc8i.48xlarge e ecs.ebmg7a.64xlarge.
Os resultados dependem da ferramenta de teste de estresse e do ambiente. Os resultados a seguir são específicos para esses dois tipos de instância.
Ambiente de teste
Máquinas testadas: instâncias ecs.ebmc8i.48xlarge e ecs.ebmg7a.64xlarge executando uma aplicação Redis
Aplicação Redis: multithread, 4 vCores, 32 GB de memória (imagem:
redis:6.0.5)-
Máquina de teste de estresse: uma máquina separada que envia requisições para a máquina testada
NotaPara máquinas de teste com especificações menores, implante uma instância Redis single-thread e reduza as solicitações de CPU e memória adequadamente.
Procedimento de teste

-
Implante uma aplicação Redis usando o YAML a seguir. Ajuste
redis-configpara corresponder às especificações da sua máquina de teste.--- kind: ConfigMap apiVersion: v1 metadata: name: example-redis-config data: redis-config: | maxmemory 32G maxmemory-policy allkeys-lru io-threads-do-reads yes io-threads 4 --- kind: Service apiVersion: v1 metadata: name: redis spec: type: NodePort ports: - port: 6379 targetPort: 6379 nodePort: 32379 selector: app: redis --- apiVersion: v1 kind: Pod metadata: name: redis annotations: cpuset-scheduler: "true" # Bind vCores using topology-aware CPU scheduling labels: app: redis spec: containers: - name: redis image: redis:6.0.5 command: ["bash", "-c", "redis-server /redis-master/redis.conf"] ports: - containerPort: 6379 resources: limits: cpu: "4" # Adjust based on test machine specifications volumeMounts: - mountPath: /redis-master-data name: data - mountPath: /redis-master name: config volumes: - name: data emptyDir: {} - name: config configMap: name: example-redis-config items: - key: redis-config path: redis.conf -
Aumente as cargas de memória para simular desvio de memória NUMA remota.
-
Grave dados de negócio no Redis usando o script shell a seguir. O script grava dados em lotes via pipelines. Substitua
<max-out-cir>e<max-in-cir>pelos valores apropriados para sua configuração. Para uma instância Redis de 4 vCores e 32 GB, usemax-out-cir=300emax-in-cir=1000000.NotaGravar grandes volumes de dados leva tempo. Execute o script na máquina testada para maximizar a velocidade de gravação.
for((j=1;j<=<max-out-cir>;j++))
do
        echo "set k$j-0 v$j-0" > data.txt
        for((i=1;i<=<max-in-cir>;i++))
        do
                echo "set k$j-$i v$j-$i" >> data.txt
        done
        echo "$j"
        unix2dos data.txt  # Pipeline writes require DOS format
        cat data.txt | redis-cli --pipe -h <redis-server-IP> -p <redis-server-port>
done
Enquanto os dados estão sendo gravados, aumente as cargas de memória de cargas de trabalho colocalizadas no mesmo nó NUMA para simular desvio de memória. Use
numactl --membindpara vincular as cargas de trabalho a um nó NUMA específico. -
Execute o comando a seguir para aumentar a pressão de memória. Substitua
<workers-num>pelo número de processos de estresse e<malloc-size-per-workers>pela memória alocada por processo.NotaComo os vCores estão vinculados ao pod Redis, a memória NUMA local é preferencialmente alocada a ele até que a memória local se esgote e o excesso transborde para nós NUMA remotos. Execute
numactl -Hpara verificar a utilização de memória por nó NUMA e defina os parâmetros adequadamente.numactl --membind=<numa-id> stress -m <workers-num> --vm-bytes <malloc-size-per-workers>
-
-
Execute testes de estresse com a aceleração desativada e ativada.
-
Teste de estresse com aceleração desativada
Envie requisições da máquina de teste de estresse para gerar cargas de nível médio e alto no redis-server.
-
500 requisições simultâneas (carga média):
redis-benchmark -t GET -c 500 -d 4096 -n 2000000 -h <redis-server-IP> -p <redis-server-port> -
10.000 requisições simultâneas (carga alta):
redis-benchmark -t GET -c 10000 -d 4096 -n 2000000 -h <redis-server-IP> -p <redis-server-port>
-
-
Ative aceleração de acesso à memória próxima
Execute o comando a seguir para ativar a aceleração para o pod Redis:
kubectl annotate pod redis koordinator.sh/memoryLocality='{"policy": "BestEffort"}' --overwriteVerifique se a migração foi concluída:
kubectl describe pod redisSaída esperada (grandes volumes de memória remota podem levar tempo para migrar):
Normal MemoryLocalitySuccess 0s koordlet-resmanager migrated memory from remote numa: 0 to local numa: 1, cur local memory ratio 98, rest remote memory pages 28586 -
Teste de estresse com aceleração ativada
Repita os testes de estresse da etapa a para gerar cargas de nível médio e alto.
-
Resultados para ecs.ebmc8i.48xlarge
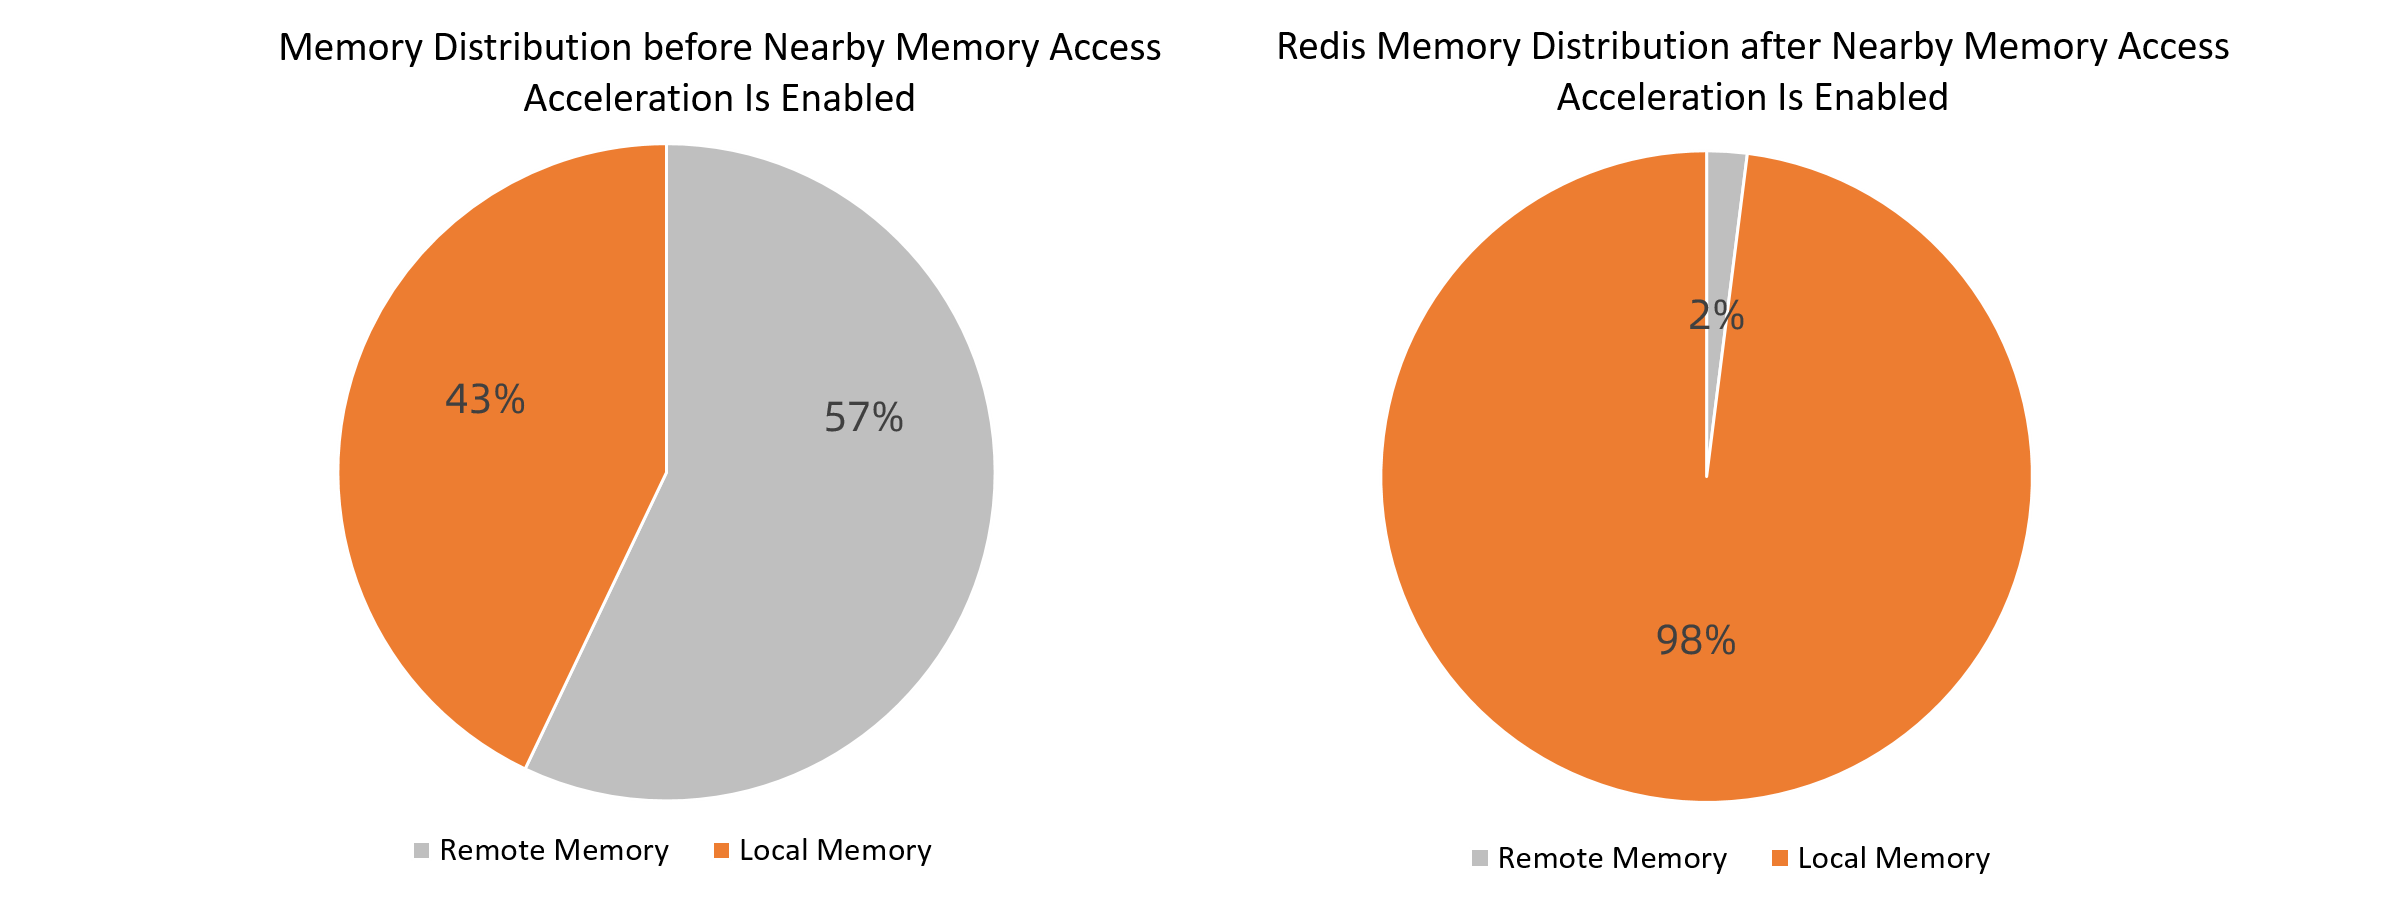
Distribuição de memória: 43% local antes da aceleração, 98% local após a aceleração.
-
500 requisições simultâneas
Cenário
P99 ms
P99,99 ms
QPS
Antes da aceleração
3
9,6
122.139,91
Após a aceleração
3
8,2
129.367,11
Latência P99 inalterada. Latência P99,99 reduzida em 14,58%. QPS aumentou 5,917%.
-
10.000 requisições simultâneas
Cenário
P99 ms
P99,99 ms
QPS
Antes da aceleração
115
152,6
119.895,56
Após a aceleração
101
145,2
125.401,44
Latência P99 reduzida em 12,17%. Latência P99,99 reduzida em 4,85%. QPS aumentou 4,59%.
Resultados para ecs.ebmg7a.64xlarge
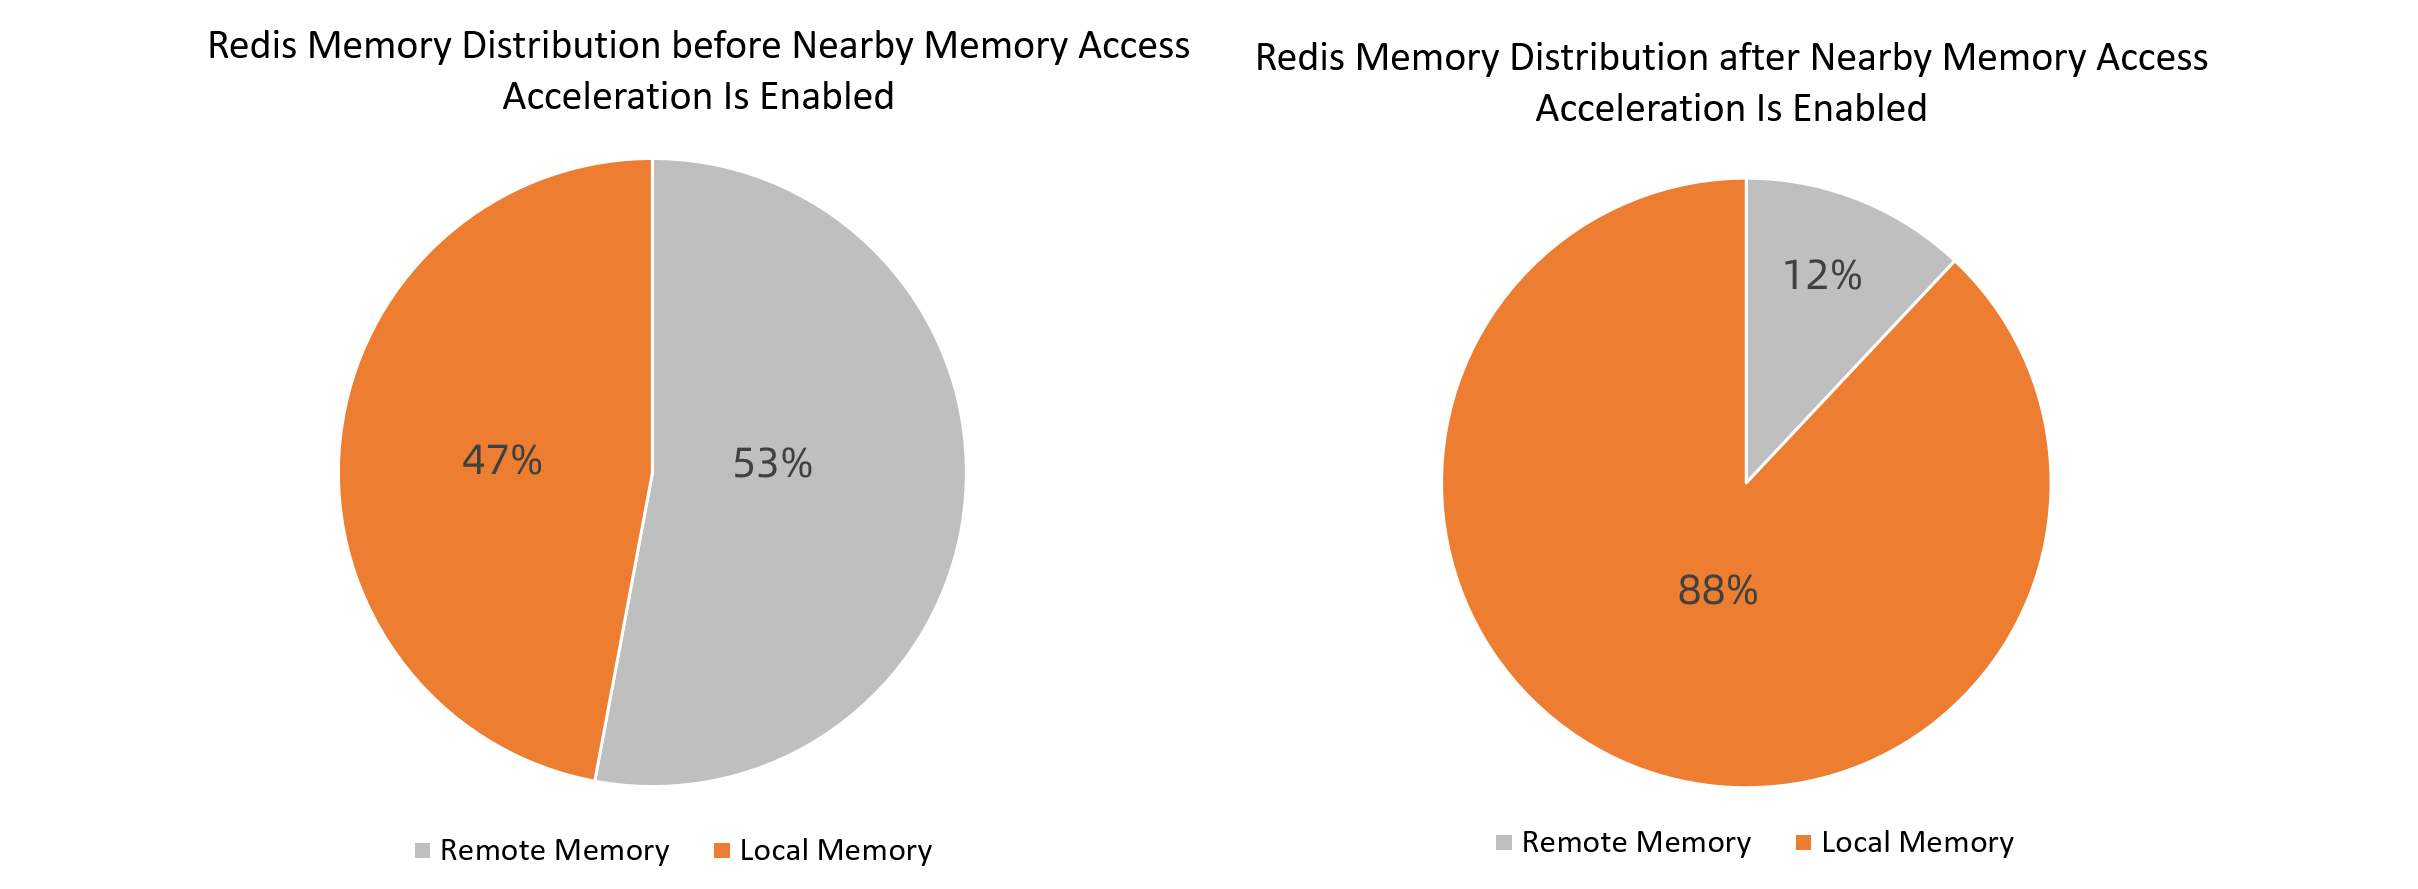
Distribuição de memória: 47% local antes da aceleração, 88% local após a aceleração.
-
500 requisições simultâneas
Cenário
P99 ms
P99,99 ms
QPS
Antes da aceleração
2,4
4,4
135.180,99
Após a aceleração
2,2
4,4
136.296,37
Latência P99 reduzida em 8,33%. Latência P99,99 inalterada. QPS aumentou 0,83%.
-
10.000 requisições simultâneas
Cenário
P99 ms
P99,99 ms
QPS
Antes da aceleração
58,2
80,4
95.757,10
Após a aceleração
56,6
76,8
97.015,50
Latência P99 reduzida em 2,7%. Latência P99,99 reduzida em 4,4%. QPS aumentou 1,3%.
Conclusão: Sob altas cargas de memória em que os dados da aplicação foram desviados para nós NUMA remotos, vincular vCores e ativar a aceleração de acesso à memória próxima reduz a latência de acesso e aumenta o throughput do Redis tanto em concorrência média quanto alta.