このトピックでは、コンソールでモデルのファインチューニングタスクを実行する方法について説明し、適切なファインチューニング方法とパラメーターを選択するのに役立ちます。モデルのファインチューニングには、教師ありファインチューニング (SFT)、継続的事前学習 (CPT)、Direct Preference Optimization (DPO) の 3 つのトレーニング方法が含まれます。
モデルファインチューニングのプロセス
ステップ 1:ファインチューニング方法の選択
[モデルファインチューニング] ページに移動し、トレーニングタスクを作成する ボタンをクリックします。
[トレーニングタスクの作成] ページに入った後、[トレーニング設定] エリアで [トレーニング方法] を [効率的なトレーニング] または [全パラメーターのトレーニング] として選択できます。ページの右側にある [トレーニングタスクの概要] パネルには、現在のタスクのモデル、優先度、課金方法、その他の設定概要がリアルタイムで表示されます。
[基本情報] セクションで、[ジョブ名] と [ジョブの優先度] を設定します。ジョブの優先度には L0、L1、L2、L3 の 4 つのレベルがあり、高い順にリストされています。優先度はトレーニングジョブのスケジューリング順序に影響します。優先度が高いほど、実行が早くなります。
CPT、SFT、DPO の選択方法
CPT (継続的事前学習) は、大量のラベルなしデータを使用して、特定の業界におけるモデルのパフォーマンスを向上させます。
SFT (教師ありファインチューニング) は、ターゲットを絞ったデータセットとトレーニングを使用して、特定のビジネスシナリオにおけるモデルのパフォーマンスを向上させます。
DPO (Direct Preference Optimization) は、トレーニングデータセットで正例と負のサンプルのペアを使用します。否定的なフィードバックを取り入れることで、ハルシネーションを減らし、特定の不適切なケースを最適化します。
Model Studio が提供する 3 つのファインチューニング方法は相互排他的ではなく、進歩的かつ補完的です。
CPT (オプション) → SFT → DPO (オプション)
-
CPT (継続的事前学習) - 知識を補完します (一般的なモデルは広範だが浅い知識しか持たず、専門分野の深さと精度の要件を満たせない場合があります)
- 金融モデル:
金融用語を学習 - 医療モデル:
薬剤の病理を記憶 - 法律モデル:
法律の条文や判例を理解
- 金融モデル:
-
SFT (教師ありファインチューニング) - タスクの実行方法を学習します
- カスタマーサービスボット:
カスタマーサービスの手順を学習 - コードアシスタント:
プログラミングパラダイムを学習 - ツール呼び出し (エージェント):
MCP の使用方法を学習
- カスタマーサービスボット:
-
DPO (Direct Preference Optimization) - タスクをより良く実行します
- 安全性と責任:
有害な提案を拒否 - 簡潔さと有効性:
簡潔な回答を提供 - 客観性と中立性:
公正かつ客観的に評価
- 安全性と責任:
SFT トレーニングセット
SFT ChatML (Chat Markup Language) 形式のトレーニングデータは、マルチターン対話とさまざまなロール設定をサポートします。
OpenAI の
nameおよびweightパラメーターはサポートされていません。すべてのアシスタントの出力がトレーニングされます。
# トレーニングデータの 1 行 (JSON 形式) は、展開すると次のような典型的な構造になります:
{"messages": [
  {"role": "system", "content": "システム入力 1"},
  {"role": "user", "content": "ユーザー入力 1"},
  {"role": "assistant", "content": "期待されるモデル出力 1"},
  {"role": "user", "content": "ユーザー入力 2"},
  {"role": "assistant", "content": "期待されるモデル出力 2"}
  ...
]}
system、user、assistant の違いについては、「概要」をご参照ください。サンプルトレーニングデータセット:SFT-ChatML_format_example.jsonl、SFT-ChatML_format_example.xlsx。XLS および XLSX 形式は、シングルターンの対話のみをサポートします。
単一のトレーニングデータ入力におけるすべてのアシスタント行は、"loss_weight" パラメーターをサポートしており、これによりトレーニング中のその行の相対的な重要度を設定します。(範囲:0.0 から 1.0。値が大きいほど重要度が高くなります。)
このパラメーターは招待制プレビューで利用可能です。使用するには、アカウントマネージャーにお問い合わせください。
 {"role": "assistant", "content": "期待されるモデル出力 1", "loss_weight": 1.0},
 {"role": "assistant", "content": "期待されるモデル出力 2", "loss_weight": 0.5}
各トレーニング方法のデータ量要件については、「データセットサイズの要件」をご参照ください。
Alibaba Cloud Model Studio は、モデルのファインチューニングを次の順序で使用することを推奨します:CPT (オプション) → SFT → DPO:- まず、大量 (少なくとも 1,000 万トークン) のラベルなしドメイン固有データを収集し、CPT を実行してモデルを業界やドメインの専門家にします。
- アプリケーションを起動する前に、特定のシナリオやビジネスに対して十分な (1,000+) 正例 (入力と期待されるモデル出力のペア) を収集し、SFT を実行します。
- アプリケーションが起動または試用運用に入った後、十分な (100+) ユーザーフィードバック (いいね、嫌い、または直接のフィードバックなど) または不適切なケースを収集します。このデータを DPO トレーニングセットに変換し、DPO を実行します。
初めてモデルをファインチューニングする場合は、公式モデルを選択します。
パフォーマンスが低いためにモデルを再トレーニングする場合は、[マイモデル] > 再トレーニングしたいモデルを選択します。
モデルを選択した後、一部のモデルでは[トレーニングモダリティ] オプション (テキスト生成や視覚理解など) が表示されます。ビジネスシナリオに合ったモダリティを選択してください。サポートされている場合は、[思考モード] オプション (Instruct や Thinking など) も表示されます。必要に応じて選択してください。
全パラメーターのトレーニング vs. 効率的なトレーニング
- 全パラメーターのトレーニングは、学習中にすべてのモデルパラメーターを更新します。
- 効率的なトレーニングは、Low-Rank Adaptation (LoRA) を使用します。これは、重み行列を分解し、低ランクのコンポーネントのみを更新します。
両方の方法のコストは同じであるため、Alibaba Cloud Model Studio は、モデルがサポートしている場合は全パラメーターのトレーニングを使用することを推奨します。これは、効率的なトレーニングよりも優れた結果と高いコスト効率を実現するためです。
ステップ 2:ハイパーパラメーターの設定
トレーニングパラメーターの説明:
すべてのモデルがすべてのパラメーターをサポートしているわけではありません。利用可能なオプションについては、コンソールをご参照ください。
パラメーター名 | 推奨設定 | ハイパーパラメーターの機能 | |
|---|---|---|---|
バッチサイズ (batch_size) | デフォルトを使用 | バッチサイズは、モデルがパラメーターを更新する前に処理するデータサンプルの数を決定します。一般的な値は 16 または 32 です。有効な範囲はモデルとトレーニング方法によって異なります。コンソールをご参照ください。 | パラメーター設定パネルには、バッチサイズに加えて次のトレーニングパラメーターとデフォルト値が含まれています:
|
学習率 (learning_rate) | 効率的なトレーニング:~1e-4 全パラメーターのトレーニング:~1e-5 CPT トレーニング:~1e-5 | モデルが重みを調整する強さを制御します。 学習率が高すぎると、モデルのパラメーターが大幅に変化し、パフォーマンスが悪化する可能性があります。 学習率が低すぎると、パフォーマンスの向上がほとんどありません。 | |
エポック数 (n_epochs) | データ量 < 10,000:3~5 エポック データ量 > 10,000:1~2 エポック 実験結果に基づいて調整 | モデルがトレーニングデータを走査する回数。経験に基づいて調整します。 エポック数が多いほど、トレーニング時間が長くなり、コストが高くなります。範囲:[1, 200]。 | |
評価ステップ (eval_steps) | デフォルトを使用 | トレーニング中にモデルを評価する頻度を、トレーニングステップ単位で測定します。トレーニングの精度と損失を追跡するために使用されます。 このパラメーターは、検証損失と検証トークン精度が表示される頻度を制御します。 | |
学習率スケジューラ (lr_scheduler_type) | 「linear」または「inverse_sqrt」を使用します。 | トレーニング中に学習率を動的に調整する戦略。 詳細については、「学習率スケジューラの種類」をご参照ください。 | |
シーケンス長 (max_length) | モデルがサポートする最大値に設定 | トレーニングサンプルごとの最大トークン長。サンプルがこの長さを超えた場合: SFT はサンプル全体を破棄します。 DPO は制限を超えたトークンを切り捨て、短縮されたサンプルでトレーニングします。 トークンと文字列の変換については、「トークンと文字列の変換方法」をご参照ください。範囲:[500, 32768]。 | |
ウォームアップ比率 (warmup_ratio) | デフォルトを使用 | 学習率のウォームアップに使用される総トレーニングステップの割合。ウォームアップは低い学習率で始まり、目標値まで線形に増加します。 これにより、トレーニング初期のパラメーターの変更が制限され、安定性が向上します。 比率が高すぎると、低い学習率のように機能し、改善がほとんど見られません。 比率が低すぎると、高い学習率のように機能し、パフォーマンスが低下する可能性があります。範囲:[0, 1]。
| |
重み減衰 (weight_decay) | デフォルトを使用 | L2 正則化の強度。L2 正則化は汎化の維持に役立ちます。値が高すぎると、ファインチューニングの効果が低下します。範囲:[0, 0.2]。 | |
効率的なトレーニングパラメーター | |||
LoRA アルファ (lora_alpha) | デフォルトを使用 | 元のモデルの重みと LoRA の低ランク更新のバランスをとるスケーリング係数。 アルファが高いほど、LoRA の更新に重みが置かれ、モデルはタスク固有の情報に依存するようになります。 アルファが低いほど、元の事前学習済み知識がより多く保持されます。 | |
LoRA ドロップアウト (lora_dropout) | デフォルトを使用 | トレーニング中に LoRA の低ランク行列に適用されるドロップアウト率。 推奨値は汎化を向上させます。 値が高すぎると、ファインチューニングの効果が低下します。範囲:[0, 0.2]。 | |
LoRA ランク (lora_rank) | モデルがサポートする最大値に設定 | LoRA の低ランク行列のランク。ランクが高いほど、わずかに良い結果が得られますが、トレーニングは遅くなります。 | |
ViT のフリーズ (freeze_vit) | デフォルトを使用 | ビジョンバックボーンネットワークのパラメーターをフリーズして、トレーニング中に更新されないようにします。Qwen-VL (視覚理解) モデルにのみ適用されます。 トークンベースの課金は、freeze_vit が「true」に設定されている場合にのみ利用可能です。 | |
注記サポートされるパラメーターはトレーニング方法によって異なります:
- SFT (効率的なトレーニング):上記のすべてのパラメーターをサポートします。
- DPO (効率的なトレーニング):「freeze_vit」を除くすべてのパラメーターをサポートします。
- CPT (全パラメーターのトレーニング):バッチサイズ、学習率、エポック数、評価ステップ、学習率スケジューラ、シーケンス長のみをサポートします。LoRA パラメーター、ウォームアップ比率、重み減衰はサポートしません。
学習率スケジューリング戦略の紹介
「学習率スケジューラ」は、[ハイパーパラメーター設定] > [設定の展開] の最初の設定です。8 つの戦略を提供します。
詳細については、以下をご参照ください:
線形:学習率が線形に減少します。 ユースケース:短いトレーニングタスク。
| 多項式:学習率は、トレーニングステップまたはエポックにわたって事前定義された多項式関数に従って減少します。 ユースケース:多項式減衰は、学習率のよりきめ細かい制御を提供し、より複雑なタスクを含むシナリオに適しています。 しかし、組み込みの多項式係数は 1 であり、線形と同じになります。推奨されません。
|
余弦:学習率は余弦曲線に従います。 ユースケース:微調整が必要な長いトレーニングタスク。 | Cosine_with_restarts:学習率は余弦曲線に従い、各サイクルの終わりに初期値にリセットされ、新しいサイクルを開始します。 ユースケース:局所最適解から脱出して、より良い大域的解を見つけるため。 しかし、テストでは、学習率が曲線の底で実際にはリセットされないことが示されています。推奨されません。 |
定数:学習率は変わりません。「ウォームアップ比率」は効果がありません。 ユースケース:初期のパフォーマンス探索。 | Constant_with_warmup:学習率は一定ですが、「ウォームアップ比率」が適用されます。 ユースケース:初期のパフォーマンス探索。 |
Inverse_sqrt:学習率は、トレーニングステップ数の逆平方根に比例して減少します。 ユースケース:SFT ファインチューニング。学習効率と収束のバランスが取れています。
| Reduce_lr_on_plateau:監視対象のメトリック (検証損失または精度) が数連続エポックにわたって大幅な改善を示さない場合に、学習率を自動的に下げます。 ユースケース:モデルがさらに改善するのに苦労している場合に、この戦略は最適化を続けるのに役立ちます。
|
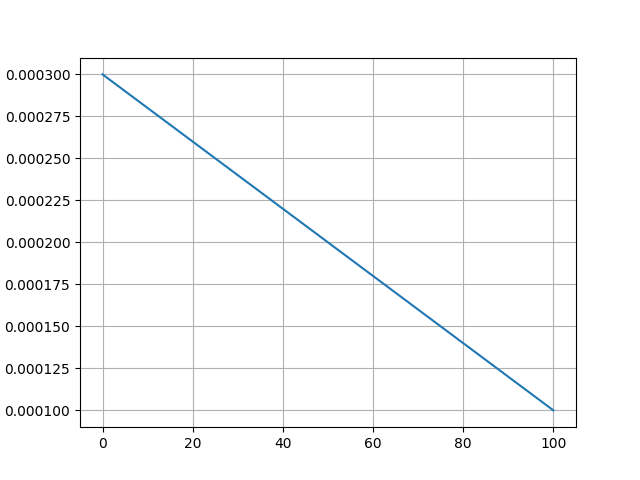
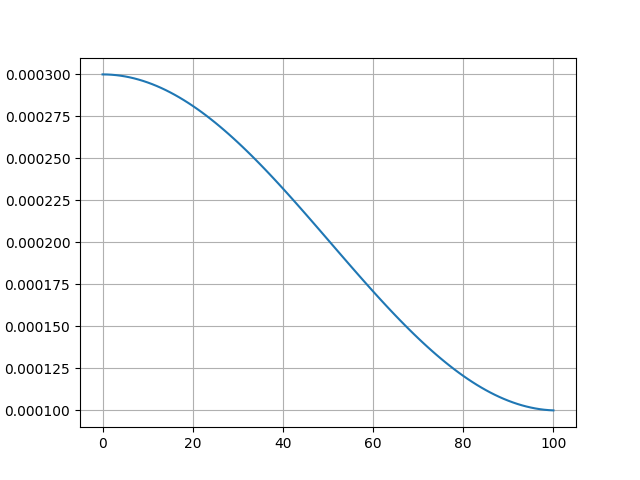
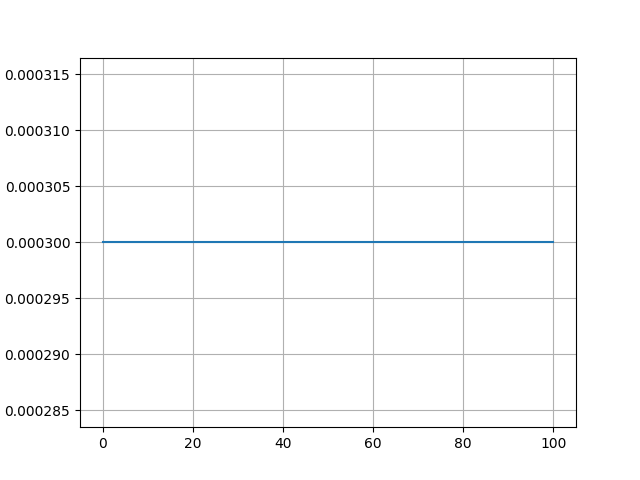
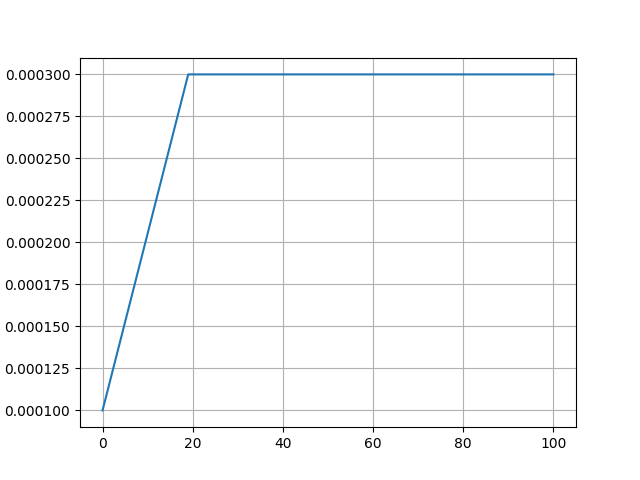
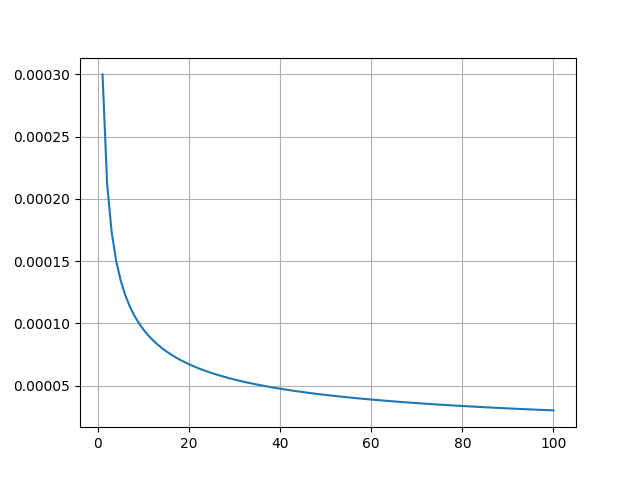
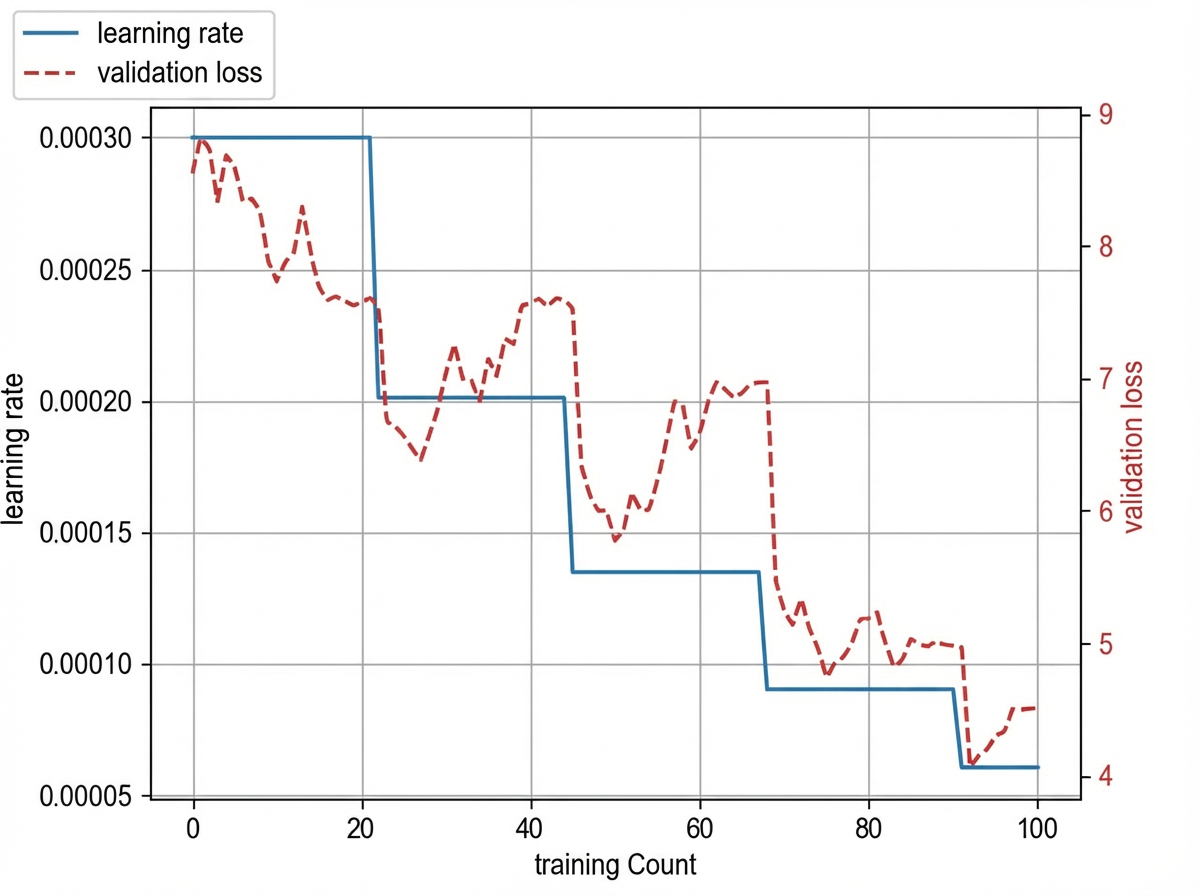
注記グラフに示されている学習率の下限値と最小値は例示です。実際の値は設定によって異なります。
ステップ 3:トレーニングデータの選択
データセット構築のヒントについては、「データセット構築のヒント」をご参照ください。ファインチューニングデータセットをアップロードするには、 [データ管理] ページに移動します。
[データ設定] セクションで、以下を設定します:
- トレーニングセット: [データセットの選択] と [データセットのマウント] の 2 つの方法をサポートしています。[データセットの選択] では、アップロード済みのファインチューニングデータセットを使用します。[データセットのマウント] では、OSS からデータファイルを直接マウントします。
- 混合トレーニング:有効にすると、追加の混合トレーニングデータセットを追加できます。混合トレーニングは、ファインチューニング中にモデルの一般的な能力を維持し、タスク固有のデータに過学習して一般的な対話能力を失うのを防ぎます。複数のビジネスシナリオのデータがある場合は、これを有効にしてください。
- 検証セット:[自動分割] と [データセットの選択] をサポートします。[自動分割] は、トレーニングデータの 10% をランダムに検証セットとして選択します。別の検証データセットをアップロードすることもできます。検証セットは、トレーニング中のモデルのパフォーマンスを評価し、検証損失と検証トークン精度を表示します。
ステップ 4:トレーニングリソースの設定
[トレーニングリソースの設定] セクションで、トレーニングジョブの課金方法を選択します。
- トークンベースの課金:共有のアイドルリソースを使用します。トレーニング中に消費されたトークンの数に基づいて課金されます。トレーニング速度はリソースの可用性に依存し、キューイングが発生する場合があります。
注記詳細な課金情報と価格については、「モデルファインチューニングの概要 – 課金」をご参照ください。
ステップ 5:トレーニング出力
以下の設定は、SFT、DPO、および CPT トレーニングに適用されます。
注記モデルのファインチューニングが完了した後、Model Studio プラットフォームでパラメータースナップショットをエクスポートできます。その後、このパラメータースナップショットに基づいて Model Studio 上でモデルをデプロイできます。
エクスポートされたパラメータースナップショットはクラウドストレージに保存され、アクセスまたはダウンロードすることはできません。
モデルのエクスポート で、以下を設定します:
- モデル名:出力モデルの名前を設定します。トレーニングが完了すると、最終的なチェックポイントがこの名前で My Models に自動的に公開されます。
- [最大スナップショット数]:保持するチェックポイントの最大数を設定します。
- [チェックポイント間隔]:チェックポイントを保存する頻度を、エポック (トレーニングサイクル) またはステップ (トレーニングステップ) で設定します。
- モデル暗号化 (セキュリティアップグレード):有効にすると、プラットフォームはフルマネージドキーを使用して OSS サーバーサイド暗号化 (SSE-OSS) でモデルファイルを暗号化します。暗号化アルゴリズム:AES256。
ステップ 6:モデルのトレーニング
[トレーニングの開始] をクリックし、[モデルファインチューニング課金通知] を確認して、トレーニングを開始します。
権限が不十分な場合は、「モデルのファインチューニングで権限が不足している場合の対処法
トレーニング中に、[ログ] ボタンをクリックしてリアルタイムのトレーニングログを表示できます。また、[メトリック] タブに移動して、トレーニング損失、検証損失、または検証トークン精度をモニターすることもできます。
トレーニング完了後、トレーニング損失と検証損失の傾向を確認します。
-
トレーニング損失が減少し、検証損失が増加する場合、モデルは過学習しています。トレーニングは失敗したか、結果が悪い可能性があります。以下の最適化を (推奨順に) 適用し、再トレーニングします:
- データ拡張を使用して、データの多様性と量を増やします。
- より多くのトレーニングデータを収集して、多様性と量を増やします。
- ハイパーパラメーターを調整します:エポック数を減らし、学習率を下げ、バッチサイズを小さくし、重み減衰を増やし、LoRA ドロップアウトを上げ、ウォームアップ比率を増やします。
-
トレーニング損失がほとんど変化しないか、増加する場合 (まれ)、モデルは学習不足です。トレーニングは失敗しました。以下の最適化を (推奨順に) 適用し、トレーニングを続行します:
- データ品質を確認し、徹底的なデータクレンジングを確保します。
- ハイパーパラメーターを調整します:エポック数を増やし、学習率を上げ、バッチサイズを大きくし、重み減衰を減らし、LoRA ドロップアウトを下げ、ウォームアップ比率を減らします。
-
どちらの問題も発生しない場合は、次のステップに進みます。
ステップ 7:デプロイメントのためにモデルを公開する
中間モデルのスナップショットの公開は、SFT ファインチューニングのみがサポートしています。
トレーニングが完了すると、最終的なチェックポイントは、ステップ 5:トレーニング出力で設定した名前で [マイモデル] に自動的に公開されます。
中間チェックポイントを公開するには、トレーニングジョブの詳細ページの 出力 タブに移動します。保存されたチェックポイントのリストを表示し、ターゲットのチェックポイントを選択して、モデル公開 をクリックします。
出力 タブには、チェックポイント ID、保存情報、公開ステータス、モデル名、残りの保持期間、作成時刻、およびアクションが表示されます。
注記チェックポイントには保持期間があります。期限が切れると、自動的に削除され、公開できなくなります。必要なスナップショットは速やかに公開してください。
公開されたモデルは [マイモデル] ページに表示され、デプロイできます。
ステップ 8:モデルのデプロイ
[マイモデル] ページに移動して、サポートされているデプロイモード、モデル ID、その他の詳細をすばやく見つけます。デプロイ後、ファインチューニングされたモデルを評価します。デプロイの詳細については、「モデルデプロイ」をご参照ください。
ステップ 9:モデルの評価
重要複数のビジネスシナリオがある場合や、混合トレーニングデータを使用した場合は、評価セットをシナリオごとに分割し、各シナリオを個別に評価して、ファインチューニングが要件を満たしていることを確認してください。
Alibaba Cloud Model Studio の [モデル評価] 機能を使用して、カスタムモデルのパフォーマンスを評価します。詳細については、「ヘルプセンター:モデル評価の概要」をご参照ください。
よくある質問
モデルのファインチューニングはいつ使用すべきですか?
-
テキスト生成モデルのファインチューニングは、特定のビジネスシナリオで優れた結果を達成できますが、以下の制限があります:
- 時間のかかる作業:大規模な CPT データセット (少なくとも 5,000 万トークン) の作成、効果的な SFT データセット (1,000+ エントリ) の構築、モデルデプロイの課金のための効果的な DPO データセットを構築するための十分な不適切なケース (100+) の収集、およびモデル最適化の反復の遅さなどが含まれます。
- 高コスト:ファインチューニングされたモデルはデプロイ後にのみ使用でき、モデルデプロイの課金は高額です。
-
Alibaba Cloud Model Studio は、まず プロンプトエンジニアリングまたは 関数呼び出しを使用してアプリケーションをカスタマイズすることを推奨します。モデルのファインチューニングは、通常、モデルのパフォーマンスを向上させるための「最後の手段」です。これは、以下の理由によります:
- 多くのタスクでは、モデルは最初はパフォーマンスが低いかもしれませんが、正しいプロンプト技術を適用することで、モデルのファインチューニングを必要とせずに結果を改善できます。
- プロンプトとプラグインを反復的に最適化する方が、モデルのファインチューニングの反復よりも機敏でコスト効率が高いです。なぜなら、ファインチューニングには、データの再収集、クレンジング、最適化、不適切なケースの収集、顧客調査の実施が必要になる場合があるためです。
- 最終的にモデルのファインチューニングを行うことを決定した場合でも、プロンプトエンジニアリングとプラグイン最適化に関する初期作業は無駄にはなりません。この予備作業は、ファインチューニングデータセットを構築する際に完全に再利用できます。
モデルのファインチューニング中に権限エラーが発生した場合はどうすればよいですか?
プラットフォームまたはワークスペースの管理者に連絡して、以下の権限を確認し、付与してもらってください:
-
ご利用のアカウントには、ファインチューニングジョブを実行するワークスペースで、[モデルファインチューニング – 操作]、[モデルデプロイ – 操作]、および [モデル評価 – 操作] のページ権限が必要です。
詳細については、「アカウント権限管理」をご参照ください。コンソールリンク: Model Studio – アカウント管理。
-
ファインチューニングジョブを実行するワークスペースには、特定のモデルに対する Model Training (ファインチューニング) 権限が必要です。
詳細については、「サブワークスペースにモデルの呼び出し、トレーニング、およびデプロイメントの権限を付与する」をご参照ください。コンソールリンク: Model Studio – ワークスペース管理。
[ビジネススペース管理] の [モデルリスト] ページで、ターゲットモデル (例:Qwen3-8B) の Model Training 列が [承認済み] ステータスであることを確認します。
ファインチューニング後の評価結果が悪い場合はどうすればよいですか?
- 手動評価を使用している場合は、評価基準がビジネスやシナリオと一致していることを確認します。
- 評価結果が悪いテストケースを収集し、なぜ失敗したかを分析し、それに応じてトレーニングデータセットを調整します。その後、ファインチューニングを反復します。
- 評価の悪いケースから DPO の例を生成し、DPO トレーニングを実行します。
Alibaba Cloud Model Studio でファインチューニングしたモデルをローカルデプロイ用にダウンロードできますか?
Alibaba Cloud Model Studio でファインチューニングされたモデルはエクスポートできません。Model Studio にデプロイした後にのみテストおよび呼び出しが可能です。
トレーニングデータが不足しているためにモデルのファインチューニングが失敗した場合はどうすればよいですか?
データ不足のためにファインチューニングが失敗した場合は、[シーケンス長] (max_length) パラメーターを調整してみてください。
説明シーケンス長は、トレーニングサンプルごとの最大トークン長を設定します。SFT (教師ありファインチューニング) では、この長さを超えるサンプルは破棄されます。シーケンス長が大きすぎると、多くのサンプルが破棄され、トレーニングに十分なデータが残らず、失敗の原因となる可能性があります。
ソリューション- トレーニングジョブを作成する際に、[パラメーター設定] を展開し、[max_length] (シーケンス長) を見つけます。
- シーケンス長を短くして (例えば 8192 に)、より多くのサンプルが長さの要件を満たし、トレーニングに参加できるようにします。
- トレーニングジョブを再送信します。
注記モデルファインチューニングジョブのリストで、失敗したジョブの横にある ログ をクリックして、正確な失敗理由を確認できます。
ファインチューニングされたモデルがプレイグラウンドでまだベースモデルの ID で応答する場合はどうすればよいですか?
Model Studio コンソールの [プレイグラウンド] ページは、システムプロンプトの設定をサポートしていません。その結果、ファインチューニングデータからの ID 設定が有効にならず、モデルはベースモデルとして応答します。
ファインチューニングされた ID 設定を確認するには、次のいずれかの方法を使用します:
- 方法 1:API を介してモデルを呼び出し、リクエストに
systemパラメーターを含めてシステムプロンプトを渡します。 - 方法 2:Model Studio コンソールの [モデルデバッグ] ページを使用して、テスト前にシステムプロンプトを設定します。