Este tema describe cómo sincronizar datos desde una base de datos OceanBase en modo compatible con MySQL o compatible con Oracle hacia una instancia de DataHub.
Requisitos previos
El servicio de transmisión de datos debe tener privilegios para acceder a los recursos en la nube. Para obtener más información, consulte Grant privileges to roles for data transmission.
Debe haber creado un usuario de base de datos dedicado para la sincronización de datos en la base de datos OceanBase de origen y haberle otorgado los privilegios correspondientes. Para obtener más información, consulte Create a database user.
Límites
Al seleccionar la sincronización completa, el servicio de transmisión de datos solo admite tablas con claves únicas.
La sincronización DDL solo aplica a temas BLOB.
Durante la sincronización de datos, el servicio de transmisión de datos permite eliminar una tabla antes de crear una nueva. Es decir, puede ejecutar
DROP TABLEy luego ejecutarCREATE TABLE. El servicio de transmisión de datos no permite crear una nueva tabla renombrando una existente; por lo tanto, no es posible ejecutarRENAME TABLE a TO a_tmp.El servicio de transmisión de datos admite la sincronización de datos con los conjuntos de caracteres UTF8 y GBK.
El nombre de la tabla que se va a sincronizar, así como los nombres de sus columnas, no deben contener caracteres chinos.
El servicio de transmisión de datos solo admite la sincronización de un objeto cuando se cumplen las siguientes condiciones: el nombre de la base de datos, el nombre de la tabla y el nombre de la columna del objeto están codificados en ASCII sin caracteres especiales. Los caracteres especiales incluyen saltos de línea, espacios y los siguientes símbolos: . | " ' ` ( ) = ; / & \.
El servicio de transmisión de datos no admite una base de datos OceanBase en espera como origen.
DataHub tiene los siguientes límites:
DataHub limita el tamaño de un mensaje según el entorno de nube. Por lo general, un mensaje puede tener un tamaño máximo de 1 MB. DataHub envía mensajes en lotes, y cada lote no supera los 4 MB.
Consideraciones
En una tarea de sincronización de datos donde el origen es una base de datos OceanBase y la sincronización DDL está habilitada, si se realiza una operación
RENAMEen una tabla de la base de datos de origen, se recomienda reiniciar la tarea para evitar la pérdida de datos durante la sincronización incremental.If the source is an OceanBase database of a version ranging from V4.0.0 to V4.3.x (excluding V4.2.5 BP1) and you have selected incremental synchronization, you need to specify the STORED attribute for a generated column. If you do not specify this attribute, no information about the generated column is stored in the incremental logs, which may result in data errors in incremental synchronization.
-
Tenga en cuenta las siguientes consideraciones cuando una fila actualizada contiene una columna de objeto grande (LOB):
-
Si la columna LOB se actualiza, no utilice el valor almacenado en dicha columna antes de la operación
UPDATEoDELETE.Los siguientes tipos de datos se almacenan en columnas LOB: JSON, GIS, XML, tipo definido por el usuario (UDT) y TEXT, como LONGTEXT y MEDIUMTEXT.
Si la columna LOB no se actualiza, el valor almacenado en ella antes y después de la operación
UPDATEoDELETEserá NULL.
-
-
Si selecciona únicamente Incremental Synchronization al crear la tarea de sincronización de datos, el servicio de transmisión de datos requiere que los registros incrementales locales en la base de datos de origen se conserven durante al menos 48 horas.
Si selecciona Full Synchronization e Incremental Synchronization al crear la tarea de sincronización de datos, el servicio de transmisión de datos requiere que los registros incrementales locales en la base de datos de origen se conserven durante al menos siete días. De lo contrario, la tarea de sincronización podría fallar o los datos en el origen y el destino podrían ser inconsistentes porque el servicio de transmisión de datos no podrá obtener los registros incrementales.
-
Al sincronizar datos incrementales desde una base de datos OceanBase hacia una instancia de DataHub, el esquema se sincroniza con el esquema de DataHub y luego se inicializa. La siguiente tabla enumera los tipos de datos admitidos por DataHub. Estos tipos de datos aplican únicamente a temas Tuple.
Tipo
Descripción
Rango de valores
BIGINT
Entero con signo de 8 bytes.
-9223372036854775807 a 9223372036854775807
DOUBLE
Número de punto flotante de doble precisión de 8 bytes.
-1.0 _10^308 a 1.0 _10^308
BOOLEAN
Valor booleano.
True/False
true/false
0/1
TIMESTAMP
Marca de tiempo.
Precisión de microsegundos.
STRING
Cadena que solo admite codificación UTF-8.
Una sola columna STRING admite un máximo de 2 MB.
INTEGER
Entero de 4 bytes.
-2147483648 a 2147483647
FLOAT
Número de punto flotante de precisión sencilla de 4 bytes.
-3.40292347_10^38 a 3.40292347_10^38
DECIMAL
Valor numérico.
- 10^38 + 1 a 10^38 - 1
Tipos de instancias de origen y destino compatibles
En la siguiente tabla, OB_MySQL representa una base de datos OceanBase en modo compatible con MySQL, y OB_Oracle representa una base de datos OceanBase en modo compatible con Oracle.
|
Origen |
Destino |
|
OB_MySQL (instancia de clúster OceanBase) |
DataHub (instancia de DataHub en Alibaba Cloud) |
|
OB_MySQL (instancia de clúster OceanBase) |
DataHub (instancia de DataHub en la red pública) |
|
OB_MySQL (instancia serverless) |
DataHub (instancia de DataHub en Alibaba Cloud) |
|
OB_MySQL (instancia serverless) |
DataHub (instancia de DataHub en la red pública) |
|
OB_Oracle (instancia de clúster OceanBase) |
DataHub (instancia de DataHub en Alibaba Cloud) |
|
OB_Oracle (instancia de clúster OceanBase) |
DataHub (instancia de DataHub en la red pública) |
DDL compatible
Si el origen es una base de datos OceanBase en modo compatible con MySQL y ha seleccionado Tuple como tipo de tema, solo se puede sincronizar la sentencia DDL
ALTER ADD COLUMNy las restricciones NOT NULL se ignoran durante la sincronización.Si el origen es una base de datos OceanBase en modo compatible con Oracle, la sincronización DDL solo aplica a temas BLOB.
-
ALTER TABLEADD COLUMNMODIFY COLUMNDROP COLUMN
CREATE INDEXDROP INDEX-
TRUNCATE TABLENotaEn la eliminación diferida, la misma transacción contiene dos sentencias DDL
TRUNCATE TABLEidénticas. En este caso, se implementa la idempotencia para el consumo posterior.
Asignaciones de tipos de datos
Una tarea que sincroniza datos hacia una instancia de DataHub solo admite los siguientes tipos de datos: INTEGER, BIGINT, TIMESTAMP, FLOAT, DOUBLE, DECIMAL, STRING y BOOLEAN.
Si crea un tema de otro tipo al configurar la asignación de temas, la sincronización de datos fallará.
La siguiente tabla describe las reglas de asignación predeterminadas, las cuales son las más adecuadas. Si modifica la asignación, podría producirse un error.
Asignaciones de tipos de datos entre bases de datos OceanBase en modo compatible con MySQL e instancias de DataHub
Para la sincronización desde una base de datos OceanBase en modo compatible con MySQL hacia una instancia de DataHub, puede seleccionar BLOB o Tuple como tipo de tema. Las siguientes tablas describen las asignaciones de tipos de datos entre una base de datos OceanBase en modo compatible con MySQL y una instancia de DataHub cuyo tipo de tema es Tuple, cuando ha seleccionado Default o DTSCompatible para Serialization Method. Para ver las asignaciones de tipos de datos para instancias de DataHub cuyo tipo de tema es BLOB, consulte Data formats.
-
La siguiente tabla describe las asignaciones de tipos de datos entre una base de datos OceanBase en modo compatible con MySQL y una instancia de DataHub cuyo tipo de tema es Tuple, cuando ha seleccionado Default para Serialization Method.
Tipo de dato en una base de datos OceanBase en modo compatible con MySQL
Tipo de dato asignado predeterminado en una instancia de DataHub
BIT
STRING (codificado en Base64)
CHAR
STRING
BINARY
STRING (codificado en Base64)
VARBINARY
STRING (codificado en Base64)
INT
BIGINT
TINYTEXT
STRING
SMALLINT
BIGINT
MEDIUMINT
BIGINT
BIGINT
DECIMAL (Se utiliza este tipo de dato porque el valor máximo sin signo excede el valor máximo LONG en Java).
FLOAT
DECIMAL
DOUBLE
DECIMAL
DECIMAL
DECIMAL
DATE
STRING
TIME
STRING
YEAR
BIGINT
DATETIME
STRING
TIMESTAMP
TIMESTAMP (precisión de milisegundos)
VARCHAR
STRING
TINYBLOB
STRING (codificado en Base64)
TINYTEXT
STRING
BLOB
STRING (codificado en Base64)
TEXT
STRING
MEDIUMBLOB
STRING (codificado en Base64)
MEDIUMTEXT
STRING
LONGBLOB
STRING (codificado en Base64)
LONGTEXT
STRING
-
La siguiente tabla describe las asignaciones de tipos de datos entre una base de datos OceanBase en modo compatible con MySQL y una instancia de DataHub cuyo tipo de tema es Tuple, cuando ha seleccionado DTSCompatible para Serialization Method.
Tipo de dato en una base de datos OceanBase en modo compatible con MySQL
Tipo de dato asignado predeterminado en una instancia de DataHub
CHAR
STRING
VARCHAR
STRING
BINARY
STRING
VARBINARY
STRING
BIT(1)
El valor BIT puede ser 0 o 1.
BOOLEAN
El valor BIT 0 representa el valor booleano
falseen la instancia de DataHub.El valor BIT 1 representa el valor booleano
trueen la instancia de DataHub.
BIT(n)
STRING (codificado en HEX)
El número de bits contenidos en un valor puede ser inconsistente entre el origen y el destino. Tome BIT(10) como ejemplo. El valor 0 se muestra como 000 en Data Transmission Service (DTS) y como 00 tras la sincronización mediante el servicio de transmisión de datos de ApsaraDB for OceanBase.
TINYINT
BIGINT
SMALLINT
BIGINT
MEDIUMINT
BIGINT
INT
BIGINT
BIGINT
BIGINT
Los valores BIGINT en la instancia de DataHub de destino tienen signo y oscilan entre -9223372036854775807 y 9223372036854775807. Si un valor BIGINT sin signo que excede 9223372036854775807 en el origen se sincroniza con la instancia de DataHub, puede producirse un desbordamiento de datos en el destino, lo que provocaría inconsistencia en los datos.
FLOAT
DOUBLE
Los valores de este tipo de dato tienen siete dígitos significativos; más allá de ese límite, puede haber inconsistencia en la precisión.
DOUBLE
DOUBLE
Los valores de este tipo de dato tienen 16 dígitos significativos; más allá de ese límite, puede haber inconsistencia en la precisión.
DECIMAL
DECIMAL
DATE
TIMESTAMP (convertido a UTC+8; precisión de microsegundos)
TIME
STRING
YEAR
STRING
DATETIME
TIMESTAMP (convertido a UTC+8; precisión de microsegundos)
TIMESTAMP
TIMESTAMP (precisión de microsegundos)
TINYTEXT
STRING
MEDIUMTEXT
STRING
TEXT
STRING
LONGTEXT
STRING
TINYBLOB
STRING (codificado en HEX)
MEDIUMBLOB
STRING (codificado en HEX)
BLOB
STRING (codificado en HEX)
LONGBLOB
STRING (codificado en HEX)
Asignaciones de tipos de datos entre bases de datos OceanBase en modo compatible con Oracle e instancias de DataHub
|
Tipo de dato en una base de datos OceanBase en modo compatible con Oracle |
Tipo de dato asignado predeterminado en una instancia de DataHub |
|
CHAR |
STRING |
|
NCHAR |
STRING |
|
VARCHAR2 |
STRING |
|
NVARCHAR2 |
STRING |
|
CLOB |
STRING |
|
BLOB |
STRING (codificado en Base64) |
|
NUMBER |
DECIMAL |
|
BINARY_FLOAT |
DECIMAL |
|
BINARY_DOUBLE |
DECIMAL |
|
DATE |
STRING |
|
TIMESTAMP |
STRING |
|
TIMESTAMP WITH TIME ZONE |
STRING |
|
TIMESTAMP WITH LOCAL TIME ZONE |
STRING |
|
INTERVAL YEAR TO MONTH |
STRING |
|
INTERVAL DAY TO SECOND |
STRING |
|
RAW |
STRING (codificado en Base64) |
Propiedades complementarias
Si crea un tema manualmente, agregue las siguientes propiedades al esquema de DataHub antes de iniciar una tarea de sincronización de datos. Si el servicio de transmisión de datos crea automáticamente un tema y sincroniza el esquema, también agregará automáticamente las siguientes propiedades.
La siguiente tabla aplica únicamente a temas Tuple para los cuales ha seleccionado Default para Serialization Method en la sección Advanced Options de la página Synchronization Options.
|
Propiedad |
Tipo |
Descripción |
|
oms_timestamp |
STRING |
Hora en que se realizó el cambio. |
|
oms_table_name |
STRING |
Nuevo nombre de la tabla de origen. |
|
oms_database_name |
STRING |
Nuevo nombre de la base de datos de origen. |
|
oms_sequence |
STRING |
Marca de tiempo en la que los datos se sincronizan con la memoria del proceso. El valor de este campo consta de la hora y cinco dígitos incrementales. Un retroceso del reloj provocará inconsistencia en los datos. |
|
oms_record_type |
STRING |
Tipo de cambio. Valores válidos: |
|
oms_is_before |
STRING |
Indica si los datos son los originales cuando el tipo de cambio es |
|
oms_is_after |
STRING |
Indica si los datos son los modificados cuando el tipo de cambio es |
Cuando el origen es una base de datos OceanBase en modo compatible con MySQL y ha seleccionado Tuple como tipo de tema en la página Select Synchronization Objects y DTSCompatible para Serialization Method en la sección Advanced Options de la página Synchronization Options, se agrega automáticamente el sufijo dts_ a los nombres de las columnas. Por ejemplo, el nombre de columna c1 en la base de datos OceanBase de origen en modo compatible con MySQL se convierte en dts_c1 tras sincronizarse con la instancia de DataHub de destino. La siguiente tabla detalla la conversión de columnas.
Columna | Tipo de dato | Descripción |
dts_record_id | STRING | ID único de un registro de log incremental. El ID del registro se incrementa automáticamente y puede variar entre servidores debido a inconsistencias de reloj durante la migración en escenarios de recuperación ante desastres. |
dts_operation_flag | STRING | Tipo de operación. Valores válidos:
|
dts_db_name | STRING | Nombre de la base de datos. El formato de un nombre de base de datos OceanBase es |
dts_table_name | STRING | Nombre de la tabla. |
dts_utc_timestamp | STRING | Marca de tiempo de la operación, es decir, marca de tiempo del binlog en UTC. |
dts_before_flag | STRING | Indica si los datos son los originales. Valores válidos: Y y N. |
dts_after_flag | STRING | Indica si los datos son los modificados. Valores válidos: Y y N. |
Procedimiento
-
Inicie sesión en ApsaraDB for OceanBase console
y adquiera una tarea de sincronización de datos.
Para obtener más información, consulte Purchase a data synchronization task.
-
Seleccione Data Transmission > Data Synchronization. En la página que aparece, haga clic en Configuration para la tarea de sincronización de datos.
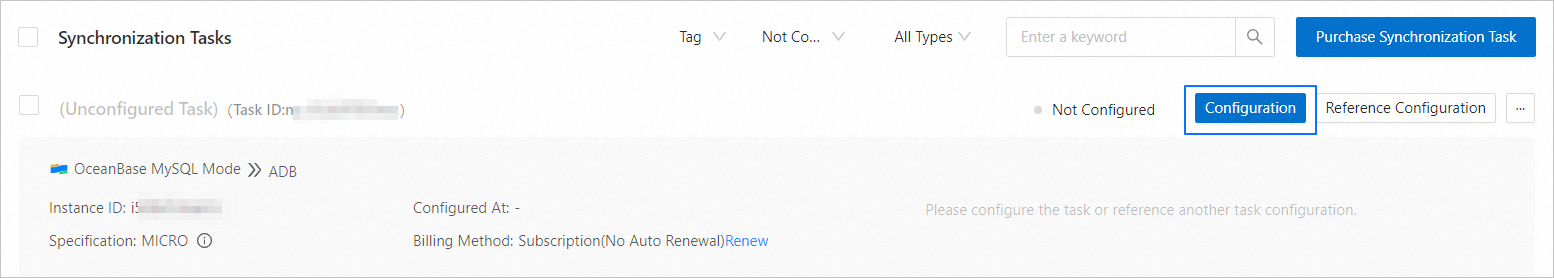
Si desea utilizar la configuración de una tarea existente como referencia, haga clic en Reference Configuration. Para obtener más información, consulte Reference and clear the configuration of a data synchronization task.
-
En la página Select Source and Target, configure los parámetros.
Parámetro
Descripción
Synchronization Task Name
Se recomienda establecer una combinación de letras y dígitos. No debe contener espacios ni exceder los 64 caracteres de longitud.
Source
Si ya creó un origen de datos de OceanBase, selecciónelo en la lista desplegable. De lo contrario, haga clic en New Data Source en la lista desplegable y cree uno en el cuadro de diálogo que aparece a la derecha. Para obtener más información sobre los parámetros, consulte Create an OceanBase data source.
Target
Si ya creó un origen de datos de DataHub, selecciónelo en la lista desplegable. De lo contrario, haga clic en New Data Source en la lista desplegable y cree uno en el cuadro de diálogo que aparece a la derecha. Para obtener más información sobre los parámetros, consulte Create a DataHub data source.
Tag (Optional)
Seleccione una etiqueta de destino en la lista desplegable. También puede hacer clic en Manage Tags para crear, modificar y eliminar etiquetas. Para obtener más información, consulte Use tags to manage data synchronization tasks.
-
Haga clic en Next. En la página Select Synchronization Type, especifique los tipos de sincronización para la tarea de sincronización de datos actual.
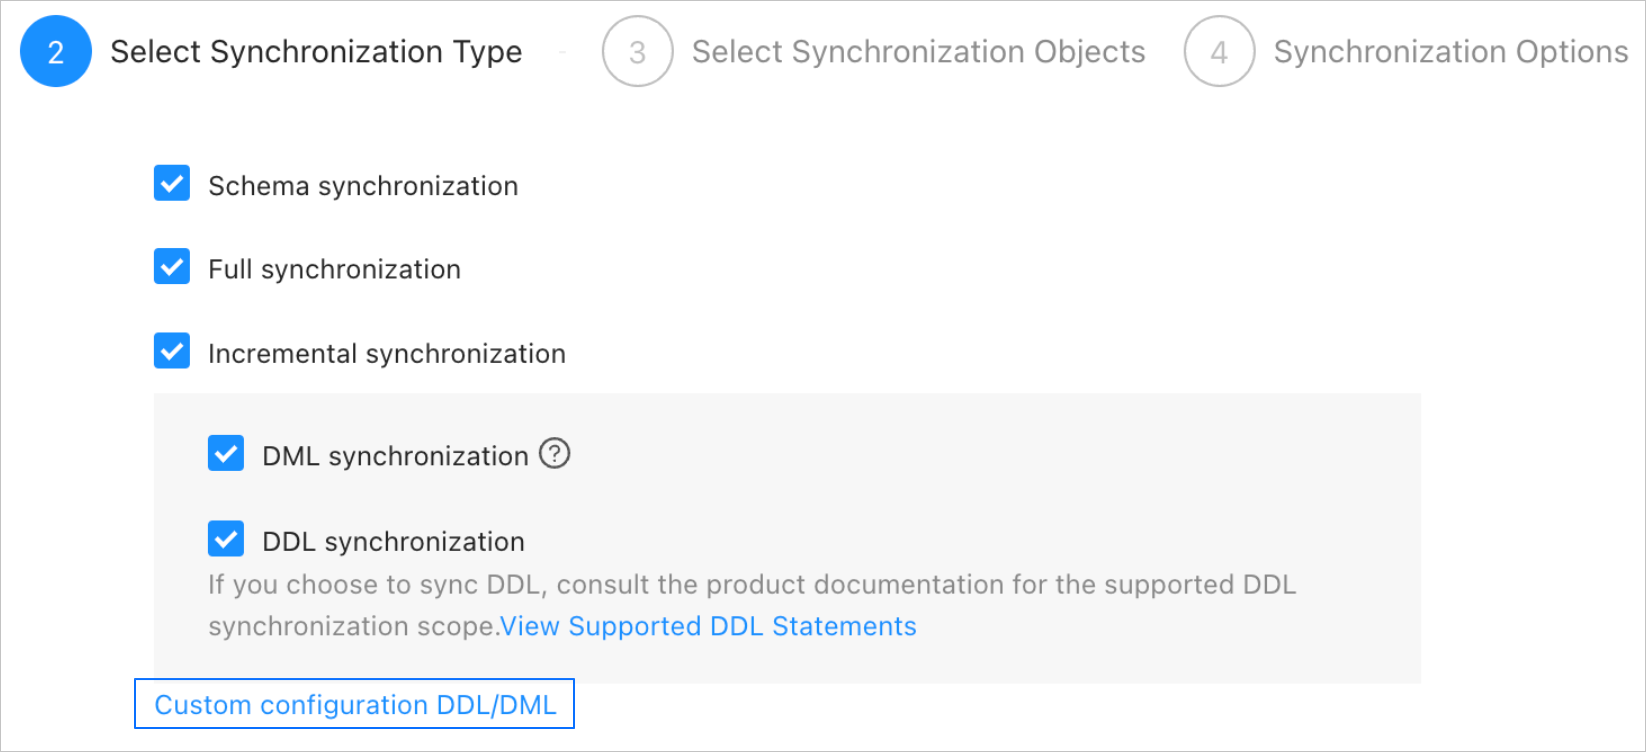
Los tipos de sincronización compatibles son Schema Synchronization, Full Synchronization y Incremental Synchronization. La opción Schema Synchronization crea un topic. Las opciones para Incremental Synchronization son DML Synchronization y DDL Synchronization. Las operaciones DML compatibles son
INSERT,DELETEyUPDATE. Puede seleccionar las opciones y operaciones según sus necesidades. Para obtener más información, consulte Configure DDL/DML synchronization.NotaCuando el origen es una base de datos OceanBase en modo compatible con Oracle y ha seleccionado DDL Synchronization para Incremental Synchronization, solo puede seleccionar BLOB como tipo de topic en la página Select Synchronization Objects.
-
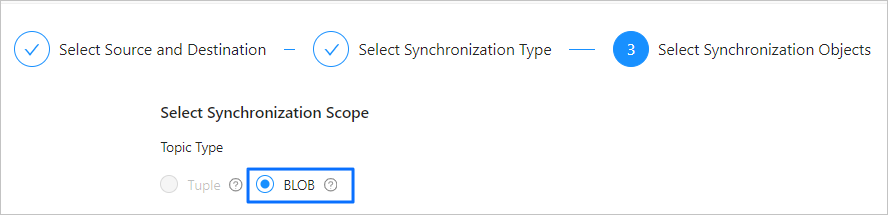
Haga clic en Next. En la página Select Synchronization Objects, seleccione el tipo de topic y los objetos que se sincronizarán en la tarea de sincronización de datos actual.
Los tipos de topic disponibles son Tuple y BLOB. Cuando el origen es una base de datos OceanBase en modo compatible con Oracle, los topics de tipo Tuple no admiten la sincronización DDL, pero sí registros similares a los de una base de datos. Cada registro contiene varias columnas. Los topics de tipo BLOB solo admiten un bloque binario como registro. Los datos se codifican en Base64 para su transmisión. Para obtener más información, visite el centro de documentación de DataHub.
Después de seleccionar el tipo de topic para la sincronización, puede elegir Specify Objects o Match Rules para especificar los objetos de sincronización. Este tema describe cómo usar la opción Specify Objects para definir dichos objetos. Para obtener información sobre cómo configurar reglas de coincidencia, consulte "Patrones de comodines para migración/sincronización de datos entre una base de datos y una instancia de Message Queue" en Configure and modify matching rules.
NotaSi seleccionó DDL Synchronization en el paso Select Synchronization Type, se recomienda seleccionar los objetos de sincronización mediante la opción Match Rules. Esto garantiza que todos los objetos nuevos que cumplan con las reglas de coincidencia se sincronicen. Si seleccionó los objetos de sincronización mediante la opción Specify Objects, los objetos nuevos o renombrados no se sincronizarán.
En la sección Select Synchronization Objects, seleccione Specify Objects.
En el panel izquierdo, seleccione los objetos que desea sincronizar.
Haga clic en >.
-
Seleccione un método de asignación.
-
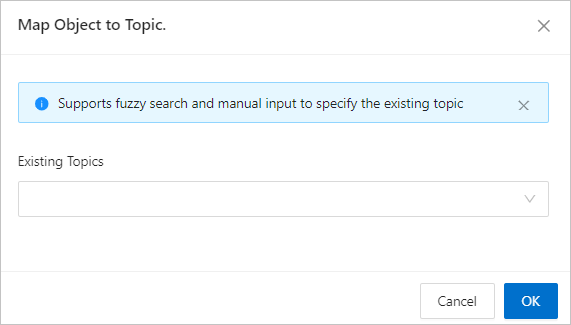
Para sincronizar una sola tabla Tuple o una o varias tablas BLOB, seleccione el método de asignación requerido y haga clic en OK en el cuadro de diálogo Map Object to Topic.
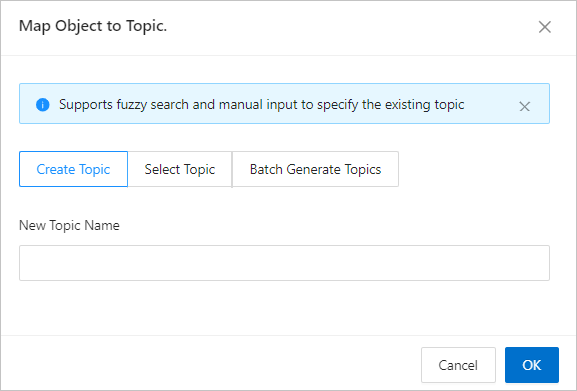
Si no seleccionó Schema Synchronization como tipo de sincronización, solo podrá elegir Existing Topics. Si seleccionó Schema Synchronization al especificar el tipo de sincronización, solo podrá seleccionar un método de asignación para crear o elegir un topic.
Por ejemplo, si seleccionó Schema Synchronization y utiliza tanto los métodos de asignación Create Topic como Select Topic, o si cambia el nombre del topic, se devolverá un error de comprobación previa debido a conflictos de opciones.
Parámetro
Descripción
Create Topic
Introduzca el nombre del nuevo topic en el cuadro de texto. El nombre del topic puede contener letras, dígitos y guiones bajos (_), y debe comenzar con una letra. No debe exceder los 128 caracteres de longitud.
Select Topic
El servicio de transmisión de datos permite consultar topics de DataHub. Puede hacer clic en Select Topic y luego buscar y seleccionar los topics que desea sincronizar en la lista desplegable Existing Topics.
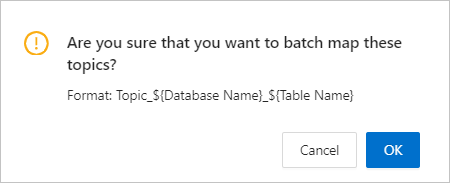
Batch Generate Topics
El formato para generar topics por lotes es
Topic_${Database Name}_${Table Name}.Si selecciona Create Topic o Batch Generate Topics, podrá consultar los topics recién creados en la instancia de DataHub una vez completada la sincronización de esquemas. De forma predeterminada, cada topic de DataHub tiene dos particiones y el período de caducidad de los datos es de 7 días, lo cual no se puede modificar.
-
Para sincronizar varias tablas Tuple, haga clic en OK en el cuadro de diálogo que aparece.
Si seleccionó un topic de tipo Tuple y varias tablas sin haber seleccionado Schema Synchronization, deberá seleccionar un topic existente y hacer clic en OK en el cuadro de diálogo Map Object to Topic.
En este caso, se muestran varias tablas bajo el topic en el panel derecho, pero solo se puede sincronizar una tabla. A continuación, haga clic en Next. Aparecerá un mensaje que indica que solo se admite la asignación uno a uno entre topics de tipo Tuple y tablas.
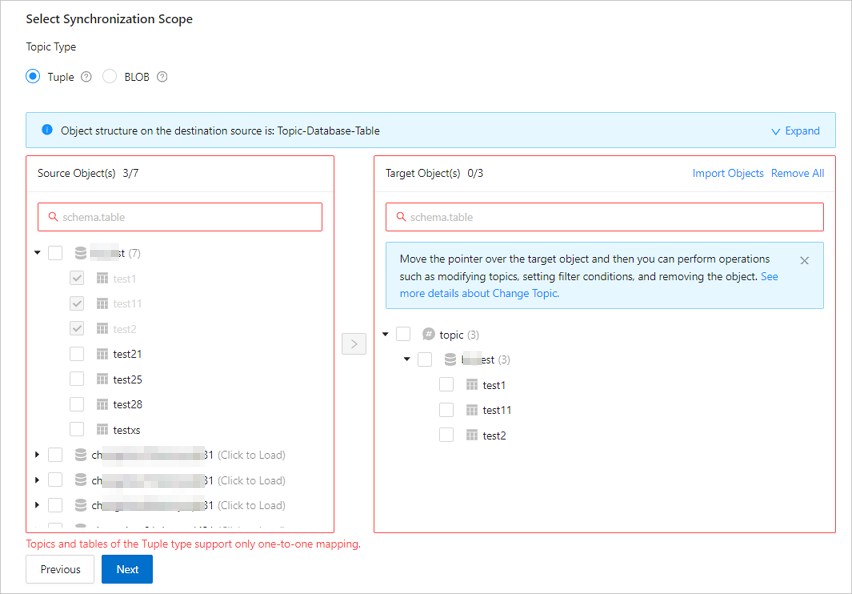
-
El servicio de transmisión de datos permite importar objetos mediante texto. También permite cambiar el nombre de los objetos, establecer filtros de fila y quitar un objeto individual o todos los objetos. Los objetos en la base de datos de destino se listan con la estructura Topic > Database > Table.
NotaCuando selecciona Match Rules para especificar objetos de sincronización, el cambio de nombre de los objetos se implementa según la sintaxis de las reglas de coincidencia especificadas. En el área de operaciones, solo puede establecer condiciones de filtrado y seleccionar columnas de fragmentación y las columnas que se sincronizarán. Para obtener más información, consulte Configure and modify matching rules.
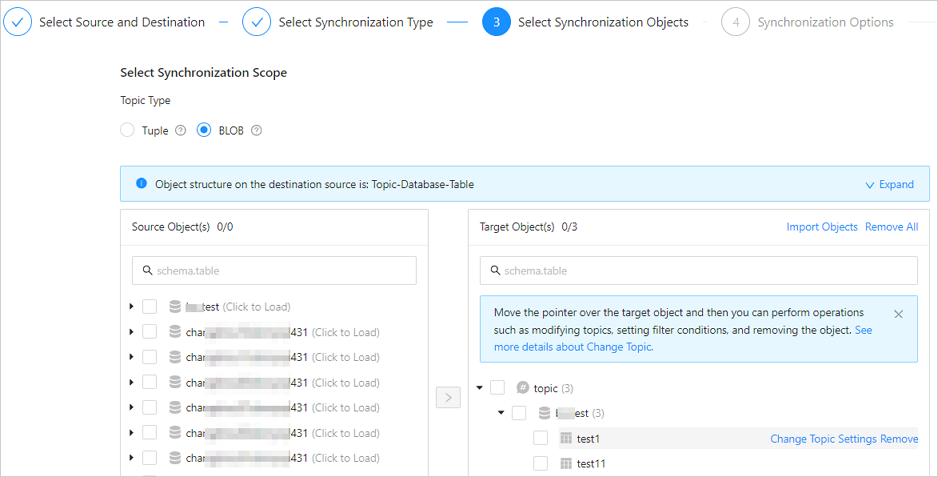
Operación
Descripción
Importar objetos
En la lista de la derecha, haga clic en Import Objects en la esquina superior derecha.
En el cuadro de diálogo que aparece, haga clic en OK.
ImportanteEsta operación sobrescribirá las selecciones anteriores. Proceda con precaución.
En el cuadro de diálogo Import Synchronization Objects, importe los objetos que desea sincronizar. Puede importar archivos CSV para cambiar el nombre de bases de datos o tablas y establecer condiciones de filtrado de filas. Para obtener más información, consulte Download and import the settings of synchronization objects.
Haga clic en Validate.
Una vez validada correctamente la operación, haga clic en OK.
Cambiar topics
Cuando el tipo de topic está establecido en BLOB, puede cambiar los topics de los objetos en la base de datos de destino. Para obtener más información, consulte Change topics.
Configuración
El servicio de transmisión de datos permite filtrar datos por fila mediante cláusulas
WHERE, seleccionar columnas de fragmentación y elegir las columnas que se sincronizarán.En la lista de la derecha, pase el puntero sobre el objeto de tabla que desea configurar.
Haga clic en Settings.
En el cuadro de diálogo Settings, puede realizar las siguientes operaciones:
En la sección Row Filters, especifique una cláusula SQL estándar
WHEREpara filtrar datos por fila. Para obtener más información, consulte Use SQL conditions to filter data.Seleccione las columnas de fragmentación que desea utilizar en la lista desplegable Sharding Columns. Puede seleccionar varios campos como columnas de fragmentación. Este parámetro es opcional.
Salvo que se indique lo contrario, seleccione las claves primarias como columnas de fragmentación. Si las claves primarias no están equilibradas en cuanto a carga, seleccione campos equilibrados con identificadores únicos como columnas de fragmentación para evitar posibles problemas de rendimiento. Las columnas de fragmentación se pueden utilizar para los siguientes propósitos:
Equilibrio de carga: Los subprocesos utilizados para enviar mensajes se pueden identificar según las columnas de fragmentación si la tabla de destino admite escrituras simultáneas.
Ordenamiento: El servicio de transmisión de datos garantiza que los mensajes se reciban en orden si los valores de las columnas de fragmentación son iguales. El ordenamiento especifica la secuencia de ejecución de las sentencias DML para una columna.
En la sección Select Columns, seleccione las columnas que se sincronizarán. Para obtener más información, consulte Column filtering.
Haga clic en OK.
Quitar uno o todos los objetos
El servicio de transmisión de datos permite quitar un solo objeto de sincronización o todos los que se agregaron a la lista de la derecha durante la asignación de datos.
Quitar un solo objeto de sincronización
En la lista de la derecha, pase el puntero sobre el objeto que desea quitar y haga clic en Remove para eliminar el objeto de sincronización.
Quitar todos los objetos de sincronización
En la lista de la derecha, haga clic en Remove All en la esquina superior derecha. En el cuadro de diálogo que aparece, haga clic en OK para quitar todos los objetos de sincronización.
-
Haga clic en Next. En la página Synchronization Options, configure los parámetros.
-
Sincronización completa
La siguiente tabla describe los parámetros de sincronización completa, que solo se muestran si seleccionó Full Synchronization en la página Select Synchronization Type.

Parámetro
Descripción
Read Concurrency
La concurrencia para leer datos del origen durante la sincronización completa. El valor máximo es 512. Una concurrencia alta puede generar una carga excesiva en el origen y afectar al negocio.
Write Concurrency
La concurrencia para escribir datos en el destino durante la sincronización completa. El valor máximo es 512. Una concurrencia de escritura alta puede generar una carga excesiva en el destino y afectar al negocio.
Full Synchronization Rate Limit
Puede elegir si desea limitar la tasa de sincronización completa según sus necesidades. Si decide limitarla, debe especificar los registros por segundo (RPS) y los bytes por segundo (BPS). El valor RPS especifica el número máximo de filas de datos sincronizadas con el destino por segundo durante la sincronización completa, y el valor BPS especifica la cantidad máxima de datos en bytes sincronizados con el destino por segundo durante la sincronización completa.
NotaLos valores de RPS y BPS especificados aquí son únicamente para limitar la tasa. El rendimiento real de la sincronización completa depende de factores como la configuración del origen y del destino, así como de las especificaciones de la instancia.
-
Sincronización incremental
La siguiente tabla describe los parámetros de sincronización incremental, que solo se muestran cuando ha seleccionado Incremental Synchronization en la página Select Synchronization Type.
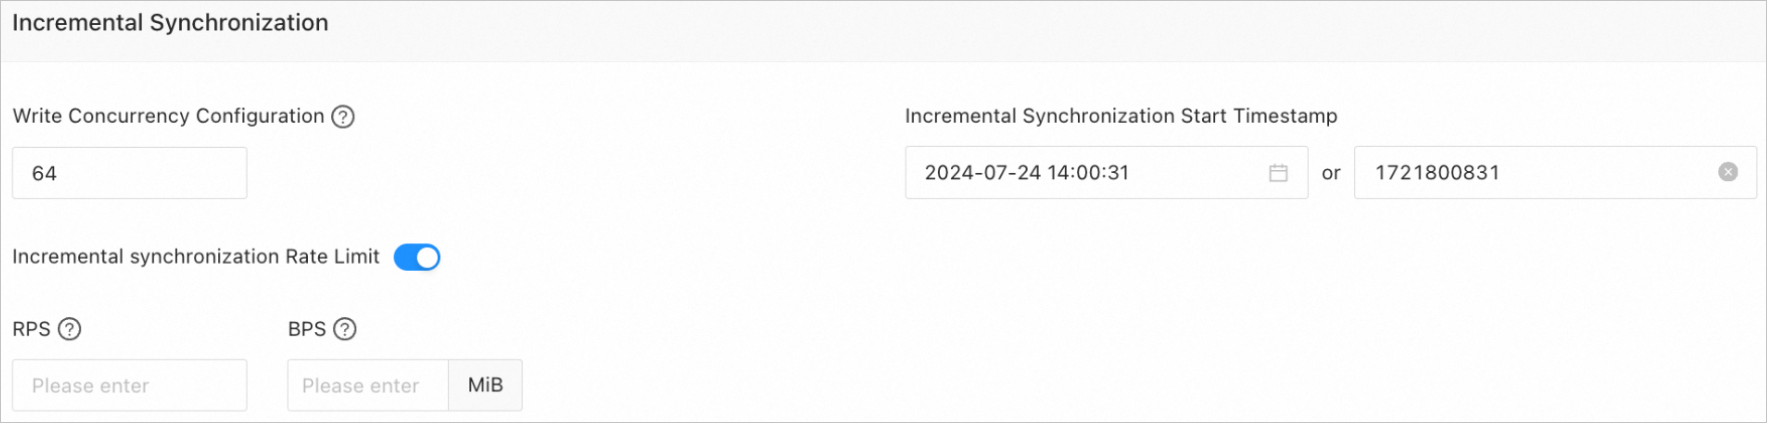
Parámetro
Descripción
Write Concurrency
La concurrencia para escribir datos en el destino durante la sincronización incremental. El valor máximo es 512. Una concurrencia de escritura alta puede generar una carga excesiva en el destino y afectar al negocio.
Incremental Synchronization Rate Limit
Puede elegir si desea limitar la tasa de sincronización incremental según sus necesidades. Si decide limitarla, debe especificar los valores RPS y BPS. El valor RPS especifica el número máximo de filas de datos sincronizadas con el destino por segundo durante la sincronización incremental, y el valor BPS especifica la cantidad máxima de datos en bytes sincronizados con el destino por segundo durante la sincronización incremental.
NotaLos valores de RPS y BPS especificados aquí son únicamente para limitar la tasa. El rendimiento real de la sincronización incremental depende de factores como la configuración del origen y del destino, así como de las especificaciones de la instancia.
Incremental Synchronization Start Timestamp
Este parámetro no está disponible si ha seleccionado Full Synchronization.
Si ha seleccionado Incremental Synchronization pero no Full Synchronization, especifique un punto en el tiempo a partir del cual se sincronizarán los datos. El valor predeterminado es la hora actual del sistema. Para obtener más información, consulte Set an incremental synchronization timestamp.
-
Parámetros avanzados
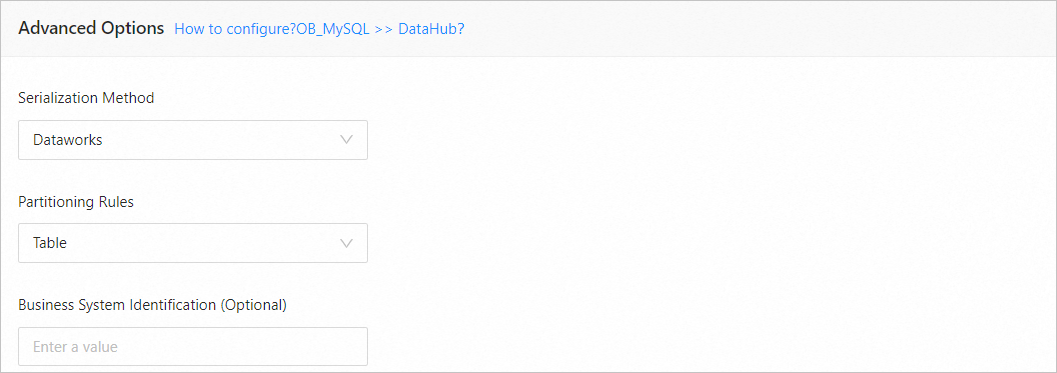
Parámetro
Descripción
Serialization Method
El formato de mensaje para sincronizar datos con la instancia de DataHub de destino. Valores válidos: Default, Canal, DataWorks (compatible con la versión 2.0), SharePlex, DefaultExtendColumnType, Debezium, DebeziumFlatten, DebeziumSmt y DTSCompatible. Para obtener más información, consulte Data formats used in serialization methods.
ImportanteEste parámetro solo está disponible si estableció el tipo de topic en BLOB en la página Select Synchronization Objects o si estableció el tipo de topic en Tuple en esta página y el origen es una base de datos OceanBase en modo compatible con MySQL.
Solo las bases de datos OceanBase en modo compatible con MySQL admiten Debezium, DebeziumFlatten, DebeziumSmt y DTSCompatible.
Cuando el origen es una base de datos OceanBase en modo compatible con MySQL y ha establecido el tipo de topic en Tuple en la página Select Synchronization Objects, puede seleccionar Default o DTSCompatible como método de serialización.
Partitioning Rules
La regla para sincronizar datos desde la base de datos de origen hacia un topic de DataHub. Valores válidos: Hash y Table. Se recomienda seleccionar Table para garantizar la consistencia en el consumo de DDL y DML cuando las aplicaciones posteriores consumen mensajes.
Hash indica que el servicio de transmisión de datos utiliza un algoritmo hash para seleccionar el shard de un topic de DataHub según el valor de la clave primaria o la columna de fragmentación.
Table indica que el servicio de transmisión de datos entrega todos los datos de una tabla a la misma partición y utiliza el nombre de la tabla como clave hash.
NotaSi ha seleccionado DDL Synchronization en la página Select Synchronization Type, la regla de particionamiento solo se puede establecer en Table.
Business System Identification (Optional)
Identifica el sistema de negocio de origen de los datos. Este parámetro solo se muestra cuando selecciona DataWorks para Serialization Method. El identificador del sistema de negocio consta de 1 a 20 caracteres.
-
-
Haga clic en Precheck.
Durante la comprobación previa , el servicio de transmisión de datos verifica el nombre y el tipo de columna, y comprueba si los valores son nulos. El servicio de transmisión de datos no verifica la longitud del valor ni el valor predeterminado. Si se devuelve un error durante la comprobación previa, puede realizar las siguientes operaciones:
Identifique y resuelva el problema, y luego vuelva a ejecutar la comprobación previa.
Haga clic en Skip en la columna Actions del elemento de comprobación previa con errores. En el cuadro de diálogo que advierte sobre las consecuencias de la operación, haga clic en OK.
-
Una vez superada la comprobación previa, haga clic en Start Task.
Si no necesita iniciar la tarea ahora, haga clic en Save. Puede iniciar la tarea manualmente en la página Synchronization Tasks o mediante operaciones por lotes más adelante. Para obtener más información sobre las operaciones por lotes, consulte Perform batch operations on data synchronization tasks.
El servicio de transmisión de datos permite modificar los objetos de sincronización mientras se ejecuta una tarea de sincronización. Para obtener más información, consulte View and modify synchronization objects and their filter conditions. Una vez iniciada la tarea de sincronización de datos, se ejecutará según los tipos de sincronización seleccionados. Para obtener más información, consulte View details of a data synchronization task.
Si la tarea de sincronización de datos encuentra una excepción de ejecución debido a un fallo de red o a un inicio lento de los procesos, puede hacer clic en Resume en la página Synchronization Tasks o en la página de detalles de la tarea de sincronización.