Hologres'in bir SQL sorgusunu nasıl çalıştırdığını incelemek için EXPLAIN ve EXPLAIN ANALYZE komutlarını kullanın. Bir sorgu kötü performans gösterdiğinde veya beklenmeyen sonuçlar döndürdüğünde, bu komutlar yürütme planını gösterir; böylece darboğazları belirleyebilir ve SQL veya tablo tasarımınızı optimize edebilirsiniz.
Hologres V1.3.4x ve sonraki sürümlerdeki yürütme planları daha net ve okunabilirdir. Bu belge V1.3.4x tabanlıdır. Adımları takip etmek için örneğinizi V1.3.4x veya üzeri bir sürüme yükseltin.
Çalışma mantığı
Her SQL deyimi iki aşamadan geçer:
Sorgu iyileştiricisi (QO) sorguyu analiz eder ve bir yürütme planı oluşturur.
Sorgu motoru (QE) bu planı alır, çalıştırır ve sonuçları döndürür.
Yürütme planı, QE'nin kullandığı işleçleri, verilerin bunlar arasındaki akış sırasını ve her adımın tahmini maliyetini açıklar. İyi seçilmiş bir plan daha az kaynak tüketir ve sonuçları daha hızlı döndürür; bu nedenle yürütme planlarını anlamak SQL ayarlamanın temelidir.
Hologres, PostgreSQL ile uyumludur ve aynı EXPLAIN / EXPLAIN ANALYZE sözdizimini kullanır:
| Komut | Ne gösterir |
|---|---|
EXPLAIN |
QO'nun tahmini planı. Sorgu çalıştırılmaz. |
EXPLAIN ANALYZE |
Gerçek çalışma zamanı planı. Sorgu çalıştırılır ve gerçek zamanlama, satır sayıları ile bellek kullanımı gösterilir. |
Hızlı bir tahmin için EXPLAIN kullanın. Doğru teşhisler için EXPLAIN ANALYZE kullanın.
EXPLAIN
Sözdizimi
EXPLAIN <sql>;Örnek
Aşağıdaki örnek yalnızca gösterim amacıyla bir TPC-H sorgusu kullanır ve resmi TPC-H kıyaslama sonuçlarını temsil etmez.
EXPLAIN SELECT
        l_returnflag,
        l_linestatus,
        sum(l_quantity) AS sum_qty,
        sum(l_extendedprice) AS sum_base_price,
        sum(l_extendedprice * (1 - l_discount)) AS sum_disc_price,
        sum(l_extendedprice * (1 - l_discount) * (1 + l_tax)) AS sum_charge,
        avg(l_quantity) AS avg_qty,
        avg(l_extendedprice) AS avg_price,
        avg(l_discount) AS avg_disc,
        count(*) AS count_order
FROM
        lineitem
WHERE
        l_shipdate <= date '1998-12-01' - interval '120' day
GROUP BY
        l_returnflag,
        l_linestatus
ORDER BY
        l_returnflag,
        l_linestatus;
Çıktı:
QUERY PLAN
Sort  (cost=0.00..7795.30 rows=3 width=80)
  Sort Key: l_returnflag, l_linestatus
  ->  Gather  (cost=0.00..7795.27 rows=3 width=80)
        ->  Project  (cost=0.00..7795.27 rows=3 width=80)
              ->  Project  (cost=0.00..7794.27 rows=3 width=104)
                    ->  Final HashAggregate  (cost=0.00..7793.27 rows=3 width=76)
                          Group Key: l_returnflag, l_linestatus
                          ->  Redistribution  (cost=0.00..7792.95 rows=1881 width=76)
                                Hash Key: l_returnflag, l_linestatus
                                ->  Partial HashAggregate  (cost=0.00..7792.89 rows=1881 width=76)
                                      Group Key: l_returnflag, l_linestatus
                                      ->  Local Gather  (cost=0.00..7791.81 rows=44412 width=76)
                                            ->  Decode  (cost=0.00..7791.80 rows=44412 width=76)
                                                  ->  Partial HashAggregate  (cost=0.00..7791.70 rows=44412 width=76)
                                                        Group Key: l_returnflag, l_linestatus
                                                        ->  Project  (cost=0.00..3550.73 rows=584421302 width=33)
                                                              ->  Project  (cost=0.00..2585.43 rows=584421302 width=33)
                                                                    ->  Index Scan using Clustering_index on lineitem  (cost=0.00..261.36 rows=584421302 width=25)
                                                                          Segment Filter: (l_shipdate <= '1998-08-03 00:00:00+08'::timestamp with time zone)
                                                                          Cluster Filter: (l_shipdate <= '1998-08-03 00:00:00+08'::timestamp with time zone)
Çıktıyı okuma
Planı aşağıdan yukarıya doğru okuyun. Her -> bir düğümdür. Veriler yaprak düğümlerden (gerçek veri kaynakları) kök düğüme (son çıktı) doğru yukarı akar.
Her düğüm üç iyileştirici tahmini gösterir:
| Alan | Açıklama |
|---|---|
cost |
startup_cost..total_cost olarak gösterilen tahmini işleç çalışma süresi. Başlangıç maliyeti, ilk çıktı satırı üretilmeden önceki maliyettir. Toplam maliyet, işlecin tamamlanana kadar çalıştırılması durumunda oluşacak maliyettir. Bir üst düğümün maliyeti tüm alt düğümlerini içerir. Örneğin, Final HashAggregate (cost=0.00..7793.27) için başlangıç maliyeti 0.00 ve toplam maliyet 7793.27 değerindedir. |
rows |
Tablo istatistiklerine dayalı tahmini çıktı satır sayısı. Tarama işlemleri için varsayılan tahmin 1000 değeridir. rows=1000 görürseniz, istatistikler muhtemelen güncel değildir; bunları yenilemek için ANALYZE <tablename> çalıştırın. |
width |
Bayt cinsinden tahmini ortalama satır genişliği. Daha büyük değerler daha geniş çıktı satırlarına işaret eder. |
EXPLAIN ANALYZE
Sözdizimi
EXPLAIN ANALYZE <sql>;Örnek
EXPLAIN ANALYZE SELECT
        l_returnflag,
        l_linestatus,
        sum(l_quantity) AS sum_qty,
        sum(l_extendedprice) AS sum_base_price,
        sum(l_extendedprice * (1 - l_discount)) AS sum_disc_price,
        sum(l_extendedprice * (1 - l_discount) * (1 + l_tax)) AS sum_charge,
        avg(l_quantity) AS avg_qty,
        avg(l_extendedprice) AS avg_price,
        avg(l_discount) AS avg_disc,
        count(*) AS count_order
FROM
        lineitem
WHERE
        l_shipdate <= date '1998-12-01' - interval '120' day
GROUP BY
        l_returnflag,
        l_linestatus
ORDER BY
        l_returnflag,
        l_linestatus;
Çıktı:
QUERY PLAN
Sort  (cost=0.00..7795.30 rows=3 width=80)
  Sort Key: l_returnflag, l_linestatus
[id=21 dop=1 time=2427/2427/2427ms rows=4(4/4/4) mem=3/3/3KB open=2427/2427/2427ms get_next=0/0/0ms]
  ->  Gather  (cost=0.00..7795.27 rows=3 width=80)
      [20:1 id=100003 dop=1 time=2426/2426/2426ms rows=4(4/4/4) mem=1/1/1KB open=0/0/0ms get_next=2426/2426/2426ms]
        ->  Project  (cost=0.00..7795.27 rows=3 width=80)
            [id=19 dop=20 time=2427/2426/2425ms rows=4(1/0/0) mem=87/87/87KB open=2427/2425/2425ms get_next=1/0/0ms]
              ->  Project  (cost=0.00..7794.27 rows=0 width=104)
                    ->  Final HashAggregate  (cost=0.00..7793.27 rows=3 width=76)
                          Group Key: l_returnflag, l_linestatus
                        [id=16 dop=20 time=2427/2425/2424ms rows=4(1/0/0) mem=574/570/569KB open=2427/2425/2424ms get_next=1/0/0ms]
                          ->  Redistribution  (cost=0.00..7792.95 rows=1881 width=76)
                                Hash Key: l_returnflag, l_linestatus
                              [20:20 id=100002 dop=20 time=2427/2424/2423ms rows=80(20/4/0) mem=3528/1172/584B open=1/0/0ms get_next=2426/2424/2423ms]
                                ->  Partial HashAggregate  (cost=0.00..7792.89 rows=1881 width=76)
                                      Group Key: l_returnflag, l_linestatus
                                    [id=12 dop=20 time=2428/2357/2256ms rows=80(4/4/4) mem=574/574/574KB open=2428/2357/2256ms get_next=1/0/0ms]
                                      ->  Local Gather  (cost=0.00..7791.81 rows=44412 width=76)
                                          [id=11 dop=20 time=2427/2356/2255ms rows=936(52/46/44) mem=7/6/6KB open=0/0/0ms get_next=2427/2356/2255ms pull_dop=9/9/9]
                                            ->  Decode  (cost=0.00..7791.80 rows=44412 width=76)
                                                [id=8 dop=234 time=2435/1484/5ms rows=936(4/4/4) mem=0/0/0B open=2435/1484/5ms get_next=4/0/0ms]
                                                  ->  Partial HashAggregate  (cost=0.00..7791.70 rows=44412 width=76)
                                                        Group Key: l_returnflag, l_linestatus
                                                      [id=5 dop=234 time=2435/1484/3ms rows=936(4/4/4) mem=313/312/168KB open=2435/1484/3ms get_next=0/0/0ms]
                                                        ->  Project  (cost=0.00..3550.73 rows=584421302 width=33)
                                                            [id=4 dop=234 time=2145/1281/2ms rows=585075720(4222846/2500323/3500) mem=142/141/69KB open=10/1/0ms get_next=2145/1280/2ms]
                                                              ->  Project  (cost=0.00..2585.43 rows=584421302 width=33)
                                                                  [id=3 dop=234 time=582/322/2ms rows=585075720(4222846/2500323/3500) mem=142/142/69KB open=10/1/0ms get_next=582/320/2ms]
                                                                    ->  Index Scan using Clustering_index on lineitem  (cost=0.00..261.36 rows=584421302 width=25)
                                                                          Segment Filter: (l_shipdate <= '1998-08-03 00:00:00+08'::timestamp with time zone)
                                                                          Cluster Filter: (l_shipdate <= '1998-08-03 00:00:00+08'::timestamp with time zone)
                                                                        [id=2 dop=234 time=259/125/1ms rows=585075720(4222846/2500323/3500) mem=1418/886/81KB open=10/1/0ms get_next=253/124/0ms]

ADVICE:
[node id : 1000xxx] distribution key miss match! table lineitem defined distribution keys : l_orderkey; request distribution columns : l_returnflag, l_linestatus;
shuffle data skew in different shards! max rows is 20, min rows is 0

Query id:[300200511xxxx]
======================cost======================
Total cost:[2505] ms
Optimizer cost:[47] ms
Init gangs cost:[4] ms
Build gang desc table cost:[2] ms
Start query cost:[18] ms
- Wait schema cost:[0] ms
- Lock query cost:[0] ms
- Create dataset reader cost:[0] ms
- Create split reader cost:[0] ms
Get the first block cost:[2434] ms
Get result cost:[2434] ms
====================resource====================
Memory: 921(244/230/217) MB,  straggler worker id: 72969760xxx
CPU time: 149772(38159/37443/36736) ms, straggler worker id: 72969760xxx
Physical read bytes: 3345(839/836/834) MB, straggler worker id: 72969760xxx
Read bytes: 41787(10451/10446/10444) MB, straggler worker id: 72969760xxx
DAG instance count: 41(11/10/10), straggler worker id: 72969760xxx
Fragment instance count: 275(70/68/67), straggler worker id: 72969760xxx
Çıktıyı okuma
Çıktı dört bölümden oluşur: QUERY PLAN, ADVICE, Cost ve Resource.
QUERY PLAN
EXPLAIN gibi planı aşağıdan yukarıya okuyun. Her düğüm iki satır gösterir:
İyileştirici tahminleri
(cost=... rows=... width=...):EXPLAINile aynı anlamdadır.Gerçek çalışma zamanı ölçümleri
[id=... dop=... time=... rows=... mem=... open=... get_next=...]: Çalıştırma sırasında toplanan gerçek değerler.
Çalışma zamanı ölçüm alanları şunlardır:
| Alan | Format | Açıklama |
|---|---|---|
dag dop (örneğin, 20:20) |
input:output |
Giriş ve çıkış eşzamanlılığı oranı. Gather 21:1 21 girişi 1'e birleştirir. Redistribution 20:20 20 çalışan arasında karıştırma yapar. Broadcast 1:21 1 girişi 21 çıkışa yayar. |
id |
Tamsayı | İşleç düğümü için benzersiz tanımlayıcı. |
dop |
Tamsayı | Paralellik derecesi (dop)—çalıştırma sırasındaki gerçek paralellik. Örneğin parça sayısıyla eşleşir. Local Gather için bu, taranan dosya sayısıdır. |
time |
max/avg/min ms |
İki aşamaya ayrılmış gerçek çalışma süresi: open (Hash gibi işleçler için tüm aşağı akış verilerini çekme dahil olmak üzere işleç başlatma) ve get_next (her kayıt grubunu getirme). |
rows |
total(max/avg/min) |
İşleç tarafından çıkarılan satırlar. Maksimum ve minimum arasında büyük bir boşluk veri eğriliğine işaret eder. |
mem |
max/avg/min |
İşleç çalıştırması sırasında tüketilen bellek. Birikimli değildir—her işlecin değeri bağımsızdır. |
Bir işlecintimedeğeri, alt işleçlerinin kümülatif zamanını içerir. Tek bir işlecin maliyetini izole etmek için alt işlecin zamanını çıkarın.rowsvememdeğerleri işleç başına olup kümülatif değildir.
ADVICE
ADVICE bölümü, mevcut çalıştırmadan türetilen otomatik ayarlama önerilerini listeler:
Eksik veya uyuşmayan dağıtım anahtarları, kümeleme anahtarları veya bitmap dizinleri (örneğin,
Table xxx misses bitmap index)Eski tablo istatistikleri (
Table xxx Miss Stats! please run 'analyze xxx')Veri eğriliği (
shuffle data skew in different shards! max rows is 20, min rows is 0)
Bu öneriler yalnızca mevcut sorguya dayanır. Değişiklikleri uygulamadan önce bunları kendi iş yükünüzle karşılaştırarak gözden geçirin.
Maliyet dökümü
Maliyet bölümü, sorgu süresinin nerede harcandığını gösterir:
| Aşama | Açıklama |
|---|---|
| Total cost | Toplam uçtan uca sorgu süresi (ms). |
| Optimizer cost | QO'nun yürütme planını oluşturma süresi. |
| Build gang desc table cost | QO planının yürütme motoru tarafından kullanılan veri yapılarına dönüştürülme süresi. |
| Init gangs cost | Planın ön işleme ve yürütme motoruna istek gönderme süresi. |
| Start query cost | Init gangs sonrası başlatma—şema hizalama, kilitleme ve kurulumu kapsar. Daha fazla ayrıntı: |
| — Wait schema cost | Depolama motorunun (SE) ve ön ucun (FE) şema sürümlerini hizalama süresi. Yüksek değerler genellikle bölümlenmiş üst tablolar üzerinde sık yapılan veri tanımlama dili (DDL) işlemlerine işaret eder; bu durum veri yazma ve sorguları yavaşlatabilir. |
| — Lock query cost | Sorgu kilitlerini edinme süresi. Yüksek değerler kilit çekişmesine işaret eder. |
| — Create dataset reader cost | Dizin veri okuyucularını oluşturma süresi. Yüksek değerler önbellek isabetlerini gösterebilir. |
| — Create split reader cost | Dosyaları açma süresi. Yüksek değerler meta veri önbelleği isabetlerini ve yüksek G/Ç ek yükünü gösterir. |
| Get the first block cost | Start query aşamasının tamamlanmasından ilk kayıt grubunun döndürülmesine kadar geçen süre. Hash Agg gibi çıktı üretmeden önce tüm aşağı akış verilerine ihtiyaç duyan işleçler için bu, toplam Get result maliyetine yakındır. |
| Get result cost | Start query aşamasının tamamlanmasından tüm sonuçların döndürülmesine kadar geçen süre. |
Kaynak tüketimi
Kaynak ölçümleri total(max/avg/min) formatını kullanır; burada her değer en yüksek tüketime sahip çalışanı, çalışan başına ortalamayı ve en düşük tüketime sahip çalışanı kapsar.
| Ölçüm | Açıklama |
|---|---|
| Memory | Toplam tüketilen bellek ve çalışan başına maks/ort/min değerleri. |
| CPU time | Tüm çekirdeklerdeki toplam CPU süresi (ms, yaklaşık). Genel sorgu karmaşıklığını yansıtır. |
| Physical read bytes | Diskten okunan veriler. Sonuçlar önbelleğe alınmadığında gerçekleşir. |
| Read bytes | Fiziksel okumalar ve önbellek isabetleri dahil toplam okunan veriler. |
| Affected rows | Etkilenen satırlar. Yalnızca DML deyimleri için gösterilir. |
| DAG instance count | Yönlendirilmemiş çevrimsiz çizge (DAG) örneklerinin sayısı. Daha yüksek değerler daha fazla paralellik ve karmaşıklığa işaret eder. |
| Fragment instance count | Parça örneklerinin sayısı. Daha yüksek değerler daha fazla yürütme planı segmenti ve dosyasına işaret eder. |
| straggler_worker_id | Her ölçüm için maksimum kaynak tüketimine sahip çalışan düğümünün kimliği. |
İşleç referansı
Aşağıdaki tablo her işleci ve rolünü listeler. Ayrıntılar ve ayarlama rehberliği için sonraki bölümlere bakın.
| İşleç | Kategori | Ne yapar |
|---|---|---|
| Seq Scan | Tarama | Tam tablo taraması—dizin kullanılmaz. |
| Seq Scan on Partitioned Table | Tarama | Bölümlenmiş bir tabloyu tarar; kaç bölümün seçildiğini gösterir. |
| Index Scan (Clustering_index) | Tarama | Bir dizine (segment, kümeleme veya bitmap) vuran sütun deposu taraması. |
| Index Seek (pk_index) | Tarama | Birincil anahtar dizini kullanan satır deposu taraması. |
| Foreign Table Type | Tarama | Harici tablonun kaynağını belirtir: MaxCompute, OSS veya Hologres. |
| Filter | Filtre | Herhangi bir dizine uymayan bir WHERE koşulunu uygular. |
| Segment Filter | Filtre | Koşul bir segment dizinine (Event Time Column) uyar. |
| Cluster Filter | Filtre | Koşul bir kümeleme dizinine uyar. |
| Bitmap Filter | Filtre | Koşul bir bitmap dizinine uyar. |
| Join Filter | Filtre | Bir birleştirmeden sonra uygulanan ek filtreleme. |
| Hash Join (varyantlar) | Birleştirme | Küçük tablodan oluşturulan bir hash tablosu kullanarak iki tabloyu birleştirir. |
| Nested Loop | Birleştirme | Her dış satır için iç tabloyu yineleyen iterasyon. Büyük veri kümeleri için pahalıdır. |
| Merge Join | Birleştirme | Birleştirme anahtarlarında önceden sıralanmış iki girişi birleştirir. |
| Cross Join | Birleştirme | Küçük tabloyu belleğe yükleyen optimize edilmiş non-equi birleştirme (V3.0+). |
| Materialize | Birleştirme | Nested Loop için iç tabloyu arabelleğe alır. |
| Broadcast | Dağıtım | Birleştirme için küçük bir tabloyu tüm parçalara kopyalar. |
| Redistribution | Dağıtım | Hash veya rastgele dağıtım kullanarak verileri parçalar arasında karıştırır. |
| Local Gather | Birleştirme | Tek bir parça içindeki verileri birden fazla dosyadan birleştirir. |
| Gather | Birleştirme | Birden fazla parçadaki verileri nihai sonuçta birleştirir. |
| Partial HashAggregate | Toplama | Dosyalar ve parçalar içinde toplama yapar. |
| Final HashAggregate | Toplama | Parçalar arasındaki kısmi toplamaları birleştirir. |
| GroupAggregate | Toplama | Hash kullanmadan önceden sıralanmış verileri toplar. |
| Sort | Diğer | Satırları bir veya daha fazla anahtara göre sıralar. |
| Limit | Diğer | Çıktı satır sayısını sınırlar. |
| Append | Diğer | UNION ALL alt sorgu sonuçlarını birleştirir. |
| Decode | Diğer | Hesaplamayı hızlandırmak için metin türü verilerin kodunu çözer veya kodlar. |
| ExecuteExternalSQL | Diğer | Bir işlevin veya işlecin HQE yerine PQE'ye geri düştüğünü belirtir. |
| Exchange | Diğer | Bir parça içinde veri aktarır. İşlem gerekmez. |
| Forward | Diğer | HQE ile PQE veya SQE arasında veri aktarır. |
| Project | Diğer | Bir alt sorgu ile dış sorgusu arasında sütun eşlemesi yapar. İşlem gerekmez. |
Tarama işleçleri
Seq scan
Seq Scan, herhangi bir dizin kullanmadan tüm tabloyu okur.
EXPLAIN SELECT * FROM public.holo_lineitem_100g;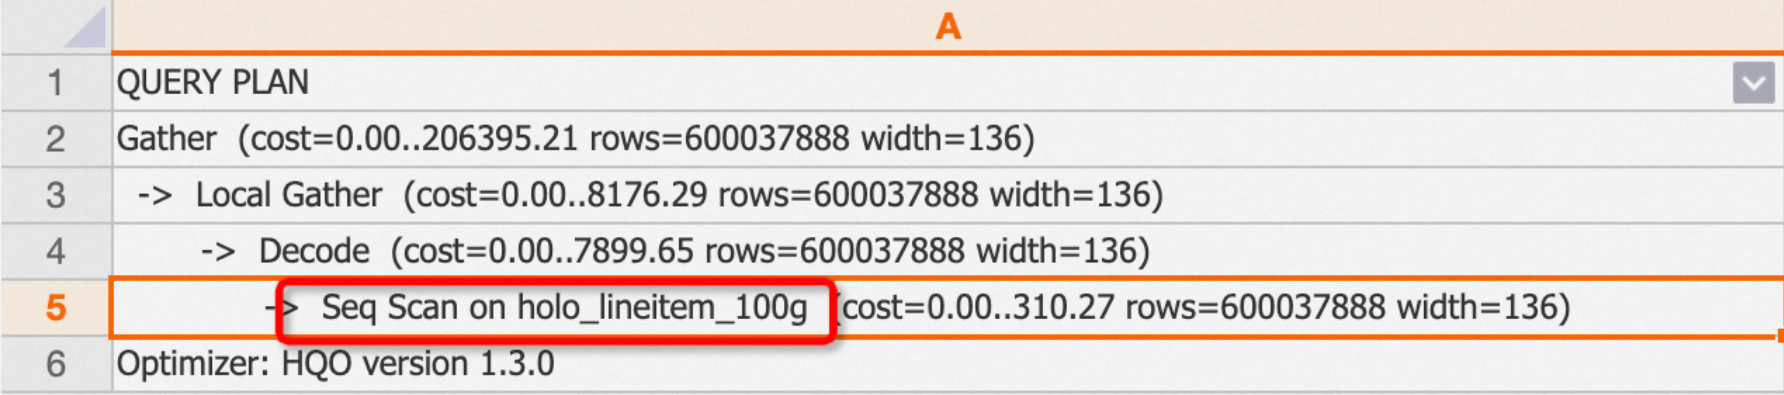
Bölümlenmiş tablolar Seq Scan on Partitioned Table işlecini gösterir ve "Partitions selected: x out of y" raporlar:
EXPLAIN SELECT * FROM public.hologres_parent;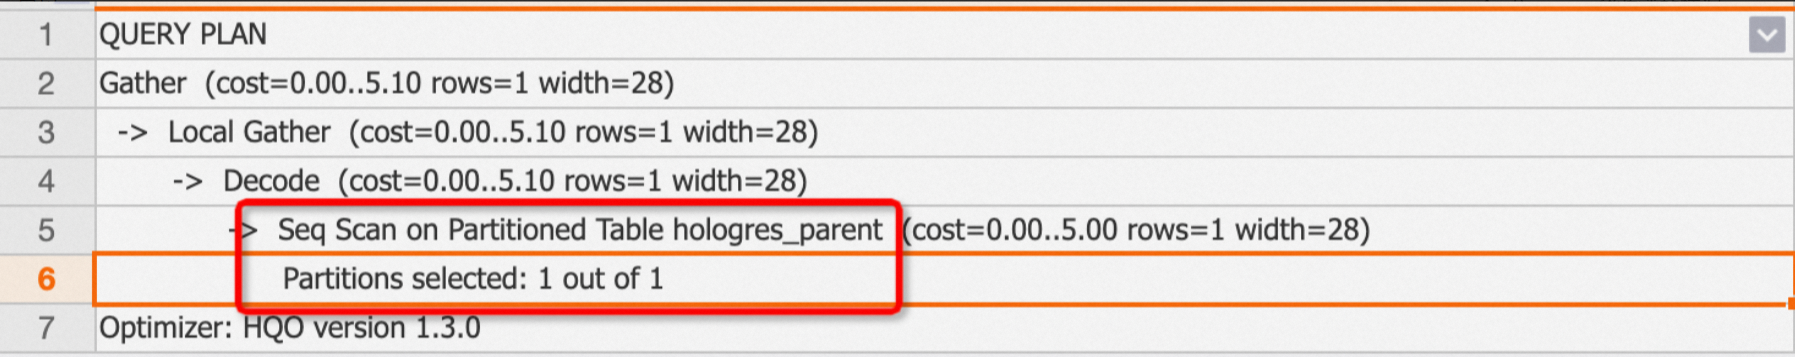
Harici tablolar, kaynağı (MaxCompute, OSS veya Hologres) tanımlayan bir Foreign Table Type etiketi içerir:
EXPLAIN SELECT * FROM public.odps_lineitem_100;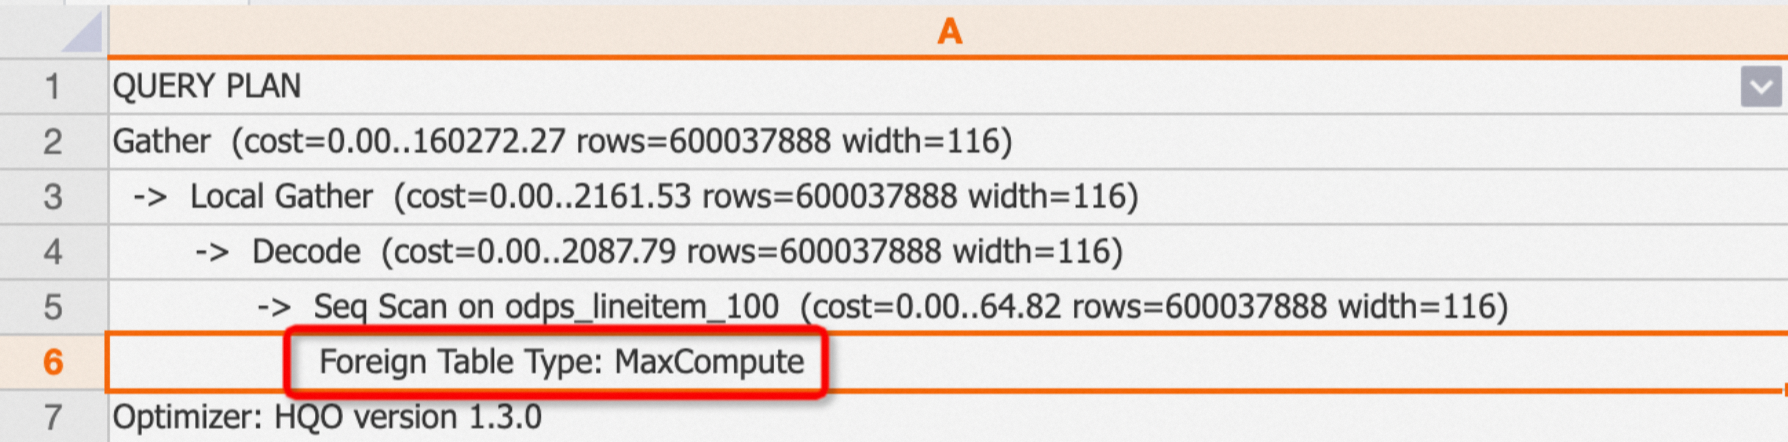
Index Scan ve Index Seek
Hologres, tablonun depolama formatına bağlı olarak farklı dizin işleçleri kullanır:
-
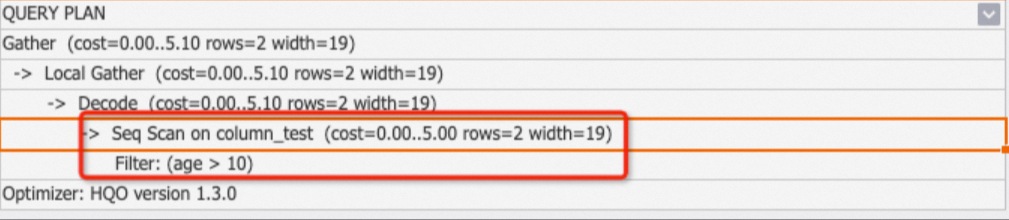
Index Scan (Clustering_index): Sütun deposu tablolar için kullanılır. Bir sorgu bir dizine uydığında görünür. Plan, hangi dizinin kullanıldığını belirleyen alt işleçleri gösterir: Segment Filter (segment dizini), Cluster Filter (kümeleme dizini) veya Bitmap Filter (bitmap dizini). Daha fazla bilgi için bkz. Sütun deposu ilkeleri. Örnek 1: Sorgu kümeleme dizinine vurur.
BEGIN;
CREATE TABLE column_test (
 "id" bigint not null ,
 "name" text not null ,
 "age" bigint not null
);
CALL set_table_property('column_test', 'orientation', 'column');
CALL set_table_property('column_test', 'distribution_key', 'id');
CALL set_table_property('column_test', 'clustering_key', 'id');
COMMIT;

INSERT INTO column_test VALUES(1,'tom',10),(2,'tony',11),(3,'tony',12);

EXPLAIN SELECT * FROM column_test WHERE id>2;
Örnek 2: Dizine alınmamış bir sütunda sorgu—planda Clustering_index yok.
EXPLAIN SELECT * FROM column_test WHERE age>10;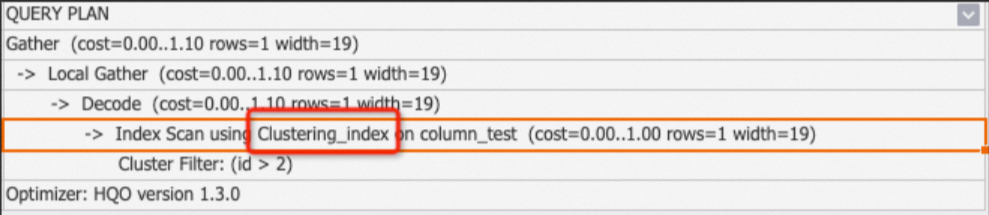
-
Index Seek (pk_index): Birincil anahtar dizinlerine sahip satır deposu tablolar için kullanılır. Birincil anahtar sorgusu Fixed Plan kullanmadığında görünür. Daha fazla bilgi için bkz. Satır deposu ilkeleri.
BEGIN;
CREATE TABLE row_test_1 (
    id bigint not null,
    name text not null,
    class text ,
PRIMARY KEY (id)
);
CALL set_table_property('row_test_1', 'orientation', 'row');
CALL set_table_property('row_test_1', 'clustering_key', 'name');
COMMIT;
INSERT INTO row_test_1 VALUES ('1','qqq','3'),('2','aaa','4'),('3','zzz','5');

BEGIN;
CREATE TABLE row_test_2 (
    id bigint not null,
    name text not null,
    class text ,
PRIMARY KEY (id)
);
CALL set_table_property('row_test_2', 'orientation', 'row');
CALL set_table_property('row_test_2', 'clustering_key', 'name');
COMMIT;
INSERT INTO row_test_2 VALUES ('1','qqq','3'),('2','aaa','4'),('3','zzz','5');

--primary key index
EXPLAIN SELECT * FROM (SELECT id FROM row_test_1 WHERE id = 1) t1 JOIN row_test_2 t2 ON t1.id = t2.id;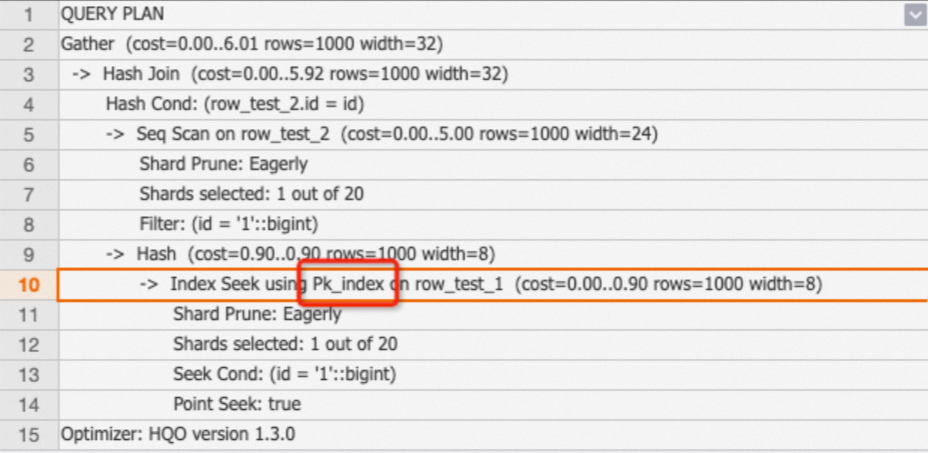
Filtre işleçleri
Filtre işleçleri, tarama işleçlerinin alt düğümleri olarak görünür ve bir koşulu bir dizine uyup uymadığını gösterir.
Filter
Düz bir Filter koşulun herhangi bir dizine uymadığı anlamına gelir. Performansı artırmak için tablonun dizin yapılandırmasını kontrol edin ve uygun dizinler ekleyin.
Plan One-Time Filter: false gösteriyorsa, sonuç kümesi boştur.
BEGIN;
CREATE TABLE clustering_index_test (
 "id" bigint not null ,
 "name" text not null ,
 "age" bigint not null
);
CALL set_table_property('clustering_index_test', 'orientation', 'column');
CALL set_table_property('clustering_index_test', 'distribution_key', 'id');
CALL set_table_property('clustering_index_test', 'clustering_key', 'age');
COMMIT;

INSERT INTO clustering_index_test VALUES (1,'tom',10),(2,'tony',11),(3,'tony',12);

EXPLAIN SELECT * FROM clustering_index_test WHERE id>2;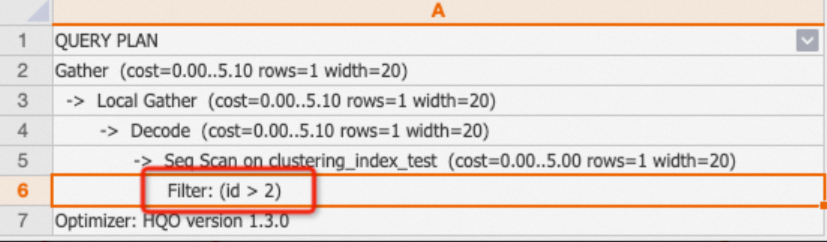
Segment Filter
Sorgu bir segment dizinine (Event Time Column) uymuştur. Index Scan ile birlikte görünür. Bkz. Event Time Column (segment key).
Cluster Filter
Sorgu bir kümeleme dizinine uymuştur. Bkz. Clustering key.
Bitmap Filter
Sorgu bir bitmap dizinine uymuştur. Bkz. Bitmap index.
Join Filter
Bir birleştirme işleminden sonra ek filtreleme uygular.
Decode
Decode işleci, hesaplamayı hızlandırmak için metin ve benzeri veri türlerinin kodunu çözer veya kodlar.
Local Gather ve Gather
Hologres'teki veriler parçalar içindeki dosyalar olarak saklanır. Local Gather, tek bir parça içindeki verileri birden fazla dosyadan birleştirir. Gather, birden fazla parçadaki verileri nihai sonuçta birleştirir.
EXPLAIN SELECT * FROM public.lineitem;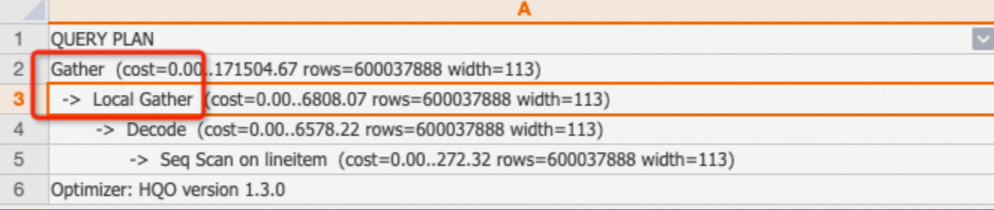
Redistribution
Redistribution işleci, hash veya rastgele dağıtım kullanarak verileri parçalar arasında karıştırır. Genellikle şu durumlarda görünür:
Dağıtım anahtarlarının eksik olduğu veya uyuşmadığı
JOIN,COUNT DISTINCTveyaGROUP BYsorguları—veriler yerel olarak birleştirilmek yerine parçalar arasında karıştırılmalıdır. Çoklu tablo birleştirmelerinde Redistribution, yerel birleştirmenin kullanılmadığı ve performansın düştüğü anlamına gelir.Orijinal alan türünü değiştiren ifadeler (dönüşümler gibi) kullanan
JOINveyaGROUP BYanahtarları, bu da yerel birleştirmeleri engeller.
Örnek 1: Uyuşmayan dağıtım anahtarları Redistribution'a neden olur.
BEGIN;
CREATE TABLE tbl1(
a int not null,
b text not null
);
CALL set_table_property('tbl1', 'distribution_key', 'a');
CREATE TABLE tbl2(
c int not null,
d text not null
);
CALL set_table_property('tbl2', 'distribution_key', 'd');
COMMIT;

EXPLAIN SELECT * FROM tbl1  JOIN tbl2 ON tbl1.a=tbl2.c;
Birleştirme koşulu tbl1.a=tbl2.c şeklindedir, ancak dağıtım anahtarları a ve d şeklindedir—bu uyuşmazlık bir veri karıştırmayı zorlar.
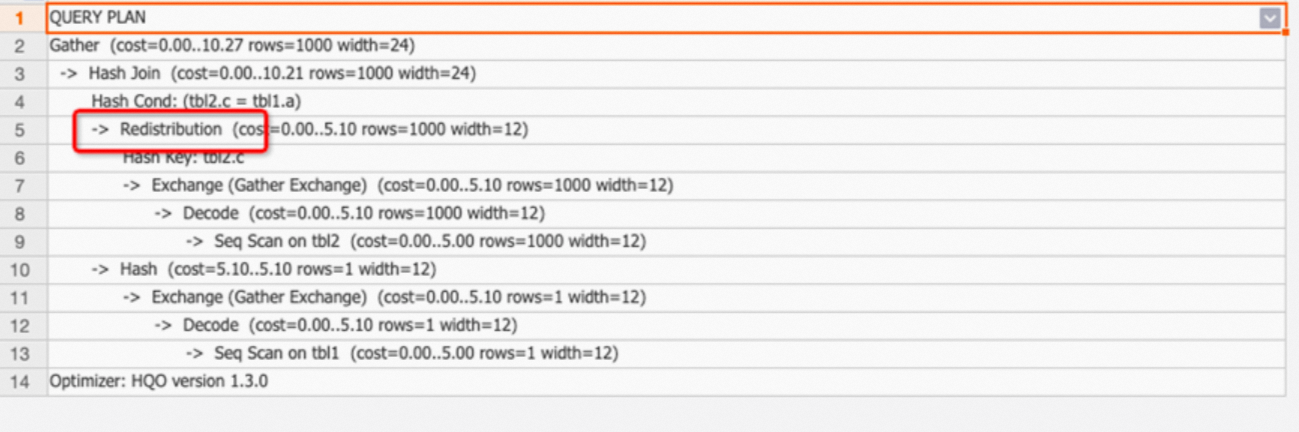
Redistribution görünüyorsa, dağıtım anahtarlarının doğru ayarlandığını kontrol edin. Bkz. Distribution key.
Örnek 2: Tür değiştiren ifade içeren bir birleştirme anahtarı yerel birleştirmeleri engeller.
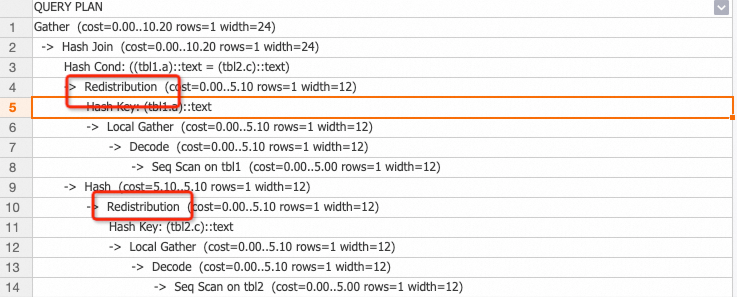
Bunu önlemek için birleştirme anahtarlarında ifadelerden kaçının.
Birleştirme işleçleri
Hash Join
Hash Join, bellekte küçük tablodan bir hash tablosu oluşturur, ardından büyük tablodan gelen verilerle satır satır sorgular.
| Tür | Açıklama |
|---|---|
| Hash Left Join | Sağ tablo sütunları için eşleşmeyen NULL değerlerle sol tablodaki tüm satırları döndürür. |
| Hash Right Join | Sol tablo sütunları için eşleşmeyen NULL değerlerle sağ tablodaki tüm satırları döndürür. |
| Hash Inner Join | Yalnızca birleştirme koşulunu karşılayan satırları döndürür. |
| Hash Full Join | Eşleşmeyen tarafta NULL değerlerle her iki tablodaki tüm satırları döndürür. |
| Hash Anti Join | Eşleşmesi olmayan sürücü tablosundaki satırları döndürür—NOT EXISTS için kullanılır. |
| Hash Semi Join | Sürücü tablosundan her eşleşme için bir satır döndürür—EXISTS için kullanılır. Yinelenen yoktur. |
Bir Hash Join'i analiz ederken ayrıca şunları kontrol edin:
hash cond: Birleştirme koşulu, örneğinhash cond (tmp.a=tmp1.b).hash key: Parçalar arasında hash hesaplama için kullanılan anahtar, tipik olarakGROUP BYanahtarıdır.
Küçük tablo hash tablosu olmalıdır. Doğrulamak için planda hash olarak etiketlenen tabloyu arayın—aşağıdan yukarıya okurken alt dalda görünür. Daha büyük tabloyu hash tablosu olarak kullanmak aşırı bellek tüketir.
Ayarlama: istatistikleri güncelleyin
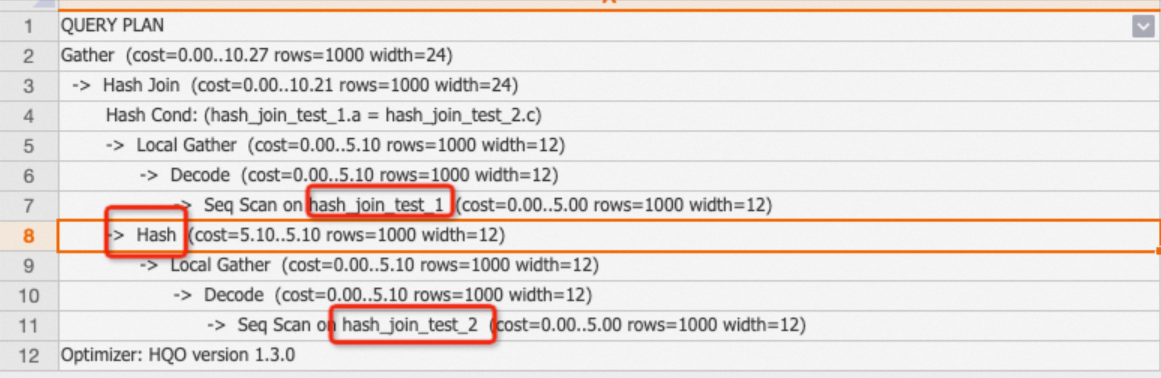
Eski istatistikler, QO'nun tablo boyutlarını yanlış değerlendirmesine neden olur. Örneğin, istatistikler aslında 1 milyon satırı olan bir tablo için rows=1000 gösterirse, hash tablosu olarak yanlış tablo seçilir.
BEGIN ;
CREATE TABLE public.hash_join_test_1 (
    a integer not null,
    b text not null
);
CALL set_table_property('public.hash_join_test_1', 'distribution_key', 'a');
CREATE TABLE public.hash_join_test_2 (
    c integer not null,
    d text not null
);
CALL set_table_property('public.hash_join_test_2', 'distribution_key', 'c');
COMMIT ;

INSERT INTO hash_join_test_1 SELECT i, i+1 FROM generate_series(1, 10000) AS s(i);
INSERT INTO hash_join_test_2 SELECT i, i::text FROM generate_series(10, 1000000) AS s(i);

EXPLAIN SELECT * FROM hash_join_test_1 tbl1  JOIN hash_join_test_2 tbl2 ON tbl1.a=tbl2.c;
Plan, yanlışlıkla daha büyük olan hash_join_test_2 tablosunu hash tablosu olarak kullanır:
İstatistikler yenilendikten sonra plan doğru şekilde daha küçük tabloyu seçer:
ANALYZE hash_join_test_1;
ANALYZE hash_join_test_2;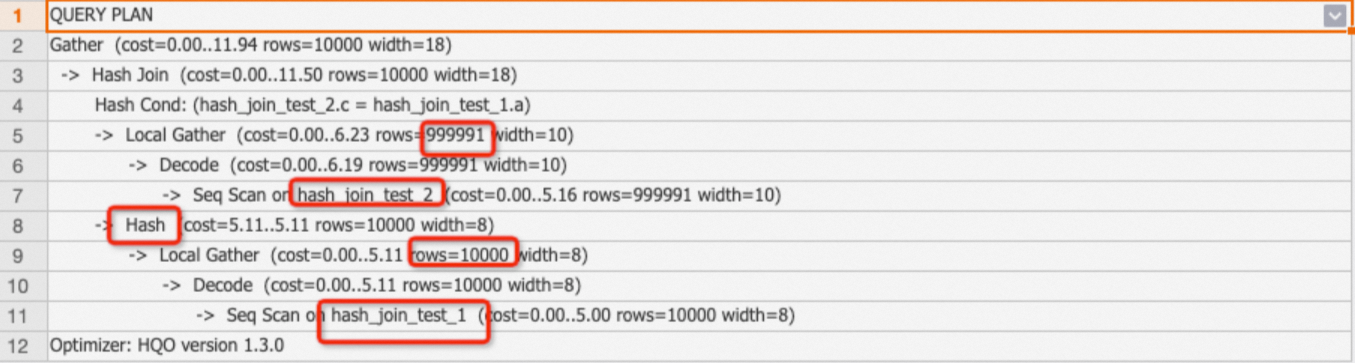
Ayarlama: karmaşık sorgular için birleştirme sırasını ayarlayın
İstatistiklerin yenilenmesi çoğu birleştirme sırası sorununu çözer. Beş veya daha fazla tablo içeren karmaşık birleştirmeler için QO, en iyi planı bulmak için önemli ölçüde zaman harcayabilir. Bunu kontrol etmek için optimizer_join_order Grand Unified Configuration (GUC) parametresini kullanın:
SET optimizer_join_order = '<value>';| Değer | Açıklama |
|---|---|
exhaustive (varsayılan) |
Tüm birleştirme sırası permütasyonlarını değerlendirir. Optimal planlar üretir ancak çok sayıda tablo için iyileştirici ek yükünü artırır. |
query |
SQL'de yazıldığı gibi birleştirme sırasını kullanır. Küçük tablolar (100 milyondan az satır) içeren birleştirmeler için QO ek yükünü azaltır. Veritabanı düzeyinde ayarlamayın—tüm birleştirmeleri etkiler. |
greedy |
Orta düzey QO ek yüküyle iyi bir birleştirme sırası bulmak için açgözlü bir algoritma kullanır. |
Nested Loop Join ve Materialize
Nested Loop işleci, dış tabloyu satır satır okur ve her eşleşme için iç tabloyu arar—temelde bir Kartezyen çarpımdır. İç tablo genellikle planda bir Materialize işleci gösterir.
BEGIN;
CREATE TABLE public.nestedloop_test_1 (
    a integer not null,
    b integer not null
);
CALL set_table_property('public.nestedloop_test_1', 'distribution_key', 'a');
CREATE TABLE public.nestedloop_test_2 (
    c integer not null,
    d text not null
);
CALL set_table_property('public.nestedloop_test_2', 'distribution_key', 'c');
COMMIT;

INSERT INTO nestedloop_test_1 SELECT i, i+1 FROM generate_series(1, 10000) AS s(i);
INSERT INTO nestedloop_test_2 SELECT i, i::text FROM generate_series(10, 1000000) AS s(i);

EXPLAIN SELECT * FROM nestedloop_test_1 tbl1,nestedloop_test_2 tbl2 WHERE tbl1.a>tbl2.c;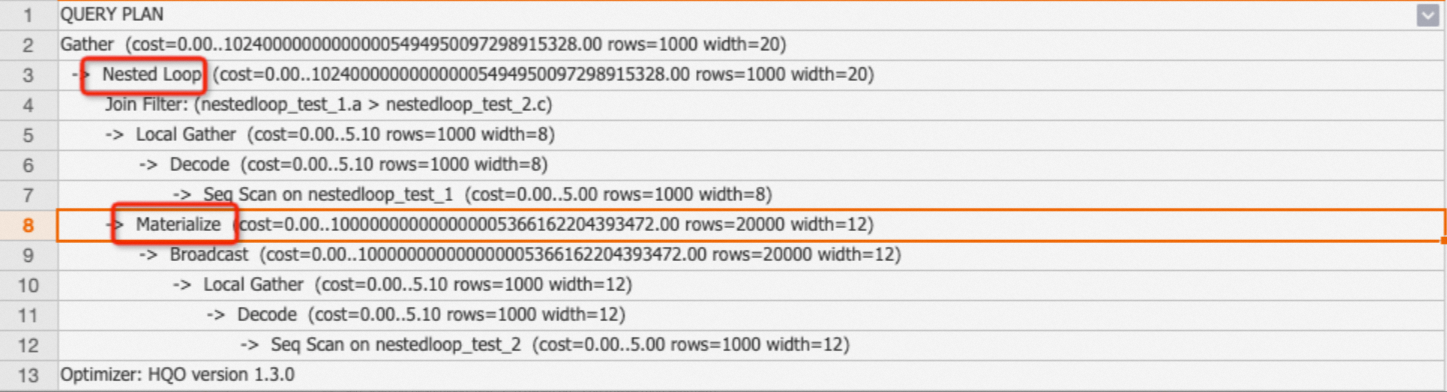
Nested Loop maliyetini azaltmak için:
İç tablonun taranma sayısını sınırlamak için dış sonuç kümesini küçük tutun.
Mümkün olduğunca non-equi birleştirmelerden kaçının—genellikle Nested Loop planları üretirler.
Cross Join
V3.0'dan başlayarak, Cross Join işleci küçük bir tablo içeren non-equi birleştirme senaryolarını optimize eder. Her dış satır için iç durumu sıfırlayan Nested Loop'un aksine, Cross Join tüm küçük tabloyu belleğe yükler ve büyük tabloyu üzerinden akıtır. Bu çok daha hızlıdır ancak daha fazla bellek kullanır.
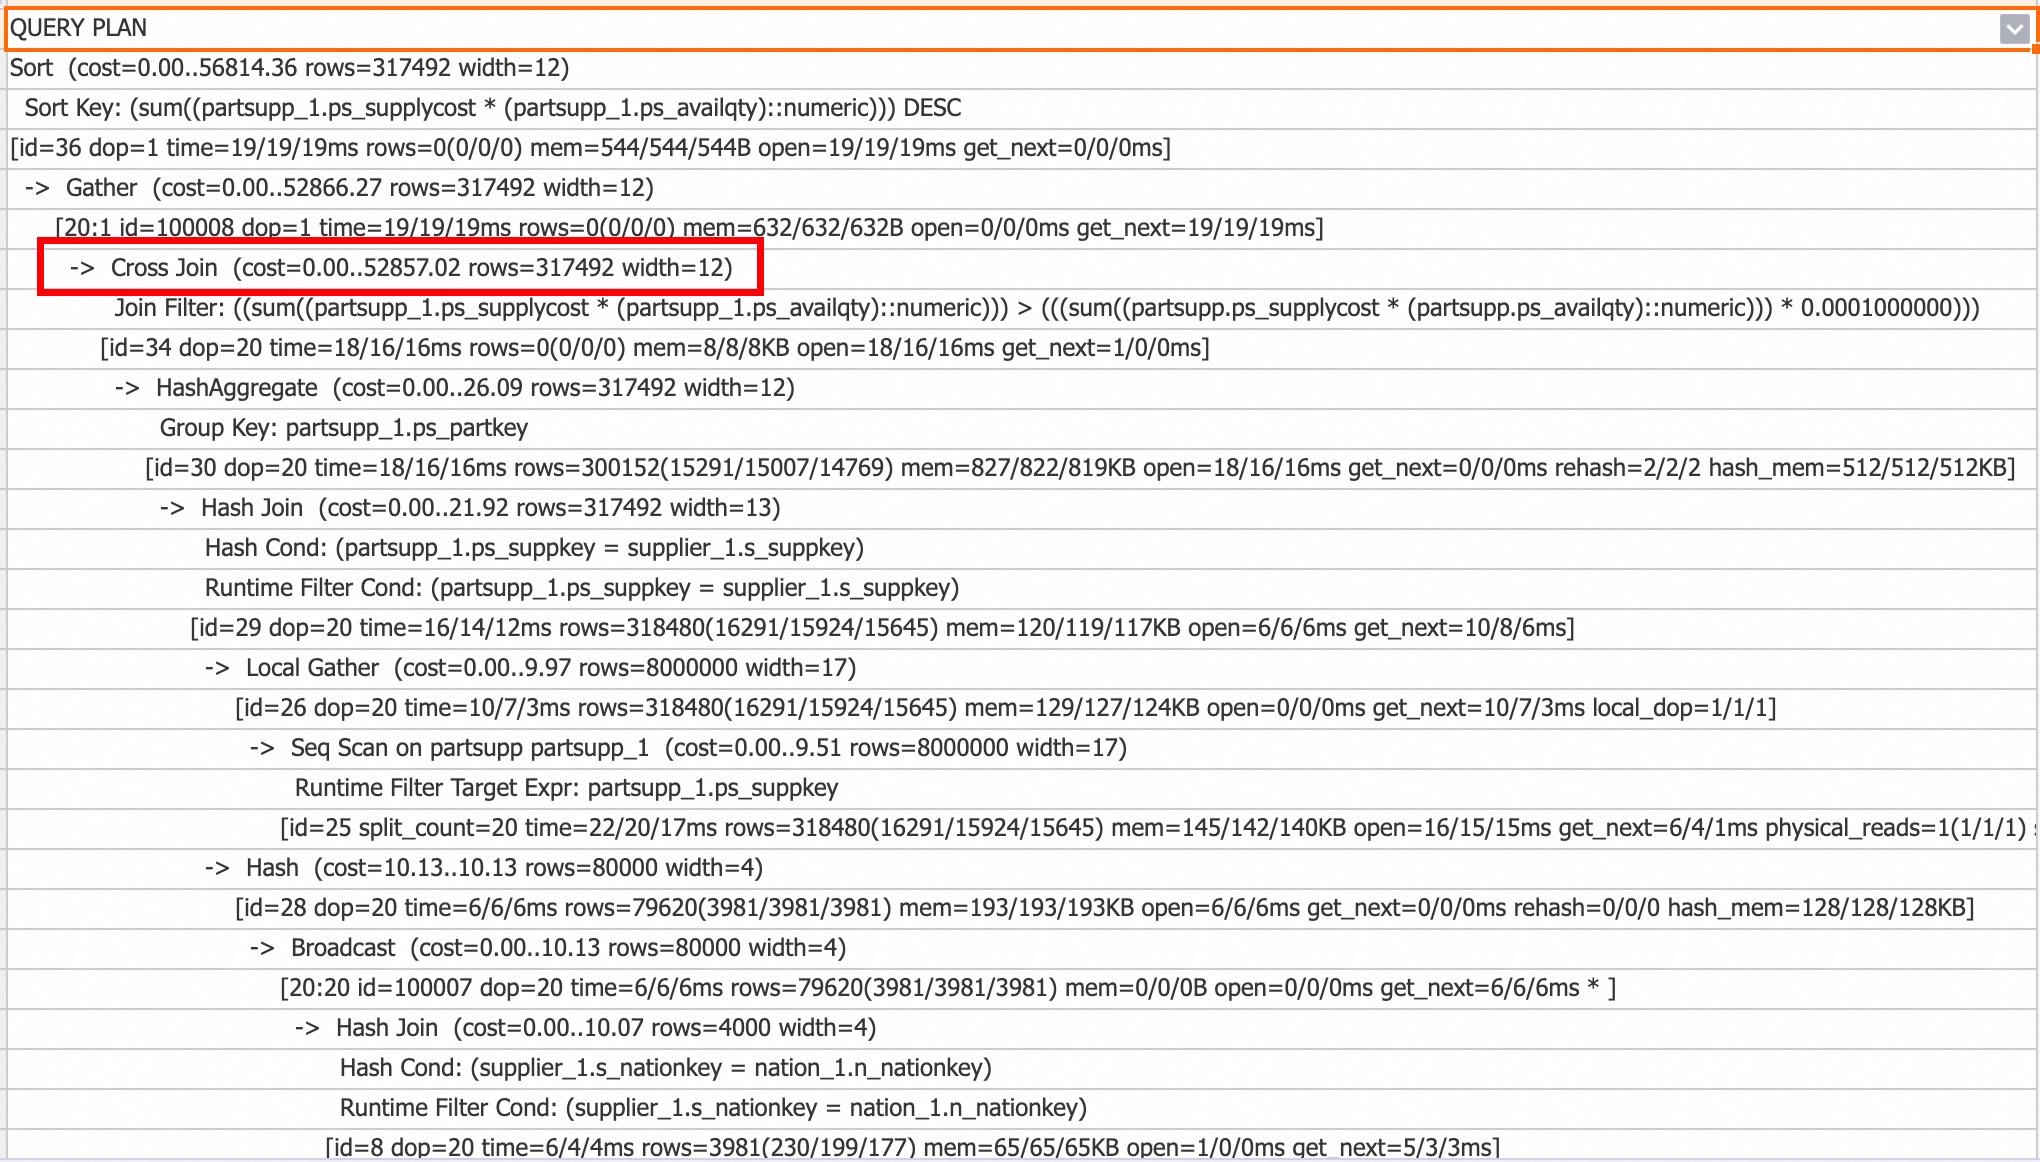
Cross Join'u devre dışı bırakmak için:
-- Disable for the current session
SET hg_experimental_enable_cross_join_rewrite = off;

-- Disable at the database level (takes effect for new connections)
ALTER database <database name> hg_experimental_enable_cross_join_rewrite = off;
Merge Join
Merge Join, girişlerinin birleştirme anahtarlarında önceden sıralanmış olmasını gerektirir. Hologres, giriş verilerinin zaten sıralı olduğu sorgular için Merge Join'i seçebilir.
Broadcast
Broadcast işleci, küçük bir tablonun büyük bir tabloyla birleştirildiği Broadcast Join senaryolarında kullanılan bir tabloyu tüm parçalara kopyalar. QO, Broadcast maliyetini Redistribution ile karşılaştırır ve daha ucuz olanı seçer.
Tablo küçükse ve örnek az parçaya sahipse (örneğin, 5 parça) Broadcast maliyet açısından etkilidir.
BEGIN;
CREATE TABLE broadcast_test_1 (
    f1 int,
    f2 int);
CALL set_table_property('broadcast_test_1','distribution_key','f2');
CREATE TABLE broadcast_test_2 (
    f1 int,
    f2 int);
COMMIT;

INSERT INTO broadcast_test_1 SELECT i AS f1, i AS f2 FROM generate_series(1, 30)i;
INSERT INTO broadcast_test_2 SELECT i AS f1, i AS f2 FROM generate_series(1, 30000)i;

ANALYZE broadcast_test_1;
ANALYZE broadcast_test_2;

EXPLAIN SELECT * FROM broadcast_test_1 t1, broadcast_test_2 t2 WHERE t1.f1=t2.f1;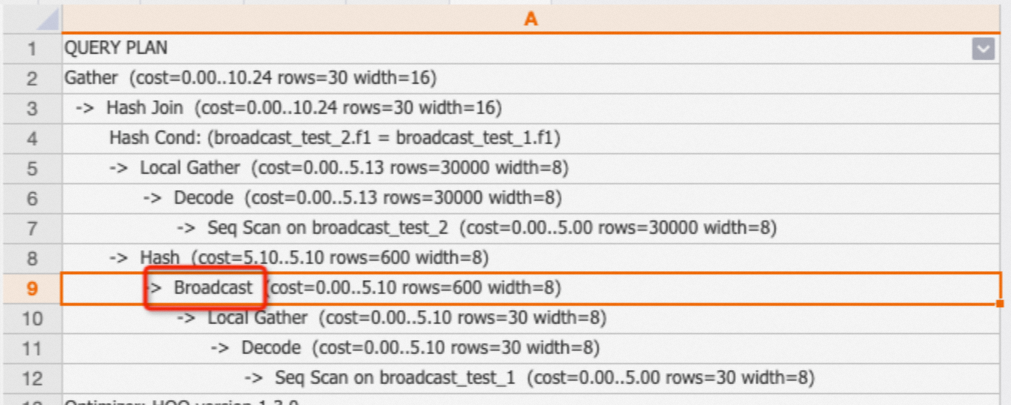
Küçük olmayan bir tablo için Broadcast görünüyorsa, muhtemel neden eski istatistiklerdir (örneğin, istatistikler 1.000 satır gösterirken gerçek tabloda 1 milyon satır vardır). Bunları yenilemek için ANALYZE <tablename> çalıştırın.
Shard prune ve Shards selected
-
Shard prune: QO'nun ilgili parçaları nasıl seçtiğini gösterir. QO uygun yöntemi otomatik olarak seçer.
lazily: Parçalar önce ID ile işaretlenir ve hesaplama sırasında seçilir.eagerly: Yalnızca eşleşen parçalar hemen seçilir; ilgisiz parçalar atlanır.
Shards selected: Kullanılan parça sayısı. Örneğin, 1 out of 20 toplam 20 parçadan 1 parçanın seçildiği anlamına gelir.
ExecuteExternalSQL
Hologres üç sorgu motoru bileşenine sahiptir: Hologres Query Engine (HQE), PostgreSQL Query Engine (PQE) ve Shard Query Engine (SQE). HQE özel motordur. HQE bir işlevi veya işleci desteklemediğinde, PQE bunu işler—bu bir performans maliyeti doğurur. Plandaki ExecuteExternalSQL işleci PQE çalıştırmasını işaretler.
Örnek 1: ::timestamp dönüşümü PQE tarafından işlenir.
CREATE TABLE pqe_test(a text);
INSERT INTO pqe_test VALUES ('2023-01-28 16:25:19.082698+08');
EXPLAIN SELECT a::timestamp FROM pqe_test;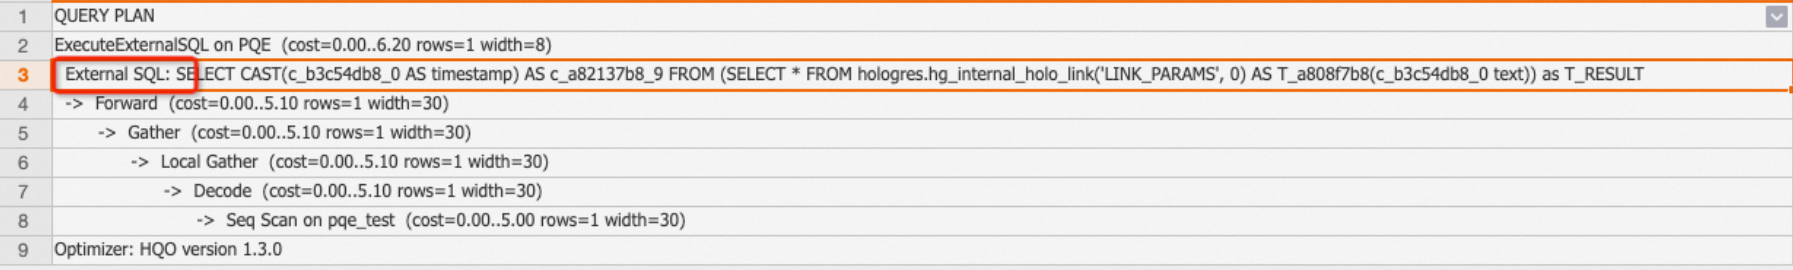
Örnek 2: ::timestamp ifadesini to_timestamp olarak yeniden yazmak HQE kullanır—planda ExecuteExternalSQL yoktur.
EXPLAIN SELECT to_timestamp(a,'YYYY-MM-DD HH24:MI:SS') FROM pqe_test;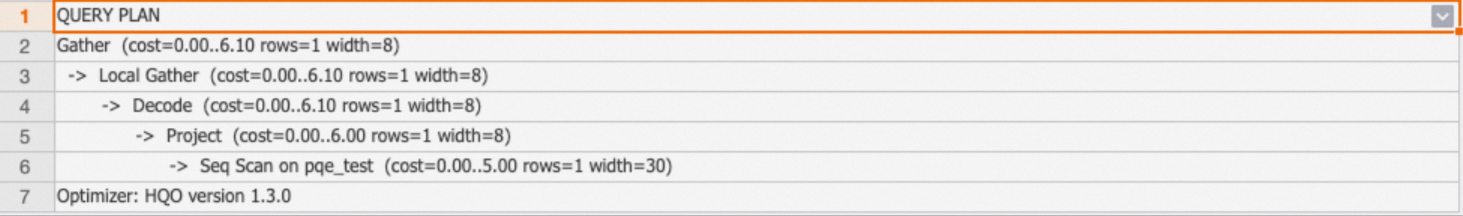
Çalıştırma planlarında PQE'yi tetikleyen işlevleri belirleyin, ardından bunları HQE uyumlu eşdeğerleri kullanacak şekilde yeniden yazın. Yaygın yeniden yazma örnekleri için bkz. Sorgu performansını optimize etme.
Hologres, her sürümle birlikte daha fazla PQE işlemini HQE'ye iter. Bazı işlevler yükseltmeden sonra otomatik olarak HQE kullanabilir. İşlev sürüm notları konusuna bakın.
Toplama işleçleri
Hologres çoğu toplama işlemi için HashAggregate kullanır. HashAggregate, paralel toplama için verileri parçalar arasında dağıtır, ardından sonuçları Gather ile birleştirir.
Büyük veri kümeleri için Hologres çok aşamalı HashAggregate kullanır:
Partial HashAggregate: Dosyalar ve parçalar içinde toplama yapar.
Final HashAggregate: Parçalar arasındaki kısmi sonuçları birleştirir.
Veriler GROUP BY anahtarlarında önceden sıralandığında GroupAggregate kullanılır.
EXPLAIN SELECT
        sum(l_extendedprice * l_discount) AS revenue
FROM
        lineitem
WHERE
        l_shipdate >= date '1996-01-01'
        AND l_shipdate < date '1996-01-01' + interval '1' year
        AND l_discount BETWEEN 0.02 - 0.01 AND 0.02 + 0.01
        AND l_quantity < 24;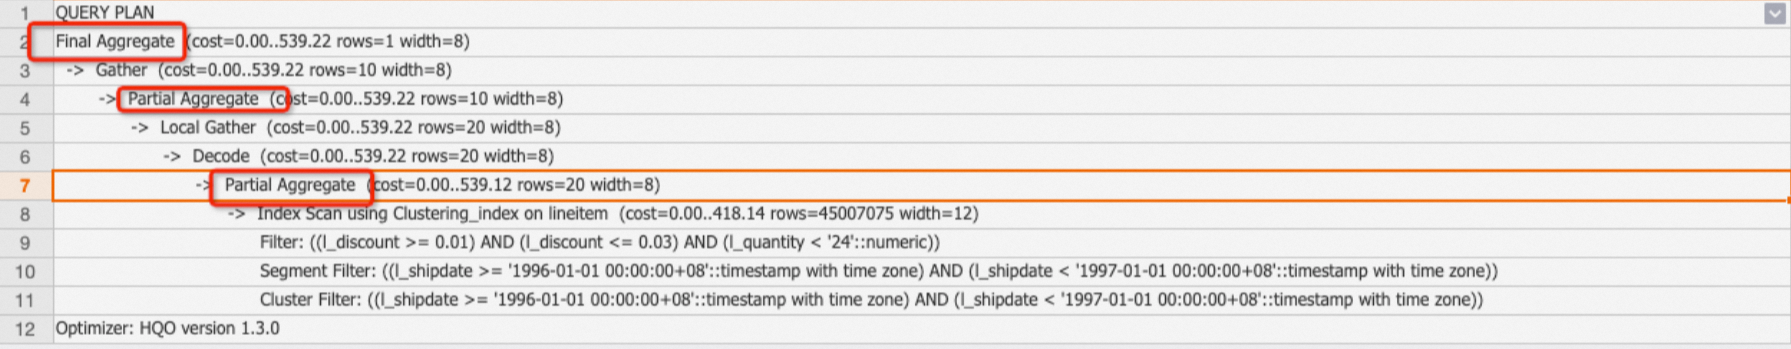
QO, veri hacmine göre otomatik olarak tek aşamalı veya çok aşamalı HashAggregate seçer. EXPLAIN ANALYZE bir Aggregate işleci için yüksek süre gösteriyorsa ancak QO yalnızca parça düzeyinde toplama seçtiyse, çok aşamalı toplamayı zorlayın:
SET optimizer_force_multistage_agg = on;Sort
Sort işleci, satırları artan (ASC) veya azalan (DESC) sırada düzenler; tipik olarak ORDER BY yan tümcelerinden gelir.
EXPLAIN SELECT l_shipdate FROM public.lineitem ORDER BY l_shipdate;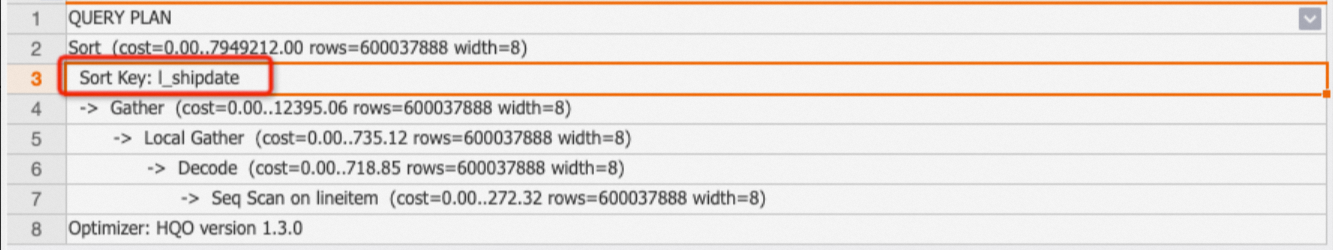
Büyük sıralama işlemleri önemli kaynaklar tüketir. Mümkün olduğunda büyük veri kümelerini sıralamaktan kaçının.
Limit
Limit işleci, çıktı satır sayısını sınırlar. Yalnızca nihai çıktıyı kontrol eder, taranan satır sayısını değil. Gerçek tarama hacmini anlamak için Limit'in Seq Scan düğümüne itilip itilmediğini kontrol edin.
EXPLAIN SELECT * FROM public.lineitem limit 1;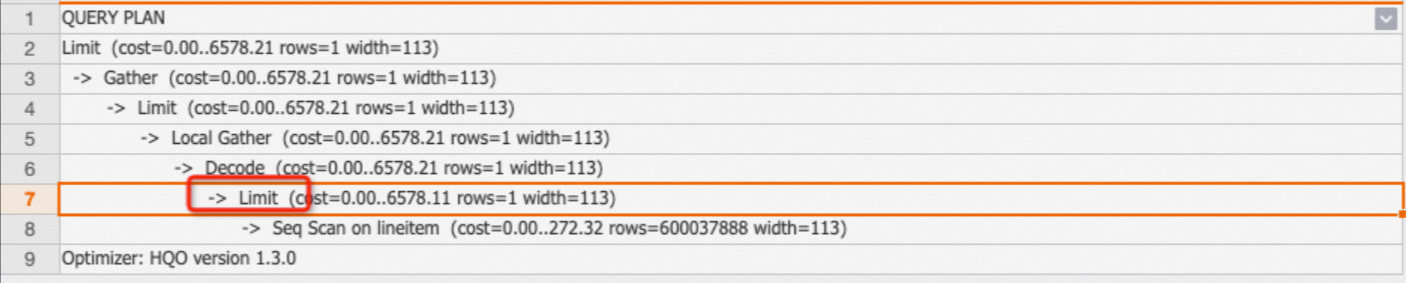
Limit hakkında notlar:
Tüm Limit işleçleri itilmez. Taranan satırları azaltmak için filtre koşulları ekleyin.
Çok büyük LIMIT değerlerinden (yüz binlerce veya daha fazla) kaçının—itilseler bile tarama süresini artırırlar.
Append
Append işleci, UNION ALL alt sorgularının sonuçlarını birleştirir.
Exchange
Exchange işleci, bir parça içinde veri aktarır. İşlem gerekmez.
Forward
Forward işleci, HQE ile PQE veya SQE arasında veri aktarır. HQE+PQE veya HQE+SQE kombinasyonlarını kullanan planlarda görünür.
Project
Project işleci, bir alt sorgu ile dış sorgusu arasındaki sütun eşlemesini temsil eder. İşlem gerekmez.
Yaygın performans sorunları
Yürütme planında belirli bir belirti gördüğünüzde bu bölümü hızlı referans olarak kullanın.
| Belirti | Olası neden | Ne yapılmalı |
|---|---|---|
Taramada rows=1000 |
Eski istatistikler | ANALYZE <tablename> çalıştırın |
| Birleştirmede Redistribution | Dağıtım anahtarı uyuşmazlığı veya birleştirme anahtarında tür değiştiren ifade | Dağıtım anahtarlarını birleştirme anahtarlarıyla hizalayın; birleştirme anahtarlarında ifadelerden kaçının. Bkz. Distribution key. |
| Hash Join'de büyük tablo hash tablosu | Eski istatistikler | Her iki tabloda da ANALYZE çalıştırın |
| Yalnızca parça düzeyinde toplamayla yüksek Aggregate süresi | Tek aşamalı toplama için veri hacmi çok büyük | optimizer_force_multistage_agg = on ayarlayın |
| ExecuteExternalSQL görünür | HQE tarafından desteklenmeyen işlev veya işleç, PQE'ye geri düşüyor | İfadeyi HQE uyumlu bir işlev kullanacak şekilde yeniden yazın. Bkz. Sorgu performansını optimize etme. |
| Büyük tablolarda Nested Loop | Non-equi birleştirme koşulu | Mümkün olduğunda equi-join'e yeniden yazın; dış sonuç kümesini küçük tutun |
Hash işleçlerinde yüksek open süresi |
Hash tablosu oluşturma yavaş—büyük iç tablo veya yavaş alt düğümler | İstatistikleri ve alt işleç sürelerini kontrol edin; birleştirme sırasını düşünün |
Maksimum ve minimum rows veya mem arasında büyük boşluk |
Parçalar arasında veri eğriliği | ADVICE bölümünü kontrol edin; dağıtım anahtarlarını ayarlayın |
| Yüksek Wait schema maliyeti | Bölümlenmiş üst tablolar üzerinde sık DDL | DDL sıklığını azaltın |
| Yüksek Lock query maliyeti | Kilit çekişmesi | Eşzamanlı sorguları araştırın |
Sonraki adımlar
HoloWeb'de yürütme planlarını görselleştirmek için bkz. Yürütme planlarını görüntüleme.