Bir tabloda sıkça GROUP BY veya JOIN işlemleri gerçekleştiriyorsanız ya da veri eğrilmesini önlemek istiyorsanız tabloyu oluştururken bir dağıtım anahtarı belirtebilirsiniz. Uygun bir dağıtım anahtarı verileri tüm hesaplama düğümlerine eşit şekilde dağıtarak hesaplama ve sorgu performansını önemli ölçüde artırır. Bu konuda Hologres'te bir tablo için dağıtım anahtarının nasıl ayarlanacağı açıklanmaktadır.
Giriş
Hologres'te distribution_key tablo özelliği bir tablo için veri dağıtım stratejisini belirtir. Sistem aynı dağıtım anahtarı değerine sahip kayıtların aynı parçaya tahsis edilmesini garanti eder. Aşağıdaki sözdizimini kullanarak bir tablo oluştururken bu özelliği ayarlayabilirsiniz:
-- Syntax supported by Hologres V2.1 and later
CREATE TABLE <table_name> (...) WITH (distribution_key = '[<columnName>[,...]]');
-- Syntax supported by all versions
BEGIN;
CREATE TABLE <table_name> (...);
call set_table_property('<table_name>', 'distribution_key', '[<columnName>[,...]]');
COMMIT;
Aşağıdaki tabloda parametreler açıklanmaktadır.
|
|
|
|
|
|
|
|
|
Doğru yapılandırılmış bir dağıtım anahtarı aşağıdaki avantajları sağlar:
-
Geliştirilmiş hesaplama performansı
Hesaplamalar farklı parçalarda paralel olarak çalışabilir ve genel hesaplama performansı artar.
-
Saniye başına sorgu sayısında (QPS) artış
Dağıtım anahtarını filtre koşulu olarak kullandığınızda Hologres yalnızca ilgili parçaları tarayabilir. Aksi takdirde Hologres tüm parçaları taramak zorunda kalır ve bu durum QPS'i düşürür.
-
Önemli ölçüde geliştirilmiş join performansı
İki tablo aynı tablo grubundaysa ve join sütunları aynı zamanda dağıtım anahtarlarıysa Hologres eşleşen join anahtarlarına sahip verilerin aynı parçada bulunmasını sağlar. Bu durum her düğümün verileri düğümler arasında taşımadan kendi verilerini yerel olarak birleştirmesine olanak tanır ve yürütme verimliliğini büyük ölçüde artırır.
Kullanım yönergeleri
Dağıtım anahtarı ayarlarken aşağıdaki ilkeleri izleyin:
Dağıtım anahtarı için yüksek kardinaliteye ve eşit veri dağılımına sahip sütunları seçin. Eşit olmayan veri dağılımı veri eğrilmesine ve dengesiz iş yüküne neden olarak sorgu verimliliğini azaltır. Veri eğrilmesini gidermek için bkz. İş yükü eğriliğini algılama ve ele alma.
GROUP BYyan tümcelerinde sıkça kullanılan sütunları dağıtım anahtarı olarak seçin.Join işlemleri için yerel bir join etkinleştirmek ve veri karıştırmayı önlemek amacıyla join sütunlarını dağıtım anahtarları olarak ayarlayın. Join edilen tabloların aynı tablo grubunda olması gerekir.
En fazla iki sütundan oluşan bir dağıtım anahtarı ayarlamanızı öneririz. Çok sütunlu bir anahtar kullanırsanız sorgular tüm anahtar sütunlarında filtre içermiyorsa veri karıştırmasına neden olabilir. Her zaman aynı değere sahip olan iki sütun gibi yedek sütunlardan oluşan bileşik bir dağıtım anahtarı kullanmaktan kaçının. Altta yatan veriler düşük kardinaliteye sahipse bu durum veri eğrilmesine yol açabilir.
Tek bir sütunu veya birden çok sütunu dağıtım anahtarı olarak ayarlayabilirsiniz. Tek bir sütun kullanıyorsanız komutta ekstra boşluk bırakmayın. Birden çok sütun kullanıyorsanız sütun adlarını virgül (,) ile ayırın ve ekstra boşluk bırakmayın. Çok sütunlu bir dağıtım anahtarındaki sütunların sırası veri düzenini veya sorgu performansını etkilemez.
Bir tablonun birincil anahtarı (PK) varsa dağıtım anahtarı PK veya PK sütunlarının bir alt kümesi olmalıdır. Bir dağıtım anahtarı boş olamaz; yani en az bir sütun belirtmeniz gerekir. Bu gereklilik tek bir kayda ait tüm verilerin yalnızca bir parçada bulunmasını sağlar. Açıkça bir dağıtım anahtarı belirtmezseniz Hologres varsayılan dağıtım anahtarı olarak PK'yı kullanır.
Sınırlamalar
Dağıtım anahtarını tabloyu oluştururken ayarlamalısınız. Mevcut bir tablonun dağıtım anahtarını değiştirmek için tabloyu yeniden oluşturmanız ve verileri yeniden içe aktarmanız gerekir.
Dağıtım anahtarı sütunlardaki değerleri güncelleyemezsiniz. Bu değerleri değiştirmek için tabloyu yeniden oluşturmanız gerekir.
FLOAT, DOUBLE, NUMERIC, ARRAY, JSON veya diğer karmaşık veri türlerine sahip sütunları dağıtım anahtarı olarak ayarlayamazsınız.
-
Birincil anahtarı olmayan bir tablo için dağıtım anahtarı boş olabilir; bu durumda veriler tüm parçalara rastgele dağıtılır. Ancak Hologres V1.3.28'den başlayarak açıkça boş bir dağıtım anahtarı ayarlamak yasaktır. Aşağıdaki sözdizimi yasaklanan duruma bir örnektir:
--This syntax is prohibited in Hologres V1.3.28 and later.
CALL SET_TABLE_PROPERTY('<tablename>', 'distribution_key', '');
Bir dağıtım anahtarı sütunu
nulldeğerleri içeriyorsa Hologres bunları boş dizeler""olarak değerlendirir. Bu tüm null değerlerin aynı anahtara eşlendiği ve aynı parçaya dağıtıldığı anlamına gelir.
Nasıl çalışır?
Bir dağıtım anahtarı bir tablo için veri dağıtım stratejisini belirtir. Davranış farklı kullanım senaryolarında nasıl yapılandırıldığına bağlı olarak değişir.
Dağıtım anahtarı ayarlama
Bir tablo için dağıtım anahtarı ayarladığınızda Hologres verileri anahtara göre farklı parçalara tahsis eder. Hologres her kayıt için hedef parçayı belirlemek üzere Hash(distribution_key) % shard_count algoritmasını kullanır. Sistem aynı dağıtım anahtarı değerine sahip kayıtların aynı parçaya yerleştirilmesini garanti eder. Aşağıdaki örneklerde dağıtım anahtarının nasıl ayarlanacağı gösterilmektedir.
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
-- Set column 'a' as the distribution key. The system hashes the values in column 'a' and then applies a modulo operation: hash(a) % shard_count = shard_id. Records with the same result are distributed to the same shard. CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- Set columns 'a' and 'b' as the distribution key. The system hashes the values from both columns and then applies a modulo operation: hash(a,b) % shard_count = shard_id. Records with the same result are distributed to the same shard. CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a,b' ); -
Tüm sürümler tarafından desteklenen sözdizimi:
-- Set column 'a' as the distribution key. The system hashes the values in column 'a' and then applies a modulo operation: hash(a) % shard_count = shard_id. Records with the same result are distributed to the same shard.
begin;
create table tbl (
a int not null,
b text not null
);
call set_table_property('tbl', 'distribution_key', 'a');
commit;
-- Set columns 'a' and 'b' as the distribution key. The system hashes the values from both columns and then applies a modulo operation: hash(a,b) % shard_count = shard_id. Records with the same result are distributed to the same shard.
begin;
create table tbl (
  a int not null,
  b text not null
);
call set_table_property('tbl', 'distribution_key', 'a,b');
commit;
Aşağıdaki şekil bu veri dağılımını göstermektedir. 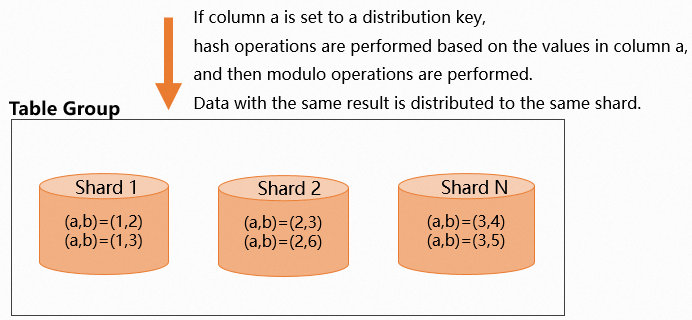 Bir dağıtım anahtarı ayarlarken verileri eşit şekilde dağıtan sütunları seçin. Hologres'te parça sayısı çalışan düğüm sayısıyla ilişkilidir. Daha fazla bilgi için bkz. Temel kavramlar. Eşit olmayan veri dağılımına neden olan bir anahtar seçerseniz veriler birkaç parçada yoğunlaşır. Bu durum hesaplama işlerinin çoğunu gerçekleştirmek için küçük sayıda çalışan düğümü zorlar ve uzun kuyruk etkisine yol açarak sorgu verimliliğini azaltabilir. Veri eğriliğini nasıl tespit edip çözebileceğiniz hakkında bilgi için bkz. İş yükü eğriliğini algılama ve ele alma.
Dağıtım anahtarını atlatma
Bir dağıtım anahtarı ayarlamazsanız veriler parçalara rastgele dağıtılır. Aynı değere sahip kayıtlar aynı parçaya veya farklı parçalara yerleştirilebilir. Aşağıdaki örnek dağıtım anahtarı olmadan bir tablonun nasıl oluşturulacağını göstermektedir.
-- Do not set a distribution key.
begin;
create table tbl (
a int not null,
b text not null
);
commit;
Aşağıdaki şekil bu rastgele veri dağılımını göstermektedir.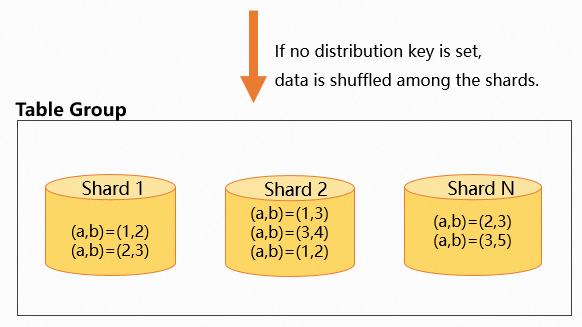
GROUP BY toplaması için dağıtım anahtarı
Bir dağıtım anahtarı ayarlarsanız aynı anahtar değerine sahip kayıtlar aynı parçada bulunur. GROUP BY toplama sorguları için sistem gruplama anahtarlarına göre verileri yeniden dağıtır. Dağıtım anahtarını GROUP BY yan tümcelerinde sıkça kullanılan sütunlara ayarlayarak verilerin her parçada zaten birlikte konumlandırılmasını sağlarsınız. Bu parçalar arasındaki veri yeniden dağıtımını azaltır ve sorgu performansını artırır. Aşağıdaki örnek bunu nasıl yapacağınızı göstermektedir.
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
CREATE TABLE agg_tbl ( a int NOT NULL, b int NOT NULL ) WITH ( distribution_key = 'a' ); -- Example query: aggregate on column a. select a,sum(b) from agg_tbl group by a; -
Tüm sürümler tarafından desteklenen sözdizimi:
begin;
create table agg_tbl (
a int not null,
b int not null
);
call set_table_property('agg_tbl', 'distribution_key', 'a');
commit;
-- Example query: aggregate on column a.
select a,sum(b) from agg_tbl group by a;
EXPLAIN komutunu çalıştırdığınızda redistribution işleci içermeyen bir yürütme planı görürsünüz. Tablonun dağıtım anahtarı (a) GROUP BY sütunuyla eşleştiği için Hologres veri yeniden dağıtımından kaçınarak toplamayı doğrudan her parça içinde gerçekleştirebilir.
İki tablo join işlemi için dağıtım anahtarı
-
Join sütunlarını dağıtım anahtarları olarak ayarlama
İki tablo join senaryosunda her iki tablonun join sütunlarını kendi dağıtım anahtarları olarak ayarlarsanız Hologres aynı join anahtarı değerine sahip verilerin aynı parçada bulunmasını garanti eder. Bu yerel bir join işlemine olanak tanır ve sorgu yürütmesini hızlandırır. Aşağıdaki örnek bunu göstermektedir.
-
Tabloları oluşturma DDL'si:
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
-- Data in tbl1 is distributed by column 'a', and data in tbl2 is distributed by column 'c'. When tbl1 and tbl2 are joined on a=c, the corresponding data resides on the same shard, allowing a local join for faster query performance. BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'c' ); COMMIT; -
Tüm sürümler tarafından desteklenen sözdizimi:
-- Data in tbl1 is distributed by column 'a', and data in tbl2 is distributed by column 'c'. When tbl1 and tbl2 are joined on a=c, the corresponding data resides on the same shard, allowing a local join for faster query performance.
begin;
create table tbl1(
a int not null,
b text not null
);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(
c int not null,
d text not null
);
call set_table_property('tbl2', 'distribution_key', 'c');
commit;
-
-
Sorgu deyimi:
select * from tbl1 join tbl2 on tbl1.a=tbl2.c;
Aşağıdaki şekil veri dağılımını göstermektedir.
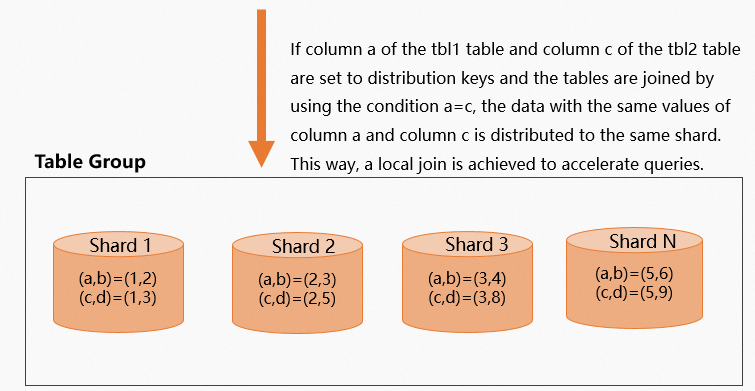 Yürütme planını (EXPLAIN SQL) inceleyerek planda
redistributionişlecinin bulunmadığını ve dolayısıyla hiçbir veri yeniden dağıtımı gerçekleşmediğini görebilirsiniz.QUERY PLAN Gather (cost=0.00..10.27 rows=1000 width=24) -> Hash Join (cost=0.00..10.21 rows=1000 width=24) Hash Cond: (tbl1.a = tbl2.c) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl1 (cost=0.00..5.00 rows=1000 width=12) -> Hash (cost=5.10..5.10 rows=1000 width=12) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl2 (cost=0.00..5.00 rows=1000 width=12) Optimizer: HQO version 1.3.0 -
-
Join sütunlarının ikisi de dağıtım anahtarı olarak ayarlanmamışsa
İki tablo join senaryosunda join sütunlarının ikisi de dağıtım anahtarı olarak ayarlanmamışsa Hologres sorgu sırasında verileri parçalar arasında karıştırır. İyimserleştirici iki tablonun boyutlarına göre karıştırma mı yoksa yayınlama mı yapılacağını belirler. Aşağıdaki örnekte
tbl1için dağıtım anahtarıasütunutbl2için isedsütunudur. Join koşulua=cşeklindedir.csütunutbl2için dağıtım anahtarı olmadığından verilerinin her parçaya karıştırılması gerekir ve bu durum sorgu performansını düşürür.-
Tabloları oluşturma DDL'si:
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'd' ); COMMIT; -
Tüm sürümler tarafından desteklenen sözdizimi:
begin;
create table tbl1(
a int not null,
b text not null
);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(
c int not null,
d text not null
);
call set_table_property('tbl2', 'distribution_key', 'd');
commit;
-
-
Sorgu deyimi:
select * from tbl1 join tbl2 on tbl1.a=tbl2.c;
Aşağıdaki şekil veri dağılımını göstermektedir.
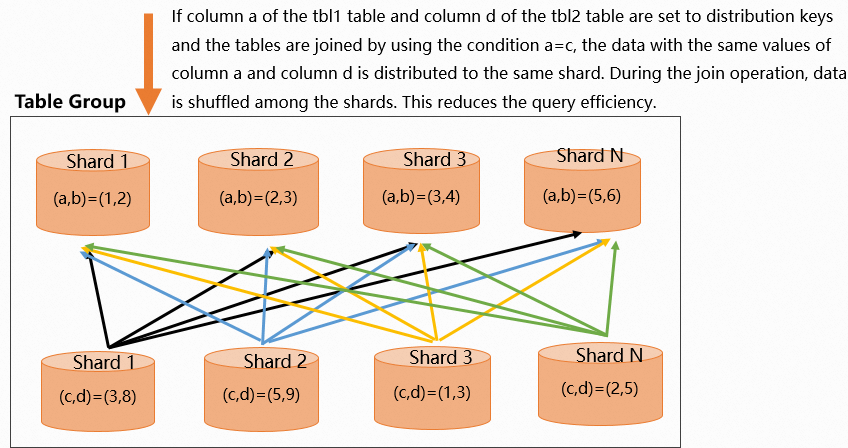 Yürütme planı verilerin parçalar arasında yeniden karıştırıldığını gösteren bir
redistributionişleci içermektedir. Bu durum ekstra veri hareketine ve performans düşüşüne neden olan optimal olmayan bir dağıtım anahtarı yapılandırmasına işaret eder.QUERY PLAN Gather (cost=0.00..10.27 rows=1000 width=24) -> Hash Join (cost=0.00..10.21 rows=1000 width=24) Hash Cond: (tbl2.c = tbl1.a) -> Redistribution (cost=0.00..5.10 rows=1000 width=12) Hash Key: tbl2.c -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl2 (cost=0.00..5.00 rows=1000 width=12) -> Hash (cost=5.10..5.10 rows=1 width=12) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1 width=12) -> Decode (cost=0.00..5.10 rows=1 width=12) -> Seq Scan on tbl1 (cost=0.00..5.00 rows=1 width=12) Optimizer: HQO version 1.3.0 -
Çoklu tablo join işlemi için dağıtım anahtarı
Çoklu tablo join işlemleri daha karmaşıktır. Aşağıdaki genel ilkeleri izleyin:
Tüm tablolar aynı sütunlar üzerinden join ediliyorsa bu join sütunlarını her tablo için dağıtım anahtarı olarak ayarlayın.
Tablolar farklı sütunlar üzerinden join ediliyorsa en büyük tablolar arasındaki join işlemini önceliklendirin. En büyük tabloların join sütunlarını dağıtım anahtarları olarak ayarlayın.
Aşağıdaki örneklerde bu durumlar üç tablo join işlemi kullanılarak gösterilmektedir. Aynı mantığı üçten fazla tablo içeren join işlemlerine de uygulayabilirsiniz.
-
Üç tablonun da aynı join sütunlarına sahip olması
Üç tablonun tamamı aynı sütunlar üzerinden join ediliyorsa senaryo basittir. Yerel bir join işlemi etkinleştirmek için ortak join sütunlarını üç tablonun tamamı için dağıtım anahtarı olarak ayarlayabilirsiniz.
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
BEGIN; CREATE TABLE join_tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE join_tbl2 ( a int NOT NULL, d text NOT NULL, e text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE join_tbl3 ( a int NOT NULL, e text NOT NULL, f text NOT NULL, g text NOT NULL ) WITH ( distribution_key = 'a' ); COMMIT; -- 3-table join query SELECT * FROM join_tbl1 INNER JOIN join_tbl2 ON join_tbl2.a = join_tbl1.a INNER JOIN join_tbl3 ON join_tbl2.a = join_tbl3.a; -
Tüm sürümler tarafından desteklenen sözdizimi:
begin;
create table join_tbl1(
a int not null,
b text not null
);
call set_table_property('join_tbl1', 'distribution_key', 'a');
create table join_tbl2(
a int not null,
d text not null,
e text not null
);
call set_table_property('join_tbl2', 'distribution_key', 'a');
create table join_tbl3(
a int not null,
e text not null,
f text not null,
g text not null
);
call set_table_property('join_tbl3', 'distribution_key', 'a');
commit;
--3-table join query
SELECT * FROM join_tbl1
INNER JOIN join_tbl2 ON join_tbl2.a = join_tbl1.a
INNER JOIN join_tbl3 ON join_tbl2.a = join_tbl3.a;
Yürütme planı (EXPLAIN SQL) şunları göstermektedir:
redistributionişleci yoktur. Bu verilerin yeniden karıştırılmadığını ve yerel bir join işlemi gerçekleştirildiğini gösterir.exchangeişleci verileri yürütme aşamaları veya düğümler arasında taşır. Bu süreç yalnızca ilgili parçadaki verilerin işlenmesini sağlayarak sorgu verimliliğini artırır.
QUERY PLAN Gather (cost=0.00..16.44 rows=10000 width=36) -> Hash Join (cost=0.00..15.57 rows=10000 width=36) Hash Cond: ((join_tbl2.a = join_tbl3.a) AND (join_tbl1.a = join_tbl3.a)) -> Hash Join (cost=0.00..10.31 rows=10000 width=20) Hash Cond: (join_tbl2.a = join_tbl1.a) -> Exchange (Gather Exchange) (cost=0.00..5.11 rows=10000 width=12) -> Decode (cost=0.00..5.11 rows=10000 width=12) -> Seq Scan on join_tbl2 (cost=0.00..5.00 rows=10000 width=12) -> Hash (cost=5.11..5.11 rows=10000 width=8) -> Exchange (Gather Exchange) (cost=0.00..5.11 rows=10000 width=8) -> Decode (cost=0.00..5.11 rows=10000 width=8) -> Seq Scan on join_tbl1 (cost=0.00..5.00 rows=10000 width=8) -> Hash (cost=5.12..5.12 rows=10000 width=16) -> Exchange (Gather Exchange) (cost=0.00..5.12 rows=10000 width=16) -> Decode (cost=0.00..5.12 rows=10000 width=16) -> Seq Scan on join_tbl3 (cost=0.00..5.00 rows=10000 width=16) Optimizer: HQO version 1.3.0 -
-
Üç tablonun farklı join sütunlarına sahip olması
Pratikte çoklu tablo join işlemindeki join sütunları farklı olabilir. Bu durumda dağıtım anahtarını ayarlamak için aşağıdaki ilkeleri kullanın:
Temel iyileştirme ilkesi en büyük tablolar arasındaki join işlemini önceliklendirmektir. Büyük tabloların join sütunlarını dağıtım anahtarı olarak ayarlayın. Küçük tablolar daha az veri içerdiğinden bunların dağıtım stratejisi daha düşük önceliğe sahiptir.
Tablolar yaklaşık olarak aynı miktarda veri içeriyorsa dağıtım anahtarını
GROUP BYyan tümcelerinde en sık kullanılan join sütunlarına ayarlayın.
Aşağıdaki örnekte üç tablo join edilmekte ve join sütunları aynı değildir. En iyi strateji en büyük tablonun join sütunlarını dağıtım anahtarı olarak seçmektir.
join_tbl_1tablosu 10 milyon satır içerirkenjoin_tbl_2vejoin_tbl_3tablolarının her biri 1 milyon satır içermektedir. Bu nedenlejoin_tbl_1birincil optimizasyon hedefidir.-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
BEGIN; -- join_tbl_1 contains 10 million rows. CREATE TABLE join_tbl_1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- join_tbl_2 contains 1 million rows. CREATE TABLE join_tbl_2 ( a int NOT NULL, d text NOT NULL, e text NOT NULL ) WITH ( distribution_key = 'a' ); -- join_tbl_3 contains 1 million rows. CREATE TABLE join_tbl_3 ( a int NOT NULL, e text NOT NULL, f text NOT NULL, g text NOT NULL ) WITH ( distribution_key = 'a' ); COMMIT; -- When join keys are different, choose the join key of the largest table as the distribution key. SELECT * FROM join_tbl_1 INNER JOIN join_tbl_2 ON join_tbl_2.a = join_tbl_1.a INNER JOIN join_tbl_3 ON join_tbl_2.d = join_tbl_3.f; -
Tüm sürümler tarafından desteklenen sözdizimi:
begin;
--join_tbl_1 contains 10 million rows.
create table join_tbl_1(
a int not null,
b text not null
);
call set_table_property('join_tbl_1', 'distribution_key', 'a');
--join_tbl_2 contains 1 million rows.
create table join_tbl_2(
a int not null,
d text not null,
e text not null
);
call set_table_property('join_tbl_2', 'distribution_key', 'a');
--join_tbl_3 contains 1 million rows.
create table join_tbl_3(
a int not null,
e text not null,
f text not null,
g text not null
);
call set_table_property('join_tbl_3', 'distribution_key', 'a');
commit;
-- When join keys are different, choose the join key of the largest table as the distribution key.
SELECT * FROM join_tbl_1
INNER JOIN join_tbl_2 ON join_tbl_2.a = join_tbl_1.a
INNER JOIN join_tbl_3 ON join_tbl_2.d = join_tbl_3.f;
Yürütme planı (EXPLAIN SQL) şunları göstermektedir:
join_tbl_2ilejoin_tbl_3arasındaki join işlemi için birredistributionişleci görünmektedir.join_tbl_3daha küçük bir tablo olduğundan ve join sütunu dağıtım anahtarıyla eşleşmediğinden Hologres verilerini yeniden dağıtır.join_tbl_1ilejoin_tbl_2arasındaki join işlemi içinredistributionişleci yoktur. Her iki tablo da ortak join sütununu dağıtım anahtarı olarak kullandığından join işleminin bu kısmı için veri yeniden dağıtımı gerekmez.
QUERY PLAN
Gather  (cost=0.00..183.90 rows=1000000 width=49)
  -> Hash Join  (cost=0.00..64.87 rows=1000000 width=49)
      Hash Cond: (join_tbl_2.d = join_tbl_3.f)
      -> Redistribution  (cost=0.00..40.22 rows=1000000 width=27)
          Hash Key: join_tbl_2.d
          -> Hash Join  (cost=0.00..35.99 rows=1000000 width=27)
              Hash Cond: (join_tbl_1.a = join_tbl_2.a)
              -> Exchange (Gather Exchange)  (cost=0.00..18.45 rows=10000000 width=11)
                  -> Decode  (cost=0.00..18.08 rows=10000000 width=11)
                      -> Seq Scan on join_tbl_1  (cost=0.00..7.75 rows=10000000 width=11)
              -> Hash  (cost=6.93..6.93 rows=1000000 width=16)
                  -> Exchange (Gather Exchange)  (cost=0.00..6.93 rows=1000000 width=16)
                      -> Decode  (cost=0.00..6.88 rows=1000000 width=16)
                          -> Seq Scan on join_tbl_2  (cost=0.00..5.29 rows=1000000 width=16)
      -> Hash  (cost=10.97..10.97 rows=1000000 width=22)
          -> Redistribution  (cost=0.00..10.97 rows=1000000 width=22)
              Hash Key: join_tbl_3.f
              -> Exchange (Gather Exchange)  (cost=0.00..7.53 rows=1000000 width=22)
                  -> Decode  (cost=0.00..7.45 rows=1000000 width=22)
                      -> Seq Scan on join_tbl_3  (cost=0.00..5.31 rows=1000000 width=22)
Optimizer: HQO version 1.3.0
Örnekler
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
-- Set a single-column distribution key. CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- Set a multi-column distribution key. CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a,b' ); -- Set join keys as distribution keys in a join scenario. BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'c' ); COMMIT; SELECT b, count(*) FROM tbl1 JOIN tbl2 ON tbl1.a = tbl2.c GROUP BY b; -
Tüm sürümler tarafından desteklenen sözdizimi:
-- Set a single-column distribution key.
begin;
create table tbl (a int not null, b text not null);
call set_table_property('tbl', 'distribution_key', 'a');
commit;
-- Set a multi-column distribution key.
begin;
create table tbl (a int not null, b text not null);
call set_table_property('tbl', 'distribution_key', 'a,b');
commit;
-- Set join keys as distribution keys in a join scenario.
begin;
create table tbl1(a int not null, b text not null);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(c int not null, d text not null);
call set_table_property('tbl2', 'distribution_key', 'c');
commit;
select b, count(*) from tbl1 join tbl2 on tbl1.a = tbl2.c group by b;
İlgili belgeler
İş senaryolarınıza göre tablo özelliklerini ayarlama konusunda rehberlik için bkz. Senaryo tabanlı tablo tasarımı kılavuzu.
Hologres dahili tablolarında sorgu performansını optimize etmeye ilişkin en iyi uygulamalar hakkında daha fazla bilgi için bkz. Sorgu performansını optimize etme.
-
Hologres dahili tablolarıyla ilgili DDL deyimleri için bkz.: