Hologres tablo verilerini üç biçimde saklar: satır yönelimli, sütun yönelimli ve hibrit. Her biçim farklı sorgu kalıpları için optimize edilmiştir. Tabloyu oluştururken biçimi seçin; daha sonra değiştirmek tablonun yeniden oluşturulmasını gerektirir.
Depolama biçimi seçin
İş yükünüze uygun biçimi belirlemek için bu tabloyu kullanın. Varsayılan olarak sütun yönelimli depolama kullanılır.
| Sütun yönelimli | Satır yönelimli | Hibrit | |
|---|---|---|---|
| En uygun olduğu durumlar | OLAP iş yükleri: karmaşık sorgular, join işlemleri, tam taramalar, toplamlar | Yüksek QPS değerine sahip birincil anahtar (PK) nokta sorguları | Hem PK nokta sorgularına hem de OLAP sorgularına ihtiyaç duyan tablolar; PK dışı nokta sorguları |
| Sütun sınırı | 300 | 3.000 | 300 |
| Varsayılan dizinler | Dize sütunları için bitmap dizinleri dahil olmak üzere birden çok dizin | Yalnızca PK dizini | Satır + sütun dizinleri |
| Depolama ek yükü | Düşük | Düşük | Daha yüksek (veriler hem satır hem de sütun biçiminde saklanır) |
orientation değeri |
column (varsayılan) |
row |
row,column |
Her yazma işlemi hem satır yönelimli hem de sütun yönelimli kopyalara gerçekleştiği için hibrit depolama daha yüksek depolama ek yüküne neden olur. Bu yöntemi yalnızca tek bir tablonun gerçekten hem PK aramalarına hem de analitik sorgulara ihtiyaç duyduğu durumlarda kullanın.
Depolama biçimini ayarlayın
Bir tablo oluştururken orientation özelliğini belirtin.
V2.1 ve sonraki sürümler:
CREATE TABLE <table_name> (...) WITH (orientation = '[column | row | row,column]');Tüm sürümler:
BEGIN;
CREATE TABLE <table_name> (...);
CALL set_table_property('<table_name>', 'orientation', '[column | row | row,column]');
COMMIT;
Nasıl çalışır?
Üç biçim, verileri diskte nasıl düzenledikleri ve hangi dizinleri oluşturdukları açısından farklılık gösterir. Bu durum, hangi sorgu türlerini verimli bir şekilde karşılayabileceklerini belirler.
Sütun yönelimli depolama, her sütunun değerlerini bitişik olarak saklar. SELECT SUM(revenue) FROM orders WHERE region = 'APAC' gibi bir sorgu, yalnızca revenue ve region sütunlarını okur ve diğerlerini atlar. Bu yaklaşım, birçok satırda bulunan küçük bir sütun alt kümesine erişen analitik sorgular için G/Ç işlemlerini azaltır.
Satır yönelimli depolama, her satırın değerlerini bitişik olarak saklar. SELECT * FROM orders WHERE id = '1001' gibi bir sorgu, tek bir PK araması yapar ve tüm satırı tek bir taramada alır. Belirli bir satırın tüm sütunlarına anında ihtiyaç duyduğunuzda bu yöntem verimlidir.
Hibrit depolama, her satırın hem satır yönelimli hem de sütun yönelimli bir kopyasını tutar. Sorgu iyileştiricisi, yürütme planına göre daha iyi performans sağlayan kopyayı seçer. Her yazma işleminin başarılı olması için her iki kopyaya da yazılması gerekir.
Sütun yönelimli
Sütun yönelimli tablolar ORC biçimini kullanır. Veriler, Run-Length Encoding (RLE) ve sözlük kodlaması gibi algoritmalarla kodlanır, ardından Snappy, Zlib, Zstd veya LZ4 ile sıkıştırılır. Depolama katmanı ayrıca bitmap dizinleri oluşturur ve gereksiz veri okumalarını azaltmak için geç materyalleştirme kullanır.
Sütun yönelimli bir tabloda birincil anahtar (PK) bulunduğunda sistem her satır için bir satır tanımlayıcısı (RID) oluşturur. Sık sorgulanan sütunlarda dağıtım anahtarı veya kümeleme anahtarı gibi dizinler tanımlandığında motor, parçayı ve dosyayı hızlı bir şekilde bulur.
V2.1 ve sonraki sürümler:
CREATE TABLE public.tbl_col (
    id TEXT NOT NULL,
    name TEXT NOT NULL,
    class TEXT NOT NULL,
    in_time TIMESTAMPTZ NOT NULL,
    PRIMARY KEY (id)
)
WITH (
    orientation = 'column',
    clustering_key = 'class',
    bitmap_columns = 'name',
    event_time_column = 'in_time'
);

SELECT * FROM public.tbl_col WHERE id = '3333';
SELECT id, class, name FROM public.tbl_col WHERE id < '3333' ORDER BY id;
Tüm sürümler:
BEGIN;
CREATE TABLE public.tbl_col (
    id TEXT NOT NULL,
    name TEXT NOT NULL,
    class TEXT NOT NULL,
    in_time TIMESTAMPTZ NOT NULL,
    PRIMARY KEY (id)
);
CALL set_table_property('public.tbl_col', 'orientation', 'column');
CALL set_table_property('public.tbl_col', 'clustering_key', 'class');
CALL set_table_property('public.tbl_col', 'bitmap_columns', 'name');
CALL set_table_property('public.tbl_col', 'event_time_column', 'in_time');
COMMIT;

SELECT * FROM public.tbl_col WHERE id = '3333';
SELECT id, class, name FROM public.tbl_col WHERE id < '3333' ORDER BY id;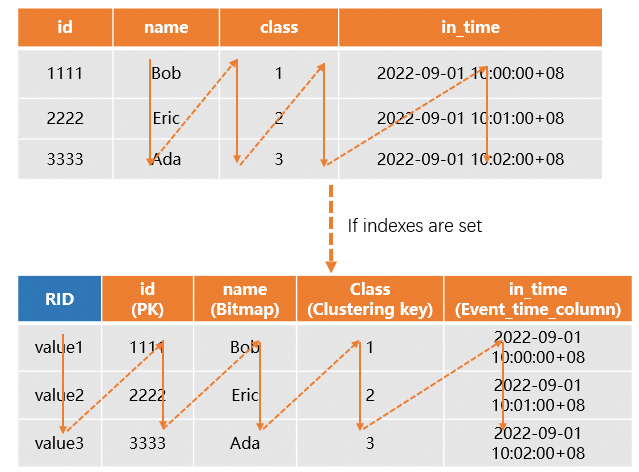
Satır yönelimli
Satır yönelimli tablolar SST biçimini kullanır. Veriler, anahtara göre sıralanmış ve sıkıştırılmış bloklar halinde saklanır. Depolama katmanı Blok Dizini ve Bloom Filter dizinleri oluşturur ve arka planda çalışan bir birleştirme mekanizması dosyaları verimli PK aramaları için düzenli tutar.
Önerilen: Yalnızca birincil anahtarı tanımlayın
Satır yönelimli bir tabloda PK bulunduğunda sistem, PK'yı hem dağıtım anahtarı hem de kümeleme anahtarı olarak otomatik şekilde ayarlar ve her satır için bir RID oluşturur. PK tabanlı bir nokta sorgusu, tüm sütunları almak için yalnızca bir PK dizinini tarar.
Satır yönelimli bir tablo oluştururken yalnızca PK'yı tanımlayın. Sistem dağıtım anahtarını ve kümeleme anahtarını otomatik olarak yapılandırır.
V2.1 ve sonraki sürümler:
CREATE TABLE public.tbl_row (
    id TEXT NOT NULL,
    name TEXT NOT NULL,
    class TEXT,
    PRIMARY KEY (id)
)
WITH (
    orientation = 'row',
    clustering_key = 'id',
    distribution_key = 'id'
);

-- PK-based point query
SELECT * FROM public.tbl_row WHERE id = '1111';

-- Multiple key lookup
SELECT * FROM public.tbl_row WHERE id IN ('1111', '2222', '3333');
Tüm sürümler:
BEGIN;
CREATE TABLE public.tbl_row (
    id TEXT NOT NULL,
    name TEXT NOT NULL,
    class TEXT,
    PRIMARY KEY (id)
);
CALL set_table_property('public.tbl_row', 'orientation', 'row');
CALL set_table_property('public.tbl_row', 'clustering_key', 'id');
CALL set_table_property('public.tbl_row', 'distribution_key', 'id');
COMMIT;

-- PK-based point query
SELECT * FROM public.tbl_row WHERE id = '1111';

-- Multiple key lookup
SELECT * FROM public.tbl_row WHERE id IN ('1111', '2222', '3333');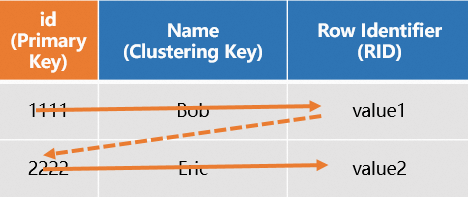
Önerilmez: PK ve kümeleme anahtarı uyumsuzluğu
PK ve kümeleme anahtarı için farklı alanlar tanımlarsanız her PK tabanlı sorgu iki tarama gerektirir:
Kümeleme anahtarı değerini ve RID'yi bulmak için PK dizinini kullanın.
Tam satırı getirmek için kümeleme anahtarını ve RID'yi kullanın.
Bu çift tarama deseni sorgu performansını önemli ölçüde düşürür.
V2.1 ve sonraki sürümler:
-- Avoid: clustering_key differs from PK
CREATE TABLE public.tbl_row (
    id TEXT NOT NULL,
    name TEXT NOT NULL,
    class TEXT,
    PRIMARY KEY (id)
)
WITH (
    orientation = 'row',
    clustering_key = 'name',  -- different from PK (id)
    distribution_key = 'id'
);
Tüm sürümler:
BEGIN;
CREATE TABLE public.tbl_row (
    id TEXT NOT NULL,
    name TEXT NOT NULL,
    class TEXT,
    PRIMARY KEY (id)
);
CALL set_table_property('public.tbl_row', 'orientation', 'row');
CALL set_table_property('public.tbl_row', 'clustering_key', 'name');  -- different from PK (id)
CALL set_table_property('public.tbl_row', 'distribution_key', 'id');
COMMIT;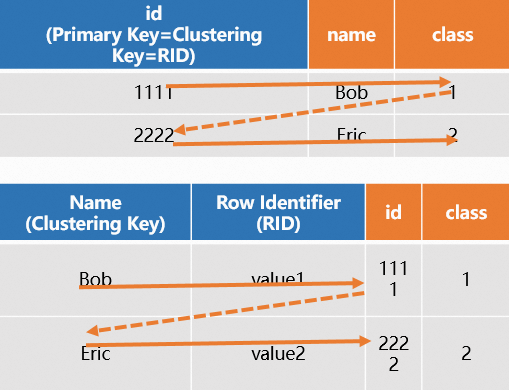
Hibrit
V1.1'de tanıtılan hibrit depolama, verileri aynı anda hem satır yönelimli hem de sütun yönelimli biçimlerde saklar. Birincil anahtar gereklidir. Her yazma işlemi atomik olarak tamamlanır; işlem yalnızca her iki kopya da yazıldıktan sonra başarılı olur.
Sorgular sırasında iyileştirici, daha yüksek verimlilik sağlayan biçimi seçer:
PK nokta sorguları (
SELECT * FROM tbl WHERE pk = xxx) ve Fixed Plan senaryoları: satır yönelimli yol.PK dışı nokta sorguları (
SELECT * FROM tbl WHERE col1 = xx AND col2 = yyy): iyileştirici önce sütun yönelimli kopyadan eşleşen satırları okur, ardından alınan anahtar değerlerini kullanarak satır yönelimli kopyadan tam satırları getirir. Bu yaklaşım, tüm sütunları döndürürken tam tablo taramasından kaçınır.Genel sorgular: sütun yönelimli yol.
V2.1 ve sonraki sürümler:
CREATE TABLE public.tbl_row_col (
    id TEXT NOT NULL,
    name TEXT NOT NULL,
    class TEXT NOT NULL,
    PRIMARY KEY (id)
)
WITH (
    orientation = 'row,column',
    distribution_key = 'id',
    clustering_key = 'class',
    bitmap_columns = 'name'
);

SELECT * FROM public.tbl_row_col WHERE id = '2222';                         -- PK point query
SELECT * FROM public.tbl_row_col WHERE class = 'Class Two';                 -- Non-PK point query
SELECT * FROM public.tbl_row_col WHERE id = '2222' AND class = 'Class Two'; -- General OLAP query
Tüm sürümler:
BEGIN;
CREATE TABLE public.tbl_row_col (
    id TEXT NOT NULL,
    name TEXT NOT NULL,
    class TEXT,
    PRIMARY KEY (id)
);
CALL set_table_property('public.tbl_row_col', 'orientation', 'row,column');
CALL set_table_property('public.tbl_row_col', 'distribution_key', 'id');
CALL set_table_property('public.tbl_row_col', 'clustering_key', 'class');
CALL set_table_property('public.tbl_row_col', 'bitmap_columns', 'name');
COMMIT;

SELECT * FROM public.tbl_row_col WHERE id = '2222';                         -- PK point query
SELECT * FROM public.tbl_row_col WHERE class = 'Class Two';                 -- Non-PK point query
SELECT * FROM public.tbl_row_col WHERE id = '2222' AND class = 'Class Two'; -- General OLAP query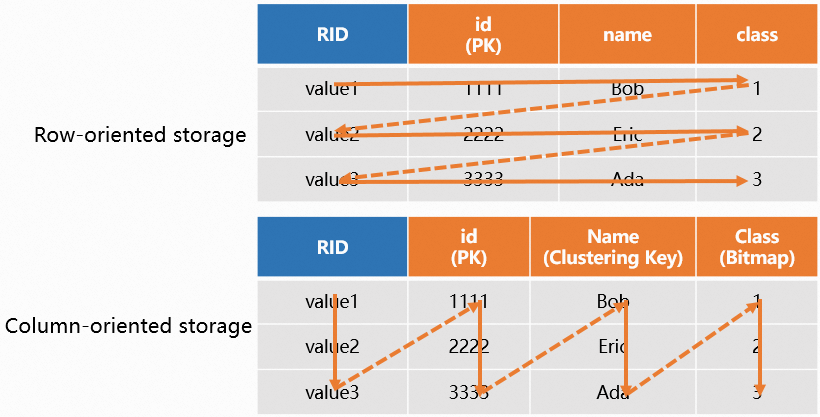
Kullanım örnekleri
Aşağıdaki örnekler V2.1 WITH (orientation = ...) söz dizimini kullanır. Tüm sürümlerle uyumlu olan eşdeğer set_table_property söz dizimi için yukarıdaki bölümlere bakın.
-- Column-oriented table (default)
CREATE TABLE tbl_col (
    a INT NOT NULL,
    b TEXT NOT NULL
)
WITH (
    orientation = 'column'
);

-- Row-oriented table
CREATE TABLE public.tbl_row (
    a INTEGER NOT NULL,
    b TEXT NOT NULL,
    PRIMARY KEY (a)
)
WITH (
    orientation = 'row'
);

-- Hybrid table (row + column)
CREATE TABLE tbl_col_row (
    pk TEXT NOT NULL,
    col1 TEXT,
    col2 TEXT,
    col3 TEXT,
    PRIMARY KEY (pk)
)
WITH (
    orientation = 'row,column'
);
SSS
Hibrit depolama hem PK nokta sorgularını hem de OLAP sorgularını destekliyorsa neden her zaman kullanılmıyor?
Veriler hem satır hem de sütun biçiminde iki kez yazıldığı için hibrit depolama daha yüksek depolama ek yüküne neden olur. Hibrit depolamayı yalnızca tek bir tablonun gerçekten hem yüksek QPS değerine sahip PK aramalarına hem de analitik sorgulara ihtiyaç duyduğu durumlarda kullanın. Yalnızca OLAP amaçlı tablolar için sütun yönelimli depolama daha verimlidir. Yalnızca PK araması yapılan tablolar için satır yönelimli depolama ek yükten kaçınır.
Oluşturulduktan sonra bir tablonun depolama biçimini değiştirebilir miyim?
Hayır. Doğrudan dönüştürme desteklenmez. Depolama biçimini değiştirmek için tabloyu yeni orientation değeriyle yeniden oluşturun.
Neden satır yönelimli depolama, sütun yönelimli depolamadan daha fazla sütunu destekler?
Sütun yönelimli tablolar varsayılan olarak dize sütunları için bitmap dizinleri dahil olmak üzere birden çok dizin oluşturur. Sütun sayısı arttıkça bu dizinler depolama ek yükünü artırır ve yazma işlemlerini yavaşlatır. Satır yönelimli tablolar yalnızca birincil anahtarı dizinlediği için sütun başına maliyet çok daha düşüktür.
Satır yönelimli bir tablo 3.000 sütunu veya sütun yönelimli bir tablo 300 sütunu aşarsa ne olur?
Bunlar kesin sınırlar değil, önerilen sınırlardır. Bu sınırların aşılması performansı düşürür: çok sayıda sütuna sahip sütun yönelimli tablolar yüksek dizin depolama ve yazma ek yüküne neden olur; çok sayıda sütuna sahip satır yönelimli tablolar satır boyutunu artırır ve nokta sorgusu aktarım hızını düşürür. Üretim iş yükleri için önerilen sınırlar içinde kalın.
Sonraki adımlar
Sorgu kalıplarınıza bağlı olarak depolama biçimi seçimini dağıtım anahtarı, kümeleme anahtarı ve bölümleme gibi diğer tablo özellikleriyle birleştirme konusunda rehberlik için bkz. Senaryo tabanlı tablo oluşturma optimizasyon kılavuzu.