Bu konu, Hologres'te verileri sıralamak ve sorguları hızlandırmak için kümeleme anahtarının nasıl kullanılacağını açıklar.
Giriş
Hologres, dosyalar içindeki verileri bir kümeleme anahtarına göre sıralar. Bu durum, dizine eklenen sütunlarda aralık ve filtre sorgularını hızlandırabilir. Aşağıdaki sözdizimini kullanarak bir tablo oluştururken kümeleme anahtarını belirtmeniz gerekir.
-- Syntax supported by Hologres V2.1 and later
CREATE TABLE <table_name> (...) WITH (clustering_key = '[<columnName>[,...]]');
-- Syntax supported by all versions
BEGIN;
CREATE TABLE <table_name> (...);
CALL set_table_property('<table_name>', 'clustering_key', '[<columnName>{:asc} [,...]]');
COMMIT;
Parametreler:
|
|
|
|
|
|
|
|
|
Kullanım önerileri
Kümeleme anahtarı, nokta ve aralık sorguları için idealdir.
WHERE a = 1veyaWHERE a > 1 AND a < 5gibi sorgulardaki filtre işlemlerinin performansını önemli ölçüde artırır. En iyi nokta sorgusu performansı için aynı sütunlarda hem kümeleme anahtarı hem de bitmap dizini tanımlayabilirsiniz.Kümeleme anahtarı en soldan eşleşme ilkesini takip eder. Bu nedenle, geniş bir sorgu yelpazesine uygulanabilmesini sağlamak için kümeleme anahtarında iki sütundan fazla bulundurmamanız önerilir. Sütunların sırası önemlidir: önce listelenen sütunlar, daha sonra listelenenlere göre daha yüksek önceliğe sahiptir.
-
Bir Kümeleme Anahtarı alanı belirtirken, dizin için sıralama düzenini belirtmek üzere alan adından sonra
:ascekleyebilirsiniz. Varsayılan sıralama düzeniasc(artan) şeklindedir. Hologres V2.1'den önceki sürümler, sıralama düzeninin azalan (desc) olarak ayarlanmasını desteklemez. Bu sürümlerde, sıralama düzeni azalan olarak ayarlandığında Kümeleme Anahtarı isabet edemezdi ve bu da kötü sorgu performansına neden olurdu. V2.1 sürümünden itibaren, belirli bir GUC parametresini etkinleştirdikten sonra Kümeleme Anahtarınıdescolarak ayarlayabilirsiniz. Ancak bu özellik yalnızca Text, Char, Varchar, Bytea ve Int gibi veri türlerine sahip alanlar için desteklenir. Diğer veri türlerine sahip alanlar için Kümeleme Anahtarınındescolarak ayarlanması henüz desteklenmemektedir.set hg_experimental_optimizer_enable_variable_length_desc_ck_filter = on; Satır yönelimli bir tablo için kümeleme anahtarı varsayılan olarak birincil anahtardır. Hologres V0.9'dan önceki sürümlerde varsayılan olarak kümeleme anahtarı ayarlanmamıştır. Birincil anahtardan farklı bir kümeleme anahtarı tanımlarsanız, Hologres verilerin iki sıralı kopyasını oluşturur; biri birincil anahtar için, diğeri kümeleme anahtarı için. Bu durum veri çoğaltmasına neden olur.
Sınırlamalar
Kümeleme anahtarını değiştirmek için yeni bir tablo oluşturmanız ve verileri içe aktarmanız gerekir.
-
Kümeleme anahtarında belirtilen sütunlar
NOT NULLolmalıdır. Hologres V1.3.20 ile V1.3.27 arasındaki sürümler, kümeleme anahtarında null değerlere izin veren sütunları desteklemiştir ancak V1.3.28'den itibaren bu destek kaldırılmıştır. Null değerlere izin veren bir kümeleme anahtarı veri doğruluğunu etkileyebilir. İş gereksinimleriniz null değerlere izin veren bir kümeleme anahtarı gerektiriyorsa, SQL deyiminizi çalıştırmadan önce aşağıdaki komutu çalıştırarak bunu etkinleştirebilirsiniz.set hg_experimental_enable_nullable_clustering_key = true; Float, Float4, Float8, Double, Decimal(Numeric), Json, Jsonb, Bit, Varbit, Money ve Time With Time Zone veya diğer karmaşık veri türlerine sahip sütunlar kümeleme anahtarında kullanılamaz.
-
Hologres V2.1'den önceki sürümlerde, bir dizinin sıralama düzenini azalan (
desc) olarak ayarlayamazsınız. Sıralama düzeni azalan olarak ayarlanırsa, kümeleme anahtarı isabet edemez ve bu da kötü sorgu performansına neden olur. V2.1 sürümünden itibaren, aşağıdaki GUC'u etkinleştirerek kümeleme anahtarınıdescolarak ayarlayabilirsiniz. Ancak bu özellik yalnızca Text, Char, Varchar, Bytea ve Int gibi veri türlerine sahip alanlar için desteklenir. Diğer veri türlerine sahip alanlar için kümeleme anahtarınıdescolarak ayarlayamazsınız.set hg_experimental_optimizer_enable_variable_length_desc_ck_filter = on; Sütun yönelimli bir tablo için varsayılan olarak kümeleme anahtarı tanımlanmaz. Kullanım durumunuza göre açıkça bir tane belirtmeniz gerekir.
-
Hologres'te her tablo için yalnızca bir kümeleme anahtarı ayarlayabilirsiniz. Bu, bir tablo oluştururken
callkomutunu birden çok kez değil, yalnızca bir kez çalıştırabileceğiniz anlamına gelir. Örneğin:-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
-- Correct usage CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a,b' ); -- Incorrect usage CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a', clustering_key = 'b' ); -
Tüm sürümler tarafından desteklenen sözdizimi:
-- Correct usage
BEGIN;
CREATE TABLE tbl (a int NOT NULL, b text NOT NULL);
CALL set_table_property('tbl', 'clustering_key', 'a,b');
COMMIT;
-- Incorrect usage
BEGIN;
CREATE TABLE tbl (a int NOT NULL, b text NOT NULL);
CALL set_table_property('tbl', 'clustering_key', 'a');
CALL set_table_property('tbl', 'clustering_key', 'b');
COMMIT;
-
Nasıl çalışır?
Kümeleme anahtarı, dosyalar içindeki verileri fiziksel olarak sıralar. Varsayılan olarak veriler artan (asc) düzende sıralanır. Aşağıdaki bölümler, kümeleme anahtarı için mantıksal ve fiziksel düzen kavramlarını açıklamaktadır.
-
Mantıksal düzen
Kümeleme anahtarı kullanan sorgular en soldan eşleşme ilkesini takip eder. Bir sorgunun filtre koşulları kümeleme anahtarı sütunlarının ön ekiyle eşleşmiyorsa, kümeleme anahtarı sorguyu hızlandıramaz. Aşağıdaki örnek, Hologres'teki bir kümeleme anahtarının mantıksal düzenini göstermektedir.
Name, Date ve Class sütunlarına sahip bir tablonuz olduğunu varsayalım.
Kümeleme anahtarını (Date) olarak ayarlarsanız, tablodaki veriler Date sütununa göre sıralanır.
Kümeleme anahtarını (Class, Date) olarak ayarlarsanız, veriler önce Class sütununa göre, ardından her sınıf içinde Date sütununa göre sıralanır.
Kümeleme anahtarı sütunlarının seçimi, verilerin nihai sıralı düzenini belirler.
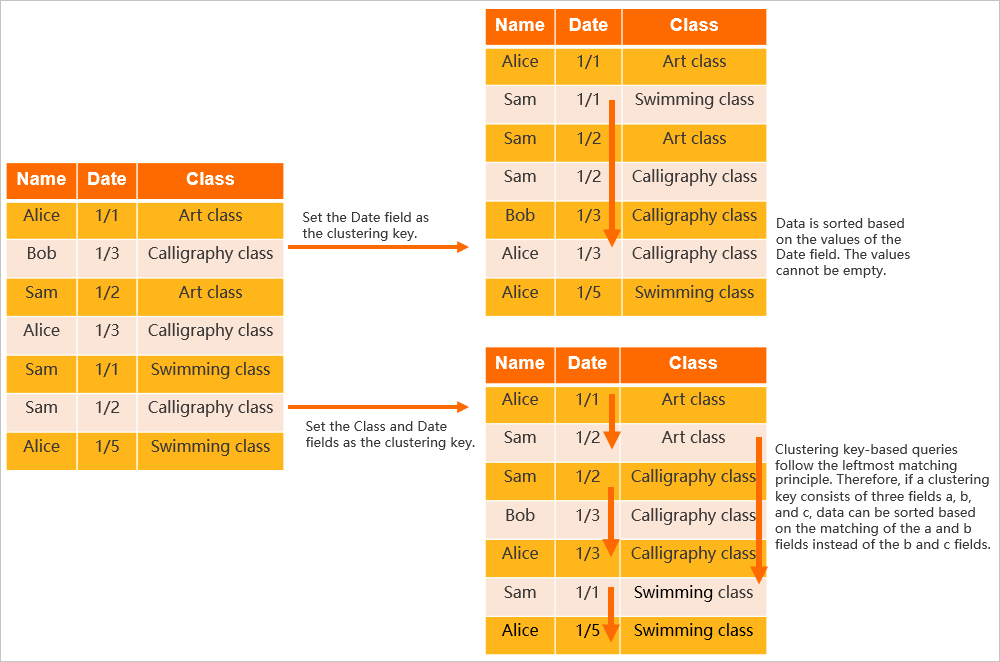
-
Fiziksel depolama düzeni
Kümeleme anahtarının fiziksel depolama düzeni, ilişkili verileri birlikte gruplandırır.
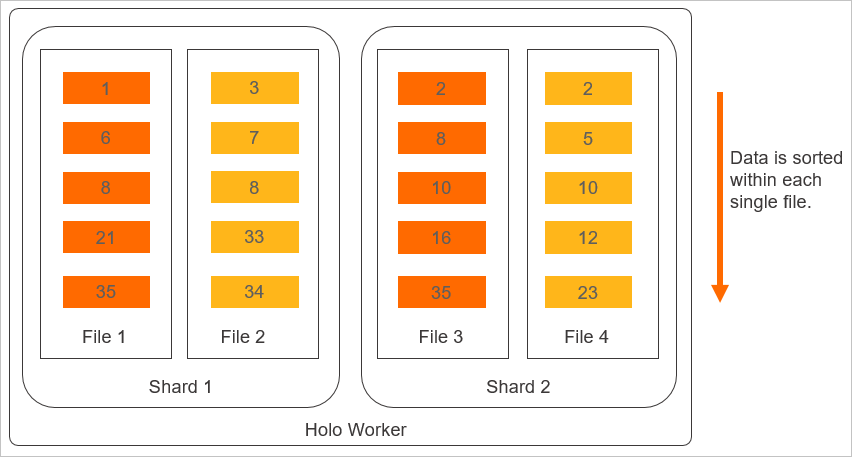
Bu düzen ilkelerinin şu sonuçları vardır:
Kümeleme anahtarı, aralık filtreleri için oldukça uygundur. Örneğin,
WHERE date = '1/1'veyaWHERE a > '1/1' AND a < '1/5'gibi koşullara sahip sorgular önemli ölçüde hızlanır.Sorgular en soldan eşleşme ilkesini takip eder. Örneğin, bir kümeleme anahtarı (
a,b,c) sütunlarında tanımlanırsa, sorgu (a,b,c) veya (a,b) üzerinde filtreleme yapıyorsa hızlandırılabilir. Sorgu (a,c) üzerinde filtreleme yapıyorsa, yalnızcaaüzerindeki koşul kümeleme anahtarını kullanabilir. Sorgu (b,c) üzerinde filtreleme yapıyorsa, kümeleme anahtarını hiç kullanamaz.
Aşağıdaki örnekte, uid,class,date sütunları kümeleme anahtarını oluşturur.
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
CREATE TABLE clustering_test ( uid int NOT NULL, name text NOT NULL, class text NOT NULL, date text NOT NULL, PRIMARY KEY (uid) ) WITH ( clustering_key = 'uid,class,date' ); INSERT INTO clustering_test VALUES (1,'Alice','1','2022-10-19'), (2,'Bob','3','2022-10-19'), (3,'Sam','2','2022-10-20'), (4,'Joe','2','2022-10-20'), (5,'Sue','2','2022-10-18'), (6,'Ben','3','2022-10-17'), (7,'Tom','3','2022-10-20'); -
Tüm sürümler tarafından desteklenen sözdizimi:
BEGIN;
CREATE TABLE clustering_test (
  uid int NOT NULL,
  name text NOT NULL,
  class text NOT NULL,
  date text NOT NULL,
  PRIMARY KEY (uid)
);
CALL set_table_property('clustering_test', 'clustering_key', 'uid,class,date');
COMMIT;
INSERT INTO clustering_test VALUES
(1,'Alice','1','2022-10-19'),
(2,'Bob','3','2022-10-19'),
(3,'Sam','2','2022-10-20'),
(4,'Joe','2','2022-10-20'),
(5,'Sue','2','2022-10-18'),
(6,'Ben','3','2022-10-17'),
(7,'Tom','3','2022-10-20');
-
Yalnızca
uidsütununu sorgulamak kümeleme anahtarını isabet eder.SELECT * FROM clustering_test WHERE uid > '3';EXPLAIN deyimi ile yürütme planını incelediğinizde, bir
Cluster Filteroperatörü görürsünüz. Bu, iyileştiricinin sorguyu hızlandırmak için kümeleme anahtarını kullandığını gösterir.explain SELECT * FROM clustering_test WHERE uid > '3'; QUERY PLAN Gather (cost=0.00..1.10 rows=4 width=24) -> Exchange (Gather Exchange) (cost=0.00..1.10 rows=4 width=24) -> Decode (cost=0.00..1.10 rows=4 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=4 width=24) Cluster Filter: (uid > 3) Optimizer: HQO version 1.3.0 -
uid,classsütunlarını sorgulamak kümeleme anahtarını isabet eder.SELECT * FROM clustering_test WHERE uid = '3' AND class >'1' ;Yürütme planı, iyileştiricinin sorguyu hızlandırmak için kümeleme anahtarını kullandığını gösteren bir
Cluster Filteroperatörü içerir.explain SELECT * FROM clustering_test WHERE uid = '3' AND class >'1' ; QUERY PLAN Exchange (Gather Exchange) (cost=0.00..1.10 rows=1 width=24) -> Decode (cost=0.00..1.10 rows=1 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=1 width=24) Cluster Filter: ((uid = 3) AND (class > '1'::text)) Shard Selector(Eagerly): ->: l0 [3] Optimizer: HQO version 1.3.0 -
uid,class,datesütunlarını sorgulamak kümeleme anahtarını isabet eder.SELECT * FROM clustering_test WHERE uid = '3' AND class ='2' AND date > '2022-10-17';Yürütme planını incelediğinizde, kümeleme anahtarının isabet ettiğini ve sorgunun hızlandırıldığını gösteren bir
Cluster Filteroperatörü görebilirsiniz. Yürütme planı sonucu,Index Scan using holo_index:[1] on clustering_testkullanıldığını veCluster Filterkoşulunun((uid = 3) AND (class = '2'::text) AND (date > '2022-10-17'::text))olduğunu gösterir. Bu, kümeleme anahtarının doğru şekilde kullanıldığını doğrular. -
uid,datesütunlarını sorgulamak en soldan eşleşme ilkesini takip etmez. Bu nedenle, yalnızcauidKümeleme Anahtarını isabet edebilir vedatenormal bir filtre kullanılarak işlenir.SELECT * FROM clustering_test WHERE uid = '3' AND date > '2022-10-17';Yürütme planını (EXPLAIN SQL) görüntülediğinizde, aşağıda gösterilen planda yalnızca
uidsütunununCluster Filteroperatörüne sahip olduğunu görebilirsiniz.explain SELECT * FROM clustering_test WHERE uid = '3' AND date > '2022-10-17'; QUERY PLAN Exchange (Gather Exchange) (cost=0.00..1.10 rows=1 width=24) -> Decode (cost=0.00..1.10 rows=1 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=1 width=24) Filter: (date > '2022-10-17'::text) Cluster Filter: (uid = 3) Shard Selector(Eagerly): ->: I0 [3] Optimizer: HQO version 1.3.0 -
Yalnızca
class,datesütunlarını sorgulamak en soldan eşleşme ilkesini takip etmez. Sorgu kümeleme anahtarından yararlanamaz.SELECT * FROM clustering_test WHERE class ='2' AND date > '2022-10-17';Yürütme planında (
Cluster Filterçıktısında)Cluster Filteroperatörünün bulunmaması, Kümeleme Anahtarının kullanılmadığını gösterir.EXPLAINçalıştırdıktan sonra, sorgu planıdatesütununun birFilterveclasssütununun birBitmap Filterkullandığı birIndex Scangösterir; bunların hiçbiri Kümeleme Anahtarı tarafından hızlandırılmaz.
Örnekler
Örnek 1: Bir sorgunun kümeleme anahtarını isabet edebileceği senaryolar.
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
CREATE TABLE table1 ( col1 int NOT NULL, col2 text NOT NULL, col3 text NOT NULL, col4 text NOT NULL ) WITH ( clustering_key = 'col1,col2' ); -- For the table created above, the following queries can be accelerated. -- This query can be accelerated. select * from table1 where col1='abc'; -- This query can be accelerated. select * from table1 where col1>'xxx' and col1<'abc'; -- This query can be accelerated. select * from table1 where col1 in ('abc','def'); -- This query can be accelerated. select * from table1 where col1='abc' and col2='def'; -- This query cannot be accelerated. select col1,col4 from table1 where col2='def'; -
Tüm sürümler tarafından desteklenen sözdizimi:
begin;
create table table1 (
  col1 int not null,
  col2 text not null,
  col3 text not null,
  col4 text not null
);
call set_table_property('table1', 'clustering_key', 'col1,col2');
commit;
-- For the table created above, the following queries can be accelerated.
-- This query can be accelerated.
select * from table1 where col1='abc';
-- This query can be accelerated.
select * from table1 where col1>'xxx' and col1<'abc';
-- This query can be accelerated.
select * from table1 where col1 in ('abc','def');
-- This query can be accelerated.
select * from table1 where col1='abc' and col2='def';
-- This query cannot be accelerated.
select col1,col4 from table1 where col2='def';
Örnek 2: Kümeleme Anahtarı asc/desc olarak ayarlanır.
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a:desc,b:asc' ); -
Tüm sürümler tarafından desteklenen sözdizimi:
BEGIN;
CREATE TABLE tbl (
  a int NOT NULL,
  b text NOT NULL
);
CALL set_table_property('tbl', 'clustering_key', 'a:desc,b:asc');
COMMIT;
Gelişmiş ayarlama
MySQL veya SQL Server gibi geleneksel veritabanlardaki kümeleme anahtarının aksine, Hologres'te sıralama yalnızca dosyalar içinde gerçekleştirilir, tüm tablo genelinde değil. Bu nedenle, Kümeleme Anahtarı üzerinde bir ORDER BY işlemi gerçekleştirmek hala bir performans maliyeti taşır.
V1.3 sürümünden itibaren Hologres, kümeleme anahtarı kullanım durumları için önemli performans optimizasyonları sunmuştur. Bu optimizasyonlar aşağıdaki iki senaryoda daha iyi performans sağlar. Hologres örneğiniz 1.3'ten önceki bir sürümdeyse, bkz. Sorun giderme: Yükseltme hazırlık hataları veya Çevrimiçi destek nasıl alınır? bölümündeki talimatları izleyerek bizimle iletişime geçin.
-
Kümeleme anahtarlarında ORDER BY kullanma
Hologres'te, bir dosya içindeki veriler tanımlanan kümeleme anahtarlarına göre sıralanır. V1.3'ten önceki sürümlerde, iyileştirici optimal bir yürütme planı oluşturmak için kümeleme anahtarlarının sıralı özelliğini kullanamıyordu. Ayrıca, çok yönlü birleştirme nedeniyle karıştırma düğümünden geçtikten sonra veri sırası garanti edilemiyordu. Bu durum genellikle daha yüksek hesaplama yüküne ve daha uzun sorgu sürelerine yol açardı. Hologres V1.3 bu süreci optimize eder. İyileştirici artık kümeleme anahtarlarının sıralı özelliğini kullanan ve karıştırmalar arasında veri sırasını koruyan bir yürütme planı oluşturabilir; bu da sorgu performansını artırır. Ancak aşağıdaki hususlara dikkat edin:
Bir sorgu bir tablonun kümeleme anahtarlarında filtreleme yapmazsa, varsayılan olarak IndexScan yerine SeqScan kullanılır. Sıralı özelliği yalnızca IndexScan kullanır.
İyileştirici, her zaman kümeleme anahtarının sıralama düzenine dayalı bir yürütme planı seçmez çünkü bu yaklaşımın bazı ek yükleri vardır. Örneğin, dosyalar içinde sıralanmış veriler yine de bellekte ek sıralama gerektirebilir.
Örnek:
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys;
CREATE TABLE test_use_sort_info_of_clustering_keys (
    a int NOT NULL,
    b int NOT NULL,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys SELECT i%500, i%100, i::text FROM generate_series(1, 1000) as s(i);
ANALYZE test_use_sort_info_of_clustering_keys;
Tüm sürümler tarafından desteklenen sözdizimi:
DROP TABLE if exists test_use_sort_info_of_clustering_keys; BEGIN; CREATE TABLE test_use_sort_info_of_clustering_keys ( a int NOT NULL, b int NOT NULL, c text ); CALL set_table_property('test_use_sort_info_of_clustering_keys', 'distribution_key', 'a'); CALL set_table_property('test_use_sort_info_of_clustering_keys', 'clustering_key', 'a,b'); COMMIT; INSERT INTO test_use_sort_info_of_clustering_keys SELECT i%500, i%100, i::text FROM generate_series(1, 1000) as s(i); ANALYZE test_use_sort_info_of_clustering_keys; -
Sorgu deyimi:
explain select * from test_use_sort_info_of_clustering_keys where a > 100 order by a, b; -
Yürütme planı karşılaştırması
-
Aşağıdaki kod, V1.1 gibi V1.3'ten önceki bir sürümdeki yürütme planını gösterir. Planı
EXPLAINdeyimi çalıştırarak görüntüleyebilirsiniz.Sort (cost=0.00..0.00 rows=797 width=11) -> Gather (cost=0.00..2.48 rows=797 width=11) Sort Key: a, b -> Sort (cost=0.00..2.44 rows=797 width=11) Sort Key: a, b -> Exchange (Gather Exchange) (cost=0.00..1.11 rows=797 width=11) -> Decode (cost=0.00..1.11 rows=797 width=11) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys (cost=0.00..1.00 rows=797 width=11) Cluster Filter: (a > 100) -
Aşağıdaki kod, Hologres V1.3'teki yürütme planını gösterir.
 Gather  (cost=0.00..1.15 rows=797 width=11)
   Merge Key: a, b
   ->  Exchange (Gather Exchange)  (cost=0.00..1.11 rows=797 width=11)
         Merge Key: a, b
         ->  Decode  (cost=0.00..1.11 rows=797 width=11)
               ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys  (cost=0.00..1.01 rows=797 width=11)
                     Order by: a, b
                     Cluster Filter: (a > 100)
V1.3 için yürütme planı daha verimlidir. Çıktıyı doğrudan birleştirmek için kümeleme anahtarının sıralı özelliğini kullanır. Bu, boru hattı tabanlı bir yürütme oluşturur ve büyük veri kümeleriyle çalışırken yavaş sıralama işlemlerini önler. Karşılaştırmada gösterildiği gibi, V1.3 planı
Sortoperatörünü daha verimli bir birleştirme tabanlı işlemi gösterenMerge Keyile değiştirir. -
-
Kümeleme anahtarlarında JOIN kullanma (Beta)
Hologres V1.3, iyileştiricinin kümeleme anahtarlarının sıralı yapısından yararlanmasına, hesaplama yükünü azaltmasına ve performansı artırmasına olanak tanıyan
Merge Joinoperatörünü tanıttı. Ancak aşağıdaki hususlara dikkat edin:-
Bu özellik beta aşamasındadır ve varsayılan olarak devre dışıdır. Kullanmak için, sorgunuzu yürütmeden önce aşağıdaki parametreyi etkinleştirmeniz gerekir.
-- Enable merge join
set hg_experimental_enable_sort_merge_join=on;
Bir sorgu bir tablonun kümeleme anahtarlarında filtreleme yapmazsa, varsayılan olarak IndexScan yerine SeqScan kullanılır. Sıralı özelliği yalnızca IndexScan kullanır.
İyileştirici, her zaman kümeleme anahtarlarının sıralı düzenine dayalı bir yürütme planı oluşturmaz çünkü bu özelliği kullanmanın bazı maliyetleri vardır. Örneğin, dosyalar içinde sıralanmış veriler yine de bellekte ek sıralama gerektirebilir.
Örnek:
-
Hologres V2.1 ve sonraki sürümler tarafından desteklenen sözdizimi:
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys1;
CREATE TABLE test_use_sort_info_of_clustering_keys1 (
    a int,
    b int,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys1 SELECT i % 500, i % 100, i::text FROM generate_series(1, 10000) AS s(i);
ANALYZE test_use_sort_info_of_clustering_keys1;
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys2;
CREATE TABLE test_use_sort_info_of_clustering_keys2 (
    a int,
    b int,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys2 SELECT i % 600, i % 200, i::text FROM generate_series(1, 10000) AS s(i);
ANALYZE test_use_sort_info_of_clustering_keys2;
Tüm sürümler tarafından desteklenen sözdizimi:
drop table if exists test_use_sort_info_of_clustering_keys1; begin; create table test_use_sort_info_of_clustering_keys1 ( a int, b int, c text ); call set_table_property('test_use_sort_info_of_clustering_keys1', 'distribution_key', 'a'); call set_table_property('test_use_sort_info_of_clustering_keys1', 'clustering_key', 'a,b'); commit; insert into test_use_sort_info_of_clustering_keys1 select i%500, i%100, i::text from generate_series(1, 10000) as s(i); analyze test_use_sort_info_of_clustering_keys1; drop table if exists test_use_sort_info_of_clustering_keys2; begin; create table test_use_sort_info_of_clustering_keys2 ( a int, b int, c text ); call set_table_property('test_use_sort_info_of_clustering_keys2', 'distribution_key', 'a'); call set_table_property('test_use_sort_info_of_clustering_keys2', 'clustering_key', 'a,b'); commit; insert into test_use_sort_info_of_clustering_keys2 select i%600, i%200, i::text from generate_series(1, 10000) as s(i); analyze test_use_sort_info_of_clustering_keys2; -
Sorgu deyimi:
explain select * from test_use_sort_info_of_clustering_keys1 a join test_use_sort_info_of_clustering_keys2 b on a.a = b.a and a.b=b.b where a.a > 100 and b.a < 300; -
Yürütme planı karşılaştırması
-
Aşağıdaki kod, V1.1 gibi V1.3'ten önceki bir sürümdeki yürütme planını gösterir.
Gather (cost=0.00..3.09 rows=4762 width=24) -> Hash Join (cost=0.00..2.67 rows=4762 width=24) Hash Cond: ((test_use_sort_info_of_clustering_keys1.a = test_use_sort_info_of_clustering_keys2.a) AND (test_use_sort_info_of_clustering_keys1.b = test_use_sort_info_of_clustering_keys2.b)) -> Exchange (Gather Exchange) (cost=0.00..1.14 rows=3993 width=12) -> Decode (cost=0.00..1.14 rows=3993 width=12) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys1 (cost=0.00..1.01 rows=3993 width=12) Cluster Filter: ((a > 100) AND (a < 300)) -> Hash (cost=1.13..1.13 rows=3386 width=12) -> Exchange (Gather Exchange) (cost=0.00..1.13 rows=3386 width=12) -> Decode (cost=0.00..1.13 rows=3386 width=12) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys2 (cost=0.00..1.01 rows=3386 width=12) Cluster Filter: ((a > 100) AND (a < 300)) -
Aşağıdaki kod, Hologres V1.3'teki yürütme planını gösterir.
  Gather  (cost=0.00..2.88 rows=4762 width=24)
   ->  Merge Join  (cost=0.00..2.46 rows=4762 width=24)
         Merge Cond: ((test_use_sort_info_of_clustering_keys2.a = test_use_sort_info_of_clustering_keys1.a) AND (test_use_sort_info_of_clustering_keys2.b = test_use_sort_info_of_clustering_keys1.b))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3386 width=12)
               Merge Key: test_use_sort_info_of_clustering_keys2.a, test_use_sort_info_of_clustering_keys2.b
               ->  Decode  (cost=0.00..1.14 rows=3386 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys2  (cost=0.00..1.01 rows=3386 width=12)
                           Order by: test_use_sort_info_of_clustering_keys2.a, test_use_sort_info_of_clustering_keys2.b
                           Cluster Filter: ((a > 100) AND (a < 300))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3993 width=12)
               Merge Key: test_use_sort_info_of_clustering_keys1.a, test_use_sort_info_of_clustering_keys1.b
               ->  Decode  (cost=0.00..1.14 rows=3993 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys1  (cost=0.00..1.01 rows=3993 width=12)
                           Order by: test_use_sort_info_of_clustering_keys1.a, test_use_sort_info_of_clustering_keys1.b
                           Cluster Filter: ((a > 100) AND (a < 300))
V1.3 planı, kümeleme anahtarının sıralı yapısından yararlanarak bir
Merge Joinkullanır. Birleştirmeden önce her parça içinde bir sıralama-birleştirme işlemi gerçekleştirerek verimli bir boru hattı oluşturur. Bu yaklaşım, birleştirme tarafının belleğe sığmayacak kadar büyük olması durumundaHash Joinile ortaya çıkabilecek yetersiz bellek (OOM) hatalarını önler. -
-
İlgili belgeler
Hologres dahili tabloları için Veri Tanımlama Dili (DDL) deyimleri hakkında daha fazla bilgi için aşağıdaki konulara bakın: