O EAS (Elastic Algorithm Service) permite implantar modelos treinados como serviço de inferência online ou aplicação web de IA. O EAS oferece suporte a recursos heterogêneos e combina funcionalidades como dimensionamento automático, teste de estresse com um clique, canary release e monitoramento em tempo real para garantir a estabilidade do serviço em cenários de alta concorrência com menor custo.
Arquitetura do produto
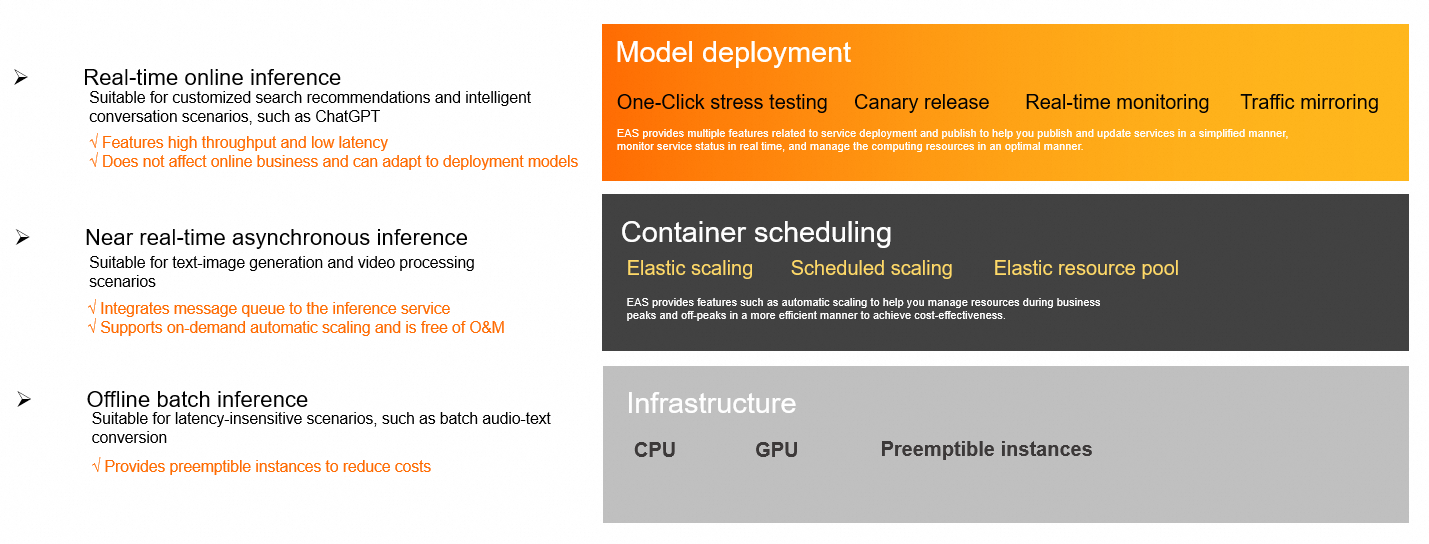
Principais capacidades
O EAS abrange todo o fluxo de trabalho, desde o gerenciamento de recursos e a implantação de modelos até a operação e manutenção do serviço.
Gerenciamento flexível de recursos e custos
Suporte a hardware heterogêneo: Compatível com CPUs, GPUs e instâncias especializadas de aceleração de IA para atender às necessidades de desempenho de diferentes modelos.
Otimização de custos: Permite usar instâncias preemptíveis para reduzir significativamente os gastos computacionais. Com o dimensionamento agendado, defina políticas baseadas nos ciclos de negócio para controlar a alocação de recursos com precisão.
Pool de recursos elástico: Quando um grupo de recursos dedicados atinge sua capacidade máxima, o EAS agenda automaticamente novas instâncias no grupo de recursos públicos, equilibrando controle de custos e estabilidade do serviço.
Estabilidade e alta disponibilidade
Dimensionamento elástico: Ajusta automaticamente o número de réplicas do serviço com base na carga de trabalho em tempo real. Gerencia picos de tráfego imprevisíveis e evita subutilização de recursos ou sobrecarga do serviço.
Mecanismo de alta disponibilidade: A recuperação automática de falhas garante a continuidade do serviço. Os recursos dedicados possuem isolamento físico, eliminando o risco de preempção de recursos.
Releases seguros: Oferece suporte a canary release, permitindo direcionar uma porcentagem do tráfego para uma nova versão visando validação. Também disponibiliza espelhamento de tráfego, que copia o tráfego de produção para um serviço de teste e verifica a confiabilidade sem afetar as requisições reais dos usuários.
Implantação e O&M eficientes
Teste de estresse com um clique: Aumenta dinamicamente a carga para sondar os limites de desempenho do serviço. Visualize dados de monitoramento por segundo e relatórios de teste de estresse em tempo real para avaliar rapidamente as capacidades do serviço.
Monitoramento em tempo real: Fornece monitoramento em tempo real de métricas essenciais como QPS, tempo de resposta e utilização da CPU. Ative também alertas de monitoramento de serviço para manter-se informado sobre a integridade do sistema.
Múltiplos métodos de implantação: Implante serviços utilizando uma imagem de runtime (recomendado) ou uma implantação de processador, adequando-se a diferentes pilhas tecnológicas.
Diversos modos de inferência
Inferência síncrona em tempo real: Apresenta alto throughput e baixa latência, sendo adequada para cenários sensíveis à latência, como recomendações de busca e bots de conversação.
Inferência assíncrona quase em tempo real: Inclui uma fila de mensagens integrada, ideal para tarefas de longa duração, como geração de texto para imagem e processamento de vídeo. Suporta dimensionamento automático baseado no acúmulo da fila para evitar congestionamento de requisições.
Inferência em lote offline: Indicada para cenários de processamento em lote não sensíveis ao tempo de resposta, como conversão em massa de dados de voz. Também aceita instâncias preemptíveis para redução de custos.
Procedimento
Etapa 1: Preparar recursos e arquivos
-
Prepare os recursos de inferência: Selecione um tipo de recurso EAS adequado com base no tamanho do modelo, nas necessidades de concorrência e no orçamento. Para obter orientações sobre seleção e compra de recursos, consulte Visão geral dos recursos de implantação do EAS.
NotaUse recursos públicos diretamente sem comprá-los antecipadamente. Outros tipos de recursos, como grupos de recursos EAS e cotas de recursos, devem ser adquiridos antes do uso.
Prepare os arquivos: Carregue seu modelo treinado, código de processamento e dependências em um serviço de armazenamento em nuvem, como o Object Storage Service (OSS). Em seguida, acesse esses arquivos a partir do serviço usando a montagem de armazenamento.
Etapa 2: Implantar o serviço
Implante e gerencie serviços usando o console, a ferramenta de linha de comando EASCMD ou um SDK. Para mais informações, consulte Implantação de serviço.
Console: Oferece opções fáceis de usar de Custom Deployment e implantação baseada em cenários, ideais para iniciantes. Para modelos sem solução de implantação predefinida no EAS, como modelos de terceiros (ex: MinerU), crie um serviço usando o recurso Custom Deployment. Prepare o modelo e os arquivos de configuração e carregue-os em um serviço de armazenamento em nuvem como o OSS.
Ferramenta de linha de comando EASCMD: Suporta operações como criação, atualização e visualização de serviços. É adequada para desenvolvedores de algoritmos familiarizados com o EAS.
SDK: Ideal para agendamento unificado e O&M em grande escala.
Etapa 3: Invocar e testar o serviço sob estresse
Aplicação web: Se você implantar o serviço como uma aplicação web de IA, abra a página interativa diretamente no navegador para testá-lo.
Serviço de API: Utilize o recurso de depuração online para verificar a funcionalidade do serviço ou chame a API de forma síncrona ou assíncrona. Para mais informações, consulte Invocação de serviço.
Teste de estresse de serviço: Use a ferramenta integrada de teste de estresse com um clique para avaliar o desempenho do serviço sob pressão. Para mais informações, consulte Teste de estresse de serviço.
Etapa 4: Monitorar e gerenciar o serviço
Monitoramento e alertas: Na lista de Serviços de Inferência, visualize o status de execução e as informações do grupo de recursos dos seus serviços, filtrando-os por grupo de recursos. Recomendamos ativar alertas de monitoramento de serviço para acompanhar a integridade do serviço em tempo real.
Dimensionamento elástico: Configure políticas de dimensionamento elástico ou dimensionamento agendado conforme seus requisitos de negócio para gerenciar dinamicamente os recursos computacionais.
-
Atualizações de serviço: Na coluna Actions, clique em Update para implantar uma nova versão. Após concluir a atualização, visualize as informações da versão ou alterne entre versões.
AvisoAs atualizações de serviço causam uma interrupção temporária, o que pode levar à falha de requisições dependentes. Prossiga com cautela.
Migração de serviço: Para migrar uma configuração de serviço EAS entre regiões, use a ferramenta de linha de comando EASCMD para exportar a configuração do serviço da região de source. Em seguida, utilize a configuração exportada para criar um novo serviço na região de destino.
Observações importantes
Se um serviço EAS permanecer em um estado diferente de Running por 180 dias consecutivos, o sistema o excluirá automaticamente.
O EAS está disponível nas regiões listadas em Regiões e zonas de disponibilidade.
Faturamento
Para mais informações, consulte Faturamento do Elastic Algorithm Service (EAS).
Início rápido
Consulte Início rápido para Elastic Algorithm Service (EAS).
Casos de uso
LLM: Implantar um modelo de linguagem grande (LLM) | Implantar um modelo Mixture-of-Experts (MoE) usando paralelismo de especialistas e separação de paralelismo de pipeline-dados
AIGC: Geração de vídeo por IA - Implantar ComfyUI | Geração de arte por IA - Implantar SD-WebUI
Outros: Acessar um gateway dedicado totalmente gerenciado entre VPCs | Melhores práticas para PAI-EAS Spot
FAQ
P: Recursos dedicados vs. recursos públicos?
Recursos públicos: Adequados para desenvolvimento, testes ou aplicações de pequena escala sensíveis a custos, que toleram flutuações de desempenho. Possuem baixo custo, mas podem sofrer contenção de recursos durante horários de pico.
Recursos dedicados: Ideais para ambientes de produção que exigem alta estabilidade e desempenho. Possuem isolamento físico, eliminando o risco de preempção de recursos. O recurso de pool de recursos elástico permite que as cargas de trabalho transbordem para recursos públicos quando a capacidade dedicada se esgota, equilibrando custo e estabilidade durante picos. Para reservar tipos de instância com estoque limitado, adquira-os como recursos dedicados.
P: EAS vs. serviços autogerenciados
O EAS fornece O&M gerenciado. Ele lida automaticamente com agendamento de recursos, recuperação de falhas e monitoramento, além de incluir funcionalidades integradas como dimensionamento elástico e canary release. Isso libera os desenvolvedores para focarem no desenvolvimento de modelos, reduzindo a sobrecarga operacional e acelerando o tempo de lançamento no mercado.
Referências
Documentação da API: Visão geral da API
FAQ: FAQ sobre o EAS