Este tópico apresenta os principais índices do Hologres, como a chave de distribuição, a coluna de tempo de evento (segment key) e a clustering key. O objetivo é orientar você no uso de índices para melhorar o desempenho das consultas durante o desenvolvimento no Hologres.
Como o Hologres funciona
O Hologres é um data warehouse distribuído que utiliza computação paralela e vetorial para fornecer respostas de consulta em segundos. Devido a essa arquitetura, a distribuição de dados é fundamental para o desempenho. Isso inclui o balanceamento de dados entre os nós distribuídos, regido pela distribution key, e a ordenação dos dados dentro dos arquivos em um único nó, regida pela event time column (também conhecida como segment key). Por padrão, o Hologres usa armazenamento colunar em cenários de processamento analítico online (OLAP). Nesse contexto, a ordem dos dados dentro de um arquivo também é essencial e segue a clustering key. Dominar esses três conceitos é fundamental para otimizar o desempenho. Como essas propriedades de layout são definidas na gravação e têm alto custo de alteração, recomendamos projetar as tabelas com esses três atributos desde o início. Atributos que não afetam diretamente o layout dos dados, como bitmap indexes e dictionary encoding, podem ser ajustados posteriormente conforme necessário.
O Hologres utiliza uma estrutura de metadados de três níveis: Database > Schema > Table. Para evitar consultas entre bancos de dados, agrupe tabelas logicamente relacionadas no mesmo schema. Um database é uma unidade básica para isolamento de metadados, não de recursos.
Fundamentos de otimização de SQL
Projetar tabelas com uma estratégia adequada de distribuição de dados permite que as consultas SQL localizem rapidamente as informações necessárias. Essa prática reduz a E/S, consome menos recursos de computação e proporciona maior desempenho nas consultas. Uma distribuição equilibrada também garante o uso eficiente de recursos concorrentes e evita gargalos em pontos únicos. O diagrama a seguir ilustra como uma consulta SQL recupera dados e reduz a E/S.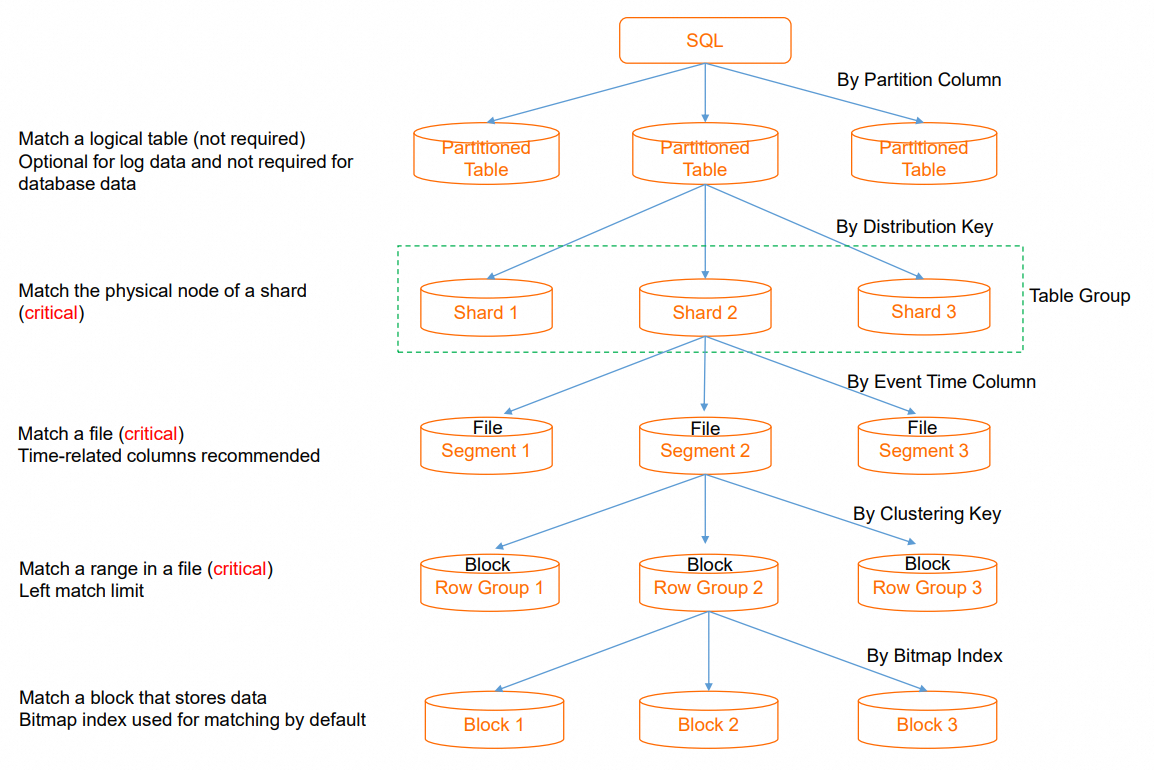
Poda de partição: ao consultar uma tabela particionada, o otimizador usa a poda de partição para localizar as partições relevantes. Se as condições de filtro não incluírem a chave de partição, a consulta precisará verificar todas as partições, causando E/S excessiva. Como regra geral, o particionamento por dia é uma boa prática. Tabelas não particionadas ignoram a poda de partição.
Poda de shard: utilize a chave de distribuição para localizar rapidamente o shard que contém os dados necessários. Isso reduz o consumo de recursos em consultas individuais e aumenta o throughput em consultas concorrentes. Caso não seja possível localizar um shard específico, o framework distribuído agenda todos os shards para participar da computação. Embora isso aumente o paralelismo da consulta individual, consome mais recursos e diminui a concorrência geral. Operadores que exigem execução centralizada também podem gerar sobrecarga extra de shuffle. Como melhor prática, escolha colunas com distribuição uniforme de dados (como IDs de pedidos, usuários ou eventos) como chave de distribuição. Se várias tabelas unidas compartilharem a mesma chave de distribuição, os dados relacionados ficarão no mesmo shard, permitindo operações de junção local eficientes.
Poda de segment key: use a segment key (coluna de tempo de evento) para localizar rapidamente o arquivo de dados específico dentro de um nó e evitar o acesso a arquivos desnecessários. Sem filtragem nesse nível, todos os arquivos precisarão ser verificados.
Poda de clustering key: empregue a clustering key para localizar rapidamente segmentos de dados dentro de um único arquivo. Esse recurso melhora a eficiência de consultas de intervalo e a ordenação de colunas.
Otimização de SQL na prática
Esta seção utiliza consultas TPC-H para demonstrar como configurar índices do Hologres visando melhor desempenho. Para obter mais informações sobre o TPC-H, consulte Test plan overview.
Referência de SQL TPC-H
Consulta TPC-H Q1
A consulta TPC-H Q1 realiza agregações e filtragens em colunas específicas da tabela lineitem. Ela inclui a seguinte condição:
l_shipdate <=: esta é uma condição de filtro. Para permitir filtragem de intervalo eficiente e recuperar rapidamente os dados necessários, defina um índice apropriado.
--TPC-H Q1
SELECT
        l_returnflag,
        l_linestatus,
        SUM(l_quantity) AS sum_qty,
        SUM(l_extendedprice) AS sum_base_price,
        SUM(l_extendedprice * (1 - l_discount)) AS sum_disc_price,
        SUM(l_extendedprice * (1 - l_discount) * (1 + l_tax)) AS sum_charge,
        AVG(l_quantity) AS avg_qty,
        AVG(l_extendedprice) AS avg_price,
        AVG(l_discount) AS avg_disc,
        COUNT(*) AS count_order
FROM
        lineitem
WHERE
        l_shipdate <= DATE '1998-12-01' - INTERVAL '120' DAY
GROUP BY
        l_returnflag,
        l_linestatus
ORDER BY
        l_returnflag,
        l_linestatus;
Consulta TPC-H Q4
A consulta TPC-H Q4 une principalmente as tabelas lineitem e orders. Ela inclui as seguintes condições:
o_orderdate >= DATE '1996-07-01': esta é uma condição de filtro. Para permitir filtragem de intervalo eficiente e recuperar rapidamente os dados necessários, defina um índice apropriado.-
l_orderkey = o_orderkey: esta é uma condição de junção entre as duas tabelas. Para obter o melhor desempenho, use o mesmo índice em ambas as tabelas para habilitar uma junção local e reduzir o embaralhamento de dados durante a operação.--TPC-H Q4 Query SELECT o_orderpriority, COUNT(*) AS order_count FROM orders WHERE o_orderdate >= DATE '1996-07-01' AND o_orderdate < DATE '1996-07-01' + INTERVAL '3' MONTH AND EXISTS ( SELECT * FROM lineitem WHERE l_orderkey = o_orderkey AND l_commitdate < l_receiptdate ) GROUP BY o_orderpriority ORDER BY o_orderpriority;
Recomendações para criação de tabelas
As consultas Q1 e Q4 envolvem as tabelas lineitem e orders.
hologres_dataset_tpch_100g.lineitem
Tanto a consulta Q1 quanto a Q4 usam a tabela lineitem, mas com colunas e condições diferentes.
Para a consulta Q1: a consulta utiliza principalmente
l_shipdatepara filtragem de intervalo. A clustering key acelera as varreduras de intervalo ao aproveitar a ordem classificada dos dados nos arquivos. **Portanto, definal_shipdatecomo a clustering key. A segment key (coluna de tempo de evento) mantém a ordem entre os arquivos. Em colunas de data monotonicamente crescentes ou decrescentes, definir esse campo como segment key permite uma poda eficaz. Assim, você também pode definirl_shipdatecomo a segment key.**Para a consulta Q4: a consulta une a tabela
lineitemà tabelaorderspelas colunasl_orderkeyeo_orderkey. A chave de distribuição define a estratégia de distribuição de dados. O sistema coloca dados com o mesmo valor de chave no mesmo shard. Se duas tabelas estiverem no mesmo grupo de tabelas e forem unidas pelas colunas de chave de distribuição, o sistema distribuirá automaticamente os registros correspondentes para o mesmo shard durante a gravação. Na junção dessas tabelas, o sistema executa uma junção local em cada nó sem embaralhar dados pela rede. Isso evita o embaralhamento e a redistribuição de dados em tempo de execução, melhorando significativamente a eficiência. **Portanto, definal_orderkeycomo a chave de distribuição.**-
A estrutura final da tabela
lineitemé a seguinte:BEGIN; CREATE TABLE hologres_dataset_tpch_100g.lineitem ( l_ORDERKEY BIGINT NOT NULL, L_PARTKEY INT NOT NULL, L_SUPPKEY INT NOT NULL, L_LINENUMBER INT NOT NULL, L_QUANTITY DECIMAL(15,2) NOT NULL, L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL, L_DISCOUNT DECIMAL(15,2) NOT NULL, L_TAX DECIMAL(15,2) NOT NULL, L_RETURNFLAG TEXT NOT NULL, L_LINESTATUS TEXT NOT NULL, L_SHIPDATE TIMESTAMPTZ NOT NULL, L_COMMITDATE TIMESTAMPTZ NOT NULL, L_RECEIPTDATE TIMESTAMPTZ NOT NULL, L_SHIPINSTRUCT TEXT NOT NULL, L_SHIPMODE TEXT NOT NULL, L_COMMENT TEXT NOT NULL, PRIMARY KEY (L_ORDERKEY,L_LINENUMBER) ) WITH ( distribution_key = 'L_ORDERKEY',--Enables local join. clustering_key = 'L_SHIPDATE',--Accelerates range filtering. event_time_column = 'L_SHIPDATE'--Accelerates segment key pruning. ); COMMIT;
hologres_dataset_tpch_100g.orders
Neste exemplo, a tabela orders é usada na consulta Q4.
Defina a coluna
o_orderkeyda tabelaorderscomo chave de distribuição para aproveitar os recursos de junção local e melhorar a eficiência das consultas de junção.A coluna
o_orderdateserve principalmente para filtragem de data. Defina-a como segment key para acelerar a poda da segment key.-
A estrutura final da tabela
ordersé a seguinte:BEGIN; CREATE TABLE hologres_dataset_tpch_100g.orders ( O_ORDERKEY BIGINT NOT NULL PRIMARY KEY, O_CUSTKEY INT NOT NULL, O_ORDERSTATUS TEXT NOT NULL, O_TOTALPRICE DECIMAL(15,2) NOT NULL, O_ORDERDATE timestamptz NOT NULL, O_ORDERPRIORITY TEXT NOT NULL, O_CLERK TEXT NOT NULL, O_SHIPPRIORITY INT NOT NULL, O_COMMENT TEXT NOT NULL ) WITH ( distribution_key = 'O_ORDERKEY',--Enables local join. event_time_column = 'O_ORDERDATE'--Accelerates segment key pruning. ); COMMIT;
Importar dados de amostra
Importe rapidamente 100 GB de dados TPC-H para sua instância do Hologres usando o recurso Import public datasets with a few clicks no HoloWeb. No HoloWeb, selecione Data Solutions na barra de navegação superior e clique em Import public datasets with a few clicks no painel de navegação à esquerda. Na página de configuração, selecione um Instance Name (por exemplo, holo_test) e um Database. Em seguida, selecione tpch_100g na lista Public Dataset Name. O sistema gera automaticamente um script SQL não editável na parte inferior da página. Esse script inclui instruções para criar os schemas hologres_foreign_dataset_tpch_100g e hologres_dataset_tpch_100g, além de importar sequencialmente dados para tabelas externas como customer, lineitem, nation, orders, part, partsupp, region e supplier.
Resultados do teste de desempenho
Esta seção compara o desempenho das consultas antes e depois da definição das propriedades recomendadas da tabela (índices).
-
Ambiente de teste
Especificação da instância: 32 núcleos
Tipo de rede: VPC
Execute cada consulta duas vezes usando um cliente PSQL e registre a latência da segunda execução.
-
Conclusão
Em consultas filtradas de tabela única, definir a coluna de filtro como clustering key acelera efetivamente a consulta.
Em consultas de junção de múltiplas tabelas, definir as colunas de junção como chave de distribuição melhora significativamente a eficiência da junção.
Consulta
Latência com índices
Latência sem índices
Q1
48.293 ms
59.483 ms
Q4
822.389 ms
3.027,957 ms
Referências
Mais informações
Princípios técnicos
Aprofunde-se nos princípios técnicos fundamentais do Hologres (arquitetura, mecanismo de armazenamento e mecanismo de computação): Tecnologia Central do Data Warehouse de Dados em Tempo Real Nativo da Nuvem da Alibaba Cloud.
Ativação do service
Escolha de especificações: Instance management.
Autorização de usuário RAM: Quick start for RAM user authorization.
Importação de dados
Gravações em tempo real e consultas de tabela de dimensões com Flink: Realtime Compute for Apache Flink.
Sincronização completa em tempo real de bancos de dados como MySQL, Oracle e PolarDB: Configure a MySQL data source.
Importação de dados do OSS: Accelerate access to OSS data lakes by using DLF.
Use o Fixed Plan para aumentar em 10 vezes a eficiência de gravação e atualização de dados. Para mais informações, consulte Accelerate SQL execution by using Fixed Plan.
Consulta de dados
Recomendações de criação de tabelas para diferentes casos de uso: Scenario-based table tuning guide.
Antes de criar tabelas, entenda parâmetros essenciais como
distribution_key,clustering_key,event_time_columnebitmap_index. Usar sintaxe e índices adequados para definir uma estrutura de tabela ideal melhora significativamente o desempenho. Para mais informações, consulte CREATE TABLE.Ajuste de desempenho de tabela interna: Optimize query performance.
Aceleração do MaxCompute: Accelerate MaxCompute data queries by using foreign tables.
Operação e monitoramento
Consultas ativas (solucionar problemas de consultas em execução e verificar bloqueios existentes ou potenciais): Manage queries.
Consultas lentas (solucionar problemas de consultas com falha ou de longa duração): Get and analyze slow query logs.
Separação de leitura/gravação e isolamento de carga: Deploy read/write splitting for primary and secondary instances (shared storage).
Casos de uso e melhores práticas
Práticas e casos de uso: Melhores práticas e casos de uso clássicos de clientes para cenários típicos da indústria.