Este tópico descreve como usar uma chave de clustering no Hologres para ordenar dados e acelerar consultas.
Introdução
O Hologres ordena os dados dentro dos arquivos com base em uma chave de clustering. Isso pode acelerar consultas de intervalo e filtros nas colunas indexadas. Especifique a chave de clustering ao criar uma tabela com a seguinte sintaxe.
-- Syntax supported by Hologres V2.1 and later
CREATE TABLE <table_name> (...) WITH (clustering_key = '[<columnName>[,...]]');
-- Syntax supported by all versions
BEGIN;
CREATE TABLE <table_name> (...);
CALL set_table_property('<table_name>', 'clustering_key', '[<columnName>{:asc} [,...]]');
COMMIT;
Parâmetros:
|
Parâmetro |
Descrição |
|
table_name |
O nome da tabela na qual você deseja especificar uma chave de clustering. |
|
columnName |
O nome da coluna que você deseja especificar como a chave de clustering. |
Recomendações de uso
Uma chave de clustering é ideal para consultas pontuais e de intervalo. Ela melhora significativamente o desempenho de operações de filtro, como consultas com
WHERE a = 1ouWHERE a > 1 AND a < 5. Para obter o melhor desempenho em consultas pontuais, defina tanto uma chave de clustering quanto um índice de bitmap nas mesmas colunas.A chave de clustering segue o princípio de correspondência mais à esquerda. Portanto, recomendamos incluir no máximo duas colunas em uma chave de clustering para garantir que ela se aplique a uma ampla variedade de consultas. A ordem das colunas é importante: as colunas listadas primeiro têm prioridade de ordenação maior do que as listadas posteriormente.
-
Ao especificar um campo de Clustering Key, adicione
:ascapós o nome do campo para definir a ordem de classificação do índice. A ordem de classificação padrão éasc(crescente). As versões do Hologres anteriores à V2.1 não suportam a definição da ordem de classificação como decrescente (desc). Nessas versões, se a ordem de classificação fosse definida como decrescente, a Clustering Key não seria atingida, o que resultava em baixo desempenho da consulta. A partir da V2.1, defina a Clustering Key comodescapós ativar um parâmetro GUC específico. No entanto, esse recurso é suportado apenas para campos de tipos de dados como Text, Char, Varchar, Bytea e Int. A definição da Clustering Key comodescainda não é suportada para campos de outros tipos de dados.set hg_experimental_optimizer_enable_variable_length_desc_ck_filter = on; Para uma tabela orientada a linhas, a chave de clustering tem como padrão a chave primária. Nas versões anteriores ao Hologres V0.9, nenhuma chave de clustering era definida por padrão. Se você definir uma chave de clustering diferente da chave primária, o Hologres criará duas cópias ordenadas dos dados: uma para a chave primária e outra para a chave de clustering. Isso causa redundância de dados.
Limites
Para modificar uma chave de clustering, crie uma nova tabela e importe os dados.
-
As colunas especificadas em uma chave de clustering devem ser
NOT NULL. As versões do Hologres da V1.3.20 à V1.3.27 suportavam colunas anuláveis em uma chave de clustering, mas isso não é mais suportado a partir da V1.3.28. Uma chave de clustering anulável pode afetar a correção dos dados. Se o seu negócio exigir uma chave de clustering anulável, ative-a executando o seguinte comando antes da sua instrução SQL.set hg_experimental_enable_nullable_clustering_key = true; Colunas com os seguintes tipos de dados não podem ser usadas em uma chave de clustering: Float, Float4, Float8, Double, Decimal(Numeric), json, jsonb, Bit, Varbit, Money e Time With Time Zone, ou outros tipos de dados complexos.
-
Nas versões do Hologres anteriores à V2.1, não é possível definir a ordem de classificação de um índice como decrescente (
desc). Se a ordem de classificação for definida como decrescente, a chave de clustering não poderá ser atingida, o que resulta em baixo desempenho da consulta. A partir da V2.1, ative o seguinte GUC para definir a chave de clustering comodesc. No entanto, esse recurso é suportado apenas para campos de tipos de dados como Text, Char, Varchar, Bytea e Int. Não é possível definir a chave de clustering comodescpara campos de outros tipos de dados.set hg_experimental_optimizer_enable_variable_length_desc_ck_filter = on; Para uma tabela orientada a colunas, nenhuma chave de clustering é definida por padrão. Especifique explicitamente uma com base no seu caso de uso.
-
No Hologres, defina apenas uma chave de clustering para cada tabela. Isso significa que, ao criar uma tabela, execute o comando
callapenas uma vez, e não várias vezes. Por exemplo:-
Sintaxe suportada pelo Hologres V2.1 e posterior:
-- Correct usage CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a,b' ); -- Incorrect usage CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a', clustering_key = 'b' ); -
Sintaxe suportada por todas as versões:
-- Correct usage
BEGIN;
CREATE TABLE tbl (a int NOT NULL, b text NOT NULL);
CALL set_table_property('tbl', 'clustering_key', 'a,b');
COMMIT;
-- Incorrect usage
BEGIN;
CREATE TABLE tbl (a int NOT NULL, b text NOT NULL);
CALL set_table_property('tbl', 'clustering_key', 'a');
CALL set_table_property('tbl', 'clustering_key', 'b');
COMMIT;
-
Como funciona
Uma chave de clustering ordena fisicamente os dados dentro dos arquivos. Por padrão, o Hologres ordena os dados em ordem crescente (asc). As seções a seguir explicam os conceitos de layouts lógicos e físicos para uma chave de clustering.
-
Layout lógico
As consultas que usam uma chave de clustering seguem o princípio de correspondência mais à esquerda. Se as condições de filtro de uma consulta não corresponderem ao prefixo das colunas da chave de clustering, a chave de clustering não poderá acelerar a consulta. O exemplo a seguir ilustra o layout lógico de uma chave de clustering no Hologres.
Suponha que você tenha uma tabela com as colunas Name, Date e Class.
Se você definir a chave de clustering como (Date), o Hologres ordenará os dados na tabela pela coluna Date.
Se você definir a chave de clustering como (Class, Date), o Hologres ordenará os dados primeiro pela coluna Class e, em seguida, pela coluna Date dentro de cada classe.
A escolha das colunas da chave de clustering determina o layout final ordenado dos dados.
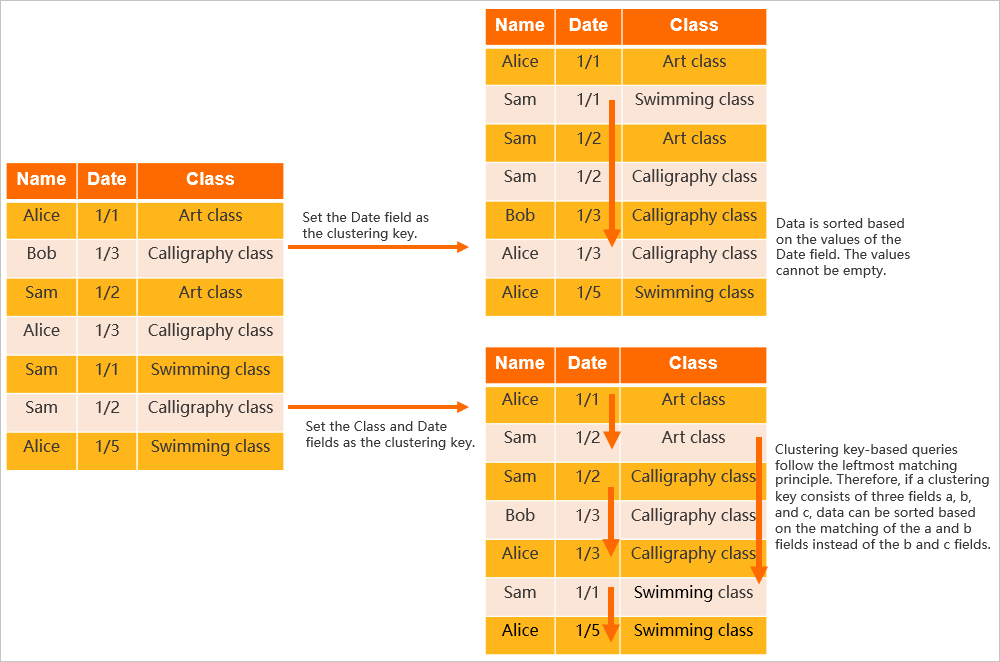
-
Layout de armazenamento físico
O layout de armazenamento físico de uma chave de clustering agrupa dados relacionados.
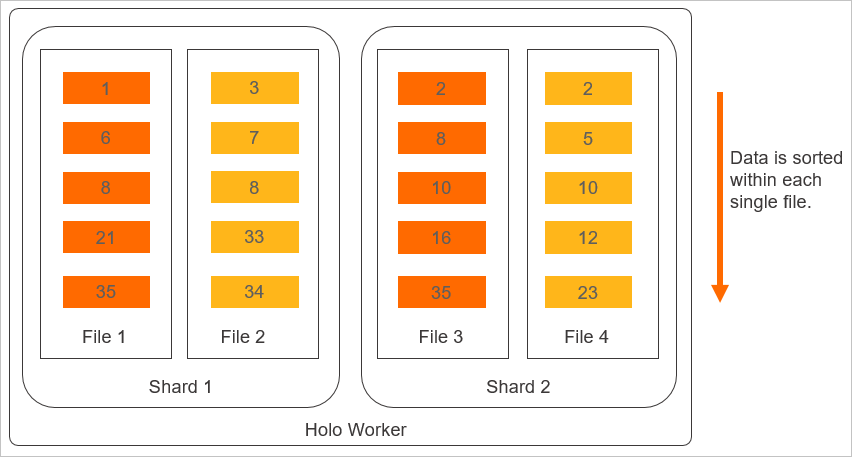
Esses princípios de layout têm as seguintes implicações:
A chave de clustering é muito adequada para filtros de intervalo. Por exemplo, consultas com condições como
WHERE date = '1/1'ouWHERE a > '1/1' AND a < '1/5'são significativamente aceleradas.As consultas seguem o princípio de correspondência mais à esquerda. Por exemplo, se uma chave de clustering for definida nas colunas (
a,b,c), uma consulta poderá ser acelerada se filtrar por (a,b,c) ou (a,b). Se a consulta filtrar por (a,c), apenas a condição emapoderá usar a chave de clustering. Se a consulta filtrar por (b,c), ela não poderá usar a chave de clustering de forma alguma.
No exemplo a seguir, as colunas uid,class,date formam a chave de clustering.
-
Sintaxe suportada pelo Hologres V2.1 e posterior:
CREATE TABLE clustering_test ( uid int NOT NULL, name text NOT NULL, class text NOT NULL, date text NOT NULL, PRIMARY KEY (uid) ) WITH ( clustering_key = 'uid,class,date' ); INSERT INTO clustering_test VALUES (1,'Alice','1','2022-10-19'), (2,'Bob','3','2022-10-19'), (3,'Sam','2','2022-10-20'), (4,'Joe','2','2022-10-20'), (5,'Sue','2','2022-10-18'), (6,'Ben','3','2022-10-17'), (7,'Tom','3','2022-10-20'); -
Sintaxe suportada por todas as versões:
BEGIN;
CREATE TABLE clustering_test (
  uid int NOT NULL,
  name text NOT NULL,
  class text NOT NULL,
  date text NOT NULL,
  PRIMARY KEY (uid)
);
CALL set_table_property('clustering_test', 'clustering_key', 'uid,class,date');
COMMIT;
INSERT INTO clustering_test VALUES
(1,'Alice','1','2022-10-19'),
(2,'Bob','3','2022-10-19'),
(3,'Sam','2','2022-10-20'),
(4,'Joe','2','2022-10-20'),
(5,'Sue','2','2022-10-18'),
(6,'Ben','3','2022-10-17'),
(7,'Tom','3','2022-10-20');
-
Consultar apenas a coluna
uidatinge a chave de clustering.SELECT * FROM clustering_test WHERE uid > '3';Inspecionar o plano de execução com a instrução EXPLAIN revela um operador
Cluster Filter. Isso indica que o otimizador usou a chave de clustering para acelerar a consulta.explain SELECT * FROM clustering_test WHERE uid > '3'; QUERY PLAN Gather (cost=0.00..1.10 rows=4 width=24) -> Exchange (Gather Exchange) (cost=0.00..1.10 rows=4 width=24) -> Decode (cost=0.00..1.10 rows=4 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=4 width=24) Cluster Filter: (uid > 3) Optimizer: HQO version 1.3.0 -
Consultar as colunas
uid,classatinge a chave de clustering.SELECT * FROM clustering_test WHERE uid = '3' AND class >'1' ;O plano de execução mostra um operador
Cluster Filter, o que indica que o otimizador usou a chave de clustering para acelerar a consulta.explain SELECT * FROM clustering_test WHERE uid = '3' AND class >'1' ; QUERY PLAN Exchange (Gather Exchange) (cost=0.00..1.10 rows=1 width=24) -> Decode (cost=0.00..1.10 rows=1 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=1 width=24) Cluster Filter: ((uid = 3) AND (class > '1'::text)) Shard Selector(Eagerly): ->: l0 [3] Optimizer: HQO version 1.3.0 -
Consultar as colunas
uid,class,dateatinge a chave de clustering.SELECT * FROM clustering_test WHERE uid = '3' AND class ='2' AND date > '2022-10-17';Ao inspecionar o plano de execução, é possível ver um operador
Cluster Filter, o que indica que a chave de clustering foi atingida e a consulta foi acelerada. O resultado do plano de execução mostra que umIndex Scan using holo_index:[1] on clustering_testé usado e a condição doCluster Filteré((uid = 3) AND (class = '2'::text) AND (date > '2022-10-17'::text)). Isso confirma que a chave de clustering foi usada corretamente. -
Consultar as colunas
uid,datenão segue o princípio de correspondência mais à esquerda. Portanto, apenasuidpode atingir a Clustering Key, edateé processado usando um filtro comum.SELECT * FROM clustering_test WHERE uid = '3' AND date > '2022-10-17';Ao visualizar o plano de execução (EXPLAIN SQL), é possível ver que, no plano mostrado abaixo, apenas a coluna
uidpossui o operadorCluster Filter.explain SELECT * FROM clustering_test WHERE uid = '3' AND date > '2022-10-17'; QUERY PLAN Exchange (Gather Exchange) (cost=0.00..1.10 rows=1 width=24) -> Decode (cost=0.00..1.10 rows=1 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=1 width=24) Filter: (date > '2022-10-17'::text) Cluster Filter: (uid = 3) Shard Selector(Eagerly): ->: I0 [3] Optimizer: HQO version 1.3.0 -
Consultar apenas as colunas
class,datenão segue o princípio de correspondência mais à esquerda. A consulta não pode aproveitar a chave de clustering.SELECT * FROM clustering_test WHERE class ='2' AND date > '2022-10-17';A ausência do operador
Cluster Filterno plano de execução (deEXPLAIN SQL) indica que a Clustering Key não foi usada. Após executarEXPLAIN, o plano de consulta mostra umIndex Scanonde a colunadateusa umFiltere a colunaclassusa umBitmap Filter, nenhum dos quais é acelerado pela Clustering Key.
Exemplos
Exemplo 1: Cenários em que uma consulta pode atingir uma chave de clustering.
-
Sintaxe suportada pelo Hologres V2.1 e posterior:
CREATE TABLE table1 ( col1 int NOT NULL, col2 text NOT NULL, col3 text NOT NULL, col4 text NOT NULL ) WITH ( clustering_key = 'col1,col2' ); -- For the table created above, the following queries can be accelerated. -- This query can be accelerated. select * from table1 where col1='abc'; -- This query can be accelerated. select * from table1 where col1>'xxx' and col1<'abc'; -- This query can be accelerated. select * from table1 where col1 in ('abc','def'); -- This query can be accelerated. select * from table1 where col1='abc' and col2='def'; -- This query cannot be accelerated. select col1,col4 from table1 where col2='def'; -
Sintaxe suportada por todas as versões:
begin;
create table table1 (
  col1 int not null,
  col2 text not null,
  col3 text not null,
  col4 text not null
);
call set_table_property('table1', 'clustering_key', 'col1,col2');
commit;
-- For the table created above, the following queries can be accelerated.
-- This query can be accelerated.
select * from table1 where col1='abc';
-- This query can be accelerated.
select * from table1 where col1>'xxx' and col1<'abc';
-- This query can be accelerated.
select * from table1 where col1 in ('abc','def');
-- This query can be accelerated.
select * from table1 where col1='abc' and col2='def';
-- This query cannot be accelerated.
select col1,col4 from table1 where col2='def';
Exemplo 2: A Clustering Key é definida como asc/desc.
-
Sintaxe suportada pelo Hologres V2.1 e posterior:
CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a:desc,b:asc' ); -
Sintaxe suportada por todas as versões:
BEGIN;
CREATE TABLE tbl (
  a int NOT NULL,
  b text NOT NULL
);
CALL set_table_property('tbl', 'clustering_key', 'a:desc,b:asc');
COMMIT;
Ajustes avançados
Ao contrário da chave de clustering em bancos de dados tradicionais, como MySQL ou SQL Server, o Hologres realiza a ordenação apenas dentro dos arquivos, e não em toda a tabela. Portanto, executar uma operação ORDER BY na Clustering Key ainda gera um custo de desempenho.
A partir da V1.3, o Hologres introduziu otimizações significativas de desempenho para casos de uso de chave de clustering. Essas otimizações fornecem melhor desempenho nos cenários a seguir. Se a sua instância do Hologres estiver em uma versão anterior à V1.3, consulte Troubleshooting: Upgrade preparation errors ou entre em contato conosco para obter suporte seguindo as instruções em How to get online support?.
-
Usar ORDER BY em chaves de clustering
No Hologres, os dados dentro de um arquivo são ordenados de acordo com as chaves de clustering definidas. Nas versões anteriores à V1.3, o otimizador não podia usar a propriedade ordenada das chaves de clustering para gerar um plano de execução ideal. Além disso, a ordem dos dados não podia ser garantida após passar por um nó de shuffle devido à mesclagem de múltiplos caminhos. Isso frequentemente levava a uma maior carga computacional e a tempos de consulta mais longos. O Hologres V1.3 otimiza esse processo. Agora, o otimizador pode gerar um plano de execução que usa a propriedade ordenada das chaves de clustering e preserva a ordem dos dados entre os shuffles, o que melhora o desempenho da consulta. No entanto, observe os seguintes pontos:
Se uma consulta não filtrar nas chaves de clustering de uma tabela, o padrão será um SeqScan em vez de um IndexScan. Apenas um IndexScan usa a propriedade ordenada das chaves de clustering.
O otimizador nem sempre escolhe um plano de execução que depende da ordem de classificação da chave de clustering, pois essa abordagem tem alguma sobrecarga. Por exemplo, os dados ordenados dentro dos arquivos ainda podem exigir uma ordenação adicional na memória.
Exemplo:
-
Sintaxe suportada pelo Hologres V2.1 e posterior:
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys;
CREATE TABLE test_use_sort_info_of_clustering_keys (
    a int NOT NULL,
    b int NOT NULL,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys SELECT i%500, i%100, i::text FROM generate_series(1, 1000) as s(i);
ANALYZE test_use_sort_info_of_clustering_keys;
Sintaxe suportada por todas as versões:
DROP TABLE if exists test_use_sort_info_of_clustering_keys; BEGIN; CREATE TABLE test_use_sort_info_of_clustering_keys ( a int NOT NULL, b int NOT NULL, c text ); CALL set_table_property('test_use_sort_info_of_clustering_keys', 'distribution_key', 'a'); CALL set_table_property('test_use_sort_info_of_clustering_keys', 'clustering_key', 'a,b'); COMMIT; INSERT INTO test_use_sort_info_of_clustering_keys SELECT i%500, i%100, i::text FROM generate_series(1, 1000) as s(i); ANALYZE test_use_sort_info_of_clustering_keys; -
Instrução de consulta:
explain select * from test_use_sort_info_of_clustering_keys where a > 100 order by a, b; -
Comparação de planos de execução
-
O código a seguir mostra o plano de execução em uma versão anterior à V1.3, como a V1.1. Visualize o plano executando a instrução
EXPLAIN.Sort (cost=0.00..0.00 rows=797 width=11) -> Gather (cost=0.00..2.48 rows=797 width=11) Sort Key: a, b -> Sort (cost=0.00..2.44 rows=797 width=11) Sort Key: a, b -> Exchange (Gather Exchange) (cost=0.00..1.11 rows=797 width=11) -> Decode (cost=0.00..1.11 rows=797 width=11) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys (cost=0.00..1.00 rows=797 width=11) Cluster Filter: (a > 100) -
O código a seguir mostra o plano de execução no Hologres V1.3.
 Gather  (cost=0.00..1.15 rows=797 width=11)
   Merge Key: a, b
   ->  Exchange (Gather Exchange)  (cost=0.00..1.11 rows=797 width=11)
         Merge Key: a, b
         ->  Decode  (cost=0.00..1.11 rows=797 width=11)
               ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys  (cost=0.00..1.01 rows=797 width=11)
                     Order by: a, b
                     Cluster Filter: (a > 100)
O plano de execução para a V1.3 é mais eficiente. Ele usa a propriedade ordenada da chave de clustering para mesclar diretamente a saída. Isso cria uma execução em pipeline e evita operações de ordenação lentas ao trabalhar com grandes conjuntos de dados. Conforme mostrado na comparação, o plano da V1.3 substitui o operador
Sortpor umMerge Key, o que indica um processo baseado em mesclagem mais eficiente. -
-
Usar JOIN em chaves de clustering (Beta)
O Hologres V1.3 introduziu o operador
Merge Join, que permite ao otimizador aproveitar a natureza ordenada das chaves de clustering, reduzir a carga computacional e melhorar o desempenho. No entanto, observe os seguintes pontos:-
Este recurso está em beta e é desativado por padrão. Para usá-lo, ative o seguinte parâmetro antes de executar sua consulta.
-- Enable merge join
set hg_experimental_enable_sort_merge_join=on;
Se uma consulta não filtrar nas chaves de clustering de uma tabela, o padrão será um SeqScan em vez de um IndexScan. Apenas um IndexScan usa a propriedade ordenada das chaves de clustering.
O otimizador nem sempre gera um plano de execução com base na ordem classificada das chaves de clustering, pois o uso dessa propriedade tem alguns custos. Por exemplo, os dados ordenados dentro dos arquivos ainda podem exigir uma ordenação adicional na memória.
Exemplo:
-
Sintaxe suportada pelo Hologres V2.1 e posterior:
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys1;
CREATE TABLE test_use_sort_info_of_clustering_keys1 (
    a int,
    b int,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys1 SELECT i % 500, i % 100, i::text FROM generate_series(1, 10000) AS s(i);
ANALYZE test_use_sort_info_of_clustering_keys1;
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys2;
CREATE TABLE test_use_sort_info_of_clustering_keys2 (
    a int,
    b int,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys2 SELECT i % 600, i % 200, i::text FROM generate_series(1, 10000) AS s(i);
ANALYZE test_use_sort_info_of_clustering_keys2;
Sintaxe suportada por todas as versões:
drop table if exists test_use_sort_info_of_clustering_keys1; begin; create table test_use_sort_info_of_clustering_keys1 ( a int, b int, c text ); call set_table_property('test_use_sort_info_of_clustering_keys1', 'distribution_key', 'a'); call set_table_property('test_use_sort_info_of_clustering_keys1', 'clustering_key', 'a,b'); commit; insert into test_use_sort_info_of_clustering_keys1 select i%500, i%100, i::text from generate_series(1, 10000) as s(i); analyze test_use_sort_info_of_clustering_keys1; drop table if exists test_use_sort_info_of_clustering_keys2; begin; create table test_use_sort_info_of_clustering_keys2 ( a int, b int, c text ); call set_table_property('test_use_sort_info_of_clustering_keys2', 'distribution_key', 'a'); call set_table_property('test_use_sort_info_of_clustering_keys2', 'clustering_key', 'a,b'); commit; insert into test_use_sort_info_of_clustering_keys2 select i%600, i%200, i::text from generate_series(1, 10000) as s(i); analyze test_use_sort_info_of_clustering_keys2; -
Instrução de consulta:
explain select * from test_use_sort_info_of_clustering_keys1 a join test_use_sort_info_of_clustering_keys2 b on a.a = b.a and a.b=b.b where a.a > 100 and b.a < 300; -
Comparação de planos de execução
-
O código a seguir mostra o plano de execução em uma versão anterior à V1.3, como a V1.1.
Gather (cost=0.00..3.09 rows=4762 width=24) -> Hash Join (cost=0.00..2.67 rows=4762 width=24) Hash Cond: ((test_use_sort_info_of_clustering_keys1.a = test_use_sort_info_of_clustering_keys2.a) AND (test_use_sort_info_of_clustering_keys1.b = test_use_sort_info_of_clustering_keys2.b)) -> Exchange (Gather Exchange) (cost=0.00..1.14 rows=3993 width=12) -> Decode (cost=0.00..1.14 rows=3993 width=12) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys1 (cost=0.00..1.01 rows=3993 width=12) Cluster Filter: ((a > 100) AND (a < 300)) -> Hash (cost=1.13..1.13 rows=3386 width=12) -> Exchange (Gather Exchange) (cost=0.00..1.13 rows=3386 width=12) -> Decode (cost=0.00..1.13 rows=3386 width=12) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys2 (cost=0.00..1.01 rows=3386 width=12) Cluster Filter: ((a > 100) AND (a < 300)) -
O código a seguir mostra o plano de execução no Hologres V1.3.
  Gather  (cost=0.00..2.88 rows=4762 width=24)
   ->  Merge Join  (cost=0.00..2.46 rows=4762 width=24)
         Merge Cond: ((test_use_sort_info_of_clustering_keys2.a = test_use_sort_info_of_clustering_keys1.a) AND (test_use_sort_info_of_clustering_keys2.b = test_use_sort_info_of_clustering_keys1.b))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3386 width=12)
               Merge Key: test_use_sort_info_of_clustering_keys2.a, test_use_sort_info_of_clustering_keys2.b
               ->  Decode  (cost=0.00..1.14 rows=3386 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys2  (cost=0.00..1.01 rows=3386 width=12)
                           Order by: test_use_sort_info_of_clustering_keys2.a, test_use_sort_info_of_clustering_keys2.b
                           Cluster Filter: ((a > 100) AND (a < 300))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3993 width=12)
               Merge Key: test_use_sort_info_of_clustering_keys1.a, test_use_sort_info_of_clustering_keys1.b
               ->  Decode  (cost=0.00..1.14 rows=3993 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys1  (cost=0.00..1.01 rows=3993 width=12)
                           Order by: test_use_sort_info_of_clustering_keys1.a, test_use_sort_info_of_clustering_keys1.b
                           Cluster Filter: ((a > 100) AND (a < 300))
O plano da V1.3 usa um
Merge Joinaproveitando a natureza ordenada da chave de clustering. Ele realiza uma mesclagem de ordenação dentro de cada shard antes do join, criando um pipeline eficiente. Essa abordagem evita possíveis erros de falta de memória (OOM) que podem ocorrer com umHash Joinquando um lado do join é muito grande para caber na memória. -
-
-
Usar consultas TopN que ordenam na ordem inversa das chaves de clustering
A partir do Hologres V5.0.0, após ativar o parâmetro GUC
hg_enable_reverse_scan_for_clustering_keys, as consultasORDER BY ... LIMIT Nque ordenam na direção oposta da chave de clustering podem usar uma varredura reversa. A varredura reversa lê menos dados e remove o operador Sort. Além disso, a partir da V5.0.0, o Hologres leva em consideração a ordenação NULL ao determinar se uma consulta pode usar a ordem de classificação de uma coluna de chave de clustering anulável. Para obter mais informações, consulte Use clustering keys to accelerate TopN queries.
Documentação relacionada
Para obter mais informações sobre as instruções de Data Definition Language (DDL) para tabelas internas do Hologres, consulte os seguintes tópicos: