Em grandes conjuntos de dados, caso você execute operações UPDATE com frequência com base em uma primary key ou execute consultas com condições de range filter, defina uma event time column (segment key). O sistema classifica os arquivos de dados com base no intervalo da event time column antes de mesclá-los. Esse processo reduz a sobreposição entre arquivos, permitindo que o mecanismo de consulta elimine o maior número possível de arquivos e melhore a eficiência da consulta. Uma event time column configurada adequadamente melhora a velocidade da consulta e o desempenho geral. Este tópico descreve como definir a propriedade event_time_column para uma tabela no Hologres.
Coluna de tempo de evento
A propriedade event_time_column era anteriormente chamada de segment key. No Hologres V0.9 e versões posteriores, o nome padrão da propriedade é event_time_column. A propriedade segment key é mantida para compatibilidade com versões anteriores.
A event time column é usada principalmente nos seguintes cenários:
Consultas que incluem um
range filterou umaequality condition.Operações
UPDATEcom base em umaprimary key.
Para definir a propriedade event_time_column, especifique-a ao criar uma tabela. Selecione a seguinte sintaxe:
-- Syntax supported in Hologres V2.1 and later
CREATE TABLE <table_name> (...) WITH (event_time_column = '[<columnName>[,...]]');
-- Syntax supported in all versions
BEGIN;
CREATE TABLE <table_name> (...);
call set_table_property('<table_name>', 'event_time_column', '[<columnName> [,...]]');
COMMIT;
Parâmetros:
|
Parâmetro |
Descrição |
|
table_name |
O nome da tabela. |
|
columnName |
A coluna a ser usada como |
Recomendações
A
event time columné mais adequada para colunas com valores monotonicamente crescentes ou decrescentes, como colunas de timestamp. É ideal para dados relacionados ao tempo, como logs e dados de tráfego, em que uma configuração adequada pode melhorar significativamente o desempenho. Se umaevent time columnestiver completamente desordenada, os arquivos mesclados não terão intervalos de valores distintos, o que anula os benefícios da eliminação de arquivos.Se uma tabela não tiver uma coluna claramente crescente ou decrescente de forma monotônica, considere adicionar uma coluna como
update_timee atualize a hora nela para cada operaçãoUPSERT.A
event time columnsegue oleftmost matching principle. Definir várias colunas pode limitar os padrões de consulta acelerados. Portanto, recomendamos especificar no máximo duas colunas na maioria dos casos.
Limitações
-
A
event time columndeve ser uma coluna ou uma combinação de colunas definidas comoNOT NULL. Você pode omitir a propriedadeevent_time_column, mas não pode defini-la para uma coluna que permita valores nulos. No Hologres V1.3.20 a V1.3.27, colunas anuláveis eram suportadas para a propriedadeevent_time_column. A partir do Hologres V1.3.28, isso não é mais suportado porque umaevent time columnanulável pode comprometer a integridade dos dados. Se você tiver um forte requisito de negócio para definir uma coluna anulável comoevent time column, adicione a seguinte instrução antes da sua instrução SQL:set hg_experimental_enable_nullable_segment_key = true;Use a seguinte instrução SQL para verificar se o banco de dados atual contém alguma
event time column(ousegment key) que seja anulável:WITH t_base AS ( SELECT * FROM hologres.hg_table_info WHERE collect_time::date = CURRENT_DATE ), t1 AS ( SELECT db_name, schema_name, table_name, jsonb_array_elements(table_meta::jsonb -> 'columns') cols FROM t_base ), t2 AS ( SELECT db_name, schema_name, table_name, cols ->> 'name' col_name FROM t1 WHERE cols -> 'nullable' = 'true'::jsonb ), t3 AS ( SELECT db_name, schema_name, table_name, regexp_replace(regexp_split_to_table(table_meta::jsonb ->> 'segment_key', ','), ':asc|:desc$', '') segment_key_col FROM t_base WHERE table_meta::jsonb -> 'segment_key' IS NOT NULL ) SELECT CURRENT_DATE, t3.db_name, t3.schema_name, t3.table_name, jsonb_build_object('nullable_segment_key_column', string_agg(t3.segment_key_col, ',')) as nullable_segment_key_column FROM t2, t3 WHERE t3.db_name = t2.db_name AND t3.schema_name = t2.schema_name AND t3.table_name = t2.table_name AND t2.col_name = t3.segment_key_col GROUP BY t3.db_name, t3.schema_name, t3.table_name; Não modifique a propriedade
event_time_columnapós a criação da tabela. Para alterá-la, exclua e recrie a tabela.Não é possível definir uma
event time columnpara umarow-oriented table.Para uma
column-oriented table, se você não definir explicitamente umaevent time column, o Hologres usa por padrão a primeira colunaNOT NULLdo tipo de dadosTIMESTAMPouTIMESTAMPTZcomoevent time column. Se não existir tal coluna, a primeira colunaNOT NULLdo tipo de dadosDATEserá usada. Em versões anteriores ao Hologres V0.9, nenhumaevent time columnpadrão é definida.Não é possível usar
DECIMAL,NUMERIC,FLOAT,DOUBLE,ARRAY,JSON,JSONB,BIT,MONEYou outros tipos de dados complexos para umaevent time column.
Como funciona
A figura a seguir mostra o processo de gravação de dados em um único shard: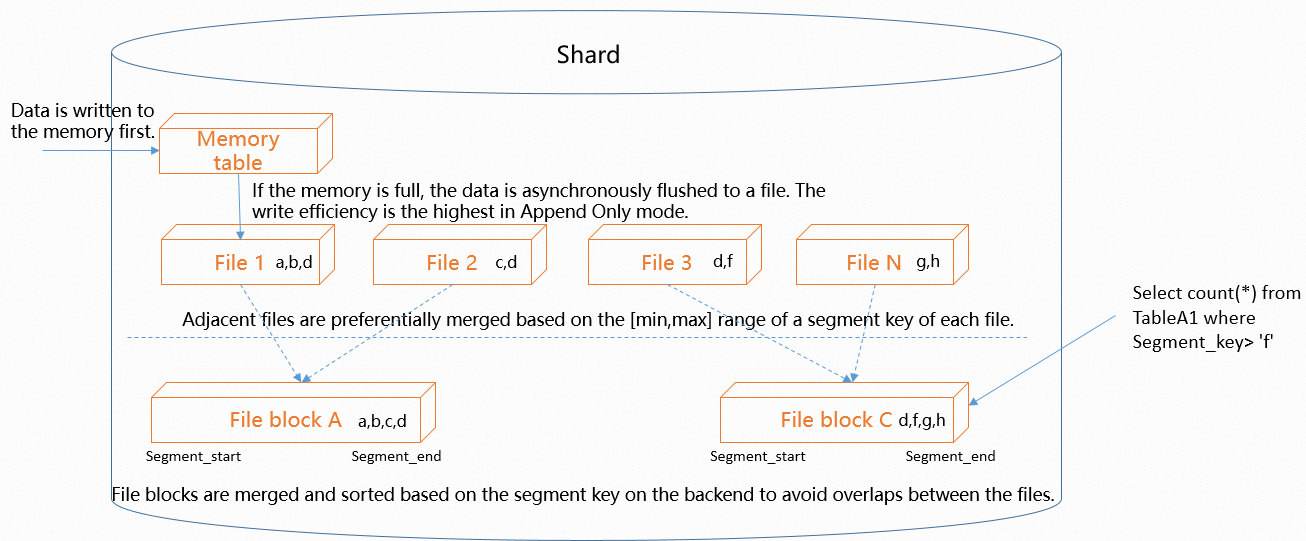
Dentro de um
shard, os dados são primeiro gravados em umain-memory tableno modo append-only para maximizar o desempenho de gravação. AsIn-memory tables têm um tamanho fixo. Quando umain-memory tableestá cheia, o sistema libera seus dados de forma assíncrona para arquivos.Para otimizar o desempenho de gravação, os dados são gravados no modo append-only, o que faz com que o número de arquivos aumente com o tempo. O sistema mescla periodicamente esses arquivos em segundo plano. Se você definir uma
event time column(ousegment key), o sistema classifica os arquivos com base no intervalo daevent time columne, em seguida, mescla arquivos com intervalos adjacentes. Esse processo reduz a sobreposição entre arquivos, permitindo que o otimizador de consulta elimine mais arquivos e melhore a eficiência da consulta.Os arquivos são classificados com base na
event time column. Portanto, aevent time columntambém segue oleftmost matching principle. Por exemplo, se você definir as colunasa,beccomoevent time column, uma consulta poderá se beneficiar dessa configuração se suas condições de filtro forem ema,b,coua,b. Se as condições de filtro forem ema,c, apenas a colunaapoderá se beneficiar. Se as condições de filtro forem emb,c, a consulta não poderá se beneficiar daevent time column.
Conforme descrito, a event time column pode acelerar os seguintes cenários:
-
Consultas que incluem um
range filterou umaequality condition.Se uma coluna consultada for definida como
event time column, o Hologres compara as condições de intervalo na consulta com as estatísticas no nível do arquivo (min/max) da coluna. Isso permite que o Hologres elimine rapidamente arquivos irrelevantes e acelere a consulta. -
Operações
UPDATEcom base em umaprimary key.O comando
UPDATEdo Hologres é implementado como uma combinação dos comandosDELETEeINSERT. Em cenários que envolvem um UPDATE ou INSERT ON CONFLICT(UPSERT) baseado em chave primária, a chave primária é usada primeiro para encontrar a segment key dos dados antigos na tabela de destino. Essa segment key é então usada para localizar o arquivo que contém os dados antigos e, finalmente, os dados são marcados comoDELETE. Se uma segment key for configurada adequadamente, o arquivo que contém os dados antigos poderá ser localizado rapidamente, o que melhora o desempenho de gravação. Por outro lado, se uma tabela orientada a colunas não tiver uma segment key configurada, se a segment key estiver configurada com um campo inadequado, ou se o campo da segment key não tiver uma forte correlação com o tempo durante as gravações de dados (por exemplo, se os dados estiverem majoritariamente fora de ordem), um grande número de arquivos precisará ser verificado para encontrar os dados antigos. Esse processo não apenas causa um grande número de operações de I/O, mas também consome recursos significativos de CPU, o que afeta negativamente o desempenho de gravação e a carga de toda a instância.
Exemplos
-
Para verificar o
execution plan, execute a instruçãoEXPLAIN. SeSegment Filteraparecer no plano, a consulta está usando aevent time column. O plano a seguir inclui umSegment Filter, indicando que aevent time columnestá ativa.Primeiro, crie uma única
event time columnao criar uma tabela.-
Sintaxe suportada no Hologres V2.1 e versões posteriores:
CREATE TABLE tbl_segment_test ( a int NOT NULL, b timestamptz NOT NULL ) WITH ( event_time_column = 'b' ); INSERT INTO tbl_segment_test values (1,'2022-09-05 10:23:54+08'), (2,'2022-09-05 10:24:54+08'), (3,'2022-09-05 10:25:54+08'), (4,'2022-09-05 10:26:54+08'); EXPLAIN SELECT * FROM tbl_segment_test WHERE b > '2022-09-05 10:24:54+08'; -
Sintaxe suportada em todas as versões:
BEGIN;
CREATE TABLE tbl_segment_test (
    a int NOT NULL,
    b timestamptz NOT NULL
    );
CALL set_table_property('tbl_segment_test', 'event_time_column', 'b');
COMMIT;
INSERT INTO tbl_segment_test VALUES
(1,'2022-09-05 10:23:54+08'),
(2,'2022-09-05 10:24:54+08'),
(3,'2022-09-05 10:25:54+08'),
(4,'2022-09-05 10:26:54+08');
EXPLAIN SELECT * FROM tbl_segment_test WHERE b > '2022-09-05 10:24:54+08';
QUERY PLAN Gather (cost=0.00..1.10 rows=1 width=12) -> Exchange (Gather Exchange) (cost=0.00..1.10 rows=1 width=12) -> Decode (cost=0.00..1.10 rows=1 width=12) -> Index Scan using holo_index:[1] on tbl_segment_test (cost=0.00..1.00 rows=1 width=12) Segment Filter: (b > '2022-09-05 10:24:54+08'::timestamp with time zone) Optimizer: HQO version 1.3.0 -
-
Crie várias
event time columns ao criar uma tabela.-
Sintaxe suportada no Hologres V2.1 e versões posteriores:
CREATE TABLE tbl_segment_test_2 ( a int NOT NULL, b timestamptz NOT NULL ) WITH ( event_time_column = 'a,b' ); INSERT INTO tbl_segment_test_2 VALUES (1,'2022-09-05 10:23:54+08'), (2,'2022-09-05 10:24:54+08'), (3,'2022-09-05 10:25:54+08'), (4,'2022-09-05 10:26:54+08') ; -- The query does not hit the event time column. SELECT * FROM tbl_segment_test_2 WHERE b > '2022-09-05 10:24:54+08'; -- The query hits the event time column. SELECT * FROM tbl_segment_test_2 WHERE a = 3 and b > '2022-09-05 10:24:54+08'; SELECT * FROM tbl_segment_test_2 WHERE a > 3 and b < '2022-09-05 10:26:54+08'; SELECT * FROM tbl_segment_test_2 WHERE a > 3 and b > '2022-09-05 10:24:54+08'; -
Sintaxe suportada em todas as versões:
BEGIN;
CREATE TABLE tbl_segment_test_2 (
    a int NOT NULL,
    b timestamptz NOT NULL
    );
CALL set_table_property('tbl_segment_test_2', 'event_time_column', 'a,b');
COMMIT;
INSERT INTO tbl_segment_test_2 VALUES
(1,'2022-09-05 10:23:54+08'),
(2,'2022-09-05 10:24:54+08'),
(3,'2022-09-05 10:25:54+08'),
(4,'2022-09-05 10:26:54+08')
;
-- The query does not hit the event time column.
SELECT * FROM tbl_segment_test_2 WHERE b > '2022-09-05 10:24:54+08';
-- The query hits the event time column.
SELECT * FROM tbl_segment_test_2 WHERE a = 3 and b > '2022-09-05 10:24:54+08';
SELECT * FROM tbl_segment_test_2 WHERE a > 3 and b < '2022-09-05 10:26:54+08';
SELECT * FROM tbl_segment_test_2 WHERE a > 3 and b > '2022-09-05 10:24:54+08';
-
Tópicos relacionados
Para obter orientações sobre como escolher as propriedades de tabela adequadas para seus padrões de consulta, consulte Guide on scenario-specific table creation and tuning.
-
Para instruções DDL relacionadas a tabelas internas do Hologres, consulte: