Se você realiza operações de GROUP BY ou JOIN com frequência em uma tabela, ou deseja evitar distorção de dados, defina uma distribution key ao criar a tabela. Uma distribution key adequada distribui os dados de forma uniforme entre todos os nós de computação, melhorando significativamente o desempenho de computação e consulta. Este tópico descreve como definir uma distribution key para uma tabela no Hologres.
Introdução
No Hologres, a propriedade de tabela distribution_key especifica a estratégia de distribuição de dados de uma tabela. O sistema garante que registros com o mesmo valor de distribution key sejam alocados ao mesmo shard. Configure essa propriedade ao criar uma tabela com a seguinte sintaxe:
-- Syntax supported by Hologres V2.1 and later
CREATE TABLE <table_name> (...) WITH (distribution_key = '[<columnName>[,...]]');
-- Syntax supported by all versions
BEGIN;
CREATE TABLE <table_name> (...);
call set_table_property('<table_name>', 'distribution_key', '[<columnName>[,...]]');
COMMIT;
A tabela a seguir descreve os parâmetros.
|
Parâmetro |
Descrição |
|
table_name |
O nome da tabela para a qual você deseja definir a distribution key. |
|
columnName |
O nome da coluna a ser usada como distribution key. |
Uma distribution key configurada corretamente oferece os seguintes benefícios:
-
Melhor desempenho de computação
As computações são executadas em paralelo entre diferentes shards, melhorando o desempenho geral de processamento.
-
Maior número de consultas por segundo (QPS)
Quando você usa a distribution key como condição de filtro, o Hologres verifica apenas os shards relevantes. Sem ela, o Hologres precisa varrer todos os shards, o que reduz o QPS.
-
Desempenho de join significativamente aprimorado
Quando duas tabelas pertencem ao mesmo table group e suas colunas de join também são suas distribution keys, o Hologres garante que os dados com chaves de join correspondentes estejam no mesmo shard. Isso permite um local join, onde cada nó processa seus próprios dados sem movimentá-los entre nós, melhorando drasticamente a eficiência de execução.
Diretrizes de uso
Siga estes princípios ao definir uma distribution key:
Escolha colunas com alta cardinalidade e distribuição uniforme de dados para a distribution key. Uma distribuição desigual causa distorção de dados e desequilíbrio de carga, reduzindo a eficiência das consultas. Para solucionar problemas de distorção de dados, consulte Detect and handle workload skew.
Prefira colunas usadas com frequência em cláusulas
GROUP BYcomo distribution key.Para operações de join, defina as colunas de join como distribution keys para habilitar o local join e evitar data shuffle. As tabelas envolvidas no join devem pertencer ao mesmo table group.
Recomenda-se definir uma distribution key com no máximo duas colunas. Com uma chave de múltiplas colunas, as consultas podem causar data shuffle se não incluírem filtros em todas as colunas da chave. Evite usar uma distribution key composta com colunas redundantes, como duas colunas que sempre têm o mesmo valor, pois isso pode provocar distorção de dados quando os dados subjacentes também apresentam baixa cardinalidade.
É possível definir uma ou mais colunas como distribution key. Para uma única coluna, não adicione espaços extras no comando. Para múltiplas colunas, separe os nomes com vírgulas (,) sem espaços extras. A ordem das colunas em uma distribution key de múltiplas colunas não afeta o layout dos dados nem o desempenho das consultas.
Se uma tabela possui uma chave primária (PK), a distribution key deve ser a própria PK ou um subconjunto de suas colunas. A distribution key não pode ser vazia, ou seja, especifique ao menos uma coluna. Esse requisito garante que todos os dados de um único registro pertençam a apenas um shard. Quando a distribution key não é definida explicitamente, o Hologres usa a PK como distribution key padrão.
Limitações
A distribution key deve ser definida no momento da criação da tabela. Para modificá-la em uma tabela existente, recrie a tabela e importe os dados novamente.
Não é possível atualizar os valores de colunas que compõem a distribution key. Para alterar esses valores, recrie a tabela.
Colunas dos seguintes tipos de dados não podem ser usadas como distribution key: FLOAT, DOUBLE, NUMERIC, ARRAY, JSON ou outros tipos de dados complexos.
-
Para tabelas sem chave primária, a distribution key pode ser vazia, o que distribui os dados aleatoriamente entre todos os shards. No entanto, a partir do Hologres V1.3.28, é proibido definir explicitamente uma distribution key vazia. A sintaxe a seguir exemplifica o que não é permitido:
--This syntax is prohibited in Hologres V1.3.28 and later.
CALL SET_TABLE_PROPERTY('<tablename>', 'distribution_key', '');
Se uma coluna da distribution key contiver valores
null, o Hologres os trata como strings vazias"". Isso significa que todos os valores nulos são mapeados para a mesma chave e distribuídos ao mesmo shard.
Como funciona
A distribution key especifica a estratégia de distribuição de dados de uma tabela. O comportamento varia conforme a configuração nos diferentes casos de uso.
Definindo uma distribution key
Ao definir uma distribution key para uma tabela, o Hologres aloca os dados em diferentes shards com base nessa chave. O algoritmo Hash(distribution_key) % shard_count determina o shard de destino de cada registro. O sistema garante que registros com o mesmo valor de distribution key sejam colocados no mesmo shard. Os exemplos a seguir mostram como definir uma distribution key.
-
Sintaxe compatível com o Hologres V2.1 e versões posteriores:
-- Set column 'a' as the distribution key. The system hashes the values in column 'a' and then applies a modulo operation: hash(a) % shard_count = shard_id. Records with the same result are distributed to the same shard. CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- Set columns 'a' and 'b' as the distribution key. The system hashes the values from both columns and then applies a modulo operation: hash(a,b) % shard_count = shard_id. Records with the same result are distributed to the same shard. CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a,b' ); -
Sintaxe compatível com todas as versões:
-- Set column 'a' as the distribution key. The system hashes the values in column 'a' and then applies a modulo operation: hash(a) % shard_count = shard_id. Records with the same result are distributed to the same shard.
begin;
create table tbl (
a int not null,
b text not null
);
call set_table_property('tbl', 'distribution_key', 'a');
commit;
-- Set columns 'a' and 'b' as the distribution key. The system hashes the values from both columns and then applies a modulo operation: hash(a,b) % shard_count = shard_id. Records with the same result are distributed to the same shard.
begin;
create table tbl (
  a int not null,
  b text not null
);
call set_table_property('tbl', 'distribution_key', 'a,b');
commit;
A figura a seguir ilustra essa distribuição de dados. 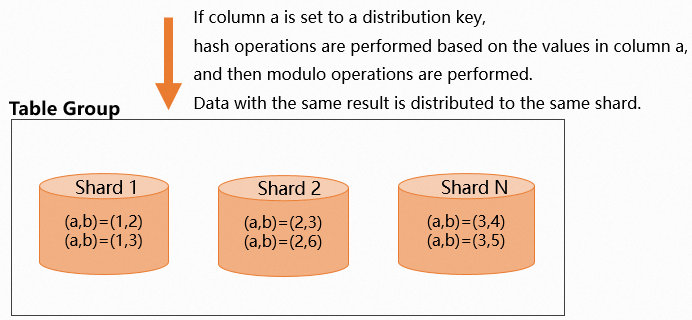 Ao definir uma distribution key, escolha colunas que distribuam os dados de forma uniforme. No Hologres, o número de shards está relacionado ao número de nós worker. Para mais informações, consulte Basic concepts. Se a chave escolhida resultar em distribuição desigual, os dados se concentrarão em poucos shards, forçando um número reduzido de nós worker a processar a maior parte do trabalho computacional. Isso pode causar o efeito de cauda longa e reduzir a eficiência das consultas. Para saber como identificar e resolver distorções de dados, consulte Detect and handle workload skew.
Omitindo a distribution key
Quando a distribution key não é definida, os dados são distribuídos aleatoriamente entre os shards. Registros com o mesmo valor podem ser colocados no mesmo shard ou em shards diferentes. O exemplo a seguir mostra como criar uma tabela sem distribution key.
-- Do not set a distribution key.
begin;
create table tbl (
a int not null,
b text not null
);
commit;
A figura a seguir ilustra essa distribuição aleatória de dados.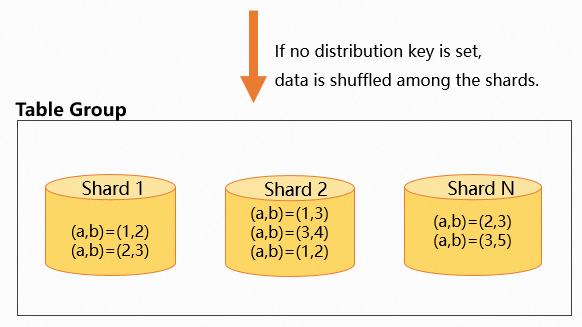
Distribution key para agregação GROUP BY
Com uma distribution key definida, registros com o mesmo valor de chave ficam no mesmo shard. Para consultas de agregação com GROUP BY, o sistema redistribui os dados com base nas colunas de agrupamento. Ao definir a distribution key nas colunas frequentemente usadas em cláusulas GROUP BY, você garante que os dados já estejam co-localizados em cada shard, reduzindo a redistribuição entre shards e melhorando o desempenho das consultas. O exemplo a seguir demonstra como fazer isso.
-
Sintaxe compatível com o Hologres V2.1 e versões posteriores:
CREATE TABLE agg_tbl ( a int NOT NULL, b int NOT NULL ) WITH ( distribution_key = 'a' ); -- Example query: aggregate on column a. select a,sum(b) from agg_tbl group by a; -
Sintaxe compatível com todas as versões:
begin;
create table agg_tbl (
a int not null,
b int not null
);
call set_table_property('agg_tbl', 'distribution_key', 'a');
commit;
-- Example query: aggregate on column a.
select a,sum(b) from agg_tbl group by a;
Ao executar o comando EXPLAIN, o plano de execução exibido não contém o operador redistribution. Como a distribution key da tabela (a) coincide com a coluna do GROUP BY, o Hologres realiza a agregação diretamente em cada shard, evitando redistribuição de dados.
Distribution key para joins entre duas tabelas
-
Definindo colunas de join como distribution keys
Em um cenário de join entre duas tabelas, quando as colunas de join de ambas as tabelas são definidas como suas respectivas distribution keys, o Hologres garante que os dados com o mesmo valor de chave de join residam no mesmo shard. Isso habilita o local join e acelera a execução das consultas. O exemplo a seguir demonstra essa situação.
-
DDL para criação das tabelas:
-
Sintaxe compatível com o Hologres V2.1 e versões posteriores:
-- Data in tbl1 is distributed by column 'a', and data in tbl2 is distributed by column 'c'. When tbl1 and tbl2 are joined on a=c, the corresponding data resides on the same shard, allowing a local join for faster query performance. BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'c' ); COMMIT; -
Sintaxe compatível com todas as versões:
-- Data in tbl1 is distributed by column 'a', and data in tbl2 is distributed by column 'c'. When tbl1 and tbl2 are joined on a=c, the corresponding data resides on the same shard, allowing a local join for faster query performance.
begin;
create table tbl1(
a int not null,
b text not null
);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(
c int not null,
d text not null
);
call set_table_property('tbl2', 'distribution_key', 'c');
commit;
-
-
Instrução de consulta:
select * from tbl1 join tbl2 on tbl1.a=tbl2.c;
A figura a seguir mostra a distribuição dos dados.
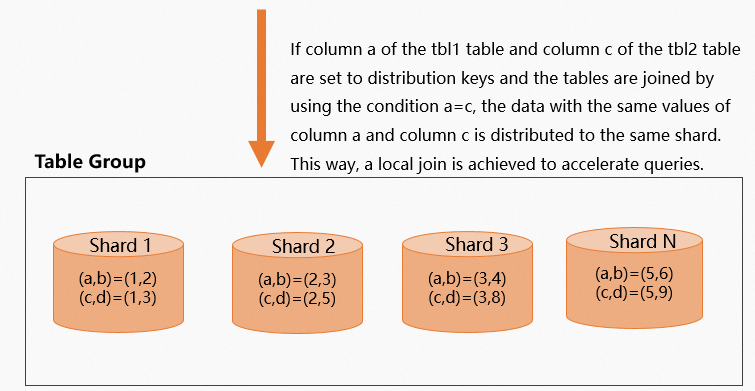 Ao inspecionar o plano de execução (EXPLAIN SQL), é possível verificar que ele não inclui o operador
redistribution, confirmando que não houve redistribuição de dados.QUERY PLAN Gather (cost=0.00..10.27 rows=1000 width=24) -> Hash Join (cost=0.00..10.21 rows=1000 width=24) Hash Cond: (tbl1.a = tbl2.c) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl1 (cost=0.00..5.00 rows=1000 width=12) -> Hash (cost=5.10..5.10 rows=1000 width=12) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl2 (cost=0.00..5.00 rows=1000 width=12) Optimizer: HQO version 1.3.0 -
-
Colunas de join não definidas como distribution keys
Em um cenário de join entre duas tabelas, quando as colunas de join não são ambas definidas como distribution keys, o Hologres realiza shuffle dos dados entre os shards durante a consulta. O otimizador decide entre shuffle ou broadcast com base no tamanho das duas tabelas. No exemplo a seguir, a distribution key de
tbl1é a colunaa, e a distribution key detbl2é a colunad. A condição de join éa=c. Como a colunacnão é a distribution key detbl2, seus dados precisam ser redistribuídos entre todos os shards, o que degrada o desempenho das consultas.-
DDL para criação das tabelas:
-
Sintaxe compatível com o Hologres V2.1 e versões posteriores:
BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'd' ); COMMIT; -
Sintaxe compatível com todas as versões:
begin;
create table tbl1(
a int not null,
b text not null
);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(
c int not null,
d text not null
);
call set_table_property('tbl2', 'distribution_key', 'd');
commit;
-
-
Instrução de consulta:
select * from tbl1 join tbl2 on tbl1.a=tbl2.c;
A figura a seguir mostra a distribuição dos dados.
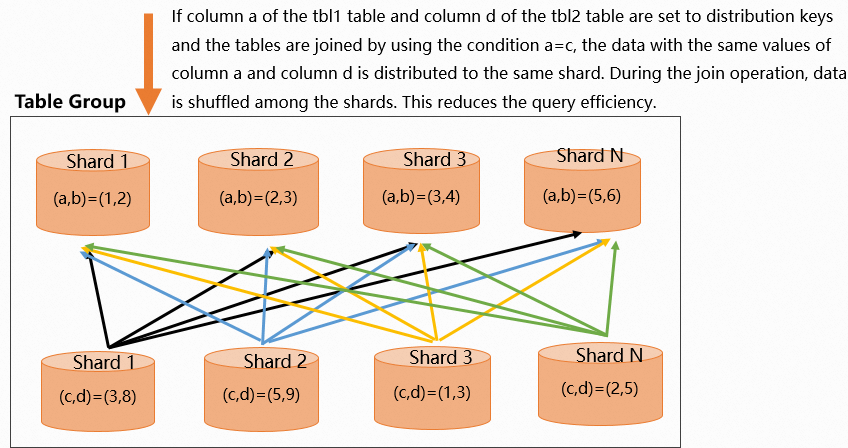 O plano de execução inclui um operador
redistribution, indicando que os dados estão sendo redistribuídos entre os shards. Isso evidencia uma configuração de distribution key abaixo do ideal, que gera movimentação extra de dados e degradação de desempenho.QUERY PLAN Gather (cost=0.00..10.27 rows=1000 width=24) -> Hash Join (cost=0.00..10.21 rows=1000 width=24) Hash Cond: (tbl2.c = tbl1.a) -> Redistribution (cost=0.00..5.10 rows=1000 width=12) Hash Key: tbl2.c -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl2 (cost=0.00..5.00 rows=1000 width=12) -> Hash (cost=5.10..5.10 rows=1 width=12) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1 width=12) -> Decode (cost=0.00..5.10 rows=1 width=12) -> Seq Scan on tbl1 (cost=0.00..5.00 rows=1 width=12) Optimizer: HQO version 1.3.0 -
Distribution key para joins entre múltiplas tabelas
Joins envolvendo múltiplas tabelas são mais complexos. Siga estes princípios gerais:
Se todas as tabelas são unidas pelas mesmas colunas, defina essas colunas de join como a distribution key de cada tabela.
Se as tabelas são unidas por colunas diferentes, priorize o join entre as tabelas maiores e defina as colunas de join dessas tabelas como suas distribution keys.
Os exemplos a seguir usam um join entre três tabelas para ilustrar esses casos. A mesma lógica se aplica a joins com mais de três tabelas.
-
As três tabelas possuem as mesmas colunas de join
Quando todas as três tabelas são unidas pelas mesmas colunas, o cenário é direto. Defina essas colunas comuns de join como a distribution key das três tabelas para habilitar o local join.
-
Sintaxe compatível com o Hologres V2.1 e versões posteriores:
BEGIN; CREATE TABLE join_tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE join_tbl2 ( a int NOT NULL, d text NOT NULL, e text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE join_tbl3 ( a int NOT NULL, e text NOT NULL, f text NOT NULL, g text NOT NULL ) WITH ( distribution_key = 'a' ); COMMIT; -- 3-table join query SELECT * FROM join_tbl1 INNER JOIN join_tbl2 ON join_tbl2.a = join_tbl1.a INNER JOIN join_tbl3 ON join_tbl2.a = join_tbl3.a; -
Sintaxe compatível com todas as versões:
begin;
create table join_tbl1(
a int not null,
b text not null
);
call set_table_property('join_tbl1', 'distribution_key', 'a');
create table join_tbl2(
a int not null,
d text not null,
e text not null
);
call set_table_property('join_tbl2', 'distribution_key', 'a');
create table join_tbl3(
a int not null,
e text not null,
f text not null,
g text not null
);
call set_table_property('join_tbl3', 'distribution_key', 'a');
commit;
--3-table join query
SELECT * FROM join_tbl1
INNER JOIN join_tbl2 ON join_tbl2.a = join_tbl1.a
INNER JOIN join_tbl3 ON join_tbl2.a = join_tbl3.a;
O plano de execução (EXPLAIN SQL) apresenta o seguinte:
Não há operador
redistribution, indicando que os dados não foram redistribuídos e que o local join foi realizado.O operador
exchangemove dados entre estágios ou nós de execução, melhorando a eficiência ao garantir que apenas os dados do shard relevante sejam processados.
QUERY PLAN Gather (cost=0.00..16.44 rows=10000 width=36) -> Hash Join (cost=0.00..15.57 rows=10000 width=36) Hash Cond: ((join_tbl2.a = join_tbl3.a) AND (join_tbl1.a = join_tbl3.a)) -> Hash Join (cost=0.00..10.31 rows=10000 width=20) Hash Cond: (join_tbl2.a = join_tbl1.a) -> Exchange (Gather Exchange) (cost=0.00..5.11 rows=10000 width=12) -> Decode (cost=0.00..5.11 rows=10000 width=12) -> Seq Scan on join_tbl2 (cost=0.00..5.00 rows=10000 width=12) -> Hash (cost=5.11..5.11 rows=10000 width=8) -> Exchange (Gather Exchange) (cost=0.00..5.11 rows=10000 width=8) -> Decode (cost=0.00..5.11 rows=10000 width=8) -> Seq Scan on join_tbl1 (cost=0.00..5.00 rows=10000 width=8) -> Hash (cost=5.12..5.12 rows=10000 width=16) -> Exchange (Gather Exchange) (cost=0.00..5.12 rows=10000 width=16) -> Decode (cost=0.00..5.12 rows=10000 width=16) -> Seq Scan on join_tbl3 (cost=0.00..5.00 rows=10000 width=16) Optimizer: HQO version 1.3.0 -
-
As três tabelas possuem colunas de join diferentes
Na prática, as colunas de join em um join com múltiplas tabelas podem ser distintas. Nesse caso, use os seguintes princípios para definir a distribution key:
O princípio central de otimização é priorizar o join entre as tabelas maiores. Defina as colunas de join das tabelas grandes como a distribution key. Tabelas pequenas contêm menos dados, portanto sua estratégia de distribuição tem menor prioridade.
Se as tabelas possuem volumes de dados semelhantes, defina a distribution key nas colunas de join usadas com maior frequência em cláusulas
GROUP BY.
No exemplo a seguir, três tabelas são unidas com colunas de join distintas. A melhor estratégia é escolher as colunas de join da tabela maior como distribution key. A tabela
join_tbl_1possui 10 milhões de linhas, enquantojoin_tbl_2ejoin_tbl_3têm 1 milhão de linhas cada. Portanto,join_tbl_1é o principal alvo de otimização.-
Sintaxe compatível com o Hologres V2.1 e versões posteriores:
BEGIN; -- join_tbl_1 contains 10 million rows. CREATE TABLE join_tbl_1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- join_tbl_2 contains 1 million rows. CREATE TABLE join_tbl_2 ( a int NOT NULL, d text NOT NULL, e text NOT NULL ) WITH ( distribution_key = 'a' ); -- join_tbl_3 contains 1 million rows. CREATE TABLE join_tbl_3 ( a int NOT NULL, e text NOT NULL, f text NOT NULL, g text NOT NULL ) WITH ( distribution_key = 'a' ); COMMIT; -- When join keys are different, choose the join key of the largest table as the distribution key. SELECT * FROM join_tbl_1 INNER JOIN join_tbl_2 ON join_tbl_2.a = join_tbl_1.a INNER JOIN join_tbl_3 ON join_tbl_2.d = join_tbl_3.f; -
Sintaxe compatível com todas as versões:
begin;
--join_tbl_1 contains 10 million rows.
create table join_tbl_1(
a int not null,
b text not null
);
call set_table_property('join_tbl_1', 'distribution_key', 'a');
--join_tbl_2 contains 1 million rows.
create table join_tbl_2(
a int not null,
d text not null,
e text not null
);
call set_table_property('join_tbl_2', 'distribution_key', 'a');
--join_tbl_3 contains 1 million rows.
create table join_tbl_3(
a int not null,
e text not null,
f text not null,
g text not null
);
call set_table_property('join_tbl_3', 'distribution_key', 'a');
commit;
-- When join keys are different, choose the join key of the largest table as the distribution key.
SELECT * FROM join_tbl_1
INNER JOIN join_tbl_2 ON join_tbl_2.a = join_tbl_1.a
INNER JOIN join_tbl_3 ON join_tbl_2.d = join_tbl_3.f;
O plano de execução (EXPLAIN SQL) apresenta o seguinte:
O operador
redistributionaparece no join entrejoin_tbl_2ejoin_tbl_3. Comojoin_tbl_3é uma tabela menor e sua coluna de join não corresponde à sua distribution key, o Hologres redistribui seus dados.Não há operador
redistributionno join entrejoin_tbl_1ejoin_tbl_2. Como ambas as tabelas utilizam a coluna de join comum como distribution key, essa parte do join não requer redistribuição de dados.
QUERY PLAN
Gather  (cost=0.00..183.90 rows=1000000 width=49)
  -> Hash Join  (cost=0.00..64.87 rows=1000000 width=49)
      Hash Cond: (join_tbl_2.d = join_tbl_3.f)
      -> Redistribution  (cost=0.00..40.22 rows=1000000 width=27)
          Hash Key: join_tbl_2.d
          -> Hash Join  (cost=0.00..35.99 rows=1000000 width=27)
              Hash Cond: (join_tbl_1.a = join_tbl_2.a)
              -> Exchange (Gather Exchange)  (cost=0.00..18.45 rows=10000000 width=11)
                  -> Decode  (cost=0.00..18.08 rows=10000000 width=11)
                      -> Seq Scan on join_tbl_1  (cost=0.00..7.75 rows=10000000 width=11)
              -> Hash  (cost=6.93..6.93 rows=1000000 width=16)
                  -> Exchange (Gather Exchange)  (cost=0.00..6.93 rows=1000000 width=16)
                      -> Decode  (cost=0.00..6.88 rows=1000000 width=16)
                          -> Seq Scan on join_tbl_2  (cost=0.00..5.29 rows=1000000 width=16)
      -> Hash  (cost=10.97..10.97 rows=1000000 width=22)
          -> Redistribution  (cost=0.00..10.97 rows=1000000 width=22)
              Hash Key: join_tbl_3.f
              -> Exchange (Gather Exchange)  (cost=0.00..7.53 rows=1000000 width=22)
                  -> Decode  (cost=0.00..7.45 rows=1000000 width=22)
                      -> Seq Scan on join_tbl_3  (cost=0.00..5.31 rows=1000000 width=22)
Optimizer: HQO version 1.3.0
Exemplos
-
Sintaxe compatível com o Hologres V2.1 e versões posteriores:
-- Set a single-column distribution key. CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- Set a multi-column distribution key. CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a,b' ); -- Set join keys as distribution keys in a join scenario. BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'c' ); COMMIT; SELECT b, count(*) FROM tbl1 JOIN tbl2 ON tbl1.a = tbl2.c GROUP BY b; -
Sintaxe compatível com todas as versões:
-- Set a single-column distribution key.
begin;
create table tbl (a int not null, b text not null);
call set_table_property('tbl', 'distribution_key', 'a');
commit;
-- Set a multi-column distribution key.
begin;
create table tbl (a int not null, b text not null);
call set_table_property('tbl', 'distribution_key', 'a,b');
commit;
-- Set join keys as distribution keys in a join scenario.
begin;
create table tbl1(a int not null, b text not null);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(c int not null, d text not null);
call set_table_property('tbl2', 'distribution_key', 'c');
commit;
select b, count(*) from tbl1 join tbl2 on tbl1.a = tbl2.c group by b;
Documentação relacionada
Para orientações sobre como definir propriedades de tabela com base em seus cenários de negócio, consulte Scenario-based guide for table design.
Para mais informações sobre as melhores práticas de otimização de desempenho de consultas em tabelas internas do Hologres, consulte Optimize query performance.
-
Para instruções DDL relacionadas a tabelas internas do Hologres, consulte: