O conjunto de IA nativa da cloud é uma solução do Container Service for Kubernetes (ACK) que oferece infraestrutura completa para criar e operar workloads de IA e machine learning no Kubernetes. Ele gerencia recursos, agenda jobs, acelera dados e fornece ferramentas de ciclo de vida, permitindo que sua equipe foque no desenvolvimento e treinamento de modelos em vez de gerenciar clusters.
O conjunto expõe todos os recursos por meio de CLI, SDKs multilíngues e console do ACK, além de se integrar a services de IA da Alibaba Cloud, frameworks open source e ferramentas de IA de terceiros pelas mesmas interfaces.
Arquitetura
Construído sobre o ACK, o conjunto de IA nativa da cloud gerencia recursos heterogêneos de computação, armazenamento e rede na camada inferior e expõe clusters e APIs padrão do Kubernetes na camada superior. Sobre essa base, ele fornece os componentes de agendamento, orquestração de dados, workflow e ciclo de vida necessários para suas workloads de IA.

Integração com o PAI
O conjunto se integra à Platform for AI (PAI) para formar uma plataforma de IA elástica e de alto desempenho. O ACK melhora a elasticidade e a eficiência dos services do PAI: Data Science Workshop (DSW), Deep Learning Containers (DLC) e Elastic Algorithm Service (EAS). Implante a Lightweight Platform for AI no seu cluster ACK com poucos cliques para trazer os algoritmos e engines profundamente otimizados do PAI para workloads containerizadas, acelerando tanto o treinamento quanto a inferência. Para mais informações, consulte What is PAI?
Recursos principais
O conjunto de IA nativa da cloud usa o Kubernetes como base e oferece suporte e otimização completos para aplicações e sistemas de IA e machine learning. A tabela a seguir descreve os principais recursos fornecidos pelo conjunto de IA nativa da cloud.
|
Gerenciamento de recursos heterogêneos |
|
|
|
Agendamento de jobs de IA |
|
|
|
Agendamento elástico |
Agendamento elástico para jobs de deep learning distribuído: O conjunto dimensiona dinamicamente o número de workers e de nós sem afetar o treinamento do modelo nem sua precisão. Ele adiciona workers para acelerar o treinamento quando o cluster possui recursos ociosos e libera workers quando o cluster não consegue fornecer recursos suficientes. Isso garante que o treinamento do modelo não seja afetado pela falta de recursos. Esse modo melhora significativamente a utilização geral dos recursos do cluster, ajuda a evitar falhas em nós e reduz o tempo de espera para iniciar jobs. |
|
|
Orquestração e aceleração de dados de IA |
Fluid: introduz o conceito de dataset. Ele fornece aos jobs de treinamento uma abstração de dados e oferece uma plataforma de orquestração e aceleração de dados para ajudar a gerenciar datasets, aplicar controle de acesso e acelerar o acesso aos dados. O ack-fluid pode ingerir dados de diferentes services de armazenamento e agregá-los no mesmo dataset. Também é possível conectar o ack-fluid a services de armazenamento na cloud ou on-premises em um ambiente de cloud híbrida para gerenciar dados e acelerar o acesso. Além disso, o ack-fluid pode ser estendido para suportar diversos services de cache distribuído. Configure um service de cache para cada dataset e use recursos como aquecimento de dataset, monitoramento de capacidade de cache e dimensionamento elástico para reduzir significativamente a sobrecarga de ingestão remota de dados nos jobs de treinamento e melhorar a eficiência da computação em GPU. |
|
|
Gerenciamento do ciclo de vida de jobs de IA |
|
Casos de uso
O conjunto de IA nativa da cloud é ideal para melhorar continuamente a utilização de recursos heterogêneos e lidar eficientemente com workloads heterogêneas, como jobs de IA.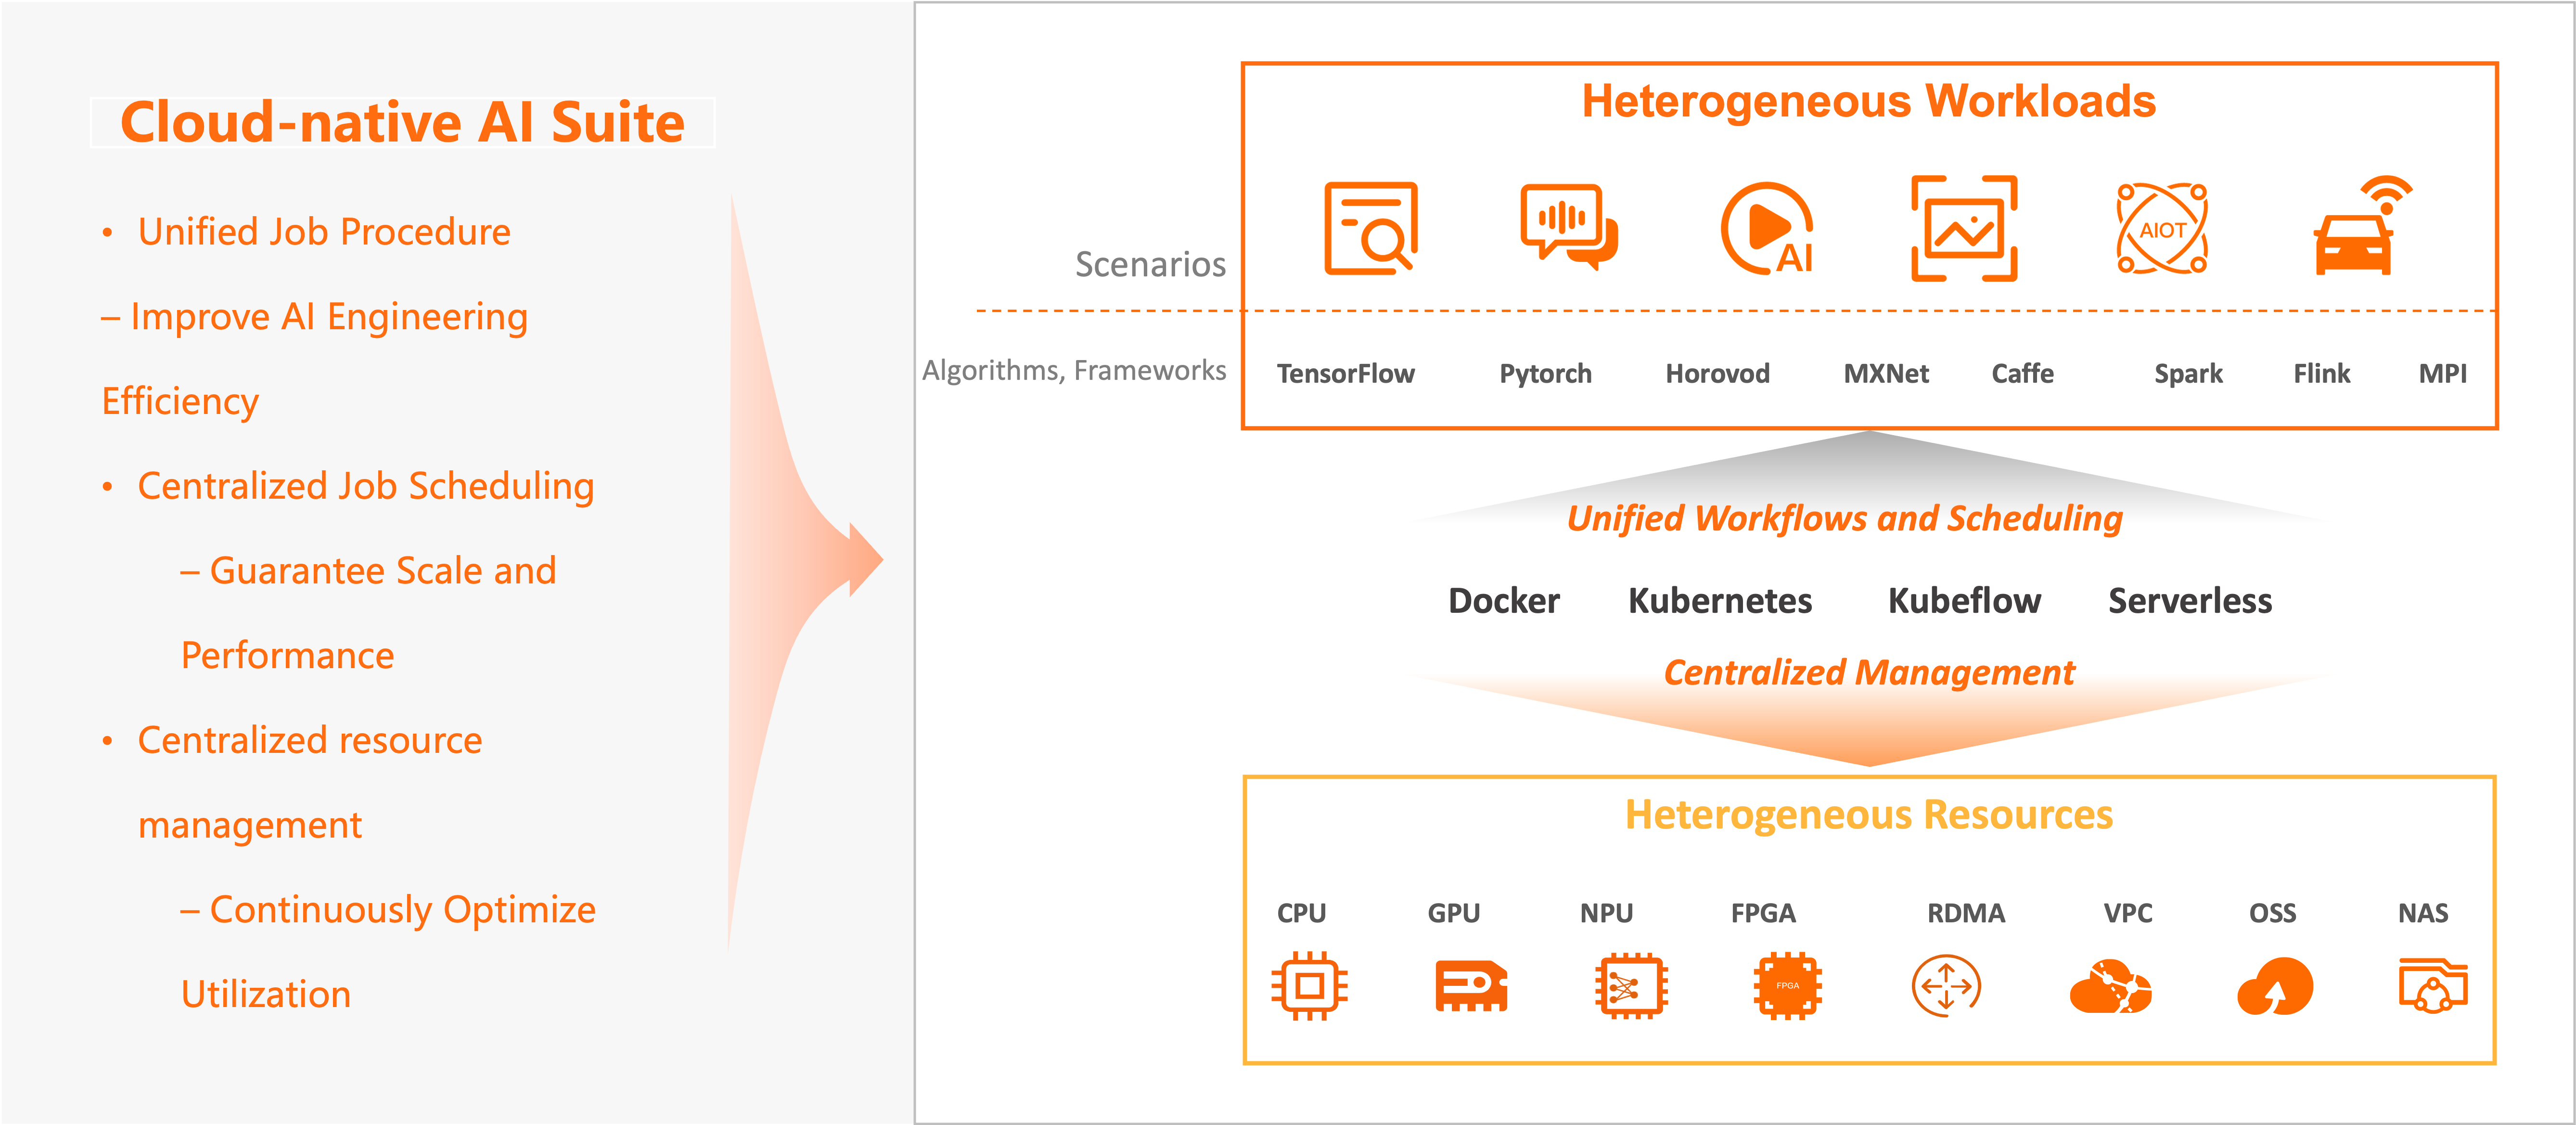
Caso de uso 1: Melhorar continuamente a utilização de recursos heterogêneos
O conjunto de IA nativa da cloud fornece uma abstração de recursos heterogêneos na cloud, incluindo recursos de computação (como CPUs, GPUs, NPUs, VPUs e FPGAs), recursos de armazenamento (OSS, NAS, CPFS e HDFS) e recursos de rede (TCP e RDMA). Utilize o conjunto para gerenciar, manter e alocar esses recursos centralmente, melhorando continuamente a utilização com base no dimensionamento de recursos e em otimizações de software e hardware.
Caso de uso 2: Lidar eficientemente com workloads heterogêneas, como jobs de IA
O conjunto de IA nativa da cloud é compatível com engines open source predominantes, como TensorFlow, PyTorch, DeepSpeed, Ray, Horovod, Spark, Flink, Kubeflow, Kserve, vLLM e Triton Inference Server, além de suportar engines e runtimes autogerenciados. O conjunto também otimiza continuamente os jobs de treinamento em termos de desempenho, eficiência e custos, aprimora a experiência do usuário em desenvolvimento e manutenção e aumenta a eficiência de engenharia.
Funções de usuário
O conjunto de IA nativa da cloud define as seguintes funções de usuário.
|
Função |
Descrição |
|
Administrador de O&M |
Responsável por construir a infraestrutura de IA e pela administração diária. Para mais informações, consulte Deploy the suite, Manage users, Manage elastic quota groups e Manage datasets. |
|
Engenheiro de algoritmos e cientista de dados |
Usa o conjunto de IA nativa da cloud para gerenciar jobs. Para mais informações, consulte Model trainingModel training in Kubernetes clusters, Manage models in MLflow Model Registry through Arena e Analyze and optimize models. |
Trabalhar com o conjunto de IA nativa da cloud
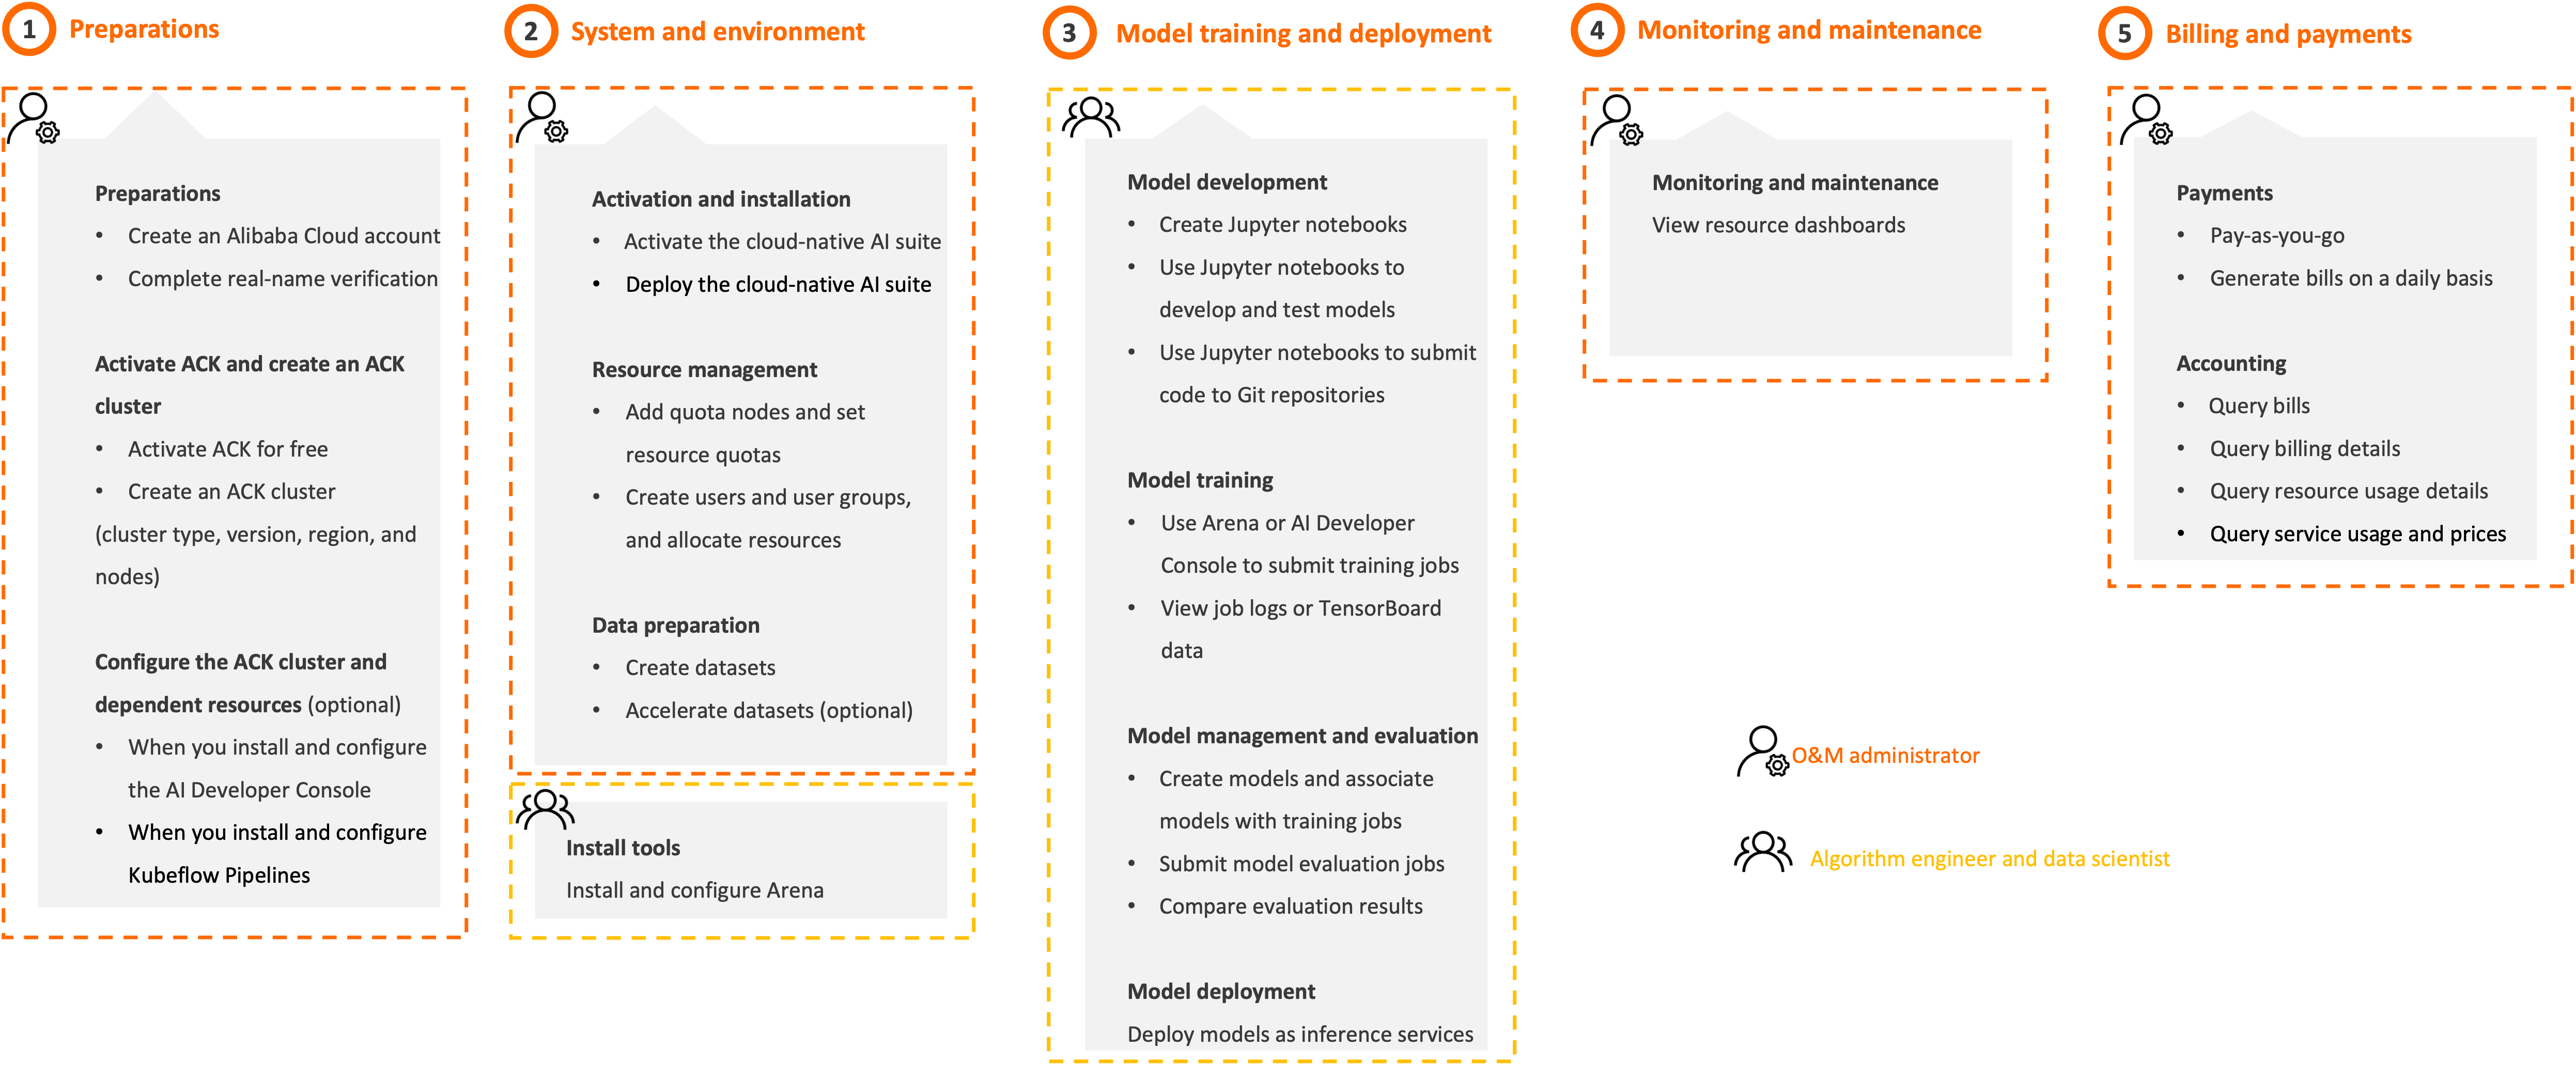
Siga as etapas na figura abaixo para usar o conjunto de IA nativa da cloud de acordo com a função de usuário que você assume.
|
Etapa |
Descrição |
Console |
|
1. Preparações (Administrador de O&M) |
Crie uma conta Alibaba Cloud Crie uma conta Alibaba Cloud e conclua a verificação de nome real. Para mais informações, consulte Register an Alibaba Cloud account. |
|
|
Crie um cluster ACK Ative o ACK e crie um cluster ACK. Recomendamos as seguintes configurações de cluster. Para mais informações, consulte Create an ACK managed cluster.
|
||
|
(Opcional) Configure dependências do cluster e crie recursos de cloud dependentes
|
||
|
2. Sistema e ambiente (Administrador de O&M) |
Ative e instale o conjunto de IA nativa da cloud
|
|
|
Gerencie usuários e cotas
|
AI Dashboard e kubectl Nota
Os consoles de IA fornecidos pela Alibaba Cloud (incluindo o console de desenvolvedor e o console de O&M) estão disponíveis como recurso de lista de permissões desde 22 de janeiro de 2025. Se você implantou esses consoles antes da entrada em vigor da lista de permissões, sua implantação existente não será afetada. Usuários que não estão na lista de permissões podem instalar e configurar o console do conjunto de IA a partir da comunidade open source. Para mais informações sobre a configuração open source, consulte Open-source AI console. |
|
|
Prepare dados
|
||
|
(Engenheiro de algoritmos e cientista de dados) |
O conjunto de IA nativa da cloud permite que engenheiros de algoritmos e cientistas de dados usem o Arena, o web console e o AI Developer Console para desenvolver modelos, treinar modelos, implantar services de inferência e gerenciar jobs.
|
|
|
3. Treinamento e implantação de modelos (Engenheiro de algoritmos e cientista de dados) |
Ao usar o Arena ou o AI Developer Console, execute as etapas a seguir para treinar e implantar modelos: Desenvolva modelos
Treine modelos
Gerencie modelos
Implante modelos Implante um modelo como service de inferência. Para mais informações, consulte AI service deploymentDeploy AI services. |
AI Developer Console e Arena |
|
Utilize a Lightweight Platform for AI para desenvolver, treinar e implantar modelos. |
N/A |
|
|
4. Monitoramento e manutenção (Administrador de O&M) |
Monitore e mantenha recursos Visualize os painéis de vários recursos, incluindo clusters, nós, jobs de treinamento e cotas de recursos. Para mais informações, consulte Cloud-native AI monitoring dashboards. |
|
|
Gerencie cotas
|
||
|
Gerencie usuários Crie, consulte, atualize e exclua usuários ou grupos de usuários. Para mais informações, consulte Manage users e Manage user groups. |
||
|
Gerencie datasets
|
||
|
Gerencie jobs elásticos Visualize jobs elásticos e detalhes dos jobs. Para mais informações, consulte View elastic tasks. |
||
|
5. Faturamento e pagamentos (Administrador de O&M) |
A partir das 00:00:00 (UTC+8) de 6 de junho de 2024, o conjunto de IA nativa da cloud é gratuito. Para mais informações, consulte Billing of cloud-native AI suite. |
|
|
Gere faturas diariamente
|
Regras de faturamento
Para mais informações, consulte Billing of cloud-native AI suite.
Referências
|
Referência |
Descrição |
|
Ajuda você a aplicar rapidamente o conjunto de IA nativa da cloud em seu trabalho de desenvolvimento e O&M por meio de algumas práticas. |
|
|
Descreve as notas de versão do conjunto de IA nativa da cloud. |