Este tópico apresenta a solução de compartilhamento de GPU fornecida pela Alibaba Cloud, descreve os benefícios do GPU Sharing Professional Edition e compara os recursos e cenários de uso do GPU Sharing Basic Edition e do GPU Sharing Professional Edition. Isso ajuda você a compreender e utilizar melhor o compartilhamento de GPU.
Informações de contexto
O compartilhamento de GPU permite execute vários containers no mesmo dispositivo de GPU. Após a Alibaba Cloud Container Service for Kubernetes (ACK) tornar o compartilhamento de GPU open source, você pode implementar uma estrutura de compartilhamento de GPU em clusters de containers tanto na Alibaba Cloud quanto em data centers on-premises. Isso possibilita que múltiplos containers compartilhem o mesmo dispositivo de GPU, reduzindo assim os custos de uso.
No entanto, além de garantir a eficiência de custos, também é essencial assegurar a operação estável dos containers na GPU. Ao isolar os recursos de GPU alocados para cada container, é possível limitar o uso de recursos de cada container na mesma GPU, evitando interferências mútuas causadas pelo uso excessivo. Para resolver esse problema, a indústria de computação oferece diversas soluções, como NVIDIA vGPU, Multi-Process Service (MPS) e vCUDA, a fim de proporcionar um gerenciamento mais refinado do uso da GPU.
Para atender a esses requisitos, o ACK introduziu a solução de compartilhamento de GPU. Essa solução não apenas permite que várias tarefas compartilhem uma única GPU, mas também isola a memória e particiona o poder de computação da GPU para diferentes aplicações no mesmo dispositivo.
Recursos e benefícios
A solução de compartilhamento de GPU utiliza o driver do kernel do servidor desenvolvido pela Alibaba Cloud para proporcionar um uso mais eficiente dos drivers subjacentes das GPUs da NVIDIA. O compartilhamento de GPU oferece os seguintes recursos:
Alta compatibilidade: o compartilhamento de GPU é compatível com soluções open source padrão, como Kubernetes e NVIDIA Docker.
Facilidade de uso: o compartilhamento de GPU oferece uma excelente experiência ao usuário. Para substituir uma biblioteca da Compute Unified Device Architecture (CUDA) de uma aplicação de IA, não é necessário recompilar a aplicação ou crie uma nova imagem de container.
Estabilidade: o compartilhamento de GPU proporciona operações subjacentes estáveis em GPUs NVIDIA. As operações de api em bibliotecas CUDA e algumas operações de api privadas da CUDA Deep Neural Network (cuDNN) possuem chamadas complexas.
Isolamento de recursos: o compartilhamento de GPU garante que a memória e o poder de computação da GPU alocados não interfiram uns nos outros.
O compartilhamento de GPU oferece uma solução econômica, confiável e fácil de usar, que permite ativar o agendamento de GPU e o isolamento de memória.
Benefício | Descrição |
Suporta compartilhamento, agendamento e isolamento de memória de GPU. |
|
Suporta políticas flexíveis de compartilhamento de GPU e isolamento de memória. |
|
Suporta monitoramento abrangente dos recursos de GPU. | Permite o monitoramento tanto de GPUs exclusivas quanto de GPUs compartilhadas. |
Gratuito | É necessário ative o cloud native AI suite antes de utilizar o compartilhamento de GPU. A partir de 00:00:00 (UTC+8) do dia 6 de junho de 2024, o cloud native AI Suite passou a ser totalmente aberto para uso gratuito. |
Notas de uso
O compartilhamento de GPU suporta apenas clusters ACK Pro. Para mais informações sobre como instale e usar o compartilhamento de GPU, consulte os seguintes tópicos:
Também é possível utilizar os seguintes recursos avançados do compartilhamento de GPU:
Termos
Modo de compartilhamento e modo exclusivo
O modo de compartilhamento permite que múltiplos pods compartilhem uma GPU, conforme ilustrado na figura a seguir. 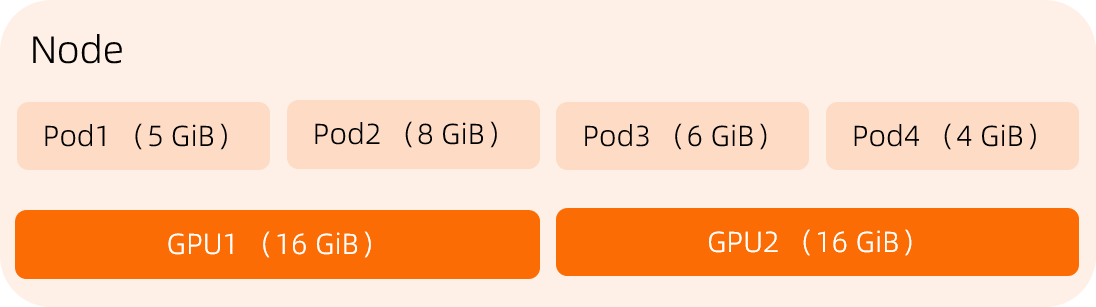
O modo exclusivo permite que um pod ocupe uma ou mais GPUs de forma exclusiva, conforme ilustrado na figura a seguir. 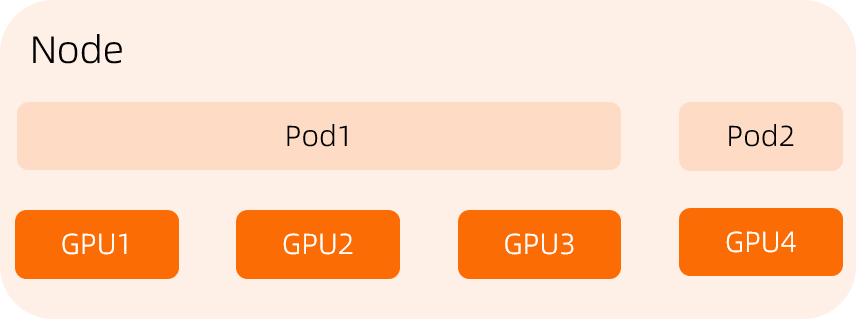
Isolamento de memória da GPU
O compartilhamento de GPU garante apenas que múltiplos pods sejam executados em uma GPU, mas não evita a contenção de recursos entre os pods quando o isolamento de memória da GPU está desativado. A seção a seguir mostra um exemplo.
O Pod 1 solicita 5 GiB de memória de GPU e o Pod 2 solicita 10 GiB de memória de GPU. Quando o isolamento de memória da GPU está desativado, o Pod 1 pode usar até 10 GiB de memória de GPU, incluindo os 5 GiB solicitados pelo Pod 2. Consequentemente, o Pod 2 falha ao iniciar devido à memória de GPU insuficiente. Após a ativação do isolamento de memória da GPU, quando o Pod 1 tenta usar uma quantidade de memória maior que o valor solicitado, o módulo de isolamento de memória da GPU força a falha do Pod 1. 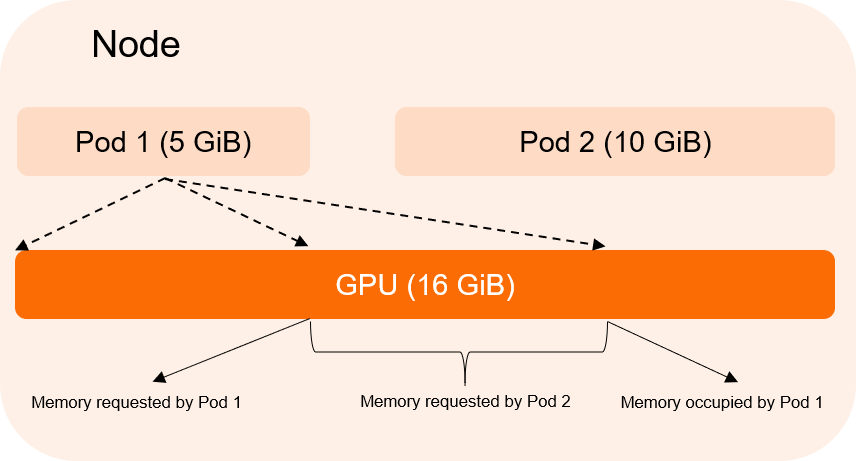
Políticas de agendamento de GPU: binpack e spread
Se um nó com o recurso de compartilhamento de GPU ativado possuir múltiplas GPUs, escolha uma das seguintes políticas de seleção de GPU:
Binpack: por padrão, a política binpack é utilizada. O agendador aloca todos os recursos de uma GPU para os pods antes de passar para outra GPU. Isso ajuda a evitar fragmentos de GPU.
Spread: o agendador tenta distribuir os pods em diferentes GPUs no nó para evitar interrupções nos negócios caso ocorra falha em uma GPU.
Neste exemplo, um nó possui duas GPUs. Cada GPU fornece 15 GiB de memória. O Pod1 solicita 2 GiB de memória e o Pod2 solicita 3 GiB de memória.

Compartilhamento de GPU única e compartilhamento de múltiplas GPUs
Compartilhamento de GPU única: um pod pode solicitar recursos de GPU alocados por apenas uma GPU.
Compartilhamento de múltiplas GPUs: um pod pode solicitar recursos de GPU alocados de forma uniforme por múltiplas GPUs.
