Elastic Algorithm Service (EAS) の組み込み TorchEasyRec プロセッサは、TorchEasyRec または PyTorch でトレーニングされたレコメンデーションモデルを、特徴量エンジニアリングが統合されたスコアリングサービスとしてデプロイします。このプロセッサは、特徴量エンジニアリングと PyTorch モデルを共同で最適化し、パフォーマンス専有型のスコアリングサービスを提供します。このトピックでは、TorchEasyRec モデルサービスのデプロイと呼び出し方法について説明します。
背景情報
以下の図は、TorchEasyRec プロセッサに基づくレコメンデーションエンジンのアーキテクチャを示しています。
TorchEasyRec プロセッサは、以下のモジュールで構成されています。
-
アイテム特徴量キャッシュ:フィーチャーストアからのアイテムサイド特徴量をメモリにキャッシュし、ネットワークオーバーヘッドを削減し、フィーチャーストアへの負荷を軽減し、推論サービスのパフォーマンスを向上させます。アイテムサイド特徴量にリアルタイム特徴量が含まれる場合、フィーチャーストアがその同期を処理します。
-
特徴量ジェネレーター (FG):設定ファイルで特徴量変換を定義し、統一された C++ コードベースを使用して、オフラインとオンラインの特徴量処理ロジックの一貫性を確保します。
-
TorchModel:TorchEasyRec または PyTorch でトレーニングされ、ScriptedModel としてエクスポートされた PyTorch モデルです。
制限事項
サポートは、汎用インスタンスファミリーの g6、g7、g8 モデル、および RTX Pro 5000、L20、A10、T4 などの GPU モデルに限定されます。詳細については、「汎用インスタンスファミリー (g シリーズ)」をご参照ください。GPU サービスをデプロイする場合、CUDA ドライバーのバージョンが 535 以降であることを確認してください。
バージョン履歴
TorchEasyRec プロセッサは活発に開発されています。推論サービスをデプロイする際は、より多くの機能と高い推論パフォーマンスを提供する最新バージョンを使用することを推奨します。リリースされたバージョンは以下の通りです。
|
プロセッサ |
日付 |
Torch バージョン |
FG バージョン |
更新内容 |
|
easyrec-torch-0.1 |
2024-09-10 |
2.4 |
0.2.9 |
|
|
easyrec-torch-0.2 |
2024-09-30 |
2.4 |
0.2.9 |
|
|
easyrec-torch-0.3 |
2024-10-14 |
2.4 |
0.2.9 |
|
|
easyrec-torch-0.4 |
2024-10-28 |
2.4 |
0.3.1 |
|
|
easyrec-torch-0.5 |
2024-11-14 |
2.4 |
0.3.1 |
|
|
easyrec-torch-0.6 |
2024-11-18 |
2.4 |
0.3.6 |
|
|
easyrec-torch-0.7 |
2024-12-06 |
2.5 |
0.3.9 |
|
|
easyrec-torch-0.8 |
2024-12-25 |
2.5 |
0.3.9 |
|
|
easyrec-torch-0.9 |
2025-01-15 |
2.5 |
0.4.1 |
|
|
easyrec-torch-1.0 |
2025-02-06 |
2.5 |
0.4.2 |
|
|
easyrec-torch-1.1 |
2025-04-23 |
2.5 |
0.5.9 |
|
|
easyrec-torch-1.2 |
2025-05-12 |
2.5 |
0.6.0 |
|
|
easyrec-torch-1.3 |
2025-05-29 |
2.5 |
0.6.5 |
|
|
easyrec-torch-1.4 |
2025-07-15 |
2.5 |
0.6.9 |
|
|
easyrec-torch-1.5 |
2025-09-18 |
2.5 |
0.7.3 |
|
|
easyrec-torch-1.6 |
2025-10-21 |
2.5 |
0.7.4 |
|
|
easyrec-torch-1.7 |
2025-11-04 |
2.5 |
0.7.4 |
|
|
easyrec-torch-1.8 |
2025-12-01 |
2.5 |
0.7.4 |
|
|
easyrec-torch-1.9 |
2026-01-09 |
2.5 |
1.0.0 |
|
|
easyrec-torch-1.10 |
2026-01-23 |
2.5 |
1.0.1 |
|
|
easyrec-torch-1.11 |
2026-02-10 |
2.5 |
1.0.1 |
|
|
easyrec-torch-1.12 |
2026-03-13 |
2.5 |
1.0.1 |
|
|
バージョン 2.0 以降に関する注意
|
||||
|
easyrec-torch-2.0 |
2026-03-17 |
2.8 |
1.0.1 |
|
|
easyrec-torch-2.1 |
2026-04-09 |
2.8 |
1.0.2 |
|
|
easyrec-torch-2.2 |
2026-04-29 |
2.8 |
1.0.5 |
|
|
easyrec-torch-2.3 |
2026-06-08 |
2.11 |
1.0.5 |
|
|
easyrec-torch-2.4 |
2026-07-21 |
2.11 |
1.0.5 |
|
|
easyrec-torch-2.5 |
2026-09-10 |
2.11 |
1.0.6 |
|
ステップ 1:サービスのデプロイ
-
torcheasyrec.jsonサービス設定ファイルを準備します。プロセッサタイプを easyrec-torch-{version} として指定し、{version} の値をバージョン履歴から選択する必要があります。JSON 設定ファイルの例は以下の通りです。
FG を使用する例 (fg_mode='normal')
{
  "metadata": {
    "instance": 1,
    "name": "alirec_rank_with_fg",
    "rpc": {
      "enable_jemalloc": 1,
      "max_queue_size": 256,
      "worker_threads": 16
    }
  },
  "cloud": {
        "computing": {
            "instance_type": "ecs.gn6i-c16g1.4xlarge"
        }
  },
  "model_config": {
    "fg_mode": "normal",
    "fg_threads": 8,
    "region": "YOUR_REGION",
    "fs_project": "YOUR_FS_PROJECT",
    "fs_model": "YOUR_FS_MODEL",
    "fs_entity": "item",
    "load_feature_from_offlinestore": true,
    "access_key_id":"YOUR_ACCESS_KEY_ID",
    "access_key_secret":"YOUR_ACCESS_KEY_SECRET"
  },
  "storage": [
    {
      "mount_path": "/home/admin/docker_ml/workspace/model/",
      "oss": {
        "path": "oss://xxx/xxx/export",
        "readOnly": false
      },
      "properties": {
        "resource_type": "code"
      }
    }
  ],
  "processor":"easyrec-torch-2.4"
}
FG を使用しない例 (fg_mode='bypass')
{ "metadata": { "instance": 1, "name": "alirec_rank_no_fg", "rpc": { "enable_jemalloc": 1, "max_queue_size": 256, "worker_threads": 16 } }, "cloud": { "computing": { "instance_type": "ecs.gn6i-c16g1.4xlarge" } }, "model_config": { "fg_mode": "bypass" }, "storage": [ { "mount_path": "/home/admin/docker_ml/workspace/model/", "oss": { "path": "oss://xxx/xxx/export", "readOnly": false }, "properties": { "resource_type": "code" } } ], "processor":"easyrec-torch-2.4" }その他のパラメーターについては、「JSON デプロイメント」をご参照ください。
パラメーター
必須
説明
例
processor
はい
TorchEasyRec プロセッサ。
"processor":"easyrec-torch-1.12"
path
はい
モデルファイルを保存するためにサービスにマウントされる OSS パス。
"path": "oss://examplebucket/xxx/export"
fg_mode
いいえ
特徴量エンジニアリングモードを指定します。有効な値:
-
bypass (デフォルト):特徴量エンジニアリング (FG) を無効にします。Torch モデルのみがデプロイされます。
-
カスタム特徴量処理にはこのモードを使用します。
-
このモードでは、プロセッサはフィーチャーストアのアクセスパラメーターを必要としません。
-
-
normal:FG を有効にします。このモードは通常、モデルトレーニングに TorchEasyRec と共に使用されます。
"fg_mode": "normal"
fg_threads
いいえ
リクエストごとの FG 実行のための並行スレッド数。
"fg_threads": 15
outputs
いいえ
Torch モデルの予測からの出力変数名 (例:
probs_ctr)。複数の名前を区切るにはカンマ (,) を使用します。このパラメーターが指定されていない場合、サービスはすべての変数を返します。"outputs":"probs_ctr,probs_cvr"
item_empty_score
いいえ
アイテム ID が存在しない場合に返すデフォルトスコア。デフォルト値:0。
"item_empty_score": -1
プロセッサのベクトルリコールパラメーター
faiss_neigh_num
いいえ
FAISS ベクトルリコールで取得するアイテムの数。サービスはリクエストボディの
faiss_neigh_numフィールドの値を優先します。このフィールドが提供されない場合、model_configセクションのfaiss_neigh_numパラメーターの値を使用します。デフォルト値は 1 です。"faiss_neigh_num": 200
faiss_nprobe
いいえ
nprobeパラメーターは、取得時に検索するクラスターの数を指定します。FAISS では、転置ファイルインデックスがデータをより小さなクラスターに分割し、それぞれに転置リストを維持します。大きなnprobe値は、一般的に計算量と検索時間が増加する代わりに再現率を向上させ、小さな値は精度を低下させますが検索を高速化します。デフォルト値は 800 です。"faiss_nprobe" : 700
フィーチャーストアアクセス用のプロセッサパラメーター
fs_project
いいえ
ご利用のフィーチャーストアプロジェクトの名前。このパラメーターはフィーチャーストアを使用する場合に必須です。詳細については、「フィーチャーストアプロジェクトの設定」をご参照ください。
"fs_project": "fs_demo"
fs_model
いいえ
フィーチャーストア内の特徴量モデルの名前。
"fs_model": "fs_rank_v1"
fs_entity
いいえ
フィーチャーストア内のエンティティ名。
"fs_entity": "item"
region
いいえ
ご利用のフィーチャーストアプロジェクトが配置されているリージョン。例えば、中国 (北京) リージョンには
cn-beijingを指定します。サポートされているリージョンとそのエンドポイントのリストについては、「エンドポイント」をご参照ください。"region": "cn-beijing"
access_key_id
いいえ
フィーチャーストアにアクセスするための AccessKey ID。
"access_key_id": "xxxxx"
access_key_secret
いいえ
フィーチャーストアにアクセスするための AccessKey Secret。
"access_key_secret": "xxxxx"
load_feature_from_offlinestore
いいえ
フィーチャーストアのオフラインストアからオフライン特徴量を直接ロードするかどうかを指定します。有効な値:
-
True:フィーチャーストアのオフラインストアからデータをロードします。
-
False (デフォルト):フィーチャーストアのオンラインストアからデータをロードします。
"load_feature_from_offlinestore": True
featuredb_username
いいえ
FeatureDB のユーザー名。
"featuredb_username":"xxx"
featuredb_password
いいえ
FeatureDB のパスワード。
"featuredb_passwd":"xxx"
自動特徴量展開 (input_tile) のパラメーター
INPUT_TILE
いいえ
パフォーマンスを最適化するために自動特徴量展開を有効にします。
user_idのように、単一のリクエスト内のすべてのアイテムで同じ値を共有する特徴量については、値を一度だけ送信できます。これにより、リクエストペイロードサイズ、ネットワーク遅延、計算時間が削減されます。この機能は
normalモードで、TorchEasyRec でトレーニングされたモデルと共に使用する必要があります。モデルのエクスポート中にも対応する環境変数を設定する必要があります。デフォルトでは、システムはエクスポートされたモデルディレクトリ内のmodel_acc.jsonファイルからINPUT_TILEの値を読み取ります。このファイルがない場合、システムは環境変数から値を読み取ります。この機能が有効な場合:
-
環境変数が 2 に設定されている場合、ユーザーサイド特徴量の FG は一度だけ計算されます。
-
環境変数が 3 に設定されている場合、ユーザーサイド特徴量の FG は一度だけ計算されます。システムはユーザーとアイテムの特徴量の埋め込みを別々に計算し、ユーザーサイドの埋め込みは一度だけ計算されます。この設定は、多くのユーザーサイド特徴量があるシナリオに最適です。
"processor_envs":
[
{
"name": "INPUT_TILE",
"value": "2"
}
]
NO_GRAD_GUARD
いいえ
推論中の勾配計算を無効にします。これにより、操作の追跡が停止し、計算グラフの構築が防がれます。
説明このパラメーターを
1に設定すると、一部のモデルで互換性の問題が発生する可能性があります。2 回目の推論実行中にサービスがハングする場合、PYTORCH_TENSOREXPR_FALLBACK=2環境変数を設定することで問題を解決できます。これにより、コンパイルステップをバイパスしつつ、一部のグラフ最適化機能を保持します。"processor_envs":
[
{
"name": "NO_GRAD_GUARD",
"value": "1"
}
]
モデルウォームアップパラメーター
warmup_data_path
いいえ
モデルウォームアップ機能を有効にし、ウォームアップファイルを保存するパスを指定します。ウォームアップファイルを永続化するには、
storage設定でこの場所に OSS パスをマウントする必要があります。"warmup_data_path": "/warmup"
warmup_cnt_per_file
いいえ
各 Protobuf ファイルに対してウォームアッププロセスを実行する回数。値が大きいほどウォームアップが徹底されますが、起動時間が増加します。デフォルト値:20。
"warmup_cnt_per_file": 20,
warmup_pb_files_count
いいえ
次のサービス起動のために Protobuf ファイルとして保存するオンラインリクエストの数。ファイルはモデルウォームアップに使用され、
warmup_data_pathで指定されたパスに保存されます。デフォルト値:64。"warmup_pb_files_count": 64
低速リクエストのロギングと保存
long_request_threshold
いいえ
低速リクエストを識別するための時間しきい値 (ミリ秒)。リクエストの処理時間がこのしきい値を超えると、システムは各ステージの実行時間を自動的にログに記録します。デフォルト値:200。
"long_request_threshold": 200
save_long_request
いいえ
long_request_thresholdを超えるリクエストを Protobuf ファイルとして保存するかどうかを指定します。trueに設定すると、ファイルはモデルディレクトリ以下のtorch_reqディレクトリに保存されます。デフォルト値:false。"save_long_request": true
生リクエストとアイテム特徴量の OSS への保存
request_log_path
いいえ
Protobuf ファイルを保存するためのディスクパス。サービス設定でこの場所に OSS パスをマウントする必要があります。
"request_log_path": "/online_log_pb"
background_feature_thread_num
いいえ
ファイルをディスクに書き込むための専用のバックグラウンドスレッド数。ディスク書き込みのワークロードが重い場合、この値を増やすことで保存プロセスを高速化できます。デフォルト値:4。
"background_feature_thread_num": 8
パススルーデータ設定
pass_through_data
いいえ
レスポンスにパススルーするデータを指定します。これはダウンストリームサービスに情報を渡すのに役立ちます。値は JSON オブジェクトである必要があります。
"pass_through_data": {"model_version": "20260513"}
-
-
以下のいずれかの方法で TorchEasyRec モデルサービスをデプロイします。
JSON (推奨)
以下の手順に従ってください。
PAI コンソールにログインします。ページ上部でリージョンを選択します。次に、目的のワークスペースを選択して、[Elastic Algorithm Service (EAS) に移動] をクリックします。
-
Elastic Algorithm Service (EAS) ページで、サービスのデプロイメント をクリックします。カスタムモデルのデプロイ セクションで、JSON 独立デプロイメント をクリックします。
-
JSON エディターに JSON 構成を貼り付け、デプロイメント をクリックします。
eascmd CLI
-
クライアントのダウンロードと認証を行います。以下の手順では、64 ビット Windows バージョンを例として使用します。
-
JSON ファイルが含まれるディレクトリから、以下のコマンドを実行してサービスを作成します。コマンドの詳細については、「コマンドリファレンス」をご参照ください。
eascmdwin64.exe create <service.json><service.json> をご利用の JSON ファイル名 (例:
torcheasyrec.json) に置き換えます。
ステップ 2:サービスの呼び出し
TorchEasyRec モデルサービスをデプロイした後、以下の手順に従ってサービス呼び出し情報を表示します。
-
PAI コンソールにログインし、ページ上部でリージョンを、右側でワークスペースを選択し、次に[EAS に移動]をクリックします。
-
対象のサービスのサービス方式列で呼び出し情報をクリックすると、サービスエンドポイントとトークンが表示されます。
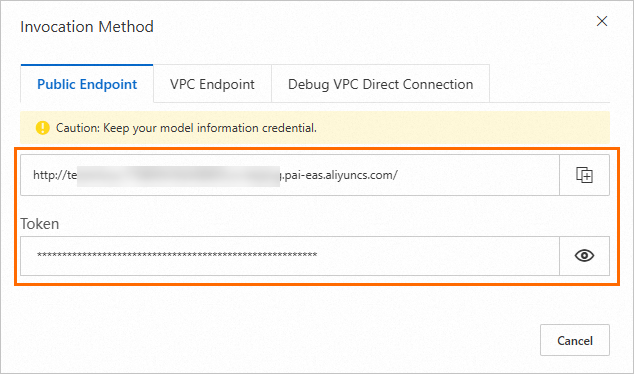
呼び出し情報 ダイアログボックスで [パブリックアドレス] タブを選択し、後続のサービス呼び出しで使用する [パブリックエンドポイント] と [トークン] を取得します。
TorchEasyRec モデルサービスは、入出力フォーマットとして Protobuf を使用します。FG が有効かどうかによって、2 つの呼び出し方法があります。
FG を使用する場合 (fg_mode='normal')
以下のいずれかの方法でサービスを呼び出すことができます。
EAS Java SDK
コードを実行する前に、Maven 環境を設定してください。詳細については、「Java SDK の使用方法」をご参照ください。Java SDK の最新バージョンについては、https://github.com/pai-eas/eas-java-sdk をご参照ください。以下のコードは、alirec_rank_with_fg サービスにリクエストを送信する方法を示しています。
package com.aliyun.openservices.eas.predict;

import com.aliyun.openservices.eas.predict.http.Compressor;
import com.aliyun.openservices.eas.predict.http.HttpConfig;
import com.aliyun.openservices.eas.predict.http.PredictClient;
import com.aliyun.openservices.eas.predict.proto.TorchRecPredictProtos;
import com.aliyun.openservices.eas.predict.request.TorchRecRequest;
import com.aliyun.openservices.eas.predict.proto.TorchPredictProtos.ArrayProto;

import java.util.*;


public class TorchRecPredictTest {
    public static PredictClient InitClient() {
        return new PredictClient(new HttpConfig());
    }

    public static TorchRecRequest buildPredictRequest() {
        TorchRecRequest TorchRecRequest = new TorchRecRequest();
        TorchRecRequest.appendItemId("7033");

        TorchRecRequest.addUserFeature("user_id", 33981,"int");

        ArrayList<Double> list = new ArrayList<>();
        list.add(0.24689289764507472);
        list.add(0.005758482924454689);
        list.add(0.6765301324940026);
        list.add(0.18137273055602343);
        TorchRecRequest.addUserFeature("raw_3", list,"List<double>");

        Map<String,Integer> myMap =new LinkedHashMap<>();
        myMap.put("866", 4143);
        myMap.put("1627", 2451);
        TorchRecRequest.addUserFeature("map_1", myMap,"map<string,int>");

        ArrayList<ArrayList<Float>> list2 = new ArrayList<>();
        ArrayList<Float> innerList1 = new ArrayList<>();
        innerList1.add(1.1f);
        innerList1.add(2.2f);
        innerList1.add(3.3f);
        list2.add(innerList1);
        ArrayList<Float> innerList2 = new ArrayList<>();
        innerList2.add(4.4f);
        innerList2.add(5.5f);
        list2.add(innerList2);
        TorchRecRequest.addUserFeature("click", list2,"list<list<float>>");

        TorchRecRequest.addContextFeature("id_2", list,"List<double>");
        TorchRecRequest.addContextFeature("id_2", list,"List<double>");

        System.out.println(TorchRecRequest.request);
        return TorchRecRequest;
    }

    public static void main(String[] args) throws Exception{
        PredictClient client = InitClient();
        client.setToken("tokenGeneratedFromService"); // サービスから生成されたトークン
        client.setEndpoint("175805416243****.cn-beijing.pai-eas.aliyuncs.com");
        client.setModelName("alirec_rank_with_fg");
        client.setRequestTimeout(100000);


        testInvoke(client);
        testDebugLevel(client);
        client.shutdown();
    }

    public static void testInvoke(PredictClient client) throws Exception {
        long startTime = System.currentTimeMillis();
        TorchRecPredictProtos.PBResponse response = client.predict(buildPredictRequest());
        for (Map.Entry<String, ArrayProto> entry : response.getMapOutputsMap().entrySet()) {

            System.out.println("Key: " + entry.getKey() + ", Value: " + entry.getValue());
        }
        long endTime = System.currentTimeMillis();
        System.out.println("Spend Time: " + (endTime - startTime) + "ms");

    }

    public static void testDebugLevel(PredictClient client) throws Exception {
        long startTime = System.currentTimeMillis();
        TorchRecRequest request = buildPredictRequest();
        request.setDebugLevel(1);
        TorchRecPredictProtos.PBResponse response = client.predict(request);
        Map<String, String> genFeas = response.getGenerateFeaturesMap();
        for(String itemId: genFeas.keySet()) {
            System.out.println(itemId);
            System.out.println(genFeas.get(itemId));
        }
        long endTime = System.currentTimeMillis();
        System.out.println("Spend Time: " + (endTime - startTime) + "ms");

    }
}
主要なパラメーターは以下の通りです。
-
client.setToken("tokenGeneratedFromService"):括弧内の値をサービス トークンに置き換えます。例:
MmFiMDdlO****wYjhhNjgwZmZjYjBjMTM1YjliZmNkODhjOGVi****。 -
client.setEndpoint("175805416243****.cn-beijing.pai-eas.aliyuncs.com"):括弧内の値をサービスのエンドポイントに置き換えます。例:
175805416243****.cn-beijing.pai-eas.aliyuncs.com。 -
client.setModelName("alirec_rank_with_fg"):括弧内の値をサービス名に置き換えます。
EAS Python SDK
コードを実行する前に、pip install -U eas-prediction --user コマンドを実行して eas-prediction ライブラリをインストールまたは更新してください。設定の詳細については、「Python SDK の使用」をご参照ください。ソースコードは https://github.com/pai-eas/eas-python-sdk/blob/master/eas_prediction/torchrec_request.py で確認できます。以下はサンプルコードです。
from eas_prediction import PredictClient
from eas_prediction.torchrec_request import TorchRecRequest


if __name__ == '__main__':
    endpoint = 'http://localhost:6016'

    client = PredictClient(endpoint, '<YOUR_SERVICE_NAME>')
    client.set_token('<your_service_token>')
    client.init()
    torchrec_req = TorchRecRequest()

    torchrec_req.add_user_fea('user_id', 'u001d', "STRING")
    torchrec_req.add_user_fea('age', 12, "INT")
    torchrec_req.add_user_fea('weight', 129.8, "FLOAT")
    torchrec_req.add_item_id('item_0001')
    torchrec_req.add_item_id('item_0002')
    torchrec_req.add_item_id('item_0003')
    torchrec_req.add_user_fea("raw_3", [0.24689289764507472, 0.005758482924454689, 0.6765301324940026, 0.18137273055602343], "list<double>")
    torchrec_req.add_user_fea("raw_4", [0.9965264740966043, 0.659596586238391, 0.16396649403055896, 0.08364986620265635], "list<double>")
    torchrec_req.add_user_fea("map_1", {"0":0.37845234405201145}, "map<int,float>")
    torchrec_req.add_user_fea("map_2", {"866":4143,"1627":2451}, "map<int,int>")
    torchrec_req.add_context_fea("id_2", [866], "list<int>" )
    torchrec_req.add_context_fea("id_2", [7022,1], "list<int>" )
    torchrec_req.add_context_fea("id_2", [7022,1], "list<int>" )
    torchrec_req.add_user_fea("click", [[0.94433516,0.49145547], [0.94433516, 0.49145597]], "list<list<float>>")

    res = client.predict(torchrec_req)
    print(res)
主要な設定は以下の通りです。
-
endpoint:このパラメーターをサービスのエンドポイントに設定します。例:
http://175805416243****.cn-beijing.pai-eas.aliyuncs.com/。 -
<your_service_name>:このプレースホルダーをサービス名に置き換えます。
-
<your_service_token>:このプレースホルダーをサービス トークンに置き換えます。例:
MmFiMDdlO****wYjhhNjgwZmZjYjBjMTM1YjliZmNkODhjOGVi****。
FG を使用しない場合 (fg_mode='bypass')
EAS Java SDK
コードを実行する前に、Maven 環境を設定してください。詳細については、「Java SDK の使用」をご参照ください。最新の SDK バージョンを取得するには、GitHub のプロジェクトをご参照ください。以下の例は、alirec_rank_no_fg サービスにリクエストを送信する方法を示しています。
package com.aliyun.openservices.eas.predict;

import java.util.List;
import java.util.Arrays;


import com.aliyun.openservices.eas.predict.http.PredictClient;
import com.aliyun.openservices.eas.predict.http.HttpConfig;
import com.aliyun.openservices.eas.predict.request.TorchDataType;
import com.aliyun.openservices.eas.predict.request.TorchRequest;
import com.aliyun.openservices.eas.predict.response.TorchResponse;

public class Test_Torch {
    public static PredictClient InitClient() {
        return new PredictClient(new HttpConfig());
    }

    public static TorchRequest buildPredictRequest() {
        TorchRequest request = new TorchRequest();
        float[] content = new float[2304000];
        for (int i = 0; i < content.length; i++) {
            content[i] = (float) 0.0;
        }
        long[] content_i = new long[900];
        for (int i = 0; i < content_i.length; i++) {
            content_i[i] = 0;
        }

        long[] a = Arrays.copyOfRange(content_i, 0, 300);
        float[] b = Arrays.copyOfRange(content, 0, 230400);
        request.addFeed(0, TorchDataType.DT_INT64, new long[]{300,3}, content_i);
        request.addFeed(1, TorchDataType.DT_FLOAT, new long[]{300,10,768}, content);
        request.addFeed(2, TorchDataType.DT_FLOAT, new long[]{300,768}, b);
        request.addFeed(3, TorchDataType.DT_INT64, new long[]{300}, a);
        request.addFetch(0);
        request.setDebugLevel(903);
        return request;
    }

    public static void main(String[] args) throws Exception {
        PredictClient client = InitClient();
        client.setToken("tokenGeneratedFromService"); // サービスから生成されたトークン
        client.setEndpoint("175805416243****.cn-beijing.pai-eas.aliyuncs.com");
        client.setModelName("alirec_rank_no_fg");
        client.setIsCompressed(false);
        long startTime = System.currentTimeMillis();
        for (int i = 0; i < 10; i++) {
            TorchResponse response = null;
            try {
                response = client.predict(buildPredictRequest());
                List<Float> result = response.getFloatVals(0);
                System.out.print("Predict Result: [");
                for (int j = 0; j < result.size(); j++) {
                    System.out.print(result.get(j).floatValue());
                    if (j != result.size() - 1) {
                        System.out.print(", ");
                    }
                }
                System.out.print("]\n");
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
        long endTime = System.currentTimeMillis();
        System.out.println("Spend Time: " + (endTime - startTime) + "ms");
        client.shutdown();
    }
}
主要なパラメーターは以下の通りです。
-
client.setToken("tokenGeneratedFromService"):プレースホルダーの値をサービス トークンに置き換えます。例:
MmFiMDdlO****wYjhhNjgwZmZjYjBjMTM1YjliZmNkODhjOGVi****。 -
client.setEndpoint("175805416243****.cn-beijing.pai-eas.aliyuncs.com"):プレースホルダーの値をサービスのエンドポイントに置き換えます。例:
175805416243****.cn-beijing.pai-eas.aliyuncs.com。 -
client.setModelName("alirec_rank_no_fg"):プレースホルダーの値をサービス名に置き換えます。
EAS Python SDK
コードを実行する前に、pip install -U eas-prediction --user を実行して eas-prediction ライブラリをインストールまたは更新してください。詳細については、「Python SDK の使用」をご参照ください。以下の例は、alirec_rank_no_fg サービスにリクエストを送信する方法を示しています。
from eas_prediction import PredictClient
from eas_prediction import TorchRequest

# snappy data
req = TorchRequest(False)

req.add_feed(0, [300, 3], TorchRequest.DT_INT64, [1] * 900)
req.add_feed(1, [300, 10, 768], TorchRequest.DT_FLOAT, [1.0] * 3 * 768000)
req.add_feed(2, [300, 768], TorchRequest.DT_FLOAT, [1.0] * 3 * 76800)
req.add_feed(3, [300], TorchRequest.DT_INT64, [1] * 300)


client = PredictClient('<your_endpoint>', '<your_service_name>')
client.set_token('<your_service_token>')

client.init()

resp = client.predict(req)
print(resp)
主要な設定は以下の通りです。
-
<your_endpoint>:このプレースホルダーをサービスのエンドポイントに置き換えます。例:
http://175805416243****.cn-beijing.pai-eas.aliyuncs.com/。 -
<your_service_name>:このプレースホルダーをサービス名に置き換えます。
-
<your_service_token>:このプレースホルダーをサービス トークンに置き換えます。例:
MmFiMDdlO****wYjhhNjgwZmZjYjBjMTM1YjliZmNkODhjOGVi****。
サービスステータスコードの詳細については、「サービスステータスコード」をご参照ください。サービスリクエストの作成については、「リクエストフォーマット」もご参照ください。
リクエストフォーマット
サービスを呼び出すには、.proto ファイルから予測リクエストコードを生成できます。または、リクエストを自分で作成する場合は、以下の Protobuf 定義を使用します。
pytorch_predict.proto: Torch モデル
syntax = "proto3";

package pytorch.eas;
option cc_enable_arenas = true;
option java_package = "com.aliyun.openservices.eas.predict.proto";
option java_outer_classname = "TorchPredictProtos";

enum ArrayDataType {
  // DataType の有効な値ではありません。DataType フィールドが設定されていないことを示すために使用されます。
  DT_INVALID = 0;

  // すべての計算デバイスがサポートすることが期待されるデータ型。
  DT_FLOAT = 1;
  DT_DOUBLE = 2;
  DT_INT32 = 3;
  DT_UINT8 = 4;
  DT_INT16 = 5;
  DT_INT8 = 6;
  DT_STRING = 7;
  DT_COMPLEX64 = 8;  // 単精度複素数
  DT_INT64 = 9;
  DT_BOOL = 10;
  DT_QINT8 = 11;     // 量子化 int8
  DT_QUINT8 = 12;    // 量子化 uint8
  DT_QINT32 = 13;    // 量子化 int32
  DT_BFLOAT16 = 14;  // 16 ビットに切り捨てられた Float32。キャスト操作のみ。
  DT_QINT16 = 15;    // 量子化 int16
  DT_QUINT16 = 16;   // 量子化 uint16
  DT_UINT16 = 17;
  DT_COMPLEX128 = 18;  // 倍精度複素数
  DT_HALF = 19;
  DT_RESOURCE = 20;
  DT_VARIANT = 21;  // 任意の C++ データ型
}

// 配列の次元。
message ArrayShape {
  repeated int64 dim = 1 [packed = true];
}

// 配列を表します。
message ArrayProto {
  // データ型。
  ArrayDataType dtype = 1;

  // 配列の形状。
  ArrayShape array_shape = 2;

  // DT_FLOAT。
  repeated float float_val = 3 [packed = true];

  // DT_DOUBLE。
  repeated double double_val = 4 [packed = true];

  // DT_INT32, DT_INT16, DT_INT8, DT_UINT8。
  repeated int32 int_val = 5 [packed = true];

  // DT_STRING。
  repeated bytes string_val = 6;

  // DT_INT64。
  repeated int64 int64_val = 7 [packed = true];

}


message PredictRequest {

  // 入力テンソル。
  repeated ArrayProto inputs = 1;

  // 出力フィルター。
  repeated int32 output_filter = 2;

  // レコメンデーションモデルの入力テンソル。
  map<string, ArrayProto> map_inputs = 3;

  // レコメンデーションモデルのデバッグレベル。
  int32 debug_level = 100;
}

// 成功した PredictRequest に対するレスポンス。
message PredictResponse {
  // 出力テンソル。
  repeated ArrayProto outputs = 1;
  // レコメンデーションモデルからの出力テンソル。
  map<string, ArrayProto> map_outputs = 2;
}
torchrec_predict.proto: FG を使用した Torch モデル
syntax = "proto3";

option go_package = ".;torch_predict_protos";
option java_package = "com.aliyun.openservices.eas.predict.proto";
option java_outer_classname = "TorchRecPredictProtos";
package com.alibaba.pairec.processor;
import "pytorch_predict.proto";

// int64 からのマッピング。
message LongStringMap {
  map<int64, string> map_field = 1;
}
message LongIntMap {
  map<int64, int32> map_field = 1;
}
message LongLongMap {
  map<int64, int64> map_field = 1;
}
message LongFloatMap {
  map<int64, float> map_field = 1;
}
message LongDoubleMap {
  map<int64, double> map_field = 1;
}

// string からのマッピング。
message StringStringMap {
  map<string, string> map_field = 1;
}
message StringIntMap {
  map<string, int32> map_field = 1;
}
message StringLongMap {
  map<string, int64> map_field = 1;
}
message StringFloatMap {
  map<string, float> map_field = 1;
}
message StringDoubleMap {
  map<string, double> map_field = 1;
}

// int32 からのマッピング。
message IntStringMap {
  map<int32, string> map_field = 1;
}
message IntIntMap {
  map<int32, int32> map_field = 1;
}
message IntLongMap {
  map<int32, int64> map_field = 1;
}
message IntFloatMap {
  map<int32, float> map_field = 1;
}
message IntDoubleMap {
  map<int32, double> map_field = 1;
}

// 1 階層のリスト。
message IntList {
  repeated int32 features = 1;
}
message LongList {
  repeated int64 features  = 1;
}

message FloatList {
  repeated float features = 1;
}
message DoubleList {
  repeated double features = 1;
}
message StringList {
  repeated string features = 1;
}

// ネストされたリスト。
message IntLists {
  repeated IntList lists = 1;
}
message LongLists {
  repeated LongList lists = 1;
}

message FloatLists {
  repeated FloatList lists = 1;
}
message DoubleLists {
  repeated DoubleList lists = 1;
}
message StringLists {
  repeated StringList lists = 1;
}

message PBFeature {
  oneof value {
    int32 int_feature = 1;
    int64 long_feature = 2;
    string string_feature = 3;
    float float_feature = 4;
    double double_feature=5;

    LongStringMap long_string_map = 6;
    LongIntMap long_int_map = 7;
    LongLongMap long_long_map = 8;
    LongFloatMap long_float_map = 9;
    LongDoubleMap long_double_map = 10;

    StringStringMap string_string_map = 11;
    StringIntMap string_int_map = 12;
    StringLongMap string_long_map = 13;
    StringFloatMap string_float_map = 14;
    StringDoubleMap string_double_map = 15;

    IntStringMap int_string_map = 16;
    IntIntMap int_int_map = 17;
    IntLongMap int_long_map = 18;
    IntFloatMap int_float_map = 19;
    IntDoubleMap int_double_map = 20;

    IntList int_list = 21;
    LongList long_list =22;
    StringList string_list = 23;
    FloatList float_list = 24;
    DoubleList double_list = 25;

    IntLists int_lists = 26;
    LongLists long_lists =27;
    StringLists string_lists = 28;
    FloatLists float_lists = 29;
    DoubleLists double_lists = 30;

  }
}

// コンテキスト特徴量。
message ContextFeatures {
  repeated PBFeature features = 1;
}

// アグリゲーターに送信されるリクエストを定義します。
message PBRequest {
  // デバッグレベル。
  int32 debug_level = 1;

  // ユーザー特徴量。入力名をキーとします。
  map<string, PBFeature> user_features = 2;

  // アイテム ID。
  repeated string item_ids = 3;

  // 各アイテムのコンテキスト特徴量。入力名をキーとします。
  map<string, ContextFeatures> context_features = 4;

  // Faiss から取得する最近傍の数。
  int32 faiss_neigh_num = 5;

  // 各アイテムのアイテム特徴量。入力名をキーとします。
  map<string, ContextFeatures> item_features = 6;

  // オプションのメタデータ。
  map<string, string> meta_data = 7;
}

// アグリゲーターからのレスポンスを定義します。
message PBResponse {
  // Torch の出力テンソル。
  map<string, pytorch.eas.ArrayProto> map_outputs = 1;

  // 特徴量ジェネレーター (FG) からの出力特徴量。
  map<string, string> generate_features = 2;

  // 特徴量ジェネレーター (FG) のすべての入力特徴量。
  map<string, string> raw_features = 3;

  // アイテム ID。
  repeated string item_ids = 4;

  // モデルで設定されたパススルーデータ。
  map<string, string> pass_through_data = 5;
}
debug_level パラメーターは以下の通りです。
設定はデバッグ時にのみ必要です。
|
値 |
説明 |
|
0 |
標準的な予測を実行します。 |
|
1 |
|
|
2 |
|
|
3 |
|
|
100 |
予測リクエスト (元のリクエスト、 |
|
102 |
|
|
903 |
各ステージの |
|
904 |
リクエストに欠落している |
サービスステータスコード
このセクションでは、TorchEasyRec サービスの主要なステータスコードについて説明します。EAS サービスのステータスコードについては、「付録:サービスステータスコードと一般的なエラー」をご参照ください。
|
ステータスコード |
説明 |
|
200 |
リクエストは成功しました。 |
|
400 |
無効なリクエストです。 |
|
500 |
予測に失敗しました。詳細については、サービスログを確認してください。 |
Protobuf リクエストの保存と解析
プロセッサバージョン 1.12 以降では、PAI-REC エンジンリクエストボディで debug=True を設定することでデバッグモードを有効にできます。これにより、元のリクエストとアイテムサイドの入出力特徴量が protobuf ファイルに保存され、分析と検証が可能になります。この機能を使用するには、request_log_path パラメーターを宛先パスに設定し、そのパスに OSS をマウントします。例:
"model_config": {
        "fg_mode": "normal",
        "fg_threads": 8,
        "request_log_path": "/request_log",
        "background_feature_thread_num": 8
},
 "storage": [
    {
        "mount_path": "/request_log",
        "oss": {
            "path": "oss://my-bucket/my-model/myrequests/",
            "readOnly": false
        }
    },
    {
        "mount_path": "/home/admin/docker_ml/workspace/model/",
        "oss": {
            "path": "oss://my-bucket/my-model/20260316",
            "readOnly": false
        }
    }
]プロセッサは、date_hour サブディレクトリを、request_log_path で指定されたパスに作成し、リクエストデータを保存します。 バックグラウンドスレッドが、このデータをディスクに非同期で書き込みます。 model_config.background_feature_thread_num パラメーターを使用して、バックグラウンドスレッドの数を設定します。 デフォルトは 4 で、この値を大きくすると書き込みスループットを向上させることができます。 ディスクに書き込まれる Protobuf ファイルは、<request_id>_<random_str>.pb というフォーマットになります。 OSS の書き込み帯域幅は限られているため、PAI-REC エンジンでリクエストボリュームが大きい場合は、デバッグモードを有効にしないでください。 ディスクへの書き込みが遅れた場合、モデルサービスの内部キューは新しいリクエストを破棄します。
protobuf ファイルを解析するには、EAS-Python-SDK 0.35 以降、または EAS-Java-SDK 2.0.29 以降を使用する必要があります。以下の例は、Python でこれを行う方法を示しています。
from eas_prediction.torchrec_predict_pb2 import PBLogData
with open('xxxx.pb', 'rb') as f:
    pb_data = f.read()
pb_log = PBLogData()
pb_log.ParseFromString(pb_data)
print(pb_log) # ログ全体を出力
print(pb_log.request) # リクエストを出力
print(pb_log.raw_features) # 生のアイテムサイド特徴量を出力
print(pb_log.generate_features) # 生成されたアイテムサイド特徴量を出力
モデルサービスのウォームアップ
モデルサービスが起動または更新されると、応答時間のスパイクが発生することがあります。これらのスパイクを軽減するために、プロセッサのウォームアップ機能を設定します。例えば、easyrec-torch-1.5 以降のバージョンでは、model_config に 3 つのパラメーターを追加することでこの機能を有効にできます。
"warmup_data_path": "/warmup",  # ウォームアップを有効にし、ウォームアップファイルのパスを設定します。
"warmup_cnt_per_file": 20, # ファイルごとのウォームアップ反復回数。値が大きいほど、より徹底的なウォームアップが行われます。
"warmup_pb_files_count": 64 # ウォームアップ用に保存するオンラインリクエストの数。値が大きいほど、より多くのデータパターンをカバーするのに役立ちます。
protobuf ファイルを永続化するには、storage セクションの warmup_data_path に OSS マウントを設定します。例:
"storage": [
    ...,
    {
        "mount_path": "/warmup",
        "oss": {
            "path": "oss://<warmup Protobuf file path>",
            "readOnly": false
        }
    }
]
設定後の最初の起動時に、プロセッサは warmup_pb_files_count で指定された数のオンラインリクエストをキャプチャして保存します。その後の再起動時には、これらの保存された protobuf ファイルを使用してウォームアップします。
オンライン学習のトレーニングとデプロイ
レコメンデーションや広告のシナリオでは、ユーザーの興味、アイテムの人気度、ビジネスデータは絶えず変化します。モデルは新しいフィードバック信号をタイムリーに取り込み、トレーニング結果をオンラインサービスに同期させる必要があります。オンライン学習は、継続的なトレーニングとパラメーター更新を通じて、新しいデータがトレーニングに参加してから予測結果に影響を与えるまでの時間を短縮します。
easyrec-torch-2.5 以降、TorchEasyRec プロセッサは分散埋め込み推論モードでの増分埋め込み更新と密モデルのホットアップデートをサポートします。TorchEasyRec トレーニングジョブと FeatureDB を組み合わせることで、パラメーター更新ごとに推論サービスを再起動または再デプロイすることなく、継続的なトレーニングからパラメーター公開、オンライン推論までのエンドツーエンドパイプラインを構築できます。TorchEasyRec はモデルパラメーターのトレーニングとエクスポートを担当し、FeatureDB は埋め込み更新データを保存・提供し、プロセッサは更新をオンライン推論に適用します。
仕組み
オンライン学習は、モデルの更新を 2 つのパスに分割します。
-
増分埋め込み更新:トレーニング側は変更された埋め込みをキャプチャし、FeatureDB に書き込みます。プロセッサは、推論に使用されるローカル埋め込みテーブルをプルして更新し、すべてのパラメーターを繰り返しロードするオーバーヘッドを削減します。このメカニズムは、浮動小数点と量子化埋め込みの両方をサポートし、トレーニング側で削除された動的埋め込みキーのクリーンアップもサポートします。
-
密モデルのホットアップデート:トレーニング側は新しい密モデルバージョンを公開します。プロセッサが更新を検出すると、互換性チェックとウォームアップを実行し、新しいバージョンにホットスワップします。ロードとウォームアップ中、既存のモデルは推論リクエストの処理を継続します。
2 つのパスを連携させるために、TorchEasyRec とプロセッサは、オンラインスコアリングの品質を確保するための Dense/Sparse 更新アライメントメカニズムを提供します。
使用方法
-
前提条件
-
TorchEasyRec:>= 1.4.3 以降
-
プロセッサ:>= easyrec-torch-2.5
-
プロセッサは NVIDIA GPU 環境で実行されます。
-
FeatureDB が有効化されています。プロジェクトを作成し、FeatureDB をオンラインデータソースとして設定します。
-
-
手順
-
トレーニングフェーズ
トレーニングフェーズは、プロセッサを初期化するための完全オフライン トレーニングと、プロセッサを継続的に更新するための増分オンライン トレーニングの 2 つのステップで構成されます。
-
完全オフラインデータトレーニング:以前と同じ方法でモデルをトレーニングし、分散モードでエクスポートします。
トレーニングコマンド:
torchrun --master_addr=localhost --master_port=<port> \
    --nnodes=1 --nproc-per-node=1 --node_rank=0 \
    -m tzrec.train_eval \
    --pipeline_config_path ${work_dir}/your_training_config.config \
    --train_input_path ${data_dir}/\*.parquet \
    --eval_input_path ${data_dir}\*.parquet \
    --model_dir ${work_dir}/your_model_dir
エクスポートコマンド:
USE_DISTRIBUTED_EMBEDDING環境変数を 1 に設定します。量子化が必要な場合は、DIST_QUANT=INT8も設定します。export USE_DISTRIBUTED_EMBEDDING=1 torchrun --master_addr=localhost --master_port=<port> \ --nnodes=1 --nproc-per-node=1 --node_rank=0 \ -m tzrec.export \ --pipeline_config_path ${model_dir}/pipeline.config \ --export_dir ${model_dir}/export_dist # 完全オフライン トレーニングのエクスポートディレクトリ。このディレクトリはオンライン トレーニング中にも指定する必要があります。 -
オンライン増分トレーニング:埋め込みデータを継続的に FeatureDB にアップロードし、密モデルを継続的に OSS にエクスポートします。
埋め込みデータを継続的に FeatureDB にアップロードするには、トレーニング設定の
train_configフィールドに以下の設定を追加します。```protobuf train_config{ delta_embedding_dump_config { paired_dump_interval_minutes: 5 # 必須。全体的な周波数スイッチ。5 分ごとに密モデルをエクスポートし、デルタ埋め込みもダンプしてアップロードします。 sparse_dump_interval_minutes: 1 # オプション。スパース埋め込みの詳細な周波数スイッチ。埋め込みをより頻繁にアップロードします。 quant_type: DELTA_EMBEDDING_QUANT_INT8 feature_store_config { region: "cn-beijing" project_name: "dynemb_test" feature_view_name: "demo_dynemb_feature_view" version: "20260725" } } } ```パラメーターの説明:
paired_dump_interval_minutes
オンライン学習の全体的な頻度。N 分ごとに、その間隔で変更された埋め込みを収集してフィーチャーストアにアップロードし、密モデルのスナップショットもエクスポートすることを指定します。
sparse_dump_interval_minutes
スパース埋め込みアップロードの詳細な頻度。M 分ごとに、その間隔で変更された埋め込みを収集してフィーチャーストアにアップロードしますが、密モデルのスナップショットはエクスポートしません。このパラメーターはオプションです。設定する場合、paired_dump_interval_minutes より小さくする必要があります。
paired_dump_interval_steps / sparse_dump_interval_steps
上記と同じですが、分ではなくトレーニングステップを頻度の基準として使用します。分ベースのパラメーターとは相互に排他的です。
quant_type
量子化タイプ。有効な値:
DELTA_EMBEDDING_QUANT_NONE (量子化なし)
DELTA_EMBEDDING_QUANT_INT8 (INT8 量子化)
デフォルトでは量子化は無効です。モデルが大きい場合は有効にすることを推奨します。
feature_store_config
region
FeatureDB が有効化されているリージョン。例:cn-beijing。
project_name
事前に作成されたフィーチャーストアプロジェクトの名前。
feature_view_name
特徴量ビューの名前。存在しない場合、システムが自動的に作成します。
version
現在のトレーニングバージョン番号。オンライン トレーニングは、このバージョンで指定されたデータプールに埋め込みデータをアップロードします。これはフィーチャーストアによって管理されます。プロセッサもこのバージョンを指定する必要があります。
トレーニングコマンド:
export ALIBABA_CLOUD_ACCESS_KEY_ID=お使いのキー
export ALIBABA_CLOUD_ACCESS_KEY_SECRET=お使いのシークレット
export FEATUREDB_USERNAME=お使いの fdb ユーザー
export FEATUREDB_PASSWORD=お使いの fdb パスワード

export ONLINE_DENSE_EXPORT=1
export USE_DISTRIBUTED_EMBEDDING=1
export ONLINE_DENSE_EXPORT_DIR=オフラインエクスポートディレクトリのフルパス
export ONLINE_DENSE_EXPORT_KEEP_VERSIONS=20

torchrun --master_addr=localhost --master_port=32555 \
    --nnodes=1 --nproc-per-node=1 --node_rank=0 \
    -m tzrec.train_eval \
    --pipeline_config_path online_train.config \
    --continue_train \
    --train_input_path /<data_dir>/\*.parquet \
    --eval_input_path /<data_dir>/\*.parquet \
    --model_dir お使いのモデルディレクトリ
環境変数の説明:
ONLINE_DENSE_EXPORT=1
密モデルの継続的なエクスポートを有効にします。
USE_DISTRIBUTED_EMBEDDING=1
スパース/密分離による分散エクスポートを有効にします。
ONLINE_DENSE_EXPORT_DIR
完全オフラインエクスポートのディレクトリ。
ONLINE_DENSE_EXPORT_KEEP_VERSIONS
エクスポートされた密モデルのクリーンアップを制御します。デフォルト値:0 (クリーンアップなし)。0 より大きい値に設定すると、システムは最新の K バージョンを保持します。K の最小値は 3 です。これにより、ファイルが多すぎることによる過剰なリソース使用量を防ぎます。
-
-
推論フェーズ
プロセッサの設定:
"model_config": {
        "fg_mode": "normal",
        "featuredb_username": "your user",
        "featuredb_password": "your pw",
        "access_key_id": "your ak",
        "access_key_secret": "your as",
        "region": "your region"
        "fs_project": "your fs project",

        "dense_hot_load": {
            "enable": true,
            "dense_poll_interval_minutes": 1
        },
        "feature_store_embedding_polling": {
            "feature_view_name": "your feature view name",
            "mode": "apply",
            "version": "your feature store version",
            "sparse_poll_interval_secs": 10
        }
    },
    "processor": "easyrec-torch-2.5",
パラメーターの説明:
dense_hot_load
enable: true
プロセッサがモデルディレクトリをポーリングするように有効にします。新しい密モデルが検出されると、プロセッサは自動的にそれをロードして切り替えます。切り替える前に、プロセッサは FeatureDB からデータをプルしてスパース埋め込みを同期します。
dense_poll_interval_minutes
プロセッサがモデルディレクトリをポーリングする頻度 (分単位)。デフォルト値:1。
feature_store_embedding_polling
feature_view_name
埋め込み更新をポーリングする特徴量ビューの名前。
mode
更新モード。このパラメーターを
applyに設定します。version
トレーニング設定と一致するフィーチャーストアのバージョン。
sparse_poll_interval_secs
プロセッサがフィーチャーストアをポーリングしてスパース埋め込みの更新を確認する間隔 (秒単位)。デフォルト値:10。
-