このトピックでは、サービスを呼び出すときに返されるステータスコードと一般的なエラーについて説明します。
ステータスコードの説明
|
ステータスコード |
説明 |
|
200 |
サービスはリクエストを正常に処理しました。 |
|
400 |
リクエストボディの形式が正しくないか、カスタムプロセッサのコードで例外が発生しました。 説明
カスタムプロセッサのコードが例外をスローすると、サーバーは 400 ステータスコードを返します。これを他のエラーと区別するには、例外に対して特定のステータスコードを返すようにカスタムプロセッサを設定してください。 |
|
401 |
サービスの認証に失敗しました。詳細については、「401 認証失敗」をご参照ください。 |
|
404 |
サービスが見つかりません。詳細については、「404 Not Found」をご参照ください。 |
|
405 |
許可されていないメソッドです。たとえば、GET リクエストのみをサポートするサーバーに POST リクエストを送信すると、サーバーは 405 エラーを返します。別の HTTP メソッドを使用してみてください。 |
|
408 |
リクエストがタイムアウトしました。サーバーには、各リクエストに対してデフォルトで 5 秒のタイムアウトがあります。これは、サービスの作成時に JSON ファイルの 説明
単一リクエストの合計処理時間には、プロセッサの計算時間、ネットワークデータパケットの受信時間、およびキューでの待機時間が含まれます。 |
|
429 |
リクエストがレート制限をトリガーしました。
|
|
450 |
|
|
499 |
クライアントが接続を閉じました。クライアントが自発的に接続を閉じた場合、クライアントは 499 ステータスコードを受信しません。代わりに、サーバーはその接続からの未処理のリクエストを 499 ステータスコードでログに記録します。たとえば、クライアントの HTTP タイムアウトが 30 ms で、サーバー側の処理レイテンシーが 50 ms の場合、クライアントは 30 ms 後にリクエストを破棄して接続を閉じます。その後、サーバー側のモニタリングに 499 ステータスコードが表示されます。 |
|
500 |
内部サーバーエラー。サーバーがリクエストの実行を妨げる予期しない状態に遭遇しました。 |
|
501 |
実装されていません。サーバーは、リクエストを実行するために必要な機能をサポートしていません。 |
|
502 |
不正なゲートウェイ。ゲートウェイまたはプロキシとして機能しているサーバーが、アップストリームサーバーから無効な応答を受信しました。 |
|
503 |
サービスが利用できません。ゲートウェイ経由でサービスにアクセスする際、すべてのバックエンドサービスインスタンスが Ready 状態でない場合、ゲートウェイは 503 ステータスコードを返します。詳細については、「503 no healthy upstream」をご参照ください。 |
|
504 |
ゲートウェイタイムアウト。詳細については、「504 timeout」をご参照ください。 |
|
505 |
サポートされていない HTTP バージョンです。サーバーは、リクエストで使用された HTTP プロトコルのバージョンをサポートしていません。 |
SDK 呼び出しのエラーコード
公式の EAS SDK を使用してサービスを呼び出す場合、SDK は独自のエラーコードを生成することがあり、これはサーバーが返すコードとは異なる場合があります。常にゲートウェイとサービスログのエラーコードを正として参照してください。
|
ステータスコード |
説明 |
|
512 |
EAS Golang SDK を使用している場合、クライアントが自発的に切断すると、SDK は 512 エラーコードを返します。このクライアント側のタイムアウトは、サーバー側の 499 ステータスコードに対応します。 |
一般的なエラー
404 Not Found
404 エラーは通常、無効なリクエストパス、正しくないリクエストボディ、またはサービスがサポートしていない API を示します。受信した特定のエラーメッセージに基づいて、次のシナリオを使用してトラブルシューティングを行ってください。
エラータイプ 1: {"object":"error","message":"The model `` does not exist.","type":"NotFoundError","param":null,"code":404}
原因: vLLM でデプロイされたサービスの /v1/chat/completions エンドポイントを呼び出す際に、リクエストボディの model パラメーターが空または無効です。
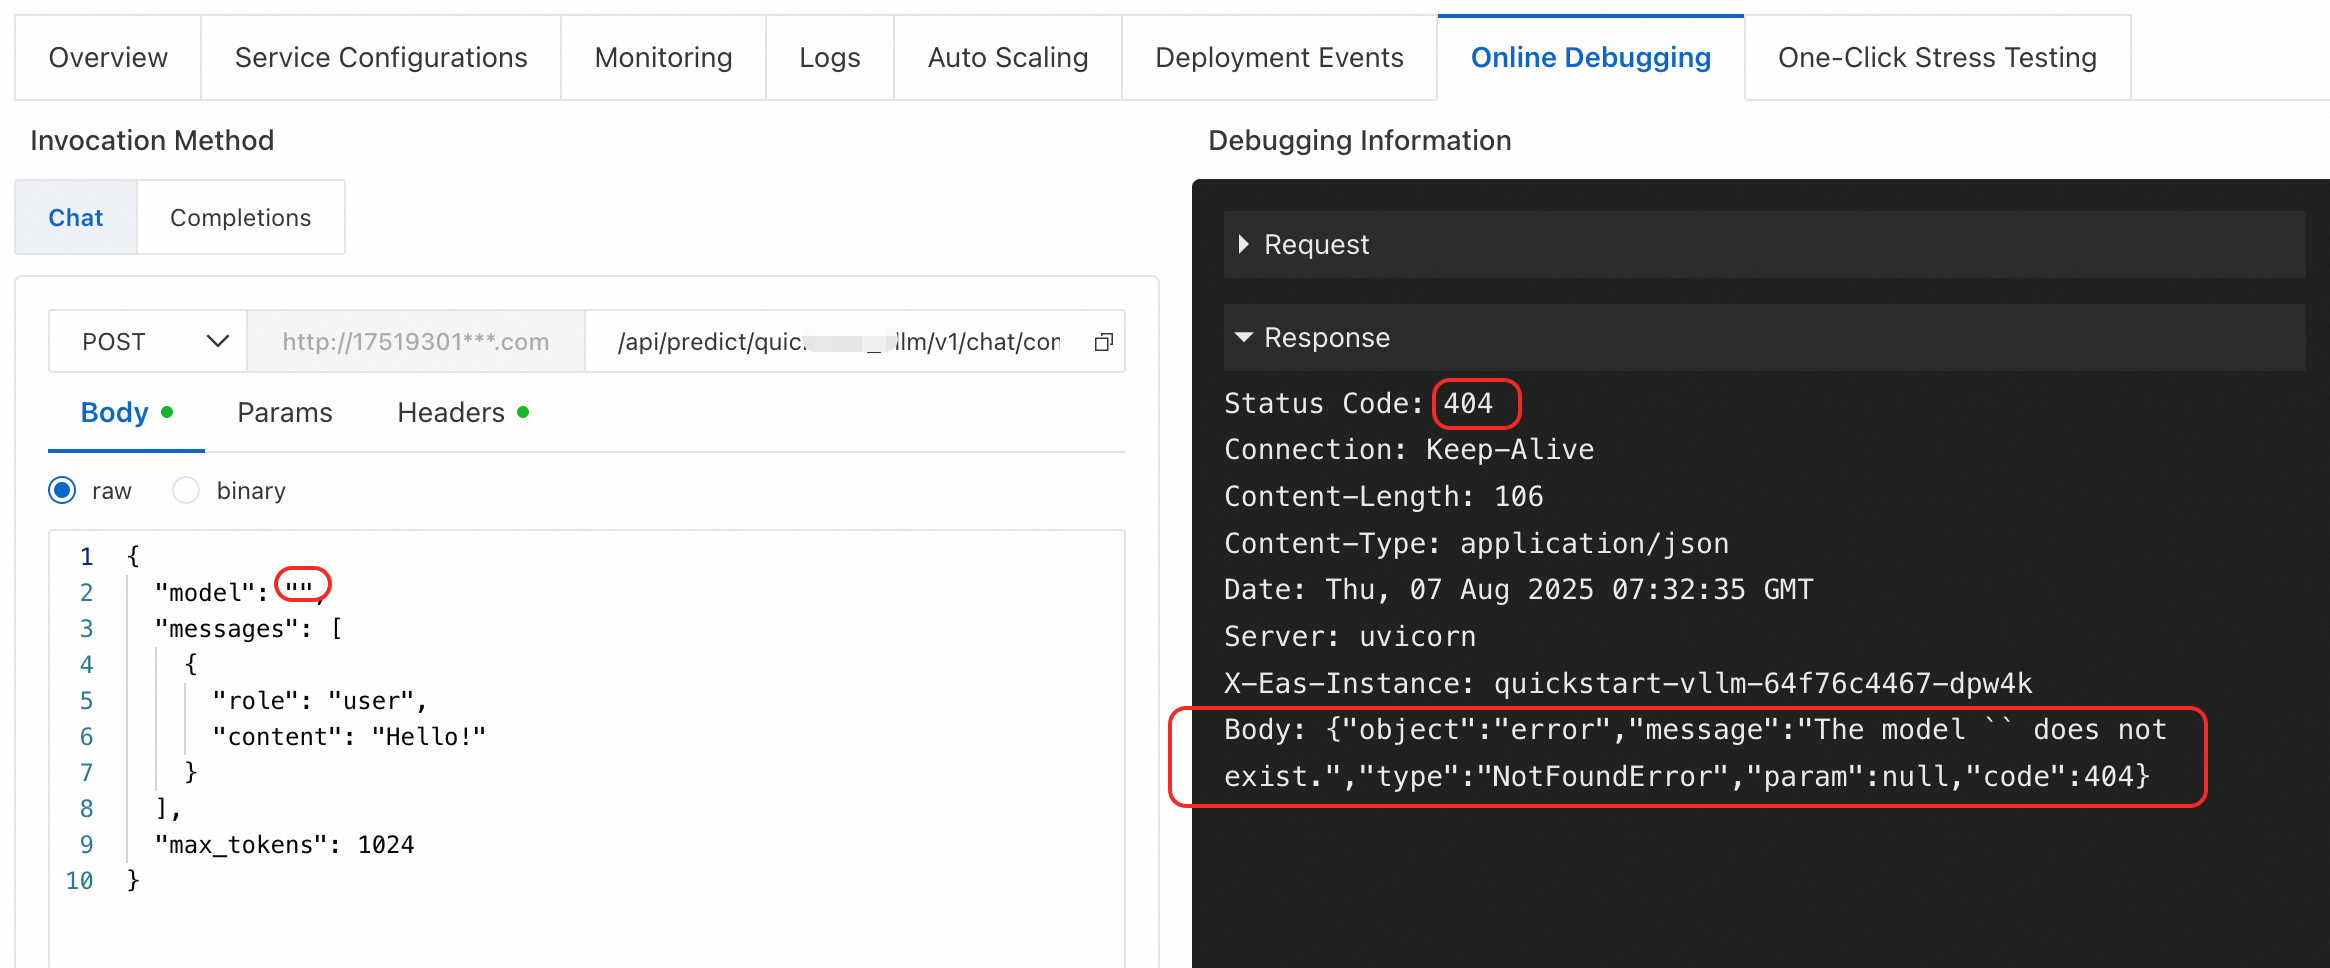
解決策: model パラメーターの値は、有効なモデル名である必要があります。v1/models エンドポイントを使用して、有効なモデル名を照会してください。
エラータイプ 2: {"detail":"Not Found"}
原因:リクエストパスが不完全または正しくありません。たとえば、LLM サービスのチャットエンドポイントを呼び出す際に、ベース URL に v1/chat/completions パスを追加していません。
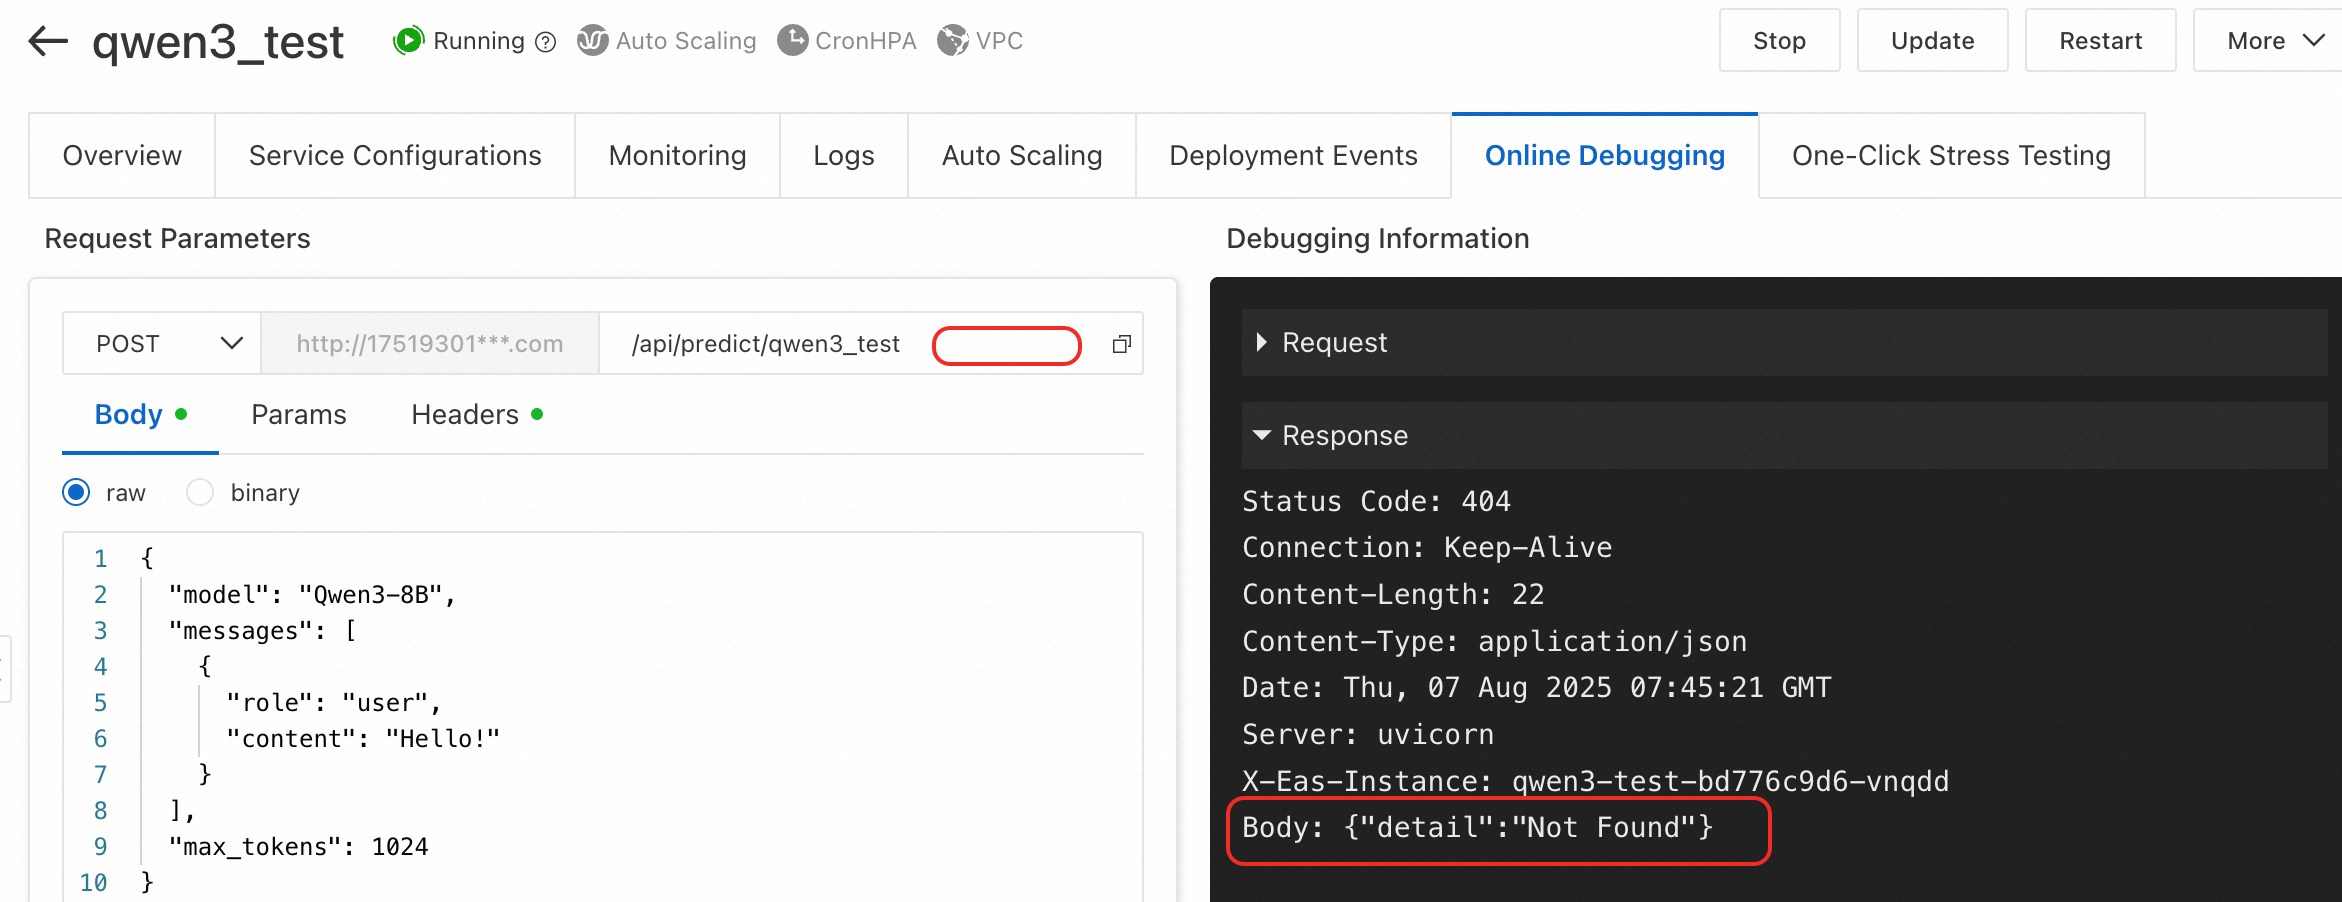
解決策: API リクエストパスが完全かつ正しいことを確認してください。LLM サービスについては、「LLM サービスの呼び出し」をご参照ください。
エラータイプ 3:BladeLLM の /v1/models エンドポイントを呼び出すと 404: Not Found が返される
原因: BladeLLM でデプロイされたサービスは、v1/models エンドポイントをサポートしていません。
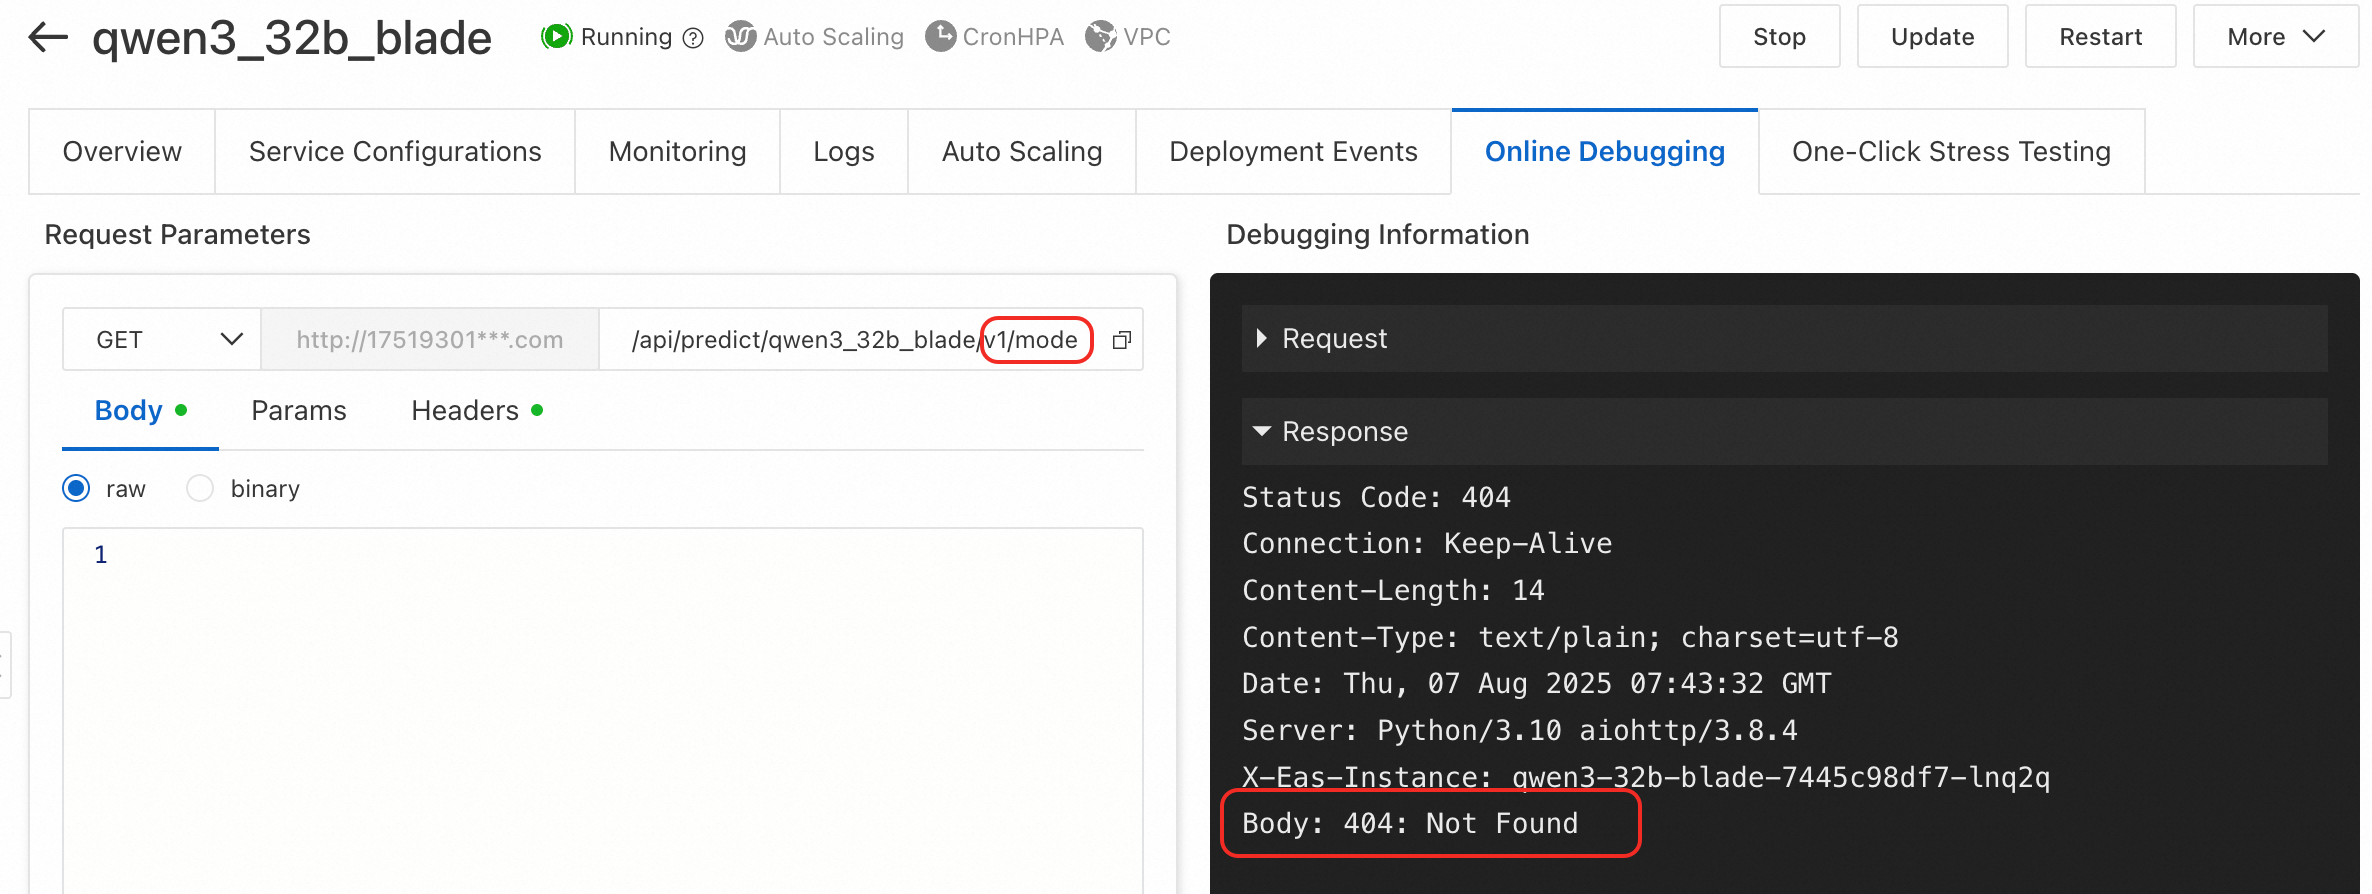
解決策:サポートされている API のリストについては、「BladeLLM サービス呼び出しのパラメーター設定」をご参照ください。
エラータイプ 4:オンラインデバッグページで 404 エラーが返され、他の情報が表示されない
原因:リクエストパスが正しくありません。オンラインデバッグを使用する場合、ベース URL は通常 http://123***.cn-hangzhou.pai-eas.aliyuncs.com/predict/service_name です。URL のサービス名部分を誤って変更または削除すると、404 エラーが発生します。
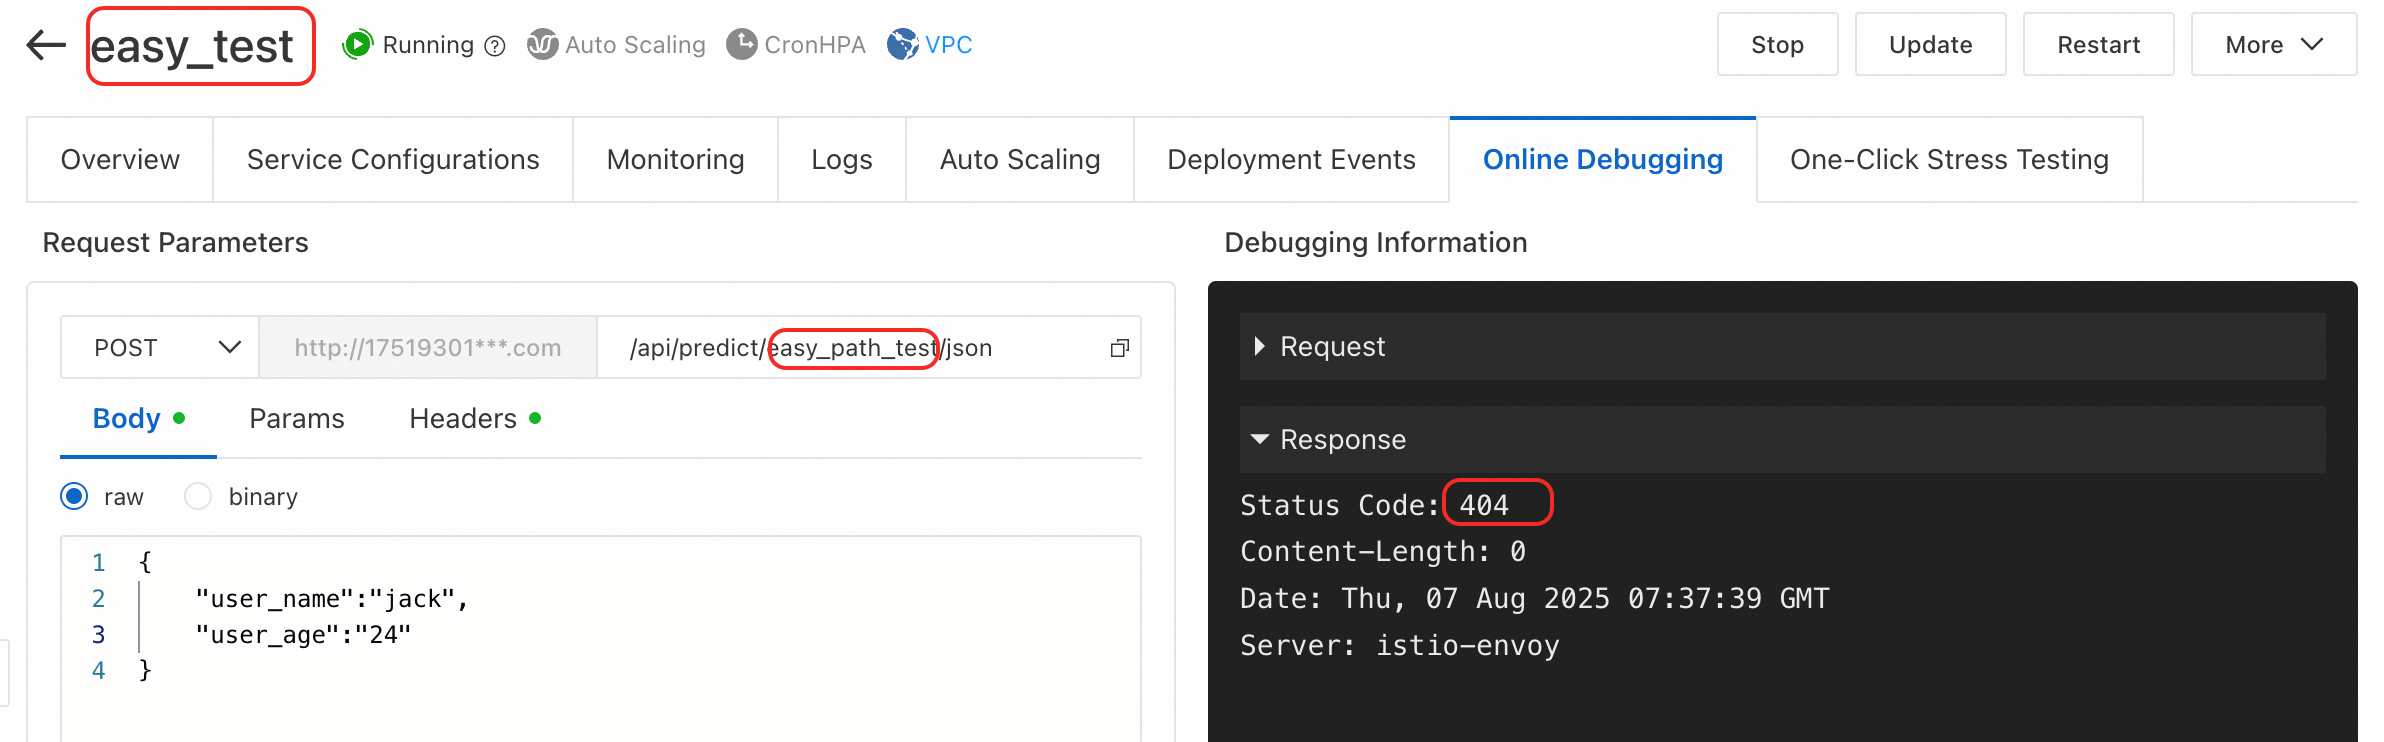
解決策:オンラインデバッグを使用する場合、通常、デフォルトの URL を変更または削除する必要はありません。呼び出す必要がある特定の API パスを追加してください。
エラータイプ 5:ComfyUI への API 呼び出しで "404 not found page" が返される
400 Bad Request
リクエストボディの形式が正しくありません。JSON 構造、フィールド名、データ型など、リクエストボディの形式を注意深く確認してください。
401 認証失敗
認証トークンが見つからない、正しくない、または不適切に使用されています。以下を確認してください:
-
トークンが正しいかどうかを確認します。サービスの [Overview] ページで、[Basic Information] セクションの [View Invocation Information] をクリックします。
説明デフォルトでは、サービスは自動的に認証トークンを生成します。カスタムトークンを指定し、サービスの更新時にそれを更新することもできます。
-
トークンが正しく設定されているかを確認します。
-
curlコマンドを使用する場合、トークンを HTTP ヘッダーのAuthorizationフィールドに追加します。例:curl -H 'Authorization: NWMyN2UzNjBiZmI2YT***' http:// xxx.cn-shanghai.aliyuncs.com/api/predict/echo。 -
サービスにアクセスするために SDK を使用する場合、対応する
SetToken()関数を呼び出します。詳細については、「Java SDK の使用手順」をご参照ください。
-
504 timeout
ゲートウェイまたはプロキシとして機能しているサーバーが、アップストリームサーバーから時間内に応答を受信しませんでした。これは通常、モデル推論に時間がかかりすぎていることを意味します。この問題を解決するには:
-
クライアントコードで、HTTP リクエストのタイムアウトを増やしてください。
-
長時間実行されるタスクには、バッチまたは長時間実行される推論タスクを処理するように設計されている EAS Queue Service (非同期呼び出し) モードを使用してください。
450:キュー満杯によるリクエスト破棄
サーバー側のコンピューティングインスタンスがリクエストを受信すると、まずリクエストをキューに配置します。インスタンス内のワーカーが利用可能になると、キューからデータを取得して処理します。ワーカーのデフォルト数は 5 で、サービス作成時の JSON ファイルの metadata.rpc.worker_threads フィールドを使用して調整できます。ワーカーの処理時間が長すぎると、リクエストがキューに蓄積される可能性があります。キューが満杯になると、インスタンスは新しいリクエストを即座に 450 ステータスコードで拒否し、過剰なキューイングによるレイテンシーの増加やサービスの利用不能を防ぎます。デフォルトのキューの長さは 64 で、サービス作成時の JSON ファイルの metadata.rpc.max_queue_size フィールドを使用して調整できます。
キューの長さを制限することは、トラフィックスパイクによるサービスのカスケード障害を防ぐためのレート制限の一形態としても機能します。
解決策:
-
少数の 450 ステータスコードを受信した場合は、リクエストを再試行できます。サーバー側のインスタンスは独立しているため、再試行は混雑の少ないインスタンスにルーティングされる可能性があり、クライアント側ではこの問題は意識されません。ただし、無期限に再試行しないでください。これはレート制限保護の目的を損なうことになります。
-
すべてのリクエストが 450 ステータスコードを返す場合、プロセッサ内のコードがスタックしている可能性があります。すべてのワーカーがリクエストの処理中にデッドロックし、キューからデータを取得しなくなった場合は、プロセッサのコードをデバッグしてバグを見つける必要があります。
503 no healthy upstream
オンラインデバッグ中に、「no healthy upstream」というメッセージとともに 503 エラーが表示されます:

次のように問題をトラブルシューティングしてください:
-
インスタンスのステータスを確認します。インスタンスが停止している場合は、[Restart Service] を実行してください。
-
サービスのステータスが [Running] の場合、インスタンスのリソース (CPU、メモリ、GPU メモリなど) が不足している可能性があり、バッファースペースの不足につながります。
-
パブリックリソースを使用している場合は、オフピーク時間にもう一度呼び出しを試みるか、別のリソース仕様またはリージョンに切り替えてください。
-
専用リソース (EAS リソースグループ) を使用している場合は、リソースグループがインスタンス用に十分な CPU、メモリ、および GPU メモリを予約していることを確認してください。バッファとして少なくとも 20% のリソースを空けておくことを推奨します。
-
-
もう 1 つの一般的なシナリオは、サービスのステータスが「Running」であり、デプロイ後にすべてのインスタンスが Ready である場合です。しかし、リクエストがコード内のバグをトリガーし、バックエンドサービスインスタンスがクラッシュして応答しなくなります。この状況では、ゲートウェイはクライアントに 503 ステータスコードを返します。バグを特定して修正するには、ログを使用してください。
エラー:Unexpected token 12606 while expecting start token 200006
vllm を使用して gpt-oss をデプロイすると、サービスの呼び出しで次のエラーが返されることがあります:
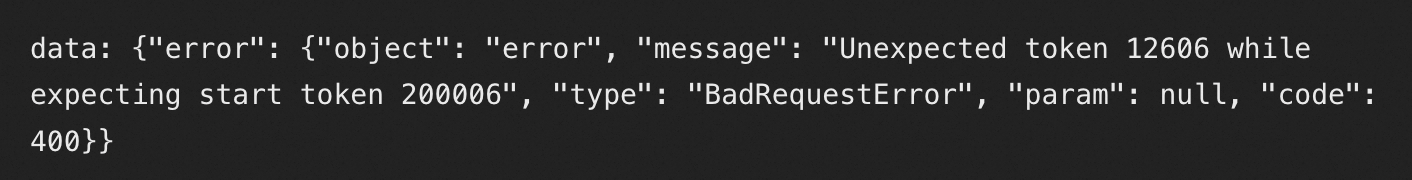
解決策:SGLang アクセラレーションを使用してデプロイしてみてください。
curl 呼び出しエラー: no URL specified
次のコマンドでリクエストを送信した後、no URL specified エラーが表示されます:
curl -X http://17****.cn-hangzhou.pai-eas.aliyuncs.com/api/predict/service_name/**path** \
-H "Content-Type: application/json" \
-H "Authorization: **********==" \
-d '{"***":"****"}'原因: curl コマンドは -X フラグを使用していますが、POST などのメソッドが欠落しています。
呼び出しで ASCII エンコーディングが返される問題
次のようにコードを変更してください:
from flask import Flask, Response

@app.route('/hello', methods=['POST'])
def get_advice():
    result = "result"
    return Response(result, mimetype='text/plain', charset='utf-8')
サービスログの「[WARN] connection is closed: End of file」または「Write a Invalid stream: End of file」を解決する方法
この警告ログは、クライアントまたはサーバーが接続を閉じ、サーバーがその閉じた接続に応答を書き込もうとしていたことを示します。接続は 2 つの方法で閉じることができます:
-
サーバー側のタイムアウト:プロセッサモードでは、デフォルトのサーバー側タイムアウトは 5 秒です。これは、サービスの
metadata.rpc.keepaliveパラメーターを使用して変更できます。タイムアウトに達すると、サーバーは接続を閉じ、モニタリングに 408 ステータスコードを記録します。 -
クライアント側のタイムアウト:呼び出し元のコードの設定によって、クライアント側のタイムアウトが決まります。クライアントが設定されたタイムアウト期間内に HTTP 応答を受信しない場合、クライアントは自発的に接続を閉じます。その後、サーバーはモニタリングに 499 ステータスコードを記録します。
upstream connect error or disconnect/reset before headers. reset reason: connection termination
持続的な接続タイムアウトやインスタンス負荷の不均衡などの問題が、通常このエラーを引き起こします。サーバー側の処理時間がクライアントで設定された HTTP タイムアウトを超えると、クライアントはリクエストを破棄し、自発的に接続を閉じます。その後、サーバー側のモニタリングに 499 ステータスコードが表示されます。モニタリングメトリックを確認すると、さらに詳細がわかります。時間のかかる推論タスクについては、非同期推論サービスをデプロイしてください。
Tensorflow/Pytorch プロセッサでデプロイされたサービスのオンラインデバッグの失敗を解決する方法
パフォーマンス上の理由から、TensorFlow/PyTorch プロセッサはリクエストボディに非プレーンテキストの protobuf 形式を使用します。現在、オンラインデバッグはプレーンテキスト入力のみをサポートしています。したがって、これらのプロセッサでデプロイされたサービスをコンソールで直接デバッグすることはできません。提供されている EAS SDK を使用してサービスを呼び出してください。さまざまな言語の SDK については、「サービス呼び出し SDK」をご参照ください。