このトピックでは、Data Lake Formation (DLF)、Realtime Compute for Apache Flink、StarRocks を使用してストリーミングデータレイクハウスを構築する方法について説明します。
背景情報
ビジネスのデジタルトランスフォーメーションが加速するにつれて、タイムリーなデータへの需要はかつてないほど高まっています。従来のオフラインデータウェアハウスは、時間指定スケジューリングジョブに依存して、オペレーショナルデータストア (ODS)、データウェアハウス詳細 (DWD)、データウェアハウスサービス (DWS)、およびアプリケーションデータサービス (ADS) レイヤーにデータを増分的に追加します。このモデルには主に 2 つの課題があります。第一に、レイテンシーが高いことです。スケジューリングサイクルは通常、時間または日単位であるため、データコンシューマーはリアルタイムの情報を取得できません。第二に、コストが高いことです。データの更新はパーティションの上書きに依存します。システムは元のデータを再読み込みして変更をマージする必要があり、大量のコンピューティングリソースを消費します。
Flink と DLF に基づいてストリーミングデータレイクハウスを構築することは、これらの課題に対する効果的なソリューションです。Flink は、データウェアハウスの異なるレイヤー間でデータをリアルタイムに流すことを可能にします。DLF は、効率的なデータ更新メカニズムを使用して、ダウンストリームのコンシューマーが分単位のレイテンシーで最新のデータ変更を取得できるようにします。このアーキテクチャは、データ遅延を大幅に削減し、ストレージとコンピューティングのコストを削減します。
プロダクトの特徴の詳細については、「利点」をご参照ください。
アーキテクチャと利点
アーキテクチャ
Flink は、大規模なリアルタイムデータの効率的な処理をサポートする強力なストリームコンピューティングエンジンです。DLF は、ストリーム処理とバッチ処理のための統一されたレイクストレージフォーマットとして Paimon を使用します。Paimon は、高スループットの更新と低レイテンシーのクエリをサポートします。Paimon は Flink と深く統合されており、統合されたストリーミングデータレイクハウスソリューションを提供します。
Flink はデータソースから Paimon にデータを書き込み、ODS レイヤーを形成します。
Flink は ODS レイヤーから changelog データをサブスクライブし、データを処理して、再度 Paimon に書き込み、DWD レイヤーを形成します。
Flink は DWD レイヤーから changelog データをサブスクライブし、データを処理して、再度 Paimon に書き込み、DWS レイヤーを形成します。
最後に、オープンソースの E-MapReduce の StarRocks が Paimon の外部テーブルを読み取り、アプリケーションにクエリサービスを提供します。

利点
このソリューションには、次の利点があります:
Paimon データの各レイヤーは、分単位のレイテンシーでダウンストリームシステムに変更を伝播できます。これにより、従来のオフラインデータウェアハウスのレイテンシーが時間単位、さらには日単位から分単位に短縮されます。
Paimon データの各レイヤーは、パーティションを上書きすることなく変更データを直接受け入れることができます。これにより、従来のオフラインデータウェアハウスでのデータ更新と修正のコストが大幅に削減されます。また、中間レイヤーのデータのクエリ、更新、修正が困難であるという問題も解決します。
モデルが統一され、アーキテクチャが簡素化されます。抽出、変換、書き出し (ETL) パイプラインロジックは Flink SQL に基づいて実装されます。ODS、DWD、DWS レイヤーのデータは Paimon に一元的に保存されます。これにより、アーキテクチャの複雑さが軽減され、データ処理の効率が向上します。
このソリューションは、Paimon の 3 つのコア機能に依存しています。詳細は次の表をご参照ください。
Paimon のコア機能 | 詳細 |
プライマリキーテーブルの更新 | Paimon は、基盤となるレイヤーで Log-structured Merge-tree (LSM) データ構造を使用して、効率的なデータ更新を実現します。 Paimon のプライマリキーテーブルと Paimon の基盤となるデータ構造の詳細については、「Primary Key Table」および「File Layouts」をご参照ください。 |
Changelog プロデューサー | Paimon は、任意の入力データストリームに対して完全な changelog データを生成できます。すべての update_after データには対応する update_before データがあります。これにより、データの変更がダウンストリームシステムに完全に渡されることが保証されます。詳細については、「Changelog プロデューサー」をご参照ください。 |
マージエンジン | Paimon のプライマリキーテーブルが同じプライマリキーを持つ複数のデータを受け取ると、Paimon の結果テーブルはこれらのデータを 1 つにマージして、プライマリキーの一意性を維持します。Paimon は、重複排除、部分更新、事前集約など、さまざまなデータマージ動作をサポートします。詳細については、「マージエンジン」をご参照ください。 |
ベストプラクティス
この例では、e コマースプラットフォーム向けのストリーミングデータレイクハウスを構築して、データを処理およびクレンジングし、上位レイヤーのアプリケーションからデータをクエリする方法を示します。これにより、データが階層化および再利用され、トランザクションダッシュボードのデータ分析、行動データ分析、ユーザープロファイルタギング、パーソナライズされた推奨などの複数のビジネスシナリオをサポートするレポートクエリが可能になります。

ODS レイヤーの構築:ビジネスデータベースのデータをリアルタイムでデータウェアハウスにインジェストします MySQL データベースには、orders、orders_pay、product_catalog というビジネステーブルが含まれています。Realtime Compute for Apache Flink は、これらのテーブルのデータをリアルタイムで Object Storage Service (OSS) に書き込み、Apache Paimon 形式でデータを保存して ODS レイヤーを形成します。
DWD レイヤーの構築:ワイドテーブル Realtime Compute for Apache Flink は、Apache Paimon の部分更新データマージメカニズムを使用して、orders、orders_pay、product_catalog テーブルのデータを DWD レイヤーのワイドテーブルに結合し、分単位のレイテンシーで changelog を生成します。
DWS レイヤーの構築:メトリック計算 Realtime Compute for Apache Flink は、ワイドテーブルの changelog をリアルタイムで消費し、Apache Paimon の集約データマージメカニズムを使用して、データウェアハウス中間 (DWM) レイヤーに dwm_users_shops という名前のユーザー・店舗集約中間テーブルを生成し、最終的に DWS レイヤーに dws_users という名前のユーザー集約メトリックテーブルと dws_shops という名前の店舗集約メトリックテーブルを生成します。
前提条件
DLF が有効化されていること。詳細については、「DLF の概要」をご参照ください。
Realtime Compute for Apache Flink が有効化されていること。詳細については、「Realtime Compute for Apache Flink の有効化」をご参照ください。
EMR Serverless StarRocks が有効化されていること。詳細については、「ストレージ・コンピューティング分離アーキテクチャを使用する Serverless StarRocks インスタンスの概要」をご参照ください。
StarRocks インスタンスと DLF は、Flink ワークスペースと同じリージョンにある必要があります。
制限事項
Ververica Runtime (VVR) 11.1.0 以降のみが、このストリーミングデータレイクハウスソリューションをサポートします。
ストリーミングデータレイクハウスの構築
MySQL CDC データソースの準備
この例では、ApsaraDB RDS for MySQL インスタンスの order_dw という名前のデータベースに 3 つのビジネステーブルを作成し、それらのテーブルにデータを挿入します。
ApsaraDB RDS for MySQL インスタンスの作成。
説明ご利用の ApsaraDB RDS for MySQL と Flink ワークスペースが同じ VPC にない場合は、「VPC をまたいで他のサービスにアクセスする方法」をご参照ください。
order_dwという名前のデータベースを作成し、order_dwデータベースに対する読み取りおよび書き込み権限を持つ特権アカウントまたは標準アカウントを作成します。3 つのテーブルを作成し、データを挿入します。
CREATE TABLE `orders` (
  order_id bigint not null primary key,
  user_id varchar(50) not null,
  shop_id bigint not null,
  product_id bigint not null,
  buy_fee bigint not null,
  create_time timestamp not null,
  update_time timestamp not null default now(),
  state int not null
);

CREATE TABLE `orders_pay` (
  pay_id bigint not null primary key,
  order_id bigint not null,
  pay_platform int not null,
  create_time timestamp not null
);

CREATE TABLE `product_catalog` (
  product_id bigint not null primary key,
  catalog_name varchar(50) not null
);

-- データの準備
INSERT INTO product_catalog VALUES(1, 'phone_aaa'),(2, 'phone_bbb'),(3, 'phone_ccc'),(4, 'phone_ddd'),(5, 'phone_eee');

INSERT INTO orders VALUES
(100001, 'user_001', 12345, 1, 5000, '2023-02-15 16:40:56', '2023-02-15 18:42:56', 1),
(100002, 'user_002', 12346, 2, 4000, '2023-02-15 15:40:56', '2023-02-15 18:42:56', 1),
(100003, 'user_003', 12347, 3, 3000, '2023-02-15 14:40:56', '2023-02-15 18:42:56', 1),
(100004, 'user_001', 12347, 4, 2000, '2023-02-15 13:40:56', '2023-02-15 18:42:56', 1),
(100005, 'user_002', 12348, 5, 1000, '2023-02-15 12:40:56', '2023-02-15 18:42:56', 1),
(100006, 'user_001', 12348, 1, 1000, '2023-02-15 11:40:56', '2023-02-15 18:42:56', 1),
(100007, 'user_003', 12347, 4, 2000, '2023-02-15 10:40:56', '2023-02-15 18:42:56', 1);

INSERT INTO orders_pay VALUES
(2001, 100001, 1, '2023-02-15 17:40:56'),
(2002, 100002, 1, '2023-02-15 17:40:56'),
(2003, 100003, 0, '2023-02-15 17:40:56'),
(2004, 100004, 0, '2023-02-15 17:40:56'),
(2005, 100005, 0, '2023-02-15 18:40:56'),
(2006, 100006, 0, '2023-02-15 18:40:56'),
(2007, 100007, 0, '2023-02-15 18:40:56');
メタデータ管理
Paimon カタログの作成
左側のナビゲーションウィンドウで、メタデータ管理を選択し、カタログの作成をクリックします。
[組み込みカタログ] タブで [Apache Paimon] をクリックし、次に [次へ] をクリックします。
次のパラメーターを入力し、ストレージクラスとして DLF を選択し、[OK] をクリックします。
設定項目
説明
必須
備考
metastore
メタストアのタイプ。
はい
この例では dlf ストレージクラスを使用します。
catalog name
DLF データカタログの名前。
重要Resource Access Management (RAM) ユーザーまたはロールを使用する場合は、DLF データに対する読み取りおよび書き込み権限があることを確認してください。詳細については、「データ権限の管理」をご参照ください。
はい
既存の DLF データカタログを選択します。データカタログを作成するには、「データカタログ」をご参照ください。
この例では、
paimoncatalogという名前のデータカタログが事前に作成されています。データカタログに対応する order_dw データベースを作成して、MySQL の order_dw データベースからすべてのテーブルデータを同期します。
左側のナビゲーションウィンドウで、 を選択し、[新規作成] をクリックして一時クエリを作成します。
-- paimoncatalog データソースを使用します
USE CATALOG paimoncatalog;
-- order_dw データベースを作成します
CREATE DATABASE order_dw;
メッセージ
The following statement has been executed successfully!が表示されたら、データベースが作成されたことを示します。
Paimon カタログの使用方法の詳細については、「Paimon カタログの管理」をご参照ください。
MySQL カタログの作成
[メタデータ管理] ページで、[カタログの作成] をクリックします。
[ビルトインカタログ] タブで、[MySQL] をクリックし、次に [次へ] をクリックします。
次のパラメーターを入力して [OK] をクリックすると、mysqlcatalog という名前の MySQL カタログが作成されます。
設定項目
説明
必須
備考
catalog name
カタログの名前。
はい
英語でカスタム名を入力します。このトピックでは、例として mysqlcatalog を使用します。
hostname
MySQL データベースの IP アドレスまたはホスト名。
はい
詳細については、「インスタンスのエンドポイントとポート番号の表示と管理」をご参照ください。ApsaraDB RDS for MySQL インスタンスとフルマネージド Flink は同じ VPC 内にあるため、内部ネットワークアドレスを入力します。
port
MySQL データベースサービスのポート番号。デフォルト値は 3306 です。
いいえ
詳細については、「インスタンスのエンドポイントとポート番号の表示と管理」をご参照ください。
default-database
デフォルトの MySQL データベース名。
はい
このトピックでは、同期するデータベース名 order_dw を使用します。
username
MySQL データベースサービスのユーザー名。
はい
これは、「MySQL CDC データソースの準備」で作成したアカウントです。
password
MySQL データベースサービスのパスワード。
はい
これは、「MySQL CDC データソースの準備」で作成したアカウントのパスワードです。
ODS レイヤーの構築:データウェアハウスへのリアルタイムデータインジェスト
Flink CDC を使用して MySQL から Paimon にデータをインジェストし、ODS レイヤーを構築します。
データインジェストジョブを作成します。
Realtime Compute for Apache Flink の管理コンソールにログインします。 お使いのワークスペースの [アクション] 列で [コンソール] をクリックして、開発コンソールに入ります。
左側のナビゲーションメニューで、 を選択し、 をクリックします。[新規ドラフト] ダイアログで、[名前] フィールドに
odsを入力し、[作成] をクリックします。SQL エディターで、次のコードをコピーして貼り付けます。source: type: mysql name: MySQL Source hostname: rm-bp1e********566g.mysql.rds.aliyuncs.com port: 3306 username: ${secret_values.username} password: ${secret_values.password} tables: order_dw.\.* # MySQL DB order_dw のすべてのテーブルを読み取ります。 sink: type: paimon name: Paimon Sink catalog.properties.metastore: rest catalog.properties.uri: http://ap-southeast-5-vpc.dlf.aliyuncs.com catalog.properties.warehouse: paimoncatalog catalog.properties.token.provider: dlf pipeline: name: MySQL to Paimon Pipeline設定項目
説明
必須
例
catalog.properties.metastoreメタストアのタイプ。
restに設定します。はい
rest
catalog.properties.token.providerトークンプロバイダー。
dlfに設定します。はい
dlf
catalog.properties.uriDLF サーバーの URI。フォーマット:
http://[region-id]-vpc.dlf.aliyuncs.com。[region-id]を実際のリージョン ID に置き換えます (「エンドポイント」をご参照ください)。はい
http://ap-southeast-5-vpc.dlf.aliyuncs.com
catalog.properties.warehouseDLF カタログ名。
はい
paimoncatalog
Paimon テーブルのプロパティを設定して、書き込みパフォーマンスを向上させることができます。詳細については、「パフォーマンスの最適化」をご参照ください。
SQL エディターの右上隅で、[デプロイ]をクリックします。
左側のナビゲーションメニューで、 を選択します。[デプロイメント] ページで、ジョブデプロイメント
odsを見つけ、[アクション] 列の [開始] をクリックします。[ジョブの開始] パネルで、[初期モード] を選択し、[開始] をクリックします。
MySQL から Paimon に同期されたデータを表示します。
Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、 を選択します。 をクリックします。 SQL エディターで、次のコードをコピーして貼り付け、コードを選択し、[実行] をクリックします:
SELECT * FROM paimoncatalog.order_dw.orders ORDER BY order_id;
DWD レイヤーの構築:ワイドテーブル
Apache Paimon の DWD レイヤーに dwd_orders という名前のワイドテーブルを作成
Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、 を選択し、[スクリプト] タブで をクリックします。 SQL エディターで、次のコードをコピーし、コードを選択してから [実行] をクリックします:
CREATE TABLE paimoncatalog.order_dw.dwd_orders (
    order_id BIGINT,
    order_user_id STRING,
    order_shop_id BIGINT,
    order_product_id BIGINT,
    order_product_catalog_name STRING,
    order_fee BIGINT,
    order_create_time TIMESTAMP,
    order_update_time TIMESTAMP,
    order_state INT,
    pay_id BIGINT,
    pay_platform INT COMMENT 'プラットフォーム 0: phone, 1: pc',
    pay_create_time TIMESTAMP,
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'merge-engine' = 'partial-update', -- 部分更新データマージメカニズムを使用してワイドテーブルを生成します。
    'changelog-producer' = 'lookup' -- ルックアップ増分データ生成メカニズムを使用して、低レイテンシーで changelog を生成します。
);
Query has been executedメッセージが返された場合、テーブルは作成されています。ODS レイヤーの orders テーブルと orders_pay テーブルの changelog をリアルタイムで消費
Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、 を選択します。表示されたページで、 をクリックして、
dwdという名前のドラフトを作成します。SQL エディターで、次のコードをコピーして貼り付け、ドラフトをデプロイします。初期状態でジョブのデプロイを開始します。このジョブは、
ordersテーブルをproduct_catalogという名前のディメンションテーブルと結合し、結合結果とorders_payテーブルのデータをdwd_ordersという名前のワイドテーブルに書き込みます。このプロセスでは、Apache Paimon の部分更新データマージメカニズムを使用して、orders テーブルとorders_payテーブルで同じorder_id値を持つデータをマージします。SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; -- Apache Paimon では、同じデプロイメントで複数の INSERT 文を使用して同じテーブルにデータを書き込むことはできません。そのため、この例では UNION ALL を使用します。 INSERT INTO paimoncatalog.order_dw.dwd_orders SELECT o.order_id, o.user_id, o.shop_id, o.product_id, dim.catalog_name, o.buy_fee, o.create_time, o.update_time, o.state, NULL, NULL, NULL FROM paimoncatalog.order_dw.orders o LEFT JOIN paimoncatalog.order_dw.product_catalog FOR SYSTEM_TIME AS OF proctime() AS dim ON o.product_id = dim.product_id UNION ALL SELECT order_id, NULL, NULL, NULL, NULL, NULL, NULL, NULL, NULL, pay_id, pay_platform, create_time FROM paimoncatalog.order_dw.orders_pay;dwd_orders という名前のワイドテーブルのデータを表示
Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、を選択します。 [スクリプト] タブで、 をクリックします。 SQL エディターで、次のコードをコピーして貼り付け、コードを選択してから [実行] をクリックします:
SELECT * FROM paimoncatalog.order_dw.dwd_orders ORDER BY order_id;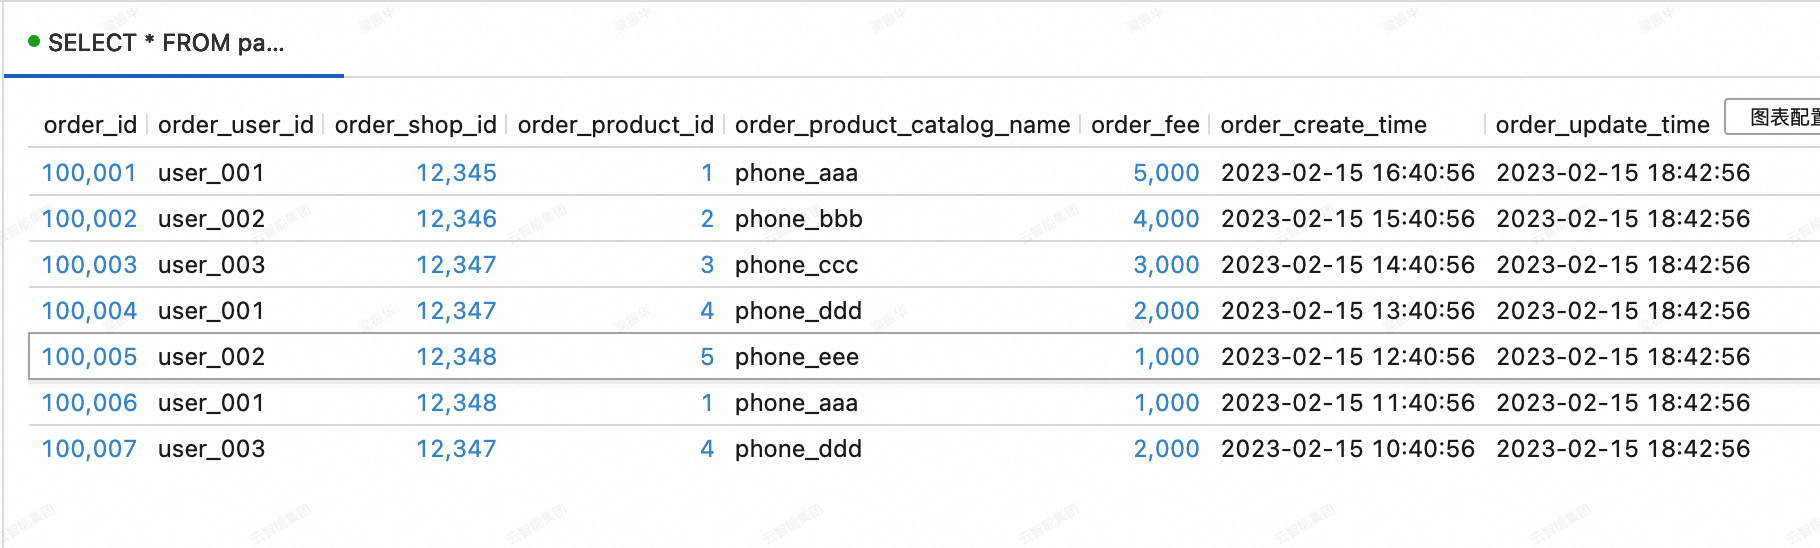
DWS レイヤーの構築:メトリック計算
DWS レイヤーに dws_users と dws_shops という名前の集約メトリックテーブルを作成します。
Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、を選択します。[スクリプト] タブで、 をクリックします。SQL エディターで、次のコードをコピーして貼り付け、コードを選択し、[実行] をクリックします。
-- ユーザーディメンションの集約メトリックテーブルを作成します。
CREATE TABLE paimoncatalog.order_dw.dws_users (
    user_id STRING,
    ds STRING,
    payed_buy_fee_sum BIGINT COMMENT '当日中に支払いが完了した合計金額',
    PRIMARY KEY (user_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- 集約データマージメカニズムを使用して集約テーブルを生成します。
    'fields.payed_buy_fee_sum.aggregate-function' = 'sum' -- payed_buy_fee_sum データの合計を計算して集約結果を生成します。
    -- dws_users テーブルはダウンストリームストレージによってストリーミングモードで消費されないため、増分データ生成メカニズムを指定する必要はありません。
);

-- 店舗ディメンションの集約メトリックテーブルを作成します。
CREATE TABLE paimoncatalog.order_dw.dws_shops (
    shop_id BIGINT,
    ds STRING,
    payed_buy_fee_sum BIGINT COMMENT '当日中に支払いが完了した合計金額',
    uv BIGINT COMMENT '当日中に商品を購入したユーザーの合計数',
    pv BIGINT COMMENT '当日中にすべてのユーザーが行った購入の合計数',
    PRIMARY KEY (shop_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- 集約データマージメカニズムを使用して集約テーブルを生成します。
    'fields.payed_buy_fee_sum.aggregate-function' = 'sum', -- payed_buy_fee_sum データの合計を計算して集約結果を生成します。
    'fields.uv.aggregate-function' = 'sum', -- ユニークビジター (UV) データの合計を計算して集約結果を生成します。
    'fields.pv.aggregate-function' = 'sum' -- ページビュー (PV) データの合計を計算して集約結果を生成します。
    -- dws_shops テーブルはダウンストリームストレージによってストリーミングモードで消費されないため、増分データ生成メカニズムを指定する必要はありません。
);

-- ユーザー視点の集約テーブルのデータと店舗視点の集約テーブルのデータを同時に計算するために、user_id フィールドと shop_id フィールドをプライマリキーとして使用する中間テーブルを作成します。
CREATE TABLE paimoncatalog.order_dw.dwm_users_shops (
    user_id STRING,
    shop_id BIGINT,
    ds STRING,
    payed_buy_fee_sum BIGINT COMMENT '当日中にユーザーが店舗で支払った合計金額',
    pv BIGINT COMMENT '当日中にユーザーが店舗で行った購入数',
    PRIMARY KEY (user_id, shop_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- 集約データマージメカニズムを使用して集約テーブルを生成します。
    'fields.payed_buy_fee_sum.aggregate-function' = 'sum', -- payed_buy_fee_sum データの合計を計算して集約結果を生成します。
    'fields.pv.aggregate-function' = 'sum', -- PV データの合計を計算して集約結果を生成します。
    'changelog-producer' = 'lookup', -- ルックアップ増分データ生成メカニズムを使用して、低レイテンシーで changelog を生成します。
    -- ほとんどの場合、DWM レイヤーの中間テーブルは上位レイヤーのアプリケーションにクエリを提供しません。そのため、書き込みパフォーマンスを最適化できます。
    'file.format' = 'avro', -- Avro 行指向ストレージフォーマットを使用して、より効率的な書き込みパフォーマンスを提供します。
    'metadata.stats-mode' = 'none' -- 統計情報を破棄します。統計情報を破棄すると、オンライン分析処理 (OLAP) クエリのコストは増加しますが、書き込みパフォーマンスは向上します。これは、連続的なストリーム処理には影響しません。
);
Query has been executedメッセージが返された場合、テーブルは作成されています。DWD レイヤーの dwd_orders テーブルの changelog を消費します。
Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、 を選択します。表示されたページで、 をクリックして、
dwmという名前のドラフトを作成します。SQL エディターで、次のコードをコピーして貼り付け、ドラフトをデプロイします。初期状態でジョブのデプロイメントを開始します。このジョブは、
dwd_ordersテーブルからdwm_users_shopsテーブルにデータを書き込みます。このプロセスでは、Apache Paimon の集約データマージメカニズムを使用してorder_feeデータの合計を計算し、店舗でのユーザーの総消費額を取得します。このジョブはまた、データエントリの数を計算して、店舗でのユーザーの購入数を取得します。SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; INSERT INTO paimoncatalog.order_dw.dwm_users_shops SELECT order_user_id, order_shop_id, DATE_FORMAT (pay_create_time, 'yyyyMMdd') as ds, order_fee, 1 -- 1 つの入力レコードは 1 回の購入を表します。 FROM paimoncatalog.order_dw.dwd_orders WHERE pay_id IS NOT NULL AND order_fee IS NOT NULL;DWM レイヤーの dwm_users_shops テーブルの changelog をリアルタイムで消費します。
Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、 を選択します。表示されたページで、 をクリックして、
dwsという名前のドラフトを作成します。SQL エディターで、次のコードをコピーして貼り付け、ドラフトをデプロイします。初期状態でジョブのデプロイメントを開始します。このジョブは、
dwm_users_shopsテーブルからdws_usersテーブルとdws_shopsテーブルにデータを書き込みます。このプロセスでは、Apache Paimon の集約データマージメカニズムを使用して、dws_usersテーブルのpayed_buy_fee_sumデータの合計を計算してすべての店舗でのユーザーの総消費額を取得し、dws_shopsテーブルのpayed_buy_fee_sumデータの合計を計算して店舗の総取引額を取得します。このデプロイメントはまた、データエントリの数を計算して店舗で購入したユーザーの数を取得し、PV データの合計を計算して店舗ですべてのユーザーが行った購入の総数を取得します。SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; -- DWD レイヤーとは異なり、DWM レイヤーでは、異なる Apache Paimon テーブルにデータを書き込む複数の INSERT 文を同じデプロイメントに配置できます。 BEGIN STATEMENT SET; INSERT INTO paimoncatalog.order_dw.dws_users SELECT user_id, ds, payed_buy_fee_sum FROM paimoncatalog.order_dw.dwm_users_shops; -- shop_id 列はプライマリキーとして使用されます。特定の人気店舗のデータ量は、他の店舗のデータ量よりもはるかに多い場合があります。 -- したがって、ローカルマージを使用して、データを Apache Paimon に書き込む前にメモリ内でデータを集約します。これは、データスキューの問題を軽減するのに役立ちます。 INSERT INTO paimoncatalog.order_dw.dws_shops /*+ OPTIONS('local-merge-buffer-size' = '64mb') */ SELECT shop_id, ds, payed_buy_fee_sum, 1, -- 1 つの入力レコードは、店舗でのユーザーのすべての消費を表します。 pv FROM paimoncatalog.order_dw.dwm_users_shops; END;dws_users テーブルと dws_shops テーブルのデータを表示します。
Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、を選択します。[スクリプト] タブで、 をクリックします。SQL エディターに次のコードをコピーして貼り付け、コードを選択してから、[実行] をクリックします:
-- dws_users テーブルのデータを表示します。
SELECT * FROM paimoncatalog.order_dw.dws_users ORDER BY user_id;
-- dws_shops テーブルのデータを表示します。
SELECT * FROM paimoncatalog.order_dw.dws_shops ORDER BY shop_id;
ビジネスデータベースの変更のキャプチャ
ストリーミングデータレイクハウスが作成されました。このセクションでは、ビジネスデータベースの変更をキャプチャするストリーミングデータレイクハウスの機能をテストします。
MySQL の
order_dwデータベースに次のデータを挿入します:INSERT INTO orders VALUES (100008, 'user_001', 12345, 3, 3000, '2023-02-15 17:40:56', '2023-02-15 18:42:56', 1), (100009, 'user_002', 12348, 4, 1000, '2023-02-15 18:40:56', '2023-02-15 19:42:56', 1), (100010, 'user_003', 12348, 2, 2000, '2023-02-15 19:40:56', '2023-02-15 20:42:56', 1); INSERT INTO orders_pay VALUES (2008, 100008, 1, '2023-02-15 18:40:56'), (2009, 100009, 1, '2023-02-15 19:40:56'), (2010, 100010, 0, '2023-02-15 20:40:56');dws_users テーブルと dws_shops テーブルのデータを表示します。 Realtime Compute for Apache Flink の開発コンソールの左側のナビゲーションメニューで、 を選択します。[スクリプト] タブで、 をクリックします。SQL エディターで、次のコードをコピーして貼り付け、コードを選択し、[実行] をクリックします:
dws_usersテーブルSELECT * FROM paimoncatalog.order_dw.dws_users ORDER BY user_id;
dws_shopsテーブルSELECT * FROM paimoncatalog.order_dw.dws_shops ORDER BY shop_id;
ストリーミングデータレイクハウスの使用
前のセクションでは、Realtime Compute for Apache Flink コンソールで Apache Paimon カタログを作成し、Apache Paimon テーブルにデータを書き込む方法について説明しました。このセクションでは、ストリーミングデータレイクハウスを作成した後に StarRocks を使用してデータを分析する具体的な簡単なシナリオについて説明します。
StarRocks インスタンスにログインし、Apache Paimon カタログを作成します。
CREATE EXTERNAL CATALOG paimon_catalog
PROPERTIES
(
    'type' = 'paimon',
    'paimon.catalog.type' = 'filesystem',
    'aliyun.oss.endpoint' = 'oss-cn-beijing-internal.aliyuncs.com',
    'paimon.catalog.warehouse' = 'oss://<bucket>/<object>'
);
パラメーター | 必須 | 説明 |
type | はい | データソースのタイプ。パラメーターを paimon に設定します。 |
paimon.catalog.type | はい | Apache Paimon カタログで使用されるメタデータストレージタイプ。この例では、filesystem を使用します。 |
aliyun.oss.endpoint | はい | OSS または OSS-HDFS のエンドポイント。paimon.catalog.warehouse パラメーターを OSS または OSS-HDFS パスに設定する場合、このパラメーターは必須です。 |
paimon.catalog.warehouse | はい | OSS で指定されたデータウェアハウスディレクトリ。フォーマットは oss://<bucket>/<object> です。ここで:
バケット名とオブジェクト名は OSS コンソールで確認できます。 |
ランキングクエリの実行
DWS レイヤーの集計テーブルを分析します。次のサンプルコードは、StarRocks を使用して 2023 年 2 月 15 日に取引量が最も多かった上位 3 店舗をクエリする方法を示しています:
SELECT ROW_NUMBER() OVER (ORDER BY payed_buy_fee_sum DESC) AS rn, shop_id, payed_buy_fee_sum
FROM dws_shops
WHERE ds = '20230215'
ORDER BY rn LIMIT 3;
詳細クエリの実行
DWD レイヤーのワイドテーブルを分析します。次のサンプルコードは、StarRocks を使用して 2023 年 2 月に特定の支払いプラットフォームで顧客が支払った注文の詳細をクエリする方法を示しています:
SELECT * FROM dwd_orders
WHERE order_create_time >= '2023-02-01 00:00:00' AND order_create_time < '2023-03-01 00:00:00'
AND order_user_id = 'user_001'
AND pay_platform = 0
ORDER BY order_create_time;;
データレポートのクエリ
DWD レイヤーのワイドテーブルを分析します。次のサンプルコードは、StarRocks を使用して 2023 年 2 月の各カテゴリの注文総数と注文総額をクエリする方法を示しています:
SELECT
  order_create_time AS order_create_date,
  order_product_catalog_name,
  COUNT(*),
  SUM(order_fee)
FROM
  dwd_orders
WHERE
  order_create_time >= '2023-02-01 00:00:00'  and order_create_time < '2023-03-01 00:00:00'
GROUP BY
  order_create_date, order_product_catalog_name
ORDER BY
  order_create_date, order_product_catalog_name;