すべてのプロダクト
Search
ドキュメントセンター

Container Service for Kubernetes:登録済みクラスターのアラート設定

最終更新日:Aug 26, 2026

Cloud Monitor のアラートを使用して、ACK One 登録済みクラスター内の異常イベントやメトリック違反を検出します。

前提条件

登録済みクラスターにおける Cloud Monitor アドオンの設定

ステップ 1: Cloud Monitor コンポーネントへの RAM 権限の付与

onectl の使用

  1. ローカルマシンに onectl をインストールおよび設定します。詳細については、「onectl を使用した登録済みクラスターの管理」をご参照ください。

  2. Cloud Monitor コンポーネントに RAM 権限を付与します。

    onectl ram-user grant --addon alicloud-monitor-controller

    期待される出力:

    Ram policy ack-one-registered-cluster-policy-alicloud-monitor-controller granted to ram user ack-one-user-ce313528c3 successfully.

コンソールの使用

登録済みクラスターにアドオンをインストールする前に、必要な権限を持つ RAM ユーザーを作成し、Alibaba Cloud サービスにアクセスするための AccessKey ペアを取得します。

  1. RAM ユーザーの作成

  2. カスタムポリシーの作成。例:

    {
                "Action": [
                    "log:*",
                    "arms:*",
                    "cms:*",
                    "cs:UpdateContactGroup"
                ],
                "Resource": [
                    "*"
                ],
                "Effect": "Allow"
    }
  3. RAM ユーザー権限の管理

  4. AccessKey の作成。

    警告

    AccessKey のセキュリティを強化するために、ネットワークアクセス制御用に AccessKey ペアベースのポリシーを構成し、AccessKey の呼び出し元を信頼できるネットワーク環境に制限することをお勧めします。

  5. AccessKey ペアを使用して、登録済みクラスターに alibaba-addon-secret という名前の Secret を作成します。

    Cloud Monitor コンポーネントは、この AccessKey ペアを使用してクラウドリソースにアクセスします。

    kubectl -n kube-system create secret generic alibaba-addon-secret --from-literal='access-key-id=<your access key id>' --from-literal='access-key-secret=<your access key secret>'
    説明

    <your access key id> と <your access key secret> をご自身の AccessKey ペアに置き換えてください。

ステップ 2: Cloud Monitor コンポーネントのインストールとアップグレード

onectl の使用

Cloud Monitor コンポーネントをインストールします。

onectl addon install alicloud-monitor-controller

期待される出力:

Addon alicloud-monitor-controller, version **** installed.

コンソールの使用

コンソールはアラートの要件を確認し、コンポーネントの有効化、インストール、またはアップグレードを案内します。

  1. ACK コンソールにログインします。左側のナビゲーションウィンドウで、クラスターリスト をクリックします。

  2. クラスターリスト ページで、ご利用のクラスター名をクリックします。左側のナビゲーションウィンドウで、操作 > アラート をクリックします。

  3. アラート ページで、画面上の指示に従って必要なコンポーネントをインストールまたはアップグレードします。

  4. インストールまたはアップグレード後、アラート ページに移動してアラートを設定します。

    タブ

    説明

    アラートルール

    • ステータス:アラートルールセットを有効または無効にします。

    • 連絡先グループの編集:アラート通知の連絡先グループを設定します。

    通知は連絡先グループのみに送信されます。事前に連絡先とグループを作成してください。個人に通知する場合は、その連絡先専用のグループを作成します。

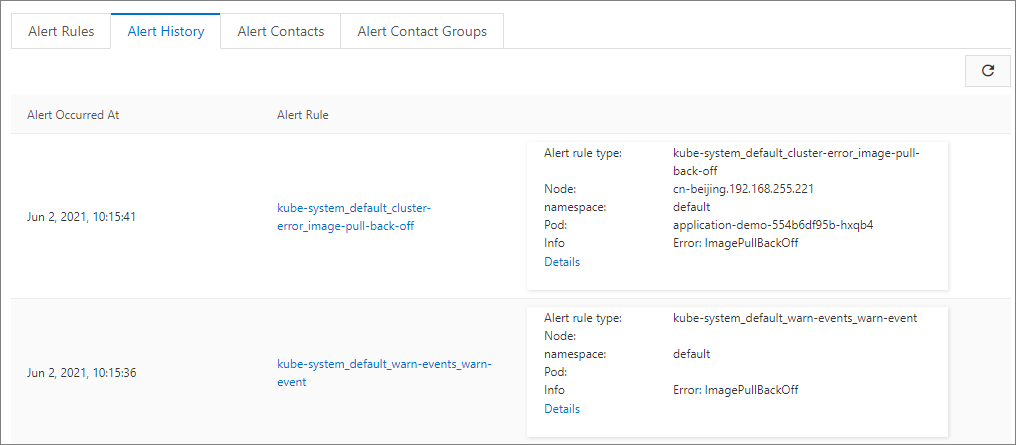
    アラート履歴

    過去 24 時間以内の最大 100 件のアラートレコードを表示します。

    • アラートルール 列のリンクをクリックして、対応するモニタリングシステムのルール設定を表示します。

    • 詳細 をクリックして、異常に関連するリソースページに移動します。

    • インテリジェント分析 をクリックして、AI による問題分析とトラブルシューティングを実行します。

    アラート連絡先

    連絡先の作成、編集、または削除を行います。

    連絡方法:

    • 音声通話/SMS:連絡先に携帯電話番号を設定して、音声通話および SMS でアラート通知を受け取ります。

      音声通話通知を受信できるのは、検証済みの携帯電話番号のみです。「携帯電話番号の検証」をご参照ください。
    • メール:連絡先にメールアドレスを設定して、アラート通知を受け取ります。

    • チャットボット:DingTalk チャットボット、WeCom チャットボット、および Lark チャットボット。

      DingTalk チャットボットの場合、セキュリティキーワードとして「alert」「dispatch」を追加してください。
    メールおよびチャットボット通知は、CloudMonitor コンソールの アラームサービス > アラーム送信先 で事前に検証してください。

    アラート連絡先グループ

    連絡先グループの作成、編集、または削除を行います。

    連絡先グループが存在しない場合、コンソールは Alibaba Cloud アカウントからデフォルトのグループを作成します。

アラートの設定

ステップ 1: デフォルトのアラートルールの有効化

  1. ACKコンソールにログインします。 左側のナビゲーションウィンドウで、[クラスター] をクリックします。

  2. [クラスター] ページで、管理するクラスターの名前をクリックします。 左側のウィンドウで、[操作] > [アラート] を選択します。

  3. [Alert Rules] タブで、デフォルトのアラートルールセットには、エラーイベントセット、警告イベントセット、クラスターノード異常アラートルールセット、クラスターリソース異常アラートルールセット、クラスターコンテナレプリカ異常アラートルールセット、クラスターストレージ異常イベントアラートルールセット、クラスターネットワーク異常アラートルールセット、およびクラスターセキュリティ異常イベントが含まれます。
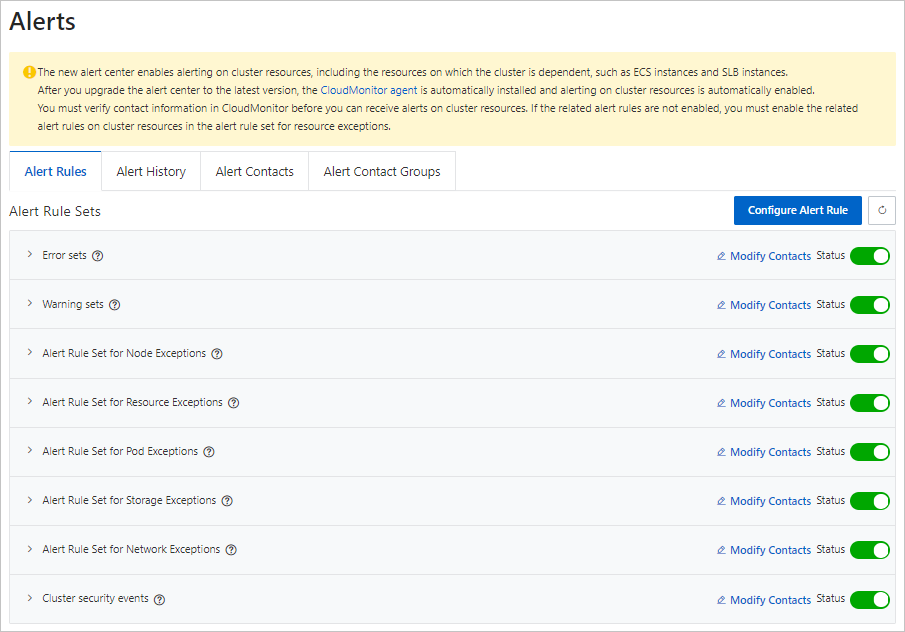
    Alert rule management

ステップ 2: アラートルールの手動設定

  1. ACKコンソールにログインします。 左側のナビゲーションウィンドウで、[クラスター] をクリックします。

  2. [クラスター] ページで、管理するクラスターの名前をクリックします。 左側のウィンドウで、[操作] > [アラート] を選択します。

  3. [Alert Rules] タブで、[Change Contact] をクリックして通知受信者を設定し、次に [Status] スイッチをオンにしてルールセットを有効にします。

    機能

    説明

    [Alert Rules]

    • ACK はコンテナシナリオ用のアラートテンプレートを自動的に生成し、異常イベントやメトリックの異常に対応します。

    • アラートルールはルールセットにグループ化されます。連絡先グループをルールセットに関連付けて、有効化または無効化します。

    • 各ルールセットには複数のルールが含まれており、それぞれが単一の異常を監視します。YAML リソースでルールセットを設定します。変更は自動的に同期されます。

    • 「CRD を使用したアラートルールの設定」をご参照ください。

    • 「Container Service アラート管理」をご参照ください。

    [Alert History]

    最新 100 件のアラート履歴を表示します。[Alert Rule] リンクをクリックすると、モニタリングシステムでその設定を表示できます。[Details] をクリックすると、影響を受けるリソースページに移動します。Alert history

    [Alert Contacts]

    連絡先の作成、編集、または削除を行います。

    [Alert Contact Groups]

    連絡先グループの作成、編集、または削除を行います。存在しない場合、コンソールは Alibaba Cloud アカウントを基にデフォルトのグループを作成します。

CRD を使用したアラートルールの設定

アラートを有効にすると、[kube-system] namespace にデフォルトテンプレートを持つ AckAlertRule リソースが作成されます。このリソースを使用して、クラスターのアラートルールセットを設定します。

コンソール

  1. ACK コンソールにログインします。左側のナビゲーションウィンドウで、クラスターリスト をクリックします。

  2. クラスターリスト ページで、ご利用のクラスター名をクリックします。左側のナビゲーションウィンドウで、操作 > アラート をクリックします。

  3. アラートルール タブで、右上隅の アラートルールの設定 をクリックします。次に、対象のルールの アクション 列で YAML をクリックして、AckAlertRule CRD リソースの設定を表示します。

  4. YAML ファイルを変更します。パラメーターの詳細については、「デフォルトのアラートルールテンプレート」をご参照ください。

    以下は、アラートルールの YAML 設定の例です。

    アラートルールの YAML 設定

    apiVersion: alert.alibabacloud.com/v1beta1
    kind: AckAlertRule
    metadata:
      name: default
    spec:
      groups:
        # The following is a sample configuration for a cluster event alert rule.
        - name: pod-exceptions                             # The name of the alert rule group, which corresponds to the Group_Name field in the alert template.
          rules:
            - name: pod-oom                                # The name of the alert rule.
              type: event                                  # The type of the alert rule (Rule_Type). Valid values: event, metric-cms (CloudMonitor metric), and metric-prometheus (Prometheus metric).
              expression: sls.app.ack.pod.oom              # The alert rule expression. If the rule type is event, the value is the Rule_Expression_Id from the default alert rule template in this topic.
              enable: enable                               # The state of the alert rule. Valid values: enable and disable.
            - name: pod-failed
              type: event
              expression: sls.app.ack.pod.failed
              enable: enable
        # The following is a sample configuration for a cluster infrastructure resource alert rule.
        - name: res-exceptions                              # The name of the alert rule group, which corresponds to the Group_Name field in the alert template.
          rules:
            - name: node_cpu_util_high                      # The name of the alert rule.
              type: metric-cms                              # The type of the alert rule (Rule_Type). Valid values: event, metric-cms (CloudMonitor metric), and metric-prometheus (Prometheus metric).
              expression: cms.host.cpu.utilization          # The alert rule expression. If the rule type is metric-cms, the value is the Rule_Expression_Id from the default alert rule template in this topic.
              contactGroups:                                # The contact groups mapped to the alert rule. This configuration is generated by the ACK console. Contacts are consistent for a single account and can be reused across multiple clusters.
                - arms_contact_group_id_v2: '69xxx'
                  cms_contact_group_name: xxx Contact Group
                  id: '10xxx'
              enable: enable                                # The state of the alert rule. Valid values: enable and disable.
              thresholds:                                   # The threshold of the alert rule.
                - key: CMS_ESCALATIONS_CRITICAL_Threshold
                  unit: percent
                  value: '85'                                # CPU utilization threshold. Default value: 85%.
                - key: CMS_ESCALATIONS_CRITICAL_Times
                  value: '3'                                # An alert is triggered if the threshold is exceeded 3 consecutive times.
                - key: CMS_RULE_SILENCE_SEC                 # The silence period after the first alert is reported.
                  value: '900'    

    rules.thresholds を使用して、アラートのしきい値をカスタマイズできます。たとえば、上記の設定では、ノードの CPU 使用率が 85% を 3 回連続で超過し、かつ前回のアラートから 900 秒以上経過した場合にアラートがトリガーされます。

    パラメーター

    必須

    説明

    デフォルト

    CMS_ESCALATIONS_CRITICAL_Threshold

    はい

    アラートルールのしきい値。このパラメーターを省略すると、ルールの同期に失敗し、ルールは無効になります。

    • unit:しきい値の単位。有効な値:percent、count、および qps。

    • value:しきい値の値。

    デフォルトのアラートルールテンプレートに基づいて異なります。

    CMS_ESCALATIONS_CRITICAL_Times

    任意

    CloudMonitor がアラートをトリガーする前に、条件が連続して満たされる必要がある回数。このパラメーターを省略すると、デフォルト値が使用されます。

    3

    CMS_RULE_SILENCE_SEC

    任意

    初期アラートが報告された後、継続的にトリガーされる CloudMonitor ルールに対するサイレンス期間(秒)。これにより、アラート疲弊を防ぎます。このパラメーターを省略すると、デフォルト値が使用されます。

    900

CLI

  1. アラートルールの YAML ファイルを編集します。

    kubectl edit ackalertrules default -n kube-system
  2. YAML ファイルを変更し、保存して終了します。パラメーターの詳細については、「デフォルトのアラートルールテンプレート」をご参照ください。

    アラートルールの YAML 設定

    apiVersion: alert.alibabacloud.com/v1beta1
    kind: AckAlertRule
    metadata:
      name: default
    spec:
      groups:
        # The following is a sample configuration for a cluster event alert rule.
        - name: pod-exceptions                             # The name of the alert rule group, which corresponds to the Group_Name field in the alert template.
          rules:
            - name: pod-oom                                # The name of the alert rule.
              type: event                                  # The type of the alert rule (Rule_Type). Valid values: event, metric-cms (CloudMonitor metric), and metric-prometheus (Prometheus metric).
              expression: sls.app.ack.pod.oom              # The alert rule expression. If the rule type is event, the value is the Rule_Expression_Id from the default alert rule template in this topic.
              enable: enable                               # The state of the alert rule. Valid values: enable and disable.
            - name: pod-failed
              type: event
              expression: sls.app.ack.pod.failed
              enable: enable
        # The following is a sample configuration for a cluster infrastructure resource alert rule.
        - name: res-exceptions                              # The name of the alert rule group, which corresponds to the Group_Name field in the alert template.
          rules:
            - name: node_cpu_util_high                      # The name of the alert rule.
              type: metric-cms                              # The type of the alert rule (Rule_Type). Valid values: event, metric-cms (CloudMonitor metric), and metric-prometheus (Prometheus metric).
              expression: cms.host.cpu.utilization          # The alert rule expression. If the rule type is metric-cms, the value is the Rule_Expression_Id from the default alert rule template in this topic.
              contactGroups:                                # The contact groups mapped to the alert rule. This configuration is generated by the ACK console. Contacts are consistent for a single account and can be reused across multiple clusters.
                - arms_contact_group_id_v2: 'xxx'
                  cms_contact_group_name: xxx
                  id: 'xxx'
              enable: enable                                # The state of the alert rule. Valid values: enable and disable.
              thresholds:                                   # The threshold of the alert rule.
                - key: CMS_ESCALATIONS_CRITICAL_Threshold
                  unit: percent
                  value: '85'                                # CPU utilization threshold. Default value: 85%.
                - key: CMS_ESCALATIONS_CRITICAL_Times
                  value: '3'                                # An alert is triggered if the threshold is exceeded 3 consecutive times.
                - key: CMS_RULE_SILENCE_SEC                 # The silence period after the first alert is reported.
                  value: '900'    

    rules.thresholds を使用して、アラートのしきい値をカスタマイズできます。たとえば、上記の設定では、ノードの CPU 使用率が 85% を 3 回連続で超過し、かつ前回のアラートから 900 秒以上経過した場合にアラートがトリガーされます。

    パラメーター

    必須

    説明

    デフォルト

    CMS_ESCALATIONS_CRITICAL_Threshold

    はい

    アラートルールのしきい値。このパラメーターを省略すると、ルールの同期に失敗し、ルールは無効になります。

    • unit:しきい値の単位。有効な値:percent、count、および qps。

    • value:しきい値の値。

    デフォルトのアラートルールテンプレートに基づいて異なります。

    CMS_ESCALATIONS_CRITICAL_Times

    任意

    CloudMonitor がアラートをトリガーする前に、条件が連続して満たされる必要がある回数。このパラメーターを省略すると、デフォルト値が使用されます。

    3

    CMS_RULE_SILENCE_SEC

    任意

    初期アラートが報告された後、継続的にトリガーされる CloudMonitor ルールに対するサイレンス期間(秒)。これにより、アラート疲弊を防ぎます。このパラメーターを省略すると、デフォルト値が使用されます。

    900

デフォルトのアラートルールテンプレート

デフォルトのアラートルールは、次の場合に作成されます。

  • デフォルトのアラートルール機能が有効になっている場合。

  • 機能が無効になっている間に、アラートルールページを初めて開いた場合。

以下の表に、デフォルトのアラートルールを示します。

アラート

説明

ソース

ルールタイプ

ACK CR ルール名

SLS イベント ID

クラスター検査異常

自動検査で潜在的な異常が検出されました。問題を確認し、必要に応じてメンテナンスを調整してください。

SLS

event

cis-sched-failed

sls.app.ack.cis.schedule_task_failed