Kubernetes クラスターの LLM 推論サービスでは、単純なトラフィック割り当てに依存し、LLM 推論の複雑なリクエストや動的なトラフィック負荷に対応できない従来のロードバランシングでは、多くの場合不十分です。このトピックでは、Gateway with Inference Extension アドオンを使用して、インテリジェントなルーティングと効率的なトラフィック管理を実現する推論サービス拡張機能の設定方法について説明します。
背景情報
大規模言語モデル(LLM)
大規模言語モデル(LLM)は、GPT、Qwen、Llama などに代表される、数十億パラメーターを持つニューラルネットワークベースの言語モデルです。これらのモデルは、Web テキスト、専門文献、コードなど多様かつ膨大なデータセットでトレーニングされており、主に補完や対話などのテキスト生成タスクに使用されます。
LLM を活用してアプリケーションを構築するには、以下の方法があります。
OpenAI、Alibaba Cloud Model Studio、Moonshot などのプラットフォームが提供する外部 LLM API サービスを利用する。
vLLM などのオープンソースまたは独自のモデル・フレームワークを使用して、独自の LLM 推論サービスを構築し、Kubernetes クラスターにデプロイする。このアプローチは、推論サービスに対する制御や LLM 推論機能の高度なカスタマイズが必要なシナリオに適しています。
vLLM
vLLM は、効率的かつユーザーフレンドリな LLM 推論サービスの構築を目的としたフレームワークです。Qwen を含むさまざまな大規模言語モデルをサポートし、PagedAttention、動的バッチ推論(Continuous Batching)、モデル量子化などの技術により推論効率を最適化します。
KV キャッシュ
ワークフロー
次の図は、ワークフローを示しています。

inference-gatewayでは、ポート 8080 は標準の HTTP Route を使用してリクエストをバックエンドの推論サービスに転送します。一方、ポート 8081 はリクエストを推論サービス拡張 (LLM Route) にルーティングし、推論サービス拡張がバックエンドの推論サービスに転送します。LLM Route では、クラスターで実行される LLM 推論サービスのワークロードのグループを宣言するために
InferencePoolリソースを構成し、InferencePool内の特定モデルに対するトラフィック分散ポリシーを指定するためにInferenceModelリソースを構成します。この構成は、推論サービス向けに強化された負荷分散アルゴリズムを使用して、inference-gatewayのポート 8081 から指定したワークロードへリクエストをルーティングします。
前提条件
GPU ノードプールを備えた ACK マネージドクラスターが必要です。あるいは、ACK マネージドクラスターに ACK 仮想ノード アドオンをインストールすることで、Alibaba Cloud の GPU 計算能力を使用することもできます。
手順
ステップ 1:サンプル推論サービスのデプロイ
お使いのクラスター環境に応じて、以下のいずれかの YAML コンテンツを使用して
vllm-service.yamlファイルを作成します。説明本記事の例では、Container Service for Kubernetes (ACK) クラスターで A10 カードを使用し、Alibaba Cloud Container Compute Service (ACS) では L20 (GN8IS) カードタイプを使用します。
LLM イメージは大きいため、Container Registry (ACR) に転送し、内部ネットワークアドレスを使用してプルしてください。パブリックネットワークからのプルは、クラスターの Elastic IP アドレス (EIP) の帯域幅によって速度が制限されるため、遅くなる可能性があります。
サンプル推論サービスをデプロイします。
kubectl apply -f vllm-service.yaml
手順 2: Gateway with Inference Extension のインストール
ACK Gateway with Inference Extension アドオンをインストールし、Gateway API 推論拡張を有効にする (デプロイ済みの推論サービスが必要) が選択されていることを確認します。
パラメーター設定で、 Deployment の レプリカ (コントロールプレーンのレプリカ数) を 2 に設定します。 envoyGateway > resources > limits で、 CPU を 500m に、メモリを 1Gi に設定します。 requests で、 CPU を 100m に、メモリを 256Mi に設定します。
ステップ 3:推論ルーティングのデプロイ
このステップでは、InferencePool および InferenceModel リソースを作成します。
inference-pool.yamlファイルを作成します。apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferencePool metadata: name: vllm-qwen-pool spec: targetPortNumber: 8000 selector: app: qwen extensionRef: name: inference-gateway-ext-proc --- apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceModel metadata: name: inferencemodel-qwen spec: modelName: /model/qwen criticality: Critical poolRef: group: inference.networking.x-k8s.io kind: InferencePool name: vllm-qwen-pool targetModels: - name: /model/qwen weight: 100構成を適用します。
kubectl apply -f inference-pool.yaml
ステップ 4:ゲートウェイのデプロイと検証
このステップでは、ポート 8080 と 8081 でリッスンするゲートウェイを作成します。
inference-gateway.yamlファイルを作成します。apiVersion: gateway.networking.k8s.io/v1 kind: GatewayClass metadata: name: qwen-inference-gateway-class spec: controllerName: gateway.envoyproxy.io/gatewayclass-controller --- apiVersion: gateway.networking.k8s.io/v1 kind: Gateway metadata: name: qwen-inference-gateway spec: gatewayClassName: qwen-inference-gateway-class listeners: - name: http protocol: HTTP port: 8080 - name: llm-gw protocol: HTTP port: 8081 --- apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: qwen-backend spec: parentRefs: - name: qwen-inference-gateway sectionName: llm-gw rules: - backendRefs: - group: inference.networking.x-k8s.io kind: InferencePool name: vllm-qwen-pool matches: - path: type: PathPrefix value: / --- apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: qwen-backend-no-inference spec: parentRefs: - group: gateway.networking.k8s.io kind: Gateway name: qwen-inference-gateway sectionName: http rules: - backendRefs: - group: "" kind: Service name: qwen port: 8000 weight: 1 matches: - path: type: PathPrefix value: / --- apiVersion: gateway.envoyproxy.io/v1alpha1 kind: BackendTrafficPolicy metadata: name: backend-timeout spec: timeout: http: requestTimeout: 1h targetRef: group: gateway.networking.k8s.io kind: Gateway name: qwen-inference-gatewayゲートウェイをデプロイします。
kubectl apply -f inference-gateway.yamlこの構成により、クラスターに
envoy-gateway-systemという名前の名前空間と、envoy-default-inference-gateway-645xxxxxという名前の Service が作成されます。ゲートウェイのパブリック IP アドレスを取得します。
export GATEWAY_HOST=$(kubectl get gateway/qwen-inference-gateway -o jsonpath='{.status.addresses[0].value}')ポート 8080 で、標準の HTTP ルーティングを介してゲートウェイが qwen Service にルーティングされることを確認します。
curl -X POST ${GATEWAY_HOST}:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{
    "model": "/model/qwen",
    "max_completion_tokens": 100,
    "temperature": 0,
    "messages": [
      {
        "role": "user",
        "content": "Write as if you were a critic: San Francisco"
      }
    ]
}'
出力例:
{"id":"chatcmpl-aa6438e2-d65b-4211-afb8-ae8e76e7a692","object":"chat.completion","created":1747191180,"model":"/model/qwen","choices":[{"index":0,"message":{"role":"assistant","reasoning_content":null,"content":"San Francisco, a city that has long been a beacon of innovation, culture, and diversity, continues to captivate the world with its unique charm and character. As a critic, I find myself both enamored and occasionally perplexed by the city's multifaceted personality.\n\nSan Francisco's architecture is a testament to its rich history and progressive spirit. The iconic cable cars, Victorian houses, and the Golden Gate Bridge are not just tourist attractions but symbols of the city's enduring appeal. However, the","tool_calls":[]},"logprobs":null,"finish_reason":"length","stop_reason":null}],"usage":{"prompt_tokens":39,"total_tokens":139,"completion_tokens":100,"prompt_tokens_details":null},"prompt_logprobs":null}ポート 8081 で、推論サービス拡張を介してゲートウェイが推論サービスにルーティングされることを確認します。
curl -X POST ${GATEWAY_HOST}:8081/v1/chat/completions -H 'Content-Type: application/json' -d '{
    "model": "/model/qwen",
    "max_completion_tokens": 100,
    "temperature": 0,
    "messages": [
      {
        "role": "user",
        "content": "Write as if you were a critic: Los Angeles"
      }
    ]
}'
出力例:
{"id":"chatcmpl-cc4fcd0a-6a66-4684-8dc9-284d4eb77bb7","object":"chat.completion","created":1747191969,"model":"/model/qwen","choices":[{"index":0,"message":{"role":"assistant","reasoning_content":null,"content":"Los Angeles, the sprawling metropolis often referred to as \"L.A.,\" is a city that defies easy description. It is a place where dreams are made and broken, where the sun never sets, and where the line between reality and fantasy is as blurred as the smog that often hangs over its valleys. As a critic, I find myself both captivated and perplexed by this city that is as much a state of mind as it is a physical place.\n\nOn one hand, Los","tool_calls":[]},"logprobs":null,"finish_reason":"length","stop_reason":null}],"usage":{"prompt_tokens":39,"total_tokens":139,"completion_tokens":100,"prompt_tokens_details":null},"prompt_logprobs":null}
(任意) ステップ 5:オブザーバビリティのメトリクスとダッシュボードの設定
クラスターでは、Managed Service for Prometheus を有効化し、統合する必要があります。これには追加料金が発生する場合があります。
vLLM サービスの
Podにアノテーションを追加し、Prometheus が デフォルトのサービスディスカバリ を使用してメトリクスをスクレイピングし、サービスの内部状態を監視できるようにします。... annotations: prometheus.io/path: /metrics # メトリクスエンドポイントの HTTP パス。 prometheus.io/port: "8000" # メトリクスエンドポイントのポート。vLLM サーバーのリッスンポートです。 prometheus.io/scrape: "true" # Prometheus がこの Pod からメトリクスをスクレイピングするかどうかを指定します。 ...次の表に、vLLM サービスの主要な監視
メトリクスを示します。メトリクス
説明
vllm:gpu_cache_usage_perc
vLLM が使用する GPU キャッシュの割合。vLLM が起動すると、KV キャッシュ用に可能な限り多くの
GPU メモリを事前に割り当てます。vLLM サーバーでは、使用率が低いほど、GPU に新しいリクエストのための十分なスペースがあることを意味します。vllm:request_queue_time_seconds_sum
リクエストがキューで待機する合計時間。受信した LLM 推論リクエストは、すぐに処理されない場合があります。リクエストは、
vLLM スケジューラがプレフィルとデコードのためにスケジュールするのを待つ必要があります。vllm:num_requests_running
vllm:num_requests_waiting
vllm:num_requests_swapped
現在処理中、待機中、またはメモリにスワップされたリクエストの数。これらの値を使用して、vLLM サービスの現在のリクエスト負荷を評価できます。
vllm:avg_generation_throughput_toks_per_s
vllm:avg_prompt_throughput_toks_per_s
デコード段階で生成され、プレフィル段階で消費される 1 秒あたりのトークン数。vllm:time_to_first_token_seconds_bucket
vLLM サービスにリクエストを送信してから最初の
トークンを受信するまでのレイテンシー。このメトリクスは、最初のトークンまでの時間 (TTFT) とも呼ばれ、クライアントが最初のレスポンスを待つ時間を測定するため、ユーザーエクスペリエンスにとって重要です。これらの監視
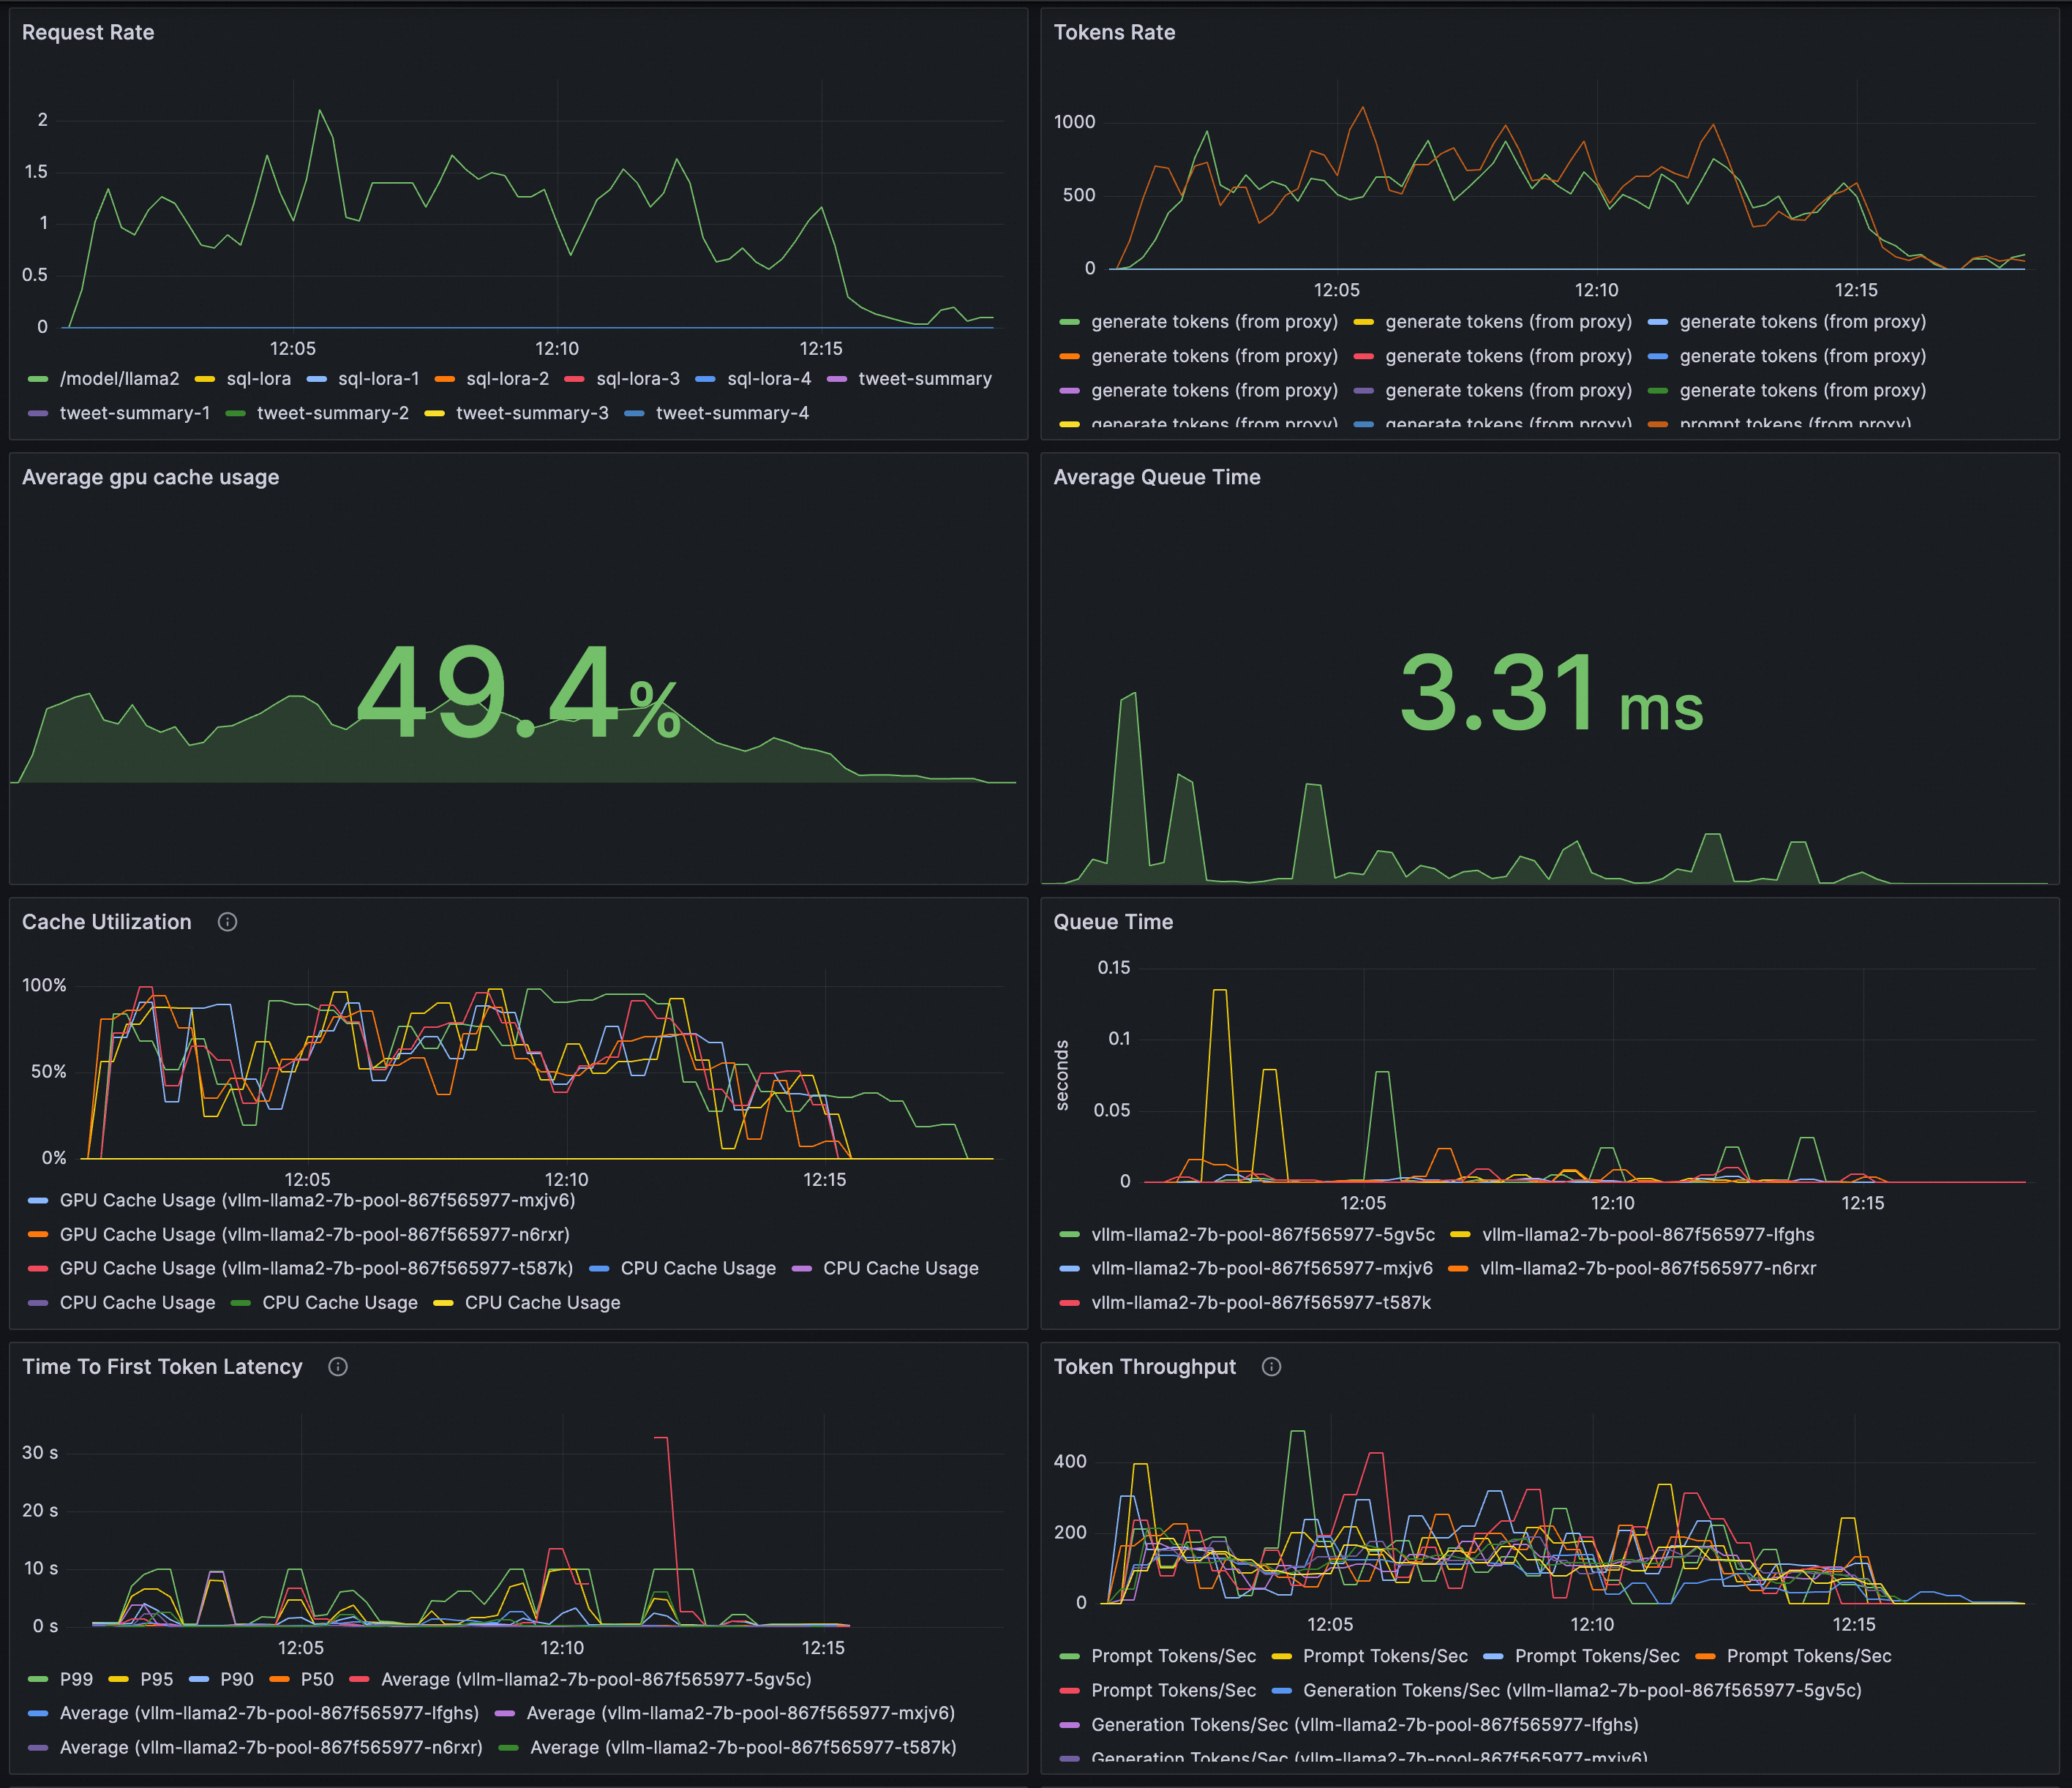
メトリクスを使用して、LLM サービスのリアルタイム監視と異常検出のためにアラートルールを設定します。vLLM でデプロイされた LLM 推論サービスをリアルタイムで監視するための Grafana ダッシュボードを設定します。このダッシュボードでは、次のことができます。
LLM サービスのリクエストレートと合計トークンスループットを確認できます。
推論ワークロードの内部状態を確認できます。
Grafana のデータソースである Prometheus インスタンスで vLLM モニタリングメトリックが収集されていることを確認した上で、ダッシュボードを作成するために、次の JSON コンテンツをGrafana にインポートしてください。
プレビュー:
ACK クラスターとvllm benchmarkを使用して推論サービスのストレステストを実行し、標準の HTTP ルーティングと推論サービスルーティングの負荷分散を比較します。
ストレステストのワークロードをデプロイします。
kubectl apply -f- <<EOF
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: vllm-benchmark
  name: vllm-benchmark
  namespace: default
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: vllm-benchmark
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: vllm-benchmark
    spec:
      containers:
      - command:
        - sh
        - -c
        - sleep inf
        image: registry-cn-hangzhou.ack.aliyuncs.com/dev/llm-benchmark:random-and-qa
        imagePullPolicy: IfNotPresent
        name: vllm-benchmark
        resources: {}
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
EOF
ストレステストを開始します。
ゲートウェイの内部 IP アドレスを取得します。
export GW_IP=$(kubectl get svc -n envoy-gateway-system -l gateway.envoyproxy.io/owning-gateway-namespace=default,gateway.envoyproxy.io/owning-gateway-name=qwen-inference-gateway -o jsonpath='{.items[0].spec.clusterIP}')ストレステストを実行します。
標準の HTTP ルーティング
kubectl exec -it deploy/vllm-benchmark -- env GW_IP=${GW_IP} python3 /root/vllm/benchmarks/benchmark_serving.py \
--backend vllm \
--model /models/Qwen-7B-Chat \
--served-model-name qwen \
--trust-remote-code \
--dataset-name random \
--random-prefix-len 10 \
--random-input-len 1550 \
--random-output-len 1800 \
--random-range-ratio 0.2 \
--num-prompts 3000 \
--max-concurrency 200 \
--host $GW_IP \
--port 8080 \
--endpoint /v1/completions \
--save-result \
2>&1 | tee benchmark_serving.txt
推論サービスルーティング
kubectl exec -it deploy/vllm-benchmark -- env GW_IP=${GW_IP} python3 /root/vllm/benchmarks/benchmark_serving.py \
--backend vllm \
--model /models/Qwen-7B-Chat \
--served-model-name qwen \
--trust-remote-code \
--dataset-name random \
--random-prefix-len 10 \
--random-input-len 1550 \
--random-output-len 1800 \
--random-range-ratio 0.2 \
--num-prompts 3000 \
--max-concurrency 200 \
--host $GW_IP \
--port 8081 \
--endpoint /v1/completions \
--save-result \
2>&1 | tee benchmark_serving.txt
テストが完了すると、ダッシュボードに標準の HTTP ルーティングと推論サービスルーティングの負荷分散の比較が表示されます。
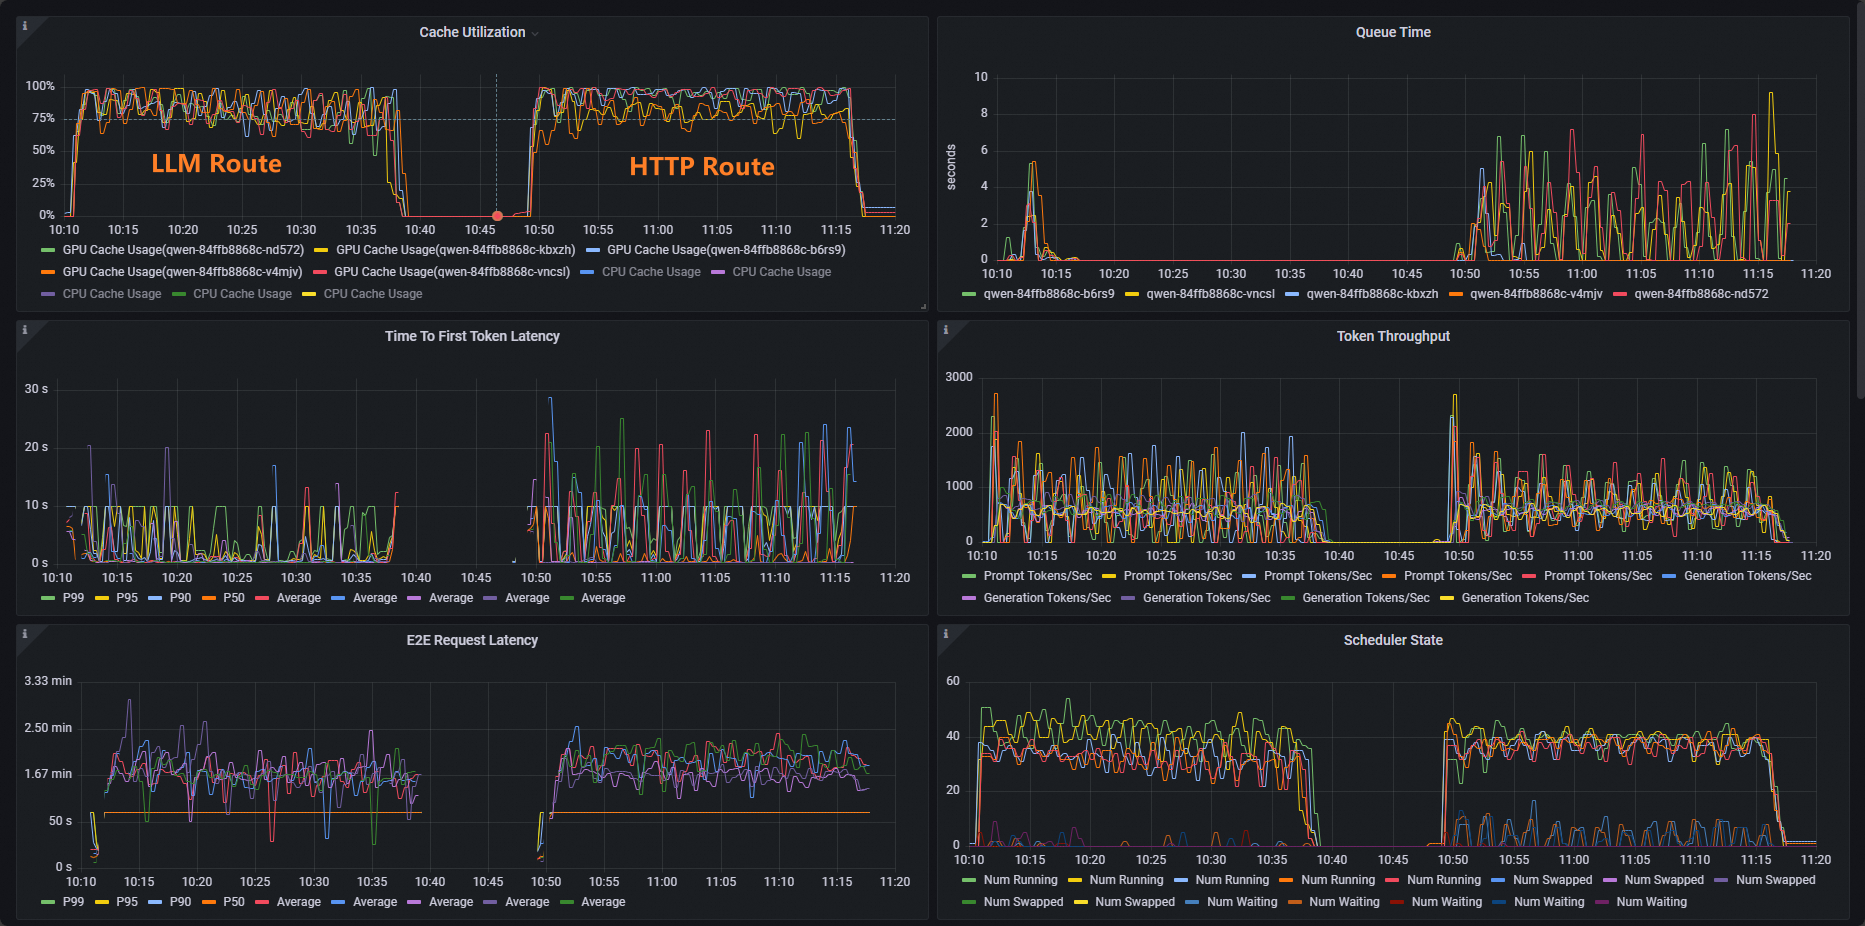
標準の HTTP ルーティングを使用するワークロードではキャッシュ使用率の分布が偏るのに対し、推論サービスルーティングを使用するワークロードでは分布が均一になります。
次のステップ
Gateway with Inference Extension は、さまざまな推論サービスのユースケースに対応する複数の負荷分散ポリシーをサポートしています。 InferencePool リソースに inference.networking.x-k8s.io/routing-strategy アノテーションを追加することで、InferencePool 内の Pod にルーティングされる推論リクエストに負荷分散ポリシーを適用できます。
次の例では、app: vllm-app セレクターを使用して推論サービス Pod を選択し、推論サーバーメトリクスに基づくデフォルトの負荷分散ポリシーを適用します。
apiVersion: inference.networking.x-k8s.io/v1alpha2
kind: InferencePool
metadata:
  name: vllm-app-pool
  annotations:
    inference.networking.x-k8s.io/routing-strategy: "DEFAULT"
spec:
  targetPortNumber: 8000
  selector:
    app: vllm-app
  extensionRef:
    name: inference-gateway-ext-proc
サポートされている負荷分散ポリシーは次のとおりです。
ポリシー | 説明 |
DEFAULT | 推論サーバーメトリクスに基づくデフォルトの負荷分散ポリシー。このポリシーは、リクエストキューの長さや GPU キャッシュ使用率などの複数のメトリクスを使用して各推論サーバーの内部状態を評価し、それに応じてトラフィックを分散します。 |
PREFIX_CACHE | リクエストプレフィックスマッチング負荷分散ポリシー。このポリシーは、共通のプレフィックスを持つリクエストを同じ推論サーバー Pod にルーティングします。このようなリクエストが大量に発生するシナリオ、特に推論サーバーで自動プレフィックスキャッシュが有効になっている場合に最適です。 一般的なユースケースは次のとおりです。
|