LangStudio menyediakan node alur kerja bawaan untuk pengendalian alur, LLM, agen, pengambilan data, penguraian dokumen, pengenalan suara, dan skrip Python.
Flow control
Start
Satu application flow hanya dapat memiliki satu node Start.
Node Start menandai titik awal eksekusi dan mendeklarasikan parameter input untuk application flow.
-
Untuk alur percakapan, sistem menyediakan dua bidang default: riwayat percakapan dan input pengguna. Tambahkan variabel kustom sesuai kebutuhan. Untuk menerima file yang diunggah pengguna, definisikan variabel input dengan tipe file. Untuk detailnya, lihat File type input and output.

-
Saat menjalankan application flow, konfigurasikan parameter input untuk sesi saat ini di panel percakapan.

Conditional branch
Node ini menerapkan logika if-else untuk pengendalian alur. Node ini mengevaluasi kondisi dan mengarahkan eksekusi ke branch pertama yang sesuai. Jika tidak ada kondisi yang bernilai true, maka else branch akan dijalankan. Pasangkan node ini dengan node Variable aggregate untuk menggabungkan hasil dari berbagai branch.
-
Configuration

-
Input
Saat mengonfigurasi kondisi branch, perhatikan hal-hal berikut:
-
Setiap branch merepresentasikan jalur eksekusi. Branch terakhir adalah else branch, yang dijalankan ketika tidak ada kondisi lain yang cocok dan tidak dapat diedit.
-
Setiap branch dapat berisi beberapa kondisi, yang dapat dikombinasikan menggunakan logika and/or.
-
Verifikasi output dari node hulu, operator (seperti
=,≠,is empty, dandoes not include), serta nilai-nilainya untuk memastikan kondisi yang akurat dan valid.
-
-
Output
Node ini tidak menghasilkan output.
-
Usage example
Saat Anda menghubungkan node Cabang Kondisional ke node downstream, setiap cabang memiliki port koneksi yang sesuai. Jika kondisi suatu cabang terpenuhi, sistem akan menjalankan node downstream di cabang tersebut dan melewatkan cabang lainnya. Gunakan node Agregat Variabel untuk mengumpulkan hasil eksekusi dari cabang aktif.

Variable aggregate
Node ini menggabungkan hasil output dari berbagai branch menjadi variabel terpadu. Saat node Conditional branch atau Intent recognition dijalankan, hanya satu branch yang dieksekusi. Node ini memungkinkan node hulu mereferensikan satu variabel agregat tunggal terlepas dari branch mana yang dijalankan, sehingga mencegah logika redundan.
-
Configuration

-
Input
Saat mengonfigurasi grup variabel, perhatikan hal-hal berikut:
-
Node hulu biasanya merupakan beberapa branch eksekusi yang dihasilkan oleh node Conditional branch atau node Intent recognition.
-
Variabel dalam grup yang sama harus memiliki tipe yang sama. Nilai non-kosong pertama menjadi output untuk grup tersebut.
-
Karena hanya satu cabang hulu yang aktif, setiap kelompok akan memiliki paling banyak satu nilai yang tidak kosong. Variabel aggregate node mengekstrak nilai tersebut untuk digunakan oleh node hilir.
-
Jika setiap branch memiliki beberapa output yang perlu dikumpulkan, Anda dapat menambahkan beberapa grup untuk mengekstrak setiap nilai output yang sesuai.
-
-
Output
Variabel output node bergantung pada grup yang dikonfigurasi. Jika terdapat beberapa grup, node menghasilkan pasangan kunci-nilai untuk setiap grup, di mana kuncinya adalah nama grup dan nilainya adalah variabel non-kosong pertama dari grup tersebut.
-
Usage example
Lihat kasus penggunaan untuk node Conditional branch.
Loop
Node Loop menjalankan tugas berulang di mana setiap iterasi bergantung pada hasil sebelumnya. Loop berlanjut hingga kondisi keluar terpenuhi atau jumlah iterasi maksimum tercapai. Di dalam node Loop, konfigurasikan sub-alur yang akan dijalankan sistem secara berulang berdasarkan variabel loop.
-
Configuration

-
Input
-
Variabel loop: Meneruskan data antar-iterasi. Nilai akhirnya tetap tersedia untuk node hilir setelah loop selesai. Anda dapat mengonfigurasi beberapa variabel loop yang nilainya dimasukkan secara manual atau dipilih dari output node hulu.
-
Kondisi keluar loop: Anda dapat mengonfigurasi kondisi keluar berdasarkan variabel loop. Loop berhenti ketika variabel loop tertentu memenuhi kondisi yang telah ditetapkan.
-
Jumlah iterasi maksimum: Membatasi jumlah maksimum eksekusi loop untuk mencegah loop tak terbatas.
-
-
Output
Output node adalah nilai variabel loop setelah iterasi terakhir. Variabel loop hanya dapat diperbarui oleh node Variable Assigner. Tanpa node ini, output loop akan tetap identik dengan input awalnya, terlepas dari jumlah iterasi.
-
Related nodes
Node terkait loop hanya dapat digunakan di dalam loop. Tambahkan node terkait berikut dengan mengklik ikon + di sebelah kanan node di dalam loop:
-
Break Loop
Keluar dari loop segera. Biasanya didahului oleh node Conditional branch.
-
Variable Assigner
Menetapkan output node di dalam loop ke variabel loop, sehingga memajukan status loop.

-
Direct output
Node Direct output mengonfigurasi konten balasan langsung dengan menggunakan templat output. Node ini mendukung referensi output node hulu dengan sintaks {{node.variable}} dan streaming output.
Contoh: Tambahkan node Direct output sebelum node LLM untuk mengirim pesan awal kepada pengguna, seperti "Thinking...", sementara tugas utama sedang diproses.


Batch processing
Node Batch processing memproses data daftar secara paralel. Node ini menerapkan sub-alur yang sama ke setiap elemen daftar, yang secara signifikan meningkatkan efisiensi. Untuk tugas iteratif di mana setiap langkah bergantung pada langkah sebelumnya, gunakan node Loop sebagai gantinya.
Input
-
Daftar input: Daftar data yang akan diproses. Node mengirim setiap elemen ke sub-alur untuk dieksekusi sebagai item independen.
-
Bidang output: Pilih variabel output dari node di dalam sub-alur untuk menjadi hasil tugas setiap item.
-
Jumlah paralel: Opsional. Mengontrol jumlah tugas yang dieksekusi secara simultan. Nilai default adalah 4, dengan rentang valid 1 hingga 10.
Output
result: Daftar yang berisi hasil output dari semua tugas batch, dalam urutan yang sama dengan daftar input. Mengagregasi nilai output aktual dari "Output field" yang ditentukan dalam input.
Related nodes
Batch Start
Node Batch Start adalah titik masuk untuk sub-alur pemrosesan batch. Node ini menyediakan variabel output berikut untuk direferensikan oleh node selanjutnya dalam sub-alur:
-
item: Item data yang sedang diproses, sesuai dengan elemen dalam daftar input.
-
index: Indeks item data saat ini dalam daftar input (dimulai dari 0).
Batch Break
Node Batch Break digunakan untuk menghentikan pemrosesan item data saat ini secara prematur ketika kondisi tertentu terpenuhi.
Catatan: Node Batch Break hanya menghentikan iterasi saat ini dan tidak memengaruhi pemrosesan item data lainnya.
Usage example
Penguraian dan pemrosesan dokumen batch secara cerdas
Skenario: Perusahaan perlu mengurai beberapa file dokumen secara batch, memanggil LLM untuk pemrosesan konten pada dokumen yang berhasil diurai, dan secara otomatis melewatkan dokumen yang gagal diurai.
Konfigurasi node Batch processing:
|
Parameter |
Nilai |
Deskripsi |
|
Input list |
|
Referensikan daftar file output dari node Start hulu. |
|
Output field |
|
Pilih bidang output node LLM sebagai output untuk node Batch processing. |
|
Parallel count |
|
Proses 4 file secara simultan. |
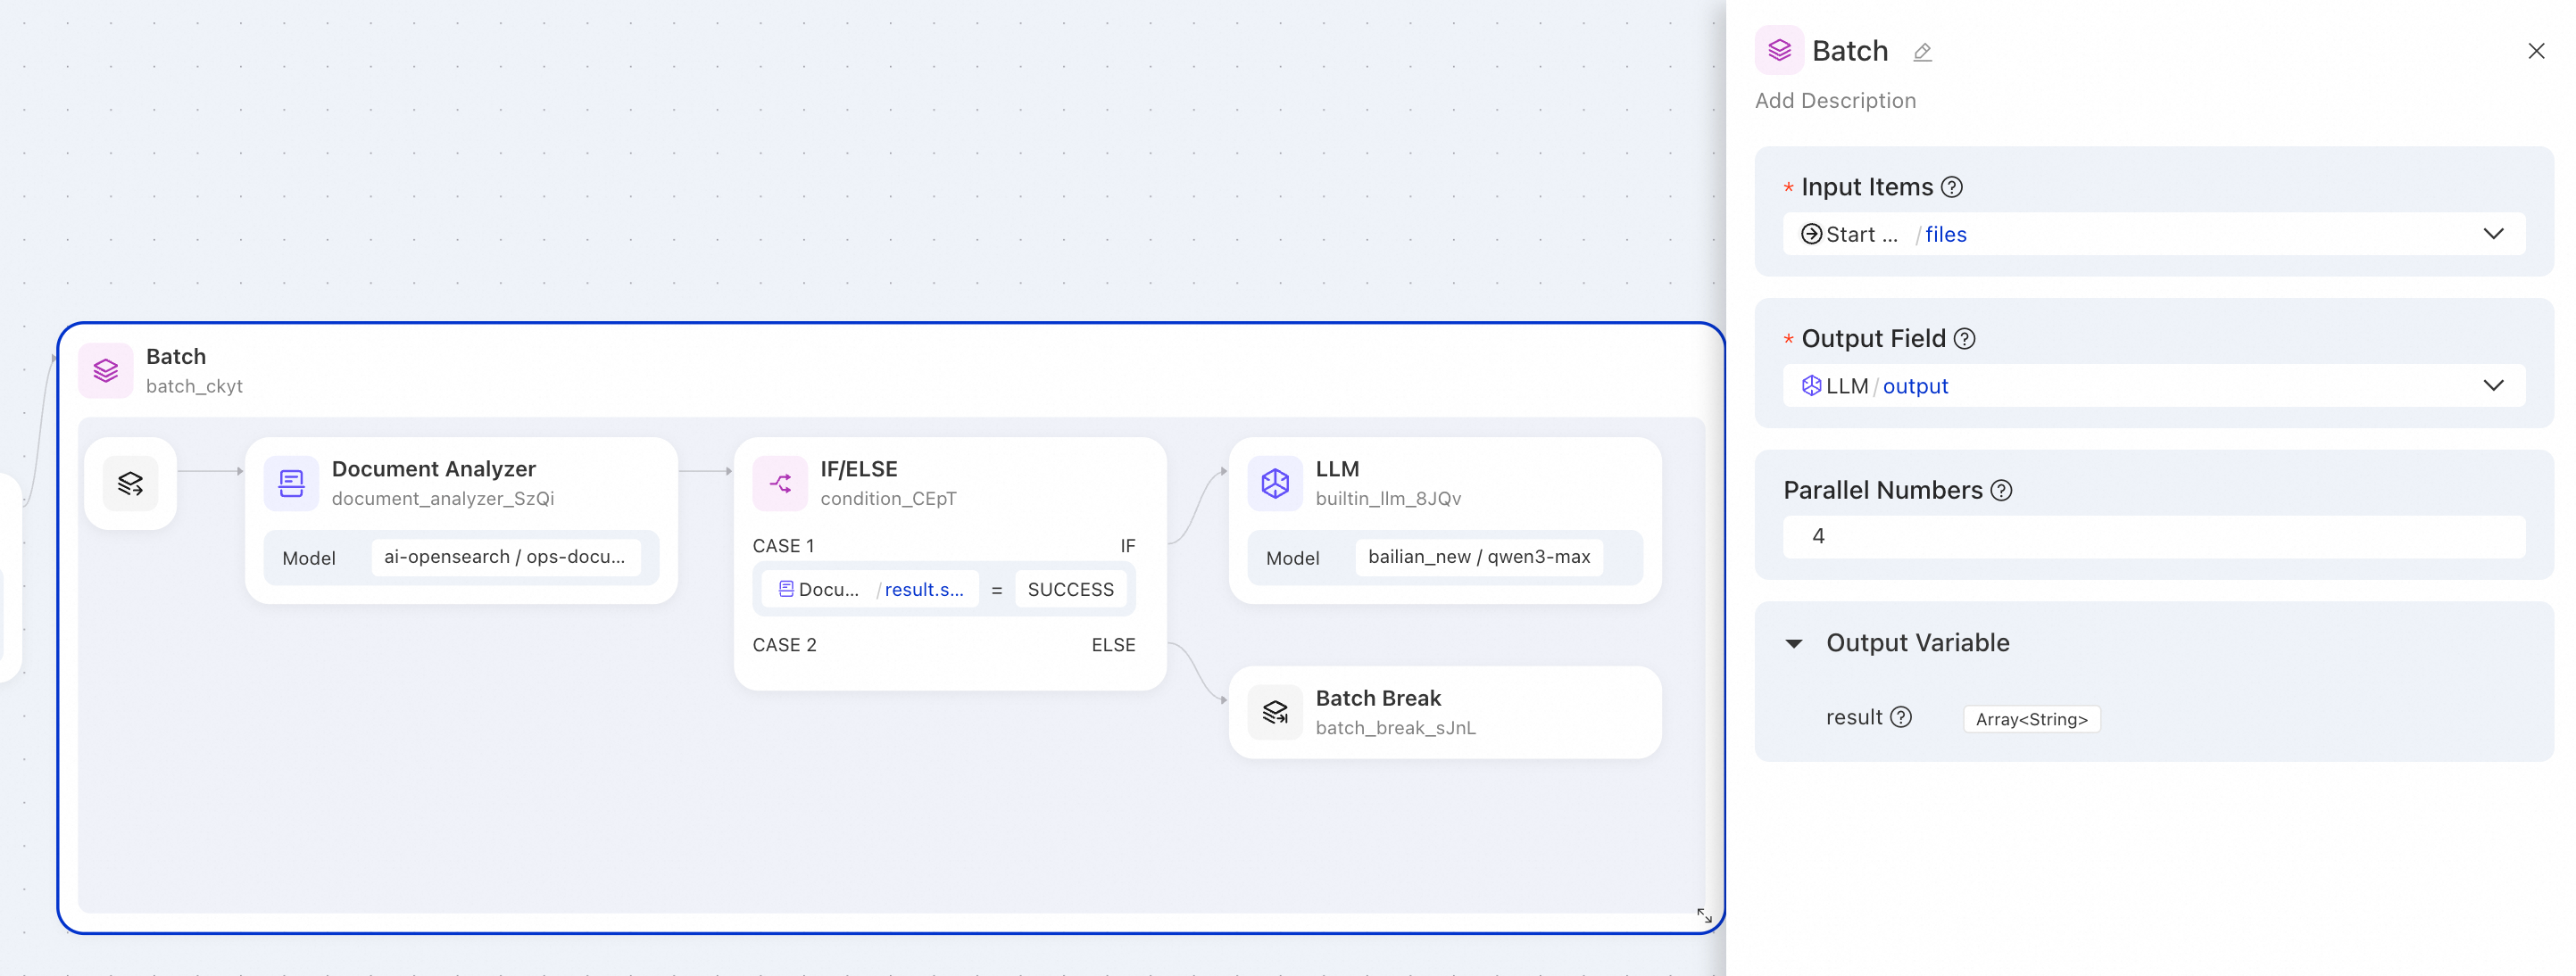
Contoh output:
{
  "result": [
    "Dokumen ini adalah panduan pengguna untuk produk XX, yang mencakup pengenalan fitur produk, langkah-langkah instalasi...",
    "Ini adalah kontrak pengadaan layanan perangkat lunak dengan masa berlaku 12 bulan...",
    null,
    "Faktur pajak pertambahan nilai biasa, tanggal 15 Januari 2026..."
  ]
}Catatan: Nilai null dalam output menunjukkan bahwa file gagal diurai, dan node Batch Break melewatkan pemrosesan selanjutnya.
Notes
-
Urutan hasil terjamin: Urutan daftar output konsisten dengan urutan daftar input.
-
Fleksibilitas sub-alur: Di dalam sub-alur, item data yang berbeda dapat memicu jalur eksekusi yang berbeda.
-
Penanganan nilai null: Jika alur eksekusi suatu item berhenti prematur atau output-nya kosong, posisi yang sesuai dalam daftar output akan bernilai null.
End
Node End menandai penyelesaian suatu application flow dan mendefinisikan parameter output-nya. Satu application flow hanya dapat memiliki satu node End.
-
Konfigurasi parameter output
Output application flow dapat mereferensikan output dari node hulu mana pun. Misalnya, pada contoh di bawah, output 'answer' dari application flow menggunakan output dari node LLM, sedangkan 'search_results' menggunakan output dari node pencarian.
 Catatan
-
Alur percakapan memiliki bidang output default 'Chat', yang berfungsi sebagai output percakapan dari application flow.
-
Application flow harus mencakup node Start dan End. Hanya node yang terhubung di antara keduanya yang dieksekusi; node yang terisolasi diabaikan.
-
AI capabilities
LLM
Node LLM adalah komponen inti dari suatu application flow yang memanggil large language model untuk tugas-tugas bahasa alami seperti generasi teks, menjawab pertanyaan, dan pemrosesan input kompleks. Node ini menyediakan opsi konfigurasi untuk menyesuaikan parameter model, mengelola riwayat percakapan, dan menyesuaikan prompt.
-
Use cases
-
Generasi teks: Hasilkan konten teks berdasarkan topik dan kata kunci.
-
Klasifikasi konten: Secara otomatis mengklasifikasikan jenis email (misalnya, permintaan informasi, keluhan, atau spam).
-
Terjemahan teks: Terjemahkan teks ke bahasa tertentu.
-
RAG: Jawab pertanyaan pengguna dengan menggabungkan pengetahuan yang diambil dengan penalaran model.
-
-
Configuration

-
Input
-
Pengaturan model: Mendukung model yang dideploy dari ModelGallery, layanan model yang dideploy khusus, dan model dari penyedia seperti Dashscope dan DeepSeek. Untuk performa terbaik, pilih model yang sangat mumpuni. Konfigurasikan parameter model berikut:
-
Temperature: Nilai biasanya antara 0 dan 1 yang mengontrol keacakan output. Nilai lebih dekat ke 0 menghasilkan output yang lebih deterministik, sedangkan nilai lebih dekat ke 1 menghasilkan hasil yang lebih beragam.
-
Top P: Ambang batas pengambilan sampel nucleus. Model mengambil sampel dari himpunan token terkecil yang probabilitas kumulatifnya melebihi ambang batas P, memengaruhi keragaman output.
-
Top K: Membatasi token kandidat hanya pada K token paling mungkin. Ini mengurangi keacakan dan membuat output lebih fokus, membatasi kreativitas lebih langsung daripada Top P.
-
Presence penalty: Mengurangi pengulangan entitas atau informasi yang sama. Memberikan penalti pada token yang sudah ada dalam teks yang dihasilkan. Nilai yang lebih tinggi mengurangi pengulangan lebih agresif.
-
Frequency penalty: Memberikan penalti pada token berdasarkan frekuensinya dalam teks yang dihasilkan, mengurangi kata atau frasa yang terlalu sering muncul. Nilai yang lebih tinggi mendorong keragaman leksikal yang lebih besar.
-
Max tokens: Panjang output maksimum (dalam token) per eksekusi. Nilai yang lebih rendah dapat memotong output, sedangkan nilai yang lebih tinggi memungkinkan respons yang lebih panjang.
-
Seed: Ketika ditentukan, model mencoba pengambilan sampel deterministik. Permintaan berulang dengan seed dan parameter yang sama seharusnya menghasilkan hasil yang sama, tetapi determinisme penuh tidak dijamin. Lihat parameter respons system_fingerprint untuk memantau perubahan.
-
Stop sequences: Hingga empat sekuens yang menginstruksikan model untuk berhenti menghasilkan output lebih lanjut. Ketika model menemukan salah satu sekuens ini, ia berhenti menghasilkan token. Teks yang dikembalikan tidak menyertakan sekuens stop.
-
-
Riwayat percakapan: Jika diaktifkan, riwayat percakapan application flow secara otomatis dimasukkan ke dalam prompt.
-
Variabel input: Variabel dapat mereferensikan output dari semua node sebelumnya.
-
Prompt: Prompt berisi konten khusus untuk System (SYSTEM), User (USER), atau Assistant (ASSISTANT). Prompt adalah templat Jinja2 tempat Anda dapat mereferensikan variabel input dengan menggunakan kurung kurawal ganda
{{}}.
-
-
Output
Secara default, node menghasilkan output String tetapi mendukung JSON. Tipe JSON mendukung variabel output kustom, dan model menghasilkan output berdasarkan nama variabel.
-
Use cases
Intent recognition
Node Intent recognition terutama digunakan untuk pengendalian alur. Node ini menggunakan large language model untuk menganalisis maksud pengguna dan mengarahkan eksekusi ke branch yang sesuai berdasarkan hasilnya. Node ini mendukung konfigurasi multi-maksud dan riwayat percakapan.
-
Configuration

-
Input
-
Input pengguna: Pilih input pengguna yang akan digunakan untuk pengenalan maksud.
-
Konfigurasi multi-maksud: Siapkan maksud sesuai kebutuhan, pastikan deskripsi setiap maksud jelas dan tidak ada tumpang tindih semantik antar maksud yang berbeda. Maksud terakhir secara default adalah "Other", yang dicocokkan ketika tidak ada maksud lain yang berlaku dan tidak dapat diedit.
-
Pengaturan model: Konfigurasikan large language model untuk pengenalan maksud. Untuk performa yang lebih baik, pilih model yang lebih mumpuni, seperti qwen-max.
-
Riwayat percakapan: Saat diaktifkan, large language model secara otomatis memasukkan riwayat percakapan application flow ke dalam prompt selama penalaran.
-
Prompt tambahan: Konten ini ditambahkan ke prompt sistem untuk membantu model melakukan pengenalan maksud dengan lebih akurat.
-
-
Output
Node ini tidak menghasilkan output.
-
Usage example
Saat menghubungkan node Intent recognition ke node hulu, setiap branch maksud memiliki port koneksi yang sesuai pada node tersebut. Saat suatu maksud dikenali, node hulu yang terhubung ke branch tersebut dieksekusi, sedangkan node pada branch lain dilewati. Anda kemudian dapat menggunakan node Variable aggregate untuk mengumpulkan hasil eksekusi dari setiap branch.

Agent
Node Agent memungkinkan large language model (LLM) merencanakan, memilih tool, dan bertindak secara otonom. Node ini mendukung strategi penalaran dan kemampuan penggunaan tool. Dengan mengintegrasikan strategi seperti FunctionCalling dan ReAct, node ini memungkinkan LLM memanggil tool yang mematuhi Model Context Protocol (MCP) secara otonom pada waktu proses untuk mencapai penalaran multi-langkah.
Node parameters
-
Strategi agent: Pilih strategi penalaran agent yang diinginkan. Saat ini, strategi FunctionCalling dan ReAct didukung.
FunctionCalling
Fitur ini memungkinkan interaksi antara Large Language Model (LLM) dan tool eksternal berdasarkan definisi
tool callterstruktur (dalam format JSON) dari OpenAI Chat API. LLM menganalisis instruksi bahasa alami pengguna untuk secara otomatis mengidentifikasi maksud, memilih tool yang sesuai, dan mengekstrak parameter. Sistem kemudian memanggil tool yang sesuai dan mengembalikan hasilnya ke model untuk melakukan penalaran lebih lanjut dan menghasilkan jawaban akhir.Kasus penggunaan dan keunggulan:
-
Panggilan terstruktur, kompatibilitas kuat: Menggunakan data terstruktur untuk mendefinisikan dengan jelas nama tool dan parameter panggilan, sehingga kompatibel dengan semua model yang mendukung tool calling.
-
Performa stabil: Cocok untuk tugas dengan tujuan jelas dan langkah-langkah terdefinisi dengan baik, seperti memeriksa cuaca, mencari informasi, atau mengkueri data.
ReAct
ReAct (Reasoning + Acting) adalah strategi penalaran fleksibel yang menggunakan prompt untuk memandu model menghasilkan Thoughts dan Actions secara eksplisit, yang menciptakan loop tertutup untuk penalaran multi-langkah dan pemanggilan tool. Strategi ini biasanya menggunakan bahasa alami untuk menggambarkan proses pemanggilan. Strategi ini memicu eksekusi tool backend dengan mengeluarkan teks seperti "Action=xxx, Action Input=xxx" dan menyuntikkan hasilnya kembali ke rantai penalaran model. Metode ini tidak memerlukan
tool_callstingkat API, sehingga cocok untuk model dan framework yang lebih umum.Kasus penggunaan dan keunggulan:
-
Kemampuan penalaran yang ditingkatkan: Memandu model untuk berpikir langkah demi langkah, dengan setiap langkah secara eksplisit menyatakan logika penalarannya.
-
Strategi transparan: Ideal untuk aplikasi agen yang memerlukan debugging dan interpretabilitas yang kuat.
-
Tidak memerlukan dukungan Tool Calling: Dapat digunakan bahkan dengan model yang tidak mendukung output terstruktur.
-
-
Pengaturan model: Strategi FunctionCalling memerlukan model yang secara native mendukung tool calling. Strategi ReAct tidak memiliki batasan ini, tetapi kami merekomendasikan memilih model dengan kemampuan penalaran yang kuat.
-
Riwayat percakapan: Mengaktifkan riwayat percakapan memberikan memori kontekstual kepada agen. Sistem secara otomatis menyertakan pesan percakapan sebelumnya dalam prompt, memungkinkan agen memahami dan mereferensikan bagian percakapan sebelumnya. Misalnya, agen dengan riwayat percakapan yang diaktifkan dapat menyelesaikan kata ganti (seperti "dia" atau "itu") tanpa memerlukan pengguna mengulang informasi.
-
Perencanaan tugas: Saat diaktifkan, sistem secara otomatis menambahkan tool bawaan
write_todoske tool yang tersedia bagi agen. Untuk pertanyaan pengguna yang kompleks, agen secara otomatis memanggil toolwrite_todosuntuk merencanakan tugas dan mengeksekusinya langkah demi langkah, memperbarui rencana secara dinamis berdasarkan informasi terbaru. -
Tool MCP & tool: Mendukung konfigurasi tool MCP dan non-MCP. Untuk informasi lebih lanjut, lihat Konfigurasikan tool untuk Agent.
-
Konfigurasi prompt
-
Variabel Input: Saat Anda ingin mereferensikan variabel dari node hulu application flow dalam prompt, Anda harus mendefinisikan variabel input yang sesuai di node saat ini dan mengatur nilainya sebagai referensi ke variabel node hulu. Kemudian, di bagian Prompt di bawah, Anda dapat menggunakan sintaks templat Jinja2, yang ditandai dengan kurung kurawal ganda (
{{}}), untuk mereferensikan variabel input yang telah didefinisikan ini dan memungkinkan pengiriman data dinamis. -
Prompt sistem: Digunakan untuk menentukan tujuan tugas dan konteks agen, memberikan latar belakang yang diperlukan kepada model untuk memandu pembuatan responsnya. Ini opsional untuk strategi ReAct.
-
Prompt pengguna: Menerima input atau kueri pengguna, yang berfungsi sebagai dasar untuk pembuatan respons model.
-
-
Jumlah loop: Menetapkan jumlah maksimum siklus eksekusi untuk agen, berkisar dari 1 hingga 99. Agen mengulangi tugas untuk menghasilkan respons hingga salah satu kondisi berikut terpenuhi:
-
LLM menentukan bahwa ia telah mengumpulkan cukup informasi dengan memanggil tool untuk menghasilkan hasil lengkap.
-
Jumlah loop maksimum yang ditetapkan tercapai.
Mengatur jumlah perulangan yang wajar membantu menyeimbangkan kelengkapan tanggapan dengan efisiensi eksekusi. Jika Task planning diaktifkan, kami merekomendasikan menggunakan jumlah perulangan maksimum default agar model dapat sepenuhnya mengeksekusi semua langkah yang direncanakan.
-
-
Variabel output:
-
intermediate_steps: String yang berisi langkah-langkah antara eksekusi agen.
-
text: String yang berisi output akhir agen.
-
Jejak dan log
Setelah mengklik Run di pojok kanan atas halaman application flow, Anda dapat melihat jejak atau log di bawah hasil eksekusi dalam kotak dialog yang muncul.
-
Lihat output antara: Klik ikon status eksekusi di pojok kanan atas node Agent dalam alur kerja. Di panel tarik di bawah, temukan
intermediate_stepsdi Output untuk melihat proses penalaran agen. -
Lihat jejak: Lihat informasi jejak eksekusi saat ini untuk memahami input dan output agen untuk setiap permintaan model (termasuk pemanggilan tool dan parameter permintaan), biaya token, dan konsumsi waktu.
-
Lihat log: Jika application flow mengalami error, Anda dapat melihat log eksekusi saat ini untuk mendapatkan detail lebih lanjut tentang proses eksekusi node.
Selain itu, Anda dapat mengklik ikon di sebelah kanan tombol Run di pojok kanan atas halaman application flow untuk melihat Run History. Pilih catatan eksekusi tertentu untuk melihat jejak atau log-nya.
Document parsing
Mendukung penggunaan parser dokumen cerdas bawaan sistem dan layanan penguraian dokumen dari AI Search Open Platform.
-
Parser bawaan: Mengekstraksi konten terstruktur dan metadata dari dokumen, mendukung berbagai format dokumen utama, termasuk PDF, DOCX, PPTX, TXT, HTML, CSV, XLSX, XLS, JSONL, dan MD.
-
AI Search Open Platform: Mencapai penguraian dokumen terstruktur presisi tinggi, mendukung ekstraksi informasi hierarki logis seperti judul dan paragraf, serta konten seperti teks, tabel, dan gambar. Ini meningkatkan efektivitas dan akurasi ekstraksi dokumen. Anda perlu terlebih dahulu mengonfigurasi koneksi layanan model AI Search Open Platform. Format file yang didukung meliputi PDF, DOCX, PPTX, TXT, dan HTML.
Tool ini mendukung skenario RAG, ringkasan, dan tanya jawab. Antarmuka konfigurasinya sebagai berikut: 
-
Dokumen file: File dokumen yang akan diurai. Pilih bidang tipe file dari node hulu.
-
Pengaturan model: (Opsional) Pilih koneksi layanan model AI Search Open Platform yang telah dibuat di LangStudio. Jika tidak dikonfigurasi, sistem menggunakan metode penguraian dasar bawaan secara default.
-
Output:
-
file_id: Pengidentifikasi unik file input.
-
content: Konten teks terstruktur yang diurai, termasuk informasi hierarkis seperti judul dan paragraf.
-
status: Status penguraian, yang dapat berupa SUCCESS atau FAIL.
-
metadata: Metadata dokumen dan detail penguraian.
-
file_name: Nama file.
-
file_type: Jenis file.
-
source_uri: URI asli file.
-
download_url: URL unduhan file.
-
analysis_method: Metode penguraian yang digunakan. "opensearch" menunjukkan penguraian terstruktur menggunakan AI Search Open Platform, sedangkan "builtin" menunjukkan penggunaan metode penguraian dasar bawaan.
-
-
Contoh penggunaan downstream: Pada node downstream, rujuk bidang hasil dari node penguraian dokumen sesuai kebutuhan. Untuk memanfaatkan hasil penguraian dokumen di node LLM, Anda dapat menyertakan konten yang telah diurai dalam prompt pengguna seperti pada contoh berikut:

Speech recognition
Gunakan node Speech recognition untuk mengonversi file audio atau video menjadi teks. Node ini mendukung berbagai format audio dan pengenalan bahasa.
Input
-
Pengaturan model: Konfigurasikan model pengenalan suara. Saat ini didukung layanan pengenalan suara yang disediakan oleh Alibaba Cloud Model Studio. Kami merekomendasikan menggunakan
paraformer-v2untuk performa pengenalan yang lebih baik dan dukungan multibahasa. -
File audio/video: Pilih file audio atau video yang akan dikenali. Untuk format yang didukung, lihat File type input and output.
-
Bahasa Pengenalan: Menentukan bahasa untuk pengenalan audio. Bahasa yang didukung adalah Mandarin, Inggris, Jepang, Kanton, Korea, Jerman, Prancis, Rusia, atau deteksi otomatis. Catatan: Fitur ini hanya didukung oleh model
paraformer-v2. Model lain menggunakan deteksi bahasa otomatis secara default.
Output
-
file_id: Pengidentifikasi unik file input.
-
status: Status pengenalan. Nilai yang mungkin adalah
SUCCESSatauFAIL. -
content: Konten teks hasil transkripsi.
-
segments: Daftar informasi fragmen kalimat, termasuk stempel waktu, fragmen teks, dan detail lainnya.
-
metadata: Metadata file, termasuk:
-
file_name: Nama file.
-
file_type: Jenis file.
-
source_uri: URI file.
-
download_url: URL unduhan file.
-
Data retrieval
Untuk mengonfigurasi node berikut, lihat Data retrieval node:
-
Knowledge base retrieval
-
Alibaba Cloud IQS - web search
-
SerpAPI - generic search
-
HTTP request
Data processing
Python development (Python)
Alur aplikasi mendukung node dengan kode Python kustom untuk pemrosesan data kompleks. Node ini mendukung input dan output streaming. Halaman konfigurasinya sebagai berikut:

Cukup isi kode Python. Input dan output secara otomatis diurai dari kode. Perhatikan hal-hal berikut:
-
Fungsi entri harus didekorasi dengan
@toolagar dimuat sebagai node.CatatanUntuk mengaktifkan input streaming untuk node Python, Anda harus mengonfigurasi
@tool(properties={"streaming_pass_through": True}). Jika tidak, input ke node Python, seperti dari LLM, akan berupa teks output lengkap alih-alih stream. -
Fungsi mendukung tipe input/output berikut: int, float, bool, str, dict, TypedDict, dataclass (hanya output), list, dan File.
-
Parameter fungsi entri diurai secara dinamis sebagai input node. Output ditempatkan dalam kamus
outputdan dapat direferensikan oleh node lain.PentingPenguraian otomatis parameter input dan output untuk node Python bergantung pada runtime. Jika runtime tidak diluncurkan, Anda tidak dapat mengonfigurasi informasi input dan output node.
-
Jika kode Python Anda memerlukan dependensi, pilih Install Dependencies di pojok kanan atas kanvas dan masukkan paket yang diperlukan. File
requirements.txtdisimpan bersama alur aplikasi. Dependensi diinstal saat Anda meluncurkan runtime atau mendeploy layanan.

Kasus penggunaan 1: Masukkan kode berikut di area kode. Kode ini dipetakan ke input dan output node:
from langstudio.core import tool
from dataclasses import dataclass

@dataclass
class Result:
    output1: str
    output2: int

@tool
def invoke(foo: str, bar: int) -> Result:
    return Result(
        output1="hello" + foo,
        output2=bar + 10
    )

Kasus penggunaan 2: Input dan output streaming. Gunakan node Python untuk memangkas stream teks dari node LLM atau agen yang mencakup proses berpikir. Dengan membuang konten dalam bagian <think>\n\n</think>, Anda bisa mendapatkan stream teks akhir dari hasilnya. Berikut contohnya:
import re
from typing import Iterator
from langstudio.core import tool

@tool(properties={"streaming_pass_through": True})
def strip_think(
    stream: Iterator[str],
) -> Iterator[str]:  # Input adalah iterator string streaming, dan output adalah iterator string streaming yang telah difilter.
    # Cocokkan struktur <think>\n...\n</think> dan tangkap teks setelah tag penutup.
    pattern = re.compile(r"<think>\n[\s\S]*\n</think>(.*)")
    in_thinking = True  # Bendera untuk menunjukkan apakah posisi saat ini berada di dalam blok <think>.
    think_buf = ""      # Buffer untuk menyimpan konten yang belum diproses.

    for chunk in stream:
        if in_thinking:
            think_buf += chunk
            m = pattern.search(think_buf)  # Periksa apakah buffer berisi blok pikiran lengkap.
            if m:
                in_thinking = False
                result_part = m.groups()[0]
                if result_part:
                    yield result_part  # Jika teks hasil ada, hasilkan segera.
        else:
            yield chunk  # Setelah keluar dari blok pikiran, langsung hasilkan semua potongan berikutnya.
Template transformation
Tool Template transformation menggunakan sintaks templat Jinja2 untuk memungkinkan pemformatan teks dan transformasi data yang fleksibel.
Input
Mode transformasi mendukung mode Jinja2 dan mode referensi node.
-
Mode Jinja2: Menggunakan sintaks templat Jinja2 lengkap untuk menyesuaikan format output. Mode ini cocok untuk output terstruktur kompleks, logika kondisional, dan rendering loop.
-
Variabel templat: Definisikan variabel yang digunakan dalam templat.
PentingNama variabel tidak boleh berupa nama metode bawaan Python, seperti
items,keys, atauvalues. Gunakan nama bidang spesifik, sepertiitem_listatauproduct_list. -
Konten templat: String templat yang ditulis dalam sintaks Jinja2. Mendukung sintaks lengkap, termasuk substitusi variabel
{{ variable }}, loop{% for %}, pernyataan kondisional{% if %}, dan filter{{ value | filter }}.PentingSemua variabel yang direferensikan dalam templat harus didefinisikan dalam daftar variabel. Jika tidak, akan terjadi error.
-
-
Mode referensi node: Langsung mereferensikan output node hulu dan secara otomatis menggabungkannya menjadi string. Mode ini cocok untuk skenario kombinasi teks sederhana.
-
Konten templat: Pilih bidang output node hulu. Sistem secara otomatis menggabungkannya secara berurutan.
-
Output
output: Hasil teks setelah templat dirender. Catatan: Panjang konten templat input dan output dibatasi hingga 100.000 karakter. Konten yang melebihi batas ini akan dipotong.
Contoh penggunaan
Contoh 1: Hasilkan email konfirmasi pesanan
Konfigurasi variabel:
|
Nama variabel |
Nilai variabel |
|
customer_name |
|
|
order_id |
|
|
products |
|
|
total |
|
Konten templat:
Dear {{ customer_name }}:

Your order {{ order_id }} has been confirmed. The details are as follows:

{% for product in products %}
- {{ product.name }}: ¥{{ product.price }}
{% endfor %}

Total: ¥{{ total }}

Thank you for your purchase!
Hasil output:
Dear John Doe:

Your order ORD-2025-001 has been confirmed. The details are as follows:

- Laptop: ¥8999
- Wireless Mouse: ¥199

Total: ¥9198

Thank you for your purchase!
Contoh 2: Format hasil pengambilan basis pengetahuan
Konfigurasi variabel:
|
Nama variabel |
Nilai variabel |
|
chunks |
|
Konten templat:
{% for chunk in chunks %}
### Relevance: {{ "%.2f" % chunk.score }}
#### {{ chunk.title }}
{{ chunk.content }}
---
{% endfor %}
Hasil output:
### Relevance: 0.95
#### Product Introduction
This is a detailed introduction to the product...
---
List operations
Tool List operations memungkinkan Anda melakukan penyaringan dan pengurutan fleksibel pada berbagai jenis data daftar untuk pemrosesan dan pemilihan data detail halus.
Input
-
Daftar input: Data daftar yang akan diproses. Mendukung semua subtipe, seperti string, angka, boolean, objek file, dan kamus.
-
Operasi: Rangkaian operasi berantai yang dieksekusi berurutan. Mendukung dua jenis operasi: penyaringan dan pengurutan.
-
Operasi filter (filter): Operasi filter secara dinamis menyediakan metode penyaringan berbeda berdasarkan tipe daftar input. Catatan: Semua operasi filter peka huruf besar/kecil.
Kunci filter
Deskripsi
Cakupan
Index
Menyaring berdasarkan posisi elemen dalam daftar.
Berlaku untuk semua tipe daftar.
Element value
Menyaring berdasarkan nilai elemen itu sendiri.
Berlaku untuk semua tipe daftar.
Custom attribute
Menyaring berdasarkan atribut kustom.
Hanya berlaku untuk daftar kamus.
File attribute
Menyaring berdasarkan atribut file.
Hanya berlaku untuk daftar file.
-
Operasi sort (sort): Operasi sort menyediakan metode pengurutan berbeda berdasarkan tipe daftar input.
Sort Key
Deskripsi
Cakupan
Element value
Mengurutkan berdasarkan nilai elemen itu sendiri.
Hanya berlaku untuk daftar string, angka, atau boolean.
Custom attribute
Mengurutkan berdasarkan atribut kustom.
Hanya berlaku untuk daftar kamus.
File attribute
Mengurutkan berdasarkan atribut file.
Hanya berlaku untuk daftar file. Atribut yang tersedia sama dengan operasi filter.
-
Output
-
result: Hasil daftar yang telah diproses.
-
first_item: Elemen pertama dari daftar hasil. Jika daftar kosong, nilainya adalah
None. -
last_item: Elemen terakhir dari daftar hasil. Jika daftar kosong, nilainya adalah
None.
Contoh penggunaan
Contoh 1: Klasifikasi file - Filter file gambar, urutkan berdasarkan panjang nama file, dan ambil 3 teratas
Skenario: Pengguna mengunggah daftar campuran berbagai jenis file. Anda perlu memfilter file gambar, mengurutkannya berdasarkan panjang nama file, dan hanya menyimpan 3 teratas untuk pemrosesan pengenalan gambar selanjutnya.
Konfigurasi operasi:
Operation 1 - Filter (berdasarkan kategori file):
  Filter key: item.category
  Filter operator: equals
  Filter value: image

Operation 2 - Sort (berdasarkan panjang nama file):
  Sort key: item.file_name
  Sort direction: asc

Operation 3 - Filter (ambil 3 teratas):
  Filter key: index
  Filter operator: less than
  Filter value: 3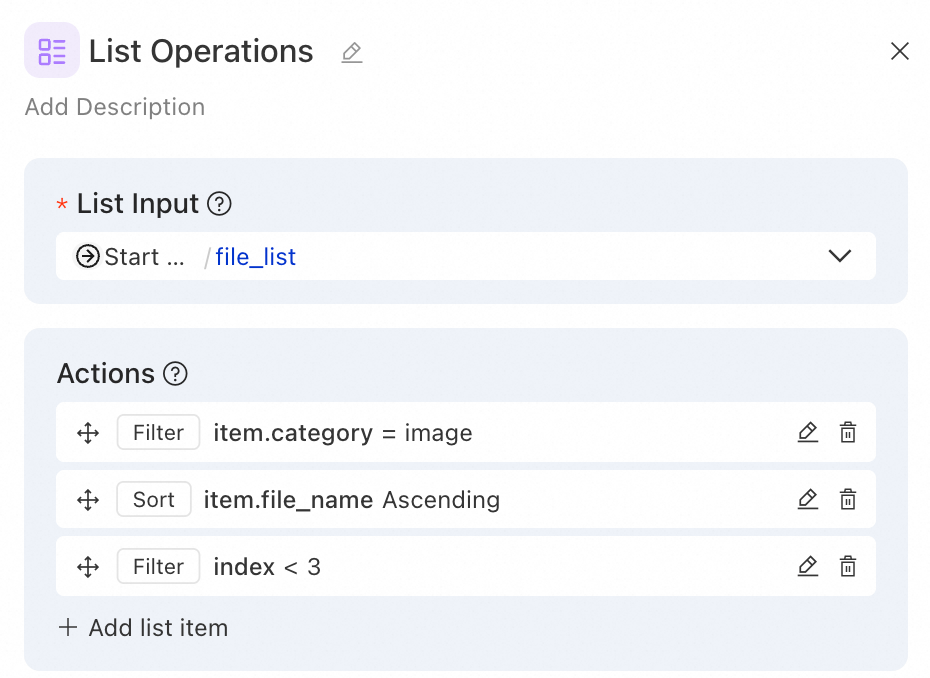
Contoh 2: Analisis data - Filter pengguna dengan skor tinggi dan ambil 5 teratas
Skenario: Dari daftar penilaian pengguna, filter pengguna dengan skor 80 atau lebih tinggi, urutkan berdasarkan skor secara menurun, dan ambil 5 teratas.
Daftar input:
[
  {"name": "Zhang San", "score": 95, "department": "Tech Dept"},
  {"name": "Li Si", "score": 72, "department": "Marketing Dept"},
  {"name": "Wang Wu", "score": 88, "department": "Tech Dept"},
  {"name": "Zhao Liu", "score": 91, "department": "Product Dept"},
  {"name": "Qian Qi", "score": 65, "department": "Marketing Dept"},
  {"name": "Sun Ba", "score": 98, "department": "Tech Dept"}
]
Konfigurasi operasi:
Operation 1 - Filter (pengguna ber-skor tinggi):
  Filter key: item.score
  Filter operator: greater than or equal to
  Filter value: 80

Operation 2 - Sort (berdasarkan skor menurun):
  Sort key: item.score
  Sort direction: desc

Operation 3 - Filter (ambil 5 teratas):
  Filter key: index
  Filter operator: less than
  Filter value: 5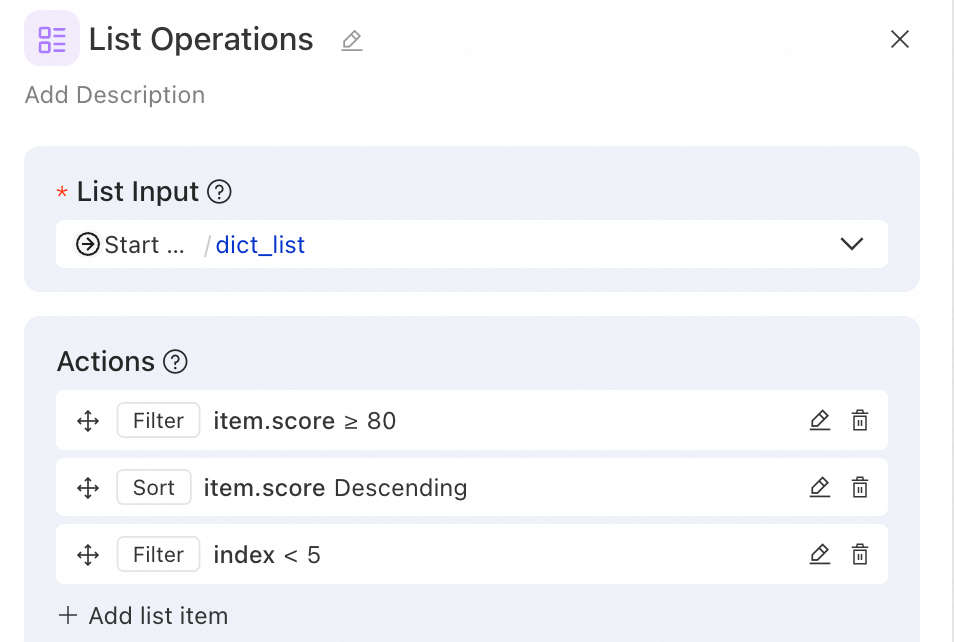
Hasil output:
[
  {"name": "Sun Ba", "score": 98, "department": "Tech Dept"},
  {"name": "Zhang San", "score": 95, "department": "Tech Dept"},
  {"name": "Zhao Liu", "score": 91, "department": "Product Dept"},
  {"name": "Wang Wu", "score": 88, "department": "Tech Dept"}
]
Catatan:
-
Jika input tool mereferensikan variabel output tipe
listyang dikustomisasi di node Python, definisikan tipe elemen yang jelas untuk daftar tersebut di node Python, sepertilist[str]. Ini memastikan pencocokan operator yang lebih akurat di node List operations.