Une source de données enregistre les détails de connexion d'un système de données externe (base de données, stockage ou file d'attente de messages) dans DataWorks pour la lecture et l'écriture de données entre les modules. Les espaces de travail en mode standard prennent en charge l'isolation d'environnement : des sources de données distinctes pour le développement et la production empêchent les opérations de test d'affecter les données de production.
Fonctionnalités
Utilisation des sources de données
Les sources de données dans DataWorks sont gérées de manière centralisée dans la section d'un espace de travail. Après avoir créé et testé une connexion, vous pouvez l'utiliser dans tous les modules de DataWorks.
|
Module |
Cas d'utilisation |
Types pris en charge |
|
Data Integration |
Exécutez des tâches de synchronisation de données pour migrer des données entre des sources de données, par exemple de MySQL vers MaxCompute. Prend en charge divers types de synchronisation, notamment table unique, base de données complète, par lots et en temps réel. |
Sources de données et solutions de synchronisation prises en charge |
|
Data Studio |
Développez, déboguez et planifiez périodiquement des nœuds. En mode standard, les tâches utilisent automatiquement la source de données désignée pour l'environnement de développement ou de production. |
|
|
Data Map |
Collectez les métadonnées à partir des sources de données. Vous pouvez consulter les structures de table et les informations de lignage. |
Sources de données et méthodes de collecte de métadonnées prises en charge |
|
Data Analysis |
Connectez-vous aux bases de données pour le traitement, l'analyse, la transformation et la visualisation des données. |
|
|
Data Service |
Générez des services API basés sur les structures de table des sources de données pour fournir des interfaces de requête de données. |
Sources de données prises en charge pour la génération d'API |
Isolation d'environnement des sources de données
Les espaces de travail en mode standard prennent en charge l'isolation d'environnement des sources de données : des sources de données distinctes pour le développement et la production empêchent les opérations de test d'affecter les données de production. Pour plus d'informations, consultez la section Description de l'environnement des sources de données.
Types de sources de données
DataWorks prend en charge deux types de sources de données :
|
Comparaison |
Type standard |
Type de métadonnées |
|
Objectif principal |
Stocke les détails de connexion pour l'accès physique aux données, utilisé pour la lecture, l'écriture et le calcul. |
Stocke les détails de connexion pour les centres de métadonnées de data lake. Il est utilisé uniquement pour la collecte et la gouvernance des métadonnées. |
|
Objet cible |
Les données physiques elles-mêmes. |
Informations descriptives sur les données (métadonnées), telles que les structures de base de données, de tables et de colonnes. |
|
Disponible pour l'exécution des tâches |
Oui. Le lecteur et le rédacteur des tâches de synchronisation doivent référencer ce type de source de données. |
Non. Ne peut pas être utilisé comme entrée ou sortie de tâche. |
|
Exemples typiques |
MySQL, MaxCompute, Hologres, DLF, OSS, etc. |
Catalogue Paimon. |
Résumé : Utilisez des sources de données standard pour la lecture, l'écriture ou le calcul de données. Utilisez des sources de données de métadonnées pour intégrer les structures de tables de data lake Paimon et autres dans DataWorks à des fins de gouvernance et de consultation.
Prérequis
Avant de configurer une source de données, assurez-vous que les conditions suivantes sont remplies :
Exigences en matière d'autorisations : Vous devez disposer du rôle Workspace Administrator ou Operator dans l'espace de travail cible, ou être un utilisateur RAM disposant de la stratégie
AliyunDataWorksFullAccessouAdministratorAccess. Autorisation : Accorder des autorisations à un utilisateur RAM et Gérer les rôles et les membres de l'espace de travail.Détails de connexion : Préparez les informations de connexion : instance ou endpoint (Endpoint/JDBC URL), port, nom de la base de données, nom d'utilisateur et mot de passe.
Connectivité réseau : Assurez-vous que le groupe de ressources DataWorks peut accéder à votre source de données. Si votre source de données est accessible via Internet et que vous utilisez un groupe de ressources serverless, vous devez configurer une passerelle NAT Internet et une EIP pour le VPC associé au groupe de ressources.
Remarques
Limites d'utilisation : Les sources de données créées avec des méthodes inter-régions, inter-comptes ou AccessKey ne peuvent être utilisées que pour la synchronisation de données, et non pour le développement de données ou la planification de tâches.
Différences de création de module : En mode standard, les sources de données créées dans Administration incluent les informations des environnements de développement et de production. Les sources de données créées dans Data Integration incluent uniquement les informations de l'environnement de production. Créez et maintenez toutes les sources de données dans Administration.
Méthodes de création : Automatique et manuelle
|
Méthode de création |
Description |
Scénario applicable |
|
Création automatique |
Lorsque vous associez une ressource de calcul (telle que MaxCompute ou Hologres) à un espace de travail, le système crée et gère automatiquement la source de données correspondante. Son cycle de vie et ses autorisations sont hérités de la ressource de calcul. |
Recommandé : Lorsque la source de données est utilisée pour le développement de données, vous devez utiliser cette méthode. Sinon, les tâches ne peuvent pas s'exécuter. |
|
Création manuelle |
Spécifiez manuellement les détails de connexion, les identifiants d'authentification et d'autres paramètres pour la source de données. Vous pouvez contrôler le cycle de vie et l'attribution des autorisations de la source de données. |
S'applique à tous les types de sources de données, en particulier pour Data Integration, Data Service ou les scénarios nécessitant un contrôle granulaire des autorisations. |
Point d'entrée
-
Connectez-vous à la console DataWorks. Dans la région cible, cliquez sur dans le volet de navigation de gauche. Sélectionnez un espace de travail dans la liste déroulante et cliquez sur Go to Management Center.
Dans le volet de navigation de gauche, cliquez sur Data Sources pour accéder à la page Data Sources.
Cliquez sur Add Connection dans le coin supérieur gauche de la page.
Créer une source de données
Étape 1 : Sélectionner un mode de connexion
DataWorks prend en charge les modes Instance Mode et User-created Data Store with Public IP Addresses pour configurer les connexions aux sources de données.
Scénario 1 : Mode instance (compte Alibaba Cloud actuel)
Si votre source de données est un service Alibaba Cloud (tel que ApsaraDB RDS ou PolarDB) sous le compte actuel, sélectionnez Instance Mode. Spécifiez la Region et l'Instance. Le système obtient automatiquement les détails de connexion.
Si vous achetez une nouvelle instance, utilisez le même VPC que le groupe de ressources DataWorks pour minimiser la configuration réseau.
Si vous disposez déjà d'une instance de source de données et que son VPC est différent du VPC utilisé par le groupe de ressources DataWorks, assurez-vous de configurer la connectivité réseau pour garantir un accès approprié à la source de données.
Scénario 2 : Mode instance (autre compte Alibaba Cloud)
Lorsque vous ajoutez une source de données en mode instance, si vous devez accéder à une instance sous Another Alibaba Cloud Account, vous pouvez configurer l'ID of Another Alibaba Cloud Account et le Name of Role Assigned to RAM User pour créer une source de données inter-comptes.
Lors de la création d'une source de données inter-comptes, assurez-vous que :
Le rôle RAM que vous utilisez a accès à la source de données cible. Pour l'autorisation inter-comptes, consultez les sections Autorisation inter-comptes pour les sources de données et Autorisation inter-comptes pour les instances.
La connectivité réseau est établie entre le groupe de ressources du compte consommateur (compte actuel) et la source de données du compte propriétaire de la ressource (autre compte).
Scénario 3 : Mode chaîne de connexion
Pour les sources de données auto-gérées sur des instances ECS, dans des centres de données sur site ou sur le réseau public, utilisez le mode chaîne de connexion. Configurez manuellement l'adresse réseau (Endpoint/JDBC URL), le port, le nom de la base de données et les identifiants (nom d'utilisateur/mot de passe/AccessKey).
Lors de l'utilisation du mode chaîne de connexion, assurez-vous que l'adresse IP et le port sont accessibles depuis le réseau du groupe de ressources DataWorks. Déterminez s'il faut activer l'accès au réseau public et configurez les groupes de sécurité et les listes d'autorisation selon les besoins. Configurer la connectivité réseau.
Si l'adresse IP de votre source de données change fréquemment ou utilise un accès basé sur un domaine, résolvez ce problème en associant un hôte à un groupe de ressources exclusif pour Data Integration ou en configurant la résolution DNS PrivateZone pour le groupe de ressources serverless.
Lorsque vous utilisez le mode chaîne de connexion, DataWorks analyse automatiquement l'URL JDBC. Si l'URL contient des paramètres non pris en charge, le système supprime automatiquement ces paramètres. Pour conserver des paramètres spéciaux, pour contacter le support technique.
Étape 2 : Saisir les détails de connexion
En mode standard, vous devez configurer séparément les détails de connexion pour l'environnement de développement et l'environnement de production. Vous pouvez choisir d'utiliser les mêmes configurations ou des configurations différentes pour les deux environnements.
Nom de la source de données : Doit être unique dans l'espace de travail. Nous vous recommandons d'utiliser un nom qui identifie clairement l'activité et l'environnement, tel que
rds_mysql_order_dev.Description de la source de données : Décrivez brièvement l'objectif de la source de données.
Détails de connexion : Selon le mode de connexion décrit ci-dessus, saisissez l'instance ou l'adresse URL, le port et d'autres informations pour la source de données.
Étape 3 : Définir les identifiants d'authentification
DataWorks prend en charge plusieurs méthodes d'authentification. Définissez les identifiants en fonction du type de source de données et de la page de configuration. Assurez-vous que les identifiants disposent des autorisations de base de données requises.
Méthode d'authentification | Cas d'utilisation |
Nom d'utilisateur et mot de passe | S'applique à la plupart des types de bases de données (tels que ApsaraDB RDS et StarRocks). DataWorks accède à la source de données via l'authentification par nom d'utilisateur et mot de passe. |
Compte RAM | Plusieurs méthodes sont prises en charge comme décrit ci-dessous. S'applique aux services Alibaba Cloud qui prennent en charge l'authentification par compte RAM, tels que MaxCompute et Hologres. Vous pouvez définir le compte en fonction des autorisations requises.
|
Authentification Kerberos | Un mécanisme d'authentification tiers. S'applique aux composants Big Data tels que Hive, HDFS et HBase. L'authentification Kerberos nécessite le téléchargement des fichiers d'authentification Keytab, krb5.conf, etc. Guide de configuration : Configurer l'authentification Kerberos. |
AccessKey | Une paire AccessKey est un identifiant d'accès permanent composé d'un AccessKey ID et d'un AccessKey Secret. S'applique aux sources de données telles que OSS et Tablestore. Les paires AccessKey ont un niveau de sécurité inférieur — utilisez l'authentification basée sur un rôle RAM lorsque cela est possible. |
Secret générique KMS | Hébergez les identifiants d'accès à la source de données dans Alibaba Cloud Key Management Service (KMS). Lors de la création d'une source de données, définissez Access identity sur Key Management Service, sélectionnez la Kms Region où réside le secret générique KMS, et sélectionnez le secret générique cible dans la KMS List. Après la rotation du secret, DataWorks utilise automatiquement le dernier identifiant, et aucune reconfiguration dans DataWorks n'est requise. Vous devez d'abord créer un secret générique dans KMS. Pour plus d'informations, consultez Gérer et utiliser des secrets génériques. Le contenu d'un secret générique KMS prend en charge les deux formats JSON suivants : Types de sources de données prenant actuellement en charge les secrets génériques KMS : DB2, FTP, MongoDB, MySQL, Oracle, PolarDB, PolarDB-O, PostgreSQL, PolarDB-X 2,0, SQL Server. Remarque Après la modification du contenu d'un secret générique KMS, DataWorks met en cache le secret pendant jusqu'à 5 minutes. Le nouveau secret prend effet au plus tard dans les 5 minutes. |
Si l'authentification SSL est activée sur votre base de données, activez également SSL lors de la création de la source de données. Activer l'authentification SSL pour une source de données PostgreSQL.
Étape 4 : Tester la connectivité
En bas de la page, cliquez sur Test Connectivity pour chaque groupe de ressources associé à l'espace de travail.
Si Connectable s'affiche, la configuration est correcte.
Si Cannot Connect s'affiche, le système fournit un outil de diagnostic pour aider au dépannage. Les causes courantes incluent des identifiants incorrects, des problèmes réseau (liste d'autorisation IP non configurée) ou une passerelle NAT manquante.
En mode standard, assurez-vous que l'environnement de développement et l'environnement de production affichent tous deux Connectable. Sinon, des erreurs se produiront lors de l'utilisation ultérieure.
Vous pouvez configurer le réseau en fonction du mode de configuration de la source de données, de la région, de la propriété de l'instance et de l'emplacement de déploiement :
|
Scénario |
Instructions |
|
La source de données est un service Alibaba Cloud et appartient au même compte Alibaba Cloud et se trouve dans la même région que l'espace de travail DataWorks. |
Connecter des sources de données (même compte et même région) |
|
La source de données est un service Alibaba Cloud et appartient au même compte Alibaba Cloud que l'espace de travail DataWorks, mais se trouve dans une région différente. |
Connecter des sources de données sous le même compte Alibaba Cloud dans différentes régions |
|
La source de données est un service Alibaba Cloud, mais appartient à un compte Alibaba Cloud différent de celui de l'espace de travail DataWorks. |
|
|
La source de données est déployée sur une instance ECS Alibaba Cloud. |
|
|
La source de données est déployée dans un centre de données sur site. |
|
|
La source de données dispose d'un endpoint public. |
Gérer les sources de données
Sur la page de gestion des sources de données, filtrez les sources par Data Source Type et Data Source Name. Vous pouvez également effectuer les opérations suivantes sur une source de données :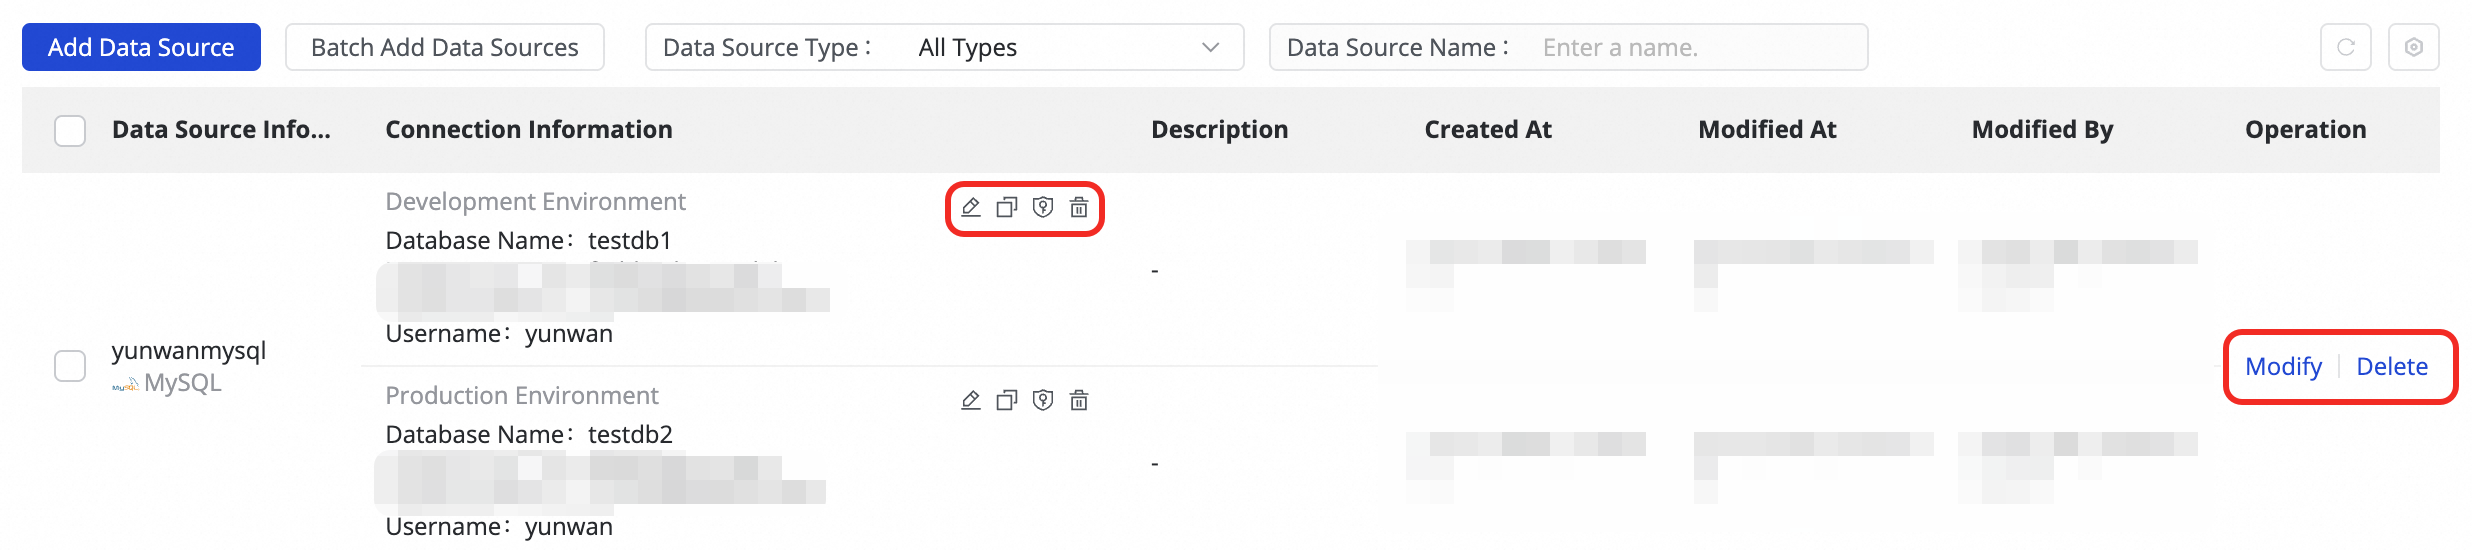
Modifier, cloner et gérer les autorisations
-
Edit : modifiez la configuration d'une source de données selon vos besoins. Le nom de la source de données et l'environnement applicable ne peuvent pas être modifiés.
Les sources de données créées automatiquement lors de l'association d'une ressource de calcul dans Administration ne peuvent pas être directement modifiées. Pour les modifier, accédez à la page de gestion des ressources de calcul.
Cloning : clonez une source de données pour créer rapidement une nouvelle source avec la même configuration.
-
Manage Permissions : cliquez sur l'icône
 pour gérer les autorisations d'utilisation inter-espaces de travail pour la source de données. La gestion des autorisations des sources de données vous permet d'accorder l'accès à la source de données actuelle à d'autres espaces de travail ou à des utilisateurs spécifiques d'autres espaces de travail. Après avoir accordé l'autorisation Allowed, l'utilisateur peut afficher et utiliser la source de données, mais ne peut pas la modifier.
Autres questions relatives aux autorisations des sources de données : FAQ sur les autorisations des sources de données .
Supprimer une source de données et ses impacts
Dans la liste des sources de données, cliquez sur le bouton de suppression pour supprimer une source de données. Toutefois, les sources de données créées automatiquement lors de l'association d'une ressource de calcul dans Administration ne peuvent pas être directement supprimées. Dans Administration, cliquez sur Computing Resources dans le volet de navigation de gauche, localisez la ressource de calcul, puis cliquez sur Disassociate. Après la dissociation, la source de données correspondante est également supprimée.
Les impacts de la suppression d'une source de données sur le module Data Integration sont les suivants :
Pré-vérification : avant de supprimer une source de données, vérifiez si celle-ci est associée à des tâches de synchronisation dans l'environnement de production.
Solution : si des tâches associées existent, utilisez la fonctionnalité de modification par lot pour changer la source de données des tâches, puis soumettez et déployez-les à nouveau.
Scénario de suppression | Impact |
Supprimer les environnements de développement et de production | • Les tâches de production échoueront complètement et ne pourront pas s'exécuter. • La source de données ne sera pas visible lors de la configuration de nouvelles tâches dans l'environnement de développement. |
Supprimer uniquement l'environnement de développement | • Les tâches de production peuvent s'exécuter normalement. • Toutefois, lors de la modification d'une tâche, les métadonnées (telles que les structures de table) ne peuvent pas être récupérées. • La source de données ne sera pas visible lors de la configuration de nouvelles tâches dans l'environnement de développement. |
Supprimer uniquement l'environnement de production | • Les tâches de production échoueront complètement et ne pourront pas s'exécuter. • Les tâches utilisant cette source de données dans l'environnement de développement ne peuvent pas être soumises ni déployées dans l'environnement de production. |
Les impacts sur les autres modules sont les suivants :
|
Module |
Niveau de risque |
Principaux impacts et solutions |
|
Operation Center |
Élevé |
Impact : toutes les tâches de calcul périodique et Data Integration dépendant de cette source de données échoueront. Solution : utilisez la modification par lot pour changer la source de données des tâches, puis redéployez-les. |
|
Data Service API |
Élevé |
Impact : tous les API générées et les orchestrations d'API basées sur cette source de données ne pourront pas être appelées. Solution : remplacez la source de données pour les API concernées. |
|
Data Analysis |
Moyen |
Impact : dans le module DataAnalysis, les tâches de requête ciblant cette source de données échoueront. Solution : basculez vers une autre source de données disponible lors de l'exécution des requêtes SQL. |
|
Data Quality |
Moyen |
Impact : les tâches avec des règles de surveillance de la qualité des données configurées signaleront des exceptions de vérification. Solution : accédez à Operation Center et dissociez les tâches des règles DQC, ou modifiez les règles. |
Si la source de données a été accordée pour une utilisation inter-espaces de travail, sa suppression entraînera également l'échec des tâches utilisant cette source de données dans d'autres espaces de travail.
Rubriques avancées
Description de l'environnement de la source de données
Modes d'espace de travail : Basique vs Standard
DataWorks propose des espaces de travail en mode basique et en mode standard. Mode basique et mode standard.
Mode basique : environnement unique. Toutes les opérations de développement affectent directement la production. Adapté à la vérification rapide ou aux tests personnels.
Mode standard : recommandé pour une utilisation en entreprise. Environnements de développement et de production intégrés. Vous pouvez configurer différentes sources de données (telles que des bases de données de test et de production) ou différentes autorisations d'accès pour chaque environnement afin d'assurer l'isolation des données.
Isolation des environnements de source de données
Les espaces de travail en mode standard prennent en charge l'isolation des environnements de source de données. Une source de données portant le même nom peut avoir deux configurations — une pour le développement et une pour la production — se connectant à différentes bases de données ou instances. Cela isole les données accessibles pendant les tests et la planification de production, empêchant la contamination des données de production par des opérations de débogage.

Dans le module Data Integration, seules les tâches de synchronisation par lot de table unique dans les espaces de travail en mode standard prennent en charge l'isolation des sources de données entre les environnements de développement et de production. Les autres types de tâches de synchronisation utilisent la source de données de l'environnement de production.
Une source de données configurée uniquement pour l'environnement de production et sans informations sur l'environnement de développement ne peut pas être sélectionnée lors de la configuration des nœuds dans Data Studio.
Si vous mettez à niveau un espace de travail du mode basique vers le mode standard, la source de données d'origine est divisée en deux sources de données pour les environnements de production et de développement. Mettre à niveau un espace de travail du mode basique vers le mode standard.
Relation avec les sources de données Data Integration
Mode basique :
Lorsque l'espace de travail est en mode basique, il n'y a qu'un seul environnement. Les sources de données créées dans Data Integration et celles créées dans Administration sont identiques.
Mode standard :
Lorsque vous créez une source de données dans Administration, une source de données portant le même nom est automatiquement créée dans Data Integration. Les deux partagent la configuration de l'environnement de production de la source de données.
Lorsque vous créez une source de données dans Data Integration, une source de données portant le même nom est également automatiquement créée dans Administration. Toutefois, cette source de données ne contient que les informations de l'environnement de production, et l'environnement de développement affichera des informations manquantes. Vous devez compléter les informations de l'environnement de développement avant que la source de données puisse être utilisée dans Data Studio.
Pour garantir l'intégrité des informations de la source de données, nous vous recommandons de toujours créer et gérer toutes les sources de données dans Administration.
FAQ
-
Q : Une tâche configurée avec une source de données dans un espace de travail en mode standard réussit dans l'environnement de développement mais échoue lors de la planification de production. Pourquoi ?
R :
Vérifiez si le test de connectivité réussit pour l'environnement de développement et l'environnement de production de la source de données.
Vérifiez si les données dans les bases de données de l'environnement de développement et de l'environnement de production sont cohérentes et répondent aux exigences métier.
-
À quoi servent les sources de données des environnements de développement et de production ?
Vous pouvez configurer des sources de données distinctes pour l'environnement de développement et l'environnement de production. Les sources de données de l'environnement de développement sont utilisées uniquement pour le développement et le débogage des nœuds, tandis que les sources de données de l'environnement de production gèrent la planification périodique des nœuds déployés. Cette séparation stricte empêche les opérations de test d'affecter les données de production.
-
Q : Pourquoi le test de connectivité de la source de données échoue-t-il ?
R : cela est généralement dû aux raisons suivantes. Vérifiez-les une par une. Pour la configuration de la connectivité réseau, consultez Configurer la connectivité réseau.
Identifiants incorrects : vérifiez si le nom d'utilisateur et le mot de passe saisis sont corrects.
Cible d'accès incorrecte : vérifiez si le nom de la base de données, du bucket ou d'une autre cible de connexion saisi est correct, et si le compte et le mot de passe disposent des autorisations d'accès requises.
Adresse ou port incorrect : vérifiez si l'adresse de connexion et le numéro de port de la source de données sont corrects. Si un nom de domaine hôte est spécifié comme adresse, assurez-vous que le nom de domaine peut être correctement résolu. Consultez Résolution DNS PrivateZone.
Problèmes réseau : vérifiez si la source de données et le groupe de ressources sont connectés. Si la source de données dispose de contrôles de liste d'autorisation, vérifiez si le bloc CIDR du vSwitch associé au groupe de ressources a été ajouté à la liste d'autorisation. Si vous utilisez un groupe de ressources serverless pour vous connecter à une source de données sur le réseau public, vérifiez si une passerelle NAT a été configurée.
-
Q : Quelle est la différence entre une ressource de calcul et une source de données ?
R :
Une ressource de calcul est une instance de ressource dans DataWorks capable d'exécuter des tâches de traitement et d'analyse des données et disposant de capacités de calcul. Elle fait généralement référence au moteur de calcul sous-jacent, tel que MaxCompute, Hologres ou AnalyticDB, et est principalement utilisée pour les tâches de développement et de planification des données.
Une source de données dans DataWorks est utilisée pour se connecter à divers services de stockage de données et fournit des capacités de stockage et de gestion des données. Les sources de données fournissent des interfaces pour la lecture et l'écriture des données, et sont principalement utilisées pour les tâches de synchronisation et d'intégration. De plus, les sources de données prennent également en charge des fonctionnalités telles que les nœuds de base de données, les API Data Service et l'analyse des requêtes.
-
Q : Quelle est la différence entre une source de données DLF et une source de données Paimon Catalog ?
R : Une source de données DLF est un type de source de données standard qui peut être utilisé pour Data Integration et Data Analysis. Elle prend également en charge la gestion des métadonnées pour Paimon, Iceberg et d'autres types de tables utilisant des métadonnées enregistrées dans DLF. Une source de données Paimon Catalog est utilisée uniquement pour la collecte de métadonnées des formats de lac Paimon provenant de sources non-DLF, prenant en charge des fonctionnalités de gouvernance telles que la récupération, l'affichage et la surveillance de la qualité des métadonnées. Elle ne prend actuellement pas en charge la synchronisation des données.