Una base de conocimientos complementa un LLM con datos privados e información actualizada. Mediante la generación aumentada por recuperación (RAG), el LLM mejora la precisión de las respuestas recuperando primero contenido relevante de la base de conocimientos antes de generar una respuesta.
Importante
-
Restricciones de acceso a la consola: Solo los usuarios que crearon aplicaciones de Alibaba Cloud Model Studio en la región de Singapore antes del 21 de abril de 2025 pueden acceder a la pestaña de Application Development.
Esta pestaña contiene las siguientes funciones: Aplicaciones (aplicación de agente y aplicación de flujo de trabajo), Componentes (ingeniería de prompts y complemento) y Datos (base de conocimiento y datos de aplicación). Todas estas son funciones de vista previa. Úselas con precaución en entornos de producción.
-
Restricciones de llamadas a la API: Solo los usuarios que crearon aplicaciones de Alibaba Cloud Model Studio en la región de Singapur antes del 21 de abril de 2025 pueden llamar a las API de datos de aplicación, base de conocimiento e ingeniería de prompts.
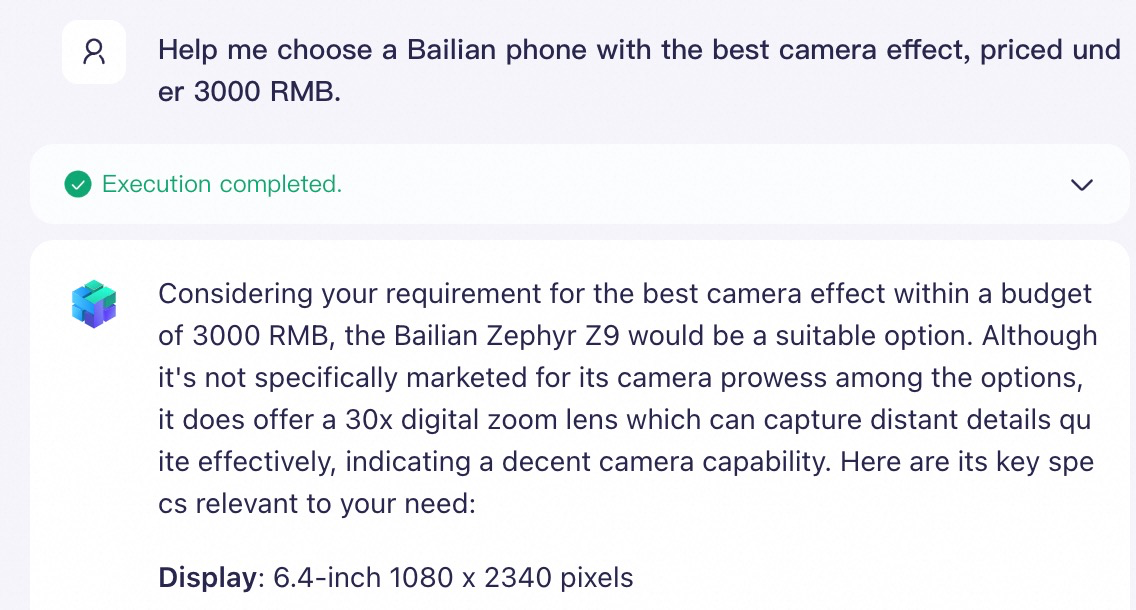
Aplicación sin una base de conocimientos dedicada Sin una base de conocimientos dedicada, un LLM no puede responder con precisión a preguntas específicas del dominio. Por ejemplo, cuando un usuario envía "Por favor, ayúdame a elegir el mejor teléfono con cámara de Alibaba Cloud Model Studio, con un presupuesto de 3,000 yuan" en la interfaz de chat, el asistente de IA no puede proporcionar recomendaciones precisas de productos debido a la falta de una base de conocimientos relevante. | Aplicación con una base de conocimientos dedicada Con una base de conocimientos dedicada, un LLM puede responder con precisión a preguntas específicas del dominio.
|
Modelos admitidos
Los siguientes modelos se pueden usar con una base de conocimientos. Configurar Qwen para usar una base de conocimientos
- Qwen-Max/Plus/Turbo
- QwenVL-Max/Plus
- Qwen versión de código abierto (por ejemplo, Qwen2.5)
Para obtener una lista actualizada de los modelos disponibles, consulte la página de Gestión de aplicaciones al crear una aplicación.
Inicio rápido
Este inicio rápido muestra cómo crear una aplicación de preguntas y respuestas de LLM sin código para responder preguntas específicas del dominio, utilizando "teléfonos de Alibaba Cloud Model Studio" como ejemplo.
1. Crear una base de conocimientos
- Vaya a la página Base de conocimientos y haga clic en Create Knowledge Base. Ingrese un Nombre y una Descripción, deje las demás configuraciones con sus valores predeterminados y haga clic en Next Step.
- Seleccione la Default Category y cargue el archivo Alibaba Cloud Model Studio Phone Series Product Introduction.docx. Haga clic en Next Step y luego haga clic en Complete.
2. Integración con aplicaciones empresariales
Después de crear una base de conocimiento, puede asociarla con una aplicación de Alibaba Cloud Model Studio o una aplicación externa dentro del mismo espacio de trabajo para procesar solicitudes de recuperación.
Aplicación de agente
-
Vaya a la página de Centro de aplicaciones, busque su aplicación de agente, haga clic en Configure en su tarjeta y seleccione un modelo para la aplicación.
-
Haga clic en el icono + junto a Document Knowledge Base para agregar la base de conocimiento que acaba de crear. Puede mantener los valores predeterminados para el umbral de similitud y el peso.
(Opcional) Umbral de similitud: Filtrar resultados de recuperación
Una base de conocimientos utiliza búsqueda semántica para encontrar texto conceptualmente relevante en sus datos o archivos privados, incluso sin palabras clave coincidentes.
Por ejemplo, un usuario envía la siguiente consulta:
Which Alibaba Cloud phone is best for photography?La respuesta real (por ejemplo, "Qwen Vivid 7...") no contiene ninguna palabra clave de la consulta.
En la siguiente tabla, la similitud por palabras clave se calcula utilizando el índice de Jaccard, y la similitud semántica es la similitud del coseno calculada por el modelo
text-embedding-v4.Texto recuperado
Similitud por palabras clave
Similitud semántica
Qwen Vivid 7: Una nueva experiencia en fotografía inteligente
0
0.43
Alibaba Cloud Model Studio Ace Ultra: La elección para jugadores
0.17
0.32
Alibaba Cloud Model Studio Flex Fold+: Una nueva era de pantallas plegables
0.25
0.24
Umbral de similitud: Solo se recupera texto con una puntuación de similitud semántica superior a este valor. Establecer este umbral demasiado alto puede provocar que se filtre texto relevante.
(Opcional) Peso: Influir en el orden de recuperación de múltiples bases de conocimientos
Cuando una aplicación de agente está asociada con múltiples bases de conocimientos, puede asignar un peso a cada una según la importancia de la fuente de información. Durante la recuperación de múltiples fuentes, si los fragmentos de diferentes bases de conocimientos tienen la misma puntuación de similitud, el sistema prioriza los fragmentos de la base de conocimientos con el mayor peso.
- Limitación clave: El peso solo surte efecto entre bases de conocimiento del mismo tipo. Por ejemplo, el peso de una base de conocimiento de búsqueda de documentos no afecta el orden de recuperación de una base de conocimiento de consulta de datos, y viceversa.
- Cómo funciona: El sistema primero calcula la relevancia de la consulta del usuario respecto al contenido de cada base de conocimientos para identificar los fragmentos más relevantes. Luego, multiplica la puntuación de similitud de cada fragmento por el peso de su base de conocimientos correspondiente. Después de reordenar los resultados basándose en estas puntuaciones ponderadas, se proporcionan al LLM como contexto, asegurando que los fragmentos con mayores puntuaciones ponderadas tengan prioridad en la respuesta final.
-
En el cuadro de entrada de la derecha, introduzca una pregunta. El LLM utiliza entonces la base de conocimientos para generar una respuesta.
Por ejemplo: "Ayúdame a elegir el teléfono de Alibaba Cloud Model Studio con la mejor cámara por menos de 3,000 CNY".
Estrategia de generación por lotes: Cuando necesita que una aplicación de agente genere un gran volumen de contenido desde una base de conocimientos, como preguntas de examen o resúmenes, una sola solicitud puede devolver menos elementos de los solicitados porque la longitud de salida de una respuesta del LLM es limitada. Divida la solicitud en varios lotes de aproximadamente 30 elementos cada uno y complételos en múltiples turnos. Por ejemplo, primero envíe "Generar preguntas 1-30 basadas en la base de conocimientos" y, después de completar ese lote, envíe "Continue con las preguntas 31-60". Referencia medida: una sola solicitud de 100 preguntas devolvió solo unas 24 preguntas, mientras que tres lotes de 30 preguntas cada uno devolvieron las 30 preguntas por lote, para un total de 90 preguntas. El número real de elementos generados varía según el modelo seleccionado y la longitud del contenido, por lo que debe usar sus propios resultados de prueba como referencia final.
Aplicación de flujo de trabajo
-
Vaya a la página Centro de aplicaciones, busque su aplicación de flujo de trabajo y haga clic en Configure en su tarjeta. Arrastre un nodo de Base de conocimientos al lienzo y conéctelo después del nodo Inicio.
-
Configure el nodo Base de conocimientos:
-
Entrada: En la lista desplegable Valor a la derecha de la variable
content, seleccione Built-in Variable query. La lista desplegable tiene una estructura de árbol; es posible que deba expandir el grupo "Variable integrada" para seleccionar la variable de consulta. -
Seleccionar base de conocimientos: Puede seleccionar una base de conocimientos para el nodo de dos maneras.
- Seleccionar una base de conocimiento fija: Seleccione la base de conocimiento que creó en el paso anterior del menú desplegable. Utilice este método cuando se requiera la misma base de conocimiento para cada llamada.
- Selección dinámica: Configure la variable
CodeListpara especificar dinámicamente una base de conocimiento según la salida de un nodo anterior. Esto es adecuado para escenarios donde necesita recuperar diferentes bases de conocimiento según distintas entradas.
-
Establecer TopK (Opcional): Esta configuración determina el número de fragmentos devueltos a los nodos posteriores, que suelen ser nodos LLM.
Aumentar este valor generalmente mejora la precisión de las respuestas del LLM, pero también incrementa el consumo de tokens de entrada del LLM.
-
-
Arrastre un nodo LLM al lienzo y conéctelo después del nodo Base de conocimientos y antes del nodo Fin.
-
Configure el nodo LLM:
-
En la lista Configuración del modelo, seleccione un modelo para el nodo.
-
En el Prompt, ingrese un prompt que indique al LLM que utilice la base de conocimiento. Ingrese "/" para insertar la variable
result(que representa los resultados devueltos por la recuperación de la base de conocimiento).Por ejemplo, ingrese el título del prompt
# Knowledge Basey el cuerpo comoPlease remember the following materials {Knowledge Base 1/result}, they may be helpful for answering questions.
-
-
Configure el nodo End: Introduzca
/y seleccione LLM 1 > result para emitir el resultado del LLM. -
Haga clic en Test en la esquina superior derecha de la página. En el cuadro de entrada de la derecha, ingrese una pregunta. El LLM utilizará la base de conocimientos para generar una respuesta.
Por ejemplo: "Ayúdame a elegir el teléfono de Alibaba Cloud Model Studio con la mejor cámara por menos de 3,000 CNY".
Aplicación externa
Además de crear aplicaciones dentro de Alibaba Cloud Model Studio, puede utilizar el SDK de Model Studio para recuperar datos de una base de conocimiento para aplicaciones de IA externas.
Para obtener pasos detallados de integración, consulte la Guía de la API de base de conocimientos.
3. Optimizar el rendimiento de RAG (Opcional)
Si recibe resultados incompletos o inexactos del proceso de preguntas y respuestas, consulte Optimización del rendimiento de RAG.
Guías prácticas
En la página de base de conocimiento, puede ver y administrar todas las bases de conocimiento en el espacio de trabajo actual.
ID de base de conocimientos: El
IDde cada base de conocimientos, utilizado para llamadas a la API.
Crear una base de conocimientos
Después de hacer clic en Create Knowledge Base, cree la base de conocimiento en tres pasos: proporcione información básica y seleccione un tipo de base de conocimiento, configure un origen de datos y establezca los parámetros de índice.
-
En la página de base de conocimientos, haga clic en Create Knowledge Base.
-
Información básica
Seleccione un Knowledge Base Type según su caso de uso. Una sola base de conocimientos admite solo un tipo. Si selecciona el tipo document search, también debe seleccionar un use case: Basic document Q&A, Rich-text Reply.
- Preguntas y respuestas básicas de documentos: Ideal para búsquedas semánticas en documentos de texto sin formato.
- Respuesta con texto enriquecido: Ideal para casos de uso que requieren respuestas que contengan tanto texto como imágenes.
El tipo de base de conocimientos no se puede cambiar después de crearla.
-
Búsqueda de documentos
-
Casos de uso:
- Ideal para recuperar información de datos no estructurados, como documentos corporativos internos y manuales de productos. Los datos no estructurados son información que no está organizada en un modelo de datos o esquema predefinido y pueden incluir texto, tablas e imágenes.
- Si sus archivos contienen imágenes que want desea que la aplicación incluya en sus respuestas, seleccione document search.
-
Fuente de datos: Puede cargar archivos locales o importarlos desde Object Storage Service (OSS).
Creación de búsqueda de documentos
-
Seleccionar datos: Especifique una fuente de datos (archivos o contenido) para la base de conocimientos. El sistema importa el contenido de origen a la base de conocimientos para su recuperación. Puede utilizar carga local o importación en la nube (seleccionando una categoría o archivo existente).
-
Carga local: Cargue archivos directamente desde su computadora. Expanda el panel desplegable a continuación para aprender cómo seleccionar un parsing method.
Métodos de análisis
Configure la estrategia de análisis según sus necesidades. Si no está seguro de qué opción elegir, recomendamos utilizar la configuración predeterminada.
- Análisis digital: No analiza ilustraciones ni gráficos en los archivos. Este es el método de análisis más rápido. Un documento de texto sin formato de 10 a 20 páginas generalmente se analiza en unos pocos segundos a 1 minuto.
- Análisis inteligente de documentos: Reconoce y extrae texto de las ilustraciones en sus archivos para generar resúmenes de texto. Estos resúmenes, junto con otro contenido no gráfico, se fragmentan y vectorizan para su recuperación. Este método es relativamente rápido. Un documento de 10 a 20 páginas con ilustraciones generalmente tarda de 1 a 5 minutos en analizarse.
- Análisis con LLM: Permite que las aplicaciones que utilizan el modelo Qwen-VL respondan preguntas sobre el contenido de ilustraciones y gráficos en sus archivos. Para habilitar el reconocimiento y la comprensión de este contenido, seleccione LLM Parsing. Dado que este método llama a un LLM para una comprensión profunda, un documento de 10 a 20 páginas con gráficos generalmente tarda de 2 a 10 minutos en analizarse.
- Análisis con Qwen-VL: Diseñado específicamente para archivos de imagen. Puede especificar un modelo Qwen-VL y proporcionar un prompt para guiar el reconocimiento y la extracción del diseño y los elementos de la imagen. Una sola imagen generalmente se analiza en unos pocos segundos a 1 minuto.
-
Importación desde la nube: Importe archivos existentes desde Object Storage Service (OSS).
-
-
Configuración de índice: Define cómo se procesan y almacenan los datos importados, lo cual afecta directamente al rendimiento de recuperación.
Entre las siguientes configuraciones, solo el almacenamiento vectorial con AnalyticDB for PostgreSQL (ADB-PG) puede generar cargos. Todas las demás configuraciones son gratuitas.
Extracción de metadatos
Los metadatos consisten en atributos adicionales para datos no estructurados, que se integran en los fragmentos como pares clave-valor.
- Propósito: Los metadatos proporcionan un contexto importante para los fragmentos y pueden mejorar significativamente la precisión de la recuperación de la base de conocimientos. Por ejemplo, considere una base de conocimientos que contiene miles de archivos de introducción de productos donde el nombre del archivo es el nombre del producto. Cuando un usuario busca "descripción funcional del Producto A", si el cuerpo de cada archivo contiene "descripción funcional" pero none menciona "Producto A", la base de conocimientos podría recuperar muchos fragmentos irrelevantes. Sin embargo, si agrega el nombre del producto como metadato a todos los fragmentos, la base de conocimientos puede filtrar con precisión los fragmentos relacionados con "Producto A" que también contengan "descripción funcional". Esto mejora la precisión de la recuperación y reduce el consumo de tokens de entrada del LLM.
- Uso: Cuando usted llama a una aplicación mediante una API, puede especificar
metadataen el parámetro de solicitudmetadata_filter. Cuando la aplicación recupera información de la base de conocimientos, primero filtra los archivos relevantes basándose en losmetadataespecificados. - Nota: No puede configurar la extracción de metadatos después de crear una base de conocimientos.
Configuración de metadatos
Habilite Extracción de metadatos y luego haga clic en Settings para adjuntar metadatos uniformes o personalizados a all files in the knowledge base. Durante la fragmentación, los metadatos de cada archivo se integran en sus respectivos fragmentos.
Nueva plantilla de metadatos
Métodos de extracción de valores-
Constante: Adjunta un atributo fijo a todos los archivos de la base de conocimientos.
Como se muestra en el ejemplo anterior, si todos los archivos en la base de conocimientos tienen el mismo autor, puede establecer una constante para un campo llamado
author. -
Variable: Adjunta un atributo variable a cada archivo en la base de conocimientos. Los atributos admitidos actualmente son
file_nameycat_name. Si seleccionafile_name, Alibaba Cloud Model Studio adjunta el nombre del archivo a sus metadatos, como se muestra en el ejemplo anterior. Si seleccionacat_name, Alibaba Cloud Model Studio adjunta el nombre de la categoría que contiene el archivo a los metadatos del archivo. -
LLM: El sistema compara el contenido del archivo con la regla de Descripción de entidad configurada, extrae la información relevante y la adjunta como un atributo de metadatos.
Como se muestra en la plantilla de metadatos del ejemplo anterior, para extraer todos los años que aparecen en cada archivo como atributos de archivo, puede configurar un campo LLM llamado
date. La descripción de la entidad se configura de la siguiente manera:En el cuadro de entrada Descripción de entidad, ingrese
date information, extract only the yeary luego haga clic en OK. -
RegEx: El sistema compara el contenido de texto de cada archivo en la base de conocimiento con la expresión regular especificada. El contenido que coincide con la expresión se extrae y se agrega como un atributo a los metadatos del archivo.
Como se muestra en la plantilla de metainformación del ejemplo anterior, si necesita extraer todas las referencias que aparecen en cada archivo (suponiendo que una referencia es cualquier texto que comienza con '《' y termina con '》'), puede configurar un campo de expresión regular llamado
reference. La expresión regular se configura de la siguiente manera:Establezca el valor de la expresión regular en
《.*?》. -
Búsqueda por palabras clave: El sistema busca palabras clave predefinidas en cada archivo y agrega las palabras clave coincidentes como atributos a los metadatos del archivo.
Por ejemplo, en la plantilla de metadatos del ejemplo anterior, las palabras clave predefinidas son:
Debido a que el archivo contiene solo las palabras clave "financiamiento", "industria", "verde" y "capital", el sistema extrae solo estas cuatro palabras clave como valor para el atributo
keywordsdel archivo.
Usado para recuperación: Si está habilitado, el campo de metadatos y su valor se utilizan para la recuperación de la base de conocimiento junto con el contenido del fragmento. Si está deshabilitado, solo se utiliza el contenido del fragmento para la recuperación.
Usado para respuesta del modelo: Si está habilitado, el campo de metadatos y su valor se proporcionan al LLM como entrada para la generación de respuestas junto con el contenido del fragmento. Si está deshabilitado, solo se proporciona el contenido del fragmento al LLM para la generación de respuestas.
Ensamblaje de encabezado de Excel
Cuando está habilitado, la base de conocimiento trata la primera fila de todos los archivos XLSX y XLS como el encabezado y la agrega automáticamente a cada fragmento (fila de datos). Esto evita que el LLM malinterprete el encabezado como una fila de datos normal.
Alcance: Esta configuración se aplica solo a archivos de tabla XLSX y XLS en la base de conocimientos, y trata la primera fila de cada archivo como el encabezado. No se aplica a formatos que no son tablas, como PDF, Word o Markdown. La configuración surte efecto cuando se crea la base de conocimientos (durante la fragmentación de documentos) y, al igual que la estrategia de fragmentación, no se puede cambiar después de crear la base de conocimientos.
Lógica de procesamiento: La base de conocimientos divide los archivos de tablas por fila de datos: cada fila, excepto la primera (encabezado), se convierte en un fragmento separado. Cuando esta configuración está habilitada, la fila de encabezado se añade automáticamente a cada fragmento de fila de datos, de modo que cada fragmento contiene tanto los nombres de columna (encabezado) como los datos de la fila. Esto permite que el LLM interprete correctamente cada campo basándose en su nombre de columna, y la fila de encabezado ya no se procesa como una fila de datos normal, lo que evita confusiones semánticas durante la recuperación y las preguntas y respuestas.
No necesita habilitar esta configuración si la base de conocimientos contiene archivos en otros formatos, como PDF, o si los archivos de tabla no contienen una fila de encabezado.
Método de fragmentación
Seleccione smart chunking (recommended).
Propósito: Una base de conocimientos divide los archivos en fragmentos y los convierte en vectores utilizando un modelo de incrustación. Los fragmentos y vectores se almacenan luego como pares clave-valor en una base de datos vectorial. Después de crear la base de conocimientos, puede ver o editar el contenido específico (texto e imágenes) de cada fragmento.
Título del fragmento: Además de su contenido principal, cada fragmento lleva un título que se muestra en la lista de fragmentos, se usa para identificar el fragmento y se incluye en la recuperación. La base de conocimientos genera el título del fragmento automáticamente durante el análisis inteligente de documentos, basándose en la jerarquía de encabezados que detecta. Tiene dos formas: un título corto (
title, el encabezado más cercano al que pertenece el fragmento) y un título jerárquico (hier_title, la ruta completa desde el encabezado de nivel superior hasta el encabezado actual, con los niveles unidos por|>, por ejemploHeading 1|>Heading 2). Por lo tanto, cuanto más clara sea la estructura de encabezados de un documento (como archivos PDF, Word o Markdown con encabezados de sección bien formados), más completos serán los títulos de fragmentos generados; para archivos tipo tabla que se dividen por filas de datos y generalmente carecen de una jerarquía de encabezados textual (como Excel), el título del fragmento depende de si se detecta una jerarquía de encabezados durante el análisis, y puede estar vacío cuando no se detecta none. También puede editar el título del fragmento manualmente en la gestión de fragmentos.Nota: Después de crear una base de conocimiento, no puede cambiar la configuración de fragmentación de documentos. Una estrategia de fragmentación inadecuada puede reducir el rendimiento de recuperación y recall.
Reescritura de conversación multironda
Cuando está habilitada, esta función utiliza un modelo dedicado para reescribir la consulta del usuario incorporando el historial de conversación. Este proceso crea una consulta completa e independiente para la recuperación de la base de conocimientos.
Modelo de incrustación
Un modelo de incrustación convierte el prompt de entrada original y el texto de conocimiento en vectores numéricos para que el sistema pueda calcular la similitud semántica. El modelo predeterminado Vector oficial (text-embedding-v2) admite múltiples idiomas además del chino y el inglés, y normaliza los vectores resultantes. Esta configuración no se puede cambiar.
Las dimensiones del vector son fijas y no se pueden modificar:
- Vector oficial (text-embedding-v2): 1,536 dimensiones
- qwen3-vl-embedding: Se habilita automáticamente cuando se selecciona el caso de uso de comprensión visual. Admite la generación de vectores para imágenes y documentos de texto enriquecido después de la comprensión visual.
Modelo de reordenamiento
Un modelo de reordenamiento es externo a la base de conocimientos. Reordena los fragmentos candidatos de la recuperación vectorial inicial y devuelve los K fragmentos principales con las puntuaciones de similitud más altas. El reordenador oficial recomendado, qwen3-rerank (híbrido), considera tanto la relevancia semántica como las características de coincidencia de texto (como las puntuaciones BM25) para manejar mejor las consultas que requieren coincidencias precisas de palabras clave. Si solo necesita clasificación semántica, seleccione qwen3-rerank.
Modo de modelo de reordenamientoCuando crea una base de conocimientos, puede seleccionar uno de los siguientes tres modos para el modelo de reclasificación:
- Modo de preguntas y respuestas (predeterminado): Puntúa basándose en la "relevancia de preguntas y respuestas" entre la consulta y los fragmentos candidatos. Este modo es adecuado para escenarios donde los usuarios hacen una pregunta completa y esperan encontrar la respuesta dentro de un fragmento.
- Modo de similitud: Puntúa basándose en la "similitud semántica" entre la consulta y los fragmentos candidatos. Este modo es adecuado para escenarios donde la consulta y los fragmentos tienen un estilo de expresión similar.
- Modo avanzado personalizado: Le permite ingresar una instrucción en lenguaje natural de hasta 200 caracteres para influir en el proceso de reclasificación. Este modo es adecuado para escenarios con requisitos de clasificación especiales.
AdvertenciaPuede seleccionar un modo de modelo de reclasificación only when you create a knowledge base. You cannot change it after creation. Antes de configurar este ajuste, tenga en cuenta las siguientes limitaciones:
- Limitación de tipo de base de conocimiento: Esta función solo es aplicable a bases de conocimiento de búsqueda de documentos, Consulta de datos y búsqueda de audio/video. No es compatible con bases de conocimiento de Preguntas y respuestas sobre imágenes.
- Limitación de caso de uso: Esta función solo es compatible con los casos de uso de Preguntas y respuestas básicas sobre documentos y Respuesta de texto enriquecido. No es compatible con los casos de uso de comprensión visual (documentos de texto enriquecido) y Preguntas y respuestas rápidas.
Umbral de similitud
Este umbral establece la puntuación mínima de similitud requerida para que un fragmento sea recuperado de los resultados del modelo de reclasificación.
NotaEste es el umbral de similitud predeterminado para la base de conocimientos. Cuando asocia la base de conocimientos con una aplicación específica de Alibaba Cloud Model Studio, puede establecer un umbral separado para esa aplicación, el cual anula el umbral predeterminado de la base de conocimientos.
Reducir este umbral recupera más fragmentos, pero puede incluir contenido menos relevante. Por el contrario, aumentarlo recupera menos fragmentos y puede provocar que los relevantes se descarten si se establece demasiado alto.
Puede utilizar la prueba de aciertos para ajustar el umbral de similitud y equilibrar la recuperación y la precisión.
Recuento máximo de recuperación
El sistema recupera fragmentos relacionados con la entrada de todas las bases de conocimientos asociadas, los reordena utilizando un modelo de reordenamiento y selecciona los K fragmentos más relevantes para agregarlos a la entrada del LLM como contexto. Este valor K es el recuento máximo de recuperación (hasta 20), y determina el número de fragmentos que el modelo de reordenamiento proporciona al LLM para el contexto.
Aumentar este valor puede mejorar la precisión de la respuesta del LLM, pero también incrementa el consumo de tokens de entrada del LLM.
Almacenamiento vectorial
Seleccione una base de datos vectorial para almacenar vectores de texto. La base de datos vectorial Integrada es suficiente para las operaciones básicas de la base de conocimientos. Para capacidades avanzadas como gestión de bases de datos, auditoría o monitoreo, recomendamos AnalyticDB for PostgreSQL (ADB-PG).
Cuando adquiere una instancia de AnalyticDB for PostgreSQL (ADB-PG), debe habilitar la Optimización del motor vectorial. De lo contrario, Alibaba Cloud Model Studio no podrá utilizar la instancia.
Creación de comprensión visual
Cuando selecciona el caso de uso de visual understanding (rich-text documents), la base de conocimientos utiliza un modelo de incrustación multimodal para comprender visualmente los documentos y preservar la información del diseño original, en lugar de utilizar métodos de fragmentación tradicionales.
Restricciones de formato de archivo
En el área de carga de archivos de la pestaña Seleccionar datos, pase el cursor sobre View format requirements para ver los requisitos.
Diferencias en la configuración del índice
La configuración del índice para el caso de uso de comprensión visual difiere de la de Preguntas y respuestas básicas de documentos:
- Modelo de embedding: El modelo qwen3-vl-embedding se selecciona automáticamente y no se puede cambiar después de la creación.
- Reescritura de conversaciones de múltiples turnos: Se puede activar o desactivar.
- Umbral de similitud: El valor predeterminado es 0.20.
- Recuento máximo final de recuperaciones: El valor predeterminado es 5.
- Método de fragmentación: La comprensión visual no utiliza métodos de fragmentación tradicionales como la fragmentación inteligente o la fragmentación personalizada. En su lugar, comprende toda la página del documento basándose en la indexación visual.
Restricciones de edición
- El modelo de incrustación (qwen3-vl-embedding) y el tipo de almacenamiento vectorial (integrado) no se pueden cambiar después de la creación.
- Solo puede cambiar la edición de la base de conocimientos una vez al día.
-
-
Casos de uso:
-
Consulta de datos
-
Casos de uso:
-
Ideal para crear sistemas de preguntas y respuestas basados en datos estructurados (datos organizados según un esquema de tabla predefinido), como asistentes para consultar preguntas frecuentes, datos de productos o información personal.
-
Si sus datos consisten en pares completos de preguntas y respuestas de FAQ, seleccione Data Query. Por ejemplo, si un archivo de Excel contiene dos columnas,
QuestionyAnswer, una base de conocimientos de Consulta de datos puede usar la columnaQuestionpara la recuperación y la columnaAnswercomo contexto para la respuesta del LLM.Este procesamiento específico por columna no está disponible en el tipo de base de conocimientos de búsqueda de documentos.
-
Puede importar múltiples archivos de Excel, pero sus esquemas de tabla deben ser idénticos.
-
-
Integración de fuentes de datos: Puede cargar archivos XLS o XLSX locales.
Creación de consulta de datos
-
Seleccionar datos: Especifique un origen de datos (archivos o contenido) para la base de conocimiento. El sistema importa el contenido de origen a la base de conocimiento para su recuperación. Puede utilizar carga local o importación desde la nube.
NotaEl origen de datos no se puede cambiar después de crear la base de conocimientos. Una sola base de conocimientos admite únicamente un origen de datos.
- Carga local: Cargue tablas de datos en formato XLS o XLSX desde su computadora. La primera fila debe ser el encabezado de la tabla.
- Importación desde la nube (seleccionar tabla de datos): Seleccione una tabla de datos existente de Alibaba Cloud Model Studio.
-
Configuración de índice: Define cómo se procesan y almacenan los datos importados, lo cual afecta directamente al rendimiento de recuperación.
Entre las siguientes configuraciones, solo el almacenamiento vectorial con AnalyticDB for PostgreSQL (ADB-PG) puede generar cargos. Todas las demás configuraciones son gratuitas.
Configuración de recuperación y respuesta
-
Usado para recuperación: Si está activado, la base de conocimientos realiza la recuperación en esta columna.
-
Usado para respuesta del modelo: Si está habilitado, los resultados de recuperación de esta columna se proporcionan al LLM como contexto para la generación de respuestas. Por ejemplo, si habilita Usado para recuperación para las columnas "Nombre", "Género", "Puesto" y "Edad", pero habilita Usado para respuesta del modelo solo para las columnas "Nombre" y "Puesto", la base de conocimientos realizará la búsqueda en las cuatro columnas. Sin embargo, solo el contenido de las columnas "Nombre" y "Puesto" de los datos recuperados se proporcionará al LLM como contexto para su respuesta.
Dado que la columna "Edad" no está habilitada para las respuestas del modelo, el LLM asociado con esta base de conocimientos no puede responder a la pregunta "¿Cuál es la edad de Zhang San?".
Reescritura de conversación multironda
Cuando está habilitada, esta función utiliza un modelo dedicado para reescribir la consulta del usuario incorporando el historial de conversación. Este proceso crea una consulta completa e independiente para la recuperación de la base de conocimientos.
Modelo de incrustación
Un modelo de incrustación convierte el prompt de entrada original y el texto de conocimiento en vectores numéricos para que el sistema pueda calcular la similitud semántica. El modelo predeterminado Vector oficial (text-embedding-v2) admite múltiples idiomas además del chino y el inglés, y normaliza los vectores resultantes. Esta configuración no se puede cambiar.
Las dimensiones del vector son fijas y no se pueden modificar:
- Vector oficial (text-embedding-v2): 1,536 dimensiones
- qwen3-vl-embedding: Se habilita automáticamente cuando se selecciona el caso de uso de comprensión visual. Admite la generación de vectores para imágenes y documentos de texto enriquecido después de la comprensión visual.
Modelo de reordenamiento
Un modelo de reordenamiento es externo a la base de conocimientos. Reordena los fragmentos candidatos de la recuperación vectorial inicial y devuelve los K fragmentos principales con las puntuaciones de similitud más altas. El reordenador oficial recomendado, qwen3-rerank (híbrido), considera tanto la relevancia semántica como las características de coincidencia de texto (como las puntuaciones BM25) para manejar mejor las consultas que requieren coincidencias precisas de palabras clave. Si solo necesita clasificación semántica, seleccione qwen3-rerank.
Modo de modelo de reordenamientoCuando crea una base de conocimientos, puede seleccionar uno de los siguientes tres modos para el modelo de reclasificación:
- Modo de preguntas y respuestas (predeterminado): Puntúa basándose en la "relevancia de preguntas y respuestas" entre la consulta y los fragmentos candidatos. Este modo es adecuado para escenarios donde los usuarios hacen una pregunta completa y esperan encontrar la respuesta dentro de un fragmento.
- Modo de similitud: Puntúa basándose en la "similitud semántica" entre la consulta y los fragmentos candidatos. Este modo es adecuado para escenarios donde la consulta y los fragmentos tienen un estilo de expresión similar.
- Modo avanzado personalizado: Le permite ingresar una instrucción en lenguaje natural de hasta 200 caracteres para influir en el proceso de reclasificación. Este modo es adecuado para escenarios con requisitos de clasificación especiales.
AdvertenciaPuede seleccionar un modo de modelo de reclasificación only when you create a knowledge base. You cannot change it after creation. Antes de configurar este ajuste, tenga en cuenta las siguientes limitaciones:
- Limitación de tipo de base de conocimiento: Esta función solo es aplicable a bases de conocimiento de búsqueda de documentos, Consulta de datos y búsqueda de audio/video. No es compatible con bases de conocimiento de Preguntas y respuestas sobre imágenes.
- Limitación de caso de uso: Esta función solo es compatible con los casos de uso de Preguntas y respuestas básicas sobre documentos y Respuesta de texto enriquecido. No es compatible con los casos de uso de comprensión visual (documentos de texto enriquecido) y Preguntas y respuestas rápidas.
Umbral de similitud
Este umbral establece la puntuación mínima de similitud requerida para que un fragmento sea recuperado de los resultados del modelo de reclasificación.
NotaEste es el umbral de similitud predeterminado para la base de conocimientos. Cuando asocia la base de conocimientos con una aplicación específica de Alibaba Cloud Model Studio, puede establecer un umbral separado para esa aplicación, el cual anula el umbral predeterminado de la base de conocimientos.
Reducir este umbral recupera más fragmentos, pero puede incluir contenido menos relevante. Por el contrario, aumentarlo recupera menos fragmentos y puede provocar que los relevantes se descarten si se establece demasiado alto.
Puede utilizar la prueba de aciertos para ajustar el umbral de similitud y equilibrar la recuperación y la precisión.
Recuento máximo de recuperación
El sistema recupera fragmentos relacionados con la entrada de todas las bases de conocimientos asociadas, los reordena utilizando un modelo de reordenamiento y selecciona los K fragmentos más relevantes para agregarlos a la entrada del LLM como contexto. Este valor K es el recuento máximo de recuperación (hasta 20), y determina el número de fragmentos que el modelo de reordenamiento proporciona al LLM para el contexto.
Aumentar este valor puede mejorar la precisión de la respuesta del LLM, pero también incrementa el consumo de tokens de entrada del LLM.
Almacenamiento vectorial
Seleccione una base de datos vectorial para almacenar vectores de texto. La base de datos vectorial Integrada es suficiente para las operaciones básicas de la base de conocimientos. Para capacidades avanzadas como gestión de bases de datos, auditoría o monitoreo, recomendamos AnalyticDB for PostgreSQL (ADB-PG).
Cuando adquiere una instancia de AnalyticDB for PostgreSQL (ADB-PG), debe habilitar la Optimización del motor vectorial. De lo contrario, Alibaba Cloud Model Studio no podrá utilizar la instancia.
-
-
-
Casos de uso:
-
Preguntas y respuestas con imágenes
-
Casos de uso:
- Ideal para crear aplicaciones de recuperación multimodal que admiten búsqueda por imagen y búsqueda por imagen más texto, como asistentes de descubrimiento de productos o asistentes visuales de preguntas y respuestas.
-
Integración de fuentes de datos: Puede cargar archivos XLS o XLSX locales.
Los archivos XLS y XLSX deben contener URL de imágenes accesibles públicamente para crear índices de imágenes. Para más detalles, consulte las instrucciones de creación a continuación.
Creación de preguntas y respuestas de imágenes
-
Seleccionar datos: Especifique un origen de datos (archivos o contenido) para importar a la base de conocimiento para su recuperación. Puede utilizar carga local o importación desde la nube (seleccione una tabla de datos existente de un conector de datos).
NotaLa fuente de datos no se puede cambiar después de la creación, y una sola base de conocimientos solo admite una fuente de datos.
-
Carga local: Cargue tablas de datos en formato XLS o XLSX directamente desde su computadora.
Nota
- Requisito de campo: La tabla de datos debe contener al menos un campo del tipo
image_urlpara generar el índice de imágenes. - Proceso de creación: La base de conocimientos accede a la URL de la imagen en el campo
image_url, extrae características visuales y las convierte en vectores para su almacenamiento. - Proceso de recuperación: La base de conocimientos compara el vector generado a partir de la imagen cargada por el usuario con los vectores de imágenes almacenados y devuelve los registros más relevantes.
- Requisito de campo: La tabla de datos debe contener al menos un campo del tipo
-
Importación desde la nube (seleccionar una tabla de datos): Seleccione una tabla de datos existente de sus datos de aplicación en Alibaba Cloud Model Studio.
-
-
Configuración de índice: Define cómo se procesan y almacenan los datos importados, lo cual afecta directamente al rendimiento de recuperación.
Entre las siguientes configuraciones, solo el almacenamiento vectorial con AnalyticDB for PostgreSQL (ADB-PG) puede generar cargos. Todas las demás configuraciones son gratuitas.
Configuración de recuperación y respuesta
-
Usado para recuperación: Si está activado, la base de conocimientos realiza la recuperación en esta columna.
-
Usado para respuesta del modelo: Si está habilitado, los resultados de recuperación de esta columna se proporcionan al LLM como contexto para la generación de respuestas. Por ejemplo, si habilita Usado para recuperación para las columnas "Nombre", "Género", "Puesto" y "Edad", pero habilita Usado para respuesta del modelo solo para las columnas "Nombre" y "Puesto", la base de conocimientos realizará la búsqueda en las cuatro columnas. Sin embargo, solo el contenido de las columnas "Nombre" y "Puesto" de los datos recuperados se proporcionará al LLM como contexto para su respuesta.
Dado que la columna "Edad" no está habilitada para las respuestas del modelo, el LLM asociado con esta base de conocimientos no puede responder a la pregunta "¿Cuál es la edad de Zhang San?".
Reescritura de conversación multironda
Cuando está habilitada, esta función utiliza un modelo dedicado para reescribir la consulta del usuario incorporando el historial de conversación. Este proceso crea una consulta completa e independiente para la recuperación de la base de conocimientos.
Modelo de incrustación
Un modelo de embedding convierte los prompts de entrada originales, el texto de conocimiento y las imágenes en vectores numéricos para permitir comparaciones de similitud. Para obtener más información, consulte Vectorización de texto y multimodal.
- qwen2.5-vl-embedding: Representa entradas monomodales o de modalidad mixta como un vector unificado, adecuado para la recuperación cruzada y la búsqueda de imágenes. Por ejemplo, si ingresa una imagen de una camisa con el texto "encuentra un estilo similar que luzca más juvenil", el modelo puede fusionar la imagen y las instrucciones de texto en un solo vector para su comprensión.
- multimodal-embedding-v1: Genera vectores separados para cada parte de la entrada (imagen y texto).
- qwen3-vl-embedding: Una versión mejorada de qwen2.5-vl-embedding que mejora aún más la comprensión de la fusión de imagen y texto y la precisión de recuperación multimodal.
Modelo de reordenamiento
Un modelo de reordenamiento es externo a la base de conocimientos. Reordena los fragmentos candidatos de la recuperación vectorial inicial y devuelve los K fragmentos principales con las puntuaciones de similitud más altas. El reordenador oficial recomendado, qwen3-rerank (híbrido), considera tanto la relevancia semántica como las características de coincidencia de texto (como las puntuaciones BM25) para manejar mejor las consultas que requieren coincidencias precisas de palabras clave. Si solo necesita clasificación semántica, seleccione qwen3-rerank.
Modo de modelo de reordenamientoCuando crea una base de conocimientos, puede seleccionar uno de los siguientes tres modos para el modelo de reclasificación:
- Modo de preguntas y respuestas (predeterminado): Puntúa basándose en la "relevancia de preguntas y respuestas" entre la consulta y los fragmentos candidatos. Este modo es adecuado para escenarios donde los usuarios hacen una pregunta completa y esperan encontrar la respuesta dentro de un fragmento.
- Modo de similitud: Puntúa basándose en la "similitud semántica" entre la consulta y los fragmentos candidatos. Este modo es adecuado para escenarios donde la consulta y los fragmentos tienen un estilo de expresión similar.
- Modo avanzado personalizado: Le permite ingresar una instrucción en lenguaje natural de hasta 200 caracteres para influir en el proceso de reclasificación. Este modo es adecuado para escenarios con requisitos de clasificación especiales.
AdvertenciaPuede seleccionar un modo de modelo de reclasificación only when you create a knowledge base. You cannot change it after creation. Antes de configurar este ajuste, tenga en cuenta las siguientes limitaciones:
- Limitación de tipo de base de conocimiento: Esta función solo es aplicable a bases de conocimiento de búsqueda de documentos, Consulta de datos y búsqueda de audio/video. No es compatible con bases de conocimiento de Preguntas y respuestas sobre imágenes.
- Limitación de caso de uso: Esta función solo es compatible con los casos de uso de Preguntas y respuestas básicas sobre documentos y Respuesta de texto enriquecido. No es compatible con los casos de uso de comprensión visual (documentos de texto enriquecido) y Preguntas y respuestas rápidas.
Umbral de similitud
Este umbral establece la puntuación mínima de similitud requerida para que un fragmento sea recuperado de los resultados del modelo de reclasificación.
NotaEste es el umbral de similitud predeterminado para la base de conocimientos. Cuando asocia la base de conocimientos con una aplicación específica de Alibaba Cloud Model Studio, puede establecer un umbral separado para esa aplicación, el cual anula el umbral predeterminado de la base de conocimientos.
Reducir este umbral recupera más fragmentos, pero puede incluir contenido menos relevante. Por el contrario, aumentarlo recupera menos fragmentos y puede provocar que los relevantes se descarten si se establece demasiado alto.
Puede utilizar la prueba de aciertos para ajustar el umbral de similitud y equilibrar la recuperación y la precisión.
Recuento máximo de recuperación
El sistema recupera fragmentos relacionados con la entrada de todas las bases de conocimientos asociadas, los reordena utilizando un modelo de reordenamiento y selecciona los K fragmentos más relevantes para agregarlos a la entrada del LLM como contexto. Este valor K es el recuento máximo de recuperación (hasta 20), y determina el número de fragmentos que el modelo de reordenamiento proporciona al LLM para el contexto.
Aumentar este valor puede mejorar la precisión de la respuesta del LLM, pero también incrementa el consumo de tokens de entrada del LLM.
Almacenamiento vectorial
Seleccione una base de datos vectorial para almacenar vectores de texto. La base de datos vectorial Integrada es suficiente para las operaciones básicas de la base de conocimientos. Para capacidades avanzadas como gestión de bases de datos, auditoría o monitoreo, recomendamos AnalyticDB for PostgreSQL (ADB-PG).
Cuando adquiere una instancia de AnalyticDB for PostgreSQL (ADB-PG), debe habilitar la Optimización del motor vectorial. De lo contrario, Alibaba Cloud Model Studio no podrá utilizar la instancia.
-
-
-
Casos de uso:
Puede seleccionar un use case según sus requisitos, como Basic document Q&A, Respuesta de texto enriquecido.
Durante las horas pico, la creación de la base de conocimientos puede tardar varias horas, dependiendo del volumen de datos.
Actualizar una base de conocimientos
Los cambios en una base de conocimientos se sincronizan en tiempo real con todas las aplicaciones que la referencian.
Búsqueda de documentos
-
Actualización automática (recomendado)
Puede configurar actualizaciones automáticas integrando OSS, FC y las API de la base de conocimientos de Model Studio. Siga estos pasos:
- Crear un bucket: Vaya a la consola de OSS y cree un bucket de OSS para almacenar sus archivos de origen.
- Crear una base de conocimientos: Cree una base de conocimientos no estructurada para almacenar su contenido privado.
- Crear una función definida por el usuario: Vaya a la consola de FC y cree una función para manejar eventos de cambio de archivos, como la creación y eliminación de archivos. Para obtener más información, consulte Crear una función. La función llama a las API relevantes de la Guía de API de Base de Conocimientos para sincronizar su base de conocimientos con los cambios de archivos en OSS.
- Crear un disparador de OSS: En FC, asocie un disparador de OSS con la función definida por el usuario que creó en el paso anterior. Cuando ocurre un evento de cambio de archivo, como la carga de un nuevo archivo en OSS, el disparador ejecuta la función en FC.
-
Actualización manual
En la página de Base de conocimiento, busque la base de conocimiento que want actualizar y haga clic en View Details en su tarjeta.
-
Para agregar nuevos archivos: Haga clic en Upload Data y seleccione los archivos existentes del conector de datos.
-
Para eliminar un archivo: Busque el archivo que want eliminar y haga clic en Delete a su derecha.
-
Para modificar el contenido del archivo: Las actualizaciones en el lugar y las cargas con sobreescritura no son compatibles. Primero debe eliminar la versión anterior del archivo de la base de conocimiento y luego importar la nueva versión.
Nota: Si no elimina la versión anterior, podría aparecer contenido obsoleto en las respuestas.
-
Consulta de datos y preguntas y respuestas con imágenes
Nota: La página de detalles de una base de conocimiento de preguntas y respuestas sobre imágenes no tiene un botón directo de Upload Data. Haga clic en el enlace View Data Source para abrir la página de detalles del conector de datos y actualizar los datos.
-
Actualización automática
No admitido.
-
Actualización manual
Si el origen de datos de su base de conocimientos es una tabla de datos en Datos de la aplicación, debe actualizarla manualmente en dos pasos.
-
Paso 1: Actualizar la tabla de datos
Vaya a la pestaña Datos de la aplicación. En el panel izquierdo, seleccione la tabla de datos objetivo y haga clic en Upload Data.
-
Para insertar nuevos datos: Seleccione Incremental Upload como tipo de importación. Debe cargar un archivo de Excel que contenga solo la fila de encabezado y las nuevas filas de datos.
El encabezado del archivo debe coincidir con el esquema de tabla actual. Puede hacer clic en Download Template para obtener un archivo de plantilla con el encabezado estándar y luego agregarle sus nuevos datos.
-
Para eliminar datos: Seleccione Upload and Overwrite como tipo de importación. Debe cargar un archivo de Excel que contenga la fila de encabezado y solo los registros de datos que want conservar.
Para obtener el conjunto de datos completo, haga clic en el
 icono para descargar los datos en formato XLSX.
-
Para modificar datos: Seleccione Upload and Overwrite como tipo de importación. Debe cargar un archivo de Excel que contenga la fila de encabezado y el conjunto de datos completo y modificado.
-
-
Paso 2: Sincronizar los cambios con la base de conocimientos
Regrese a la lista de Base de conocimientos , busque la base de conocimientos objetivo y haga clic en View Details en su tarjeta. Haga clic en el
 icono en la esquina superior izquierda de la tabla de datos y confirme el aviso para sincronizar el contenido más reciente de la tabla de datos con la base de conocimientos.
Debe repetir estos pasos para cada actualización manual.
-
Paso 1: Actualizar la tabla de datos
Búsqueda de audio y video
-
Actualización automática
No admitido.
-
Actualización manual
En la página de Base de conocimiento, busque la base de conocimiento que want actualizar y haga clic en View Details en su tarjeta.
-
Para agregar nuevos archivos: Haga clic en Upload Data y seleccione archivos existentes en Application Data.
-
Para eliminar un archivo: Busque el archivo que want eliminar y haga clic en Delete a su derecha.
Esta acción elimina el archivo solo de la base de conocimientos. No elimina el archivo de origen en Datos de la aplicación.
-
Para modificar el contenido del archivo: Las actualizaciones en el lugar y las cargas con sobreescritura no son compatibles. Primero debe eliminar la versión anterior del archivo de la base de conocimiento y luego importar la nueva versión.
Nota: Si no elimina la versión anterior, podría aparecer contenido obsoleto en las respuestas.
-
Editar base de conocimientos
Después de crear una base de conocimientos, solo puede modificar su nombre de base de conocimientos, descripción de base de conocimientos y umbral de similitud. Para cambiar cualquier otra configuración, debe eliminar y volver a crear la base de conocimientos. Esta operación está disponible solo en la consola y no tiene una API correspondiente.
Procedimiento: En la página de Base de conocimientos , busque la base de conocimientos objetivo, haga clic en el  icono en su tarjeta y luego haga clic en Edit. Nota: Solo puede modificar la configuración de una base de conocimientos una vez por día natural. Los intentos posteriores se rechazarán silenciosamente.
Eliminar una base de conocimientos
AdvertenciaEsta acción es irreversible.
Antes de eliminar una base de conocimientos, recomendamos desasociarla de todas las aplicaciones de Model Studio publicadas.
Aún puede eliminar una base de conocimientos asociada a aplicaciones no publicadas.
Procedimiento
-
Para cada aplicación publicada asociada con la base de conocimientos:
- En la página Centro de aplicaciones, busque la aplicación asociada con la base de conocimientos y haga clic en Configure.
- En la lista de bases de conocimientos, elimine la base de conocimientos. Haga clic en Publish en la esquina superior derecha de la página y vuelva a publicar la aplicación según se le indique.
-
En la página de Base de conocimientos , busque la base de conocimientos objetivo, haga clic en el
icono en su tarjeta y luego haga clic en Delete.
Cambiar configuración
La Enterprise Edition utiliza RCU para garantizar un alto rendimiento de recuperación con un QPS elevado y admite una mayor capacidad de almacenamiento. La Standard Edition es adecuada para escenarios de desarrollo, pruebas o baja concurrencia.
NotaPuede cambiar entre la Edición Estándar y la Edición Empresarial, y modificar el recuento de RCU para la Edición Empresarial.
Solo puede cambiar la configuración de una base de conocimientos una vez por día natural.
RCU: Una Unidad de Cómputo de Recuperación (RCU) es una medida de la concurrencia de recuperación para una base de conocimiento. 1 RCU admite hasta aproximadamente 50 QPS para recuperación en línea. Un mayor número de RCU admite una mayor concurrencia.
-
Nota:
-
Si una base de conocimientos de Edición Empresarial utiliza almacenamiento de plataforma, debe reducir su espacio de almacenamiento utilizado a menos de 80 GB antes de poder degradarla a la Edición Estándar.
Puede liberar espacio de almacenamiento eliminando archivos o datos de la base de conocimientos.
-
-
Procedimiento:
-
En la página de Base de conocimientos , busque la base de conocimientos para reconfigurar. Haga clic en el
icono en su tarjeta y luego haga clic en Edit. -
En el cuadro de diálogo, seleccione una acción según la edición actual:
- Standard Edition: Seleccione Upgrade.
- Enterprise Edition: Seleccione Downgrade o Change RCU Count.
-
Siga las instrucciones en pantalla para completar el proceso. La nueva configuración surte efecto inmediatamente después de hacer clic en OK.
-
Prueba de recuperación
Utilice la prueba de aciertos para verificar que su base de conocimiento proporciona un contexto preciso para su aplicación de IA. Este proceso implica simular consultas de usuarios, evaluar los resultados de recuperación y ajustar el umbral de similitud.
El modelo de reordenamiento en las pruebas de recuperación admite tres modos: Modo de preguntas y respuestas (predeterminado), diseñado para consultas que no coinciden perfectamente con el contenido del documento; modo de similitud, ideal para consultas que son altamente similares al contenido del documento; y modo avanzado personalizado. Las puntuaciones de clasificación para la misma consulta pueden variar significativamente dependiendo del modo seleccionado. Por ejemplo, el mismo segmento de texto podría obtener una puntuación de 47% en el modo de preguntas y respuestas, pero hasta 69% en el modo de similitud.
Con la prueba de aciertos, usted puede:
- Verificar que la base de conocimientos proporciona un contexto efectivo a su aplicación de IA
- Ajustar el umbral de similitud para equilibrar la tasa de recuperación y la precisión
- Identificar lagunas de contenido o problemas de calidad en su base de conocimientos
Casos de uso
- Escenario 1: Consulta de precios de productos
Test input: "How much does your Model Studio phone cost?"
Expected result: Retrieve relevant text segments that contain price information.
- Escenario 2: Solución de un problema técnico
Test input: "What should I do if my device can't connect to Wi-Fi?"
Expected result: Retrieve relevant text segments about troubleshooting Wi-Fi connection issues.
- Escenario 3: Recuperación con comprensión visual
A visual understanding knowledge base supports three query modes: text-only, image-only, and image+text.
Mode 1 (text-only): Enter "Object Storage Service" to retrieve relevant segments from documents and images.
Mode 2 (image-only): Upload a product screenshot. The system uses visual understanding to match semantically similar segments.
Mode 3 (image+text): Upload an image and enter descriptive text. This combined query can improve retrieval relevance.
- Escenario 4: Preguntas y respuestas exprés
An Express Q&A knowledge base supports text-only queries (image input is not supported) and is ideal for fast retrieval from structured documents:
Test input: "What is the price of the Qwen Pro 8?"
Expected result: Quickly retrieve relevant FAQ segments that include price information.
Procedimiento
-
En la página de base de conocimientos, haga clic en Hit Test en la tarjeta de la base de conocimientos objetivo.
-
En la interfaz de prueba, introduzca una pregunta (idealmente una común de sus usuarios) y revise los resultados de la recuperación.
- Resultados de recuperación: Esta sección muestra los resultados de recuperación de la prueba actual, ordenados por similitud en orden descendente. Haga clic en cualquier segmento de texto para ver su contenido.
 Icono: Para una base de conocimientos de preguntas y respuestas de imágenes, el sistema primero convierte la imagen de entrada en un vector y recupera segmentos relevantes. Luego envía estos segmentos junto con la pregunta a un LLM para generar una respuesta. Para las bases de conocimientos de búsqueda de documentos y consulta de datos, el sistema no utiliza la imagen cargada para la recuperación. Sin embargo, una base de conocimientos de búsqueda de documentos configurada para "comprensión visual" sí utiliza la imagen para la recuperación, admitiendo modos de consulta de solo texto, solo imagen e imagen+texto. Esta consulta combinada puede mejorar la relevancia de la recuperación.
-
Verifique que se recuperen los segmentos de texto relevantes. De lo contrario, ajuste el umbral de similitud y repita el paso anterior.
-
Haga clic en View Recall History para comparar el rendimiento de recuperación entre diferentes configuraciones de umbral.

Cuotas y límites
-
Para obtener información sobre orígenes de datos compatibles, capacidad y otros límites para una base de conocimientos, consulte Cuotas y límites de la base de conocimientos.
-
Se aplican los siguientes límites cuando asocia bases de conocimientos con una aplicación de Model Studio:
- Búsqueda de documentos: Hasta 5
- Consulta de datos: Hasta 5
- Preguntas y respuestas con imágenes: Hasta 1
El límite total entre varios tipos de bases de conocimientos es 11.
Facturación
El uso de la función de base de conocimientos es gratuito, pero se le puede cobrar por llamar a una aplicación de Alibaba Cloud Model Studio que la utilice.
| Paso | Facturación | |
|---|---|---|
Sin costo. | ||
Cuando llama a una aplicación de Alibaba Cloud Model Studio, los fragmentos de texto recuperados de la base de conocimientos aumentan el recuento de tokens de entrada para el LLM, lo que incrementa las tarifas de inferencia del modelo. Para obtener más información, consulte Artículos facturables y precios.
| ||
Sin costo. | ||
Referencia de API
- Consulte el Directorio de API (Base de conocimientos) para obtener una lista completa de las API de base de conocimientos y sus parámetros.
- Consulte la Guía de la API de base de conocimientos para obtener información detallada sobre el uso y ejemplos de código.
FAQ
Creación de una base de conocimientos
P: ¿Puedo eliminar un archivo o una tabla de datos de Datos de la aplicación después de importarlo a una base de conocimientos?
- Para bases de conocimientos de búsqueda de documentos: Sí. Los archivos en una base de conocimientos son independientes de su origen en Datos de la aplicación. Eliminar el archivo de origen no afecta a los datos importados.
- Para bases de conocimientos de consulta de datos y Preguntas y respuestas de imágenes: No. Eliminar los datos de origen interrumpirá funciones como la sincronización de datos y la visualización de la base de conocimientos.
P: ¿Qué debo hacer si una llamada a la API de la base de conocimientos devuelve el código de error BailianIndexServiceNotOpen?
El código de error BailianIndexServiceNotOpen significa que no ha activado el servicio de base de conocimientos de Model Studio. Inicie sesión en la consola de Model Studio, vaya a la página Datos > Knowledge Base y haga clic en Activate Now para activar el servicio. Luego, intente nuevamente la llamada a la API.
Manejo de imágenes y contenido multimodal
P: Mi archivo contiene ilustraciones que want que una aplicación de Model Studio incluya en sus respuestas. ¿Qué debo hacer?
Búsqueda de documentos
Método 1 (Solo para aplicaciones de agente)
-
Cuando usted crea una base de conocimiento, establezca el Tipo de base de conocimiento en búsqueda de documentos y With Illustrations en With Illustrations.
Cuando selecciona With Illustrations, la base de conocimientos extrae resúmenes de las ilustraciones del archivo. Luego, el modelo de lenguaje grande decide si insertar una imagen basándose en la relevancia del resumen respecto a la pregunta del usuario.
ImportanteNo seleccione electronic document parsing al cargar documentos. Este método de análisis no reconoce imágenes, lo que impide que la función Con ilustraciones funcione correctamente.
-
Cuando crea o edita una aplicación de agente, seleccione el modelo Qwen-Plus o Qwen-Plus-Latest (las pruebas muestran que estos modelos ofrecen el mejor rendimiento). Haga clic en el botón + a la derecha de Document Knowledge Base y agregue la base de conocimientos que creó en el paso anterior.
NotaLa longitud de recuperación debe ser menor que la longitud del documento. Si es mayor, el sistema devuelve el documento completo y omite la lógica Con ilustraciones.
Nota: Las funciones "Con ilustraciones" y "Mostrar fuente de la respuesta" no se pueden activar simultáneamente.
-
Resultado real de preguntas y respuestas:
Método 2 (Para aplicaciones de agente y flujo de trabajo)
-
Cargue la imagen en una ubicación accesible públicamente y obtenga su URL completa. Recomendamos utilizar OSS. Para obtener instrucciones, consulte Cargar una imagen en OSS y usar su URL de archivo.
-
Inserte la URL completa en el archivo. No se admiten rutas relativas. No incruste archivos de imagen directamente en el documento (por ejemplo, copiando y pegando o insertando una imagen local desde un menú). Debe hacer referencia a las imágenes utilizando sus URLs accesibles públicamente.
Si una imagen no se muestra, asegúrese de que la URL en el fragmento esté completa. Elimine cualquier espacio adicional o carácter especial que pueda causar errores de análisis. Puede editar el fragmento directamente para realizar estas correcciones.
Ejemplo de referencia correcta a una imagen en un archivo Plantilla de prompt de ejemplo Resultado real de preguntas y respuestas 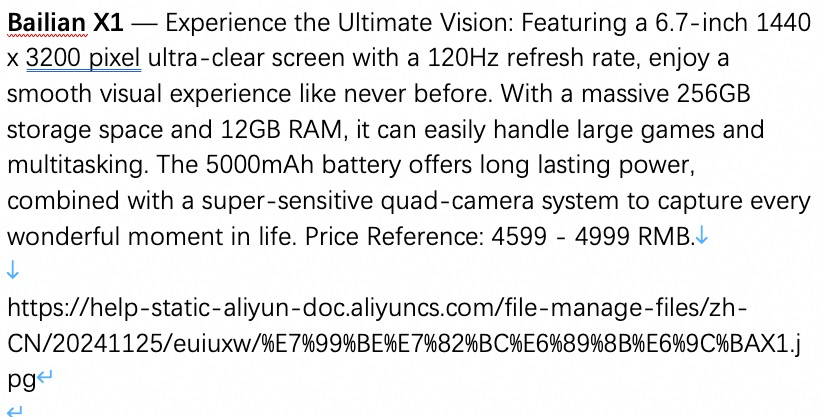
# Knowledge Base
Please remember the following materials. They may be helpful for answering questions.
${documents}

# Requirements
If there are image links, display them in full using markdown format.
Ejemplo de referencia incorrecta a una imagen en un archivo Plantilla de prompt de ejemplo Resultado real de preguntas y respuestas 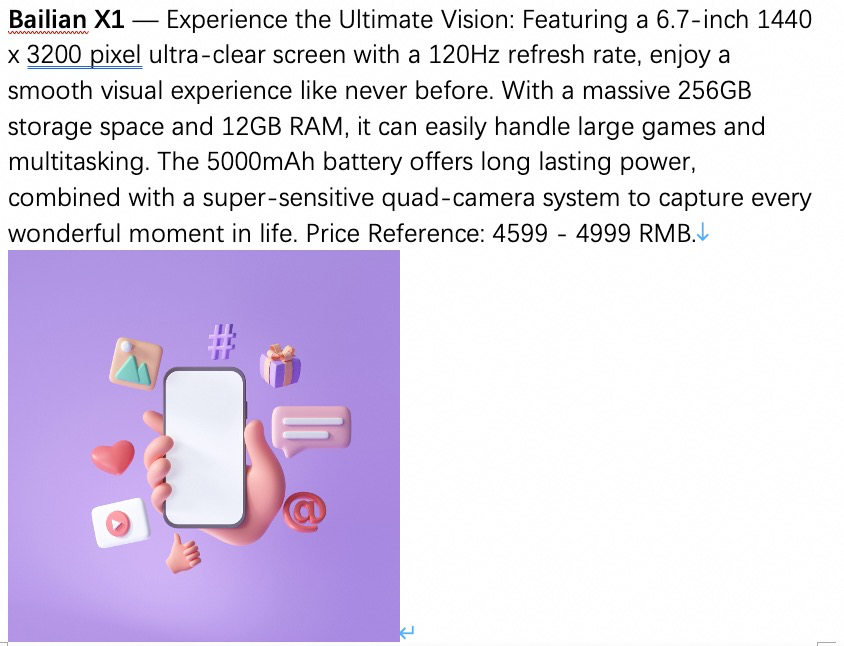
# Knowledge Base
Please remember the following materials. They may be helpful for answering questions.
${documents}

# Requirements
If there are images, please display them.
En la interfaz de prueba de chat, después de ingresar un prompt, la respuesta de la IA devuelve solo contenido de texto sin formato, sin ninguna imagen.
Explicación: Cuando incrusta una imagen directamente en un archivo, la aplicación Model Studio no muestra la imagen en su respuesta.
Preguntas y respuestas de imágenes
-
Cargue la imagen en una ubicación accesible públicamente y obtenga su URL completa. Recomendamos utilizar OSS. Para obtener instrucciones, consulte Cargar una imagen en OSS y usar su URL de archivo.
-
En la pestaña Tabla, cree una nueva tabla de datos y agregue un campo de tipo image_url para almacenar la URL completa de la imagen.
Nota
- El campo image_url no admite rutas relativas.
- Un solo campo image_url no puede almacenar múltiples URL de imágenes. Para asociar un registro con varias imágenes, cree un campo
image_urlseparado para cada una, comoimage_1yimage_2. - Cada imagen referenciada por un campo image_url debe ser de 3 MB o menos. Si una imagen supera este límite, la creación de la base de conocimientos fallará.
- No puede agregar ni modificar campos de tipo image_url después de crear una tabla de datos. Por lo tanto, debe incluir todos los campos de imagen necesarios durante el diseño inicial del esquema de la tabla.
El campo Tipo admite string, double, long, datetime e image_url. Después de la configuración, puede cargar archivos en formato xlsx o xls (no mayores de 20 MB) en el área de Importar datos.
-
Cuando usted crea una base de conocimientos, establezca el Tipo de base de conocimientos en Preguntas y respuestas de imágenes.
-
Cuando cree o edite una aplicación de agente, haga clic en el botón + a la derecha de Image (Base de conocimiento de Preguntas y respuestas sobre imágenes), agregue la base de conocimiento que creó y luego cambie la plantilla de prompt a:
# Knowledge Base
Please remember the following materials. They may be helpful for answering questions.
${documents}

# Requirements
If there are images, please display them.
-
Formule una pregunta en el cuadro de entrada situado en el lado derecho de la página.
Por ejemplo: "Presente brevemente el teléfono Model Studio X1."
Ejemplo de referencia correcta a una imagen Plantilla de prompt de ejemplo Indicación del usuario y respuesta de la aplicación Model Studio En la página de vista previa de datos de la base de conocimientos de Alibaba Cloud Model Studio, los datos de Model Studio Phone muestran Importación exitosa. La tabla de datos estructurados contiene tres columnas: Modelo (cadena), Descripción (cadena) e Imagen (image_url). En la fila de datos de ejemplo, el modelo es Model Studio X1, el campo de descripción contiene pantalla (6.7 pulgadas, 1440x3200 píxeles, 120Hz), almacenamiento (256GB+12GB RAM), batería (5000mAh), cámara (cámara cuádruple ultra sensible) y precio de referencia 4,599–4,999 yuanes, siendo la columna de imagen la URL del recurso de imagen correspondiente.
# Knowledge Base
Please remember the following materials. They may be helpful for answering questions.
${documents}

# Requirements
If there are images, please display them.
Permisos y seguridad
P: ¿Qué debo hacer si obtengo un error de "Permisos faltantes para este módulo" al gestionar una base de conocimientos?
De forma predeterminada, los usuarios RAM no pueden realizar operaciones de escritura como crear, actualizar o eliminar bases de conocimientos. Una cuenta de Alibaba Cloud debe otorgarles los permisos de página requeridos, los cuales deben ser permisos de Administrator o incluir al menos tanto los permisos de Application Data-Actions como los de Knowledge Base-Actions.
P: ¿Es privada una base de conocimientos? ¿Pueden otras organizaciones o usuarios acceder a ella?
Una base de conocimientos es privada para su espacio de trabajo y solo puede ser accedida y gestionada por los miembros de dicho espacio.
P: ¿Utilizará Alibaba Cloud las bases de conocimientos de mi cuenta para responder preguntas de otros usuarios?
Alibaba Cloud está comprometido con la privacidad de los datos y no utilizará los datos de su base de conocimiento para el entrenamiento de modelos ni para responder preguntas de otros usuarios. Para obtener más información, consulte la Declaración de cumplimiento y privacidad.
Migración y exportación
P: ¿Cómo exporto una base de conocimientos a mi máquina local?
Actualmente no se admite la exportación con un solo clic. Como solución alternativa, puede llamar a la API ListChunks y escribir un script para recuperar datos de documentos y fragmentos en lotes.