Si encuentra una recuperación de conocimientos incompleta o contenido inexacto con la función de generación aumentada por recuperación (RAG) en Alibaba Cloud Model Studio, consulte las sugerencias y ejemplos en este tema para mejorar el rendimiento de RAG.
1. Flujo de trabajo RAG
RAG (Generación Aumentada por Recuperación) es una técnica que combina la recuperación de información con la generación de texto. Permite que un modelo utilice información relevante de una base de conocimientos externa al generar respuestas.
Su flujo de trabajo incluye varias etapas clave, incluyendo análisis y fragmentación, almacenamiento vectorial, recuperación y recall, y generación de respuestas.
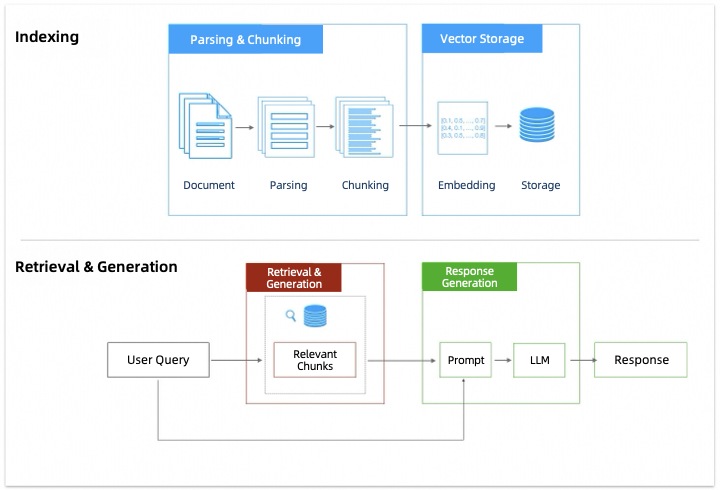
Las siguientes secciones cubren técnicas para optimizar cada etapa: análisis y fragmentación, recuperación y recall, y generación de respuestas.
2. Optimizar el rendimiento de RAG
2.1 Preparación
Primero, asegúrese de que los documentos que importa a la base de conocimiento de Model Studio cumplan con los siguientes requisitos:
-
Incluir conocimiento relevante: Si la base de conocimientos carece de información relevante, el modelo podría no responder preguntas relacionadas. Para resolver esto, actualice la base de conocimientos y agregue el conocimiento necesario.
-
Usar formato Markdown (recomendado): Los archivos PDF a menudo tienen diseños complejos, lo que puede llevar a resultados de análisis deficientes. Convierta primero los PDF a un formato de texto como Markdown, DOC o DOCX. Por ejemplo, use DashScopeParse para convertir un PDF a Markdown y luego use un modelo para limpiar el formato. Consulte el capítulo RAG del Curso ACP de grandes modelos de Alibaba Cloud.
¿Cómo debo manejar las ilustraciones en los documentos?
Actualmente, la base de conocimiento no puede analizar contenido de video o audio en documentos.
-
Use una redacción clara, una estructura razonable y sin estilos especiales: El diseño de su documento también afecta significativamente el rendimiento de RAG. Para más detalles, consulte ¿Cómo deben formatearse los documentos para beneficiar a RAG?.
-
Coincidir con el idioma de la solicitud: Si las solicitudes de los usuarios están principalmente en un idioma, como el inglés, asegúrese de que el contenido de su documento esté en el mismo idioma. Si es necesario, como para términos técnicos en el documento, puede usar dos o más idiomas.
-
Desambiguación de entidades: Unifica diferentes expresiones para la misma entidad en un documento. Por ejemplo, "ML" y "Machine Learning" pueden estandarizarse como "Machine Learning".
Puede ingresar el documento en un modelo y solicitarle que estandarice los términos. Si el documento es extenso, puede dividirlo en varias partes e ingresarlas una por una.
Después de completar estos pasos, optimice cada etapa de su aplicación RAG.
2.2 Análisis y fragmentación
Esta sección describe únicamente los elementos de configuración en Model Studio para optimizar la etapa de fragmentación de RAG.
Primero, la base de conocimientos analiza y fragmenta los documentos que usted importa. El propósito principal de la fragmentación es reducir el ruido durante el proceso de vectorización posterior mientras se preserva la integridad semántica. Por lo tanto, la estrategia de fragmentación de documentos que seleccione al crear una base de conocimientos tiene un impacto significativo en el rendimiento de RAG. Si el método de fragmentación no es adecuado, puede provocar los siguientes problemas:
Fragmentos cortos | Fragmentos largos | Truncamiento semántico |
|---|---|---|
|
|
|
Los fragmentos cortos pueden carecer de información semántica, lo que provoca fallos en la recuperación. | Los fragmentos largos pueden incluir temas irrelevantes, lo que provoca que el proceso de recuperación devuelva información ruidosa o irrelevante. | El truncamiento semántico forzado puede causar falta de contenido durante la recuperación. |
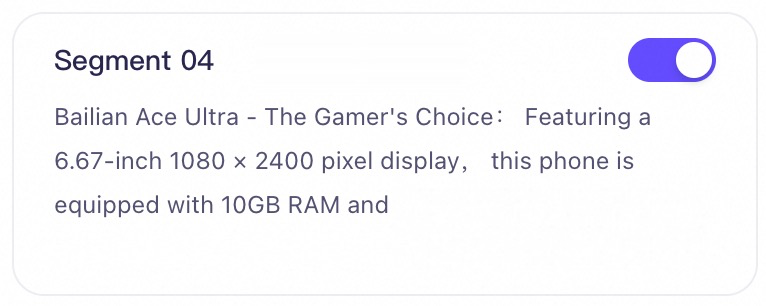
Para obtener mejores resultados, mantenga los fragmentos de texto semánticamente completos evitando el ruido excesivo. Model Studio recomienda lo siguiente:
- Cuando crea una base de conocimiento, seleccione intelligent chunking para el método de fragmentación de documentos.
- Después de importar correctamente documentos a la base de conocimiento, revise y corrija manualmente el contenido de los fragmentos de texto.
2.2.1 Fragmentación inteligente
Elegir la longitud óptima de fragmento de texto para su base de conocimiento puede ser un desafío porque depende de múltiples factores, tales como:
- Tipo de documento: Para literatura profesional, los fragmentos más largos suelen ayudar a conservar más contexto. Para publicaciones en redes sociales, los fragmentos más cortos pueden capturar la semántica con mayor precisión.
- Complejidad de la solicitud: Por lo general, si la solicitud de un usuario es compleja y específica, es posible que necesite fragmentos más largos. De lo contrario, los fragmentos más cortos podrían ser más apropiados.
Estas conclusiones no necesariamente se aplican a todas las situaciones. Debe elegir las herramientas adecuadas y experimentar repetidamente para encontrar la longitud de fragmento de texto correcta. Por ejemplo, LlamaIndex proporciona funciones de evaluación para diferentes métodos de fragmentación. Sin embargo, este proceso puede ser complejo y consumir mucho tiempo.
Para una solución rápida y efectiva, configure Fragmentación de documentos en División inteligente cuando cree una base de conocimiento.
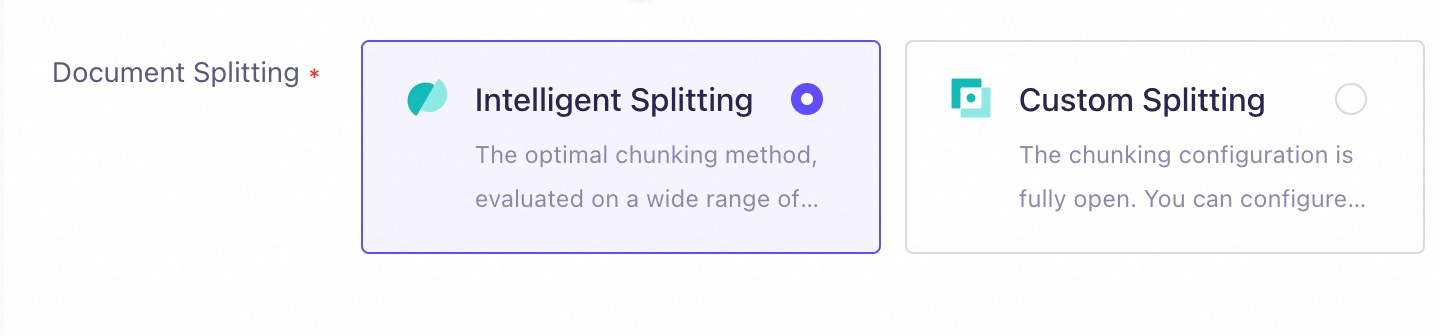
Cuando se aplica esta estrategia, la base de conocimientos:
- Primero utiliza delimitadores de oraciones integrados para dividir el documento en párrafos.
- Basándose en los párrafos divididos, selecciona adaptativamente los límites de los fragmentos según la relevancia semántica (fragmentación semántica), en lugar de utilizar una longitud fija.
Este proceso garantiza la integridad semántica de cada parte del documento y evita divisiones innecesarias. Esta estrategia se aplica a todos los documentos en esta base de conocimientos, incluidos los documentos importados posteriormente.
2.2.2 Corregir el contenido de los fragmentos
Por supuesto, durante el proceso real de fragmentación, aún pueden ocurrir divisiones inesperadas u otros problemas (por ejemplo, spaces en el texto a veces se analizan como %20 después de la fragmentación).
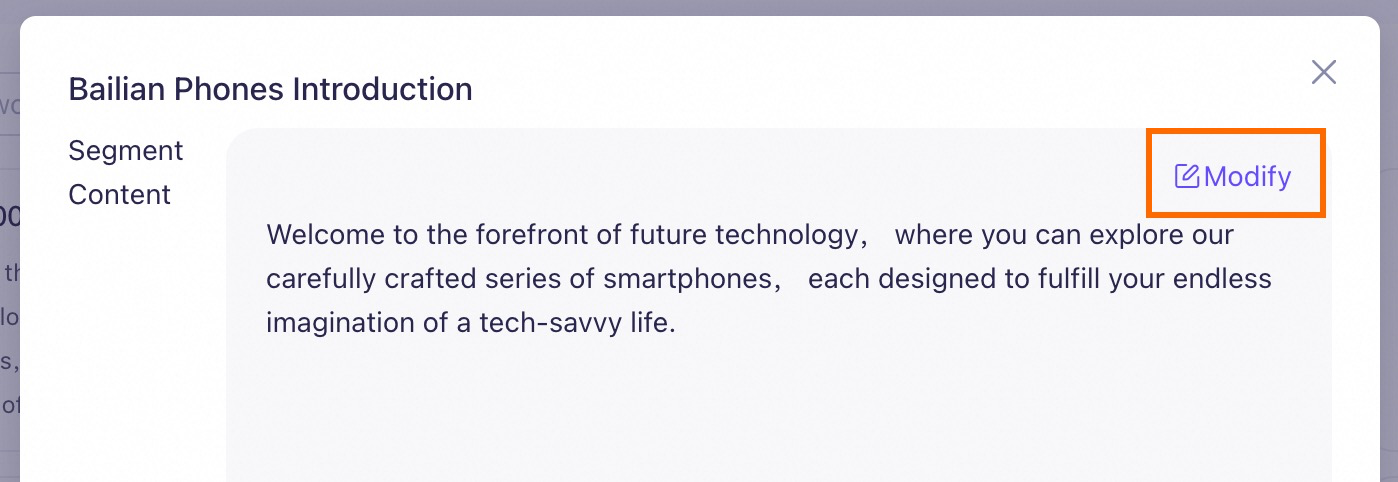
Por lo tanto, Model Studio recomienda verificar manualmente el contenido del fragmento para asegurar su integridad semántica y corrección después de importar un documento. Si encuentra fragmentos inesperados u otros errores de análisis, puede editar los fragmentos de texto directamente para corregirlos. Después de guardar, el contenido original del fragmento de texto queda invalidado y el nuevo contenido se utiliza para la recuperación de la base de conocimientos.
Tenga en cuenta que esta acción modifica solo los fragmentos de texto en la base de conocimientos, no el documento original ni la tabla de datos en su gestión de datos (almacenamiento temporal). Por lo tanto, si vuelve a importar el documento, debe realizar nuevamente la verificación y corrección manual.
2.3 Recuperación y recall
Esta sección describe únicamente los elementos de configuración en Model Studio para optimizar la etapa de recuperación y recall.
El principal desafío en la etapa de recuperación y recall es encontrar los fragmentos de texto más relevantes de la base de conocimiento que contengan la respuesta.
| Tipo de problema | Estrategia de mejora |
|---|---|
En escenarios de conversación de varios turnos, el prompt del usuario puede estar incompleto o ser ambiguo. | Habilite la reescritura de conversaciones de múltiples turnos. La base de conocimientos reescribe automáticamente la solicitud del usuario para que sea más completa, mejorando la coincidencia de conocimientos. |
La base de conocimientos contiene documentos de múltiples categorías. Cuando una búsqueda se centra en la Categoría A, los resultados de recuperación también incluyen fragmentos de texto de otras categorías, como la Categoría B. | Añada etiquetas a los documentos. Durante la recuperación, la base de conocimiento primero filtra los documentos relevantes basándose en las etiquetas antes de realizar la búsqueda.
|
La base de conocimientos contiene múltiples documentos con estructuras similares; por ejemplo, todos contienen una sección de "Resumen de características". Usted want buscar en la sección "Resumen de características" del Documento A, pero los resultados de recuperación incluyen información de otros documentos similares. | Utilice la extracción de metadatos. La base de conocimientos ejecuta una búsqueda estructurada con metadatos antes de la recuperación vectorial para encontrar con precisión el documento objetivo y extraer la información relevante.
|
Los resultados de recuperación están incompletos y no incluyen todos los fragmentos de texto relevantes. | Reduzca el umbral de similitud y aumente la cantidad de fragmentos recuperados para recuperar información que previamente se pasó por alto. |
Los resultados de recuperación contienen una gran cantidad de fragmentos de texto irrelevantes. | Aumente el umbral de similitud para excluir información con baja similitud respecto al prompt del usuario. |
2.3.1 Reescritura de conversación multironda
En una conversación de múltiples turnos, un usuario podría hacer una pregunta con una solicitud breve, como "Model Studio Phone X1". Esto puede causar que el sistema RAG carezca del contexto necesario durante la recuperación por las siguientes razones:
-
Un producto telefónico suele tener múltiples generaciones a la venta simultáneamente.
-
Para la misma generación de un producto, el fabricante suele ofrecer múltiples opciones de almacenamiento, como 128 GB y 256 GB.
...
Esta información clave puede haberse proporcionado en turnos de conversación anteriores. Utilizarla eficazmente ayuda a RAG a recuperar información más precisa.
Para solucionar esto, puede utilizar la función Reescritura de conversaciones de múltiples turnos en Model Studio. El sistema reescribe automáticamente la solicitud del usuario en una forma más completa basándose en el historial de conversaciones.
Por ejemplo, el usuario pregunta:
Model Studio Phone X1.
Con la reescritura de conversaciones de varios turnos habilitada, el sistema reescribe el prompt del usuario basándose en su historial de conversación antes de la recuperación (solo ejemplo):
Provide all available versions of Model Studio Phone X1 in the product library and their specific parameters.
Este prompt reescrito ayuda a RAG a comprender mejor la intención del usuario y proporcionar una respuesta más precisa.
La siguiente figura muestra cómo habilitar la función de reescritura de conversaciones de múltiples turnos. Esta función también se habilita cuando selecciona la Recommended Configuration.
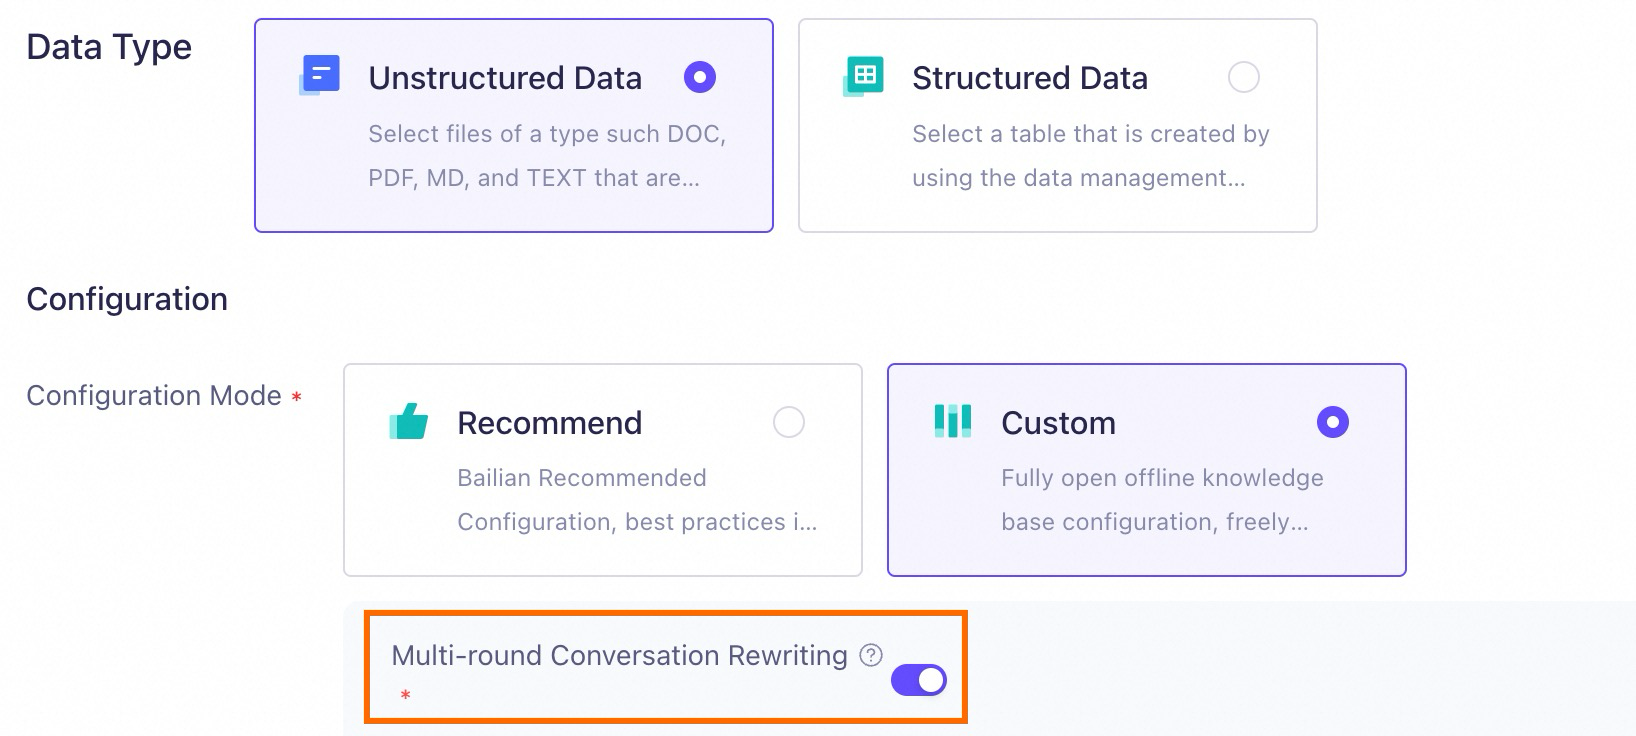
Tenga en cuenta que la función de reescritura de conversaciones de múltiples turnos está vinculada a la base de conocimientos. Una vez habilitada, se aplica solo a consultas relacionadas con la base de conocimientos actual. Esta configuración no se puede cambiar posteriormente; debe recrear la base de conocimientos para habilitarla.
2.3.2 Filtrado por etiquetas
Esta sección se aplica únicamente a las bases de conocimiento de búsqueda de documentos.
Cuando utiliza una aplicación de música, podría filtrar canciones por artista para encontrar rápidamente todas las canciones de ese artista.
De manera similar, agregar etiquetas a sus documentos no estructurados introduce información estructurada adicional. Al recuperar datos de la base de conocimientos, la aplicación puede filtrar primero los documentos según las etiquetas, lo que mejora la precisión y la eficiencia de la recuperación.
Model Studio admite los siguientes dos métodos para configurar etiquetas:
-
Establecer etiquetas al cargar documentos: Para los pasos en la consola, consulte Importar datos.
-
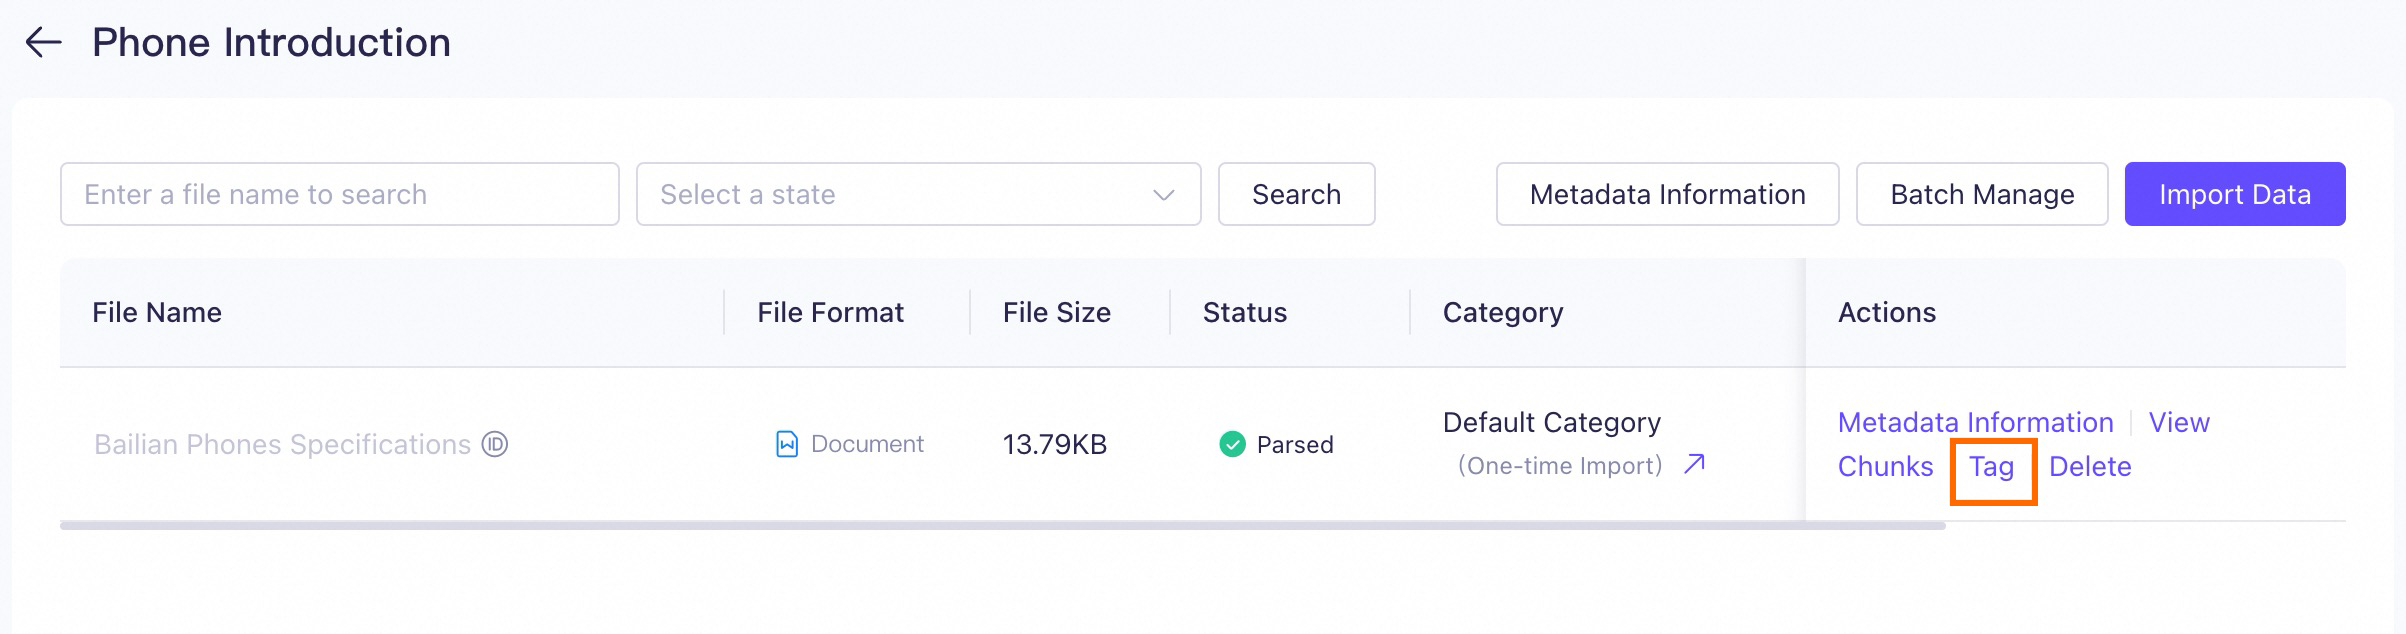
Editar etiquetas en la página de Data Management: Para documentos cargados, haga clic en Tag a la derecha del documento para editar sus etiquetas.
Model Studio admite los siguientes dos métodos para usar etiquetas:
-
Cuando usted llama a una aplicación de Model Studio mediante una API, puede especificar etiquetas en el parámetro de solicitud
tags. -
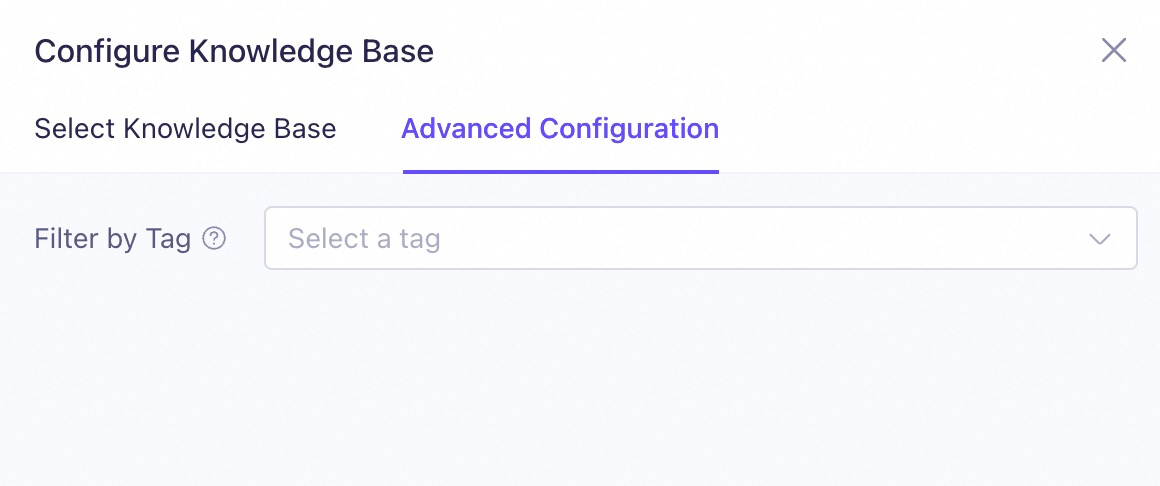
Configure etiquetas al editar una aplicación en la consola. Sin embargo, este método es aplicable únicamente a aplicaciones de agente.
Tenga en cuenta que esta configuración se aplica a todas las preguntas y respuestas posteriores del usuario para esta aplicación de agente.
2.3.3 Extracción de metadatos
Esta sección se aplica únicamente a las bases de conocimiento de búsqueda de documentos.
Incorporar metadatos en los fragmentos de texto puede mejorar eficazmente el contexto de cada fragmento. En escenarios específicos, este método puede mejorar significativamente el rendimiento de RAG en bases de conocimientos de búsqueda de documentos.
Considere el siguiente escenario:
Una base de conocimientos contiene muchos manuales de productos telefónicos. Los nombres de los documentos son los modelos de teléfono (como Model Studio X1 y Model Studio Zephyr Z9), y todos los documentos incluyen un capítulo de "Resumen de características".Si los metadatos no están habilitados para esta base de conocimiento, un usuario podría ingresar el siguiente prompt para la recuperación:
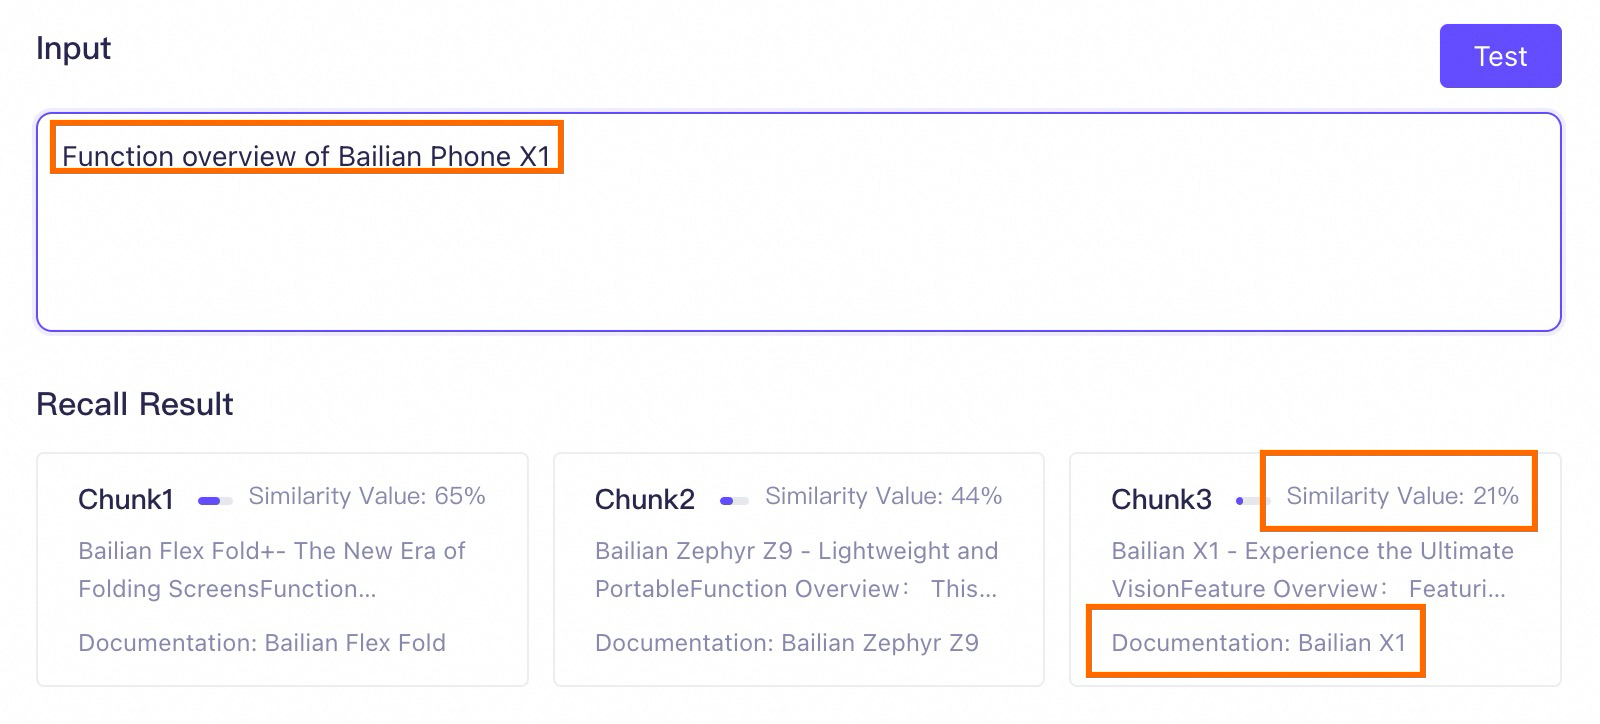
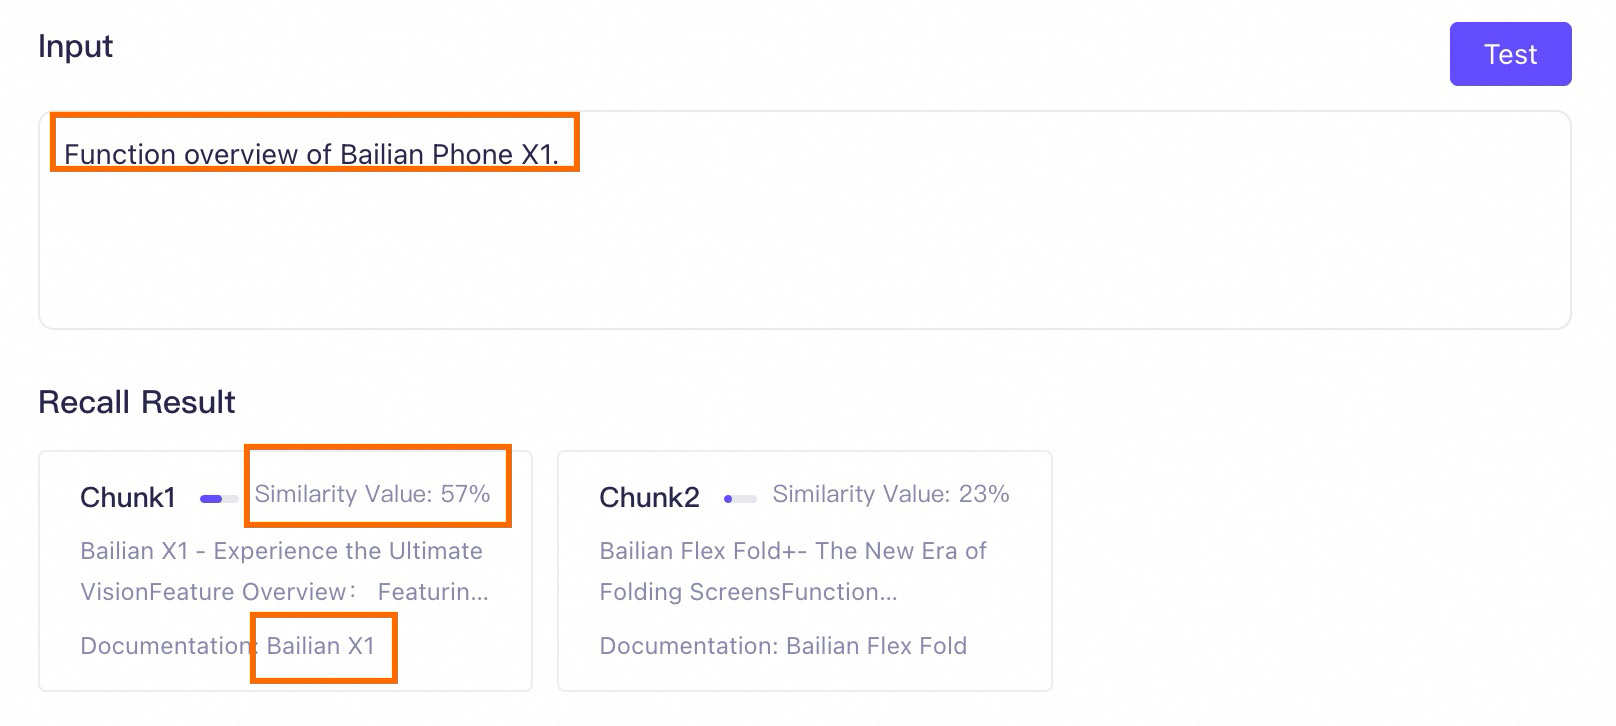
Feature overview of Model Studio Phone X1.
Una prueba de recuperación revela los fragmentos recuperados. Debido a que todos los documentos contienen "Visión general de características", la base de conocimientos recupera algunos fragmentos de texto que no están relacionados con la entidad de consulta (Model Studio Phone X1) pero son similares al prompt, como el Fragmento 1 y el Fragmento 2 en la figura. Sus clasificaciones son incluso más altas que las del fragmento de texto requerido, lo que afecta negativamente el rendimiento de RAG.
Los resultados de la prueba de recuperación garantizan la clasificación, pero la puntuación absoluta de similitud es solo orientativa. Cuando la diferencia en valores absolutos es pequeña (dentro de 5%), se puede considerar que la probabilidad de recuperación es la misma.
A continuación, configure el nombre del teléfono como metadato siguiendo los pasos en extracción de metadatos. Esto adjunta la información correspondiente del nombre del teléfono a los fragmentos de texto de cada documento. Luego, ejecute la misma prueba para comparar.
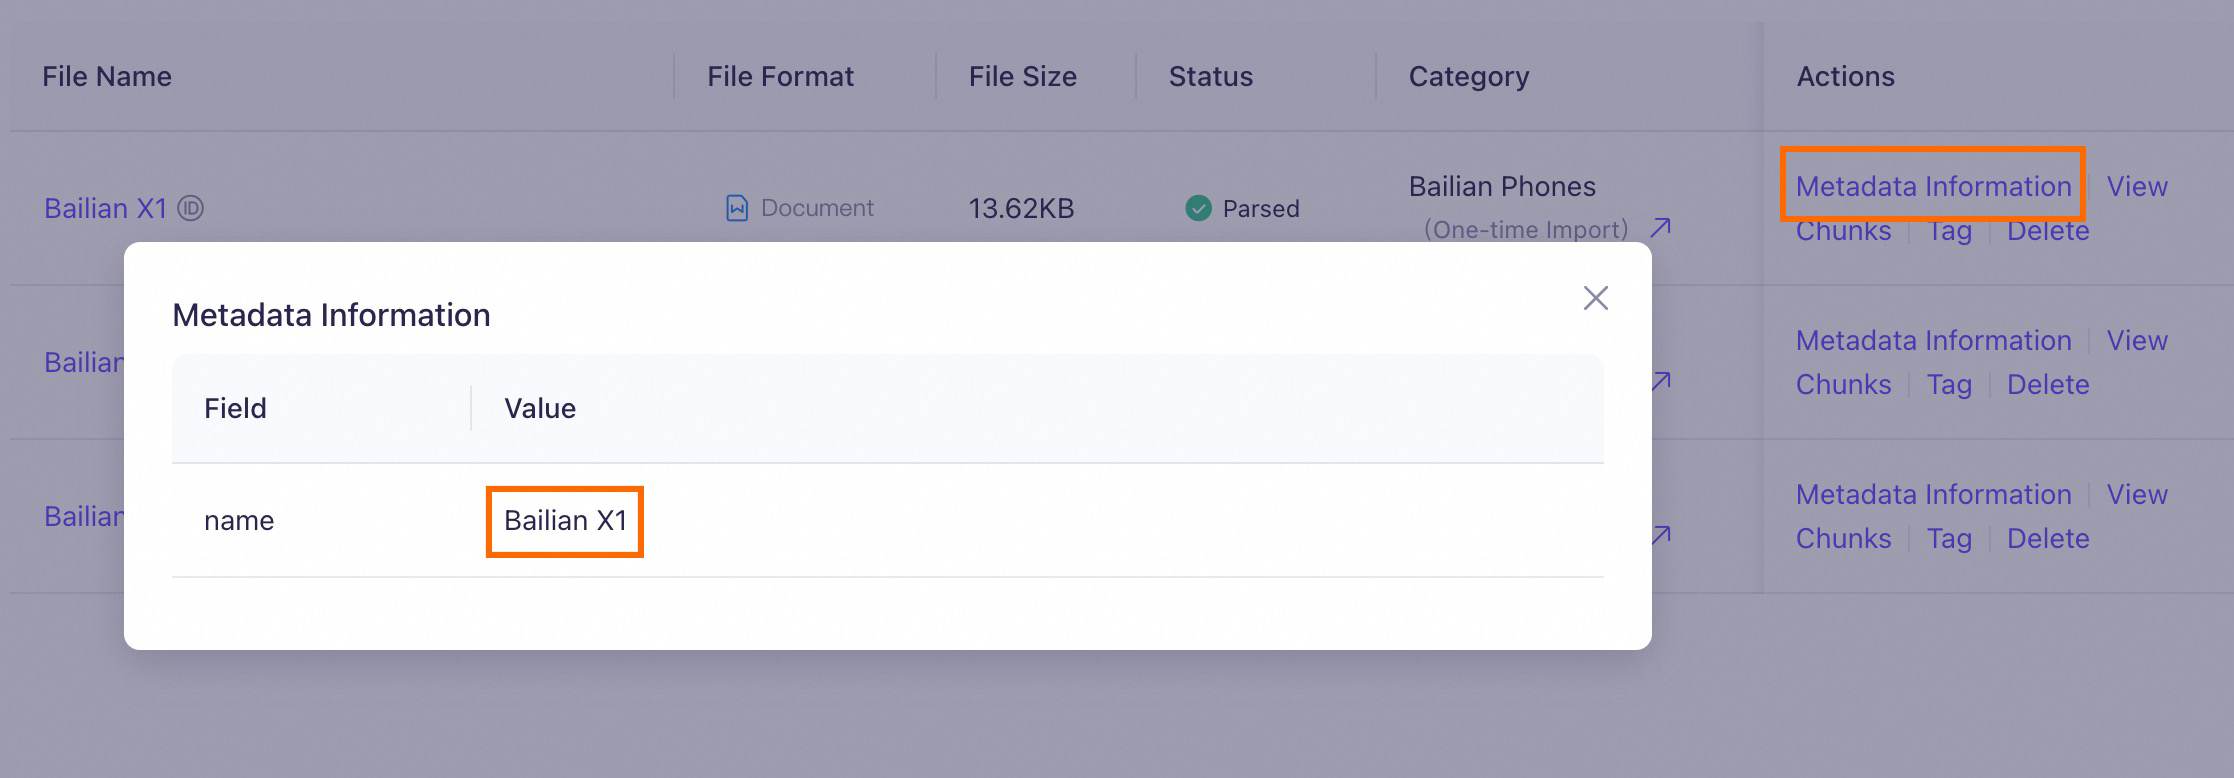
En este punto, la base de conocimiento añade una capa de búsqueda estructurada antes de la búsqueda vectorial. El proceso completo es el siguiente:
- Extraiga los metadatos {"key": "name", "value": "Model Studio Phone X1"} del prompt.
- Según los metadatos extraídos, encuentre todos los fragmentos de texto que contengan los metadatos "Model Studio Phone X1".
- Luego, realice una búsqueda vectorial (semántica) para encontrar los fragmentos de texto más relevantes.
Después de habilitar los metadatos, la base de conocimiento ahora puede encontrar con precisión el fragmento de texto relacionado con "Model Studio Phone X1" y que contiene "Descripción general de características".
Otra aplicación común de los metadatos es incorporar información de fecha en los fragmentos de texto para filtrar contenido reciente. Consulte extracción de metadatos.
2.3.4 Umbral de similitud
Cuando la base de conocimientos encuentra fragmentos de texto relacionados con el prompt del usuario, primero los envía al modelo Rank (configurado en Configuración de parámetros personalizados al crear la base de conocimientos) para su reordenamiento. Luego se utiliza el umbral de similitud para filtrar los fragmentos de texto reordenados. Solo los fragmentos de texto con una puntuación de similitud que supere este umbral pueden proporcionarse al modelo.
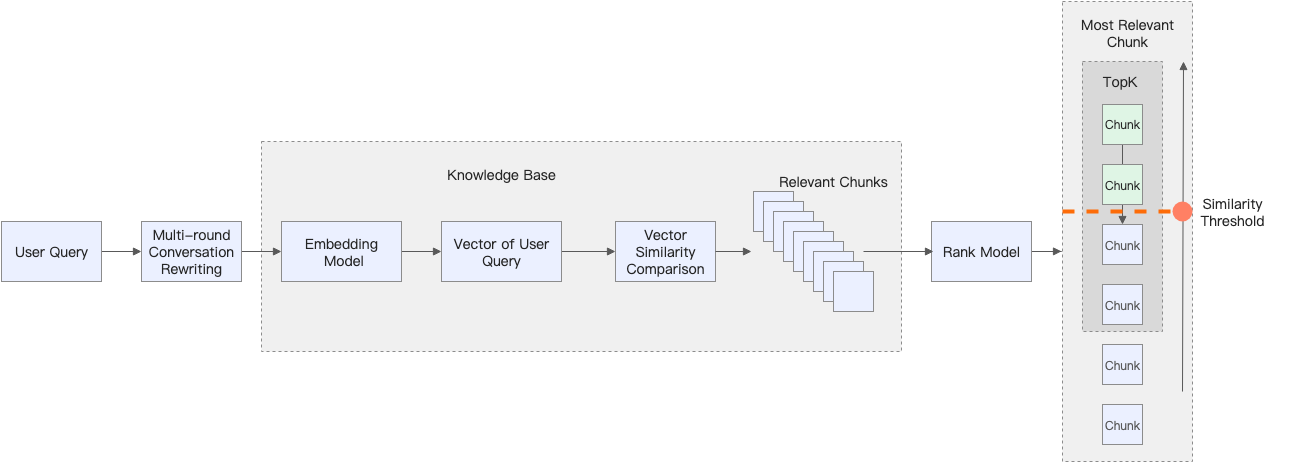
Reducir este umbral puede recuperar más fragmentos de texto, pero también puede causar que se recuperen algunos fragmentos menos relevantes. Aumentar este umbral puede reducir la cantidad de fragmentos de texto recuperados.
Si el umbral se establece demasiado alto, puede provocar que la base de conocimientos descarte todos los fragmentos de texto relevantes. Esto limita la capacidad del modelo para obtener suficiente información de contexto y generar una respuesta.
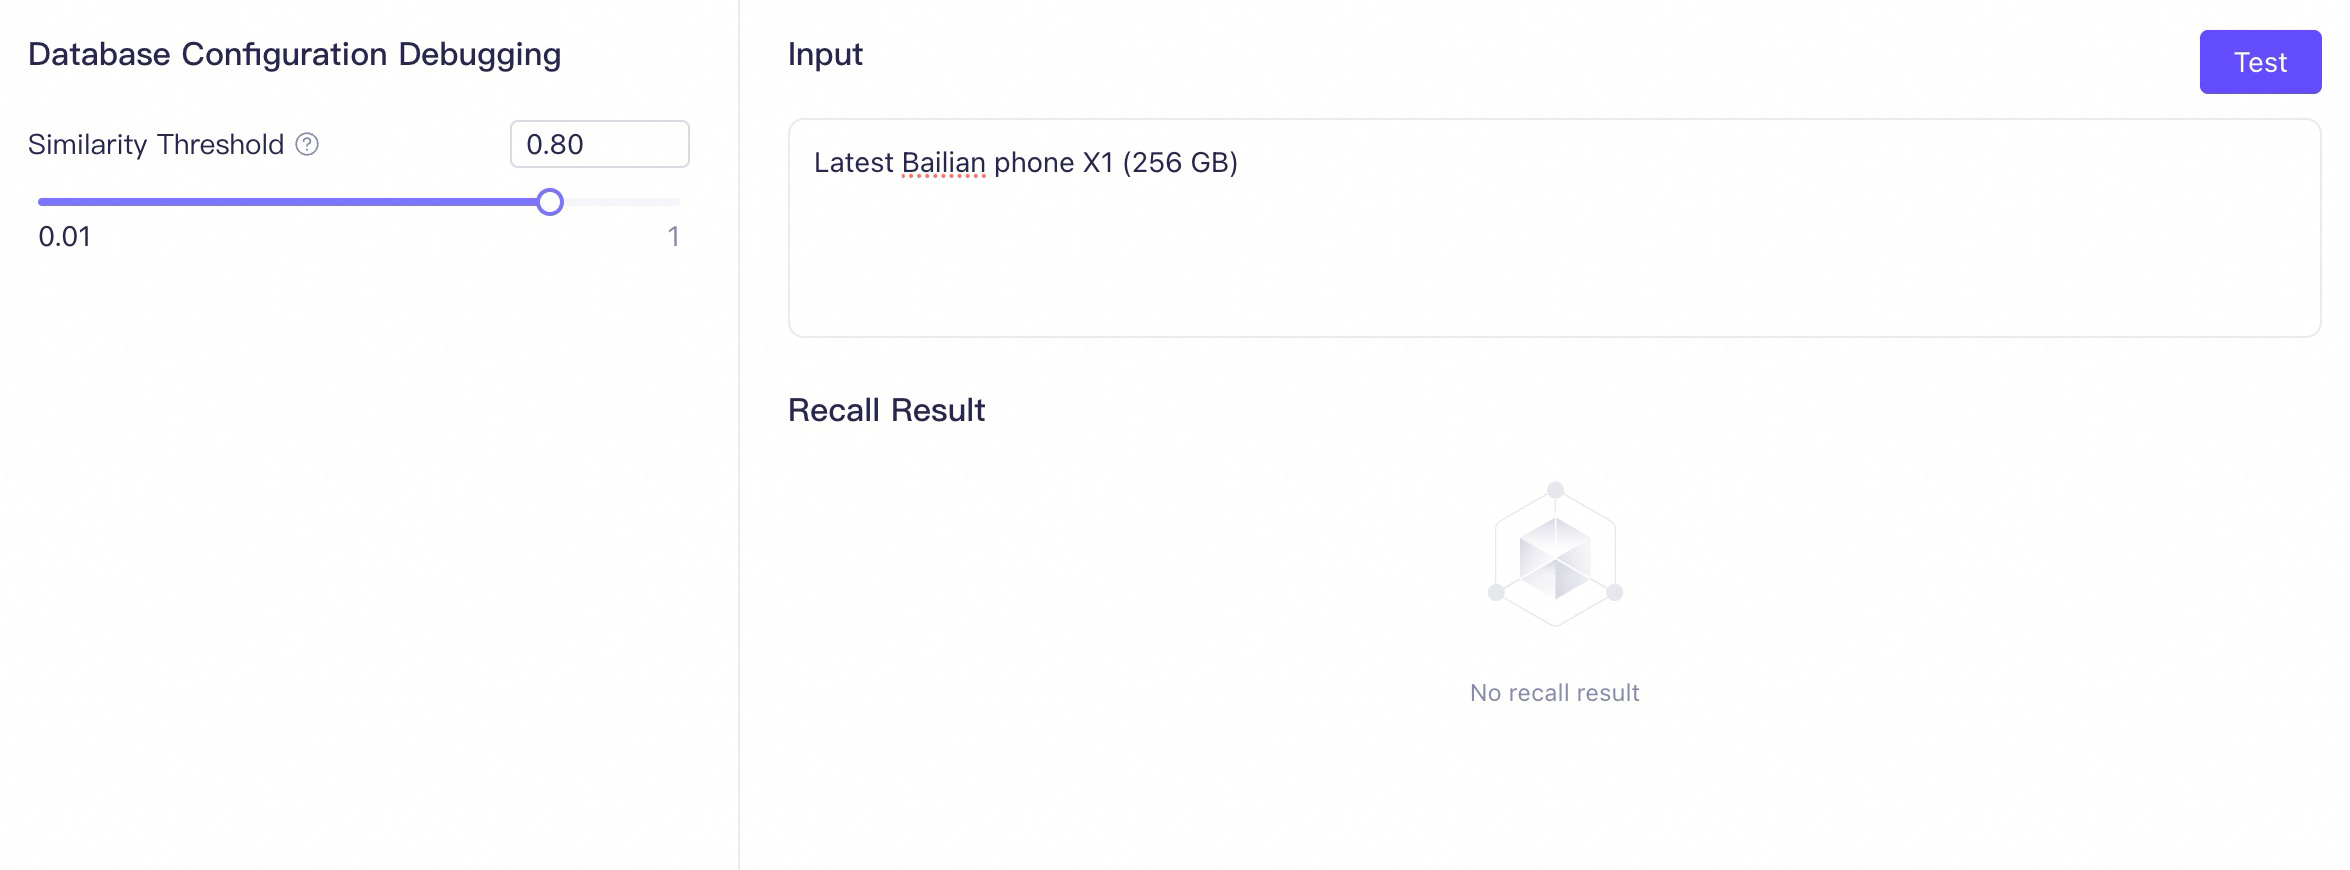
El umbral óptimo depende de su escenario. Necesita experimentar con diferentes umbrales de similitud mediante pruebas de recuperación, observar los resultados de recuperación y encontrar la solución que mejor se adapte a sus necesidades.
Pasos recomendados para las pruebas de recuperación | |
|
|

2.3.5 Número de fragmentos recuperados
El número de fragmentos recuperados es el valor K en la estrategia de recuperación multicanal. Después del filtrado por umbral de similitud, si el número de fragmentos de texto excede K, el sistema selecciona los K fragmentos de texto con las puntuaciones de similitud más altas para proporcionarlos al modelo. Debido a esto, un valor K inadecuado puede causar que RAG omita fragmentos de texto correctos, lo que afecta la capacidad del modelo para generar una respuesta completa.
Por ejemplo, un usuario recupera información con el siguiente prompt:
What are the advantages of the Model Studio X1 phone?
Hay 7 fragmentos de texto en la base de conocimientos objetivo que son relevantes para el prompt del usuario y deberían devolverse (marcados en verde a la izquierda). Sin embargo, debido a que este número excede el número máximo de fragmentos recuperados configurado actualmente (K), los fragmentos de texto que contienen la ventaja 5 (espera ultralarga) y la ventaja 6 (fotos nítidas) se descartan y no se proporcionan al modelo.

Dado que RAG no puede determinar cuántos fragmentos de texto se necesitan para proporcionar una respuesta "completa", el modelo generará una respuesta basada en los fragmentos proporcionados, incluso si están incompletos.
Muchos experimentos muestran que en escenarios como "Listar...", "Resumir..." y "Comparar X e Y...", proporcionar más fragmentos de texto de alta calidad (por ejemplo, K=20) al modelo es más efectivo que proporcionar solo los 10 principales o los 5 principales. Aunque esto puede introducir ruido, si la calidad del fragmento de texto es alta, un modelo capaz generalmente puede manejarlo.
Puede ajustar el Número de fragmentos recuperados cuando edita una aplicación en Model Studio.
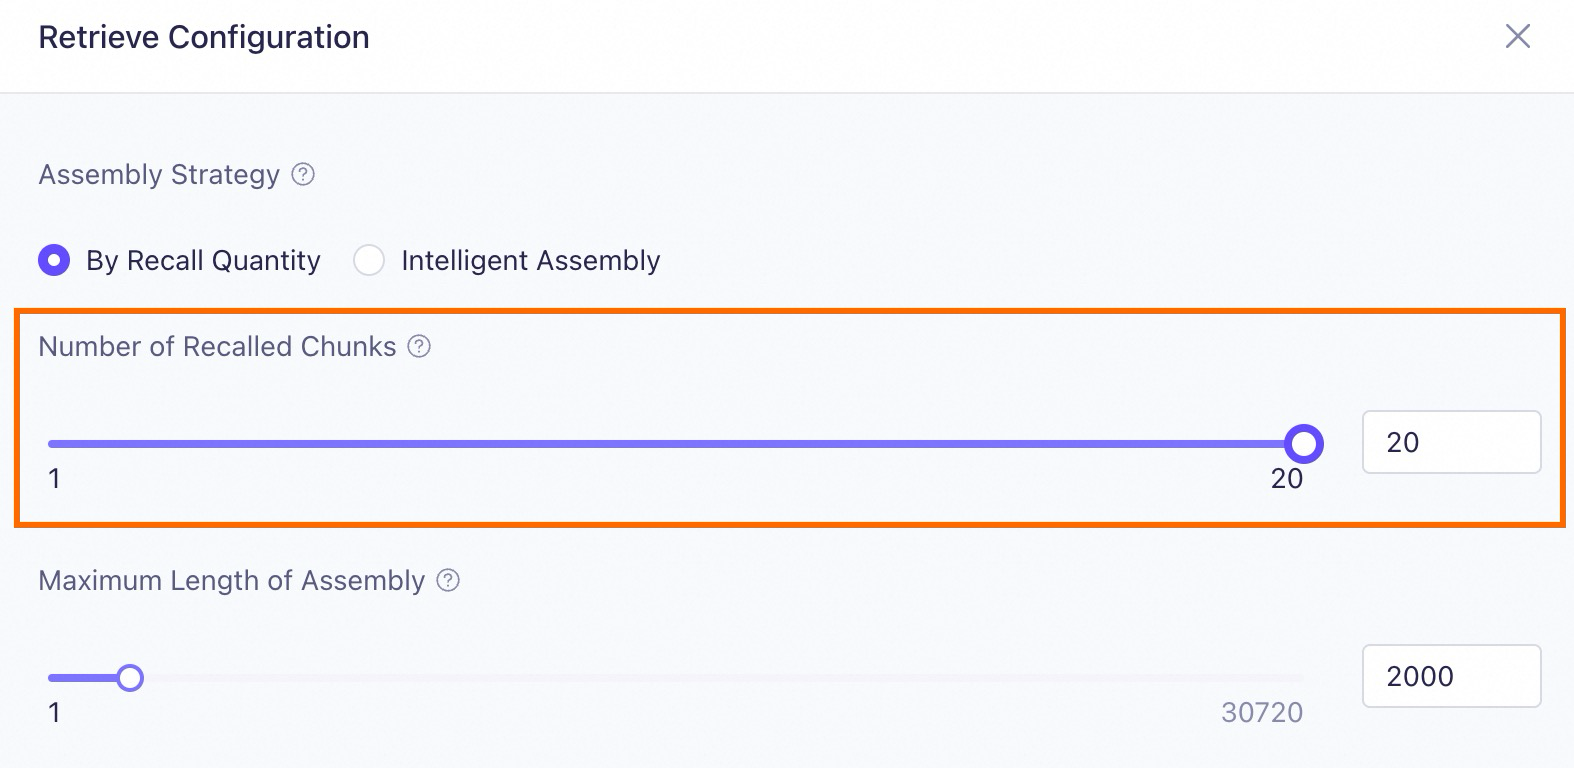
Sin embargo, una mayor cantidad de fragmentos recuperados no siempre es mejor. A veces, después de ensamblar los fragmentos de texto recuperados, su longitud total puede exceder el límite de longitud de entrada del modelo, causando truncamiento y afectando negativamente el rendimiento de RAG.
Seleccione Intelligent Assembly. Esta estrategia recupera tantos fragmentos de texto relevantes como sea posible sin exceder la longitud máxima de entrada del modelo.
2.4 Generación de respuestas
Esta sección describe únicamente los elementos de configuración que Model Studio admite para la optimización en la etapa de generación de respuestas.
En este punto, el modelo puede generar la respuesta final basándose en la solicitud del usuario y el contenido recuperado de la base de conocimientos. Sin embargo, es posible que el resultado devuelto aún no cumpla con sus expectativas.
Tipo de problema | Estrategia de mejora |
|---|---|
El modelo no comprende la relación entre el conocimiento y la solicitud del usuario. La respuesta parece estar ensamblada a partir de fragmentos de texto dispares. | Seleccione un modelo adecuado para comprender eficazmente la relación entre el conocimiento y el prompt del usuario. |
El resultado devuelto no sigue las instrucciones o no es exhaustivo. | |
El resultado devuelto no es lo suficientemente preciso. Contiene el conocimiento general propio del modelo y no se basa completamente en la base de conocimiento. | Habilitar rechazo para restringir las respuestas únicamente al conocimiento recuperado de la base de conocimiento. |
Para prompts similares, usted want que los resultados sean consistentes o variados. |
2.4.1 Selección de modelo
Los diferentes modelos grandes tienen distintas capacidades en áreas como seguimiento de instrucciones, soporte de idiomas, texto largo y comprensión del conocimiento. Esto puede llevar a la siguiente situación:
Model A no logró comprender eficazmente la relación entre el conocimiento recuperado y el prompt, y la respuesta generada no pudo abordar con precisión el prompt del usuario. Cambiar a Model B, que tiene más parámetros o capacidades especializadas más sólidas, puede resolver este problema.
Puede Seleccionar modelo cuando edita una aplicación en Model Studio según sus necesidades reales.
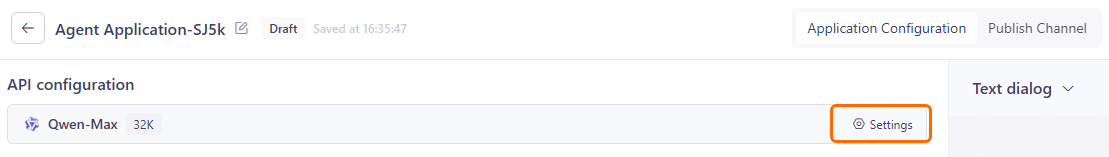
Al editar una aplicación de Alibaba Cloud Model Studio, puede Seleccionar modelo según sus necesidades reales. Seleccione un modelo comercial de Qwen, como Qwen-Max y Qwen-Plus. Estos grandes modelos comerciales tienen las capacidades y mejoras más recientes en comparación con sus versiones de código abierto.
- Para consultas de información simples y resúmenes, son suficientes modelos grandes con un pequeño número de parámetros, como
Qwen-Turbo. - Si usted want que RAG realice razonamientos lógicos más complejos, seleccione un modelo grande con más parámetros y capacidades de razonamiento más sólidas, como
Qwen-Max. - Si su consulta requiere referenciar muchos fragmentos de documentos, debe seleccionar un modelo grande con una longitud de contexto mayor, como
Qwen-Plus. - Si construye una aplicación RAG para un dominio especializado, como el dominio legal, utilice un modelo entrenado para ese dominio específico, como
Qwen-Legal.
2.4.2 Optimización de plantillas de prompts
Puede influir en el comportamiento de un modelo y mejorar el rendimiento de RAG mediante la ingeniería del prompt que guía cómo utiliza el conocimiento recuperado.
Los siguientes son tres métodos de optimización comunes:
Método 1: Restringir el contenido de salidaPuede proporcionar información contextual, instrucciones y el formato de salida esperado en la plantilla de solicitud para instruir al modelo. Por ejemplo, puede agregar la siguiente instrucción de salida:
If the information provided is not sufficient to answer the question, state clearly, "Based on the existing information, I cannot answer this question." Do not invent an answer.
Esto reduce la probabilidad de alucinaciones del modelo.
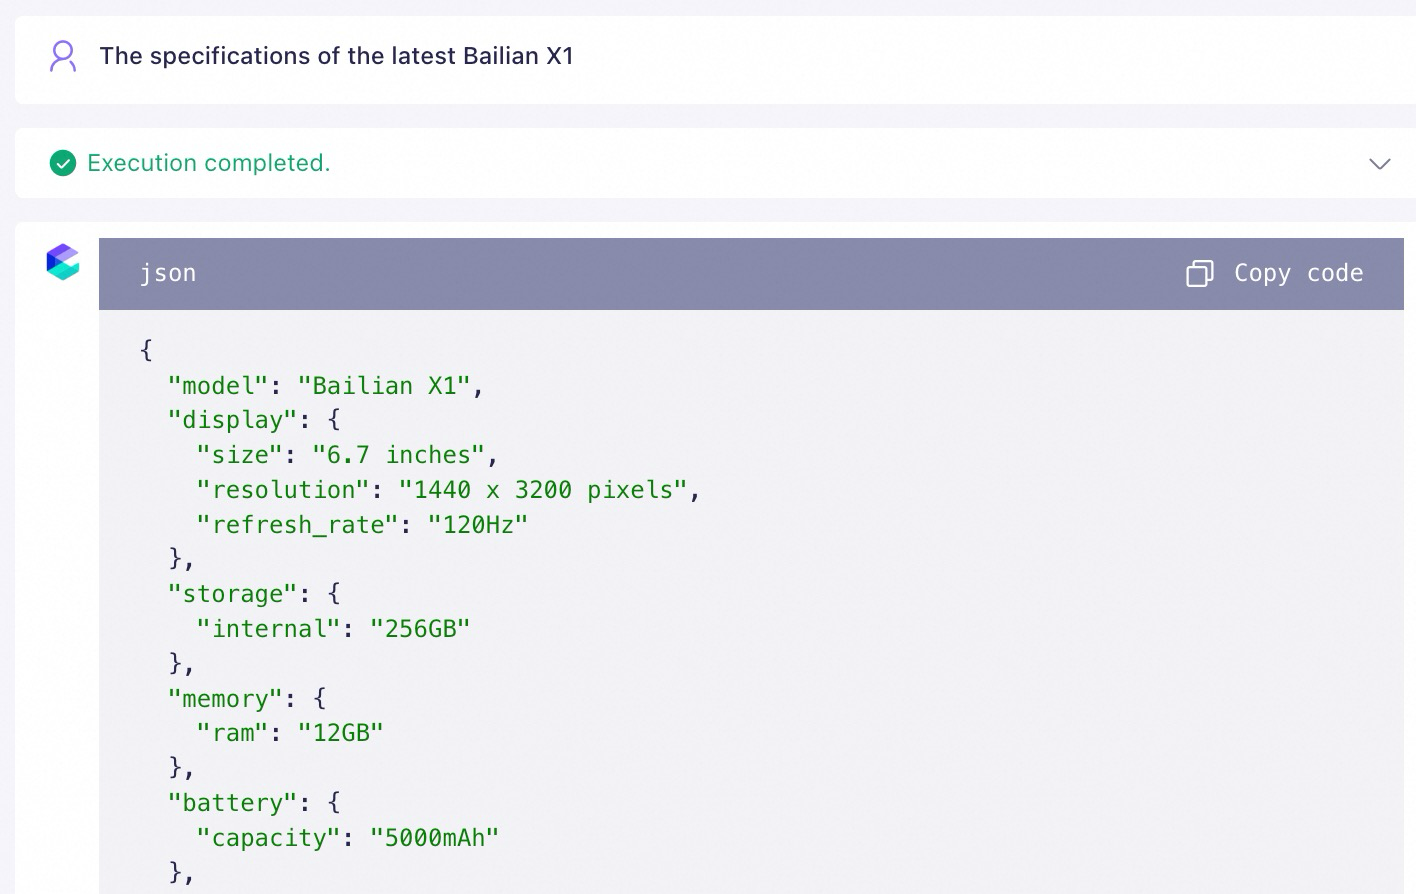
Método 2: Agregar ejemplosUtilice el método de solicitud de pocos ejemplos para agregar ejemplos de preguntas y respuestas a la solicitud para que el modelo los imite. Esto guía al modelo para que utilice correctamente el conocimiento recuperado. El siguiente ejemplo utiliza Qwen-Plus.
| Plantilla de prompt | Resultado |
|---|---|
|  |
| 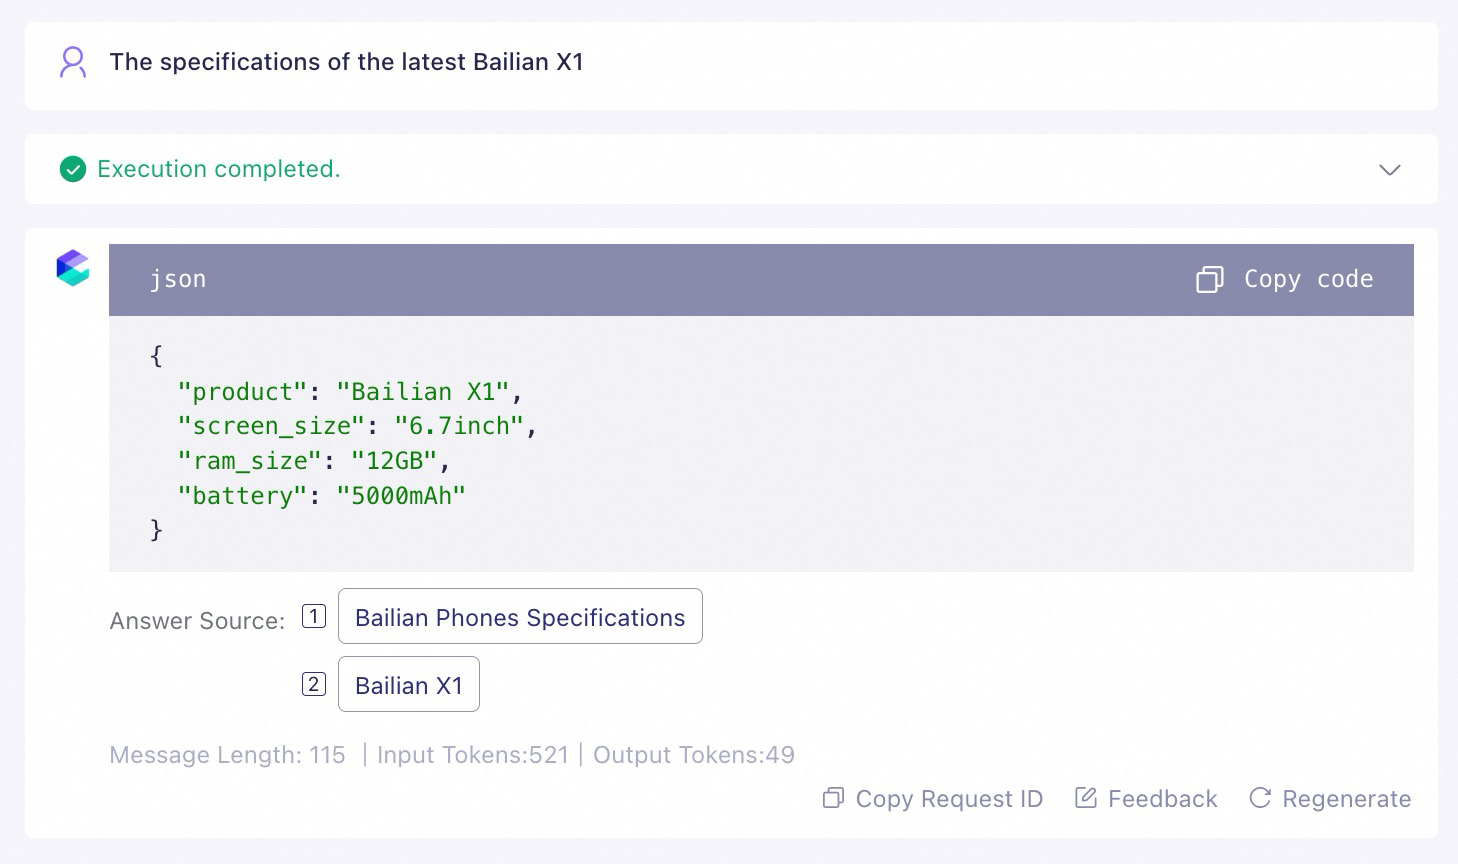 |
Si los fragmentos de texto recuperados se mezclan aleatoriamente en una plantilla de solicitud, resulta difícil para un modelo grande comprender la estructura general de la solicitud. Separe claramente la solicitud de la variable ${documents}.
Además, para garantizar los mejores resultados, asegúrese de que la variable ${documents} aparezca solo una vez en su plantilla de solicitud. Como referencia, consulte el ejemplo correcto a la izquierda abajo.
# Role
You are a customer service representative, focusing on analyzing and solving user problems and providing accurate solutions by retrieving from the knowledge base.

# Requirements
**Return the result directly**: Please provide a direct result based on the user's prompt and the content in the knowledge base, without
inference.
**Do not include specific contact information in the returned result**: The returned result should only include a summary of the user's prompt, the
names of relevant on-duty personnel, and their responsibilities.
**Default contact**: If no relevant on-duty personnel can be found, please return "On-duty representative today: Model Studio Customer Service 01".

# Knowledge base
Please remember the following materials, they may be helpful in answering the question.
${documents}
# Role
You are a customer service representative, focusing on analyzing and solving user problems and providing accurate solutions by retrieving from the knowledge base.
Please use the information in ${documents} to assist in answering.

# Requirements
**Return the result directly**: Please provide a direct result based on the user's prompt and the content in the knowledge base, without
inference.
**Do not include specific contact information in the returned result**: The returned result should only include a summary of the user's prompt, the
names of relevant on-duty personnel, and their responsibilities.
**Default contact**: If no relevant on-duty personnel can be found, please return "On-duty representative today: Model Studio Customer Service 01".

# Knowledge base
Please remember the following materials, they may be helpful in answering the question.
${documents}
Para obtener más información sobre los métodos de optimización de prompts, consulte Ingeniería de prompts.
2.4.3 Rechazo
Si usted want que los resultados devueltos por su aplicación de Model Studio se basen estrictamente en el conocimiento recuperado de la base de conocimientos y excluyan la influencia del conocimiento general propio del modelo, puede establecer el alcance de la respuesta en Solo base de conocimientos al editar la aplicación.
Para los casos en los que no se encuentra conocimiento relevante en la base de conocimiento, también puede configurar una respuesta automática fija.
Alcance de la respuesta: Base de conocimiento + Conocimiento del LLM | Alcance de la respuesta: Solo base de conocimiento |
|
|
El resultado devuelto por la aplicación Model Studio será una combinación de conocimiento recuperado de la base de conocimiento y el conocimiento general propio del modelo. | El resultado devuelto por la aplicación Model Studio se basará estrictamente en el conocimiento recuperado de la base de conocimiento. |


Para determinar el alcance del conocimiento, elija el método Search Threshold + LLM Judgement. Esta estrategia primero filtra los fragmentos de texto potenciales utilizando un umbral de similitud. Luego, un modelo actúa como árbitro, utilizando el Prompt de juicio que usted configuró para realizar un análisis profundo de la relevancia. Esto mejora aún más la precisión del juicio.
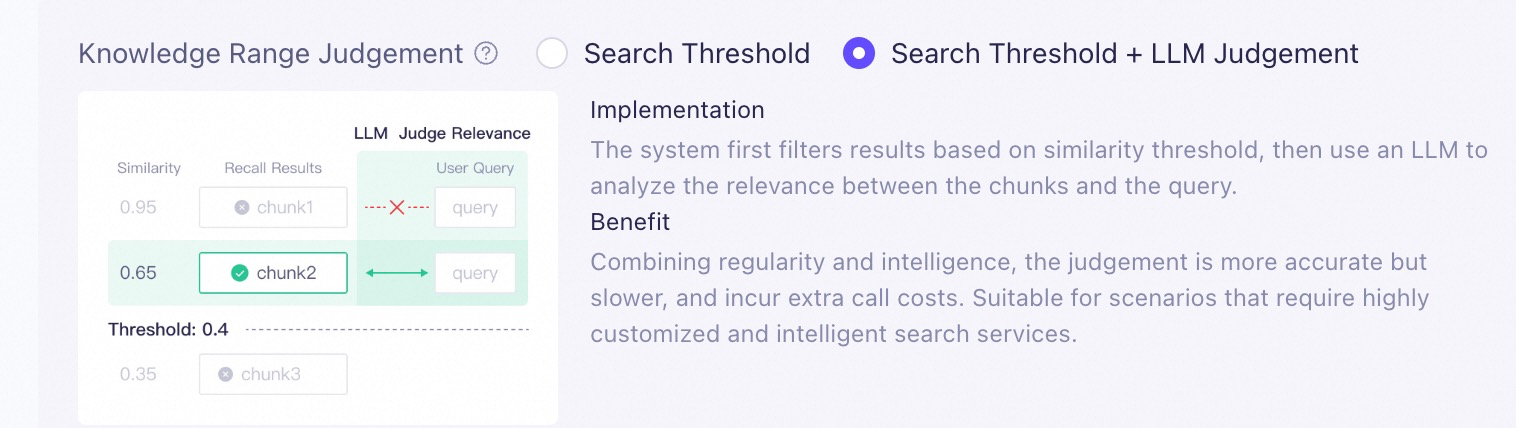
A continuación se presenta un ejemplo de solicitud de determinación para su referencia. Además, cuando no se encuentre conocimiento relevante en la base de conocimientos, establezca una respuesta fija: Sorry, no relevant phone models were found.
# Judgment rules:
- The premise for a match between the question and the document is that the entity involved in the question is exactly the same as the entity described in the document.
- The question is not mentioned at all in the document.
Consulta exitosa | Consulta fallida |
|---|---|
|
|
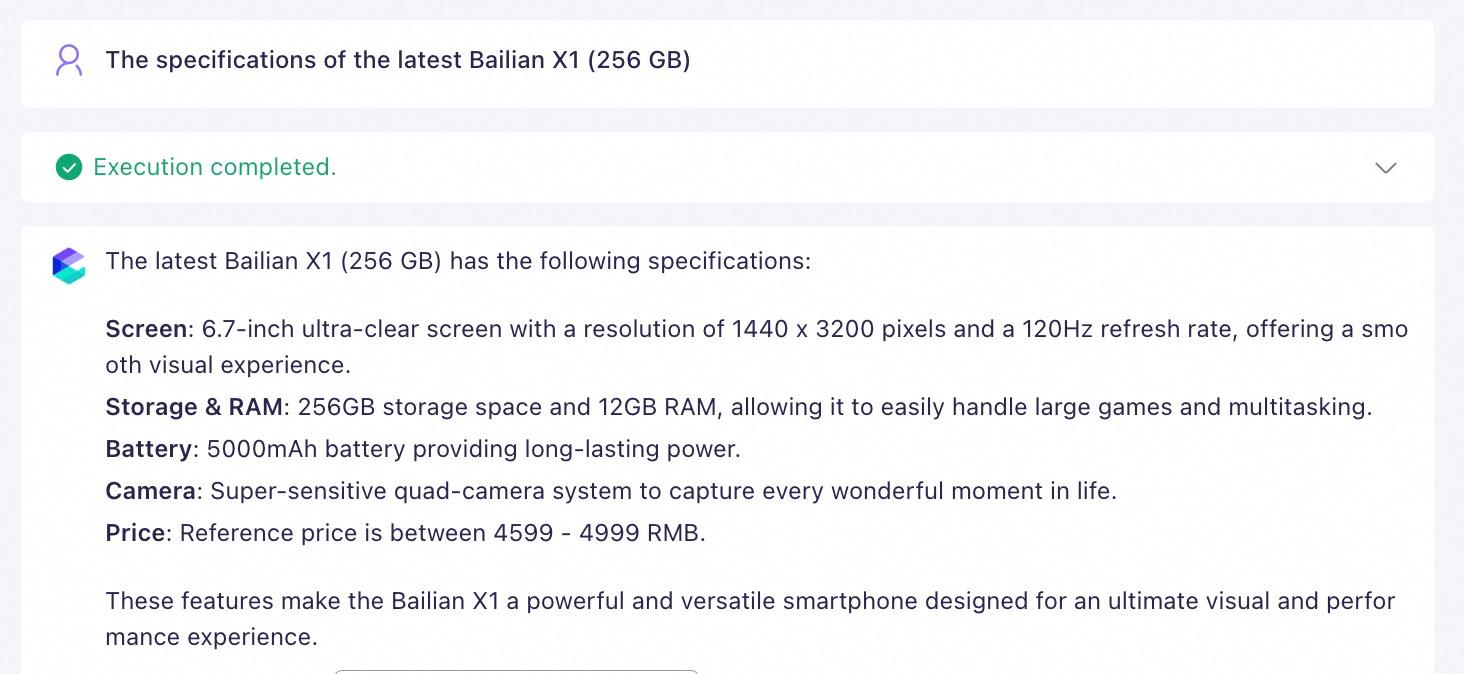
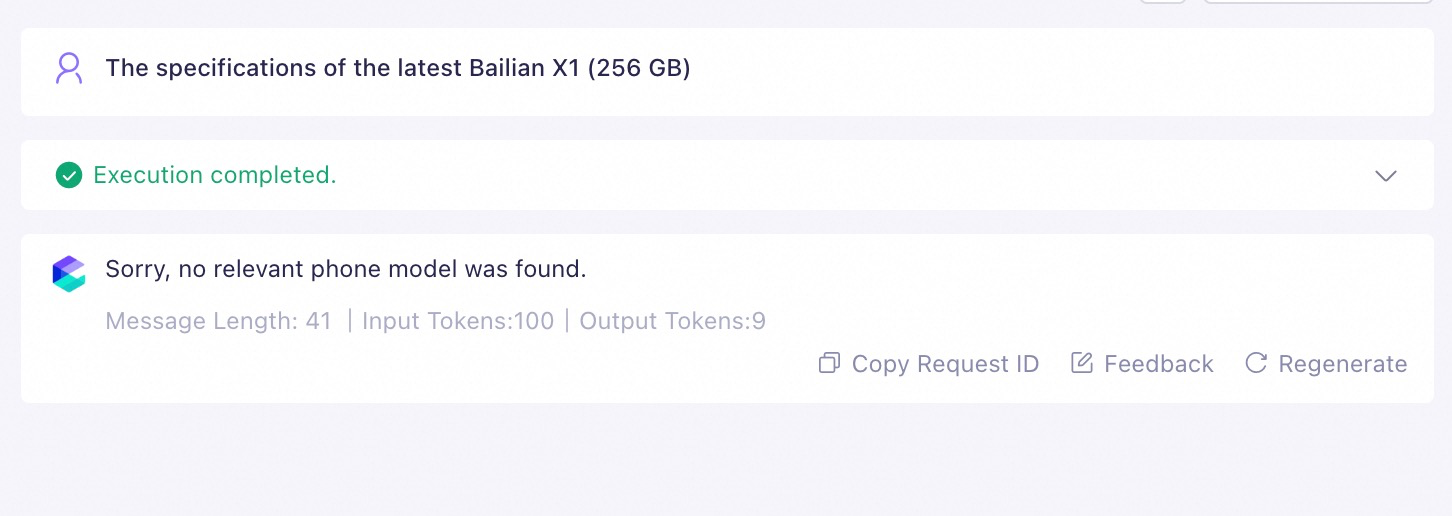
2.4.4 Parámetros del modelo
Para controlar si el modelo proporciona respuestas consistentes o variadas a solicitudes similares, puede modificar Configurar parámetros para ajustar los parámetros del modelo cuando edite la aplicación.
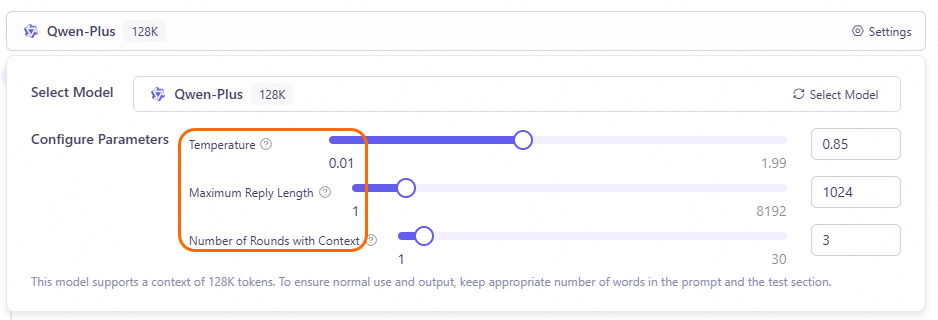
El parámetro temperatura en la figura anterior controla la aleatoriedad del contenido generado por el modelo. Cuanto mayor sea la temperatura, más diverso será el texto generado; por el contrario, el texto será más determinista.
- El texto diverso es adecuado para escritura creativa (como novelas y textos publicitarios), lluvia de ideas y escenarios de aplicaciones de chat.
- El texto determinista es adecuado para escenarios con respuestas claras (como análisis de problemas, preguntas de opción múltiple y búsqueda de hechos) o que requieren una redacción precisa (como documentos técnicos, textos legales, informes noticiosos y artículos académicos).
Los otros dos parámetros son:
Longitud máxima de respuesta: Este parámetro controla el número máximo de tokens generados por el modelo. Puede aumentar este valor para generar descripciones detalladas o disminuirlo para generar respuestas breves.
Número de turnos de contexto: Este parámetro controla el número de turnos de conversación históricos a los que hace referencia el modelo. Cuando se establece en 1, el modelo no consulta la información de conversaciones históricas al responder.
3. Preguntas frecuentes
¿Cómo deben formatearse los documentos para beneficiar a RAG?
Recomendaciones de diseño del contenido del documento
- Utilice niveles de encabezado claros. Asegúrese de que el contenido bajo cada encabezado sea claro y autónomo.
- Evite las marcas de agua.
- Evite anidar niveles de lista bajo un elemento en medio de una lista.
- Evite tablas e imágenes siempre que sea posible, ya que las tablas complejas pueden afectar la calidad del análisis.
El encabezado de Nivel 1 es "IV. Reglas de uso de premios:", y el contenido incluye "Premio 1:..." y "Premio 2:...".
 Problema después del procesamiento
"Premio 2:..." se analiza como un subtítulo de "Premio 1:...". Establezca "Premio 1:..." y "Premio 2:..." como encabezados de Nivel 2 numerados en el documento.
Marcas de agua en un documento: ejemploDocumento originalEl documento contiene una marca de agua e incluye tres elementos en total.
 Problema después del procesamiento
El tercer elemento se divide en un solo fragmento. Sin embargo, debido a que la marca de agua se reconoce como texto, aparecen palabras adicionales como "Government Gazette" después de "(V) Grado 11 tierra de cultivo: CNY 120,000/acre". Debido a que la marca de agua "Government Gazette" aparece temprano en el texto, también puede alterar el orden de los elementos (I) a (V), cambiándolo a (I), (V), (III), (IV), (II).
Listas anidadas bajo un elemento intermedio: ejemploDocumento originalBajo el encabezado de Nivel 1 "Reglas de actividad" hay una lista ordenada. El tercer elemento, "Introducción a la actividad", incluye otra lista (elementos a y b).
 Problema después del procesamiento
Debido a que el tercer elemento contiene una lista anidada, "Introducción a la actividad" puede malinterpretarse como un encabezado de Nivel 2, y todo el contenido subsiguiente se agrupa bajo él. Evite anidar listas. Si es necesario, coloque la lista anidada al final de la lista principal.
Un buen ejemplo- El contenido bajo cada encabezado es claro y relativamente independiente.
- Sin marcas de agua.
- Aparece una lista bajo el encabezado, pero no contiene listas anidadas.
- Sin tablas ni imágenes.