La instrucción CREATE TABLE AS (CTAS) sincroniza datos y cambios de esquema desde una tabla de origen hacia una tabla de destino en tiempo real. Esto simplifica la creación y el mantenimiento de la tabla de destino a medida que evoluciona el esquema de origen. Este tema describe cómo utilizar la instrucción CTAS y proporciona ejemplos prácticos.
Se recomienda utilizar trabajos YAML-based data ingestion para sincronizar datos desde un origen hacia un destino. Los trabajos SQL CTAS/CDAS existentes se pueden convertir a trabajos YAML con un solo clic mediante la función CTAS/CDAS job generation.
Ventajas de la función YAML: Los trabajos YAML abarcan todas las capacidades de CTAS/CDAS, incluida la sincronización completa de bases de datos, la sincronización de tablas únicas, la sincronización de tablas y bases de datos fragmentadas, la sincronización de nuevas tablas, los cambios de esquema y la sincronización de columnas calculadas. También ofrecen funciones adicionales como la sincronización inmediata de cambios de esquema, la sincronización de binlog sin procesar, el filtrado mediante cláusulas WHERE, la eliminación de columnas y las funciones definidas por el usuario (UDF).
Ventajas de rendimiento de YAML: En comparación con los trabajos SQL, los trabajos YAML utilizan un solo operador de origen para leer desde varias tablas y un solo operador de destino para escribir en varias tablas de forma predeterminada. Este enfoque reduce la sobrecarga de recursos.
Para consultar más ejemplos, consulte Flink CDC data ingestion best practices.
Funciones clave
Sincronización de datos
|
Función |
Descripción |
|
Sincronización de tabla única |
Sincroniza datos completos e incrementales desde una tabla de origen hacia una tabla de destino en tiempo real. (Consulte Example: Single-table synchronization). |
|
Fusionar y sincronizar tablas y bases de datos fragmentadas |
Coincide con múltiples tablas y bases de datos fragmentadas mediante una expresión regular para definir sus nombres. Posteriormente, los datos coincidentes se fusionan y sincronizan en una sola tabla de destino. (Consulte Example: Merge and synchronize sharded tables and databases). Nota
El carácter de intercalación ( |
|
Sincronizar columnas calculadas |
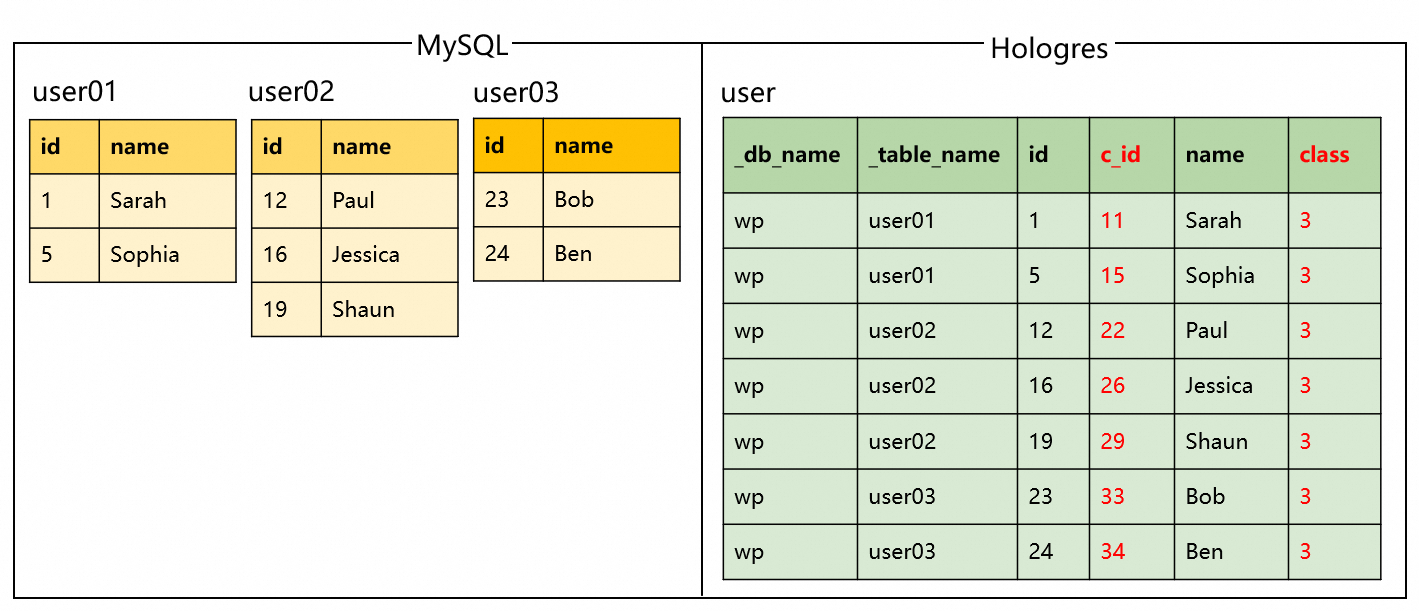
Define columnas calculadas para realizar transformaciones en los datos de la tabla de origen. Las columnas calculadas pueden usar funciones integradas o personalizadas, y se pueden especificar sus posiciones. Estas nuevas columnas se crean como columnas físicas en la tabla de destino y sus resultados se sincronizan en tiempo real. (Consulte Example: Synchronize computed columns). |
|
Múltiples instrucciones CTAS |
|
Sincronización de cambios de esquema
Mientras sincroniza datos en tiempo real, la instrucción CTAS también replica los cambios de esquema desde la tabla de origen hacia la tabla de destino. Los cambios de esquema incluyen la creación inicial de la tabla y cualquier modificación posterior.
-
Cambios de esquema compatibles
Cambio de esquema
Descripción
Agregar una columna que acepta valores NULL
La columna correspondiente se agrega automáticamente al final del esquema de la tabla de destino y sus datos se sincronizan. La nueva columna acepta valores NULL de forma predeterminada y su valor para las filas preexistentes se establece en NULL.
Agregar una columna que no acepta valores NULL
La columna correspondiente se agrega automáticamente al final del esquema de la tabla de destino y sus datos se sincronizan.
Eliminar una columna que acepta valores NULL
La columna no se elimina de la tabla de destino. En su lugar, sus datos se establecen automáticamente en NULL.
Cambiar el nombre de una columna
Esto se trata como agregar una nueva columna y eliminar la anterior. La columna renombrada se agrega al final del esquema de la tabla de destino y los datos de la columna original se establecen automáticamente en NULL.
NotaPor ejemplo, si se cambia el nombre de
col_aacol_b,col_bse agrega al final de la tabla de destino y los datos decol_ase establecen en NULL.Cambiar el tipo de datos de una columna
-
Si el sistema de destino admite cambios de tipo de datos: Actualmente, solo Paimon admite el manejo de cambios de tipo de datos. CTAS admite cambios de tipo para columnas estándar, como de INT a BIGINT.
Los cambios de tipo admitidos dependen de las reglas del destino. Consulte la documentación del conector de destino específico para obtener más detalles.
-
Si el sistema de destino no admite cambios de tipo de datos: Actualmente, solo Hologres admite el modo de normalización de tipos para manejar cambios de tipo de datos. En este modo, un trabajo CTAS crea una tabla descendente con tipos de datos más amplios. Este enfoque aprovecha la compatibilidad del destino con los cambios de tipo de datos. Para obtener más detalles, consulte Example: Synchronize data in type normalization mode.
ImportanteDebe habilitar el modo de normalización de tipos cuando se inicie el trabajo CTAS por primera vez. De lo contrario, deberá eliminar la tabla de destino y realizar un reinicio sin estado para que este modo surta efecto.
ImportanteCTAS detecta cambios de esquema comparando los esquemas de registros consecutivos en lugar de identificar la operación DDL específica.
Si se elimina una columna y luego se vuelve a agregar sin cambios de datos intermedios, CTAS no detecta un cambio de esquema.
CTAS detecta un cambio de esquema solo después de agregar una nueva columna y producirse cambios en los datos. Luego sincroniza el cambio de esquema con la tabla de destino.
-
-
Cambios de esquema no compatibles
Cambios en restricciones, como una clave primaria o un índice.
Eliminación de columnas que no aceptan valores NULL.
Cambio de una columna de NOT NULL a NULLABLE.
ImportanteSi ocurre un cambio de esquema no compatible, debe eliminar manualmente la tabla de destino y reiniciar el trabajo CTAS. Esto recrea la tabla de destino y resincroniza los datos históricos.
Proceso de inicio
El siguiente ejemplo muestra el proceso de sincronización de datos desde MySQL hacia Hologres mediante CTAS.
|
Diagrama de flujo |
Proceso de inicio |
 |
La ejecución de una instrucción CTAS desencadena el siguiente proceso:
|
Requisitos previos
Antes de ejecutar una instrucción CTAS, asegúrese de haber registrado un catálogo de destino en su espacio de trabajo. Para obtener más información, consulte Data Management.
Limitaciones
Limitaciones de sintaxis
La función de depuración no es compatible.
No puede utilizar instrucciones
INSERT INTOen el mismo trabajo.No se admite la sincronización con tablas particionadas de StarRocks.
-
No se admiten configuraciones de MiniBatch.
ImportanteAntes de crear un trabajo SQL: En la página Configurations, asegúrese de eliminar cualquier configuración de MiniBatch de la sección Other Configuration en la pestaña Deployment Defaults.
Después de crear un trabajo SQL: Para obtener una solución, consulte Error: Currently does not support merge StreamExecMiniBatchAssigner type ExecNode in CTAS/CDAS syntax.
Compatibilidad de origen y destino
La siguiente tabla enumera los conectores de origen y destino compatibles con CTAS.
|
Conector |
Tabla de origen |
Tabla de destino |
Notas |
|
√ |
× |
|
|
|
√ |
× |
Ninguna. |
|
|
√ |
× |
|
|
|
× |
√ |
Ninguna. |
|
|
× |
√ |
Solo se admite StarRocks en EMR. |
|
|
× |
√ |
Si el destino es Hologres, CTAS crea una cantidad de conexiones para cada tabla según el parámetro Nota
Al sincronizar datos con Hologres, si su tabla de origen contiene tipos de datos no admitidos por Fixed Plan, se recomienda utilizar un INSERT INTO statement para realizar la conversión de tipos dentro de Flink antes de sincronizar los datos. No utilice CTAS para crear la tabla de destino, ya que este método no puede usar Fixed Plan y resulta en un bajo rendimiento de escritura. |
|
|
× |
√ |
Solo VVR 11.1 o posterior del motor Realtime Compute for Apache Flink admite la sincronización de datos con una tabla de destino Paimon DLF 2.5. |
Sintaxis
CREATE TABLE IF NOT EXISTS <sink_table>
(
  [ <table_constraint> ]
)
[COMMENT table_comment]
[PARTITIONED BY (partition_column_name1, partition_column_name2, ...)]
WITH (
  key1=val1,
  key2=val2,
  ...
 )
AS TABLE <source_table> [/*+ OPTIONS(key1=val1, key2=val2, ... ) */]
[ADD COLUMN { <column_component> | (<column_component> [, ...])}];

<sink_table>:
  [catalog_name.][db_name.]table_name

<table_constraint>:
  [CONSTRAINT constraint_name] PRIMARY KEY (column_name, ...) NOT ENFORCED

<source_table>:
  [catalog_name.][db_name.]table_name

<column_component>:
  column_name AS computed_column_expression [COMMENT column_comment] [FIRST | AFTER column_name]
La sintaxis de CTAS se basa en la instrucción CREATE TABLE. La siguiente tabla describe sus parámetros.
|
Parámetro |
Descripción |
|
|
El nombre de la tabla de destino para la sincronización de datos. Puede especificar los nombres del catálogo y de la base de datos. |
|
|
La descripción para la tabla de destino. De forma predeterminada, se utiliza la descripción de |
|
|
Crea una tabla particionada basada en una o más columnas. Importante
No se admite la sincronización con tablas particionadas de StarRocks. |
|
|
Define la restricción de clave primaria para la tabla, lo cual garantiza la unicidad de los datos. |
|
|
Opciones de la tabla de destino. Puede introducir cualquier parámetro Nota
Tanto la clave como el valor deben ser cadenas. Por ejemplo, |
|
|
El nombre de la tabla de origen para la sincronización de datos. Puede especificar los nombres del catálogo y de la base de datos. |
|
|
Opciones de la tabla de origen. Puede introducir cualquier parámetro Nota
Tanto la clave como el valor deben ser de tipo cadena, por ejemplo, 'server-id' = '65500'. |
|
|
Define columnas nuevas o renombradas para la tabla de destino en relación con la tabla de origen. Admite alias de columnas y columnas calculadas. Importante
Un mapeo de campos puro, como |
|
|
La definición de una nueva columna. |
|
|
La expresión utilizada para calcular una columna. |
|
|
Coloca la nueva columna como el primer campo en el esquema lógico de la tabla. Si no se especifica este parámetro, la nueva columna se agrega al final del esquema lógico de forma predeterminada. |
|
|
Coloca la nueva columna después de una columna existente especificada. |
La palabra clave
IF NOT EXISTSes obligatoria. Si la tabla de destino no existe en el almacenamiento de destino, se creará primero. De lo contrario, se omite el paso de creación.El esquema de la tabla de destino hereda el esquema de la tabla de origen, incluida la clave primaria y los nombres y tipos de las columnas físicas. No incluye columnas calculadas, columnas de metadatos ni marcas de agua.
Los tipos de datos de las columnas se convierten mediante mapeo de tipos desde la tabla de origen hacia la tabla de destino. Para obtener más información, consulte la sección de mapeo de tipos en la documentación del conector correspondiente.
Ejemplos de código
Sincronización de tabla única
Escenario: Sincronizar la tabla web_sales desde MySQL hacia Hologres.
Requisitos previos: Ha registrado los siguientes catálogos en su espacio de trabajo.
Un catálogo de Hologres llamado holo.
Un catálogo de MySQL llamado mysql.
Ejemplo de código:
CTAS se utiliza normalmente con catálogos tanto para el origen de datos como para el destino. Un catálogo de origen analiza automáticamente el esquema y las opciones de la tabla de origen, lo que elimina la necesidad de DDL manual y permite la sincronización de datos completos e incrementales desde la tabla de origen hacia la tabla de destino.
USE CATALOG holo;

CREATE TABLE IF NOT EXISTS web_sales   -- If no database is specified, the table is synchronized to the web_sales table in the default database.
WITH ('jdbcWriteBatchSize' = '1024')   -- Optional: Specifies parameters for the sink table.
AS TABLE mysql.tpcds.web_sales
/*+ OPTIONS('server-id'='8001-8004') */;  -- Specifies additional parameters for the mysql-cdc source table.
Fusionar tablas y bases de datos fragmentadas
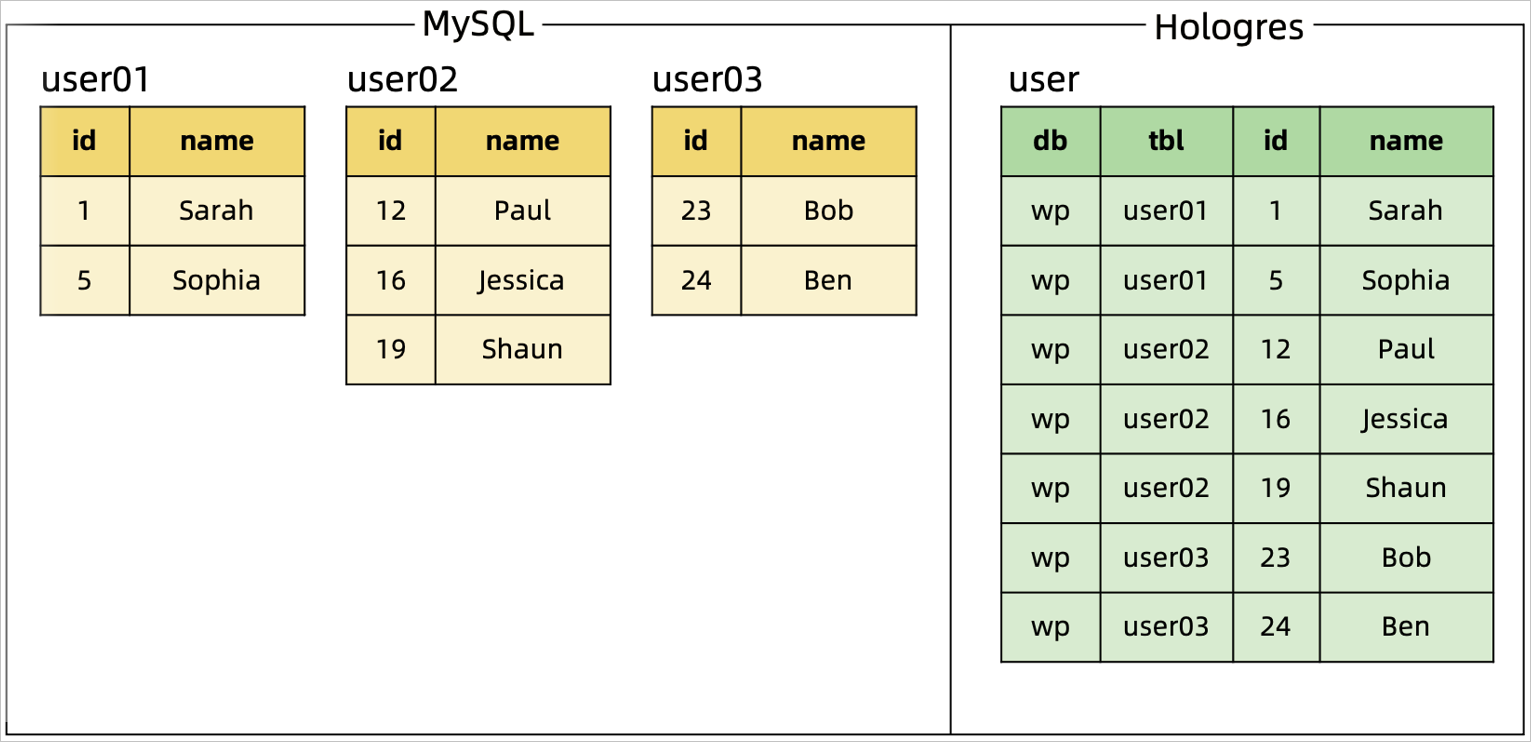
Escenario: Utilizar CTAS para fusionar múltiples tablas fragmentadas de MySQL en una sola tabla de Hologres.
Solución: En combinación con un catálogo de MySQL, utilice una expresión regular para hacer coincidir los nombres de bases de datos y tablas que desea sincronizar. Los nombres de bases de datos y tablas se escriben como dos columnas adicionales en la tabla de destino. Para garantizar la unicidad de la clave primaria, el nombre de la base de datos, el nombre de la tabla y la clave primaria original se combinan para formar una nueva clave primaria compuesta para la tabla de Hologres.
Ejemplo de código y resultado de la fusión:
|
Ejemplo de código |
Resultado de la fusión |
|
Escenario de fusión y sincronización de tablas fragmentadas: |
|
|
Escenario de cambio de esquema en tabla de origen: Se agrega una columna age a la tabla user02 y se inserta un registro. Aunque los esquemas de las tablas fragmentadas son inconsistentes, los cambios posteriores de datos y esquema en la tabla user02 se sincronizan automáticamente con la tabla descendente en tiempo real. |
|

Sincronizar columnas calculadas
Escenario: Agregar columnas calculadas personalizadas a una tabla de Hologres durante el proceso de fusión y sincronización de tablas fragmentadas de MySQL.
Ejemplo de código y resultado de la fusión:
|
Ejemplo de código |
Resultado de la fusión |
|
|
Múltiples instrucciones CTAS como un solo trabajo
Escenario: Sincronizar la tabla web_sales de MySQL y las tablas fragmentadas de usuario con Hologres como un solo trabajo.
Solución: Utilice la sintaxis STATEMENT SET para enviar múltiples instrucciones CTAS como un solo trabajo. Este enfoque permite reutilizar un solo nodo de origen para leer datos de múltiples tablas de negocio, lo que reduce la cantidad de ID de servidor, conexiones de base de datos y la carga de lectura en el origen MySQL CDC.
El origen solo se puede reutilizar si las
OPTIONSpara las tablas de origen son idénticas.Para obtener información sobre cómo configurar el ID de servidor en el conector de MySQL, consulte Set the server ID to avoid binlog consumption conflicts.
Ejemplo de código:
USE CATALOG holo;

BEGIN STATEMENT SET;

-- Synchronize the web_sales table.
CREATE TABLE IF NOT EXISTS web_sales
AS TABLE mysql.tpcds.web_sales
/*+ OPTIONS('server-id'='8001-8004') */;

-- Synchronize the sharded user tables.
CREATE TABLE IF NOT EXISTS user
AS TABLE mysql.`wp.*`.`user[0-9]+`
/*+ OPTIONS('server-id'='8001-8004') */;

END;
Sincronizar un origen con múltiples tablas de destino
-
Si las tablas de destino no requieren columnas calculadas
USE CATALOG `holo`; BEGIN STATEMENT SET; -- Use a CTAS statement to synchronize the MySQL user table to the user table in the database1 of the Hologres data warehouse. CREATE TABLE IF NOT EXISTS `database1`.`user` AS TABLE `mysql`.`tpcds`.`user` /*+ OPTIONS('server-id'='8001-8004') */; -- Use a CTAS statement to synchronize the MySQL user table to the user table in the database2 of the Hologres data warehouse. CREATE TABLE IF NOT EXISTS `database2`.`user` AS TABLE `mysql`.`tpcds`.`user` /*+ OPTIONS('server-id'='8001-8004') */; END; -
Si las tablas de destino requieren columnas calculadas
-- Create a temporary table user_with_changed_id based on the source table user. It supports defining computed columns, such as computed_id, which is calculated based on the id from the source table.
CREATE TEMPORARY TABLE `user_with_changed_id` (
  `computed_id` AS `id` + 1000
) LIKE `mysql`.`tpcds`.`user`;

-- Create a temporary table user_with_changed_age based on the source table user. It supports defining computed columns, such as computed_age, which is calculated based on the age from the source table.
CREATE TEMPORARY TABLE `user_with_changed_age` (
  `computed_age` AS `age` + 1
) LIKE `mysql`.`tpcds`.`user`;

BEGIN STATEMENT SET;

-- Use a CTAS statement to synchronize the MySQL user table to the user_with_changed_id table in the Hologres data warehouse. The table will contain the computed ID in the computed_id column.
CREATE TABLE IF NOT EXISTS `holo`.`tpcds`.`user_with_changed_id`
AS TABLE `user_with_changed_id`
/*+ OPTIONS('server-id'='8001-8004') */;

-- Use a CTAS statement to synchronize the MySQL user table to the user_with_changed_age table in the Hologres data warehouse. The table will contain the computed age in the computed_age column.
CREATE TABLE IF NOT EXISTS `holo`.`tpcds`.`user_with_changed_age`
AS TABLE `user_with_changed_age`
/*+ OPTIONS('server-id'='8001-8004') */;

END;
Sincronizar una nueva tabla
Escenario: Después de iniciar un trabajo con múltiples instrucciones CTAS, necesita agregar una nueva instrucción CTAS para sincronizar datos de una tabla recién añadida.
Solución: Habilite la función de detección de nuevas tablas en el trabajo SQL, agregue la nueva instrucción CTAS y luego reinicie el trabajo desde un punto de guardado. Una vez capturada la nueva tabla, sus datos se sincronizarán.
Limitaciones:
La función de detección de nuevas tablas es compatible con VVR 8.0.1 y versiones posteriores.
Al sincronizar desde una tabla de origen CDC, la función de detección de nuevas tablas solo es compatible con trabajos cuyo modo de inicio de tabla de origen esté configurado como initial.
La configuración de la nueva tabla de origen en la instrucción CTAS agregada debe ser idéntica a las configuraciones de tablas de origen existentes para garantizar que se pueda reutilizar el origen.
Los parámetros de configuración del trabajo, como el modo de inicio, no se pueden modificar antes ni después de agregar la nueva instrucción CTAS.
Procedimiento:
Cuando necesite agregar una nueva instrucción CTAS, vaya a la página Deployments, detenga el trabajo y seleccione Stop With Savepoint.
-
En el trabajo SQL, habilite la detección de nuevas tablas, agregue la nueva instrucción CTAS y luego vuelva a Deploy el trabajo.
-
Agregue la siguiente instrucción al trabajo SQL para habilitar la detección de nuevas tablas.
SET 'table.cdas.scan.newly-added-table.enabled' = 'true'; -
Agregue la nueva instrucción CTAS al trabajo SQL. El código completo final es el siguiente.
-- Enable new table detection.
SET 'table.cdas.scan.newly-added-table.enabled' = 'true';

USE CATALOG holo;

BEGIN STATEMENT SET;

-- Synchronize the web_sales table.
CREATE TABLE IF NOT EXISTS web_sales
AS TABLE mysql.tpcds.web_sales
/*+ OPTIONS('server-id'='8001-8004') */;

-- Synchronize the sharded user tables.
CREATE TABLE IF NOT EXISTS user
AS TABLE mysql.`wp.*`.`user[0-9]+`
/*+ OPTIONS('server-id'='8001-8004') */;

-- Synchronize the product table. (New table)
CREATE TABLE IF NOT EXISTS product
AS TABLE mysql.tpcds.product
/*+ OPTIONS('server-id'='8001-8004') */;

END;
Haga clic en Deploy.
-
-
Restaure el trabajo desde el punto de guardado.
En la página Deployments, haga clic en el nombre del trabajo objetivo, vaya a la pestaña State y haga clic en History.
En la lista Savepoints, busque el punto de guardado creado cuando se detuvo el trabajo.
En la columna Actions del punto de guardado objetivo, seleccione para iniciar el trabajo. Para obtener más información, consulte Start a job.
Sincronizar con una tabla particionada de Hologres
Escenario: Utilizar una instrucción CTAS para sincronizar una tabla de origen MySQL con una tabla particionada de Hologres.
Regla de partición de Hologres: En Hologres, si se define una clave primaria para la tabla de destino, las columnas de partición deben incluirse en la clave primaria.
Ejemplo de código:
La instrucción DDL para la tabla de origen MySQL es la siguiente:
CREATE TABLE orders (
    order_id INTEGER NOT NULL,
    product_id INTEGER NOT NULL,
    city VARCHAR(100) NOT NULL
    order_date DATE,
    purchaser INTEGER,
    PRIMARY KEY(order_id, product_id)
);
El enfoque difiere dependiendo de si la clave primaria de la tabla de origen incluye la clave de partición.
-
Si la clave primaria de origen incluye la columna de partición, puede sincronizar directamente con una instrucción CTAS.
Hologres verifica automáticamente que la columna de partición sea parte de la clave primaria.
CREATE TABLE IF NOT EXISTS `holo`.`tpcds`.`orders` PARTITIONED BY (product_id) AS TABLE `mysql`.`tpcds`.`orders`; -
Si la clave primaria de origen no incluye la columna de partición, vuelva a declarar la clave primaria de la tabla de destino en la instrucción CTAS.
Si una columna de partición (por ejemplo,
city) no forma parte de la clave primaria de la tabla de origen, el trabajo falla. Debe volver a declarar la clave primaria de la tabla de destino en la instrucción CTAS para garantizar que la columna de partición forme parte de la clave primaria.-- You can use the following SQL to specify the primary key of the Hologres partitioned table as order_id, product_id, and city. CREATE TABLE IF NOT EXISTS `holo`.`tpcds`.`orders`( CONSTRAINT `PK_order_id_city` PRIMARY KEY (`order_id`,`product_id`,`city`) NOT ENFORCED ) PARTITIONED BY (city) AS TABLE `mysql`.`tpcds`.`orders`;
Sincronizar datos en modo de normalización de tipos
Escenario: Al utilizar una sentencia CTAS para sincronizar datos hacia una tabla de Hologres, es necesario admitir escenarios que requieren ajustar la precisión de los tipos de datos existentes (por ejemplo, de VARCHAR(10) a VARCHAR(20)) o cambiar el tipo de dato (por ejemplo, de SMALLINT a INT).
Solución: Utilice el modo de normalización de tipos de Hologres para sincronizar los datos. Este modo debe habilitarse cuando se inicie el trabajo CTAS por primera vez. Si no se habilita al inicio, deberá eliminar la tabla destino y reiniciar el trabajo sin estado para que el cambio surta efecto.
Reglas de normalización de tipos:
Si se modifica un tipo de dato en el origen y tanto el tipo nuevo como el original se normalizan al mismo tipo destino, el trabajo se ejecuta con normalidad. En caso contrario, el cambio se considera incompatible y el trabajo CTAS genera una excepción. Las reglas específicas son las siguientes:
TINYINT,SMALLINT,INTyBIGINTse normalizan aBIGINT.CHAR,VARCHARySTRINGse normalizan aSTRING.FLOATyDOUBLEse normalizan aDOUBLE.Los demás tipos de datos se crean según las reglas de mapeo de tipos originales. Para obtener más información, consulte Type mapping.
Ejemplo de código:
CREATE TABLE IF NOT EXISTS `holo`.`tpcds`.`orders`
WITH (
'connector' = 'hologres',
'enableTypeNormalization' = 'true' -- Enable type normalization mode.
) AS TABLE `mysql`.`tpcds`.`orders`;
Sincronizar MongoDB con Hologres
Limitaciones:
Se requiere Realtime Compute for Apache Flink VVR 8.0.6 o posterior y MongoDB 6.0 o posterior.
En SQL Hints, establezca scan.incremental.snapshot.enabled y scan.full-changelog en true.
La función de imágenes previas y posteriores debe estar habilitada en la base de datos de MongoDB. Para obtener información sobre cómo habilitarla, consulte Document Preimages.
-
La sincronización de varias colecciones de MongoDB en un solo trabajo tiene los siguientes requisitos:
La configuración de MongoDB debe ser idéntica para cada tabla, incluidos
hosts,scheme,username,passwordyconnectionOptions.La configuración de
scan.startup.modedebe ser idéntica para cada tabla.
Ejemplo de código:
BEGIN STATEMENT SET;

CREATE TABLE IF NOT EXISTS `holo`.`database`.`table1`
AS TABLE `mongodb`.`database`.`collection1`
/*+ OPTIONS('scan.incremental.snapshot.enabled'='true','scan.full-changelog'='true') */;

CREATE TABLE IF NOT EXISTS `holo`.`database`.`table2`
AS TABLE `mongodb`.`database`.`collection2`
/*+ OPTIONS('scan.incremental.snapshot.enabled'='true','scan.full-changelog'='true') */;

END;
Preguntas frecuentes
Operación del trabajo
Problema de tiempo de espera: Error: akka.pattern.AskTimeoutException
Rendimiento del trabajo
How can I resolve low efficiency and backpressure during the full table read phase?
How do I investigate unstable data consumption from an upstream source?
Sincronización de datos
Documentos relacionados
-
CTAS utiliza catálogos para gestionar metadatos persistentes de tablas, lo que permite superar limitaciones como la imposibilidad de persistir esquemas y acceder a tablas entre distintos trabajos. Para consultar el uso común de catálogos, revise:
-
Casos de uso y escenarios prácticos para CTAS y CDAS:
Sincronización de una base de datos completa, fusión de bases de datos o sincronización de tablas recién agregadas en una base de datos de origen: CREATE DATABASE AS (CDAS) statement.
Sincronización de una base de datos MySQL completa con Kafka para reducir la carga de la base de datos generada por múltiples trabajos: Synchronize a MySQL database to Kafka with Flink CDC.
Tutoriales sobre la implementación de sincronización de datos mediante CTAS y CDAS: Real-time database ingestion, Build a Hologres real-time data warehouse o Paimon and StarRocks streaming lakehouse.
-
Implementación de sincronización de datos mediante trabajos YAML:
Inicio rápido: Flink CDC data ingestion jobs.
Conversión de un trabajo CTAS a un trabajo YAML: Create Flink CDC data ingestion jobs.