Este tema aborda los problemas comunes de rendimiento en trabajos.
How do I resolve low efficiency and backpressure during full-table read?
What do the color indicators in Status Durations for vertex subtasks mean in the job overview?
What is the RMI TCP Connection thread, and why does it use so much more CPU than other threads?
How do I optimize Flink SQL jobs experiencing backpressure due to data hotspots?
How do I troubleshoot unstable upstream data consumption rates?
¿Cómo divido los nodos de operador?
En la página , haga clic en el nombre del trabajo deseado. En la pestaña Deployment Details, dentro de la sección Runtime Parameter Settings, agregue el siguiente código en Other Settings y guárdelo para aplicar los cambios.
pipeline. operator-chaining: 'false'¿Cuáles son las técnicas de optimización de Group Aggregate?
-
Habilite MiniBatch (mejora el throughput)
MiniBatch almacena en búfer los datos entrantes antes de desencadenar el procesamiento. Esto reduce la frecuencia de acceso a State, aumenta el throughput y disminuye el volumen de salida.
MiniBatch activa el procesamiento por micro-lotes según los mensajes de evento insertados en el origen con el intervalo que usted especifique.
-
Escenarios
El procesamiento por micro-lotes intercambia una latencia ligeramente mayor por un throughput significativamente más alto. No lo habilite si requiere una latencia ultrabaja. Para la mayoría de los escenarios de agregación, habilitar MiniBatch mejora considerablemente el rendimiento del sistema.
-
Cómo habilitarlo
MiniBatch está deshabilitado de forma predeterminada. Para habilitarlo, vaya a la pestaña Deployment Details del trabajo objetivo y, en la sección Runtime Parameter Settings dentro de Other Settings, agregue el siguiente código.
table. exec. mini-batch. enabled: true
table. exec. mini-batch. allow-latency: 5s
Los parámetros se explican en la siguiente tabla.
Parámetro
Descripción
table. exec. mini-batch. enabled
Indica si se habilita mini-batch.
table. exec. mini-batch. allow-latency
Intervalo de tiempo entre las salidas de lotes.
-
-
Habilite LocalGlobal (resuelve problemas comunes de puntos críticos de datos)
El mecanismo LocalGlobal utiliza LocalAgg para preagregar datos sesgados, lo que reduce la presión de puntos críticos sobre GlobalAgg y mejora el rendimiento general.
LocalGlobal divide una sola agregación en dos fases: Local y Global, similar a las fases Combine y Reduce en MapReduce. En la primera fase, los nodos anteriores almacenan y agregan datos localmente (localAgg), y emiten acumuladores incrementales. En la segunda fase, estos acumuladores se combinan (Merge) para producir el resultado final (GlobalAgg).
-
Escenarios
Mejora el rendimiento de agregaciones estándar (como SUM, COUNT, MAX, MIN y AVG) y resuelve problemas de puntos críticos de datos en estos escenarios.
-
Límites
LocalGlobal está habilitado de forma predeterminada, pero tiene las siguientes limitaciones:
Debe habilitarse MiniBatch.
Su AggregateFunction debe implementar Merge.
-
Compruebe que el cambio surta efecto
Verifique si la topología generada contiene nodos llamados GlobalGroupAggregate o LocalGroupAggregate.
-
-
Habilite PartialFinal (resuelve problemas de puntos críticos de COUNT DISTINCT)
Para abordar los puntos críticos de COUNT DISTINCT, tradicionalmente era necesario reescribir manualmente las consultas en una agregación de dos fases (agregando una capa de redistribución basada en módulo). Realtime Compute for Apache Flink ahora proporciona redistribución automática de COUNT DISTINCT mediante la optimización PartialFinal, sin necesidad de reescritura manual.
LocalGlobal funciona bien para agregaciones estándar, pero ofrece pocos beneficios para COUNT DISTINCT. Durante la agregación local, las tasas de deduplicación de claves distintas permanecen bajas, por lo que los puntos críticos persisten en el nodo global.
-
Escenarios
Utilícelo cuando COUNT DISTINCT no cumpla con los requisitos de rendimiento del nodo de agregación.
ImportanteNo utilice la optimización PartialFinal en Flink SQL que incluya UDAF.
Evite PartialFinal cuando el volumen de datos sea pequeño, ya que introduce redistribuciones de red innecesarias y desperdicia recursos.
-
Cómo habilitarlo
Esta función está deshabilitada de forma predeterminada. Para habilitarla, en la pestaña Deployment Details del trabajo objetivo, dentro de la sección Runtime Parameter Settings, introduzca el siguiente código en el campo Other Configurations.
table. optimizer. distinct-agg. split. enabled: true -
Compruebe que los cambios sean efectivos.
Verifique si la topología generada cambia de una sola fase de agregación a dos fases.
-
-
Reescriba AGG WITH CASE WHEN como sintaxis AGG WITH FILTER (mejora el rendimiento en escenarios con varios COUNT DISTINCT)
Si su trabajo calcula UV en varias dimensiones (como UV total, UV de cliente móvil y UV de PC), utilice la sintaxis estándar AGG WITH FILTER en lugar de CASE WHEN. El optimizador de SQL de Realtime Compute reconoce los parámetros Filter, lo que permite que varias operaciones COUNT DISTINCT sobre el mismo campo compartan State y reduzcan la E/S de State. Las pruebas de rendimiento muestran que esta reescritura puede duplicar el rendimiento.
-
Escenarios
Se obtienen mejoras significativas de rendimiento al calcular varios resultados COUNT DISTINCT sobre el mismo campo bajo diferentes condiciones.
-
Texto original
COUNT(distinct visitor_id) as UV1, COUNT(distinct case when is_wireless='y' then visitor_id else null end) as UV2 -
Sintaxis optimizada
COUNT(distinct visitor_id) as UV1, COUNT(distinct visitor_id) filter (where is_wireless='y') as UV2
-
¿Cuáles son las técnicas de optimización TopN?
-
Algoritmos TopN
Si la entrada de TopN es un flujo de solo anexión (por ejemplo, desde SLS), solo hay un algoritmo disponible: AppendRank. Si la entrada es un flujo de actualización (por ejemplo, después de AGG o JOIN), hay dos algoritmos disponibles, ordenados de mayor a menor rendimiento: UpdateFastRank y RetractRank. Los nombres de los algoritmos aparecen en las etiquetas de los nodos de topología.
AppendRank: Solo compatible con flujos de solo anexión.
UpdateFastRank: Óptimo para flujos de actualización.
RetractRank: Algoritmo de respaldo para flujos de actualización. Tiene menor rendimiento. En algunos casos, se puede optimizar a UpdateFastRank.
Para optimizar RetractRank a UpdateFastRank, se deben cumplir tres condiciones:
El flujo de entrada debe ser un flujo de actualización.
El flujo de entrada debe incluir información de clave primaria; por ejemplo, después de una agregación GROUP BY.
Los campos de ordenamiento deben actualizarse monótonamente en dirección opuesta al orden de clasificación. Por ejemplo, ORDER BY COUNT, COUNT_DISTINCT o SUM (valores positivos) DESC.
Para asegurar que se use UpdateFastRank con ORDER BY SUM DESC, agregue una condición de filtro que garantice que total_fee sea positivo.
insert into print_test SELECT cate_id, seller_id, stat_date, pay_ord_amt -- Omit rownum to reduce sink table output. FROM ( SELECT *, ROW_NUMBER () OVER ( PARTITION BY cate_id, stat_date -- Include a time field to prevent data corruption from State TTL. ORDER BY pay_ord_amt DESC ) as rownum -- Sort by upstream sum result. FROM ( SELECT cate_id, seller_id, stat_date, -- Critical: Declare all SUM inputs as positive, ensuring monotonic increase. -- This allows TopN to use the optimized algorithm and fetch only top 100 records. sum (total_fee) filter ( where total_fee >= 0 ) as pay_ord_amt FROM random_test WHERE total_fee >= 0 GROUP BY cate_name, seller_id, stat_date, cate_id ) a ) WHERE rownum <= 100; -
Métodos de optimización TopN
-
Optimización sin salida de clasificación
Si la salida de TopN no necesita mostrar valores de rownum, omítalos y ordene solo una vez en el frontend. Esto reduce drásticamente el volumen de salida de la tabla destino. Para más detalles, consulte Top-N.
-
Aumentar el tamaño de caché de TopN
TopN utiliza una capa de caché de estado para mejorar la eficiencia de acceso al estado. La tasa de aciertos de caché se calcula de la siguiente manera.
cache_hit = cache_size*parallelism/top_n/partition_key_numPor ejemplo, con Top100, un tamaño de caché de 10,000, paralelismo de 50 y 100,000 claves de partición, la tasa de aciertos es de solo 10000*50/100/100000=5%. Las tasas bajas de aciertos provocan que la mayoría de las solicitudes accedan al estado basado en disco, lo que genera irregularidades en las métricas de búsqueda de estado y degrada severamente el rendimiento.
Cuando la cardinalidad de la clave de partición es muy alta, aumente el tamaño de caché de TopN y la memoria heap en consecuencia. Para más detalles, consulte Configure job deployment settings.
table. exec. rank. topn-cache-size: 200000El tamaño predeterminado de caché es 10,000. Aumentarlo a 200,000 eleva la tasa teórica de aciertos a
200000*50/100/100000 = 100%. -
Incluir un campo basado en tiempo en PartitionBy
Para clasificaciones diarias, incluya un campo Day. Sin este campo, el TTL de estado podría corromper los resultados finales de TopN.
-
¿Cuáles son las soluciones eficientes de deduplicación?
Los datos de origen en Realtime Compute for Apache Flink a veces contienen duplicados. Los usuarios solicitan con frecuencia la deduplicación. Realtime Compute admite dos estrategias: conservar la primera fila (Deduplicate Keep FirstRow) y conservar la última fila (Deduplicate Keep LastRow).
-
Sintaxis
SQL carece de una sintaxis directa para la deduplicación, por lo que se utiliza ROW_NUMBER OVER WINDOW para implementarla. La deduplicación es, en esencia, una forma especial de TopN.
SELECT *
FROM (
   SELECT *,
    ROW_NUMBER() OVER (PARTITION BY col1[, col2..]
     ORDER BY timeAttributeCol [asc|desc]) AS rownum
   FROM table_name)
WHERE rownum = 1
Parámetro
Descripción
ROW_NUMBER()
Función de ventana que asigna números de fila comenzando desde 1.
PARTITION BY col1[, col2..]
Opcional. Columnas que definen las particiones (claves de deduplicación).
ORDER BY timeAttributeCol [asc
desc])
Columna utilizada para la ordenación. Debe ser un campo de atributo de tiempo (Proctime o Rowtime). Utilice orden ascendente para Keep FirstRow o descendente para Keep LastRow.
rownum
Solo se admite
rownum=1orownum<=1.Como se muestra anteriormente, la deduplicación requiere dos capas de consulta:
-
Utilice
ROW_NUMBER()para ordenar los datos por atributo de tiempo y asignar rangos.Si el campo de ordenación es Proctime, Flink deduplica según la hora del sistema y produce resultados no deterministas.
Si el campo de ordenación es Rowtime, Flink deduplica según la hora de negocio y produce resultados deterministas.
-
Filtre por rango para conservar solo la primera fila y lograr así la deduplicación.
Los datos pueden ordenarse de forma ascendente o descendente según la columna de tiempo:
Deduplicate Keep FirstRow: Orden ascendente, conserva la primera fila.
Deduplicate Keep LastRow: Orden descendente, conserva la primera fila.
-
-
Deduplicate Keep FirstRow
Esta estrategia conserva la primera aparición de cada clave y descarta los duplicados posteriores. Almacena únicamente los datos de la clave en State, lo que ofrece un mejor rendimiento. Ejemplo:
SELECT *
FROM (
  SELECT *,
    ROW_NUMBER() OVER (PARTITION BY b ORDER BY proctime) as rowNum
  FROM T
)
WHERE rowNum = 1
Este ejemplo deduplica la tabla T por el campo b y conserva la primera fila según la hora del sistema. Aquí, proctime es un campo de atributo Processing Time en la tabla de origen T. Al deduplicar por hora del sistema, puede simplificar proctime a la llamada de función proctime() y omitir la declaración explícita del campo.
-
Deduplicate Keep LastRow
Esta estrategia conserva la última aparición de cada clave. Su rendimiento es ligeramente superior al de LAST_VALUE. Ejemplo:
SELECT *
FROM (
  SELECT *,
    ROW_NUMBER() OVER (PARTITION BY b, d ORDER BY rowtime DESC) as rowNum
  FROM T
)
WHERE rowNum = 1
Este ejemplo deduplica la tabla T por los campos b y d, y conserva la última fila según la hora de negocio. Aquí, rowtime es un campo de atributo Event Time en la tabla de origen T.
¿Qué debo tener en cuenta al usar funciones integradas?
-
Reemplace las funciones definidas por el usuario con funciones integradas
Realtime Compute optimiza continuamente las funciones integradas. Prefiera estas sobre las funciones definidas por el usuario. Las optimizaciones clave incluyen lo siguiente:
Reducción de la sobrecarga de serialización y deserialización.
Operaciones directas a nivel de bytes.
-
Use separadores de un solo carácter en las funciones KEY VALUE
Firma de KEY VALUE:
KEYVALUE(content, keyValueSplit, keySplit, keyName). Cuando keyValueSplit y keySplit son caracteres únicos (como dos puntos ":" o coma ","), el sistema utiliza un algoritmo optimizado para localizar directamente keyName en los datos binarios sin dividir todo el contenido, lo que mejora el rendimiento en aproximadamente un 30 %. -
Notas sobre la operación LIKE
Para StartWith, utilice
LIKE 'xxx%'.Para EndWith, utilice
LIKE '%xxx'.Para Contains, utilice
LIKE '%xxx%'.Para Equals, utilice
LIKE 'xxx', equivalente astr = 'xxx'.Para coincidir con el guion bajo (_), escápelo:
LIKE '%seller/_id%' ESCAPE '/'. El guion bajo (_) es un comodín de un solo carácter en SQL. Sin escaparlo,LIKE '%seller_id%'coincide conseller_id,seller#id,sellerxidyseller1id, lo que provoca resultados incorrectos.
-
Evite las funciones de expresiones regulares (REGEXP)
Las expresiones regulares son extremadamente costosas; a menudo son 100 veces más lentas que la aritmética básica y pueden entrar en bucles infinitos bajo ciertas condiciones, lo que bloquea los trabajos. Consulte Regex execution is too slow. Prefiera LIKE. Las funciones de expresiones regulares incluyen las siguientes:
¿Cómo resuelvo la baja eficiencia y la contrapresión durante la lectura de tabla completa?
La contrapresión puede derivar de un procesamiento lento en niveles inferiores. Primero, compruebe si existe contrapresión aguas abajo. Si está presente, resuélvala mediante una de las siguientes opciones:
Aumente la concurrencia.
Habilite optimizaciones de agregación como minibatch (para nodos de agregación aguas abajo).
¿Qué significan los indicadores de color en Status Durations para las subtareas de vértice en la descripción general del trabajo?
En la página Overview del trabajo, haga clic en un nodo de operador y seleccione la pestaña SubTasks para consultar las insignias de duración con código de colores en la columna Status Durations.
Status Durations muestra el tiempo que las subtareas de vértice pasan en cada fase. Los significados de los colores son:
 : CREATED
 : SCHEDULED
 : DEPLOYING
 : INITIALIZING
 : RUNNING
¿Qué es el hilo RMI TCP Connection y por qué utiliza mucho más CPU que otros hilos?
En la lista de monitoreo de hilos ordenada por uso de CPU, el hilo RMI TCP Connection(62)-172.25.240.255 muestra el estado RUNNABLE con un 82.3% de uso de CPU, una cifra muy superior a la de los hilos kafkaRequestSource (entre 16.9% y 26.4% de CPU, principalmente en TIMED_WAITING).
Los hilos RMI TCP Connection pertenecen al framework RMI (Remote Method Invocation) integrado de Java y gestionan las llamadas a métodos remotos. El uso de CPU fluctúa de forma dinámica, por lo que los picos a corto plazo no indican una carga alta sostenida. Se recomienda observar el uso de CPU a lo largo del tiempo. El análisis del gráfico de flamas (a continuación) muestra que los hilos RMI consumen casi nada de CPU.

¿Por qué Low Watermark, Watermark y Task InputWatermark en la topología en ejecución muestran una diferencia horaria respecto a la hora actual?
-
Razón 1: El Watermark de la tabla de origen declarado con
TIMESTAMP_LTZ (TIMESTAMP(p) WITH LOCAL TIME ZONE)provoca diferencias horarias.A continuación se compara el comportamiento de Watermark entre los tipos TIMESTAMP_LTZ y TIMESTAMP.
-
El Watermark de la tabla de origen utiliza el tipo TIMESTAMP_LTZ.
CREATE TEMPORARY TABLE s1 ( a INT, b INT, ts as CURRENT_TIMESTAMP,-- CURRENT_TIMESTAMP generates TIMESTAMP_LTZ. WATERMARK FOR ts AS ts - INTERVAL '5' SECOND ) WITH ( 'connector'='datagen', 'rows-per-second'='1', 'fields. b.kind'='random','fields. b.min'='0','fields. b.max'='10' ); CREATE TEMPORARY TABLE t1 ( k INT, ts_ltz timestamp_ltz(3), cnt BIGINT ) WITH ('connector' = 'print'); -- Output results. INSERT INTO t1 SELECT b, window_start, COUNT(*) FROM TABLE( TUMBLE(TABLE s1, DESCRIPTOR(ts), INTERVAL '5' SECOND)) GROUP BY b, window_start, window_end;NotaLa sintaxis heredada de ventanas produce resultados idénticos a
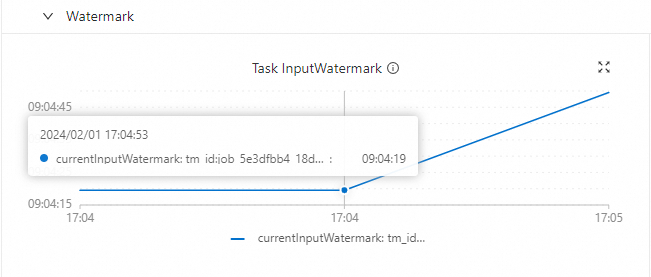
TVF Window (Table-Valued Function). Ejemplo de sintaxis heredada:SELECT b, TUMBLE_END(ts, INTERVAL '5' SECOND), COUNT(*) FROM s1 GROUP BY TUMBLE(ts, INTERVAL '5' SECOND), b;Tras desplegar y ejecutar el trabajo en la consola de desarrollo de Realtime Compute, se observa una diferencia de 8 horas entre Watermark y la hora actual (tomando UTC+8 como referencia).
-
Watermark y Low Watermark
En la pestaña Watermarks de la interfaz de monitoreo de trabajos de Flink, el SubTask 0 muestra un valor de Watermark de
1706778525521, que corresponde a Datetime of Watermark Timestamp02-01 09:08:45. La hora de inicio del trabajo fue02-01 17:03:04, lo que representa una brecha aproximada de 8 horas. El panel del operador a la izquierda muestra un Low Watermark idéntico:02-01 09:08:45. -
Task InputWatermark
-
-
El Watermark de la tabla de origen utiliza el tipo TIMESTAMP (TIMESTAMP(p) WITHOUT TIME ZONE).
CREATE TEMPORARY TABLE s1 (
  a INT,
  b INT,
  -- Simulate TIMESTAMP without timezone, starting at 2024-01-31 01:00:00 and incrementing by second.
  ts as TIMESTAMPADD(SECOND, a, TIMESTAMP '2024-01-31 01:00:00'),
  WATERMARK FOR ts AS ts - INTERVAL '5' SECOND
) WITH (
  'connector'='datagen',
  'rows-per-second'='1',
  'fields. a.kind'='sequence','fields. a.start'='0','fields. a.end'='100000',
  'fields. b.kind'='random','fields. b.min'='0','fields. b.max'='10'
);
CREATE TEMPORARY TABLE t1 (
  k INT,
  ts_ltz timestamp_ltz(3),
  cnt BIGINT
) WITH ('connector' = 'print');
-- Output results.
INSERT INTO t1
SELECT b, window_start, COUNT(*) FROM
TABLE(
    TUMBLE(TABLE s1, DESCRIPTOR(ts), INTERVAL '5' SECOND))
GROUP BY b, window_start, window_end;
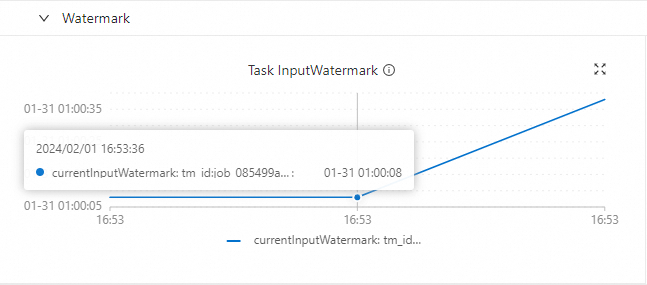
Después de desplegar y ejecutar el trabajo en la consola de desarrollo de Realtime Compute, Watermark se alinea con la hora actual (específicamente, con la hora de los datos simulados) sin ninguna diferencia horaria.
-
Watermark y Low Watermark
En los detalles de la tarea de la interfaz web de Flink, seleccione un operador (por ejemplo, GlobalWindowAggregate). El panel izquierdo de información del operador muestra Low Watermark (por ejemplo, 01-31 01:03:49). Cambie a la pestaña Watermarks a la derecha para consultar los valores de Watermark y las marcas de tiempo del SubTask; ambas horas coinciden.
-
Task InputWatermark
-
-
-
Razón 2: Diferencia de zona horaria entre la consola de desarrollo de Realtime Compute y la interfaz de Apache Flink.
La consola de desarrollo de Realtime Compute muestra las horas en UTC+0. La interfaz de Apache Flink utiliza la zona horaria local del navegador. Si se toma UTC+8 (hora de Pekín) como referencia, la consola de desarrollo de Realtime Compute muestra las horas con 8 horas de retraso respecto a la interfaz de Apache Flink.
-
Consola de desarrollo de Realtime Compute
En la topología de la página Job O&M, las horas de Watermark se muestran en UTC+0. Por ejemplo, cuando la hora del evento es la hora de Pekín
2024/1/31 09:01:34 AM, la consola muestra2024/1/31 01:01:34 AM.Las métricas de monitoreo relacionadas con Watermark en la consola del producto también utilizan UTC+0, es decir, 8 horas menos que la hora de Pekín.
-
Interfaz de Apache Flink
En la interfaz web de Apache Flink, seleccione un nodo de operador (por ejemplo,
GlobalWindowAggregate) en la topología del trabajo y cambie a la pestaña Watermarks. Consulte los valores de Watermark del SubTask y las horas de evento correspondientes. Por ejemplo, un Low Watermark de1706662894000corresponde a Datetime of Watermark Timestamp2024/1/31 09:01:34 AM. Esta es la hora del evento, no la hora de procesamiento, por lo que las diferencias con la hora del sistema son normales.
-
¿Cómo solucionar problemas de contrapresión en los trabajos?
En la página Job O& M, haga clic en el nombre del trabajo objetivo para abrir la pestaña Overview.
-
Revise Busy y BackPressure para localizar la contrapresión.
Un indicador Busy más rojo indica una mayor carga de tarea. Un indicador BackPressure más oscuro señala un impacto de contrapresión más fuerte.
Por ejemplo, si Backpressured (max) del operador ascendente es 99 %, Busy (max) del operador intermedio es 100 % (resaltado en rojo) y Busy (max) del operador descendente es solo 7 %, el cuello de botella está en el operador intermedio; optimícelo.
Haga clic en el operador con contrapresión.
-
En la pestaña BackPressure, compruebe el estado de contrapresión del SubTask.
Si Back Pressure Status aparece en verde como OK, y la tabla muestra los SubTasks 0–7 con Backpressured / Idle / Busy en
0%, 0%, N/Ay todos los estados como OK, el trabajo no tiene contrapresión.
¿Cómo soluciono problemas de latencia excesiva en los trabajos?
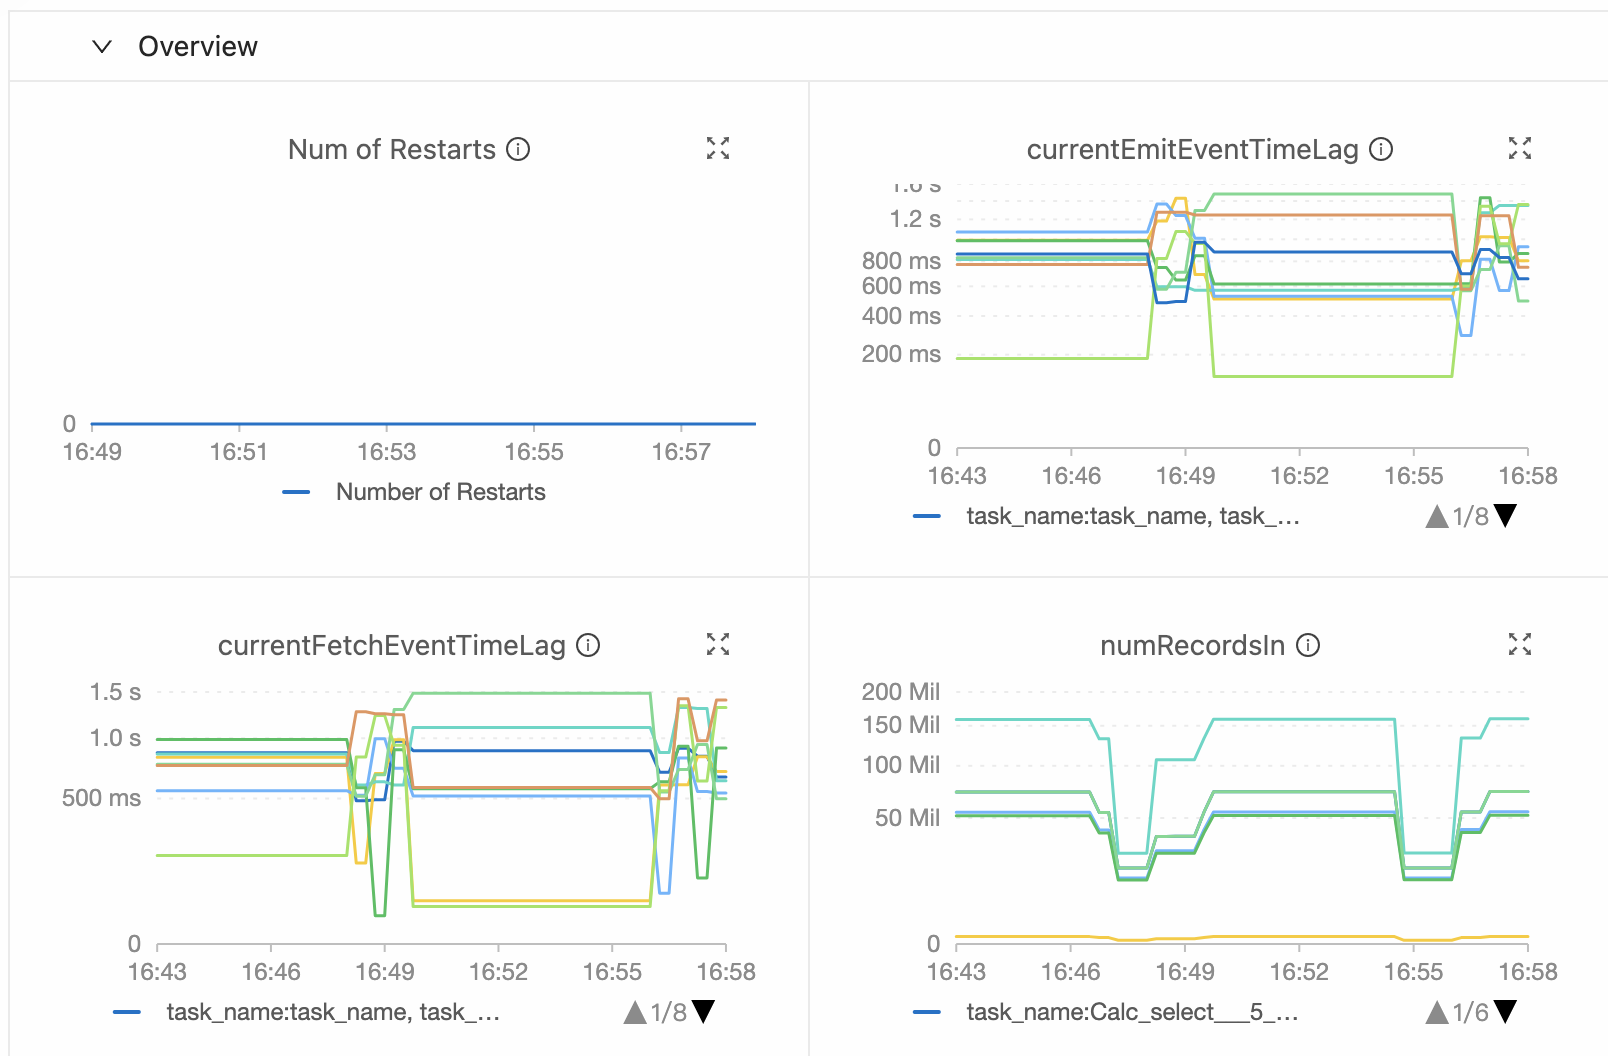
En la página Job O& M, revise la pestaña Monitoring and Alerts o Data Curves para consultar las métricas currentEmitEventTimeLag y currentFetchEventTimeLag:
Si el valor de
currentEmitEventTimeLages alto, el trabajo presenta retrasos en la obtención o el procesamiento de datos. Compruebe el rendimiento del operador.Si el valor de
currentFetchEventTimeLages alto, los retrasos provienen de la obtención de datos o del procesamiento en sistemas anteriores. Investigue la E/S de red y los sistemas anteriores.
Cuando factores externos causan una latencia elevada, ambas métricas aumentan simultáneamente.
¿Cómo optimizo un trabajo de Flink SQL cuando la asimetría de datos causa contrapresión?
Cuando la contrapresión se origina por puntos críticos de datos (confirmado mediante el análisis de subtareas), utilice las siguientes optimizaciones:
-
Habilite LocalGlobal (resuelve problemas comunes de puntos críticos de datos)
El mecanismo LocalGlobal utiliza LocalAgg para preagregar los datos asimétricos, lo que reduce la presión sobre GlobalAgg y mejora el rendimiento general.
LocalGlobal divide una agregación única en dos fases: Local y Global, similar a las fases Combine y Reduce en MapReduce. En la primera fase, los nodos anteriores almacenan en búfer y agregan los datos localmente (localAgg), y emiten acumuladores incrementales. En la segunda fase, estos acumuladores se combinan (Merge) para producir el resultado final (GlobalAgg).
-
Escenarios
Mejora el rendimiento de agregaciones estándar (como SUM, COUNT, MAX, MIN y AVG) y resuelve problemas de puntos críticos de datos en estos escenarios.
-
Límites
LocalGlobal está habilitado de forma predeterminada, pero aplican las siguientes limitaciones:
MiniBatch debe estar habilitado.
Su AggregateFunction debe implementar Merge.
-
Comprobación del estado
Compruebe si la topología generada contiene nodos llamados GlobalGroupAggregate o LocalGroupAggregate.
-
-
Habilite PartialFinal (resuelve problemas de puntos críticos en COUNT DISTINCT)
Para abordar los puntos críticos de COUNT DISTINCT, tradicionalmente era necesario reescribir manualmente las consultas en una agregación de dos fases (añadiendo una capa de distribución basada en módulo). Realtime Compute for Apache Flink ahora proporciona una distribución automática de COUNT DISTINCT mediante la optimización PartialFinal, sin necesidad de reescritura manual.
LocalGlobal funciona bien para agregaciones estándar, pero ofrece pocos beneficios para COUNT DISTINCT. Durante la agregación local, las tasas de deduplicación de claves distintas permanecen bajas, por lo que los puntos críticos persisten en el nodo global.
-
Escenarios
Utilícelo cuando COUNT DISTINCT no cumpla con los requisitos de rendimiento del nodo de agregación.
ImportanteNo utilice la optimización PartialFinal en Flink SQL que incluya UDAF.
Evite PartialFinal cuando el volumen de datos sea pequeño, ya que introduce una distribución de red innecesaria y desperdicia recursos.
-
Cómo habilitarla
De forma predeterminada, esta función está deshabilitada. Para habilitarla, en la pestaña Deployment Details del trabajo objetivo, introduzca el siguiente código en la sección Other Configurations del área Runtime Parameter Settings.
table. optimizer. distinct-agg. split. enabled: true -
Verificación de la eficacia
Compruebe si la topología generada cambia de una sola fase de agregación a dos fases.
-
¿Cómo soluciono la velocidad inestable de consumo de datos de entrada?
Causas posibles y soluciones:
-
El patrón de producción de datos anterior no coincide con la velocidad de procesamiento actual.
Analice los patrones de generación de datos anteriores para alinear las tasas de producción y procesamiento.
-
El trabajo experimenta contrapresión.
Compruebe si hay contrapresión que afecte el consumo anterior. Si su trabajo muestra solo un nodo, añada
pipeline. operator-chaining: 'false', reinicie el trabajo para dividir la cadena de operadores e identifique cualquier nodo con contrapresión que impacte la tasa de consumo. -
Tasa de E/S anómala.
Revise las curvas de entrada y consumo de datos de Flink en el momento relevante para determinar si la E/S es la causa.
-
Tasa de consumo anómala.
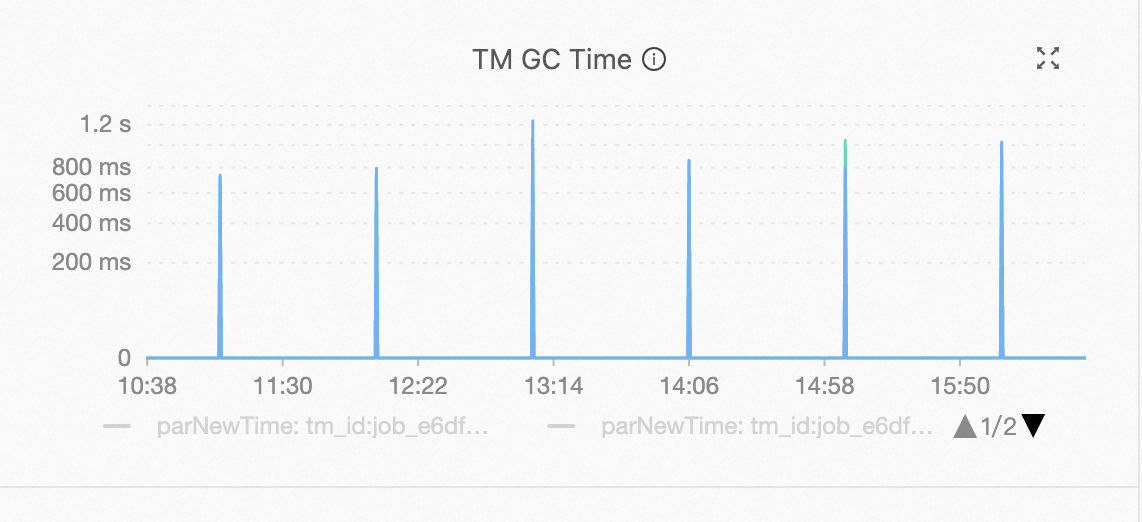
Compruebe si las fluctuaciones en la tasa de consumo coinciden con eventos de recolección de basura (GC). De ser así, inspeccione el uso de memoria del nodo TM.