Una vez que configure un catálogo JSON de Kafka, sus trabajos de Realtime Compute for Apache Flink podrán acceder directamente a los topics JSON de un clúster de Kafka sin necesidad de definir un esquema. En este tema se explica cómo crear, consultar y eliminar catálogos JSON de Kafka.
Contexto
Un catálogo JSON de Kafka deduce el esquema de un topic al analizar automáticamente los mensajes con formato JSON. Esto le permite acceder a campos específicos de los mensajes en Flink SQL sin declarar un esquema para la tabla de Kafka. Un catálogo JSON de Kafka cuenta con las siguientes características:
Los nombres de las tablas del catálogo coinciden con los nombres de los topics de Kafka. De esta forma, se elimina el registro manual de tablas mediante sentencias DDL, lo que mejora la eficiencia y la precisión durante el desarrollo.
Las tablas de un catálogo JSON de Kafka se pueden usar directamente como tablas de origen en los trabajos de Flink SQL.
Es posible combinar un catálogo JSON de Kafka con la ingesta de datos de Flink CDC para sincronizar información cuando cambia el esquema. Para obtener más información, consulte Reuse an existing catalog.
A continuación se describe cómo gestionar los catálogos JSON de Kafka:
Límites
Un catálogo JSON de Kafka solo admite topics cuyos mensajes tengan formato JSON.
La configuración de catálogos JSON de Kafka requiere el motor de cómputo de Flink VVR 6.0.2 o posterior.
No es posible modificar un catálogo JSON de Kafka existente mediante sentencias DDL.
Solo se pueden consultar tablas de datos. No se admite la creación, modificación ni eliminación de bases de datos o tablas.
Un catálogo JSON de Kafka no puede leer ni escribir en clústeres de Kafka que usen autenticación SSL o SASL.
Las tablas de un catálogo JSON de Kafka se pueden usar directamente como tablas de origen en trabajos de Flink SQL, pero no como tablas de destino (sink) ni como tablas de dimensiones de búsqueda (lookup).
Dado que ApsaraMQ for Kafka actualmente no permite eliminar un Group con la misma interfaz que Kafka de código abierto, debe especificar aliyun.kafka.instanceId, aliyun.kafka.accessKeyId, aliyun.kafka.accessKeySecret, aliyun.kafka.endpoint y aliyun.kafka.regionId al crear un catálogo JSON de Kafka. Esto habilita la eliminación automática del Group ID. Para obtener más información, consulte Comparison with open-source Kafka.
Notas de uso
El catálogo JSON de Kafka deduce el esquema de una tabla al analizar datos de muestra. Cuando un topic contiene formatos de datos inconsistentes, el catálogo conserva todas las columnas de forma predeterminada y devuelve el esquema más amplio. Los cambios en el formato de los datos del topic pueden alterar el esquema deducido, lo que podría provocar errores en los trabajos al reiniciarlos.
Por ejemplo, si reinicia un trabajo de Flink SQL que lee desde una tabla de un catálogo JSON de Kafka a partir de un savepoint, el catálogo podría deducir un esquema nuevo distinto al anterior. El plan de ejecución del trabajo se basa en el esquema antiguo, lo que genera errores en tiempo de ejecución, como condiciones de filtro incompatibles o accesos incorrectos a los campos. Para evitar estos problemas, use la sentencia CREATE TEMPORARY TABLE en su trabajo de Flink SQL y defina una tabla de Kafka con un esquema fijo.
Crear un catálogo JSON de Kafka
-
En la página Scripts, introduzca la sentencia para crear un catálogo JSON de Kafka en el editor de SQL.
-
Para un clúster de Kafka autoadministrado o un EMR on ECS Kafka cluster
CREATE CATALOG <YourCatalogName> WITH( 'type'='kafka', 'properties.bootstrap.servers'='<brokers>', 'format'='json', 'default-database'='<dbName>', 'key.fields-prefix'='<keyPrefix>', 'value.fields-prefix'='<valuePrefix>', 'timestamp-format.standard'='<timestampFormat>', 'infer-schema.flatten-nested-columns.enable'='<flattenNestedColumns>', 'infer-schema.primitive-as-string'='<primitiveAsString>', 'infer-schema.parse-key-error.field-name'='<parseKeyErrorFieldName>', 'infer-schema.compacted-topic-as-upsert-table'='true', 'max.fetch.records'='100' ); -
Para ApsaraMQ for Kafka
CREATE CATALOG <YourCatalogName> WITH(
 'type'='kafka',
 'properties.bootstrap.servers'='<brokers>',
 'format'='json',
 'default-database'='<dbName>',
 'key.fields-prefix'='<keyPrefix>',
 'value.fields-prefix'='<valuePrefix>',
 'timestamp-format.standard'='<timestampFormat>',
 'infer-schema.flatten-nested-columns.enable'='<flattenNestedColumns>',
 'infer-schema.primitive-as-string'='<primitiveAsString>',
 'infer-schema.parse-key-error.field-name'='<parseKeyErrorFieldName>',
 'infer-schema.compacted-topic-as-upsert-table'='true',
 'max.fetch.records'='100',
 'aliyun.kafka.accessKeyId'='<aliyunAccessKeyId>',
 'aliyun.kafka.accessKeySecret'='<aliyunAccessKeySecret>',
 'aliyun.kafka.instanceId'='<aliyunKafkaInstanceId>',
 'aliyun.kafka.endpoint'='<aliyunKafkaEndpoint>',
 'aliyun.kafka.regionId'='<aliyunKafkaRegionId>'
);
Parámetro
Tipo
Descripción
Obligatorio
Observaciones
YourCatalogName
String
Nombre del catálogo JSON de Kafka.
Sí
Especifique un nombre personalizado.
ImportanteReemplace el marcador de posición por el nombre de su catálogo y elimine los corchetes angulares (<>) para evitar errores de sintaxis.
type
String
Tipo del catálogo.
Sí
El valor debe ser 'kafka'.
properties.bootstrap.servers
String
Direcciones de los brokers de Kafka.
Sí
Especifique una o más direcciones con el formato
host1:port1,host2:port2,host3:port3.Separe varias direcciones con comas (,).
format
String
Formato de los mensajes de Kafka.
Sí
Actualmente, solo se admite 'json'. Flink analiza los mensajes con formato JSON para deducir el esquema.
default-database
String
Nombre de la base de datos predeterminada del catálogo.
No
Los catálogos usan un identificador de tres partes para ubicar las tablas: catalog_name.db_name.table_name. Este parámetro define db_name. Como Kafka no tiene bases de datos, puede usar cualquier cadena para representar el clúster.
key.fields-prefix
String
Prefijo personalizado que se agrega a los nombres de los campos analizados de la clave del mensaje para evitar conflictos de nombres.
No
El valor predeterminado es 'key_'. Por ejemplo, si un campo de la clave se llama 'a', su nombre en el esquema de la tabla será 'key_a'.
NotaEl valor de key.fields-prefix no puede ser un prefijo del valor de value.fields-prefix. Por ejemplo, si value.fields-prefix se establece en 'test1_value_', no puede configurar key.fields-prefix como 'test1_'.
value.fields-prefix
String
Prefijo personalizado que se agrega a los nombres de los campos analizados del valor del mensaje para evitar conflictos de nombres.
No
El valor predeterminado es 'value_'. Por ejemplo, si un campo del valor se llama 'b', su nombre en el esquema de la tabla será 'value_b'.
NotaEl valor de value.fields-prefix no puede ser un prefijo del valor de key.fields-prefix. Por ejemplo, si key.fields-prefix se establece en 'test2_value_', no puede configurar value.fields-prefix como 'test2_'.
timestamp-format.standard
String
Formato para analizar los campos de marca de tiempo en los mensajes JSON. Flink intenta primero analizar las marcas de tiempo con este formato. Si falla, prueba automáticamente otros formatos estándar.
No
Valores válidos:
-
SQL (predeterminado)
-
ISO-8601
infer-schema.flatten-nested-columns.enable
Boolean
Indica si se expanden recursivamente las columnas anidadas en el valor del mensaje JSON.
No
Valores válidos:
-
true: expande recursivamente las columnas anidadas.
Para las columnas expandidas, Flink usa la ruta de acceso como nombre de columna. Por ejemplo, para una columna 'col' en
{"nested": {"col": true}}, el nombre de la columna expandida es 'nested.col'.NotaSi configura este parámetro como true, se recomienda usarlo junto con Flink CDC data ingestion jobs. Las demás sentencias DML no admiten la expansión automática de columnas anidadas.
-
false (predeterminado): trata los tipos anidados como STRING.
infer-schema.primitive-as-string
Boolean
Indica si todos los tipos primitivos del valor del mensaje JSON se deducen como STRING.
No
Valores válidos:
-
true: deduce todos los tipos primitivos como STRING.
-
false (predeterminado): deduce los tipos según las reglas estándar.
infer-schema.parse-key-error.field-name
String
Si una clave de mensaje no vacía no se puede analizar como JSON, Flink agrega un campo VARBINARY al esquema para almacenar los datos originales de la clave. El nombre de este nuevo campo combina key.fields-prefix y el valor de este parámetro.
No
El valor predeterminado es 'col'. Por ejemplo, si el valor del mensaje se analiza en un campo llamado 'value_name' y la clave del mensaje no está vacía pero no se puede analizar, el esquema resultante contendrá dos campos: 'key_col' y 'value_name'.
infer-schema.compacted-topic-as-upsert-table
Boolean
Indica si el topic se trata como una tabla Upsert Kafka. Solo aplica cuando la política de limpieza del topic es 'compact' y la clave del mensaje no está vacía.
No
El valor predeterminado es true. Este parámetro debe establecerse en true cuando se usa la ingesta de datos de Flink CDC para sincronizar información hacia una instancia de ApsaraMQ for Kafka.
NotaEste parámetro solo se admite en VVR 6.0.2 y versiones posteriores.
max.fetch.records
Int
Número máximo de mensajes que se muestrean para deducir el esquema.
No
El valor predeterminado es 100.
aliyun.kafka.accessKeyId
String
AccessKey ID de su cuenta de Alibaba Cloud. Para obtener más información, consulte Create an AccessKey pair.
No
Este parámetro es obligatorio cuando se usa la ingesta de datos de Flink CDC para sincronizar información hacia una instancia de ApsaraMQ for Kafka.
NotaEste parámetro solo se admite en VVR 6.0.2 y versiones posteriores.
aliyun.kafka.accessKeySecret
String
AccessKey Secret de su cuenta de Alibaba Cloud. Para obtener más información, consulte Create an AccessKey pair.
No
Este parámetro es obligatorio cuando se usa la ingesta de datos de Flink CDC para sincronizar información hacia una instancia de ApsaraMQ for Kafka.
NotaEste parámetro solo se admite en VVR 6.0.2 y versiones posteriores.
aliyun.kafka.instanceId
String
ID de la instancia de ApsaraMQ for Kafka. Puede consultar el ID de la instancia en la página de detalles correspondiente de la consola de ApsaraMQ for Kafka.
No
Este parámetro es obligatorio cuando se usa la ingesta de datos de Flink CDC para sincronizar información hacia una instancia de ApsaraMQ for Kafka.
NotaEste parámetro solo se admite en VVR 6.0.2 y versiones posteriores.
aliyun.kafka.endpoint
String
Endpoint de la API para ApsaraMQ for Kafka. Para obtener más información, consulte Endpoints.
No
Este parámetro es obligatorio cuando se usa la ingesta de datos de Flink CDC para sincronizar información hacia una instancia de ApsaraMQ for Kafka.
NotaEste parámetro solo se admite en VVR 6.0.2 y versiones posteriores.
aliyun.kafka.regionId
String
ID de región de la instancia donde reside el topic. Para obtener más información, consulte Endpoints.
No
Este parámetro es obligatorio cuando se usa la ingesta de datos de Flink CDC para sincronizar información hacia una instancia de ApsaraMQ for Kafka.
NotaEste parámetro solo se admite en VVR 6.0.2 y versiones posteriores.
-
-
Seleccione la sentencia CREATE CATALOG y luego haga clic en Run en el margen izquierdo.
CREATE CATALOG KafkaCatalog WITH(
'type'='kafka',
'properties.bootstrap.servers'='<brokers>',
'format'='json',
'default-database'='<dbName>',
'key.fields-prefix'='<keyPrefix>',
'value.fields-prefix'='<valuePrefix>',
'timestamp-format.standard'='<timestampFormat>',
'infer-schema.flatten-nested-columns.enable'='<flattenNestedColumns>',
'infer-schema.primitive-as-string'='<primitiveAsString>',
'infer-schema.parse-key-error.field-name'='<parseKeyErrorFieldName>',
'infer-schema.compacted-topic-as-upsert-table'='true',
'max.fetch.records'='100',
'aliyun.kafka.accessKeyId'='<aliyunAccessKeyId>',
'aliyun.kafka.accessKeySecret'='<aliyunAccessKeySecret>',
'aliyun.kafka.instanceId'='<aliyunKafkaInstanceId>',
'aliyun.kafka.endpoint'='<aliyunKafkaEndpoint>',
'aliyun.kafka.regionId'='<aliyunKafkaRegionId>'
);
Compruebe que el catálogo aparezca en el área Catalogs del lado izquierdo.
Consultar un catálogo JSON de Kafka
-
Introduzca el siguiente comando en el editor de Scripts.
DESCRIBE `${catalog_name}`.`${db_name}`.`${topic_name}`;Parámetro
Descripción
${catalog_name}
Nombre del catálogo JSON de Kafka.
${db_name}
Nombre del clúster de Kafka.
${topic_name}
Nombre del topic de Kafka.
-
Seleccione la sentencia DESCRIBE y luego haga clic en Run en el margen izquierdo.
Cuando la sentencia se ejecuta correctamente, el panel de resultados muestra las definiciones de los campos de la tabla de origen de Kafka. La salida incluye los campos de negocio
value_from(STRING),value_name(STRING) yvalue_order(BIGINT), además de los campos virtuales de metadatospartition(INT, clave principal),offset(BIGINT, clave principal) ytimestamp(TIMESTAMP_LTZ(3)). Para estos campos virtuales de metadatos, la columnaextrasmuestraMETADATA VIRTUAL.
Usar un catálogo JSON de Kafka
-
Como tabla de origen para leer datos de un topic de Kafka.
INSERT INTO ${other_sink_table} SELECT... FROM `${kafka_catalog}`.`${db_name}`.`${topic_name}`/*+OPTIONS('scan.startup.mode'='earliest-offset')*/;NotaPara especificar opciones WITH adicionales en una tabla del catálogo JSON de Kafka, utilice hints de SQL. Por ejemplo, la sentencia SQL anterior usa un hint para comenzar a consumir datos desde el offset más antiguo. Para obtener más información sobre otros parámetros, consulte ApsaraMQ for Kafka source table parameters y ApsaraMQ for Kafka sink table parameters.
-
Como tabla de origen, utilice la ingesta de datos de Flink CDC para sincronizar información de un topic de Kafka hacia una tabla de destino Paimon. El parámetro
using.built-in-catalogreutiliza un catálogo existente y simplifica la configuración.-
Sincronice una sola tabla en tiempo real.
source: type: kafka using.built-in-catalog: kafka_json_catalog topic: topic0 properties.group.id: cdc_kafka_json_to_paimon # Consume from the earliest available offset of each topic on the first startup. scan.startup.mode: earliest-offset value.format: json sink: type: paimon using.built-in-catalog: paimon_dlf_catalog # Specify the Paimon table to which topic0 is written. route: - source-table: topic0 sink-table: db.table0 -
Sincronice varias tablas en un solo trabajo.
source:
  type: kafka
  using.built-in-catalog: kafka_json_catalog
  topic: "topic0;topic1;topic2"
  properties.group.id: cdc_kafka_json_to_paimon
  # Consume from the earliest available offset of each topic on the first startup.
  scan.startup.mode: earliest-offset
  value.format: json
  # Send the create table events known at startup in batches.
  scan.emit.create-table-events.in-batch.enabled: true

sink:
  type: paimon
  using.built-in-catalog: paimon_dlf_catalog

# Write each topic to a different table.
route:
  - source-table: topic0
    sink-table: db.table0
  - source-table: topic1
    sink-table: db.table1
  - source-table: topic2
    sink-table: db.table2
-
Para ver ejemplos integrales sobre el uso de un catálogo JSON de Kafka, consulte real-time log warehousing.
Eliminar un catálogo JSON de Kafka
Eliminar un catálogo JSON de Kafka no afecta a los trabajos en ejecución. Sin embargo, si despliega o reinicia un trabajo que use una tabla de ese catálogo, fallará con un error de "tabla no encontrada". Proceda con precaución.
-
Introduzca el siguiente comando en el editor de SQL de la página Scripts.
DROP CATALOG ${catalog_name};Reemplace ${catalog_name} por el nombre de su catálogo JSON de Kafka.
Seleccione el comando DROP CATALOG, haga clic derecho y seleccione Run.
Compruebe que el catálogo ya no aparezca en el área Catalogs del lado izquierdo.
Tablas del catálogo JSON de Kafka
Para simplificar el uso de las tablas de un catálogo JSON de Kafka, el sistema agrega automáticamente parámetros de configuración predeterminados, metadatos e información de clave principal a las tablas deducidas.
-
Deducción de esquemas para tablas de Kafka
Al deducir el esquema de un topic, el catálogo JSON de Kafka muestrea hasta max.fetch.records mensajes. Analiza el esquema de cada mensaje y luego fusiona esos esquemas individuales en uno definitivo. Las reglas de análisis son las mismas que las de basic rules, utilizadas cuando Kafka actúa como origen de datos para la ingesta de datos de Flink CDC.
ImportanteDurante la deducción del esquema, el catálogo JSON de Kafka crea un grupo de consumidores para leer datos del topic. El catálogo antepone un prefijo al nombre del grupo de consumidores para indicar que fue creado por él mismo.
Para ApsaraMQ for Kafka, se recomienda usar el catálogo JSON de Kafka con la versión 6.0.7 o posterior. Las versiones anteriores a la 6.0.7 no eliminan automáticamente el grupo de consumidores, lo que puede generar alertas por acumulación de mensajes.
El esquema consta de las siguientes partes:
-
Columnas físicas deducidas
El catálogo JSON de Kafka deduce las columnas físicas a partir de la clave y del valor del mensaje.
Si la clave del mensaje no está vacía pero no se puede analizar, el catálogo devuelve una columna VARBINARY. El nombre de esta columna es la concatenación del valor del parámetro key.fields-prefix y del valor del parámetro infer-schema.parse-key-error.field-name.
Después de obtener un lote de mensajes de Kafka, el catálogo analiza cada uno y fusiona las columnas físicas resultantes en un esquema unificado para el topic.
Si las columnas físicas deducidas contienen campos que no están en el esquema resultante, el catálogo los agrega automáticamente a dicho esquema.
-
Si ambos contienen una columna con el mismo nombre, se aplican las siguientes reglas:
Si los tipos son iguales pero la precisión difiere, se utiliza el tipo con mayor precisión.
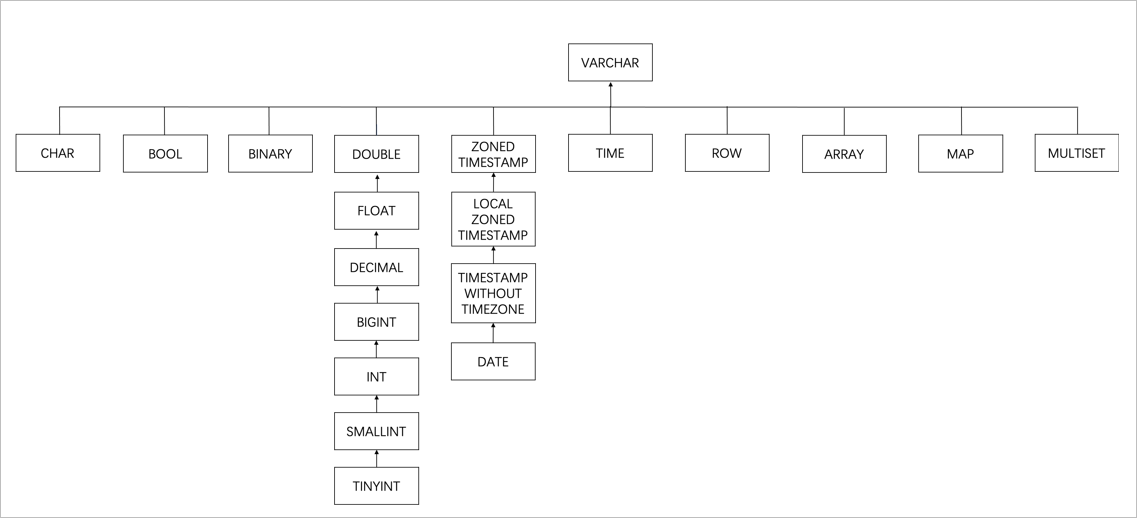
Si los tipos son distintos, el sistema busca su ancestro común más bajo en el árbol de tipos (que se muestra en la siguiente imagen) y lo usa como tipo de la columna. Sin embargo, para conservar la precisión, cuando se fusionan un tipo Decimal y un tipo Float, el resultado es Double.
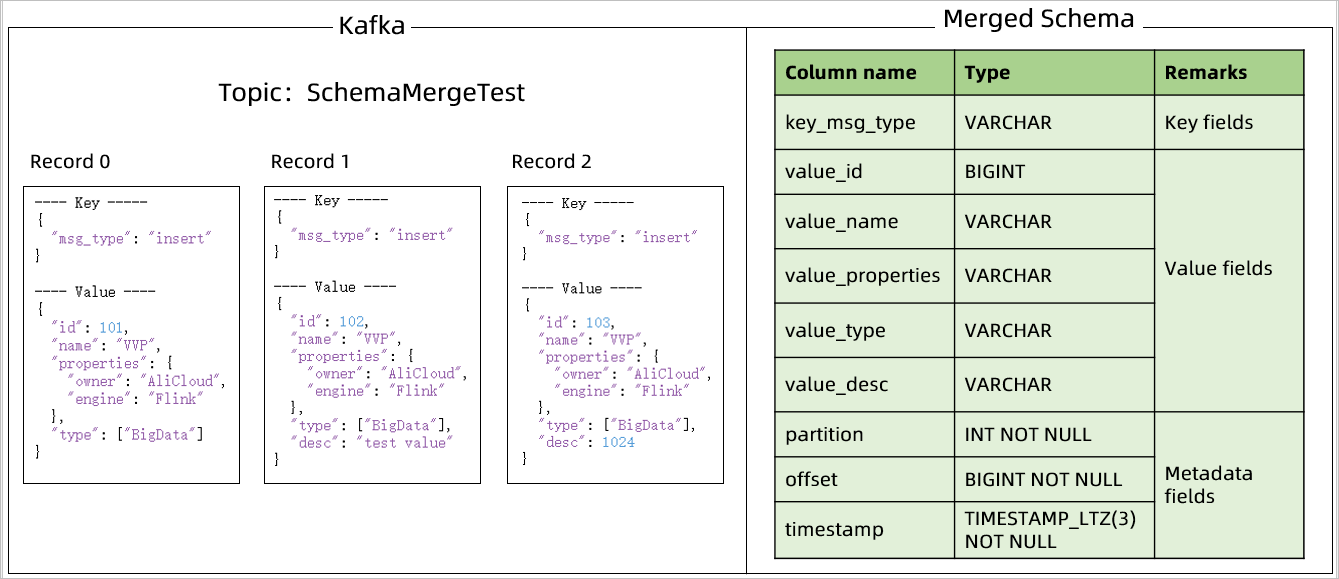
Por ejemplo, para un topic de Kafka que contiene los tres mensajes siguientes, el catálogo JSON de Kafka deduce el esquema que se muestra en la imagen.
-
Columnas de metadatos predeterminadas
De forma predeterminada, el catálogo JSON de Kafka agrega tres columnas de metadatos: partition, offset y timestamp.
Nombre del metadato
Nombre de la columna
Tipo
Descripción
partition
partition
INT NOT NULL
ID de la partición.
offset
offset
BIGINT NOT NULL
Offset del mensaje.
timestamp
timestamp
TIMESTAMP_LTZ(3) NOT NULL
Marca de tiempo del mensaje.
-
Restricción de clave principal predeterminada
Cuando se usa una tabla de un catálogo JSON de Kafka como origen, las columnas de metadatos partition y offset funcionan como clave principal predeterminada para garantizar la unicidad de los datos.
NotaSi el esquema deducido por el catálogo JSON de Kafka no cumple con sus requisitos, puede declarar una tabla temporal con el esquema deseado mediante la sintaxis CREATE TEMPORARY TABLE ... LIKE. Por ejemplo, si sus datos JSON contienen un campo
tscon el formato '2023-01-01 12:00:01', el catálogo JSON de Kafka deduce automáticamente el campotscomo tipo TIMESTAMP. Para usar el campotscomo tipo STRING, declare la tabla de la siguiente manera. Dado que la configuración predeterminada agrega el prefijovalue_a los campos provenientes del valor del mensaje, aquí el nombre del campo esvalue_ts.CREATE TEMPORARY TABLE tempTable ( value_name STRING, value_ts STRING ) LIKE `kafkaJsonCatalog`.`kafka`.`testTopic`; -
Parámetros de tabla predeterminados
Parámetro
Descripción
Observaciones
connector
Tipo de conector.
El valor es
kafkaoupsert-kafka.topic
Nombre del topic correspondiente.
Coincide con el nombre de la tabla declarada.
properties.bootstrap.servers
Direcciones de los brokers de Kafka.
Igual que la configuración properties.bootstrap.servers del catálogo.
value.format
Formato que usa el conector de Kafka de Flink para serializar o deserializar el valor del mensaje de Kafka.
El valor es
json.value.fields-prefix
Define un prefijo personalizado para todos los campos del valor del mensaje de Kafka, con el fin de evitar conflictos de nombres con los campos de la clave del mensaje o de los metadatos.
Igual que la configuración
value.fields-prefixdel catálogo.value.json.infer-schema.flatten-nested-columns.enable
Indica si se expanden recursivamente las columnas anidadas en el JSON del valor del mensaje.
Igual que la configuración
infer-schema.flatten-nested-columns.enabledel catálogo.value.json.infer-schema.primitive-as-string
Indica si todos los tipos primitivos del valor del mensaje se deducen como tipo STRING.
Igual que la configuración
infer-schema.primitive-as-stringdel catálogo.value.fields-include
Define cómo maneja el valor del mensaje los campos provenientes de la clave del mensaje.
El valor es
EXCEPT_KEY, lo que significa que el valor del mensaje no incluye los campos de la clave del mensaje.Este parámetro solo se configura si la clave del mensaje no está vacía.
key.format
Formato que usa el conector de Kafka de Flink para serializar o deserializar la clave del mensaje de Kafka.
El valor es
jsonoraw.Este parámetro solo se configura si la clave del mensaje no está vacía.
Cuando la clave del mensaje no está vacía pero el análisis falla, el valor es
raw. Si el análisis se completa correctamente, el valor esjson.key.fields-prefix
Define un prefijo personalizado para todos los campos de la clave del mensaje de Kafka, con el fin de evitar conflictos de nombres con los campos del valor del mensaje.
Igual que la configuración
key.fields-prefixdel catálogo.Este parámetro solo se configura si la clave del mensaje no está vacía.
key.fields
Campos que almacenan los datos analizados de la clave del mensaje de Kafka.
La lista de campos de clave analizados se completa automáticamente.
Este parámetro solo se configura si la clave del mensaje no está vacía y la tabla no es una tabla Upsert Kafka.