Este tema responde a las preguntas más comunes sobre la validez de los datos en Realtime Compute for Apache Flink.
¿Por qué no obtengo resultados en la tabla sink?
Si después de iniciar un trabajo no aparecen datos en la tabla sink, realice las siguientes comprobaciones en orden.
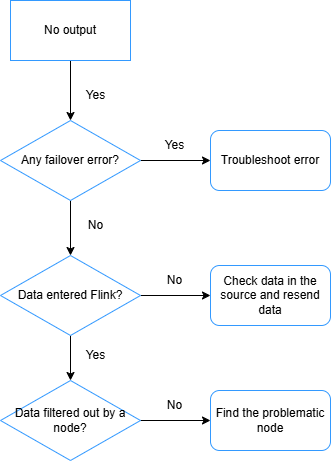
Compruebe si hay failovers. Si el trabajo ha tenido un failover, analice el mensaje de error para identificar la causa raíz y resuélvala para que el trabajo se ejecute correctamente.
Verifique que los datos llegan a Realtime Compute for Apache Flink. Si no ha ocurrido ningún failover pero la latencia de los datos es muy alta, revise la métrica
numRecordsInOfSourceen la página de monitoreo y alertas. Si la métrica muestra cero para un origen, significa que la tabla de origen no envía datos a Flink; investigue el origen de datos ascendente.Compruebe si algún operador filtra todos los registros. Agregue
pipeline.operator-chaining: 'false'al campo Other Configuration (consulte How do I configure custom running parameters for a job?). Esto divide la cadena de operadores para que pueda inspeccionar individualmente las métricas Bytes Received y Bytes Sent de cada uno. El operador que tenga entrada pero cero en la salida es el causante del problema; los más comunes son JOIN, WINDOW y WHERE.-
Compruebe si la base de datos descendente retiene datos en su búfer de escritura. Reduzca el tamaño de lote del conector descendente para vaciar los datos antes.
ImportanteEvite un tamaño de lote excesivamente pequeño. Un tamaño de lote de 1 implica que Flink envía una solicitud independiente por cada registro procesado, lo cual puede sobrecargar la base de datos descendente cuando hay grandes volúmenes de datos.
Busque interbloqueos en ApsaraDB RDS for MySQL. Consulte Deadlock when writing to MySQL through ApsaraDB RDS or TDDL connector.
Para aislar el problema, imprima los resultados intermedios en los registros mediante una tabla sink de impresión. Consulte View print connector output .
Resultados vacíos al habilitar MiniBatch con consumo parcial de binlog en CDC
-
Síntoma
Un trabajo de CDC comienza a consumir el binlog desde un punto intermedio mediante
latesto un desplazamiento específico, con MiniBatch habilitado. La tabla sink recibe entonces datos parciales o no genera ninguna salida. -
Causa
MiniBatch fusiona y cancela los mensajes de changelog correspondientes a la misma clave primaria dentro de un mismo lote. Cuando el trabajo inicia desde un punto intermedio del binlog, puede recibir un mensaje
UPDATE_AFTERsin suUPDATE_BEFOREcorrespondiente (o viceversa). Los mensajes opuestos se cancelan entre sí dentro del lote y no producen salida, lo que genera datos incorrectos en el sistema descendente. -
Soluciones
Consuma el binlog desde el inicio. Evite los modos de consumo parcial como
latesto un desplazamiento especificado, de modo que se conserve la secuencia completa de cambios para cada registro.Deshabilite MiniBatch para que el trabajo procese los registros uno por uno. Esta opción sacrifica parte del throughput a cambio de garantizar la corrección de los datos.
¿Cómo soluciono problemas de lectura en el origen de Flink?
Si Realtime Compute for Apache Flink no logra leer desde un origen, compruebe lo siguiente.
Conectividad de red
De forma predeterminada, Realtime Compute for Apache Flink solo alcanza servicios en la misma región y virtual private cloud (VPC). Para acceso entre redes:
Entre VPC: How do I access other services across VPCs?
Acceso a Internet: How do I access the Internet?
Lista de permitidos del servicio ascendente
Para leer desde servicios como Kafka y Elasticsearch, agregue su espacio de trabajo de Flink a sus listas de permitidos:
Obtenga el bloque CIDR del vSwitch de su espacio de trabajo de Flink. Consulte How do I configure a whitelist?
Agregue ese bloque CIDR a la lista de permitidos del servicio ascendente. Consulte la sección "Prerequisites" del documento del conector correspondiente, por ejemplo Kafka.
Consistencia de campos entre la tabla de Flink y la tabla física
Las discrepancias en las definiciones de campos son una causa frecuente de errores de lectura. Al escribir la DDL de su tabla de origen en Flink:
Orden de campos: Respete exactamente el mismo orden de campos de la tabla física.
Mayúsculas y minúsculas en nombres de campos: Use las mismas mayúsculas y minúsculas que en la tabla física.
Tipo de campo: Utilice los tipos equivalentes según el mapeo. Revise la sección "Data type mappings" del documento del conector correspondiente, por ejemplo Simple Log Service.
Excepciones en el registro de TaskManager
Compruebe si el registro de TaskManager de la tabla de origen contiene mensajes de excepción:
En el panel de navegación izquierdo, vaya a O&M > Deployment.
Haga clic en el nombre del deployment.
Haga clic en la pestaña Status y luego haga clic en el vértice de origen en el DAG.
En el panel derecho, haga clic en la pestaña SubTasks.
En la columna More, haga clic en el icono
 y elija Open TaskManager Log Page.
En la pestaña Logs, busque la primera entrada que contenga "Caused by", ya que generalmente señala la causa raíz.
¿Cómo soluciono la ausencia de resultados en el sistema descendente?
Realice las siguientes comprobaciones.
Conectividad de red
De forma predeterminada, Realtime Compute for Apache Flink solo alcanza servicios en la misma región y VPC. Para acceso entre redes:
Entre VPC: How do I access other services across VPCs?
Acceso a Internet: How do I access the Internet?
Lista de permitidos del sistema descendente
Para escribir en servicios como ApsaraDB RDS for MySQL, Kafka, Elasticsearch, AnalyticDB for MySQL 3.0, Apache HBase, Redis y ClickHouse, agregue su espacio de trabajo de Flink a sus listas de permitidos:
Obtenga el bloque CIDR del vSwitch de su espacio de trabajo de Flink. Consulte How do I configure a whitelist?
Agregue ese bloque CIDR a la lista de permitidos del servicio descendente. Consulte la sección "Prerequisites" del documento del conector correspondiente, por ejemplo ApsaraDB RDS for MySQL.
Consistencia de campos entre la tabla de Flink y la tabla física
Aplique las mismas comprobaciones descritas en How do I troubleshoot Flink source reading issues?: verifique el orden de los campos, el uso de mayúsculas y minúsculas en los nombres, y los mapeos de tipos de campo.
Datos filtrados por operadores
Revise los conteos de entrada y salida de cada vértice en el DAG del trabajo. Si un vértice como WHERE muestra entrada = 5 y salida = 0, ese operador está descartando todos los registros.
Umbrales de búfer del conector sink demasiado altos
Cuando el volumen de entrada es bajo, los umbrales de búfer predeterminados pueden impedir que los datos se vacíen hacia el sistema descendente, ya que el búfer nunca se llena lo suficiente para desencadenar una escritura. Reduzca las opciones relevantes según sea necesario:
|
Opción |
Descripción |
Servicio descendente relevante |
|
|
Tamaño de los datos escritos en cada operación |
DataHub, Tablestore, MongoDB, ApsaraDB RDS for MySQL, AnalyticDB for MySQL V3.0, ApsaraDB for ClickHouse, TSDB for InfluxDB |
|
|
Número máximo de registros escritos en cada operación |
|
|
|
Intervalo de vaciado del búfer de MaxCompute Tunnel Writer |
|
|
|
Tamaño de los datos almacenados en memoria antes de escribir en HBase, en bytes |
|
|
|
Número de registros almacenados en memoria antes de escribir en HBase |
|
|
|
Intervalo en el que los datos en búfer se vacían periódicamente hacia HBase |
|
|
|
Número máximo de filas procesadas a la vez por un nodo sink de streaming de Hologres al usar un controlador JDBC |
Datos desordenados en ventanas de tiempo de evento
Las marcas de agua determinan qué registros acepta una ventana. Si el primer registro tiene una marca de tiempo de 2100 y establece la marca de agua en 2100, cualquier registro posterior con una marca de tiempo inferior a 2100 (como 2021) se considera tardío y se descarta. La ventana no puede cerrarse hasta que llegue un registro con una marca de tiempo mayor a 2100.
Para detectar registros desordenados, utilice una tabla sink de impresión o examine los registros de Log4j. Consulte Create a print sink table y Configure log output. Si se confirman registros tardíos, fíltrelos o configure su estrategia de marca de agua para permitir un período de gracia para llegadas tardías.
Subtareas de origen sin entrada
Cuando una subtarea de origen no recibe datos, su marca de agua permanece en el valor predeterminado de época (1970-01-01T00:00:00Z), que se convierte en la marca de agua general del operador. Esto impide que las ventanas de tiempo de evento se cierren.
Revise el DAG del trabajo y confirme que todas las subtareas de origen reciben datos. Si alguna subtarea está inactiva, reduzca el paralelismo del trabajo para que coincida con el número de shards de la tabla ascendente, de modo que cada subtarea tenga datos asignados.
Particiones de Kafka vacías
Una partición de Kafka vacía puede detener la generación de marcas de agua. Consulte Why does an event time window produce no output from a Kafka source table?
¿Cómo soluciono la pérdida de datos?
Las reducciones en el volumen de datos suelen deberse a cláusulas WHERE, operaciones JOIN u operaciones con ventanas. Para pérdidas sin causa aparente, compruebe lo siguiente.
Directiva de caché de tabla de dimensiones
Una directiva de caché incorrecta puede provocar fallos en lookup join que descartan registros silenciosamente. Configure una directiva de caché adecuada mediante las opciones relacionadas con la caché en el documento del conector; por ejemplo, la sección "Specific to dimension tables (such as Cache parameters)" en ApsaraDB for Hbase.
Uso de funciones
El uso incorrecto de funciones como to_timestamp_tz y date_format puede causar fallos en la conversión de datos que descartan registros silenciosamente. Verifique el comportamiento de las funciones mediante una tabla sink de impresión o los registros de Log4j. Consulte Print y Configure log output.
Datos desordenados
Los eventos tardíos se descartan cuando su marca de tiempo queda fuera del rango aceptado por la ventana actual. Por ejemplo, un evento con marca de tiempo 11s que ingresa a una ventana de 15–20s se descarta porque su marca de agua es 11, por debajo del límite inferior de la ventana.
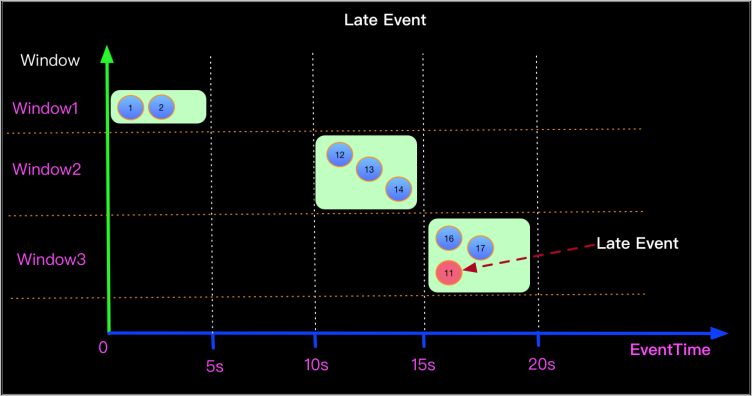
Las pérdidas por esta causa suelen concentrarse en una sola ventana. Utilice una tabla sink de impresión o Log4j para confirmar la presencia de datos desordenados.
Para minimizar las pérdidas por desorden, establezca una estrategia de generación de marcas de agua con un período de gracia (por ejemplo, Watermark = Event time - 5s). Alinee las ventanas a límites exactos de día, hora o minuto; esto hace predecible el comportamiento de la ventana y reduce los descartes en casos extremos cuando se combina con un período de gracia adecuado.
¿Por qué obtengo resultados inexactos al usar ROW_NUMBER para deduplicar datos ingeridos desde Hologres en modo CDC?
SELECT
    hg_binlog_timestamp_us,
    order_id,
    order_name,
    order_pay,
    order_starttime
FROM(
    SELECT
        hg_binlog_lsn,
        hg_binlog_event_type,
        hg_binlog_timestamp_us,
        order_id,
        order_name,
        order_pay,
        order_starttime,
        ROW_NUMBER()
            OVER(
                PARTITION BY
                    order_id
                ORDER BY
                order_starttime desc
            ) as rn
    FROM test_cdc
)
where rn = 1
Suponga que la tabla test_cdc contiene los siguientes datos de ejemplo, donde el pedido con order_id 1001 tiene dos registros de cambio:
hg_binlog_timestamp_us | order_id | order_name | order_pay | order_starttime
1785578400000000       | 1001     | phone      | 3999.00   | 2026-08-01 10:00:00
1785582000000000       | 1001     | phone      | 3599.00   | 2026-08-01 11:00:00
1785578460000000       | 1002     | earphone   | 299.00    | 2026-08-01 10:01:00
Después de ejecutar la sentencia SQL anterior, se espera que los registros se particionen por order_id y se ordenen por order_starttime en orden descendente, conservando solo los registros con rn = 1. Sin embargo, en este escenario anómalo, la deduplicación no surte efecto y el resultado aún contiene ambos registros de cambio del pedido con order_id 1001:
hg_binlog_timestamp_us | order_id | order_name | order_pay | order_starttime
1785578400000000       | 1001     | phone      | 3999.00   | 2026-08-01 10:00:00
1785582000000000       | 1001     | phone      | 3599.00   | 2026-08-01 11:00:00
1785578460000000       | 1002     | earphone   | 299.00    | 2026-08-01 10:01:00
El sistema descendente utiliza un operador de retracción (por ejemplo, ROW_NUMBER OVER WINDOW para deduplicación), pero el origen de Hologres no está configurado para emitir datos en modo upsert. Sin el modo upsert, el origen emite únicamente eventos de inserción que el operador de retracción no puede procesar correctamente.
Agregue 'upsertSource' = 'true' a la cláusula WITH de la sentencia DDL de la tabla de origen.
,'binlog' = 'true'
,'sdkMode' = 'jdbc'
,'cdcMode' = 'true'
,'binlogStartUpMode' = 'initial'
,'jdbcBinlogSlotName' = 'test_cdc_1_replication_slot'
,'binlogMaxRetryTimes' = '10',
'binlogRetryIntervalMs' = '500',
'binlogBatchReadSize' = '100'
,'upsertSource' = 'true'
)
¿Cómo soluciono resultados inexactos?
Habilite operator profiling para inspeccionar resultados intermedios sin modificar la lógica del trabajo.
-
Analice los registros de ejecución:
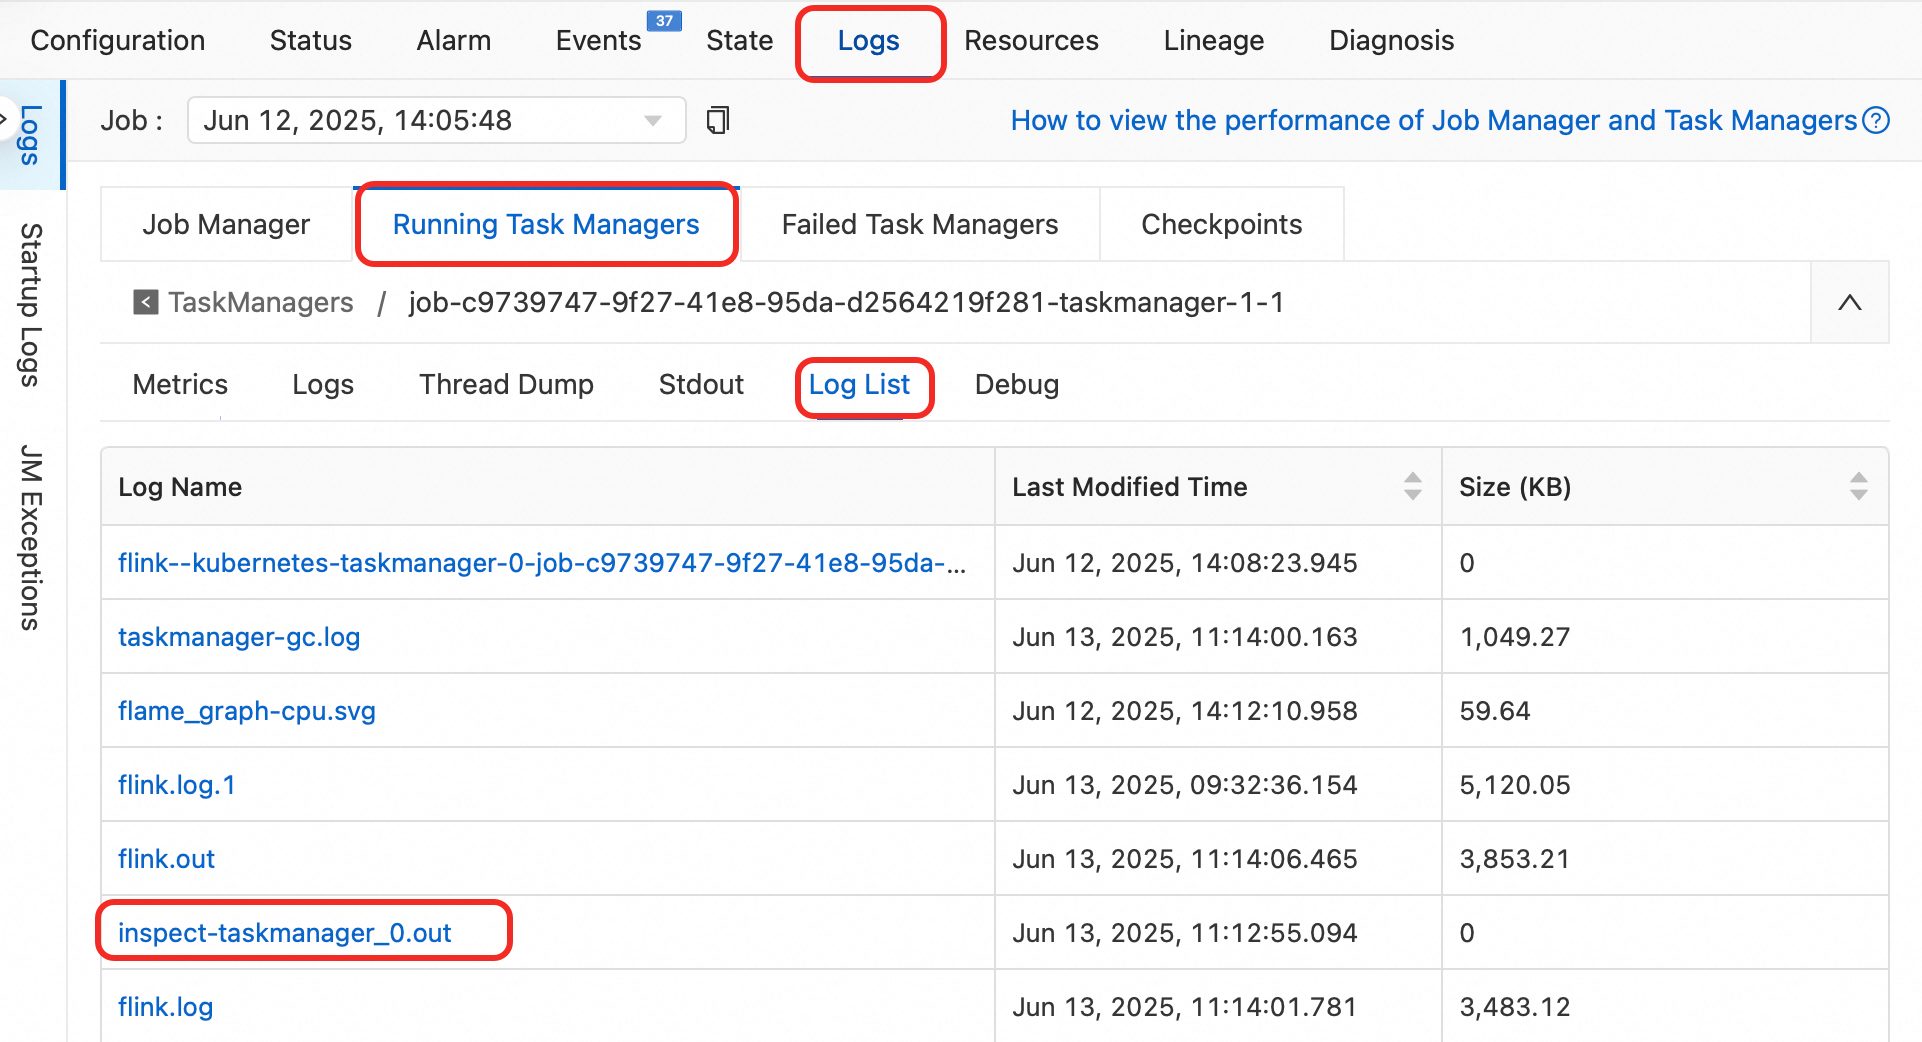
Haga clic en el nombre del deployment y luego en la pestaña Status.
En el DAG, copie el nombre del operador que produce resultados incorrectos.
En la lista de registros, haga clic en
inspect-taskmanager_0.outbajo Log Name y busque el nombre del operador.
Una vez identificada la causa raíz, corrija la lógica del operador, reinicie el trabajo y verifique la precisión de los datos.
¿Cómo corrijo el error "doesn't support consuming update and delete changes which is produced by node TableSourceScan"?
El mensaje de error tiene el siguiente aspecto:
Table sink 'vvp.default.***' doesn't support consuming update and delete changes which is produced by node TableSourceScan(table=[[vvp, default, ***]], fields=[id,b, content])
    at org.apache.flink.table.sqlserver.execution.DelegateOperationExecutor.wrapExecutor(DelegateOperationExecutor.java:286)
    at org.apache.flink.table.sqlserver.execution.DelegateOperationExecutor.validate(DelegateOperationExecutor.java:211)
    at org.apache.flink.table.sqlserver.FlinkSqlServiceImpl.validate(FlinkSqlServiceImpl.java:741)
    at org.apache.flink.table.sqlserver.proto.FlinkSqlServiceGrpc$MethodHandlers.invoke(FlinkSqlServiceGrpc.java:2522)
    at io.grpc.stub.ServerCalls$UnaryServerCallHandler$UnaryServerCallListener.onHalfClose(ServerCalls.java:172)
    at io.grpc.internal.ServerCallImpl$ServerStreamListenerImpl.halfClosed(ServerCallImpl.java:331)
    at io.grpc.internal.ServerImpl$JumpToApplicationThreadServerStreamListener$1HalfClosed.runInContext(ServerImpl.java:820)
    at io.grpc.internal.ContextRunnable.run(ContextRunnable.java:37)
    at io.grpc.internal.SerializingExecutor.run(SerializingExecutor.java:123)
    at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1147)
    at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:622)
    at java.lang.Thread.run(Thread.java:834)
La tabla sink está en modo de solo anexión y no puede consumir eventos de actualización ni eliminación del origen. Reemplácela por un sink que admita upserts, como Upsert Kafka.
¿Cómo corrijo sobrescrituras o eliminaciones inesperadas de datos al usar el conector de Lindorm?
De forma predeterminada, el conector de Lindorm utiliza el operador upsert materialize (valor predeterminado: AUTO) para gestionar el orden de escritura. Este operador genera una operación DELETE seguida de un INSERT para la misma clave primaria. Dos características de Lindorm hacen que esto sea problemático:
Precisión de marca de tiempo en milisegundos: Lindorm versiona los datos mediante marcas de tiempo en milisegundos. Varios registros con la misma clave primaria escritos dentro de un mismo milisegundo pueden llegar desordenados y causar conflictos de versión.
Sin soporte nativo para DELETE: Lindorm solo admite semántica UPSERT; las eliminaciones son irreversibles. Por lo tanto, la lógica de mantenimiento de orden de
upsert materializeresulta ineficaz y puede provocar anomalías en los datos debido a la secuencia DELETE + INSERT.
Cuando escrituras concurrentes ocurren dentro del mismo milisegundo, las operaciones DELETE e INSERT resultantes pueden producir datos incorrectos o pérdida silenciosa de datos.
Solución: Deshabilite explícitamente el operador upsert materialize agregando lo siguiente a la configuración de parámetros de ejecución de su trabajo o al código SQL:
SET 'table.exec.sink.upsert-materialize' = 'NONE';Esta configuración aplica a cualquier trabajo que escriba en Lindorm a través de Flink.
Después de deshabilitar este operador, solo se garantiza consistencia eventual. Confirme que la consistencia eventual es aceptable para su caso de uso antes de aplicar este cambio.