Los almacenes de datos tradicionales sin conexión procesan los cambios en ciclos por lotes, generalmente cada hora o cada día. Por esta razón, los consumidores de datos siempre trabajan con información desactualizada y cada actualización requiere sobrescribir particiones que reprocesan grandes volúmenes de registros. Este tutorial le muestra cómo reemplazar ese modelo con una canalización de streaming que utiliza Data Lake Formation (DLF), Realtime Compute for Apache Flink y EMR Serverless StarRocks para ofrecer datos actualizados al minuto en todas las capas del almacén.
Lo que construirá:
Una capa ODS que ingiere los cambios sin procesar de una base de datos MySQL mediante Change Data Capture (CDC).
Una capa DWD que une y desnormaliza las tablas de origen en una tabla ancha (
dwd_orders) con propagación de changelog al minuto.Una capa DWS con dos tablas de métricas agregadas (
dws_usersydws_shops) construidas a través de una tabla DWM intermedia.Consultas de StarRocks sobre las capas DWS y DWD: clasificaciones, detalles de pedidos e informes por categoría.
Cómo funciona
Flink lee el binlog de MySQL mediante CDC y escribe los registros a través de tres capas de almacén respaldadas por Paimon. Cada capa emite changelogs que la siguiente capa consume, por lo que los cambios se propagan de extremo a extremo en cuestión de minutos.
Flink lee el binlog de MySQL mediante CDC y escribe los registros sin procesar en Paimon para formar la capa ODS.
Flink se suscribe a los changelogs de ODS, une y limpia los datos, y escribe una tabla ancha en Paimon como la capa DWD.
Flink se suscribe a los changelogs de DWD, agrega las métricas y escribe tablas de resumen en Paimon como la capa DWS.
StarRocks se conecta al catálogo Paimon de DLF y consulta directamente las capas DWD y DWS.
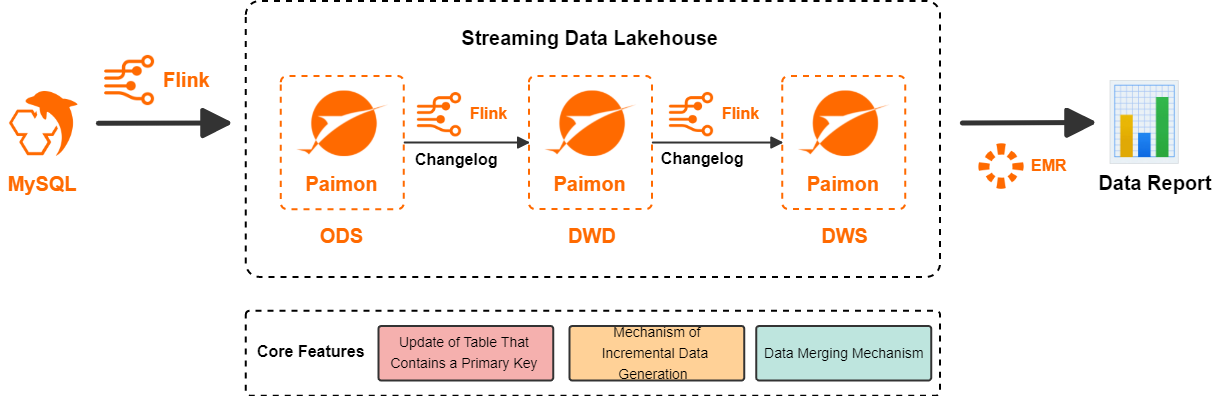
El elemento clave es Apache Paimon, que DLF utiliza como su formato de almacenamiento de lago unificado. Paimon ofrece tres capacidades que hacen posible esta arquitectura:
|
Paimon capability |
How it helps |
|
Actualizaciones de tablas de clave primaria |
Utiliza Log-structured Merge-tree (LSM) en la capa de almacenamiento para realizar upserts eficientes. Consulte Primary key table y File layouts. |
|
Productor de changelog |
Genera pares completos de |
|
Motor de fusión |
Fusiona varios registros con la misma clave primaria mediante estrategias configurables: deduplicación, actualización parcial o agregación. Consulte Merge engine. |
Cada capa del almacén propaga los cambios a la siguiente en cuestión de minutos. Los datos de cada capa se pueden consultar y corregir directamente sin sobrescribir particiones. Además, toda la canalización de extracción, transformación y carga (ETL) se expresa en Flink SQL, lo que reduce la complejidad arquitectónica.
Para obtener una descripción general completa de los beneficios del producto, consulte Benefits.
Requisitos previos
Antes de empezar, compruebe que cuenta con lo siguiente:
DLF activado. Consulte Get started with DLF.
Realtime Compute for Apache Flink activado. Consulte Activate Realtime Compute for Apache Flink.
EMR Serverless StarRocks activado con la arquitectura de separación de almacenamiento y cómputo. Consulte Get started with a Serverless StarRocks instance.
Si utiliza un usuario o rol de Resource Access Management (RAM), permisos de lectura y escritura sobre los datos de DLF. Consulte Manage data permissions.
La instancia de StarRocks, DLF y el espacio de trabajo de Flink deben estar en la misma región.
Limitaciones
Solo Ververica Runtime (VVR) 11.1.0 y versiones posteriores admiten esta solución de lakehouse de streaming.
Paso 1: Prepare un origen de datos CDC de MySQL
Cree una base de datos y tres tablas de negocio en una instancia de ApsaraDB RDS for MySQL. Este ejemplo utiliza un escenario de comercio electrónico con pedidos, registros de pago y categorías de productos.
-
Cree una instancia de ApsaraDB RDS for MySQL.
Si la instancia de RDS y su espacio de trabajo de Flink están en distintas VPC, configure primero la conectividad de VPC. Consulte How does Realtime Compute for Apache Flink access a service across VPCs?
Cree una base de datos y una cuenta. Cree una base de datos llamada
order_dwy una cuenta con privilegios, o bien una cuenta estándar con permisos de lectura y escritura sobreorder_dw.-
Cree las tres tablas de origen e inserte datos de ejemplo:
CREATE TABLE `orders` (
  order_id bigint not null primary key,
  user_id varchar(50) not null,
  shop_id bigint not null,
  product_id bigint not null,
  buy_fee bigint not null,
  create_time timestamp not null,
  update_time timestamp not null default now(),
  state int not null
);

CREATE TABLE `orders_pay` (
  pay_id bigint not null primary key,
  order_id bigint not null,
  pay_platform int not null,
  create_time timestamp not null
);

CREATE TABLE `product_catalog` (
  product_id bigint not null primary key,
  catalog_name varchar(50) not null
);

-- Insert sample data
INSERT INTO product_catalog VALUES(1, 'phone_aaa'),(2, 'phone_bbb'),(3, 'phone_ccc'),(4, 'phone_ddd'),(5, 'phone_eee');

INSERT INTO orders VALUES
(100001, 'user_001', 12345, 1, 5000, '2023-02-15 16:40:56', '2023-02-15 18:42:56', 1),
(100002, 'user_002', 12346, 2, 4000, '2023-02-15 15:40:56', '2023-02-15 18:42:56', 1),
(100003, 'user_003', 12347, 3, 3000, '2023-02-15 14:40:56', '2023-02-15 18:42:56', 1),
(100004, 'user_001', 12347, 4, 2000, '2023-02-15 13:40:56', '2023-02-15 18:42:56', 1),
(100005, 'user_002', 12348, 5, 1000, '2023-02-15 12:40:56', '2023-02-15 18:42:56', 1),
(100006, 'user_001', 12348, 1, 1000, '2023-02-15 11:40:56', '2023-02-15 18:42:56', 1),
(100007, 'user_003', 12347, 4, 2000, '2023-02-15 10:40:56', '2023-02-15 18:42:56', 1);

INSERT INTO orders_pay VALUES
(2001, 100001, 1, '2023-02-15 17:40:56'),
(2002, 100002, 1, '2023-02-15 17:40:56'),
(2003, 100003, 0, '2023-02-15 17:40:56'),
(2004, 100004, 0, '2023-02-15 17:40:56'),
(2005, 100005, 0, '2023-02-15 18:40:56'),
(2006, 100006, 0, '2023-02-15 18:40:56'),
(2007, 100007, 0, '2023-02-15 18:40:56');
Paso 2: Configure los metadatos en Flink
Cree un catálogo de Paimon
Inicie sesión en la consola de Realtime Compute for Apache Flink.
En el panel de navegación izquierdo, seleccione Metadata Management y haga clic en Create Catalog.
En la pestaña Built-in Catalog, haga clic en Apache Paimon y luego en Next.
-
Configure los siguientes parámetros, elija DLF como clase de almacenamiento y haga clic en OK.
Configuration item
Description
Required
Remarks
metastoreTipo de metastore.
Sí
Utilice
dlf.catalog nameNombre del catálogo de datos de DLF.
Sí
Seleccione un catálogo existente. Para crear uno, consulte Data catalog. Este ejemplo utiliza un catálogo llamado
paimoncatalog. -
Cree la base de datos
order_dwen el catálogo. En el panel de navegación izquierdo, seleccione Data Query > Query Script y haga clic en New para abrir una consulta temporal. Ejecute lo siguiente:-- Switch to the paimoncatalog data source USE CATALOG paimoncatalog; -- Create the target database CREATE DATABASE order_dw;El mensaje
The following statement has been executed successfully!confirma que la base de datos se creó correctamente.
Para obtener más información, consulte Manage a Paimon catalog.
Cree un catálogo de MySQL
En la página Metadata Management, haga clic en Create Catalog.
En la pestaña Built-in Catalog, haga clic en MySQL y luego en Next.
-
Introduzca los siguientes parámetros y haga clic en OK. Con esto se crea un catálogo llamado
mysqlcatalog.Configuration item
Description
Required
Remarks
catalog nameNombre del catálogo.
Sí
Este ejemplo utiliza
mysqlcatalog.hostnameDirección IP o nombre de host de la instancia de MySQL.
Sí
Utilice la dirección de red interna si la instancia de RDS y el espacio de trabajo de Flink comparten la misma VPC. Consulte View and manage endpoints and port numbers.
portPuerto del servicio de MySQL. Valor predeterminado:
3306.No
default-databaseBase de datos predeterminada de MySQL.
Sí
Utilice
order_dw.usernameNombre de usuario de la cuenta de MySQL.
Sí
La cuenta creada en el paso 1.
passwordContraseña de la cuenta de MySQL.
Sí
La contraseña de la cuenta creada en el paso 1.
Paso 3: Construya la capa ODS
La capa ODS ingiere en tiempo real todas las tablas de la base de datos MySQL order_dw hacia Paimon mediante una canalización CDC de Flink. Una sola definición de canalización gestiona las tres tablas sin necesidad de conectores de origen individuales para cada una.
En la consola de desarrollo de Flink, seleccione Development > ETL en el panel de navegación izquierdo. Haga clic en + > New Blank Stream Draft. En el cuadro de diálogo New Draft, introduzca
odsen el campo Name y haga clic en Create.-
En el editor SQL, pegue la siguiente configuración de canalización:
Parameter
Description
Required
Example
catalog.properties.metastoreTipo de metastore. Establézcalo en
rest.Sí
restcatalog.properties.token.providerProveedor de token. Establézcalo en
dlf.Sí
dlfcatalog.properties.uriEndpoint del servidor de DLF. Formato:
http://[region-id]-vpc.dlf.aliyuncs.com. Consulte Endpoints.Sí
http://ap-southeast-5-vpc.dlf.aliyuncs.comcatalog.properties.warehouseNombre del catálogo de DLF.
Sí
paimoncatalogsource: type: mysql name: MySQL Source hostname: rm-bp1e********566g.mysql.rds.aliyuncs.com port: 3306 username: ${secret_values.username} password: ${secret_values.password} tables: order_dw\.\.* # Sync all tables in the order_dw database sink: type: paimon name: Paimon Sink catalog.properties.metastore: rest catalog.properties.uri: http://ap-southeast-5-vpc.dlf.aliyuncs.com catalog.properties.warehouse: paimoncatalog catalog.properties.token.provider: dlf pipeline: name: MySQL to Paimon PipelineReemplace los parámetros del sink de Paimon con sus valores reales. Para ajustar el rendimiento de escritura, consulte Performance optimization.
Haga clic en Deploy en la esquina superior derecha.
En el panel de navegación izquierdo, seleccione O&M > Deployments. Busque el despliegue
odsy haga clic en Start en la columna Actions. En el panel Start Job, seleccione Initial Mode y haga clic en Start.
Compruebe la capa ODS: en el panel de navegación izquierdo, seleccione Development > Scripts. Haga clic en + > New Script. Ejecute la siguiente consulta para confirmar que los datos fluyen desde MySQL hacia Paimon:
SELECT * FROM paimoncatalog.order_dw.orders ORDER BY order_id;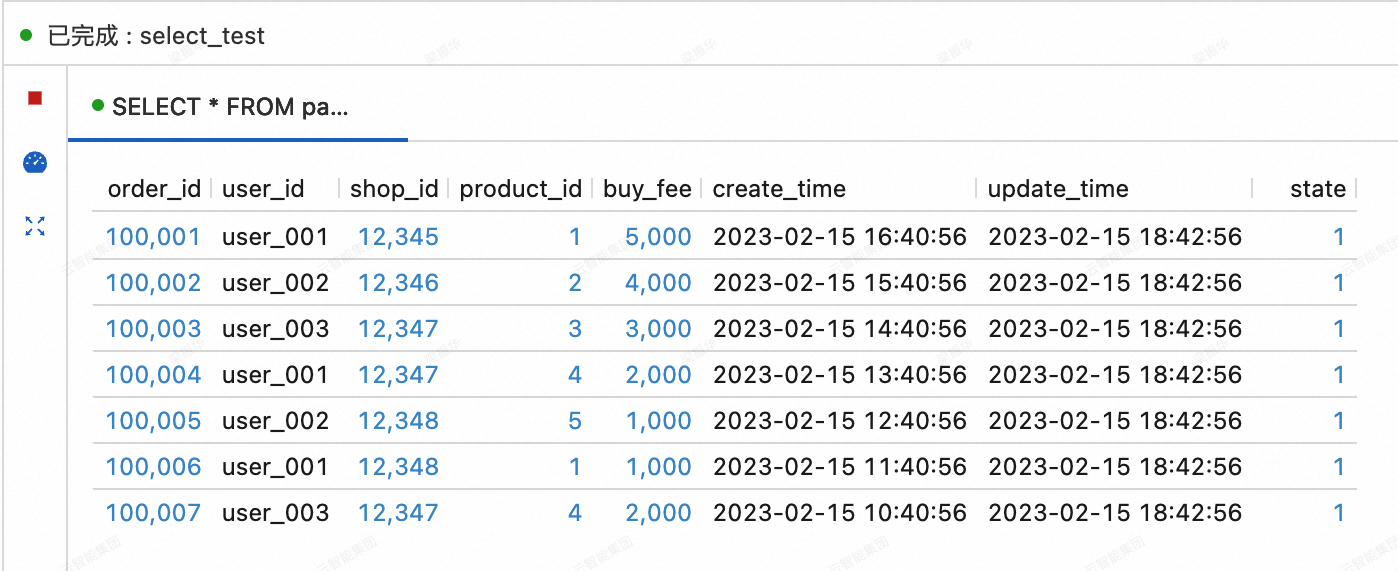
Paso 4: Construya la capa DWD
La capa DWD fusiona las tablas orders, orders_pay y product_catalog en una sola tabla ancha (dwd_orders). Como estas tablas llegan como flujos independientes, la tabla ancha utiliza el motor de fusión partial-update: cada flujo escribe únicamente las columnas que le corresponden y Paimon fusiona los registros parciales con el mismo order_id en una fila completa. Después, el productor de changelog lookup emite pares update_before/update_after para que la capa DWS consuma los cambios incrementales con baja latencia.
Cree la tabla ancha
En la consola de desarrollo de Flink, seleccione Development > Scripts. Haga clic en + > New Script. Ejecute el siguiente DDL:
CREATE TABLE paimoncatalog.order_dw.dwd_orders (
    order_id BIGINT,
    order_user_id STRING,
    order_shop_id BIGINT,
    order_product_id BIGINT,
    order_product_catalog_name STRING,
    order_fee BIGINT,
    order_create_time TIMESTAMP,
    order_update_time TIMESTAMP,
    order_state INT,
    pay_id BIGINT,
    pay_platform INT COMMENT 'platform 0: phone, 1: pc',
    pay_create_time TIMESTAMP,
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'merge-engine' = 'partial-update', -- Merge partial records from multiple source streams into one wide row
    'changelog-producer' = 'lookup'    -- Generate low-latency changelogs for downstream consumption
);
El mensaje Query has been executed confirma que la tabla se creó correctamente.
Inicie el trabajo de streaming de DWD
En el panel de navegación izquierdo, seleccione Development > ETL. Haga clic en + > New Blank Stream Draft, asigne el nombre dwd al borrador y pegue el siguiente código SQL. Despliegue el borrador e inicie el despliegue del trabajo con estados iniciales.
El trabajo utiliza UNION ALL para ejecutar dos flujos de manera simultánea: une orders con product_catalog como búsqueda de dimensión y transmite orders_pay de forma independiente. Ambos flujos escriben en dwd_orders, y el motor de fusión partial-update de Paimon ensambla la fila ancha completa cuando llegan registros con el mismo order_id.
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3';
SET 'table.exec.sink.upsert-materialize' = 'NONE';
SET 'execution.checkpointing.interval' = '10s';
SET 'execution.checkpointing.min-pause' = '10s';

-- Paimon does not allow multiple INSERT statements targeting the same table
-- in the same deployment. Use UNION ALL instead.
INSERT INTO paimoncatalog.order_dw.dwd_orders
SELECT
    o.order_id,
    o.user_id,
    o.shop_id,
    o.product_id,
    dim.catalog_name,
    o.buy_fee,
    o.create_time,
    o.update_time,
    o.state,
    NULL,  -- pay_id (populated by orders_pay stream)
    NULL,  -- pay_platform
    NULL   -- pay_create_time
FROM
    paimoncatalog.order_dw.orders o
    LEFT JOIN paimoncatalog.order_dw.product_catalog FOR SYSTEM_TIME AS OF proctime() AS dim
    ON o.product_id = dim.product_id
UNION ALL
SELECT
    order_id,
    NULL, NULL, NULL, NULL, NULL, NULL, NULL, NULL,  -- order columns (populated by orders stream)
    pay_id,
    pay_platform,
    create_time
FROM
    paimoncatalog.order_dw.orders_pay;
Compruebe la capa DWD: en el panel de navegación izquierdo, seleccione Development > Scripts. Haga clic en + > New Script. Ejecute lo siguiente:
SELECT * FROM paimoncatalog.order_dw.dwd_orders ORDER BY order_id;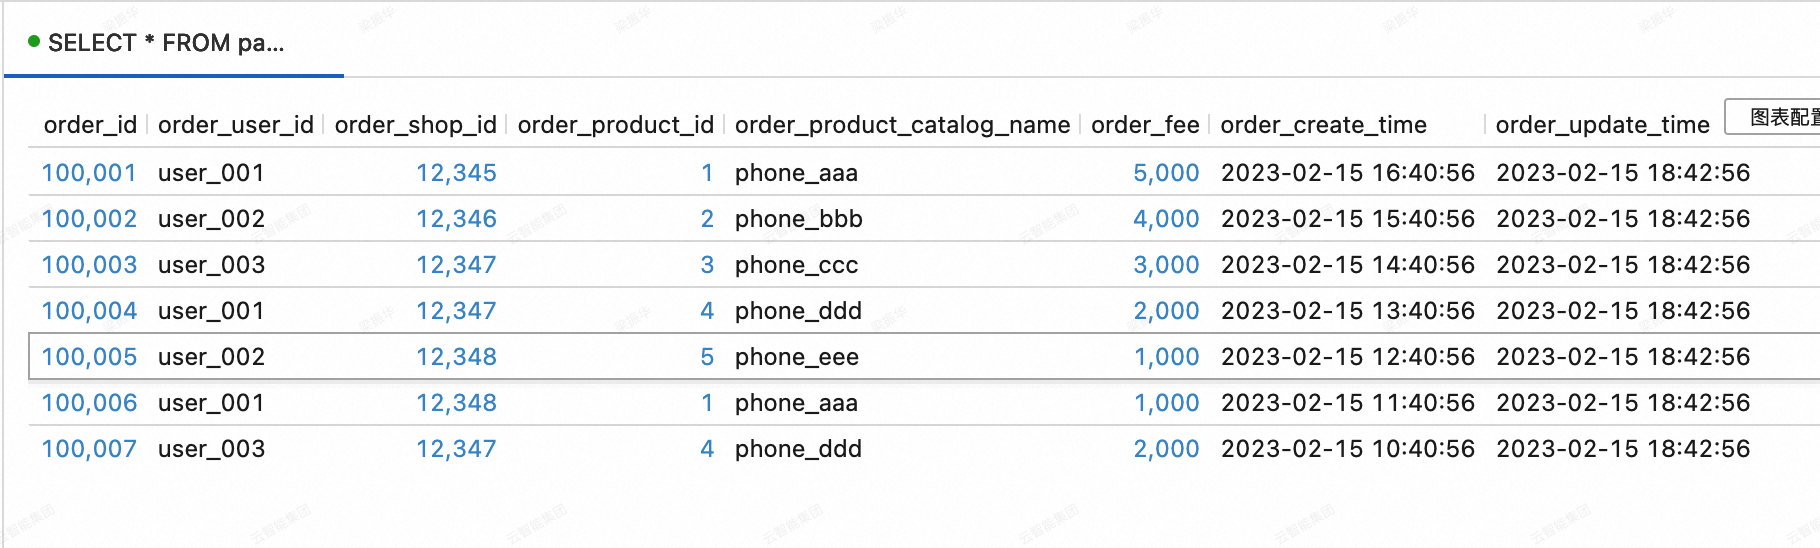
Paso 5: Construya la capa DWS
La capa DWS calcula dos tablas de métricas agregadas: totales por usuario (dws_users) y totales por tienda (dws_shops). Lo hace a través de una tabla DWM intermedia (dwm_users_shops). Las tres tablas utilizan el motor de fusión aggregation, que acumula los valores entrantes mediante funciones de agregación configuradas en lugar de sobrescribir filas.
Las tablas DWS son consultadas por StarRocks en reposo y no necesitan emitir changelogs a consumidores de streaming posteriores, por lo que no requieren changelog-producer. La tabla intermedia dwm_users_shops sí emite changelogs para que los cambios se propaguen a ambas tablas DWS.
Cree las tablas DWS y DWM
En el panel de navegación izquierdo, seleccione Development > Scripts. Haga clic en + > New Script. Ejecute el siguiente DDL:
-- User-dimension aggregate metric table
CREATE TABLE paimoncatalog.order_dw.dws_users (
    user_id STRING,
    ds STRING,
    payed_buy_fee_sum BIGINT COMMENT 'Total payment amount completed on the current day',
    PRIMARY KEY (user_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation',
    'fields.payed_buy_fee_sum.aggregate-function' = 'sum'
    -- No changelog-producer needed: dws_users is queried by StarRocks, not consumed as a stream
);

-- Shop-dimension aggregate metric table
CREATE TABLE paimoncatalog.order_dw.dws_shops (
    shop_id BIGINT,
    ds STRING,
    payed_buy_fee_sum BIGINT COMMENT 'Total payment amount completed on the current day',
    uv BIGINT COMMENT 'Total number of users that made purchases on the current day',
    pv BIGINT COMMENT 'Total number of purchases made on the current day',
    PRIMARY KEY (shop_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation',
    'fields.payed_buy_fee_sum.aggregate-function' = 'sum',
    'fields.uv.aggregate-function' = 'sum',
    'fields.pv.aggregate-function' = 'sum'
    -- No changelog-producer needed: dws_shops is queried by StarRocks, not consumed as a stream
);

-- Intermediate DWM table: aggregates by (user_id, shop_id) and emits changelogs to both DWS tables
CREATE TABLE paimoncatalog.order_dw.dwm_users_shops (
    user_id STRING,
    shop_id BIGINT,
    ds STRING,
    payed_buy_fee_sum BIGINT COMMENT 'Total amount paid by this user in this shop on the current day',
    pv BIGINT COMMENT 'Number of purchases made by this user in this shop on the current day',
    PRIMARY KEY (user_id, shop_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation',
    'fields.payed_buy_fee_sum.aggregate-function' = 'sum',
    'fields.pv.aggregate-function' = 'sum',
    'changelog-producer' = 'lookup',  -- Emit changelogs so dws_users and dws_shops can consume incrementally
    'file.format' = 'avro',           -- Row-oriented format for better write throughput on the intermediate table
    'metadata.stats-mode' = 'none'    -- Skip statistical metadata to reduce write cost (no impact on stream processing)
);
El mensaje Query has been executed confirma que las tablas se crearon correctamente.
Llene la tabla DWM a partir de los changelogs de DWD
En el panel de navegación izquierdo, seleccione Development > ETL. Haga clic en + > New Blank Stream Draft, asigne el nombre dwm al borrador y pegue el siguiente código SQL. Despliéguelo e inícielo con estados iniciales.
Este trabajo lee desde dwd_orders, filtra los registros sin datos de pago y acumula las métricas por usuario y tienda en dwm_users_shops.
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3';
SET 'table.exec.sink.upsert-materialize' = 'NONE';
SET 'execution.checkpointing.interval' = '10s';
SET 'execution.checkpointing.min-pause' = '10s';

INSERT INTO paimoncatalog.order_dw.dwm_users_shops
SELECT
    order_user_id,
    order_shop_id,
    DATE_FORMAT(pay_create_time, 'yyyyMMdd') AS ds,
    order_fee,
    1  -- Each input record counts as one purchase
FROM paimoncatalog.order_dw.dwd_orders
WHERE pay_id IS NOT NULL AND order_fee IS NOT NULL;
Llene las tablas DWS a partir de los changelogs de DWM
En el panel de navegación izquierdo, seleccione Development > ETL. Haga clic en + > New Blank Stream Draft, asigne el nombre dws al borrador y pegue el siguiente código SQL. Despliéguelo e inícielo con estados iniciales.
A diferencia de la capa DWD, en un mismo despliegue se permiten varias instrucciones INSERT dirigidas a distintas tablas de Paimon. La inserción en dws_shops usa la sugerencia local-merge-buffer-size para preagregar los registros en memoria antes de escribirlos en Paimon, lo que reduce el sesgo de datos en tiendas con mucho tráfico.
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3';
SET 'table.exec.sink.upsert-materialize' = 'NONE';
SET 'execution.checkpointing.interval' = '10s';
SET 'execution.checkpointing.min-pause' = '10s';

BEGIN STATEMENT SET;

INSERT INTO paimoncatalog.order_dw.dws_users
SELECT
    user_id,
    ds,
    payed_buy_fee_sum
FROM paimoncatalog.order_dw.dwm_users_shops;

-- Use local merge to pre-aggregate in memory before writing to Paimon.
-- This reduces data skew for popular shops that receive disproportionately high write volumes.
INSERT INTO paimoncatalog.order_dw.dws_shops /*+ OPTIONS('local-merge-buffer-size' = '64mb') */
SELECT
    shop_id,
    ds,
    payed_buy_fee_sum,
    1,   -- Each input record represents one unique user-shop combination
    pv
FROM paimoncatalog.order_dw.dwm_users_shops;

END;
Compruebe la capa DWS: en el panel de navegación izquierdo, seleccione Development > Scripts. Haga clic en + > New Script. Ejecute lo siguiente:
-- Check user aggregate metrics
SELECT * FROM paimoncatalog.order_dw.dws_users ORDER BY user_id;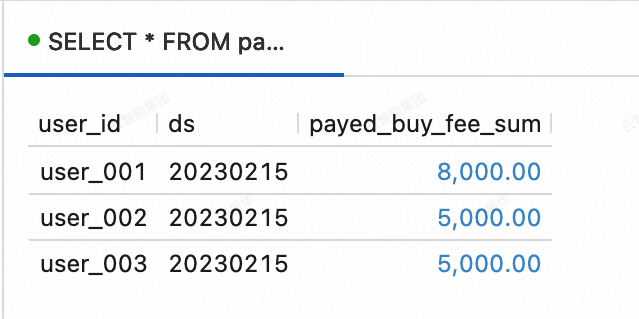
-- Check shop aggregate metrics
SELECT * FROM paimoncatalog.order_dw.dws_shops ORDER BY shop_id;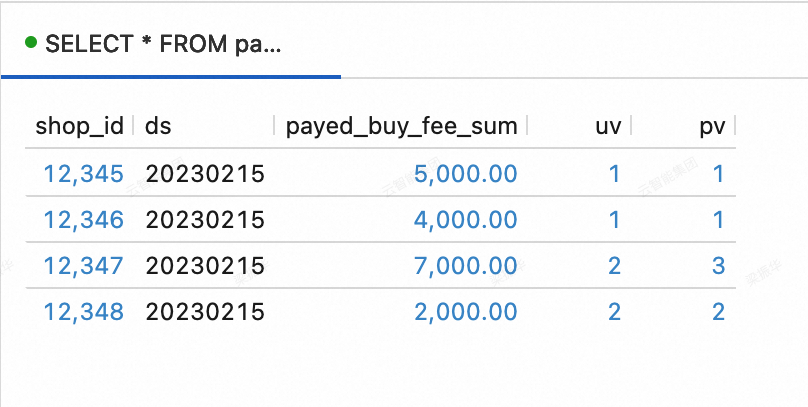
Pruebe la propagación de cambios
Inserte nuevos registros en MySQL y compruebe que los cambios fluyen por todas las capas en cuestión de minutos.
-
Inserte pedidos adicionales en la base de datos
order_dw:INSERT INTO orders VALUES (100008, 'user_001', 12345, 3, 3000, '2023-02-15 17:40:56', '2023-02-15 18:42:56', 1), (100009, 'user_002', 12348, 4, 1000, '2023-02-15 18:40:56', '2023-02-15 19:42:56', 1), (100010, 'user_003', 12348, 2, 2000, '2023-02-15 19:40:56', '2023-02-15 20:42:56', 1); INSERT INTO orders_pay VALUES (2008, 100008, 1, '2023-02-15 18:40:56'), (2009, 100009, 1, '2023-02-15 19:40:56'), (2010, 100010, 0, '2023-02-15 20:40:56'); -
Espere unos minutos para que la canalización propague los cambios. Luego, consulte las tablas DWS:
SELECT * FROM paimoncatalog.order_dw.dws_users ORDER BY user_id;SELECT * FROM paimoncatalog.order_dw.dws_shops ORDER BY shop_id;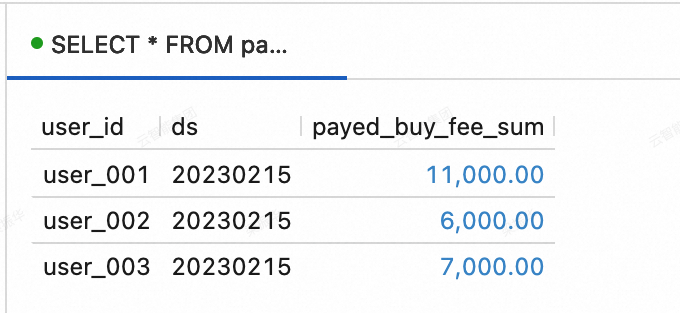
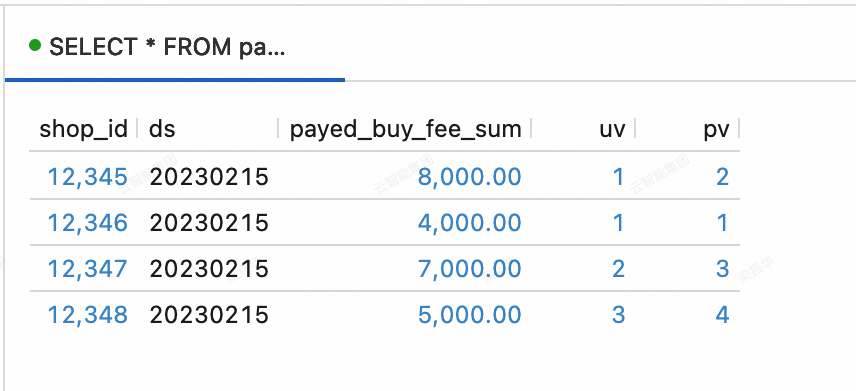
Los totales actualizados de user_001, user_002 y user_003 confirman que la propagación de changelogs de extremo a extremo funciona correctamente.
Paso 6: Conecte StarRocks al lakehouse
Flink ya escribió los datos de MySQL en el catálogo Paimon de DLF. StarRocks se conecta a estos datos y los consulta mediante un catálogo externo de Paimon.
Para conocer todos los pasos de integración entre StarRocks y el catálogo Paimon de DLF, consulte EMR Serverless StarRocks
Paso 7: Consulte el lakehouse con StarRocks
Consulta de clasificación
Busque las tres tiendas principales por volumen de transacciones el 15 de febrero de 2023:
SELECT ROW_NUMBER() OVER (ORDER BY payed_buy_fee_sum DESC) AS rn, shop_id, payed_buy_fee_sum
FROM paimoncatalog.order_dw.dws_shops
WHERE ds = '20230215'
ORDER BY rn LIMIT 3;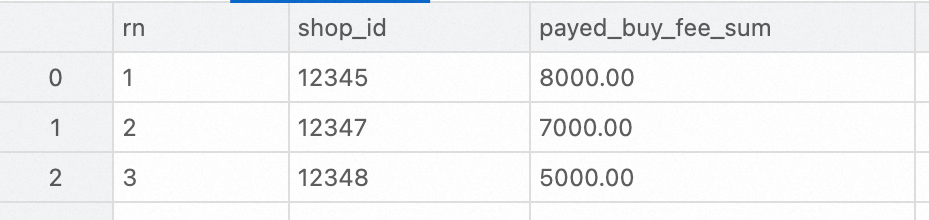
Consulta de detalles
Recupere todos los pedidos realizados por user_001 desde un celular (pay_platform = 0) en febrero de 2023:
SELECT * FROM paimoncatalog.order_dw.dwd_orders
WHERE order_create_time >= '2023-02-01 00:00:00' AND order_create_time < '2023-03-01 00:00:00'
AND order_user_id = 'user_001'
AND pay_platform = 0
ORDER BY order_create_time;
Consulta de informe
Obtenga el conteo total de pedidos y los ingresos por categoría de producto para febrero de 2023:
SELECT
  order_create_time AS order_create_date,
  order_product_catalog_name,
  COUNT(*),
  SUM(order_fee)
FROM
  paimoncatalog.order_dw.dwd_orders
WHERE
  order_create_time >= '2023-02-01 00:00:00' AND order_create_time < '2023-03-01 00:00:00'
GROUP BY
  order_create_date, order_product_catalog_name
ORDER BY
  order_create_date, order_product_catalog_name;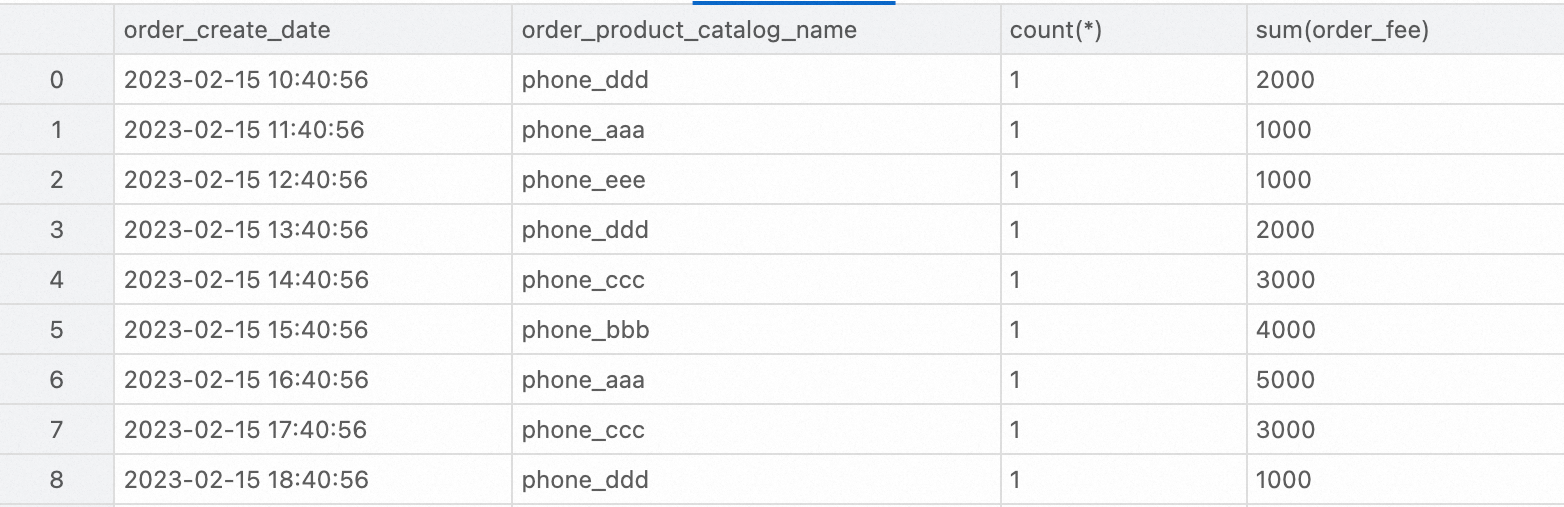
Pasos siguientes
Performance optimization: ajuste las propiedades de las tablas de Paimon para lograr un mayor throughput de escritura.
Manage a Paimon catalog: conozca las operaciones de gestión de catálogos en Flink.
Changelog producer: explore otras estrategias de productor de changelog además de
lookup.Merge engine: conozca el conjunto completo de estrategias de fusión disponibles en Paimon.