Este tema describe cómo utilizar el servicio de transmisión de datos para sincronizar información desde una base de datos OceanBase hacia una instancia de Kafka.
Contexto
Kafka es una plataforma distribuida de cómputo en streaming de alto rendimiento y uso extendido. El servicio de transmisión de datos admite la sincronización de datos en tiempo real entre una instancia de Kafka autogestionada y una base de datos OceanBase en modo compatible con Oracle o MySQL, lo que amplía la capacidad de procesamiento de mensajes. Por esta razón, el servicio de transmisión de datos se aplica ampliamente en escenarios empresariales como la construcción de almacenes de datos en tiempo real, consultas de datos y distribución de informes.
Requisitos previos
El servicio de transmisión de datos cuenta con los privilegios necesarios para acceder a los recursos en la nube. Para obtener más información, consulte Grant privileges to roles for data transmission.
Ha creado un usuario de base de datos dedicado para la sincronización de datos en la base de datos OceanBase de origen y le ha otorgado los privilegios correspondientes. Para obtener más información, consulte Create a database user.
Limitaciones
Solo se pueden sincronizar tablas físicas.
El servicio de transmisión de datos es compatible con Kafka 0.9, 1.0 y 2.x.
Durante la sincronización de datos, si cambia el nombre de una tabla de origen que se está sincronizando y el nuevo nombre queda fuera del alcance de la sincronización, los datos de dicha tabla no se sincronizarán con la instancia de Kafka de destino.
El nombre de la tabla que se va a sincronizar, así como los nombres de sus columnas, no deben contener caracteres chinos.
El servicio de transmisión de datos solo admite la migración de un objeto cuando se cumplen las siguientes condiciones: el nombre de la base de datos, el nombre de la tabla y el nombre de la columna del objeto tienen codificación ASCII sin caracteres especiales. Los caracteres especiales incluyen saltos de línea, espacios y los siguientes símbolos: . | " ' ` ( ) = ; / & \.
El servicio de transmisión de datos no admite una base de datos OceanBase en espera como origen.
Consideraciones
En una tarea de sincronización de datos donde el origen es una base de datos OceanBase y la sincronización DDL está habilitada, si se ejecuta una operación
RENAMEen una tabla de la base de datos de origen, se recomienda reiniciar la tarea para evitar la pérdida de datos durante la sincronización incremental.Si utiliza OceanBase Database V4.x y ha seleccionado la sincronización incremental, debe especificar el atributo STORED para una columna generada. If you do not specify this attribute, no information about the generated column is stored in the incremental logs, which may result in data errors in incremental synchronization.
-
Tenga en cuenta las siguientes consideraciones cuando una fila actualizada contiene una columna de objeto grande (LOB):
-
Si se actualiza la columna LOB, no utilice el valor almacenado en dicha columna antes de la operación
UPDATEoDELETE.Los siguientes tipos de datos se almacenan en columnas LOB: JSON, GIS, XML, tipo definido por el usuario (UDT) y TEXT, como LONGTEXT y MEDIUMTEXT.
Si la columna LOB no se actualiza, el valor almacenado en ella antes y después de la operación
UPDATEoDELETEserá NULL.
-
-
Si los relojes entre nodos o entre el cliente y el servidor no están sincronizados, la latencia puede ser inexacta durante la sincronización incremental.
Por ejemplo, si el reloj está atrasado respecto a la hora estándar, la latencia puede ser negativa. Si el reloj está adelantado, la latencia puede ser positiva.
Cuando se reanuda la transferencia de datos de una tarea, algunos datos (del último minuto) pueden duplicarse en la instancia de Kafka. Por lo tanto, es necesaria la deduplicación en los sistemas posteriores.
Al sincronizar datos de una base de datos OceanBase a una instancia de Kafka, si falla la ejecución de la sentencia para crear un índice único en el origen, la instancia de Kafka consumirá las sentencias DDL de creación y eliminación del índice único. Si falla la ejecución de la sentencia DDL de creación del índice único en el sistema posterior, ignore esta excepción.
-
Si selecciona únicamente Incremental Synchronization al crear la tarea de sincronización de datos, el servicio de transmisión de datos requiere que los registros incrementales locales de la base de datos de origen se conserven durante al menos 48 horas.
Si selecciona Full Synchronization e Incremental Synchronization al crear la tarea de sincronización de datos, el servicio de transmisión de datos requiere que los registros incrementales locales de la base de datos de origen se conserven durante al menos siete días. De lo contrario, la tarea de sincronización podría fallar o los datos en el origen y el destino podrían ser inconsistentes porque el servicio no podrá obtener los registros incrementales.
Tipos de instancias de origen y destino compatibles
En la siguiente tabla, OB_MySQL representa una base de datos OceanBase en modo compatible con MySQL, y OB_Oracle representa una base de datos OceanBase en modo compatible con Oracle.
|
Origen |
Destino |
|
OB_MySQL (instancia de clúster OceanBase) |
Kafka (instancia de Kafka en Alibaba Cloud) |
|
OB_MySQL (instancia de clúster OceanBase) |
Kafka (instancia de Kafka autogestionada en una VPC) |
|
OB_MySQL (instancia de clúster OceanBase) |
Kafka (instancia de Kafka en la red pública) |
|
OB_MySQL (instancia serverless) |
Kafka (instancia de Kafka en Alibaba Cloud) |
|
OB_MySQL (instancia serverless) |
Kafka (instancia de Kafka autogestionada en una VPC) |
|
OB_MySQL (instancia serverless) |
Kafka (instancia de Kafka en la red pública) |
|
OB_Oracle (instancia de clúster OceanBase) |
Kafka (instancia de Kafka en Alibaba Cloud) |
|
OB_Oracle (instancia de clúster OceanBase) |
Kafka (instancia de Kafka autogestionada en una VPC) |
|
OB_Oracle (instancia de clúster OceanBase) |
Kafka (instancia de Kafka en la red pública) |
DDL compatible
-
CREATE TABLEImportanteLa tabla creada debe ser un objeto de sincronización. Para ejecutar la sentencia
CREATE TABLEen una tabla sincronizada, ejecute primero la sentenciaDROP TABLEen dicha tabla. ALTER TABLEDROP TABLE-
TRUNCATE TABLENotaEn la eliminación diferida, la misma transacción contiene dos sentencias DDL
TRUNCATE TABLEidénticas. En este caso, se implementa la idempotencia para el consumo posterior. ALTER TABLE…TRUNCATE PARTITIONCREATE INDEXDROP INDEXCOMMENT ON TABLE-
RENAME TABLEImportanteLa tabla renombrada debe ser un objeto de sincronización.
Procedimiento
-
Inicie sesión en OceanBase Management Console y adquiera una tarea de sincronización de datos.
Para obtener más información, consulte Purchase a data sync task.
-
En la consola de Data Transmission Service, vaya a la página de Data Synchronization, localice la nueva tarea de sincronización y haga clic en Configure.
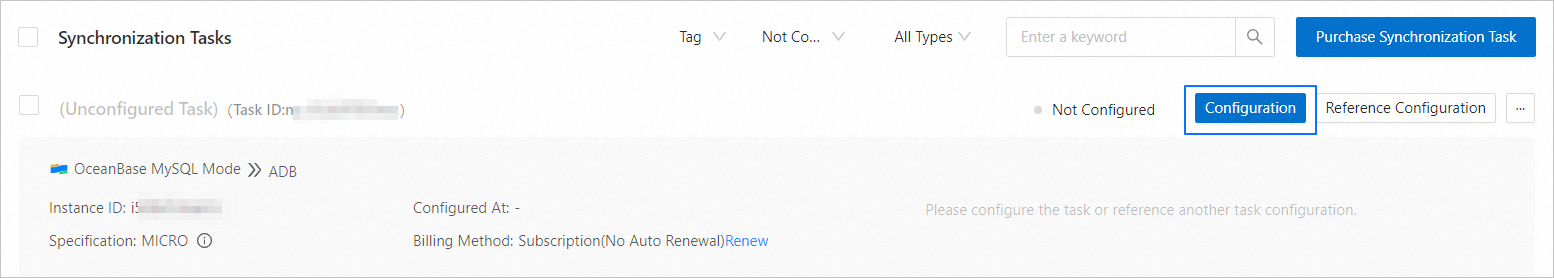
Si desea reutilizar la configuración de una tarea existente, haga clic en Reuse Configuration. Para obtener más información, consulte Reuse and clear the configurations of a data sync task.
-
En la página Select Source and Target, configure los parámetros.
Parámetro
Descripción
Synchronization Task Name
Se recomienda establecer una combinación de dígitos y letras. No debe contener espacios ni exceder los 64 caracteres de longitud.
Source
Si ya creó un origen de datos OceanBase, selecciónelo de la lista desplegable. De lo contrario, haga clic en New Data Source en la lista desplegable y cree uno en el cuadro de diálogo que aparece a la derecha. Para obtener más información sobre los parámetros, consulte Create an OceanBase data source.
ImportanteEl origen no debe ser una base de datos OceanBase cuyo Instance Type sea OceanBase Database Tenant Instance.
Target
Si ya creó un origen de datos Kafka, selecciónelo de la lista desplegable. De lo contrario, haga clic en New Data Source en la lista desplegable y cree uno en el cuadro de diálogo que aparece a la derecha. Para obtener más información, consulte Create a Kafka data source.
Tag (Optional)
Seleccione una etiqueta de destino de la lista desplegable. También puede hacer clic en Manage Tags para crear, modificar y eliminar etiquetas. Para obtener más información, consulte Use tags to manage data synchronization tasks.
-
Haga clic en Next. En la página Select Synchronization Type, especifique los tipos de sincronización para la tarea actual.
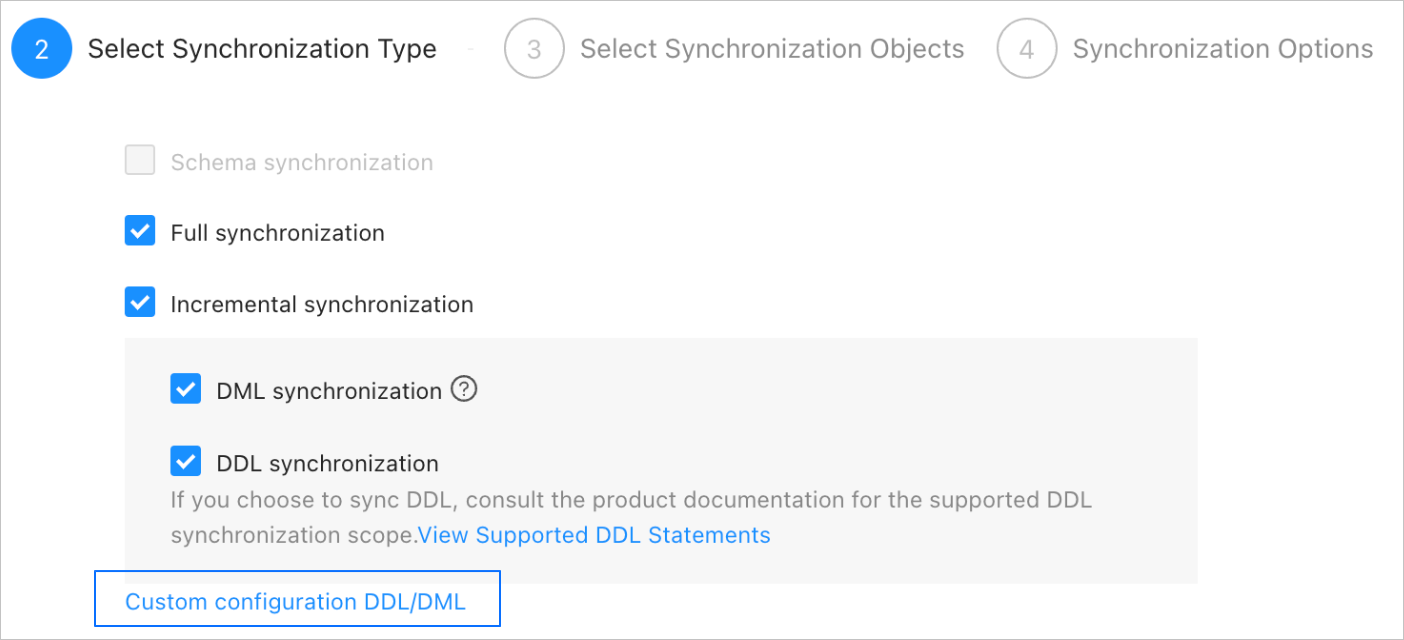
Los tipos de sincronización admitidos son Full Synchronization y Incremental Synchronization. La opción Incremental Synchronization admite DML Synchronization y DDL Synchronization. Las operaciones DML compatibles son
INSERT,DELETEyUPDATE. Puede seleccionar las opciones según sus necesidades. Para obtener más información, consulte Configure DDL/DML synchronization. -
Haga clic en Next. En la página Select Synchronization Objects, seleccione los objetos que se sincronizarán en la tarea actual.
Puede utilizar la opción Specify Objects o Match Rules para especificar los objetos de sincronización. Este tema describe cómo usar la opción Specify Objects para definir dichos objetos. Para obtener información sobre cómo configurar reglas de coincidencia, consulte "Patrones de comodín para la migración/sincronización de datos entre una base de datos y una instancia de Message Queue" en Configure and modify matching rules.
NotaSi seleccionó DDL Synchronization en el paso Select Synchronization Type, se recomienda seleccionar los objetos de sincronización mediante la opción Match Rules. Esto garantiza que todos los objetos nuevos que cumplan con las reglas de coincidencia se sincronicen. Si seleccionó los objetos mediante la opción Specify Objects, los objetos nuevos o renombrados no se sincronizarán.
Al sincronizar datos de una base de datos OceanBase a una instancia de Kafka, puede sincronizar datos de varias tablas a varios temas.
En la sección Select Synchronization Objects, seleccione Specify Objects.
En el panel izquierdo, seleccione los objetos que desea sincronizar.
Haga clic en >.
-
Haga clic en la lista desplegable Existing Topics en el cuadro de diálogo Map Object to Topic y seleccione el tema de destino.
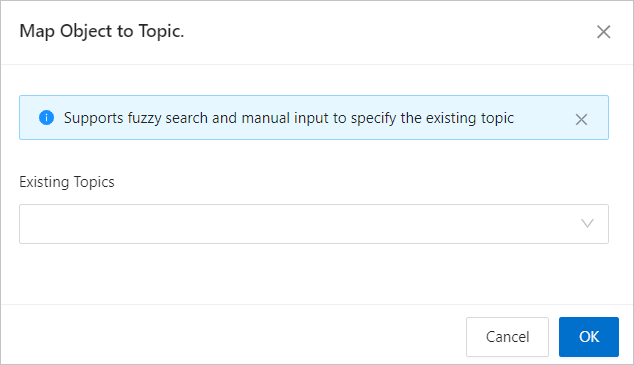
-
Haga clic en OK.
El servicio de transmisión de datos permite importar objetos mediante texto. También permite cambiar los temas de los objetos, establecer filtros de fila y quitar un solo objeto o todos ellos. Los objetos en la base de datos de destino se listan con la estructura Tema > Base de datos > Tabla.
NotaCuando selecciona Match Rules para especificar objetos de sincronización, el cambio de nombre de los objetos se implementa según la sintaxis de las reglas de coincidencia especificadas. En el área de operaciones, solo puede establecer condiciones de filtrado y seleccionar columnas de fragmentación y columnas para sincronizar. Para obtener más información, consulte Configure and modify matching rules.
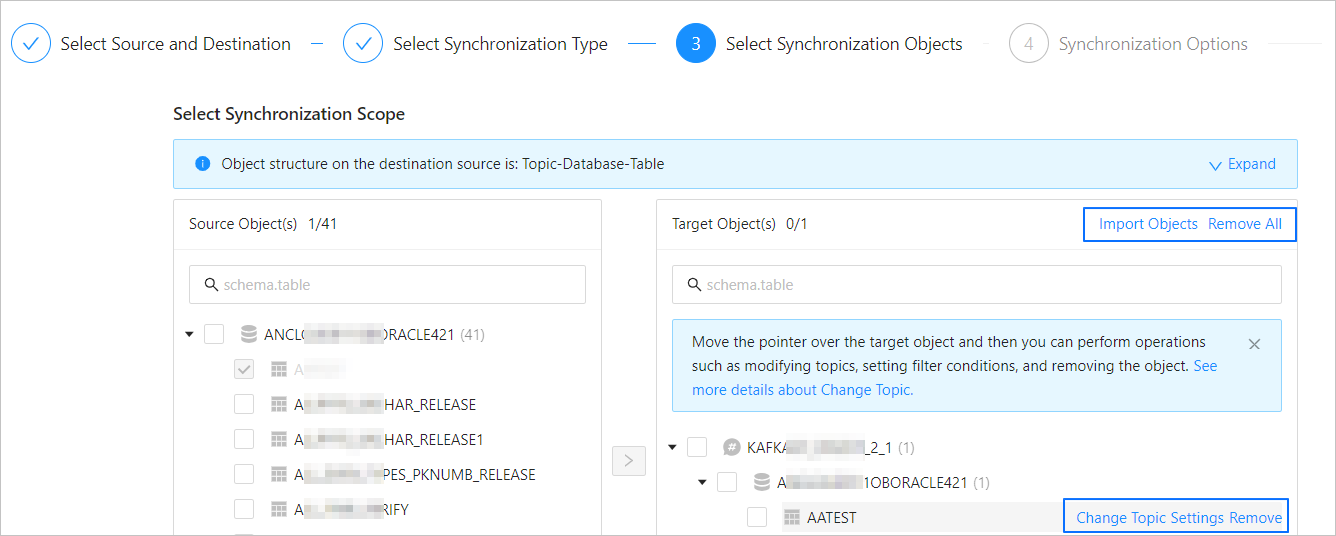
Operación
Descripción
Importar objetos
En la lista de la derecha, haga clic en Import Objects en la esquina superior derecha.
En el cuadro de diálogo que aparece, haga clic en OK.
ImportanteEsta operación sobrescribirá las selecciones anteriores. Proceda con precaución.
En el cuadro de diálogo Import Synchronization Objects, importe los objetos que desea sincronizar. Puede importar archivos CSV para establecer condiciones de filtro de fila, columnas de filtro y columnas de fragmentación. Para obtener más información, consulte Download and import the settings of synchronization objects.
Haga clic en Validate.
Una vez validada correctamente la importación, haga clic en OK.
Cambiar temas
El servicio de transmisión de datos permite cambiar los temas de los objetos en el destino. Para obtener más información, consulte Change topics.
Configurar ajustes
Puede utilizar la cláusula
WHEREpara filtrar datos por fila y seleccionar columnas de fragmentación y columnas para sincronizar.En el cuadro de diálogo Settings, puede realizar las siguientes operaciones:
En la sección Row Filters, especifique una cláusula
WHERESQL estándar para filtrar datos por fila. Para obtener más información, consulte Use SQL conditions to filter data.Seleccione las columnas de fragmentación que desea utilizar de la lista desplegable Sharding Columns. Puede seleccionar varios campos como columnas de fragmentación. Este parámetro es opcional.
A menos que se especifique lo contrario, seleccione las claves primarias como columnas de fragmentación. Si las claves primarias no están equilibradas, seleccione campos equilibrados con identificadores únicos como columnas de fragmentación para evitar posibles problemas de rendimiento. Las columnas de fragmentación se pueden utilizar para los siguientes propósitos:
Equilibrio de carga: Los subprocesos utilizados para enviar mensajes se pueden identificar según las columnas de fragmentación si la tabla de destino admite escrituras simultáneas.
Orden: El servicio de transmisión de datos garantiza que los mensajes se reciban en orden si los valores de las columnas de fragmentación son iguales. El orden especifica la secuencia de ejecución de las sentencias DML para una columna.
En la sección Select Columns, seleccione las columnas que desea sincronizar. Para obtener más información, consulte Column filtering.
Quitar uno o todos los objetos
El servicio de transmisión de datos permite quitar un solo objeto de sincronización o todos los que se agregaron a la lista de la derecha durante el mapeo de datos.
Quitar un solo objeto de sincronización
En la lista de la derecha, pase el cursor sobre el objeto que desea quitar y haga clic en Remove para eliminarlo.
Quitar todos los objetos de sincronización
En la lista de la derecha, haga clic en Remove All en la esquina superior derecha. En el cuadro de diálogo que aparece, haga clic en OK para quitar todos los objetos de sincronización.
-
Haga clic en Next. En la página Synchronization Options, configure los parámetros.
-
Sincronización completa
Los siguientes parámetros se muestran solo si selecciona Full Synchronization en la página Choose Synchronization Types.

Parámetro
Descripción
Read Concurrency
Este parámetro especifica el número de subprocesos concurrentes para leer datos del origen durante la sincronización completa. El valor máximo es 512. Una concurrencia alta puede ejercer presión excesiva sobre el origen y afectar su negocio.
Write Concurrency
Este parámetro especifica el número de subprocesos concurrentes para escribir datos en el destino durante la sincronización completa. El valor máximo es 512. Una concurrencia alta puede ejercer presión excesiva sobre el destino y afectar su negocio.
Full Synchronization Rate Limit
Puede decidir si habilita el límite de tasa de sincronización completa según sus necesidades. Si lo habilita, establezca RPS (número máximo de filas de datos que se pueden sincronizar con el destino por segundo durante la sincronización completa) y BPS (volumen máximo de datos que se puede sincronizar con el destino por segundo durante la sincronización completa).
NotaLos valores de RPS y BPS establecidos aquí son solo para limitar la tasa. El rendimiento real de la sincronización completa depende de factores como el origen, el destino y las especificaciones de la instancia.
-
Sincronización incremental
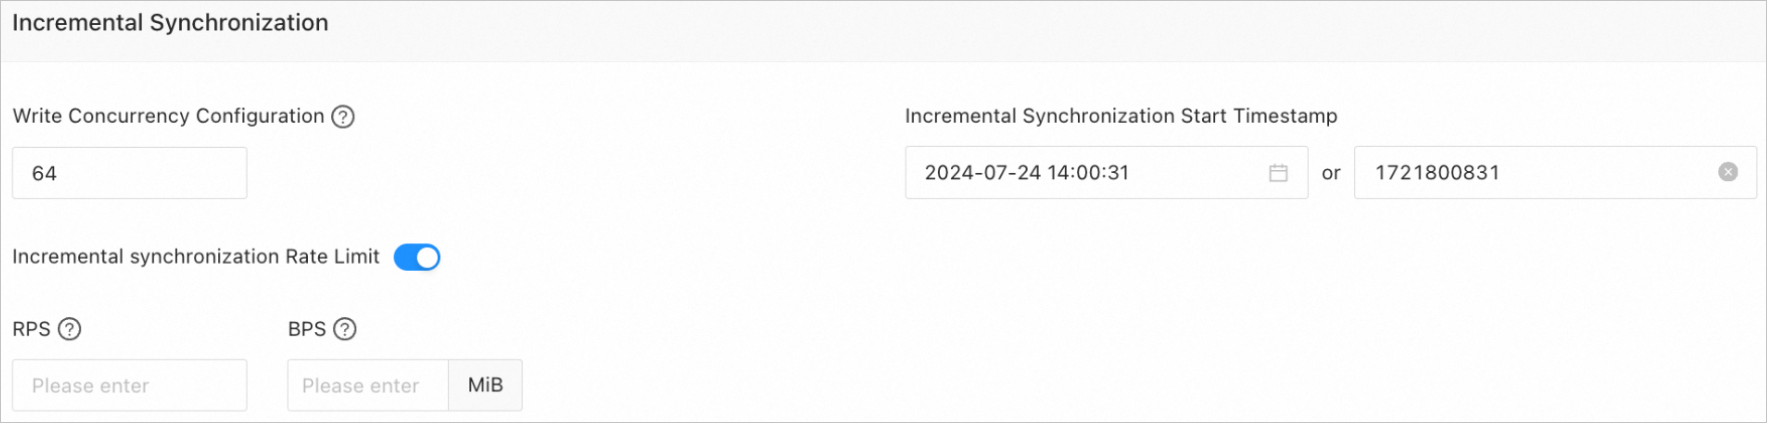
Los siguientes parámetros se muestran solo si selecciona Incremental Synchronization en la página Choose Synchronization Types.
Parámetro
Descripción
Write Concurrency
Este parámetro especifica el número de subprocesos concurrentes para escribir datos en el destino durante la sincronización incremental. El valor máximo es 512. Una concurrencia alta puede ejercer presión excesiva sobre el destino y afectar su negocio.
Incremental Synchronization Rate Limit
Puede decidir si habilita el límite de tasa de sincronización incremental según sus necesidades. Si lo habilita, establezca RPS (número máximo de filas de datos que se pueden sincronizar con el destino por segundo durante la sincronización incremental) y BPS (volumen máximo de datos que se puede sincronizar con el destino por segundo durante la sincronización incremental).
NotaLos valores de RPS y BPS establecidos aquí son solo para limitar la tasa. El rendimiento real de la sincronización incremental depende de factores como el origen, el destino y las especificaciones de la instancia.
Incremental Synchronization Start Offset
Si selecciona Full Synchronization al elegir el tipo de sincronización, no puede modificar este parámetro.
Si no selecciona Full Synchronization pero sí Incremental Synchronization al elegir el tipo de sincronización, especifique un punto en el tiempo a partir del cual desea sincronizar los datos. El valor predeterminado es la hora actual del sistema. Para obtener más información, consulte Set the start offset for incremental synchronization.
-
Parámetros avanzados
Parámetro
Descripción
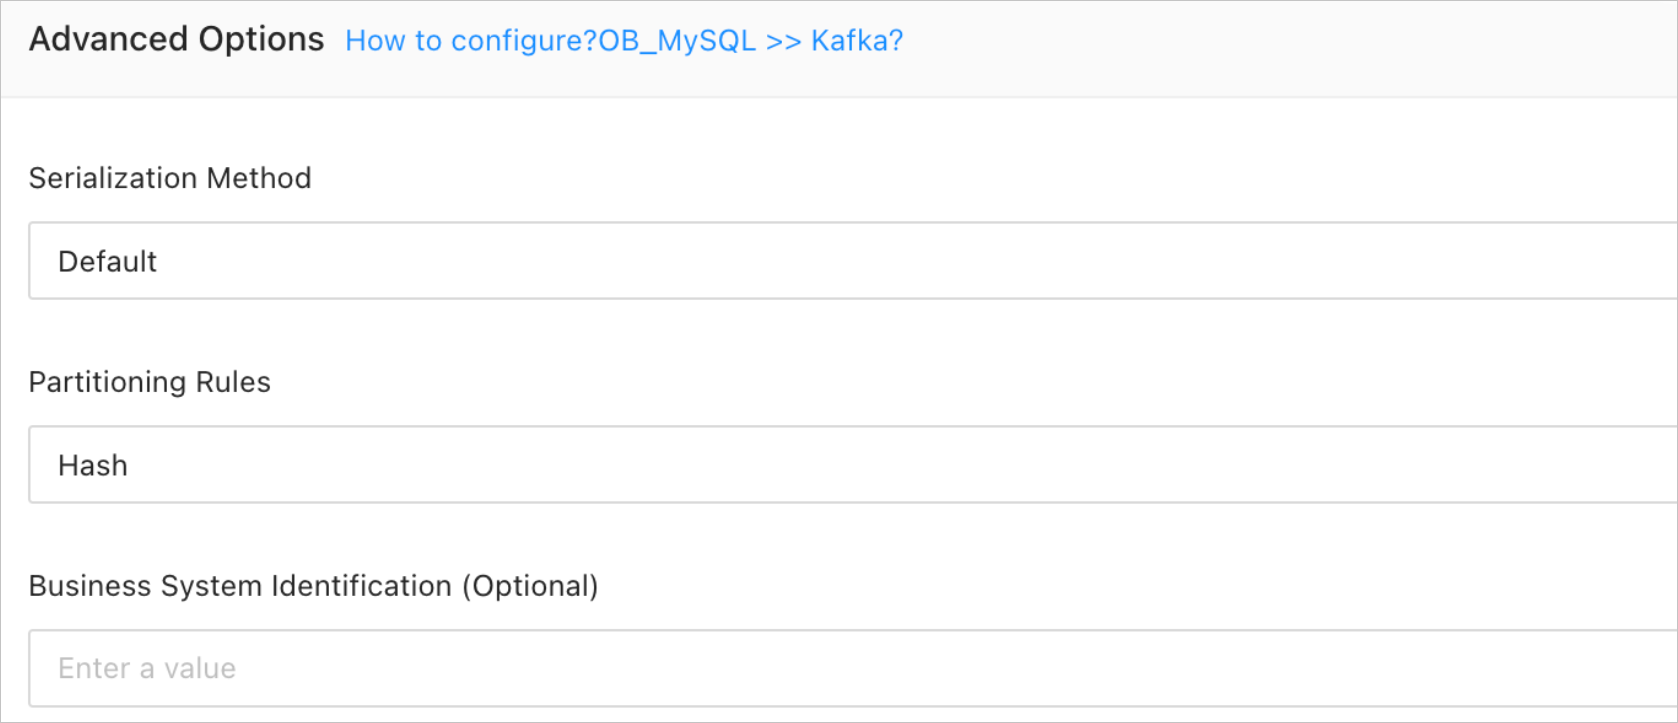
Serialization Method
El formato de mensaje para sincronizar datos con la instancia de Kafka de destino. Los valores válidos son Default, Canal, DataWorks (compatible con la versión 2.0), SharePlex, DefaultExtendColumnType, Debezium, DebeziumFlatten, DebeziumSmt y Avro. Para obtener más información, consulte Data formats.
ImportanteSolo las bases de datos OceanBase en modo compatible con MySQL admiten Debezium, DebeziumFlatten, DebeziumSmt y Avro.
Si el formato de mensaje se establece en DataWorks, las operaciones DDL
COMMENT ON TABLEyALTER TABLE…TRUNCATE PARTITIONno se pueden sincronizar.
Partitioning Rules
La regla para sincronizar datos de una base de datos OceanBase a un tema de Kafka. El servicio de transmisión de datos admite Hash, Table y One. Para obtener más información sobre la entrega de sentencias DDL en diferentes escenarios y ejemplos, consulte la descripción a continuación.
Hash indica que el servicio de transmisión de datos utiliza un algoritmo hash para seleccionar la partición de un tema de Kafka según el valor de la clave primaria o la columna de fragmentación.
Table indica que el servicio de transmisión de datos entrega todos los datos de una tabla a la misma partición y utiliza el nombre de la tabla como clave hash.
One indica que los mensajes JSON se entregan a una partición dentro de un tema para garantizar el orden.
Business System Identification (Optional)
Identifica el sistema empresarial de origen de los datos. Este parámetro se muestra solo cuando selecciona DataWorks para Serialization Method. El identificador del sistema empresarial consta de 1 a 20 caracteres.
La siguiente tabla describe la entrega de una sentencia DDL en diferentes escenarios.
Regla de particionamiento
Sentencia DDL que involucra varias tablas
(ejemplo: RENAME TABLE)
Sentencia DDL que involucra tablas desconocidas
(ejemplo: DROP INDEX)
Sentencia DDL que involucra una sola tabla
Hash
La sentencia DDL se entrega a todas las particiones de los temas asociados con las tablas involucradas.
Suponga que la sentencia DDL involucra tres tablas: A, B y C. Si A está asociada con el Tema 1, B con el Tema 2 y C no participa en la tarea actual, la sentencia DDL se entrega a todas las particiones del Tema 1 y del Tema 2.
La sentencia DDL se entrega a todas las particiones de todos los temas de la tarea actual.
Suponga que el servicio de transmisión de datos no puede identificar la sentencia DDL. Si la tarea actual tiene tres temas, la sentencia DDL se entrega a todas las particiones de estos tres temas.
La sentencia DDL se entrega a todas las particiones del tema asociado con la tabla.
Table
La sentencia DDL se entrega a particiones específicas de los temas asociados con las tablas. Las particiones corresponden a los valores hash de los nombres de las tablas involucradas.
Suponga que la sentencia DDL involucra tres tablas: A, B y C. Si A está asociada con el Tema 1, B con el Tema 2 y C no participa en la tarea actual, la sentencia DDL se entrega a las particiones correspondientes a los valores hash de los nombres de las tablas involucradas en el Tema 1 y el Tema 2.
La sentencia DDL se entrega a todas las particiones de todos los temas de la tarea actual.
Suponga que el servicio de transmisión de datos no puede identificar la sentencia DDL. Si la tarea actual tiene tres temas, la sentencia DDL se entrega a todas las particiones de estos tres temas.
La sentencia DDL se entrega a una partición del tema asociado con la tabla.
One
La sentencia DDL se entrega a una partición fija de los temas asociados con las tablas.
Suponga que la sentencia DDL involucra tres tablas: A, B y C. Si A está asociada con el Tema 1, B con el Tema 2 y C no participa en la tarea actual, la sentencia DDL se entrega a una partición fija del Tema 1 y del Tema 2.
La sentencia DDL se entrega a una partición fija de todos los temas de la tarea actual.
Suponga que el servicio de transmisión de datos no puede identificar la sentencia DDL. Si la tarea actual tiene tres temas, la sentencia DDL se entrega a una partición fija de estos tres temas.
La sentencia DDL se entrega a una partición fija del tema asociado con la tabla.
-
-
Haga clic en Precheck.
Durante la comprobación previa, el servicio de transmisión de datos detecta la conexión entre el origen y el destino. Si se devuelve un error durante la comprobación previa, puede realizar las siguientes operaciones:
Identifique y resuelva el problema, y luego vuelva a ejecutar la comprobación previa.
Haga clic en Skip en la columna Actions del elemento de comprobación previa fallido. En el cuadro de diálogo que advierte sobre las consecuencias de la operación, haga clic en OK.
-
Una vez superada la comprobación previa, haga clic en Start Task.
Si no necesita iniciar la tarea de inmediato, haga clic en Save. Posteriormente, puede iniciar la tarea manualmente en la página Sync Task List o incluirla en una operación por lotes. Para obtener más información sobre las operaciones por lotes, consulte Perform batch operations on data sync tasks.
DTS le permite modificar los objetos de sincronización mientras se ejecuta una tarea de sincronización de datos. Para obtener más información, consulte View and modify synchronization objects and their filter conditions. Una vez iniciada la tarea de sincronización de datos, se ejecuta según los tipos de sincronización seleccionados. Para obtener más información, consulte View synchronization details.
Si una tarea de sincronización de datos falla, generalmente debido a problemas de conexión de red o a un inicio lento del proceso, puede hacer clic en Resume en la lista de tareas o en la página del producto.