Qwen2.5 Omni: AI Multimodal Canggih
Oleh Farruh

Qwen2.5 Omni dari Alibaba Cloud: Paduan GenAI dengan Multimodalitas
Di era AI Generatif (GenAI), Model Bahasa Besar (LLM) tidak lagi terbatas pada teks. Model multimodal seperti Qwen2.5 Omni menjembatani celah antara teks, gambar, audio, dan video, yang memungkinkan AI untuk berpikir, melihat, mendengar, dan berbicara - seperti kita manusia.
Mengapa Multimodalitas itu Penting
- Keberadaan Data Multimodal yang Luas: 90% lalu lintas internet adalah konten visual/audio (misalnya, video TikTok, podcast).
- Interaksi Mirip Manusia: Pengguna mengharapkan AI untuk memproses input campuran (misalnya, kueri foto_dan_suara).
- Disrupsi Industri: Dari diagnostik perawatan kesehatan hingga e-niaga, AI multimodal menjadi standar baru.
Qwen2.5 Omni: Dirancang untuk Multimodalitas Lengkap
- Jauh Melampaui Teks: Sementara LLM seperti Qwen2.5-VL unggul dalam teks dan gambar, Qwen2.5 Omni menambahkan streaming audio/video, sebagai lompatan menuju AI sensor-penuh.
- Arsitektur Terpadu: Tidak seperti alat silo, Qwen2.5 Omni adalah model tunggal untuk input/output di seluruh modalitas.
Memahami Qwen2.5 Omni: Keunggulan Teknis

Gambaran umum modul Thinker (pemrosesan teks/audio/video) dan Talker (pembuatan ucapan)
Inovasi Kunci dari Laporan Teknis
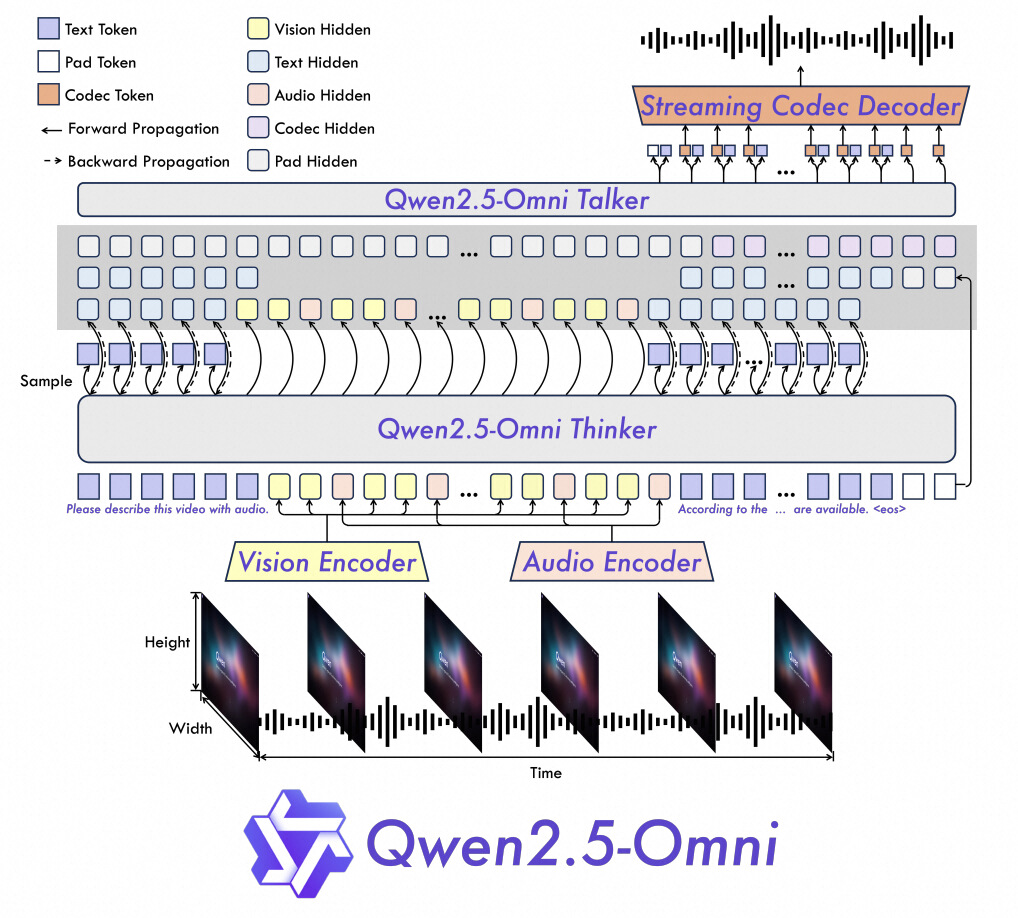
Gambaran umum Qwen2.5-Omni dengan Arsitektur Thinker-Talker
1. Pengodean Posisional TMRoPE:
- Time-aligned Multimodal RoPE memastikan bingkai audio dan video diproses secara sinkron (misalnya, suai bibir dalam video).
- Pengelompokan Berselang membagi video menjadi blok 2-detik, menggabungkan data visual/audio untuk mengurangi latensi.
2. Arsitektur Thinker-Talker:
- Thinker: LLM untuk pembuatan dan penalaran teks.
- Talker: Model jalur rangkap untuk pembuatan ucapan real-time, mengurangi latensi audio hingga 40% dibandingkan dengan Qwen2-Audio.
3. Efisiensi Streaming:
- Pengodean per Blok memproses audio/video dalam potongan, yang memungkinkan inferensi real-time.
- Sliding Window Diffusion Transformer (DiT) mengurangi keterlambatan audio awal dengan membatasi bidang reseptif.
Cara Qwen2.5 Omni Mengungguli Model Multimodal Lain

| Tugas | Qwen 2.5-Omni | Qwen2.5-VL | GPT-4o-Mini | Mutakhir |
|---|---|---|---|---|
| Gambar→Teks | 59,2 (MMMUval) | 58,6 | 60,0 | 53,9 (Lainnya) |
| Video→Teks | 72,4 (Video-MME) | 65,1 | 64,8 | 63,9 (Lainnya) |
| Penalaran Multimodal | 81,8 (MMBench) | T/A | 76,0 | 80,5 (Lainnya) |
| Pembuatan Ucapan | 1,42% WER (Mandarin) | T/A | T/A | 2,33% (Inggris) |
Mengapa Qwen2.5 Omni Unggul
- Model Terpadu: Anda tidak perlu beralih antara model audio dan video seperti Qwen2-Audio dan qwen2.5-VL.
- Latensi Rendah: Qwen2.5 Omni memproses potongan video 2-detik secara real-time, yang sangat cocok untuk aplikasi dan layanan dengan konten real-time.
- Serbaguna: Qwen2.5 Omni menangani instruksi bicara menyeluruh serta teks (misalnya, "Rangkum video ini dan bacakan dengan keras").
Mulai Cepat untuk Qwen2.5 Omni di Alibaba Cloud
Langkah 1: Pilih Model
1. Buka Model Studio Alibaba Cloud atau tautan Halaman pendahuluan Model Studio.
2. Cari "Qwen2.5-Omni" dan buka halamannya.
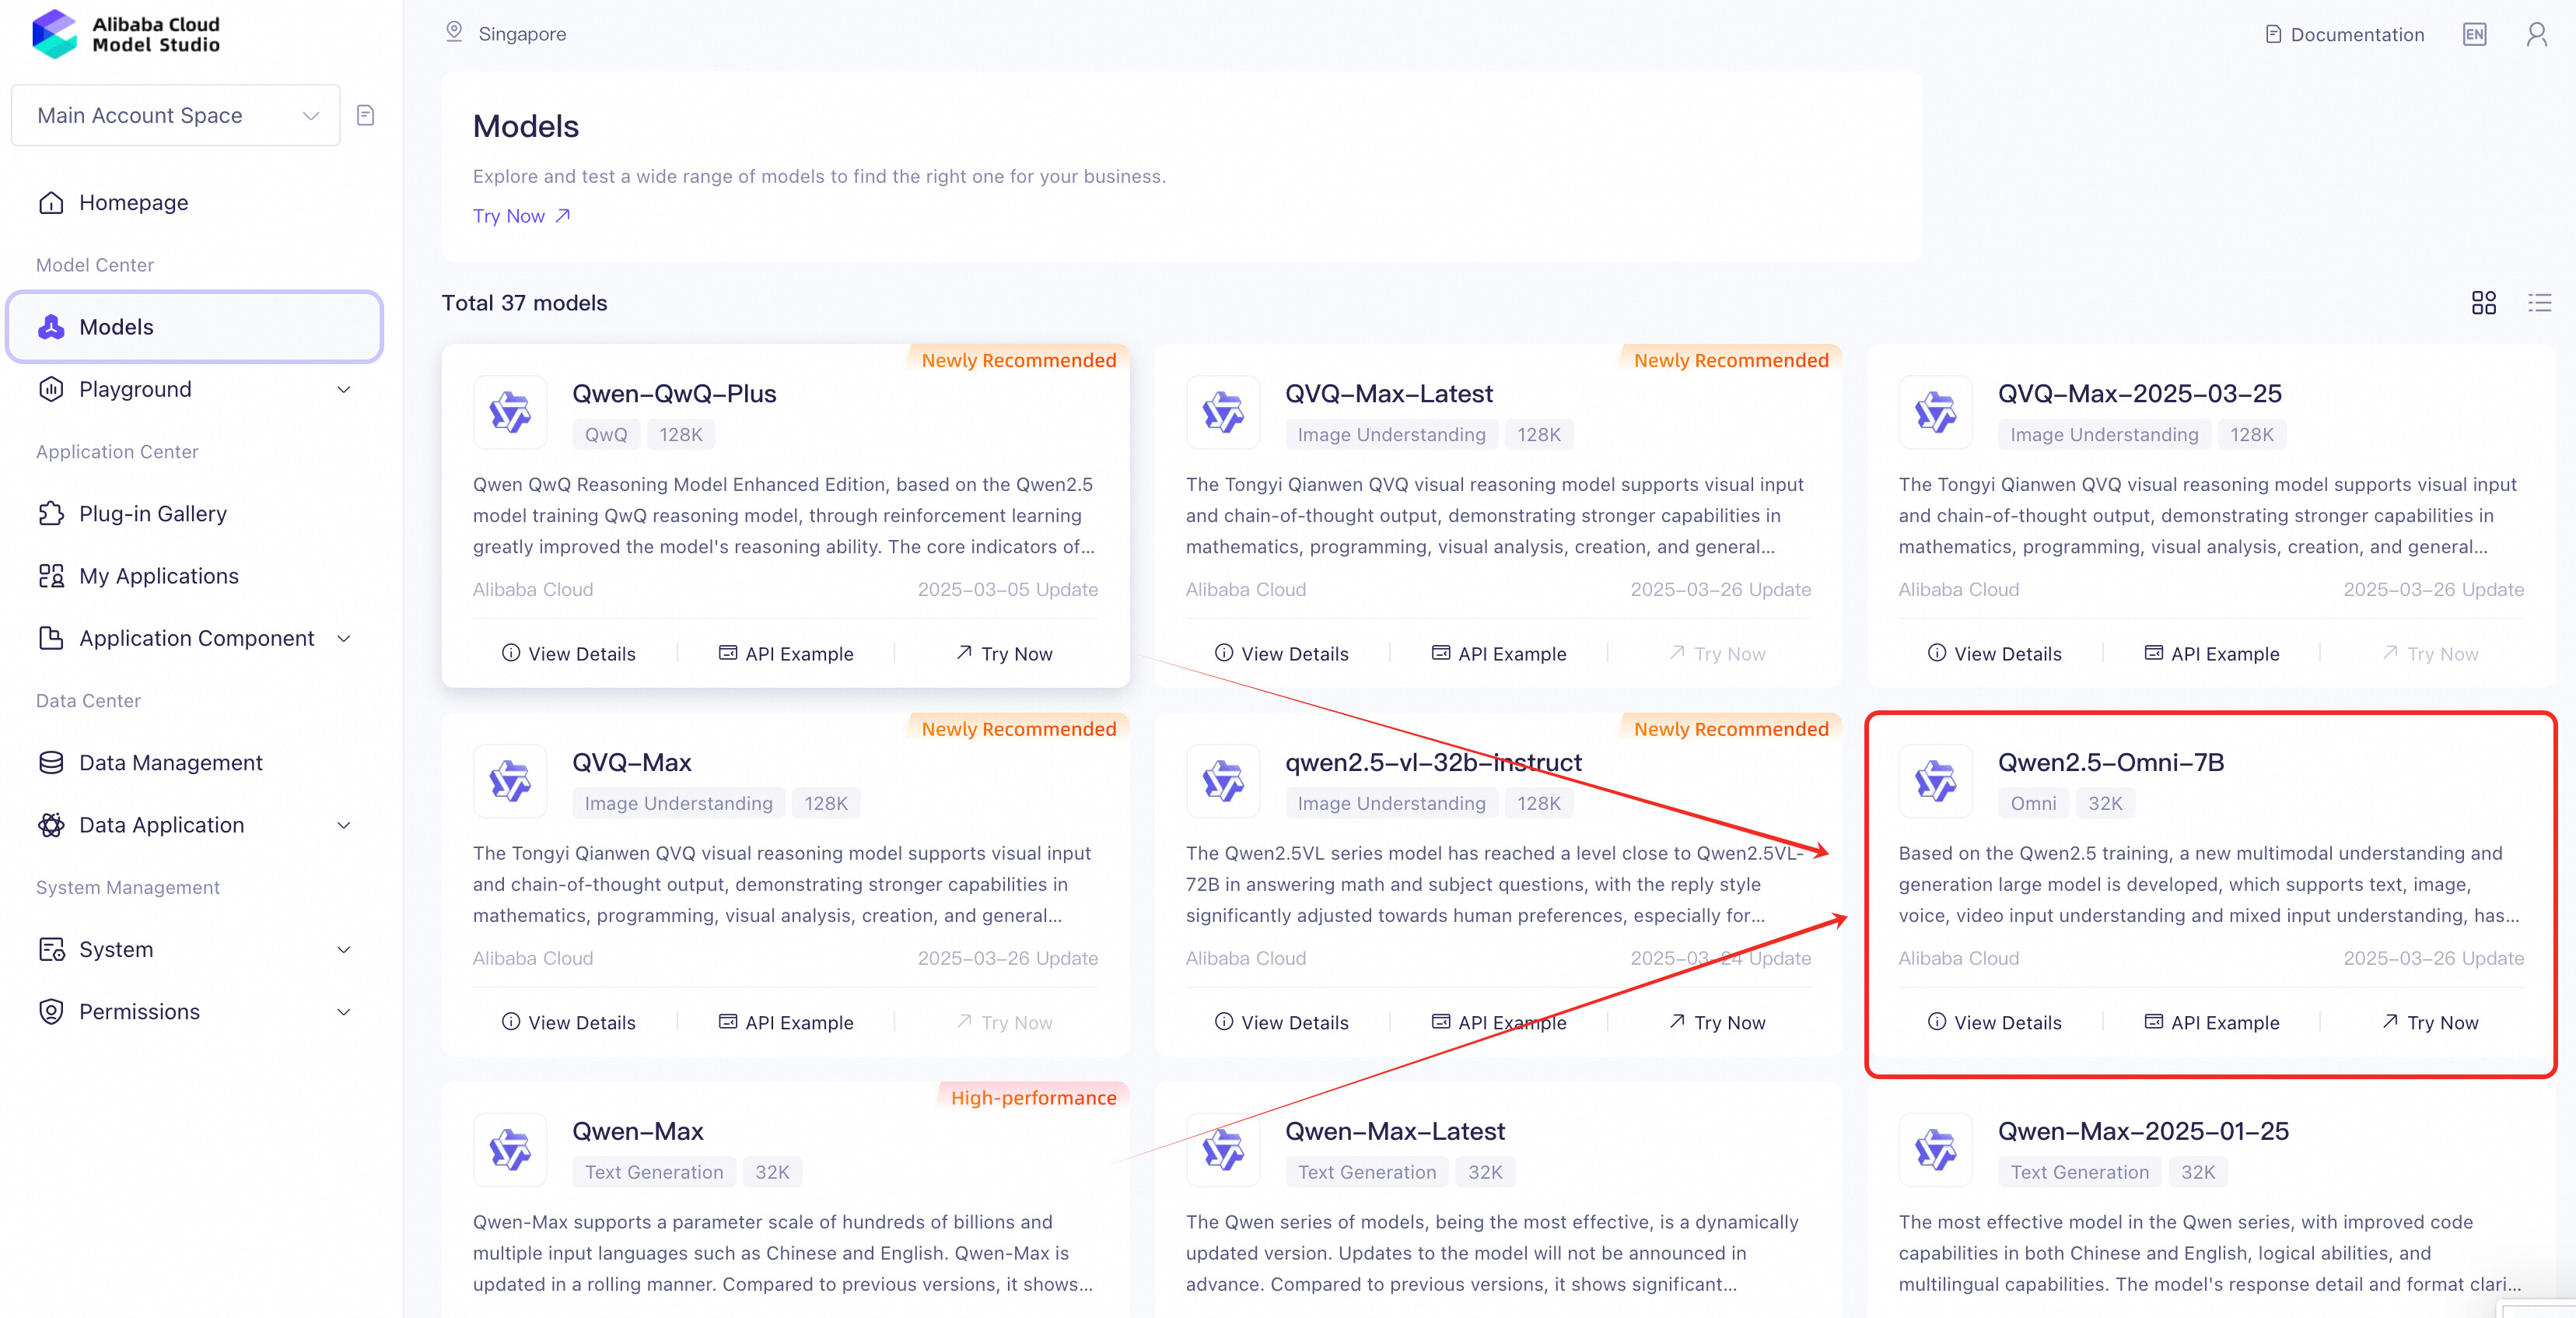
3. Otorisasi akses ke model (gratis untuk penggunaan dasar).
Langkah 2: Siapkan Lingkungan Anda
Pengaturan yang memprioritaskan keamanan:
1. Buat lingkungan virtual (disarankan):
python -m venv qwen-env
source qwen-env/bin/activate  # Linux/MacOS | Windows: qwen-env\Scripts\activate
2. Instal dependensi:
pip install openai3. Simpan kunci API dengan aman:
Buat file .env di direktori proyek Anda:
DASHSCOPE_API_KEY=your_api_key_hereLangkah 3: Lakukan Panggilan API dengan Kompatibilitas OpenAI
Gunakan pustaka OpenAI untuk berinteraksi dengan Qwen2.5-Omni:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

# Example: Text + Audio Output
completion = client.chat.completions.create(
    model="qwen2.5-omni-7b",
    messages=[{"role": "user", "content": "Siapa Anda?"}],
    modalities=["text", "audio"],  # Tentukan format output (teks/audio)
    audio={"voice": "Chelsie", "format": "wav"},
    stream=True,  # Aktifkan streaming real-time
    stream_options={"include_usage": True},
)

# Proses respons streaming
untuk potongan saat selesai:
    if chunk.choices:
        print("Partial response:", chunk.choices[0].delta)
    else:
        print("Usage stats:", chunk.usage)
Fitur Utama API
| Fitur | Detail |
|---|---|
| Jenis Input | Teks, gambar, audio, video (melalui URL/Base64) |
| Modalitas Output | Tentukan parameter modalitas (misalnya, ["text", "audio"] untuk output ganda) |
| Dukungan Streaming | Hasil real-time melalui stream=True
|
| Keamanan | Variabel lingkungan untuk kunci API (file .env) |
Kasus Penggunaan Lanjutan: Menembus Batas
1. Analisis Video Real-Time
Kasus Penggunaan: Pemberian keterangan acara siaran langsung dengan deteksi emosi.
- Input: Klip video 10 detik.
- Output: Rangkuman teks + komentar audio (misalnya, "Kerumunan bersorak热烈!").
2. E-niaga Lintas-Modal
Kasus Penggunaan: Membuat deskripsi produk dari gambar dan ulasan pengguna.
# Input: Gambar produk + "Tulis ulasan bintang 5 dalam bahasa Spanyol"
# Output: Ulasan teks + versi audio dalam bahasa Spanyol.
Mengapa Belajar Qwen2.5 Omni?
- Keterampilan Siap untuk Masa Depan: Model multimodal adalah standar generasi berikutnya untuk aplikasi AI.
- Keunggulan Kompetitif:Bisnis yang menggunakan Qwen2.5 Omni dapat:
- Mengurangi Biaya: Satu model untuk semua tugas teks/audio/video.
- Mempercepat Inovasi: Menyebarkan aplikasi real-time (misalnya, asisten virtual, pengawasan cerdas).
Pemecahan Masalah dan Praktik Terbaik
1. Batas Ukuran Berkas:
- Gambar:≤10 MB per file.
- Total Token:Menghargai batas token 32k di model ini (penyematan teks + gambar/audio).
2. Optimal untuk Streaming:
- Gunakan OSS Alibaba Cloud untuk file besar.
- Aktifkan
stream = Trueuntuk output real time.
Kesimpulan: Masa Depan adalah Multimodal
Seiring perkembangan GenAI, kemampuan multimodal akan mendominasi industri dari perawatan kesehatan hingga hiburan. Dengan menguasai Qwen2.5 Omni, Anda memasuki era berikutnya dari kolaborasi manusia dengan AI.
Mulailah bereksperimen hari ini dan bergabunglah dengan revolusi!
Referensi
- Bantuan Model Studio: Panduan Memulai
- Halaman Produk Model Studio:Jelajahi Fitur
- Blog Qwen2.5-Omni Blog:Gambaran Umum Mendalam
- Laporan Teknis: ArXiv Paper
- GitHub:Kode dan Dokumen
- HuggingFace: Unduhan Model
- Wan Visual Generation: Buat Video Mengagumkan
Artikel ini diterjemahkan dari bahasa Inggris. Lihat artikel asli di sini.
Read previous post:
Read next post:
-

-
Regional Content Hub
144 posts | 4 followers
Follow
Comments
-
-
Regional Content Hub
144 posts | 4 followers
Follow
Related Products
-
 Qwen
Full-range, open-source, multimodal, and multi-functional
Learn More -
 Alibaba Cloud Model Studio
A one-stop generative AI platform to build intelligent applications that understand your business, based on Qwen model series such as Qwen-Max and other popular models
Learn More -
Token Plan
Build more, spend less. One plan, every modality.
Learn More -
 QwenWork
 is dedicated to helping employees strengthen their professional competitiveness in the AI era and to enabling enterprises to improve organizational effectiveness.
Learn More
More Posts by Regional Content Hub
- ให้พื้นที่ทำงานชั่วคราวกับ AI เอเจนต์ของคุณด้วย Alibaba Cloud AgentRun
- Alibaba Cloud AgentRun으로 AI 에이전트에 일회용 워크스페이스 제공
- Alibaba Cloud AgentRun で AI エージェントに使い捨てワークスペースを与える
- Beri Agen AI Anda Ruang Kerja Sekali Pakai dengan Alibaba Cloud AgentRun
- Cung cấp không gian làm việc dùng một lần cho tác nhân AI của bạn với Alibaba Cloud AgentRun
- DeepSeek V4-Flash dalam Skala Besar: Panduan Deployment Berbasis Benchmark
- 大規模な DeepSeek V4-Flash の活用:ベンチマーク主導のデプロイガイド
- 대규모 DeepSeek V4-Flash: 벤치마크 기반 배포 가이드
- Alibaba Cloud ECS 上で Telegram 連携機能付きの OpenClaw をデプロイする
- Alibaba Cloud ECS에 Telegram 통합 기능을 갖춘 OpenClaw 배포