MaxCompute, Object Storage Service (OSS) dizinleriyle eşleşen OSS harici tabloları destekler. Yapılandırılmamış verileri OSS'den okumak veya OSS'ye veri yazmak için OSS harici tabloları kullanın.
Kullanım notları
OSS harici tablolar küme özelliğini desteklemez.
Tek bir dosyanın boyutu 2 GB'ı aşamaz. 2 GB'tan büyük dosyaları bölmeniz gerekir.
MaxCompute ve OSS aynı bölgede bulunmalıdır.
Erişim yöntemleri
Aşağıdaki platformlar OSS harici tablolar oluşturmayı ve kullanmayı destekler.
Yöntem | Platform |
MaxCompute SQL | |
Görselleştirme |
Ön koşullar
-
Bir OSS paketi ve dizini hazırlayın. Bir paket oluşturun ve dizinleri yönetin.
MaxCompute, OSS dizinlerini otomatik olarak oluşturabilir. Bir SQL ifadesi harici tablolar ve UDF'ler içeriyorsa, tek bir SQL ifadesi harici tabloyu okuyabilir veya yazabilir ve UDF'yi çalıştırabilir. Manuel dizin oluşturma da desteklenir.
MaxCompute yalnızca bazı bölgelerde dağıtıldığından, bölgeler arası ağ bağlantısı sorun olabilir. Paketinizi MaxCompute projenizle aynı bölgede tutun.
-
Yetkilendirme
OSS'ye erişim izinlerini alın. Bir Alibaba Cloud hesabı, bir RAM kullanıcısı veya bir RAM rolü OSS harici tablolarına erişebilir. OSS için STS yetkilendirmesi.
MaxCompute projenizde CreateTable iznini alın. MaxCompute izinleri.
İzin açıklaması
OSS harici tablolarına erişirken, bir Alibaba Cloud hesabı, RAM kullanıcısı veya RAM rolü kullanmanızdan bağımsız olarak verilere
odps.properties.rolearnparametresinde belirtilen rol aracılığıyla erişilir. Bu nedenle, bir RAM rolü oluşturmanız ve buna hedef OSS paketinine erişim izni vermeniz, ardından rolün ARN'siniodps.properties.rolearnparametresinde yapılandırmanız gerekir. Daha fazla bilgi için bkz. Parametreler.İş gereksinimlerinize göre aynı hesapta veya hesaplar arası erişimi yetkilendirebilirsiniz. Daha ayrıntılı erişim denetimi için özel bir yetkilendirme ilkesi kullanmanızı öneririz. Daha fazla bilgi için bkz. Harici veri kaynakları için yetkilendirme.
OSS harici tablosu oluşturma
-
Bölümlenmiş ve bölümlenmemiş tablolar:
Veri dosyalarınızın OSS'de nasıl depolandığına bağlı olarak seçim yapın. Dosyalar bölümlenmiş yollardaysa bölümlenmiş bir tablo kullanın; aksi takdirde bölümlenmemiş bir tablo kullanın.
OSS harici tablolar Bölüm işlemlerini destekler.
Ağ alan adı: OSS için klasik ağ alan adını kullanın. MaxCompute, genel ağ alan adları için ağ bağlantısını garanti etmez.
Bir OSS harici tablosu yalnızca bir OSS dizinine eşlemeyi kaydeder. Bir OSS harici tablosunun silinmesi, eşlenen OSS dizinindeki veri dosyalarını silmez.
Bir OSS veri dosyası arşivlenmiş bir nesneyse, önce nesneyi geri yüklemeniz gerekir.
CREATE EXTERNAL TABLE sözdizimi veri dosyası biçimine göre değişir. Sözdizimini ve parametreleri veri biçiminize göre eşleştirin. Yanlış ayarlar okuma ve yazma hatalarına neden olur.
Sözdizimi
Yerleşik metin veri ayrıştırıcısını kullanarak harici tablo oluşturma
Sözdizimi | Veri dosyası biçimi | Örnek |
| OSS'den okuma veya OSS'ye yazma için desteklenen veri dosyası biçimleri:
|
Yerleşik açık kaynaklı veri ayrıştırıcısını kullanarak harici tablo oluşturma
Sözdizimi | Veri dosyası biçimi | Örnek |
| OSS'den okuma veya OSS'ye yazma için desteklenen veri dosyası biçimleri:
|
Özel ayrıştırıcı kullanarak harici tablo oluşturma
Sözdizimi | Veri dosyası biçimi | Örnek |
| OSS'den okuma veya OSS'ye yazma için desteklenen veri dosyası biçimleri: Yukarıda listelenenler dışındaki biçimlerdeki veri dosyaları. |
Parametreler
Aşağıdaki parametreler tüm harici tablo biçimlerinde ortaktır. Biçime özgü parametreler için her biçimin belgelerine bakın.
-
Temel sözdizimi parametreleri
Parametre
Gerekli
Açıklama
mc_oss_extable_name
Evet
Oluşturulacak OSS harici tablosunun adı.
Tablo adları büyük/küçük harfe duyarlı değildir ve belirli bir büyük/küçük harf durumuna zorla dönüştürülemez.
col_name
Evet
OSS harici tablosundaki bir sütunun adı.
Harici tablonun şeması, OSS veri dosyasının şemasıyla eşleşmelidir. Aksi takdirde veriler okunamaz.
data_type
Evet
OSS harici tablosundaki bir sütunun veri türü.
Her sütunun veri türü, OSS veri dosyasındaki karşılık gelen sütunla eşleşmelidir. Aksi takdirde veriler okunamaz.
table_comment
Hayır
Tablo için açıklama. Açıklama, 1.024 baytı aşmayan geçerli bir dize olmalıdır. Aksi takdirde hata bildirilir.
partitioned by (col_name data_type, ...)
Hayır
OSS'deki veri dosyaları bölümlenmiş bir yolda depolanıyorsa, bölümlenmiş bir tablo oluşturmak için bu parametreyi ekleyin.
col_name: Bölüm anahtar sütununun adı.
data_type: Bölüm anahtar sütununun veri türü.
'<(tb)property_name>'='<(tb)property_value>'
Evet
Harici tablonun genişletilmiş özellikleri. Ayrıntılar için biçime özgü belgelere bakın.
oss_location
Evet
Veri dosyalarının bulunduğu OSS yolu. Varsayılan olarak, bu yoldaki tüm veri dosyaları okunur.
Biçim şöyledir:
oss://<oss_endpoint>/<Bucket name>/<OSS directory name>/.oss_endpoint:
OSS alan adı. OSS tarafından sağlanan ve
-internaliçeren klasik ağ uç noktasını kullanmanız gerekir.Örnek:
oss://oss-cn-beijing-internal.aliyuncs.com/xxx.OSS klasik ağ alan adları Bölgeler ve uç noktalar bölümünde listelenmiştir.
Veri dosyalarının depolandığı OSS bölgesini MaxCompute projenizin bölgesiyle aynı tutun. Farklı bölgelerde olmaları durumunda ağ bağlantısı sorunları oluşabilir.
Bir uç nokta belirtmezseniz sistem, mevcut projenin bulunduğu bölgenin uç noktasını kullanır.
Bu yöntem önerilmez çünkü bölgeler arası dosya depolama ağ bağlantısı sorunlarına neden olabilir.
Paket adı: OSS paketinin adı. Paket adı
oss_endpointöğesinden sonra gelmelidir.Örnek:
oss://oss-cn-beijing-internal.aliyuncs.com/your_bucket/path/.Paket adlarını Paketleri listeleme bölümünde görüntüleyin.
Dizin adı: OSS dizininin adı. Dizinden sonra bir dosya adı belirtmeyin.
Örnek:
oss://oss-cn-beijing-internal.aliyuncs.com/oss-mc-test/Demo1/.Yanlış örnekler:
 -- HTTP connections are not supported.
    http://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/
    -- HTTPS connections are not supported.
    https://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/
    -- Incorrect connection address.
    oss://oss-cn-shanghai-internal.aliyuncs.com/Demo1
    -- Do not specify a file name.
    oss://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/vehicle.csv
-
WITH serdeproperties öznitelikleri
property_name
Senaryo
property_value
Varsayılan değer
odps.properties.rolearn
STS yetkilendirmesi kullanırken bu özelliği ekleyin.
OSS'ye erişim iznine sahip RAM rolünün ARN'sini belirtin.
ARN'yi RAM konsolu içindeki rol ayrıntılarından alın. Örnek:
acs:ram::xxxxxx:role/<role_name>.MaxCompute ve OSS sahipleri aynı hesapsa:
Tablo oluşturma ifadesinde
odps.properties.rolearnbelirtmezseniz varsayılan olarakaliyunodpsdefaultrolerolünün ARN'si kullanılır. Önce STS yetkilendirmesi kullanarak RAM rolünü oluşturmanız gerekir.AliyunODPSDefaultRolegeniş kapsamlı izinlere sahiptir. İzinleri özel bir rol aracılığıyla vermenizi öneririz.Özel bir rol ARN'si kullanmak için önce özel rolü oluşturun. OSS için STS yetkilendirmesi (özel yetkilendirme).
MaxCompute ve OSS sahipleri farklı hesaplarsa, özel bir rolün ARN'sini belirtmeniz gerekir. Daha fazla bilgi için bkz. OSS için STS yetkilendirmesi (özel yetkilendirme).
Beyaz liste ve kara liste
MaxCompute OSS harici tabloları beyaz liste ve kara liste filtrelemeyi destekler. tblproperties içinde beyaz liste ve kara liste parametrelerini ayarlayarak bir dizinden hangi dosyaların okunacağını filtreleyebilirsiniz.
-
tblproperties parametreleri
-
Etkili kurallar
Kara liste beyaz listeden önceliklidir: Bir dosya herhangi bir kara liste koşulunu karşılıyorsa hariç tutulur.
-
Oturum bayrağı ve tblproperties kara liste parametresi "VEYA" ilişkisine sahiptir. İkisi de yapılandırılırsa her ikisi de etkili olur — herhangi bir kara liste koşulunu karşılayan bir dosya hariç tutulur. tblProperties yapılandırması önerilir.
Yapılandırma yöntemi
Yol türü
Parametre
oturum bayrağı
Mutlak yol
odps.sql.unstructured.file.pattern.black.list
tblproperties
Göreli yol
odps.external.data.file.blacklist.regex
-
Regex notları
Satır başı
^ve satır sonu$işaretleri isteğe bağlıdır. Örneğin,.jsondosyalarını eşleştirmek için.*\.jsonyeterlidir.-
Yalnızca bir regex deseni desteklenir. Birden çok dosya türünü dışlamak için | kullanın:
-- Exclude csv, txt, and parquet files
"odps.external.data.file.blacklist.regex": ".*\\.(txt|csv|parquet)$"
-
Beyaz liste ve kara liste parametrelerini güncelleme
ALTER TABLE {table_name} SET tblproperties('odps.external.data.file.whitelist.regex'='new_regex') ALTER TABLE {table_name} SET tblproperties('odps.external.data.file.blacklist.regex'='new_regex') -
Örnekler
-
Örnek veriler
-- Assume the OSS directory contains the following files: oss://xxx/bucket/level1/data1.txt oss://xxx/bucket/level1/data2.json oss://xxx/bucket/level1/data3.csv oss://xxx/bucket/level1/level2/data4.txt oss://xxx/bucket/level1/level2/data5.json oss://xxx/bucket/level1/level2/data6.parquet -
Beyaz liste: yalnızca JSON dosyalarını oku
CREATE EXTERNAL TABLE test_whitelist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED AS textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json'); -- Whitelist: JSON files only -- By running SELECT * FROM test_whitelist_table, all JSON files are selected. -- Query returns data from data2.json and level2/data5.json -
Kara liste: txt, csv ve parquet dosyalarını dışla
CREATE EXTERNAL TABLE test_blacklist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.blacklist.regex'='.*\\.(txt|csv|parquet)$'); -- Blacklist: exclude txt, csv, parquet -- By running SELECT * FROM test_blacklist_table, all TXT, CSV, and Parquet files are filtered out. -- Query returns data from data2.json and level2/data5.json -
Beyaz liste ve kara liste birleşimi: txt dosyalarını oku, level2 dizinini dışla
CREATE EXTERNAL TABLE test_whitelist_blacklist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.txt', -- Whitelist: txt files only 'odps.external.data.file.blacklist.regex'='.*level2/.*'); -- Blacklist: exclude level2 directory -- By running select * from test_whitelist_blacklist_table, -- Whitelist filters txt files, then blacklist excludes level2 directory -- Query returns data from data1.txt only -
Özyinelemeli listeleme: alt dizinlerdeki dosyaların okunup okunmayacağını denetleme
CREATE EXTERNAL TABLE test_recursive_enabled ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json' -- Whitelist: json files only 'odps.external.data.file.recursive.listing.enabled'='true'); -- Recursive enabled -- By running SELECT * FROM test_recursive_enabled, all JSON files are selected. -- Query returns data from data2.json and level2/data5.json CREATE EXTERNAL TABLE test_recursive_disabled ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json' -- Whitelist: json files only 'odps.external.data.file.recursive.listing.enabled'='false' -- Recursive disabled ); -- By running SELECT * FROM test_recursive_disabled, all JSON files are selected, but recursive reading is disabled. -- Query returns data from data2.json only (level2 directory excluded) -
ALTER TABLE aracılığıyla beyaz liste ve kara listeyi güncelleme
CREATE EXTERNAL TABLE test_alter_table_properties
(
  id INT,
  name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED as textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- Enable file extension support
  'odps.external.data.file.whitelist.regex'='.*\\.json'); -- Whitelist: json files only

-- By running SELECT * FROM test_alter_table_properties, all JSON files are selected
-- Query returns data from data2.json and level2/data5.json

ALTER TABLE test_alter_table_properties
SET tblproperties(
  'odps.external.data.file.whitelist.regex'='.*level2/.*\\.json'
)
-- By running select * from test_alter_table_properties
-- Query now returns data from level2/data5.json only
-
OSS'den veri okuma
Notlar
Bir OSS harici tablosu oluşturduktan sonra, harici tablo aracılığıyla OSS'den veri okuyabilirsiniz. Desteklenen veri dosyası türleri ve oluşturma sözdizimi için bkz. Sözdizimi.
Bir SQL ifadesi karmaşık veri türlerini içeriyorsa,
set odps.sql.type.system.odps2=true;ön ekini ekleyin ve bunları birlikte gönderin. Veri türü sürümleri.Açık kaynaklı verilere eşlenen OSS harici tabloları için, OSS'den veri okumadan önce oturum düzeyinde
set odps.sql.hive.compatible=true;ayarlayın. Aksi takdirde hata bildirilir.OSS'nin bant genişliği sınırlamaları vardır. Okuma/yazma trafiği kısa sürede örnek bant genişliği sınırını aşarsa harici tablo performansı düşer. Sınırlamalar ve performans ölçümleri.
Sözdizimi
<select_statement> FROM <from_statement>;select_statement: Kaynak tablodan hedef tabloya eklenecek verileri sorgulayan
SELECTyan tümcesi.from_statement: Veri kaynağını (örneğin harici tablonun adını) belirten
FROMyan tümcesi.
Bölümlenmemiş veriler
Bölümlenmemiş veriler
Bölümlenmemiş bir OSS harici tablosu oluşturduktan sonra, aşağıdaki yöntemlerden birini kullanarak OSS'den veri okuyabilirsiniz:
-
Yöntem 1 (Önerilen): Açık kaynaklı biçimdeki verileri OSS'den bir MaxCompute iç tablosuna aktarın ve ardından verileri okuyun.
Tekrarlanan hesaplamalar veya yüksek performans gerektiren senaryolar için en iyisidir. Harici tabloyla aynı şemaya sahip bir iç tablo oluşturun, verileri aktarın ve ardından karmaşık sorguları çalıştırın. İç depolama, MaxCompute optimizasyonundan yararlanır. Örnek komut:
CREATE TABLE <table_internal> LIKE <mc_oss_extable_name>; INSERT OVERWRITE TABLE <table_internal> SELECT * FROM <mc_oss_extable_name>; -
Yöntem 2: MaxCompute iç tablolarındaki işlemlere benzer şekilde doğrudan OSS'den veri okuyun.
Düşük performans gerektiren senaryolar için en iyisidir. Her sorgu, verileri iç depolamadan değil doğrudan OSS'den okur.
Bölümlenmiş veriler
Bölümlenmiş veriler
MaxCompute, OSS dizinindeki tüm verilerin (alt dizinler dahil) tam taramasını gerçekleştirir. Büyük veri kümeleri için bu durum gereksiz G/Ç'ye neden olur ve işlem süresini artırır. İki çözüm mevcuttur.
-
Yöntem 1 (Önerilen): Verileri OSS'de standart bölümlenmiş yol biçimi veya özel bölümlenmiş yol biçimi kullanarak depolayın.
Tablo oluşturma ifadesinde bölümü ve oss_location öğesini belirtin. Standart bölümlenmiş yollar önerilir.
-
Yöntem 2: Birden çok veri depolama yolu planlayın.
Her biri OSS verilerinin bir alt kümesine işaret eden birden çok harici tablo oluşturun. Bu yöntem zahmetlidir ve önerilmez.
Standart bölümlenmiş yol biçimi
oss://<oss_endpoint>/<Bucket name>/<directory name>/<partitionKey1=value1>/<partitionKey2=value2>/...Örnek: Bir şirket günlük log dosyalarını CSV biçiminde OSS'de depolar ve verileri her gün MaxCompute kullanarak işler. OSS verilerini depolamak için standart bölümlenmiş yol şu şekilde ayarlanmalıdır.
oss://oss-odps-test/log_data/year=2016/month=06/day=01/logfile
oss://oss-odps-test/log_data/year=2016/month=06/day=02/logfile
oss://oss-odps-test/log_data/year=2016/month=07/day=10/logfile
oss://oss-odps-test/log_data/year=2016/month=08/day=08/logfile
...
Özel bölümlenmiş yol biçimi
Özel bölümlenmiş yol biçimi yalnızca bölüm sütunu değerlerini içerir, bölüm sütunu adlarını içermez. Örnek:
oss://oss-odps-test/log_data_customized/2016/06/01/logfile
oss://oss-odps-test/log_data_customized/2016/06/02/logfile
oss://oss-odps-test/log_data_customized/2016/07/10/logfile
oss://oss-odps-test/log_data_customized/2016/08/08/logfile
...
OSS verileri standart olmayan bir bölümlenmiş yol kullanıyorsa alt dizinleri bölümlere manuel olarak bağlayabilirsiniz.
Harici tabloyu oluşturduktan sonra, alt dizinleri bölümlere bağlamak için alter table ... add partition ... location ... kullanın. Örnek:
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '06', day = '01')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/06/01/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '06', day = '02')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/06/02/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '07', day = '10')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/07/10/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '08', day = '08')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/08/08/';
Sorgu optimizasyonu
Dinamik istatistik toplama
Dinamik istatistik toplama
Harici verilerde önceden var olan istatistikler eksik olduğundan sorgu iyileştiricisi düşük verimlilikle muhafazakar bir strateji kullanır. Dinamik istatistik toplama, iyileştiricinin sorgu yürütme sırasında tablo istatistiklerini toplayarak küçük tabloları tanımlamasını sağlar; bu da Hash Join, optimize edilmiş join sırası, daha az karıştırma ve daha kısa yürütme ardışık düzenlerine olanak tanır.
Aşağıdaki parametreler yalnızca OSS'deki Hive tablosu senaryoları (Parquet, ORC, JSON ve CSV gibi) için geçerlidir ve Paimon harici tabloları, Hudi harici tabloları veya Delta Lake harici tabloları gibi lake tablosu senaryoları için geçerli değildir.
SET odps.meta.exttable.stats.onlinecollect=true;
SELECT * FROM <tablename>;
Performans testi
Test veri kümesi: TPC-DS verileri
Test ölçeği: 100 GB
Test kaynakları: 100 CU
Notlar: İş senaryoları farklılık gösterdiğinden, belirli iş yüklerinize göre daha fazla değerlendirme yapılması önerilir. Bayrağı iş SQL'inize göre seçici olarak etkinleştirin.
-
Bayrağı Etkinleştirme
SET odps.meta.exttable.stats.onlinecollect=true; -
Sonuç
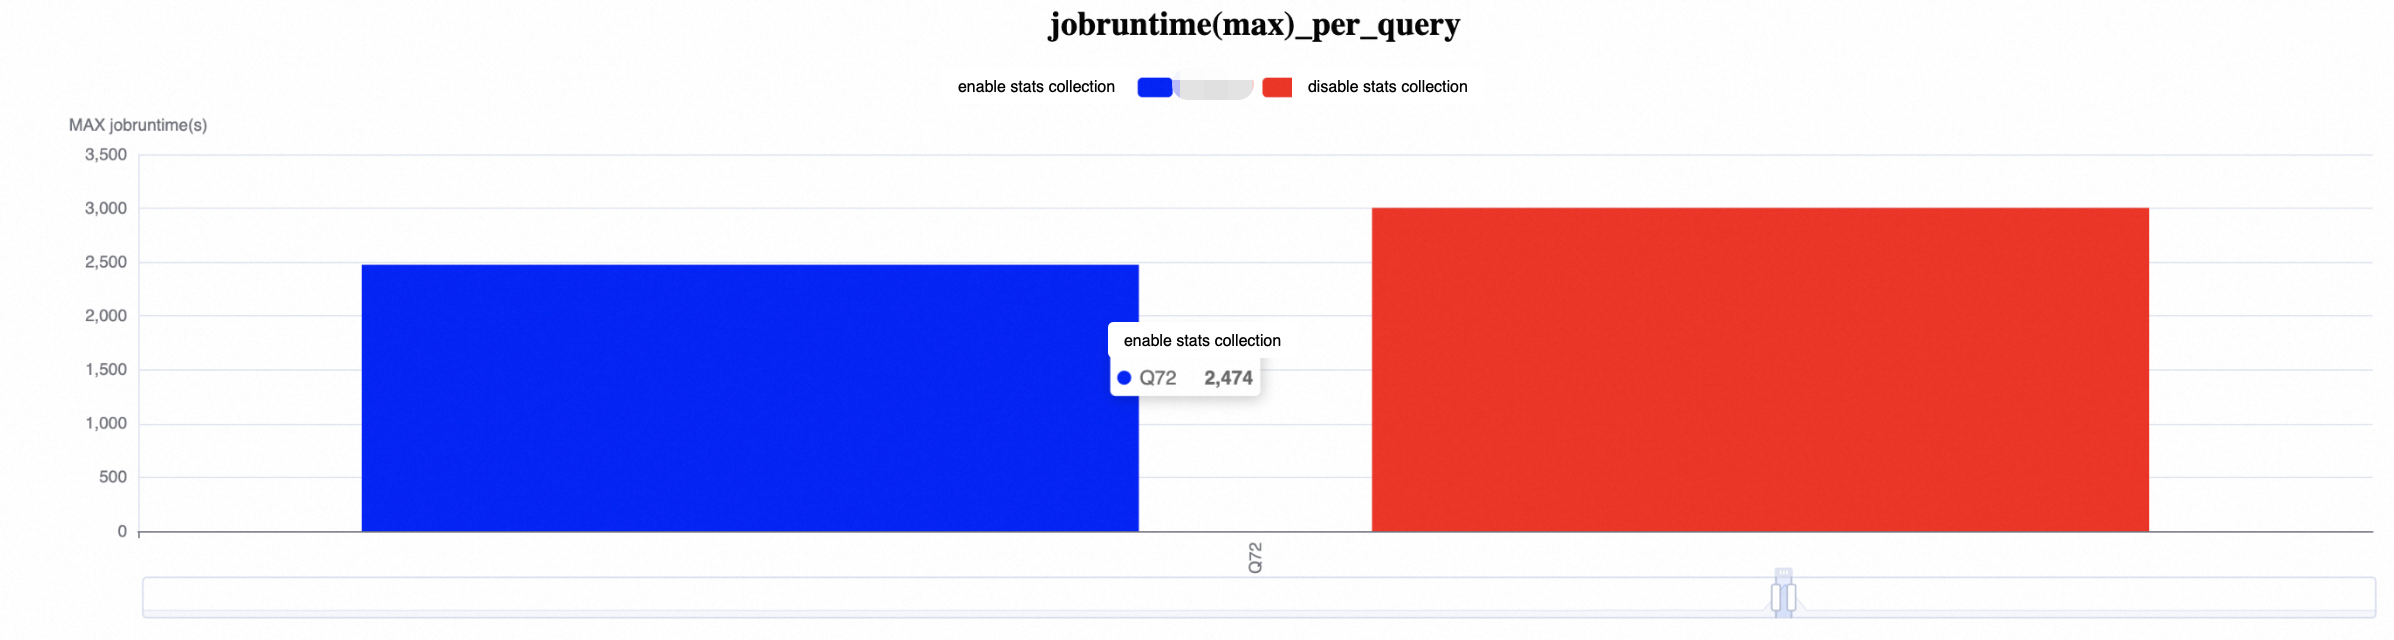
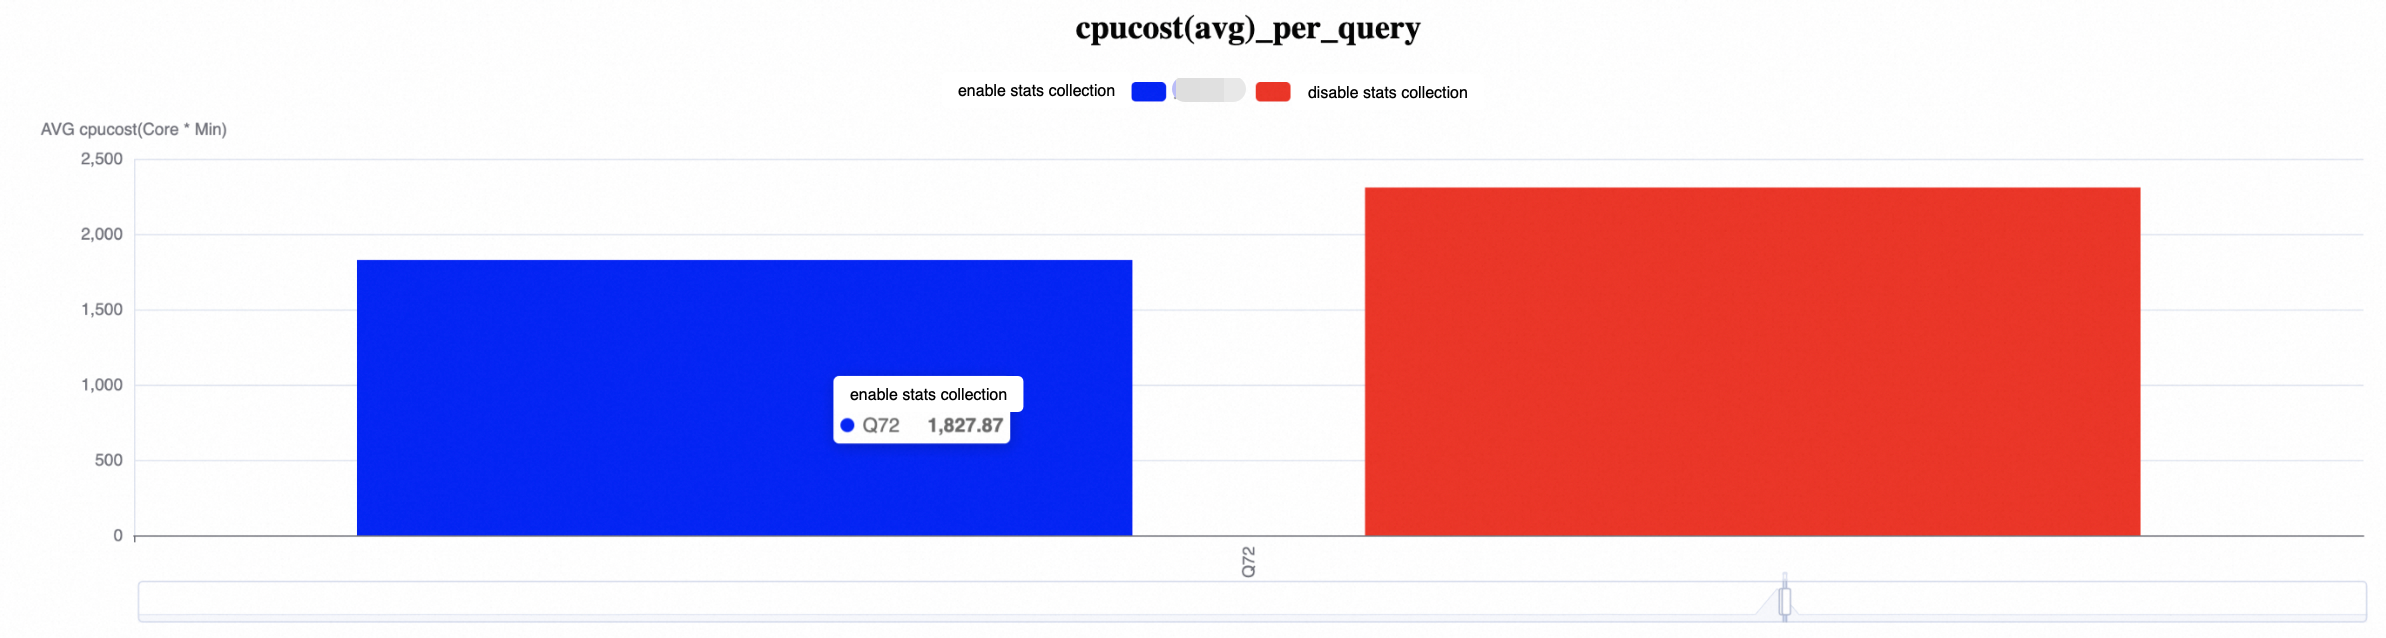
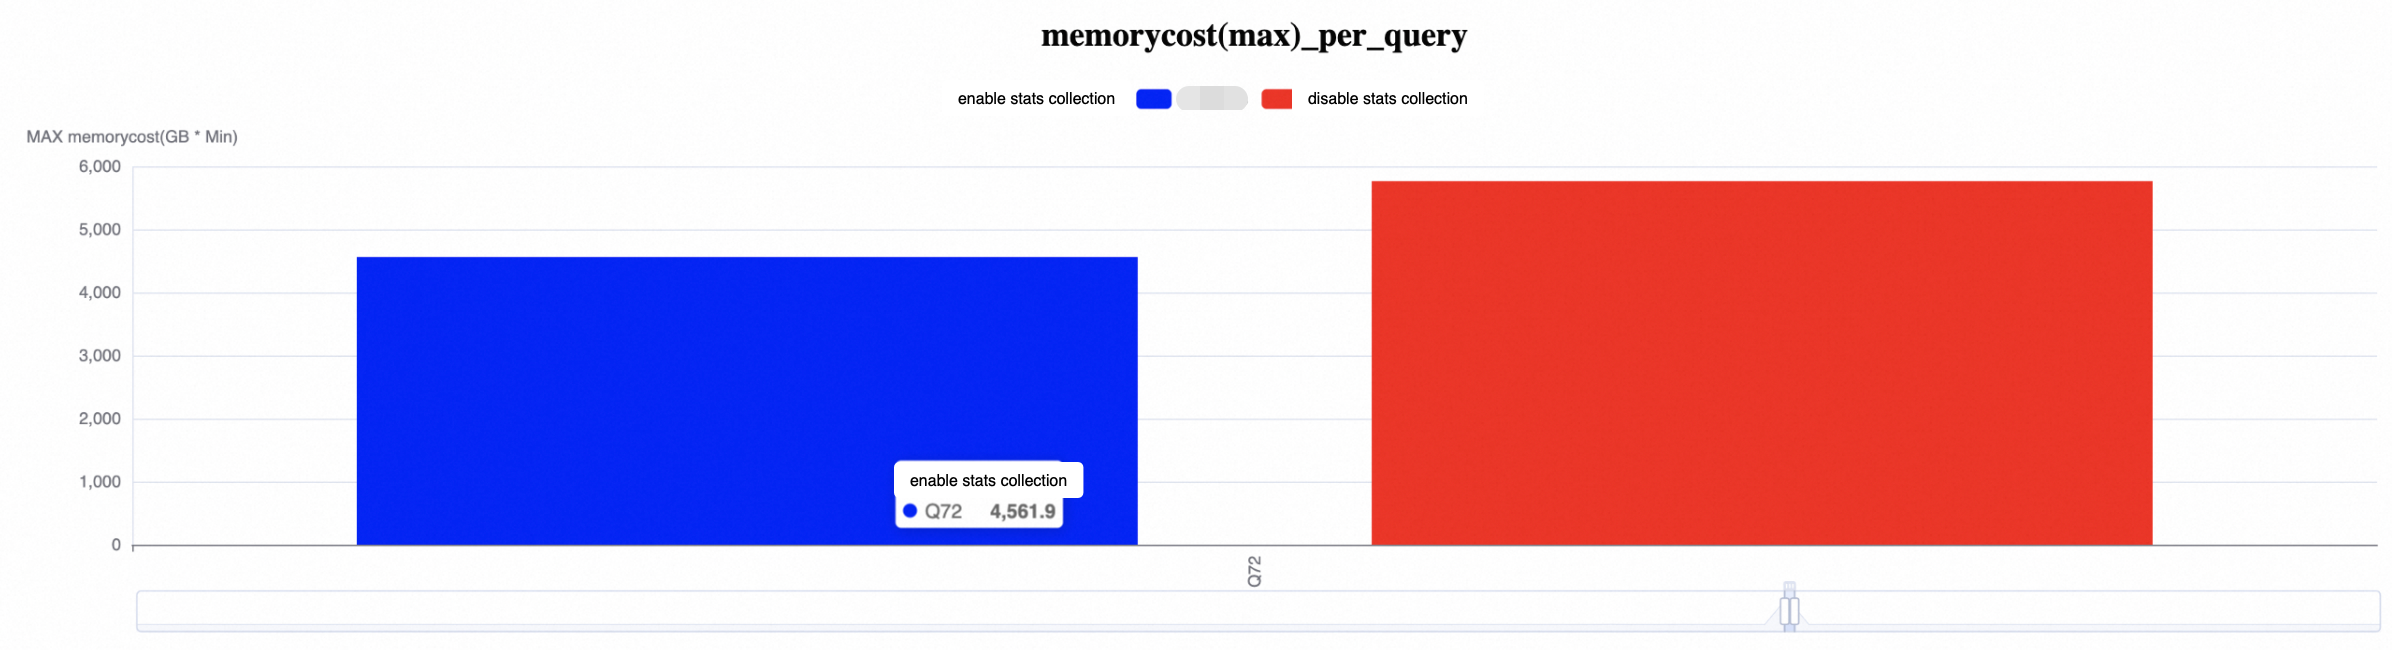
İş çalışma süresi %22,75, CPU kullanımı %21,72 ve bellek kullanımı %24 oranında azaldı.
Q72 en yavaş sorgudur; iş çalışma süresi %17,61, CPU %20,82 ve bellek %20,86 oranında azalmıştır.
TPCDS-Q72 için, küçük tablolarda eksik istatistikler önemli ölçüde yürütme planı bozulmasına neden olur; istatistik eklemek performansı 5 kata kadar artırır. Q3, Q18, Q19, Q72 ve Q99 da dikkate değer iyileşmeler göstermektedir.
Genel olarak, sorguların çoğu önemli ölçüde fayda sağlar. Yürütme planları etkilenmediği için uçtan uca sürede iyileşme görülmeyen az sayıda sorgu vardır ve bunlar yalnızca istatistik toplamadan kaynaklanan ek yükü getirir. İyileştirici aşamasında getirilen ek gecikme onlarca ila yüzlerce milisaniye arasında değişir ve uçtan uca süre üzerinde minimal etkiye sahiptir.
-
Tüm sorgular
İş çalışma süresi %22,75, CPU kullanımı %21,72 ve bellek kullanımı %24 oranında azaldı.
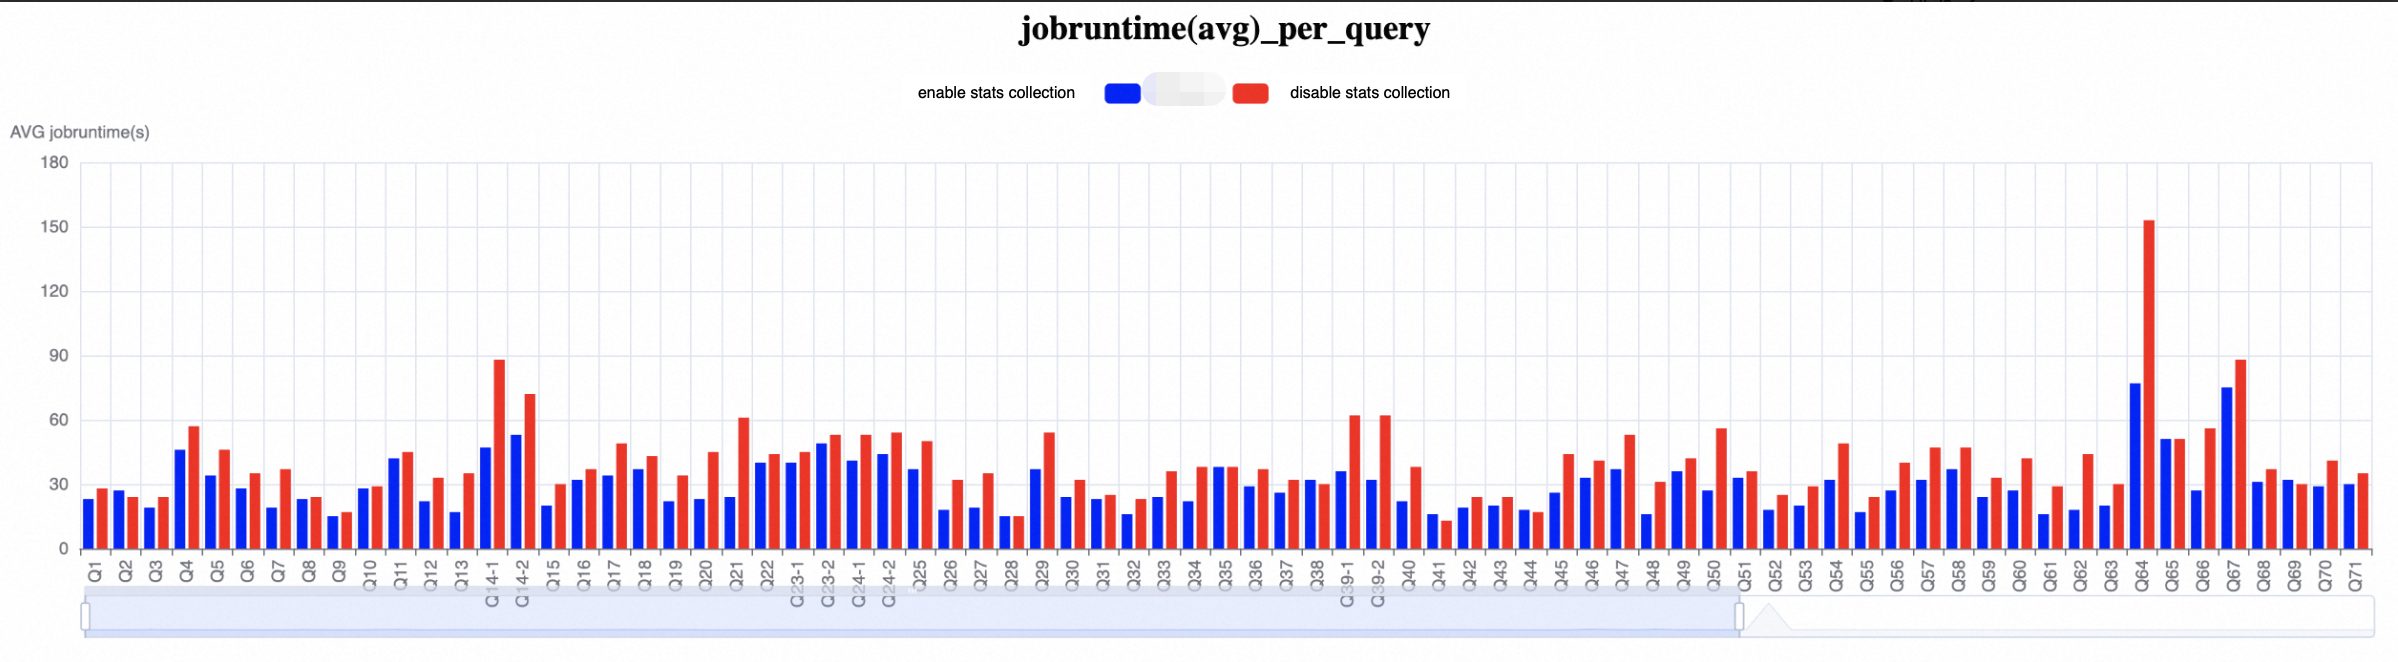
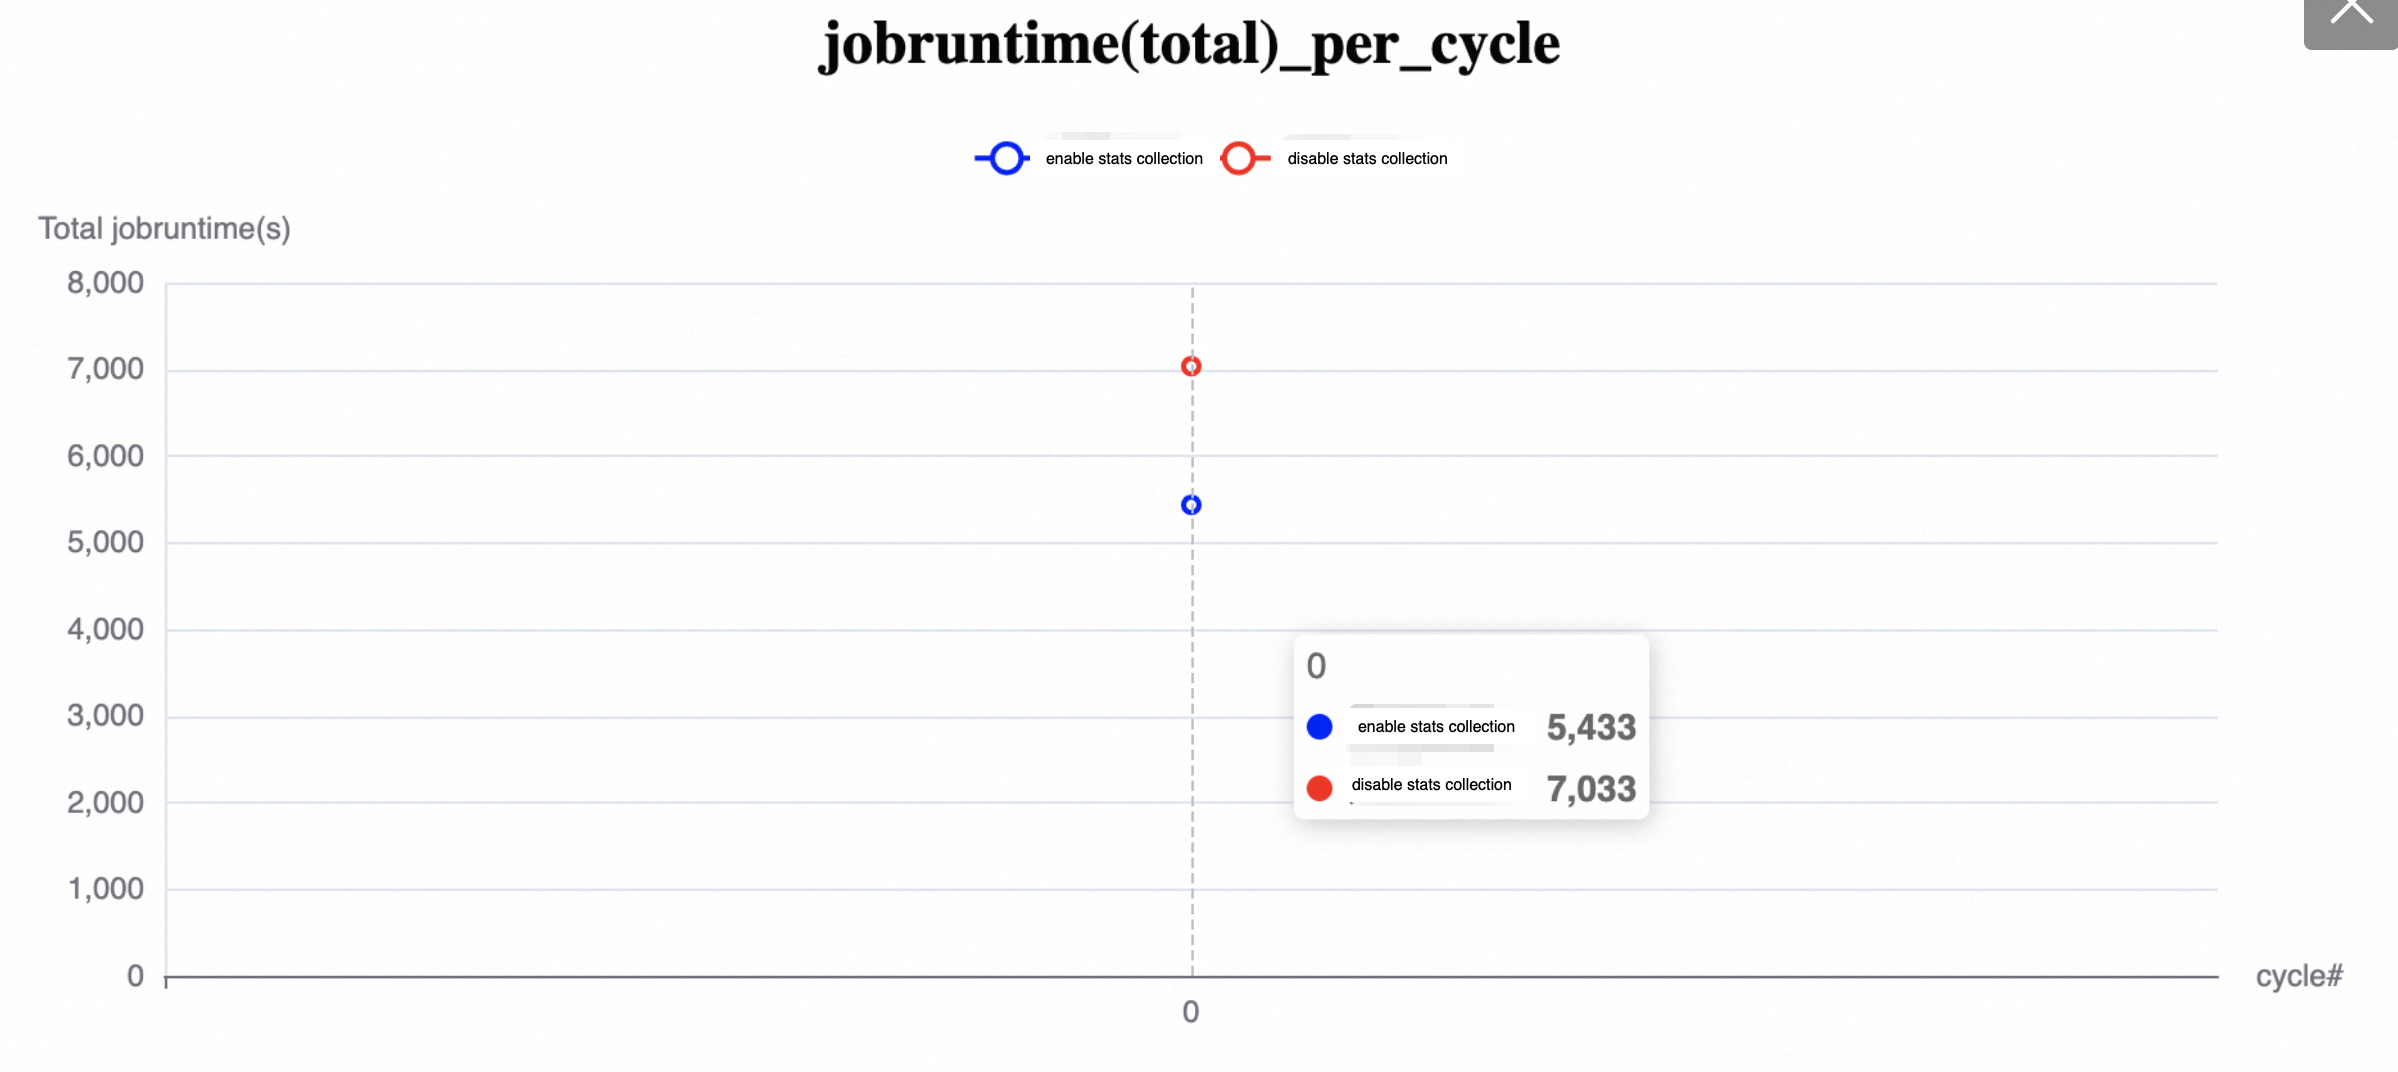
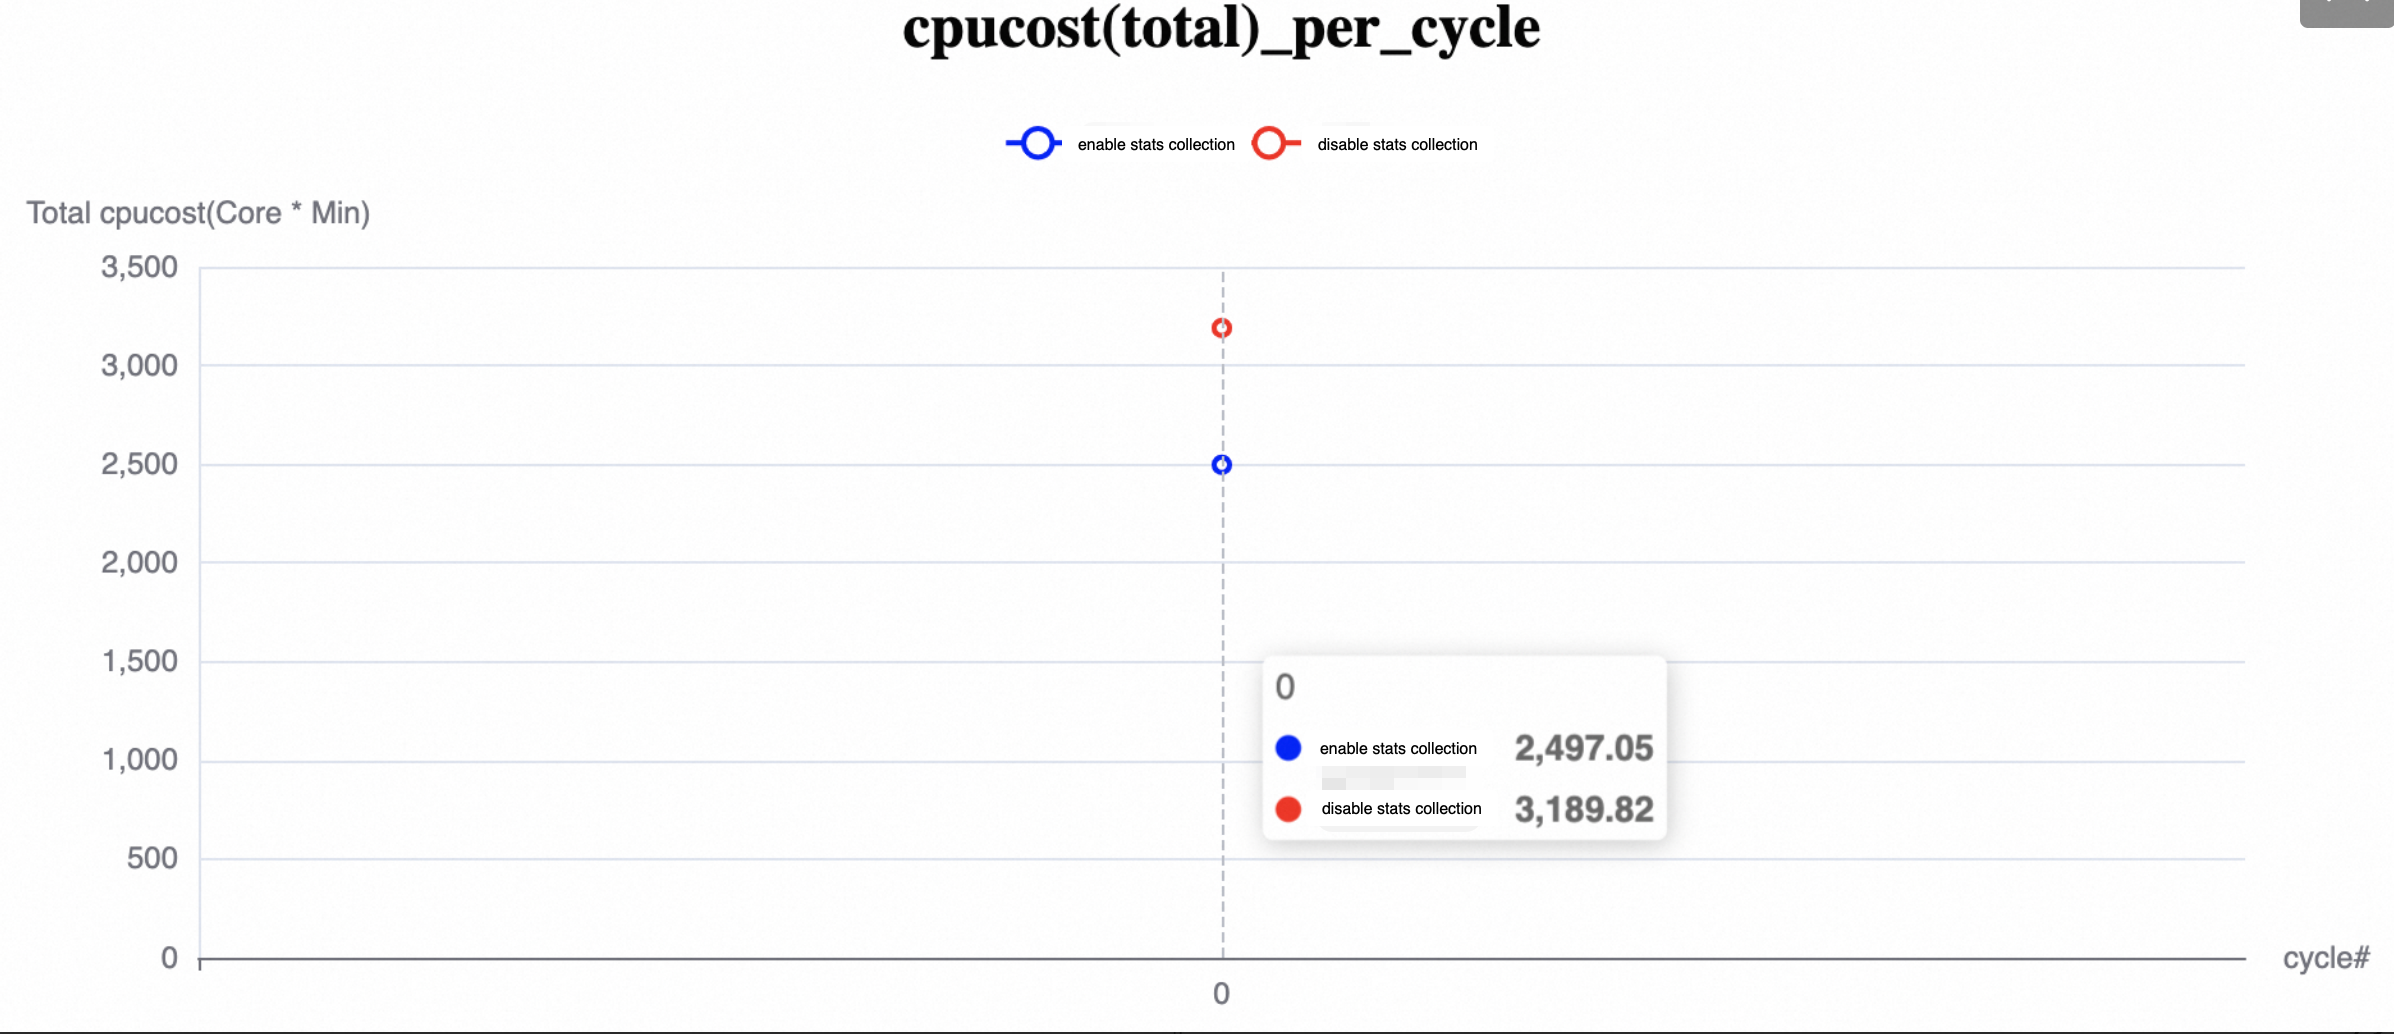
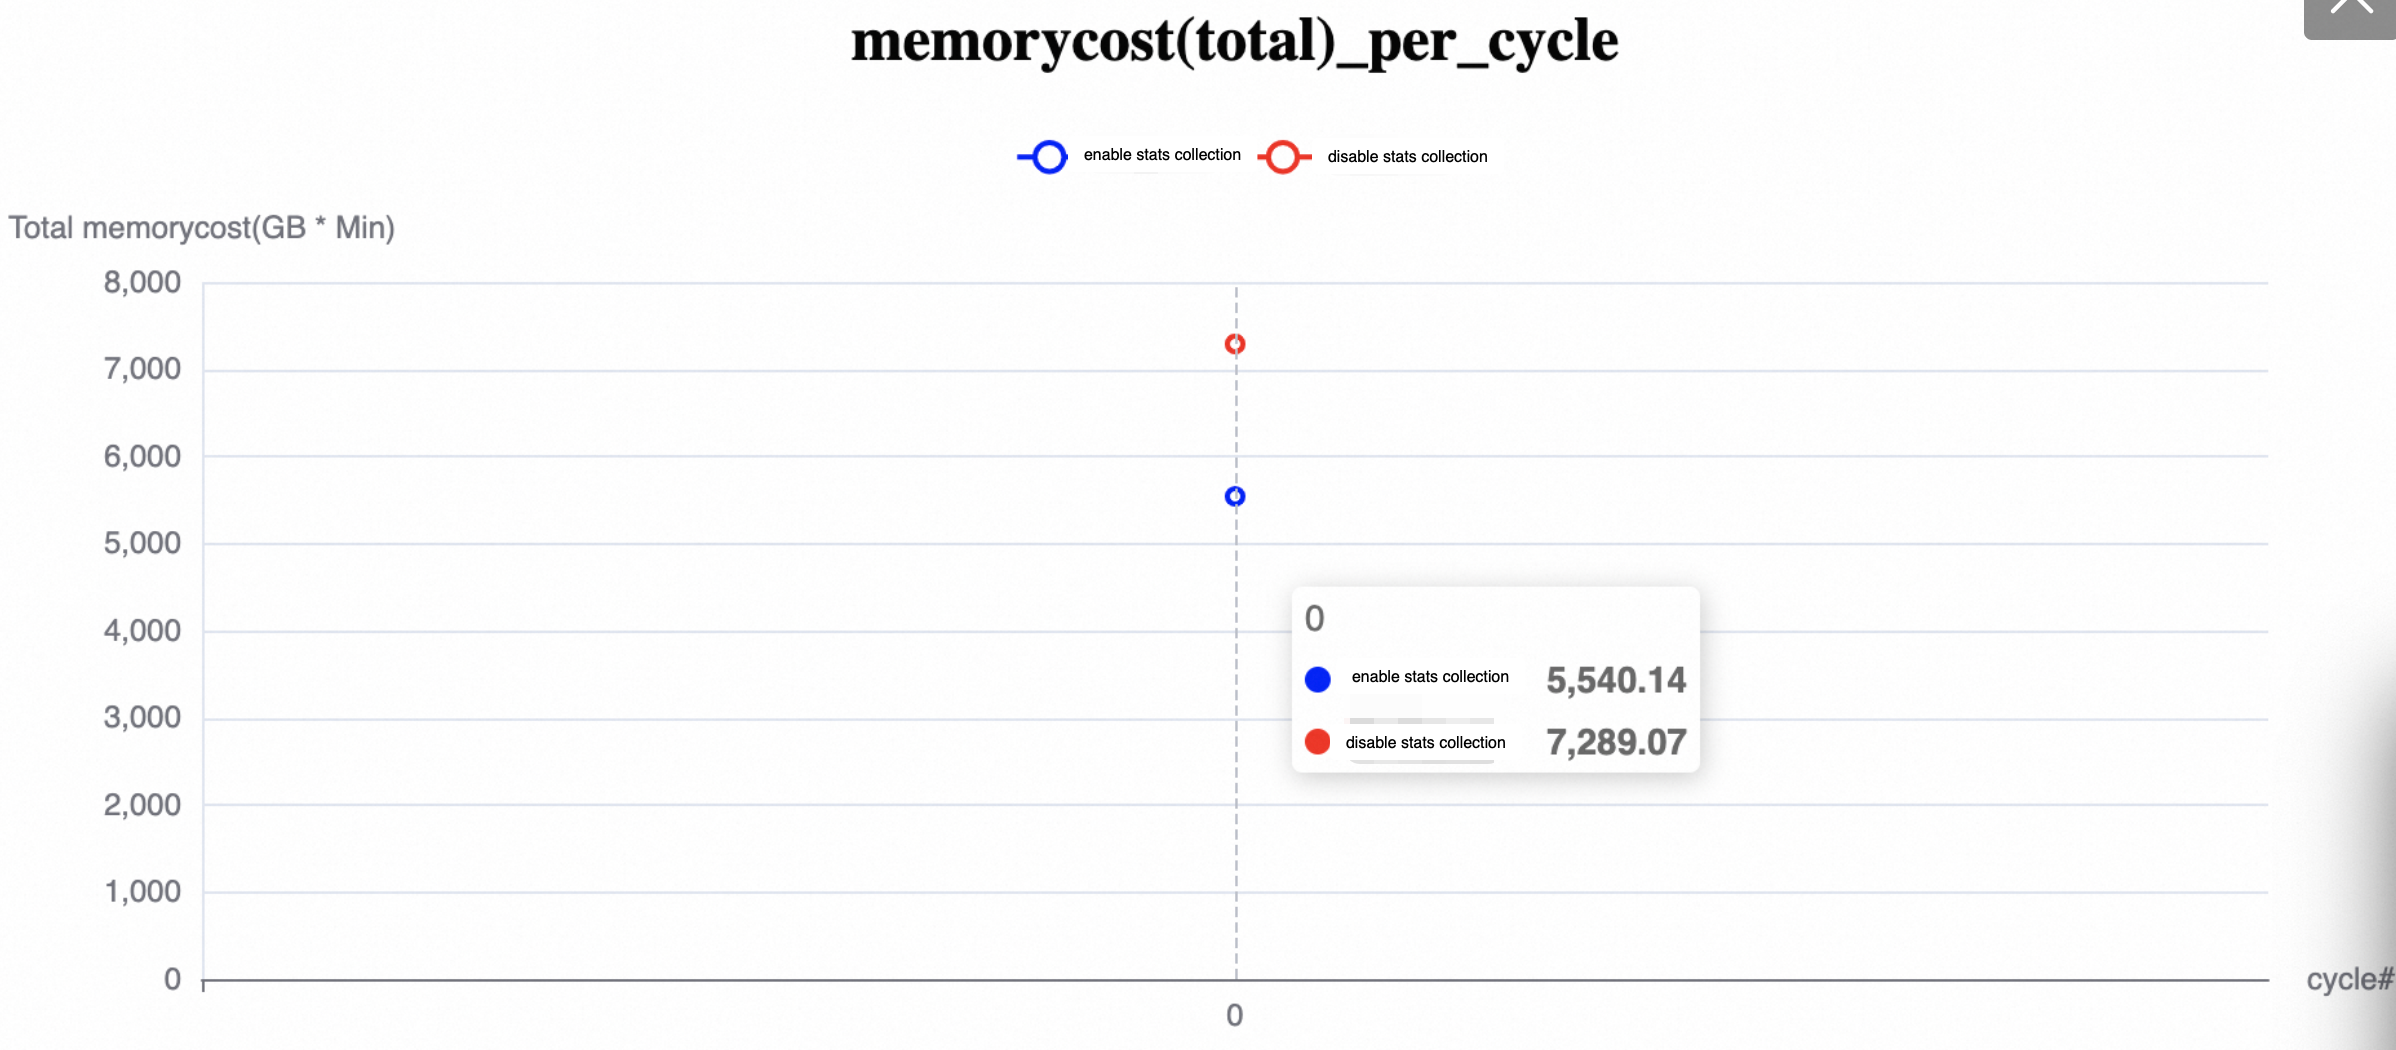
-
Q72
Q72 en yavaş sorgudur; iş çalışma süresi %17,61, CPU %20,82 ve bellek %20,86 oranında azalmıştır.
Harici tablo bölme optimizasyonu
Harici tablo bölme optimizasyonu
Her eşzamanlı görevin ne kadar veri işlediğini denetlemek için bölme boyutunu ayarlayın.
Veri hacmi büyükken bölme boyutu çok küçükse, aşırı bölmeler yüksek paralellliğe neden olur ve örnek zamanının çoğunu kaynak bekleyerek geçirir.
Veri hacmi küçükken bölme boyutu çok büyükse, çok az bölme yetersiz eşzamanlılığa ve boşta kalan kaynaklara neden olur.
-- You can use either of the following parameters.

-- Unit: MiB. Default value: 256 MiB. Applies to internal or external tables.
SET odps.stage.mapper.split.size=<value>;
SELECT * FROM <tablename>;

-- Unit: MiB. Default value: 256 MiB. Applies only to external tables.
SET odps.sql.unstructured.data.split.size=<value>;
SELECT * FROM <tablename>;
DOP denetimi
DOP ile paralellliği denetleme
Veri okurken paralellik derecesini ayarlamak için odps.sql.split.dop parametresini ayarlayabilirsiniz. Bu parametrenin önceliği odps.sql.mapper.split.size parametresinden daha yüksektir.
DOP değeri OSS dizinindeki dosya sayısından büyükse, gerçek eşzamanlılık yapılandırılan DOP değerinden önemli ölçüde farklı olabilir.
DOP değeri çok küçükse etkili olmaz. Tek bir örneğin işleyebileceği maksimum dosya sayısını değiştirmek için
odps.input.file.num.limitparametresini kullanın.
Sözdizimi
-- Syntax for the two-tier model: set odps.sql.split.dop={"project.table": xxx};
-- Syntax for the three-tier model: set odps.sql.split.dop={"project.schema.table": xxx};

SET odps.sql.split.dop={
  "project.schema.table1": xxx,
  "project.schema.table2": yyy
};

SET odps.sql.common.table.planner.ext.hive.bridge=FALSE;

SELECT * FROM <your_table>;
Kullanım örneği
Çok sayıda küçük dosyadan kaynaklanan DOP bozulması için sorun ve çözüm
MaxCompute, tek bir örneğin en fazla 240 dosya işlemesine izin verir. Bir OSS harici tablo dizini 3.449 dosya içeriyorsa minimum paralellik derecesi 3.449 / 240 ≈ 15 olacaktır. DOP'u 15'ten küçük bir değere ayarlarsanız ayar yok sayılır.
Bunu çözmek için, tek bir örneğin işleyebileceği maksimum dosya sayısını değiştirmek üzere odps.input.file.num.limit ayarlayın.
SET odps.sql.split.dop = {"lakehouse47_3.tpch_1t_parquet_snappy.lineitem": 2};
SET odps.input.file.num.limit = 5000;
Tek bir örnek en fazla 5.000 OSS dosyası işleyebilir. lineitem tablosundaki dosya sayısı bu sınırın çok altında olduğundan, gerçek paralellik derecesi yapılandırılan DOP değeriyle eşleşir.
OSS'ye veri yazma
MaxCompute, iç tablolardan veya işlenmiş harici tablolardan verileri OSS'ye yazabilir. Sınırlamalar için bkz. Kapsam.
Yerleşik metin veya açık kaynaklı veri ayrıştırıcısı kullanarak OSS'ye veri yazma: Yerleşik metin ayrıştırıcısı, Yerleşik açık kaynaklı ayrıştırıcı.
Özel ayrıştırıcı kullanarak OSS'ye veri yazma: Örnek: Özel ayrıştırıcı kullanarak OSS harici tablosu oluşturma.
OSS çok parçalı yükleme özelliğini kullanarak OSS'ye veri yazma: OSS çok parçalı yükleme özelliğini kullanarak OSS'ye veri yazma.
Sözdizimi
INSERT {INTO|OVERWRITE} TABLE <table_name> PARTITION (<ptcol_name>[, <ptcol_name> ...])
<select_statement> FROM <from_statement>;|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Dinamik bölümlere veri eklemek için bkz. Dinamik bölümlere veri ekleme veya üzerine yazma .
Notlar
INSERT OVERWRITE ... SELECT ... FROM ...;işlemi kaynak tablo from_tablename üzerinde 1.000 mapper ayırırsa 1.000 TSV veya CSV dosyası oluşturulur.-
Oluşturulan dosya sayısını MaxCompute tarafından sağlanan yapılandırmalar kullanarak denetleyebilirsiniz.
Çıktı alıcı bir mapper'daysa: Oluşturulan dosya sayısını ayarlamak için eşzamanlı mapper sayısını denetleyen
odps.stage.mapper.split.sizekullanın.Çıktı alıcı bir reducer veya joiner'daysa: Oluşturulan dosya sayısını ayarlamak için sırasıyla
odps.stage.reducer.numveodps.stage.joiner.numkullanın.
Tutarsız yazma riski: Bir OSS harici tablosunda INSERT OVERWRITE ifadesi kullandığınızda veya dosyaları OSS'ye aktarmak için UNLOAD komutunu kullandığınızda, belirtilen OSS konumunun alt dizinindeki veya bölüme karşılık gelen konumdaki veriler yeni veriler yazılmadan önce silinir. Konum dizini diğer harici motorlar tarafından doğrudan OSS'ye yazılan önemli veriler içeriyorsa, bu veriler de yeni veriler yazılmadan önce silinir. Bu nedenle, harici tablonun konum dizinindeki mevcut dosyaların yedeklendiğinden veya UNLOAD dizininin boş olduğundan emin olmalısınız. Diğer tutarsız yazma riskleri için bkz. Kapsam.
OSS çok parçalı yükleme özelliğini kullanarak OSS'ye veri yazma
Verileri açık kaynaklı biçimde OSS'ye yazmak için açık kaynaklı veri ayrıştırıcısına sahip bir harici tablo oluşturun ve OSS çok parçalı yükleme özelliğini etkinleştirin.
OSS çok parçalı yükleme özelliğini etkinleştirmek için aşağıdakileri ayarlayın:
Senaryo | Komut |
Proje düzeyinde ayarla | Tüm proje için etkili olur. |
Oturum düzeyinde ayarla | Yalnızca mevcut görev için etkili olur. |
odps.sql.unstructured.oss.commit.mode varsayılan değeri false'tur. İki mod şu şekilde çalışır:
|
|
|
|
|
|
|
|
|
Aktarılan dosyaları yönetme
Parametreler
Çıktı veri dosyalarına ön ek, son ek veya uzantı eklemek için aşağıdaki parametreleri kullanın.
property_name | Senaryo | Açıklama | property_value | Varsayılan değer |
odps.external.data.output.prefix (odps.external.data.prefix ile uyumlu) | Çıktı dosyalarına özel bir ön ek eklemeniz gerektiğinde bu özelliği ekleyin. |
| 'mc_' gibi izin verilen karakterlerin birleşimi | Yok |
odps.external.data.enable.extension | Çıktı dosyalarının uzantısını görüntülemeniz gerektiğinde bu özelliği ekleyin. | True, çıktı dosyasının uzantısının görüntülendiğini gösterir. False, görüntülenmediğini gösterir. |
| False |
odps.external.data.output.suffix | Çıktı dosyalarına özel bir son ek eklemeniz gerektiğinde bu özelliği ekleyin. | Yalnızca rakamlar, harfler ve alt çizgi içerir (a-z, A-Z, 0-9, _). | '_hangzhou' gibi izin verilen karakterlerin birleşimi | Yok |
odps.external.data.output.explicit.extension | Çıktı dosyalarına özel bir uzantı eklemeniz gerektiğinde bu özelliği ekleyin. |
| "jsonl" gibi izin verilen karakterlerin birleşimi | Yok |
Örnekler
-
OSS'ye yazılan dosyalar için özel ön eki
test06_olarak ayarlayın. DDL şu şekildedir:CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom prefix. 'odps.external.data.output.prefix'='test06_') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');Veri yazıldıktan sonra OSS'de oluşturulan dosyalar
test06_özel ön ekiyle adlandırılır, örneğintest06_202509101. -
OSS'ye yazılan dosyalar için son eki
_beijingolarak özelleştirmek üzere DDL şu şekildedir:CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom suffix. 'odps.external.data.output.suffix'='_beijing') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW'); -
Çıktı dosyaları için otomatik olarak bir dosya uzantısı oluşturmak üzere aşağıdaki DDL'yi kullanın:
CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Automatically generate a file extension. 'odps.external.data.enable.extension'='true') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW'); -
OSS'ye yazılan dosyalar için dosya uzantısını
jsonlolarak özelleştirmek üzere DDL şu şekildedir:CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom file extension. 'odps.external.data.output.explicit.extension'='jsonl') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');Oluşturulan dosya adı
20250905072538695g3mlopvxicr4_M1_1_0_0-0_TableSink1.jsonlşeklindedir ve özel dosya uzantısı.jsonlşeklindedir. -
OSS'ye yazılan dosyalar için ön eki
mc_, son eki_beijingve dosya uzantısınıjsonlolarak ayarlayın. DDL şu şekildedir:CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom prefix. 'odps.external.data.output.prefix'='mc_', -- Add a custom suffix. 'odps.external.data.output.suffix'='_beijing', -- Add a custom file extension. 'odps.external.data.output.explicit.extension'='jsonl') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');Oluşturulan dosya adı
mc_20250905073013526gra1l214x6t6_M1_1_0_0-0_TableSink1_beijing.jsonlşeklindedir; burada20250905073013526sistem tarafından oluşturulan zaman damgasıdır ve orta kısım görev tanımlayıcısıdır.
Dinamik bölümler kullanarak büyük dosyalar yazma
İş senaryosu
Bir ata tablodan hesaplama sonuçlarını bölümler halinde OSS'ye aktarın ve bunları büyük dosyalar (örn. 4 GB) olarak yazın. Dinamik bölümlerle odps.adaptive.shuffle.desired.partition.size parametresini (MB cinsinden) yapılandırın.
Avantaj: Parametre değerini yapılandırarak istenen çıktı dosyası boyutunu denetleyebilirsiniz.
Dezavantaj: Büyük dosya yazmak paralellik derecesini düşürdüğünden genel yürütme süresi daha uzundur, bu da yürütme süresini artırır.
Ölçüm açıklamaları
-- The service.mode must be turned off.
SET odps.service.mode=off;

-- The dynamic partition capability must be enabled.
SET odps.sql.reshuffle.dynamicpt=true;

-- Set the desired data consumption for each reducer. Assume you want each file to be 4 GB.
SET odps.adaptive.shuffle.desired.partition.size=4096;
Örnek
Yaklaşık 4 GB'lık bir JSON dosyasını OSS'ye yazın.
Test verilerini hazırlayın. Yaklaşık 30 GB olan
bigdata_public_dataset.tpcds_1t.web_salesgenel veri kümesi tablosunu kullanın. Veriler MaxCompute'te sıkıştırılmış biçimde depolandığından aktarımdan sonra boyut artar.-
Bir JSON harici tablosu oluşturun.
-- Sample table name: json_ext_web_sales CREATE EXTERNAL TABLE json_ext_web_sales( c_int INT , c_string STRING ) PARTITIONED BY (pt STRING) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss-mc-test/demo-test/'; -
Hiçbir parametre ayarlamadan test tablosunu dinamik bölüm biçiminde JSON harici tablosuna yazın.
-- The service.mode must be turned off.
set odps.service.mode=off;

-- Enable the Layer 3 syntax switch.
SET odps.namespace.schema=true;

-- Write to the JSON external table in a dynamic partition format.
INSERT OVERWRITE json_ext_web_sales
PARTITION(pt)
SELECT CAST(ws_item_sk AS INT) AS c_int,
       CAST(ws_bill_customer_sk AS string) AS c_string ,
      COALESCE(CONCAT(ws_bill_addr_sk %2, '_', ws_promo_sk %3),'null_pt') AS pt
FROM  bigdata_public_dataset.tpcds_1t.web_sales;
OSS'de sırasıyla 2.112 GB ve 2.102 GB boyutlarında iki dosya depolanır.
-
Büyük dosya çıktısı için
odps.adaptive.shuffle.desired.partition.sizeparametresini ekleyin ve test tablosunu dinamik bölüm biçiminde JSON harici tablosuna yazın.-- The service.mode must be turned off. SET odps.service.mode=off; -- Enable the Layer 3 syntax switch. SET odps.namespace.schema=true; -- The dynamic partition capability must be enabled. SET odps.sql.reshuffle.dynamicpt=true; -- Set the desired data consumption for each reducer. Assume you want each file to be 4 GB. SET odps.adaptive.shuffle.desired.partition.size=4096; -- Write to the JSON external table in a dynamic partition format. INSERT OVERWRITE json_ext_web_sales PARTITION(pt) SELECT CAST(ws_item_sk AS INT) AS c_int, CAST(ws_bill_customer_sk AS string) AS c_string , COALESCE(CONCAT(ws_bill_addr_sk %2, '_', ws_promo_sk %3),'null_pt') AS pt FROM bigdata_public_dataset.tpcds_1t.web_sales;Oluşturulan tek veri dosyasının boyutu yaklaşık 4.214 GB'dır.
OSS harici tablolarında bölüm işlemleri
OSS harici tabloları bölüm işlemlerini destekler. OSS harici tablolarında bölüm işlemleri ve İç tablolarda bölüm işlemleri konularına bakın. Aşağıdaki tabloda desteklenen işlemler listelenmiştir.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
OSS'ye aktarma veya OSS'den içe aktarma
LOAD komutu: OSS gibi harici depolamadan verileri bir MaxCompute tablosuna veya bölümüne aktarır.
UNLOAD komutu: Verileri bir MaxCompute projesinden OSS gibi harici depolamaya aktararak diğer hesaplama motorları tarafından kullanılmasını sağlar.
Ek: Örnek verileri hazırlama
-
OSS dizinlerini hazırlama
Sağlanan örnek veri bilgileri şu şekildedir:
oss_endpoint:
oss-cn-hangzhou-internal.aliyuncs.com, Çin (Hangzhou) bölgesidir.Paket adı:
oss-mc-test.Dizin adları:
Demo1/,Demo2/,Demo3/veSampleData/.
-
Bölümlenmemiş tablo verileri
Demo1/dizinine yüklenen dosya vehicle.csv'dir ve aşağıdaki verileri içerir.Demo1/dizini, yerleşik metin veri ayrıştırıcısıyla oluşturulan bölümlenmemiş bir tabloya eşlemek için kullanılır.1,1,51,1,46.81006,-92.08174,9/14/2014 0:00,S 1,2,13,1,46.81006,-92.08174,9/14/2014 0:00,NE 1,3,48,1,46.81006,-92.08174,9/14/2014 0:00,NE 1,4,30,1,46.81006,-92.08174,9/14/2014 0:00,W 1,5,47,1,46.81006,-92.08174,9/14/2014 0:00,S 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00,S 1,7,53,1,46.81006,-92.08174,9/15/2014 0:00,N 1,8,63,1,46.81006,-92.08174,9/15/2014 0:00,SW 1,9,4,1,46.81006,-92.08174,9/15/2014 0:00,NE 1,10,31,1,46.81006,-92.08174,9/15/2014 0:00,N -
Bölümlenmiş tablo verileri
Demo2/dizini beş alt dizin içerir:direction=N/,direction=NE/,direction=S/,direction=SW/vedirection=W/. Yüklenen dosyalar sırasıyla vehicle1.csv, vehicle2.csv, vehicle3.csv, vehicle4.csv ve vehicle5.csv'dir. Bu dosyalar aşağıdaki verileri içerir.Demo2/dizini, yerleşik metin veri ayrıştırıcısıyla oluşturulan bölümlenmiş bir tabloya eşlemek için kullanılır.--vehicle1.csv 1,7,53,1,46.81006,-92.08174,9/15/2014 0:00 1,10,31,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle2.csv 1,2,13,1,46.81006,-92.08174,9/14/2014 0:00 1,3,48,1,46.81006,-92.08174,9/14/2014 0:00 1,9,4,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle3.csv 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00 1,5,47,1,46.81006,-92.08174,9/14/2014 0:00 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle4.csv 1,8,63,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle5.csv 1,4,30,1,46.81006,-92.08174,9/14/2014 0:00 -
Sıkıştırılmış veriler
Demo3/dizinine yüklenen dosya vehicle.csv.gz'dir. Sıkıştırılmış paketin içindeki dosya,Demo1/dizinindeki dosyayla aynı içeriğe sahip olan vehicle.csv'dir. Sıkıştırma özelliklerine sahip bir OSS harici tablosuna eşlemek için kullanılır. -
Özel ayrıştırıcı verileri
SampleData/dizinine yüklenen dosya vehicle6.csv'dir ve aşağıdaki verileri içerir.SampleData/dizini, açık kaynaklı veri ayrıştırıcısıyla oluşturulan bir OSS harici tablosuna eşlemek için kullanılır.1|1|51|1|46.81006|-92.08174|9/14/2014 0:00|S 1|2|13|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|3|48|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|4|30|1|46.81006|-92.08174|9/14/2014 0:00|W 1|5|47|1|46.81006|-92.08174|9/14/2014 0:00|S 1|6|9|1|46.81006|-92.08174|9/14/2014 0:00|S 1|7|53|1|46.81006|-92.08174|9/14/2014 0:00|N 1|8|63|1|46.81006|-92.08174|9/14/2014 0:00|SW 1|9|4|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|10|31|1|46.81006|-92.08174|9/14/2014 0:00|N
OSS harici tablosu SSS
OSS harici tablosu kullanarak birden çok küçük dosyayı tek bir dosyada nasıl birleştiririm?
Bir OSS harici tablosundan okurken "Couldn't connect to server" hatasını nasıl çözerim?
Bir OSS harici tablosunda yavaş SQL işi yürütmesini nasıl çözerim?
Spark'tan bir OSS harici tablosuna erişirken oluşan "table not found" hatası için çözüm
Harici tablo kullanarak OSS verilerini işlerken "Inline data exceeds the maximum allowed size" hatasını nasıl çözerim?
-
Sorun
OSS verilerini işlerken
Inline data exceeds the maximum allowed sizehatası bildirilir. -
Neden
OSS Store'un her küçük dosya için bir boyut sınırı vardır. Bir dosya 3 GB'ı aşarsa hata bildirilir.
-
Çözüm
Her reducer'ın harici tabloya yazdığı veri boyutunu denetlemek ve dosyaları 3 GB sınırı içinde tutmak için aşağıdaki iki özelliği ayarlayın.
set odps.sql.mapper.split.size=256; # Adjusts the size of data read by each mapper, in MB.
set odps.stage.reducer.num=100; # Adjusts the number of workers in the reduce stage.
UDF yerel testleri geçse bile MaxCompute'te bir OSS harici tablosuna erişmek için bir UDF yükledikten sonra oluşan bellek taşması hatasını nasıl çözerim?
-
Sorun
MaxCompute'te bir OSS harici tablosuna erişirken, yerel testleri geçen bir UDF yüklendikten sonra aşağıdaki hatayı döndürür.
FAILED: ODPS-0123131:User defined function exception - Traceback:
java.lang.OutOfMemoryError: Java heap space
Aşağıdaki parametreleri ayarladıktan sonra çalışma süresi artar ancak hata devam eder.
set odps.stage.mapper.mem = 2048; set odps.stage.mapper.jvm.mem = 4096; -
Neden
Harici tabloda çok fazla nesne dosyası vardır, bu da aşırı bellek kullanımına neden olur ve bölüm ayarlanmamıştır.
-
Çözüm
Sorgu için daha az miktarda veri kullanın.
Bellek kullanımını azaltmak için nesne dosyalarını bölümlere ayırın.
OSS harici tablosu kullanarak birden çok küçük dosyayı tek bir dosyada nasıl birleştiririm?
SQL yürütme planındaki son aşamanın bir reducer mı yoksa joiner mı olduğunu görmek için Logview günlüğünü denetleyin.
Bir reducer ise
set odps.stage.reducer.num=1;ifadesini çalıştırınBir joiner ise
set odps.stage.joiner.num=1;ifadesini çalıştırın
Bir OSS harici tablosundan okurken "Couldn't connect to server" hatasını nasıl çözerim?
-
Sorun
Bir OSS harici tablosundan veri okurken
ODPS-0123131:User defined function exception - common/io/oss/oss_client.cpp(95): OSSRequestException: req_id: , http status code: -998, error code: HttpIoError, message: Couldn't connect to serverhatası bildirilir. -
Neden
Neden 1: OSS harici tablosu oluşturulurken oss_location adresindeki
oss_endpointiçin dahili bir uç nokta yerine genel bir uç nokta kullanıldı.Neden 2: OSS harici tablosu oluşturulurken oss_location adresindeki
oss_endpointiçin başka bir bölgenin uç noktası kullanıldı.
-
Çözüm
-
Neden 1 için
oss_location içindeki
oss_endpointöğesinin dahili bir uç nokta olduğunu doğrulayın. Genel bir uç noktaysa dahili bir uç noktayla değiştirin. Bkz. Parametreler.Örneğin, Endonezya (Cakarta) bölgesindeki bir kullanıcı harici tablo oluşturmak için
oss://oss-ap-southeast-5.aliyuncs.com/<bucket>/....adresini kullandıysa, bu adres karşılık gelen dahili adresoss://oss-ap-southeast-5-internal.aliyuncs.com/<bucket>/....ile değiştirilmelidir. -
Neden 2 için
oss_location içindeki
oss_endpointöğesinin erişmek istediğiniz bölgeyle eşleştiğini doğrulayın. OSS klasik ağ alan adları Bölgeler ve uç noktalar bölümünde listelenmiştir.
-
Bir OSS harici tablosu oluştururken "Network is unreachable (connect failed)" hatasını nasıl çözerim?
-
Sorun
Bir OSS harici tablosu oluştururken
ODPS-0130071:[1,1] Semantic analysis exception - external table checking failure, error message: Cannot connect to the endpoint 'oss-cn-beijing.aliyuncs.com': Connect to bucket.oss-cn-beijing.aliyuncs.com:80 [bucket.oss-cn-beijing.aliyuncs.com] failed: Network is unreachable (connect failed)hatası bildirilir. -
Neden
OSS harici tablosu oluşturulurken oss_location adresindeki
oss_endpointiçin dahili bir uç nokta yerine genel bir uç nokta kullanıldı. -
Çözüm
oss_location içindeki
oss_endpointöğesinin dahili bir uç nokta olduğunu doğrulayın. Genel bir uç noktaysa dahili bir uç noktayla değiştirin. Bkz. Parametreler.Örneğin, Çin (Pekin) bölgesindeki bir kullanıcı harici tablo oluşturmak için
oss://oss-cn-beijing.aliyuncs.com/<bucket>/....adresini kullandıysa, bu adres karşılık gelen dahili adresoss://oss-cn-beijing-internal.aliyuncs.com/<bucket>/....ile değiştirilmelidir.
Bir OSS harici tablosunda yavaş SQL işi yürütmesini nasıl çözerim?
-
Bir OSS harici tablosunda GZ sıkıştırılmış dosyaların yavaş okunması
-
Belirtiler
Bir kullanıcı, OSS'de 200 GB'lık bir GZ sıkıştırılmış dosyayı veri kaynağı olarak alan bir OSS harici tablosu oluşturdu. Veri okuma işlemi yavaştır.
-
Neden
Map aşamasında hesaplama yapan çok az mapper olduğu için SQL işleme hızı yavaştır.
-
Çözüm
-
Yapılandırılmış veriler için, SQL yürütmesini hızlandırmak üzere tek bir mapper tarafından okunan veri miktarını ayarlamak amacıyla aşağıdaki parametreyi ayarlayabilirsiniz.
set odps.sql.mapper.split.size=256; # Adjusts the size of table data read by each mapper, in MB. Yapılandırılmamış veriler için OSS harici tablo yolunda yalnızca bir OSS dosyası olup olmadığını denetleyin. Yalnızca bir dosya varsa, sıkıştırılmış biçimdeki yapılandırılmamış veriler bölünemediğinden yalnızca bir mapper oluşturulabilir. Bu durum yavaş işlemeye neden olur. Büyük OSS dosyasını OSS'deki karşılık gelen harici tablo yolunda daha küçük dosyalara bölmenizi öneririz. Bu, harici tablo okunurken oluşturulan mapper sayısını artırır ve okuma hızını iyileştirir.
-
-
-
SDK kullanarak MaxCompute harici tablo verilerinin yavaş aranması
-
Belirtiler
SDK kullanarak MaxCompute harici tablo verilerini aramak yavaştır.
-
Çözüm
Harici tablolar yalnızca tam tablo taramalarını destekler, bu da yavaştır. Bunun yerine bir MaxCompute iç tablosu kullanın.
-
OSS çok parçalı yükleme özelliğini kullanırken eski verilerin silinip yeni verilerin yazılmaması sorununu nasıl çözerim?
-
Sorun
Bir
insert overwritesenaryosunda, aşırı durumlarda iş başarısız olursa sonuç beklentilerle tutarsız olabilir. Eski veriler silinir ancak yeni veriler yazılmaz. -
Neden
Yeni yazılan veriler, çok düşük olasılıklı bir donanım arızası veya meta veri güncelleme hatası nedeniyle hedef tabloya yazılamaz. OSS'deki silme işlemi geri almayı desteklemez, bu nedenle silinen eski veriler kurtarılamaz.
-
Çözüm
Eski verilerine dayalı olarak bir OSS harici tablosunun üzerine yazıyorsanız, örneğin
insert overwrite table T select * from table T;, OSS verilerini önceden yedekleyin. İş başarısız olursa, yedeklenen eski verilere dayalı olarak OSS harici tablosunun üzerine yazabilirsiniz.insert overwriteişi yeniden gönderilebiliyorsa, başarısız olması durumunda işi yeniden gönderin.
Spark'tan bir OSS harici tablosuna erişirken oluşan "table not found" hatası için çözüm
-
Sorun
Spark kullanarak bir OSS harici tablosuna erişirken görev "table not found" hatasıyla başarısız olur.
-
Çözüm
-
Aşağıdaki parametreleri ekleyin:
Harici tablo yapılandırmasını etkinleştirin:spark.sql.catalog.odps.enableExternalTable=true;
OSS'nin bulunduğu bölgeyi yapılandırın:spark.hadoop.odps.oss.region.default=cn-<bölge>
-
Yukarıdaki parametreleri ekledikten sonra hata devam ederse:
at java.lang.Thread.run(Thread.java:745)
Caused by: java.lang.Exception: com.aliyun.odps.cupid.CupidException: connectionId and rolearn are mutually exclusive
    at com.aliyun.odps.cupid.table.v1.commontable.impl.reader.CupidCommonTableReadSession.splitTable
OSS harici tablosunu yeniden oluşturun ve ardından tekrar erişin.
-
Referanslar
-
Desteklenen OSS harici tablo biçimleri:
Bir OSS harici tablosu oluşturun ve özel bir ayrıştırıcı kullanarak OSS'den okuyun veya OSS'ye yazın: Özel ayrıştırıcılar.
Bir OSS dosyasını sütun filtreleme ve işlemeyi destekleyen bir şemaya sahip bir veri kümesine ayrıştırın: Özellik: Şemasız Sorgu.