全部產品
Search
文件中心

Alibaba Cloud Model Studio:模型調優簡介

更新時間:Oct 14, 2026

當您在嘗試如 Prompt 工程、外掛程式調用等最佳化方法後,模型表現仍然不及預期時,請使用阿里雲百鍊的模型調優。模型調優作為改進模型表現的核心策略,可以很好地提升模型在特定行業/業務的表現,對齊人類偏好,降低輸出延遲。模型調優包含模型微調(SFT)、繼續預訓練(CPT)、模型偏好訓練(DPO)三種模型訓練方式。

模型調優介紹

模型調優作為重要的模型效果最佳化方式,可以:

  • 提升模型在特定行業/業務表現
  • 降低模型輸出延遲
  • 抑制模型幻覺
  • 對齊人類的價值觀或偏好
  • 使用調優後的輕量級模型替代規模更大的模型

模型在調優過程中,會學習訓練資料中的知識、語氣、表達習慣、自我認知等業務/情境特徵。也由於已經在訓練過程中學習到了大量特定行業/情境的範例,訓練後模型 One-Shot 或者 Zero-Shot 的 Prompt 效果會比訓練前 Few-Shot 效果更好,這樣可以節省大量輸入 token,從而降低模型輸出延遲。

模型調優流程

詳情參見:

支援的模型

支援的模型

新加坡

文本產生

模型名稱

模型代碼

SFT全參訓練(sft)

SFT高效訓練(efficient_sft)

Qwen3.5-27B

qwen3.5-27b

支援

支援

Qwen3.5-9B

qwen3.5-9b

支援

支援

Qwen3-14B

qwen3-14b

×

支援

視覺理解(千問VL)

模型名稱

模型代碼

SFT全參訓練(sft)

SFT高效訓練(efficient_sft)

-

-

-

-

華北二(北京)

文本產生

模型服務

模型代碼

CPT全參訓練(cpt)

SFT全參訓練(sft)

SFT高效訓練(efficient_sft)

DPO全參訓練(dpo_full)

DPO高效訓練(dpo_lora)

Qwen3.7-Plus-2026-05-26

qwen3.7-plus-2026-05-26

×

支援

×

×

×

Qwen3.6-Flash-2026-04-16

qwen3.6-flash-2026-04-16

×

支援

×

×

×

Qwen3.6-Plus-2026-04-02

qwen3.6-plus-2026-04-02

×

支援

×

×

×

Qwen3.5-27B

qwen3.5-27b

×

支援

支援

×

×

Qwen3.5-9B

qwen3.5-9b

×

支援

支援

×

×

Qwen3.5-Flash-2026-02-23

qwen3.5-flash-2026-02-23

×

支援

×

×

×

Qwen3.5-Plus-2026-02-15

qwen3.5-plus-2026-02-15

×

支援

×

×

×

Qwen3-32B

qwen3-32b

支援

支援

支援

支援

支援

Qwen3-30B-A3B-Instruct-2507

qwen3-30b-a3b-instruct-2507

支援

支援

支援

×

×

Qwen3-14B

qwen3-14b

×

支援

支援

支援

支援

Qwen3-8B

qwen3-8b

×

支援

支援

支援

支援

Qwen3-4B-Instruct-2507

qwen3-4b-instruct-2507

支援

支援

支援

支援

支援

Qwen3-1.7B

qwen3-1.7b

支援

支援

支援

支援

支援

Qwen3-0.6B

qwen3-0.6b

支援

支援

支援

支援

支援

Qwen2.5-72B-Instruct

qwen2.5-72b-instruct

支援

支援

支援

支援

支援

Qwen2.5-32B-Instruct

qwen2.5-32b-instruct

支援

支援

支援

支援

支援

Qwen2.5-14B-Instruct

qwen2.5-14b-instruct

支援

支援

支援

支援

支援

Qwen2.5-7B-Instruct

qwen2.5-7b-instruct

支援

支援

支援

支援

支援

千問-Plus-Character-2025-11-06

qwen-plus-character-2025-11-06

×

支援

支援

支援

支援

視覺理解(千問VL)

模型服務

模型代碼

CPT全參訓練(cpt)

SFT全參訓練(sft)

SFT高效訓練(efficient_sft)

DPO全參訓練(dpo_full)

DPO高效訓練(dpo_lora)

Qwen3-VL-8B-Instruct

qwen3-vl-8b-instruct

×

支援

支援

×

×

Qwen3-VL-8B-Thinking

qwen3-vl-8b-thinking

×

支援

支援

×

×

Qwen3-VL-4B-Instruct

qwen3-vl-4b-instruct

×

支援

支援

×

×

Qwen2.5-VL-72B-Instruct

qwen2.5-vl-72b-instruct

×

支援

支援

×

×

Qwen2.5-VL-32B-Instruct

qwen2.5-vl-32b-instruct

×

支援

支援

×

×

Qwen2.5-VL-7B-Instruct

qwen2.5-vl-7b-instruct

×

支援

支援

×

×

調優方法對比

特性

CPT(持續預訓練)

SFT (監督微調)

DPO (直接偏好最佳化)

一句話總結

補知識(注入領域知識)

學做事(學會遵循指令)

做得更好(對齊人類偏好)

輸入資料

1000萬+ Token

無標籤的領域文本

1000+ 條

高品質的“問-答”對

100+ 組

同一指令下的“更好-更差”回答對

核心目標

領域適應,學習專業詞彙和事實

教會模型對話格式和任務執行能力

使模型輸出更符合人類價值觀和偏好

學習方式

自監督學習(預測下一個詞)

監督學習(模仿標準答案)

直接偏好學習(增大好答案機率,降低壞答案機率)

模型階段

通常在 SFT 之前

CPT 之後,DPO 之前

通常在 SFT 之後,作為對齊的最後一步

訓練模式對比

全參訓練

高效訓練 (LoRA,推薦)

適用情境

• 需要模型學習新能力

• 追求全域效果最優

• 最佳化模型特定情境下的效果

• 對訓練時間和成本敏感的情境

訓練時間

較長,收斂速度較慢。

較短,收斂速度快。

計費說明

計費方式

按訓練的資料量計費

計費公式

模型訓練費用 = (訓練資料 Token 總數 + 混合訓練資料 Token 總數)× 迴圈次數 × 訓練單價(最小計費單位:1 token)

您可以查看模型調優控制台底部的預估訓練費用,並單擊计算详情,查看訓練 Token 總數、迴圈次數和訓練單價。

訓練單價

以下為預置模型的訓練單價,自訂模型的訓練單價與對應的預置模型單價相同。

新加坡

千問

模型服務

模型代碼

價格

Qwen3.5-27B

qwen3.5-27b

$0.0075/千Token

Qwen3.5-9B

qwen3.5-9b

$0.003/千Token

Qwen3-14B

qwen3-14b

$0.0016/千Token

千問VL

模型服務

模型代碼

價格

-

-

-

華北二(北京)

千問

模型服務

模型代碼

價格

Qwen3.7-Plus-2026-05-26

qwen3.7-plus-2026-05-26

$0.048132/千Token

Qwen3.6-Flash-2026-04-16

qwen3.6-flash-2026-04-16

$0.006876/千Token

Qwen3.6-Plus-2026-04-02

qwen3.6-plus-2026-04-02

$0.041256/千Token

Qwen3.5-27B

qwen3.5-27b

$0.006876/千Token

Qwen3.5-9B

qwen3.5-9b

$0.00275/千Token

Qwen3.5-Flash-2026-02-23

qwen3.5-flash-2026-02-23

$0.006876/千Token

Qwen3.5-Plus-2026-02-15

qwen3.5-plus-2026-02-15

$0.041256/千Token

Qwen3-32B

qwen3-32b

$0.005501/千Token

Qwen3-30B-A3B-Instruct-2507

qwen3-30b-a3b-instruct-2507

$0.004126/千Token

Qwen3-14B

qwen3-14b

$0.004126/千Token

Qwen3-8B

qwen3-8b

$0.000825/千Token

Qwen3-4B-Instruct-2507

qwen3-4b-instruct-2507

$0.000825/千Token

Qwen3-1.7B

qwen3-1.7b

$0.000619/千Token

Qwen3-0.6B

qwen3-0.6b

$0.000413/千Token

Qwen2.5-72B-Instruct

qwen2.5-72b-instruct

$0.020628/千Token

Qwen2.5-32B-Instruct

qwen2.5-32b-instruct

$0.004126/千Token

Qwen2.5-14B-Instruct

qwen2.5-14b-instruct

$0.004126/千Token

Qwen2.5-7B-Instruct

qwen2.5-7b-instruct

$0.000825/千Token

千問-Plus-Character-2025-11-06

qwen-plus-character-2025-11-06

$0.020628/千Token

千問VL

模型服務

模型代碼

價格

Qwen3-VL-8B-Instruct

qwen3-vl-8b-instruct

$0.00165/千Token

Qwen3-VL-8B-Thinking

qwen3-vl-8b-thinking

$0.00165/千Token

Qwen3-VL-4B-Instruct

qwen3-vl-4b-instruct

$0.000825/千Token

Qwen2.5-VL-72B-Instruct

qwen2.5-vl-72b-instruct

$0.006876/千Token

Qwen2.5-VL-32B-Instruct

qwen2.5-vl-32b-instruct

$0.00275/千Token

Qwen2.5-VL-7B-Instruct

qwen2.5-vl-7b-instruct

$0.001375/千Token

點擊此處查看更多千問 VL 模型使用限制

使用限制
輸入檔案限制

映像限制

  • 映像解析度:
    • 最小尺寸:映像的寬度和高度均須大於10像素。

    • 寬高比:原圖及縮放後的映像,長邊與短邊的比值不得超過 200:1。

      映像縮放邏輯請參見 計算映像的Token 中 smart_resize 函數。

    • 像素上限:

      • 推薦將映像解析度控制在8K(7680x4320)以內。超過此解析度的映像可能因檔案過大、網路傳輸耗時過長而導致API調用逾時。
      • 自動縮放機制:模型可通過max_pixels和min_pixels調整映像大小;因此,提供超高解析度的映像並不會提升識別精度,反而會增加調用失敗的風險,建議在用戶端提前將映像縮放至合理大小。
  • 支援的映像格式
    • 解析度在4K (3840x2160)以下,支援的映像格式如下:

      映像格式

      常見副檔名

      MIME Type

      BMP

      .bmp

      image/bmp

      JPEG

      .jpe, .jpeg, .jpg

      image/jpeg

      PNG

      .png

      image/png

      TIFF

      .tif, .tiff

      image/tiff

      WEBP

      .webp

      image/webp

      HEIC

      .heic

      image/heic

    • 解析度處於4K(3840x2160)到8K(7680x4320)範圍,僅支援 JPEG、JPG 、PNG 格式

  • 映像大小:
    • 以公網URL傳入時:Qwen3.8系列、Qwen3.7系列、Qwen3.6系列、Qwen3.5系列、Qwen3-VL系列單個映像不超過 20MB,其他模型單個映像不超過10MB
    • 以本地路徑傳入時:單個映像不超過10MB
    • 以 Base 64 編碼傳入時(OpenAI 相容介面或DashScope):Qwen3.8系列、Qwen3.7系列、Qwen3.6系列、Qwen3.5、Qwen3-VL系列編碼前的原始影像檔不超過 20MB,其他模型不超過10MB;且編碼後的 Data URI 字串不超過 20MB。
    • 以 Base 64 編碼傳入時(Anthropic 相容介面):受請求體整體不超過6MB 的限制,多張映像時需共用此額度。

    上述限制取決於所選模型,不支援通過購買進階套餐或升級模型版本提升。

    如需壓縮檔體積請參見 如何將映像或視頻壓縮到滿足要求的大小 。

  • 圖片數量限制:多圖輸入時根據傳入方式不同,支援的圖片數量上限有所區別:

    • 以公網URL或本地路徑傳入時:

      • Qwen3.8-Max、Qwen3.7-Plus:最多 2048 張
      • Qwen3.7-Flash、Qwen3.6-Plus、Qwen3.6-Flash、Qwen3.5-Plus、Qwen3.5-Flash、Qwen3-VL、Qwen-VL、QVQ系列:最多 256 張
    • 以 Base 64 編碼傳入時:最多 250 張

    Qwen-Omni系列模型請參考全模態。

同時受模型圖文總 Token 上限(即最大輸入)的限制,所有圖片的總 Token 數必須小於模型的最大輸入。

視頻限制

  • 以映像列表傳入,映像列表的數量有如下限制:
    • qwen3.8系列、qwen3.7系列、qwen3.6系列、qwen3.5 系列:最少傳入 4 張圖片,最多 8000 張圖片
    • qwen3-vl-plus 系列、qwen3-vl-flash 系列、qwen3-vl-235b-a22b-thinking、qwen3-vl-235b-a22b-instruct:最少傳入 4 張圖片,最多 2000 張圖片
    • 其他Qwen3-VL開源、Qwen2.5-VL(包括商業版和開源版)和QVQ系列模型:最少傳入 4 張圖片,最多 512 張圖片
    • 其他模型:最少傳入 4 張圖片,最多 80 張圖片
  • 以視頻檔案傳入時:
    • 視頻大小:
      • 以公網URL傳入時:

        • qwen3.8系列、qwen3.7系列、qwen3.6系列、qwen3.5 系列、Qwen3-VL系列、qwen-vl-max :不超過 2GB;
        • qwen-vl-plus 系列、其他qwen-vl-max模型、Qwen2.5-VL開源系列及QVQ系列模型:不超過 1GB;
        • 其他模型不超過 150MB
      • 以 Base 64 編碼傳入時:編碼後的字串小於 10MB;

      • 以本地檔案路徑傳入時:視頻本身不超過 100MB。

      如需壓縮檔體積請參見 如何將映像或視頻壓縮到滿足要求的大小 。

    • 視頻時間長度:
      • qwen3.8系列、qwen3.7系列、qwen3.6系列、qwen3.5 系列:2秒至2小時;
      • qwen3-vl-plus系列、qwen3-vl-flash系列、qwen3-vl-235b-a22b-thinking、qwen3-vl-235b-a22b-instruct:2 秒至 1 小時;
      • 其他Qwen3-VL開源系列、qwen-vl-max :2 秒至 20 分鐘;
      • qwen-vl-plus系列、 其他qwen-vl-max模型、Qwen2.5-VL開源系列及QVQ系列模型:2 秒至 10 分鐘;
      • 其他模型:2 秒至 40 秒。
    • 視頻格式: MP4、AVI、MKV、MOV、FLV、WMV 等。

    • 視頻尺寸:無特定限制,模型可通過max_pixels和min_pixels自動調整視頻尺寸,更大尺寸的視頻檔案不會有更好的理解效果。

    • 視頻數量限制:最多可傳入 64 個視頻。

    • 音頻理解:不支援對視頻檔案的音頻進行理解。

檔案傳入方式
  • 公網URL:提供一個公網可訪問的檔案地址,支援HTTP或HTTPS協議。為獲得最佳穩定性和效能,可將檔案上傳至OSS,擷取公網 URL。百鍊服務無法訪問 OSS 內網地址(endpoint 中帶 -internal,如 https://<bucket>.oss-cn-hangzhou-internal.aliyuncs.com/image.jpg),傳入內網地址會導致檔案下載失敗,返回 InvalidParameter,message 為 Failed to download multimodal content。請改用 OSS 公網網域名稱(如 https://<bucket>.oss-cn-hangzhou.aliyuncs.com/image.jpg)或 OSS 臨時簽名 URL 傳入檔案。

    重要為確保模型能成功下載檔案,提供的公網URL的回應標頭中必須包含 Content-Length(檔案大小)和 Content-Type(媒體類型,如 image/jpeg)。任一欄位缺失或者錯誤將會導致檔案下載失敗。

  • Base64編碼傳入:將檔案轉換為 Base 64 編碼字串再傳入。

  • 本地檔案路徑傳入(僅限 DashScope SDK):傳入本地檔案的路徑。

關於檔案傳入方式的建議,請參見 如何選擇檔案上傳方式?

計算映像與視頻的Token

映像

計算公式:映像 Token = h_bar * w_bar / token_pixels + 2

  • h_bar、w_bar:縮放後的映像長寬,模型在處理映像前會進行預先處理,會將映像縮小至特定像素上限內,像素上限與max_pixels和vl_high_resolution_images參數的取值有關。

  • token_pixels:每視覺Token對應的像素值,不同模型情況不同:

    • qwen3.7系列、qwen3.6系列、qwen3.5系列、Qwen3-VL、qwen-vl-max、qwen-vl-plus:每個Token對應 32x32像素
    • QVQ及其他Qwen2.5-VL模型:每個Token對應28x28像素

以下代碼示範了模型內部對映像的大致縮放邏輯,可用於估算一張映像的Token,實際計費請以API響應為準。

點此查看映像 token 估算樣本

import math
from PIL import Image  # pip install Pillow

def smart_size(image_path, max_pixels, vl_high_resolution_images):
    """根據模型參數,計算映像縮放後的尺寸,用於估算映像 Token。"""
    image = Image.open(image_path)
    height, width = image.height, image.width

    # Qwen3.6、Qwen3.5、Qwen3-VL 等模型的縮放因子為 32;使用其他模型時,請將 factor 改為 28
    factor = 32
    h_bar = round(height / factor) * factor
    w_bar = round(width / factor) * factor

    # Token 下限:4 個 Token
    min_pixels = 4 * factor * factor

    # vl_high_resolution_images=True 時,Token 上限固定為 16384,忽略 max_pixels
    if vl_high_resolution_images:
        max_pixels = 16384 * factor * factor

    # 將總像素數約束在 [min_pixels, max_pixels] 範圍內
    if h_bar * w_bar > max_pixels:
        beta = math.sqrt((height * width) / max_pixels)
        h_bar = math.floor(height / beta / factor) * factor
        w_bar = math.floor(width / beta / factor) * factor
    elif h_bar * w_bar < min_pixels:
        beta = math.sqrt(min_pixels / (height * width))
        h_bar = math.ceil(height * beta / factor) * factor
        w_bar = math.ceil(width * beta / factor) * factor

    return h_bar, w_bar

if __name__ == "__main__":
    # 注意:max_pixels 和 vl_high_resolution_images 的值需要與調用模型時傳入的參數保持一致
    h_bar, w_bar = smart_size("xxx/test.jpg", max_pixels=2560 * 32 * 32, vl_high_resolution_images=False)
    print(f"縮放後的映像尺寸:高度 {h_bar},寬度 {w_bar}")

    # 每張映像額外包含 <vision_bos> 和 <vision_eos> 各 1 個 Token
    token = int(h_bar * w_bar / (32 * 32)) + 2
    print(f"映像的 Token 數:{token}")

視頻

  • 視頻檔案:

    模型處理視頻檔案時,會先進行抽幀,然後計算所有視訊框架的總 Token 數。由於該計算過程較為複雜,可使用以下代碼,通過傳入的視訊路徑來估算視頻消耗的總 Token 數:

# 使用前安裝:pip install opencv-python
import math
import os
import logging
import cv2

logger = logging.getLogger(__name__)

FRAME_FACTOR = 2

# Qwen3.6、Qwen3.5、Qwen3-VL、qwen-vl-max-0813、qwen-vl-plus-0815、qwen-vl-plus-0710等模型,映像縮放因子為32
IMAGE_FACTOR = 32

#  其他模型,映像縮放因子為28
# IMAGE_FACTOR = 28

# 視訊框架的最大長寬比
MAX_RATIO = 200
# 視訊框架的像素下限
VIDEO_MIN_PIXELS = 4 * 32 * 32
# 視訊框架的像素上限,使用Qwen3-VL-Plus模型,VIDEO_MAX_PIXELS為640 * 32 * 32,其他模型為768 * 32 * 32
VIDEO_MAX_PIXELS = 640 * 32 * 32

# 使用者未傳入FPS參數,則fps使用預設值
FPS = 2.0
# 最少抽取幀數
FPS_MIN_FRAMES = 4
# 最大抽取幀數(根據模型選擇設定值)
FPS_MAX_FRAMES = 2000

# 視頻輸入的最大像素值,使用Qwen3-VL-Plus模型,請將VIDEO_TOTAL_PIXELS設定為131072 * 32 * 32,其他模型設定為65536 * 32 * 32
VIDEO_TOTAL_PIXELS = int(float(os.environ.get('VIDEO_TOTAL_PIXELS', 131072 * 32 * 32)))

def round_by_factor(number: int, factor: int) -> int:
    """返回與”number“最接近的整數,該整數可被”factor“整除。"""
    return round(number / factor) * factor

def ceil_by_factor(number: int, factor: int) -> int:
    """返回大於或等於“number”且可被“factor”整除的最小整數。"""
    return math.ceil(number / factor) * factor

def floor_by_factor(number: int, factor: int) -> int:
    """返回小於或等於“number”且可被“factor”整除的最大整數。"""
    return math.floor(number / factor) * factor

def extract_vision_info(conversations):
    vision_infos = []
    if isinstance(conversations[0], dict):
        conversations = [conversations]
    for conversation in conversations:
        for message in conversation:
            if isinstance(message["content"], list):
                for ele in message["content"]:
                    if (
                        "image" in ele
                        or "image_url" in ele
                        or "video" in ele
                        or ele.get("type","") in ("image", "image_url", "video")
                    ):
                        vision_infos.append(ele)
    return vision_infos

def smart_nframes(ele,total_frames,video_fps):
    """用於計算抽取的視訊框架數。

    Args:
        ele (dict): 包含視頻配置的字典格式
            - fps: fps用於控制提模數型輸入幀的數量。
        total_frames (int): 視頻的原始總幀數。
        video_fps (int | float): 視頻的原始幀率

    Raises:
        nframes應該在[FRAME_FACTOR,total_frames]間隔內,否則會報錯

    Returns:
        用於模型輸入的視訊框架數。
    """
    assert not ("fps" in ele and "nframes" in ele), "Only accept either `fps` or `nframes`"
    fps = ele.get("fps", FPS)
    min_frames = ceil_by_factor(ele.get("min_frames", FPS_MIN_FRAMES), FRAME_FACTOR)
    max_frames = floor_by_factor(ele.get("max_frames", min(FPS_MAX_FRAMES, total_frames)), FRAME_FACTOR)
    duration = total_frames / video_fps if video_fps != 0 else 0
    if duration-int(duration)>(1/fps):
        total_frames = math.ceil(duration * video_fps)
    else:
        total_frames = math.ceil(int(duration)*video_fps)
    nframes = total_frames / video_fps * fps
    if nframes > total_frames:
        logger.warning(f"smart_nframes: nframes[{nframes}] > total_frames[{total_frames}]")
    nframes = int(min(min(max(nframes, min_frames), max_frames), total_frames))
    if not (FRAME_FACTOR <= nframes and nframes <= total_frames):
        raise ValueError(f"nframes should in interval [{FRAME_FACTOR}, {total_frames}], but got {nframes}.")

    return nframes

def get_video(video_path):
    # 擷取視頻資訊
    cap = cv2.VideoCapture(video_path)

    frame_width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
    # 擷取視頻高度
    frame_height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
    total_frames = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))

    video_fps = cap.get(cv2.CAP_PROP_FPS)
    return frame_height, frame_width, total_frames, video_fps

def smart_resize(ele, path, factor=IMAGE_FACTOR):
    # 擷取原視頻的寬和高
    height, width, total_frames, video_fps = get_video(path)
    # 視訊框架的Token下限
    min_pixels = VIDEO_MIN_PIXELS
    total_pixels = VIDEO_TOTAL_PIXELS
    # 抽取的視訊框架數
    nframes = smart_nframes(ele, total_frames, video_fps)
    max_pixels = max(min(VIDEO_MAX_PIXELS, total_pixels / nframes * FRAME_FACTOR),int(min_pixels * 1.05))

    # 視頻的長寬比不應超過200:1或1:200
    if max(height, width) / min(height, width) > MAX_RATIO:
        raise ValueError(
            f"absolute aspect ratio must be smaller than {MAX_RATIO}, got {max(height, width) / min(height, width)}"
        )

    h_bar = max(factor, round_by_factor(height, factor))
    w_bar = max(factor, round_by_factor(width, factor))
    if h_bar * w_bar > max_pixels:
        beta = math.sqrt((height * width) / max_pixels)
        h_bar = floor_by_factor(height / beta, factor)
        w_bar = floor_by_factor(width / beta, factor)
    elif h_bar * w_bar < min_pixels:
        beta = math.sqrt(min_pixels / (height * width))
        h_bar = ceil_by_factor(height * beta, factor)
        w_bar = ceil_by_factor(width * beta, factor)
    return h_bar, w_bar

def token_calculate(video_path, fps):
    # 傳入的視訊路徑和fps抽幀參數
    messages = [{"content": [{"video": video_path, "fps": fps}]}]
    vision_infos = extract_vision_info(messages)[0]

    resized_height, resized_width = smart_resize(vision_infos, video_path)

    height, width, total_frames, video_fps = get_video(video_path)
    num_frames = smart_nframes(vision_infos, total_frames, video_fps)
    print(f"原視頻尺寸:{height}*{width}, 輸入模型的尺寸:{resized_height}*{resized_width},視頻總幀數:{total_frames},fps等於{fps}時,抽取的總幀數:{num_frames}", end=",")
    video_token = int(math.ceil(num_frames / 2) * resized_height / 32 * resized_width / 32)
    video_token += 2   # 系統會自動添加<|vision_bos|>和<|vision_eos|>視覺標記(各計1個Token)
    return video_token

video_token = token_calculate("xxx/test.mp4", 1)
print("視頻tokens:", video_token)
  • 映像列表:

    當以映像列表形式傳入的視訊時,表示已預先完成視頻抽幀,可使用以下代碼,通過傳入映像的路徑和數量來計算傳入映像列表時消耗的Token數:

# 使用前安裝:pip install Pillow
import math
import os
import logging
from typing import Tuple
from PIL import Image

logger = logging.getLogger(__name__)

# ==================== 常量定義 ====================
FRAME_FACTOR = 2
# Qwen3-VL、qwen-vl-max-0813、qwen-vl-plus-0815、qwen-vl-plus-0710模型,縮放因子為32
IMAGE_FACTOR = 32

#  其他模型,縮放因子為28
# IMAGE_FACTOR = 28

# Token計算相關常量
TOKEN_DIVISOR = 32  # token計算時的除數
VISION_SPECIAL_TOKENS = 2  # <|vision_bos|>和<|vision_eos|>標記

# 視訊框架的最大長寬比
MAX_RATIO = 200
# 視訊框架的像素下限
VIDEO_MIN_PIXELS = 4 * 32 * 32
# 視訊框架的像素上限,使用Qwen3-VL-Plus模型,VIDEO_MAX_PIXELS為640 * 32 * 32,其他模型為768 * 32 * 32
VIDEO_MAX_PIXELS = 640 * 32 * 32

# 視頻輸入的最大像素值,使用Qwen3-VL-Plus模型,請將VIDEO_TOTAL_PIXELS設定為131072 * 32 * 32,其他模型設定為65536 * 32 * 32
VIDEO_TOTAL_PIXELS = int(float(os.environ.get('VIDEO_TOTAL_PIXELS', 131072 * 32 * 32)))

def round_by_factor(number: int, factor: int) -> int:
    """返回與”number“最接近的整數,該整數可被”factor“整除。"""
    return round(number / factor) * factor

def ceil_by_factor(number: int, factor: int) -> int:
    """返回大於或等於“number”且可被“factor”整除的最小整數。"""
    return math.ceil(number / factor) * factor

def floor_by_factor(number: int, factor: int) -> int:
    """返回小於或等於“number”且可被“factor”整除的最大整數。"""
    return math.floor(number / factor) * factor

def get_image_size(image_path: str) -> Tuple[int, int]:
    if not os.path.exists(image_path):
        raise FileNotFoundError(f"影像檔不存在: {image_path}")

    try:
        image = Image.open(image_path)
        height = image.height
        width = image.width
        image.close()  # 及時關閉檔案
        return height, width
    except Exception as e:
        raise ValueError(f"無法讀取影像檔 {image_path}: {str(e)}")

def smart_resize(height: int, width: int, nframes: int, factor: int = IMAGE_FACTOR) -> Tuple[int, int]:
    """
    計算映像縮放後的尺寸

    Args:
        height: 原始映像高度
        width: 原始映像寬度
        nframes: 視訊框架數
        factor: 縮放因子,預設為IMAGE_FACTOR

    Returns:
        (resized_height, resized_width) 縮放後的高度和寬度

    Raises:
        ValueError: 長寬比超過限制
    """
    # 視訊框架的Token下限
    min_pixels = VIDEO_MIN_PIXELS
    total_pixels = VIDEO_TOTAL_PIXELS
    # 抽取的視訊框架數
    max_pixels = max(min(VIDEO_MAX_PIXELS, total_pixels / nframes * FRAME_FACTOR), int(min_pixels * 1.05))

    # 視頻的長寬比不應超過200:1或1:200
    aspect_ratio = max(height, width) / min(height, width)
    if aspect_ratio > MAX_RATIO:
        raise ValueError(
            f"映像長寬比必須小於 {MAX_RATIO}:1,當前為 {aspect_ratio:.2f}:1"
        )

    h_bar = max(factor, round_by_factor(height, factor))
    w_bar = max(factor, round_by_factor(width, factor))
    if h_bar * w_bar > max_pixels:
        beta = math.sqrt((height * width) / max_pixels)
        h_bar = floor_by_factor(height / beta, factor)
        w_bar = floor_by_factor(width / beta, factor)
    elif h_bar * w_bar < min_pixels:
        beta = math.sqrt(min_pixels / (height * width))
        h_bar = ceil_by_factor(height * beta, factor)
        w_bar = ceil_by_factor(width * beta, factor)
    return h_bar, w_bar

def calculate_video_tokens(image_path: str, nframes: int = 1, factor: int = IMAGE_FACTOR, verbose: bool = True) -> int:
    """

    Args:
        image_path: 視訊框架檔案路徑
        nframes: 視訊框架數,
        factor: 縮放因子,預設為IMAGE_FACTOR
        verbose: 是否列印詳細資料

    Returns:
        所消耗的token數量

    Raises:
        FileNotFoundError: 檔案不存在
        ValueError: 檔案格式無效或長寬比超限
    """
    # 擷取原始映像尺寸(唯讀取一次)
    height, width = get_image_size(image_path)

    # 計算縮放後的尺寸
    resized_height, resized_width = smart_resize(height, width, nframes, factor)

    # 計算token數量
    # 公式:⌈幀數/2⌉ × (高度/TOKEN_DIVISOR) × (寬度/TOKEN_DIVISOR) + VISION_SPECIAL_TOKENS
    video_token = int(
        math.ceil(nframes / 2) *
        (resized_height / TOKEN_DIVISOR) *
        (resized_width / TOKEN_DIVISOR)
    )
    # 添加視覺標記token(<|vision_bos|>和<|vision_eos|>)
    video_token += VISION_SPECIAL_TOKENS

    if verbose:
        print(f"原視訊框架尺寸:{height}×{width},輸入模型的尺寸:{resized_height}×{resized_width},", end="")

    return video_token

if __name__ == "__main__":
    try:
        video_token = calculate_video_tokens("xxx/test.jpg", nframes=30)
        print(f"視頻tokens: {video_token}\n")
    except Exception as e:
        print(f"錯誤: {str(e)}\n")

模型調優前必讀

  • 文本產生模型調優雖然能在特定業務/情境取得非常好的效果,但有以下限制:

    • 耗時較長,包括:擁有一個大規模(最少 0.5億 token)CPT 資料集、構建一個有效(1000+)SFT 資料集、收集足夠的(100+)Bad Case 構建有效 DPO 資料集、模型最佳化迭代速度慢等。
    • 費用較高,調優後的模型部署後才能使用,模型部署計費較高。
  • 阿里雲百鍊推薦您在考慮使用文本產生模型調優前先嘗試使用的 Prompt 工程(Prompt Engineering)或外掛程式調用(Function Calling)定製化您的應用,模型調優也通常作為改進模型表現“最後的手段”。因為:

    1. 在許多任務中,模型最初可能表現不佳,但通過應用正確的 Prompt 技巧可以改進結果,不一定需要使用模型調優。
    2. 迭代最佳化 Prompt、外掛程式,比模型調優的迭代更敏捷、成本更低,因為模型調優的迭代可能需要重新收集資料、清洗最佳化資料、收集 bad case、發起客戶調研等。
    3. 即使最後一定要進行模型調優,最初的 Prompt 工程、外掛程式迭代最佳化相關工作也不會浪費。您的這些前期工作可以充分地在構建調優資料集時複用(用於構建資料集的輸入)。

快速開始

使用控制台進行模型調優

調優步驟

控制台截圖

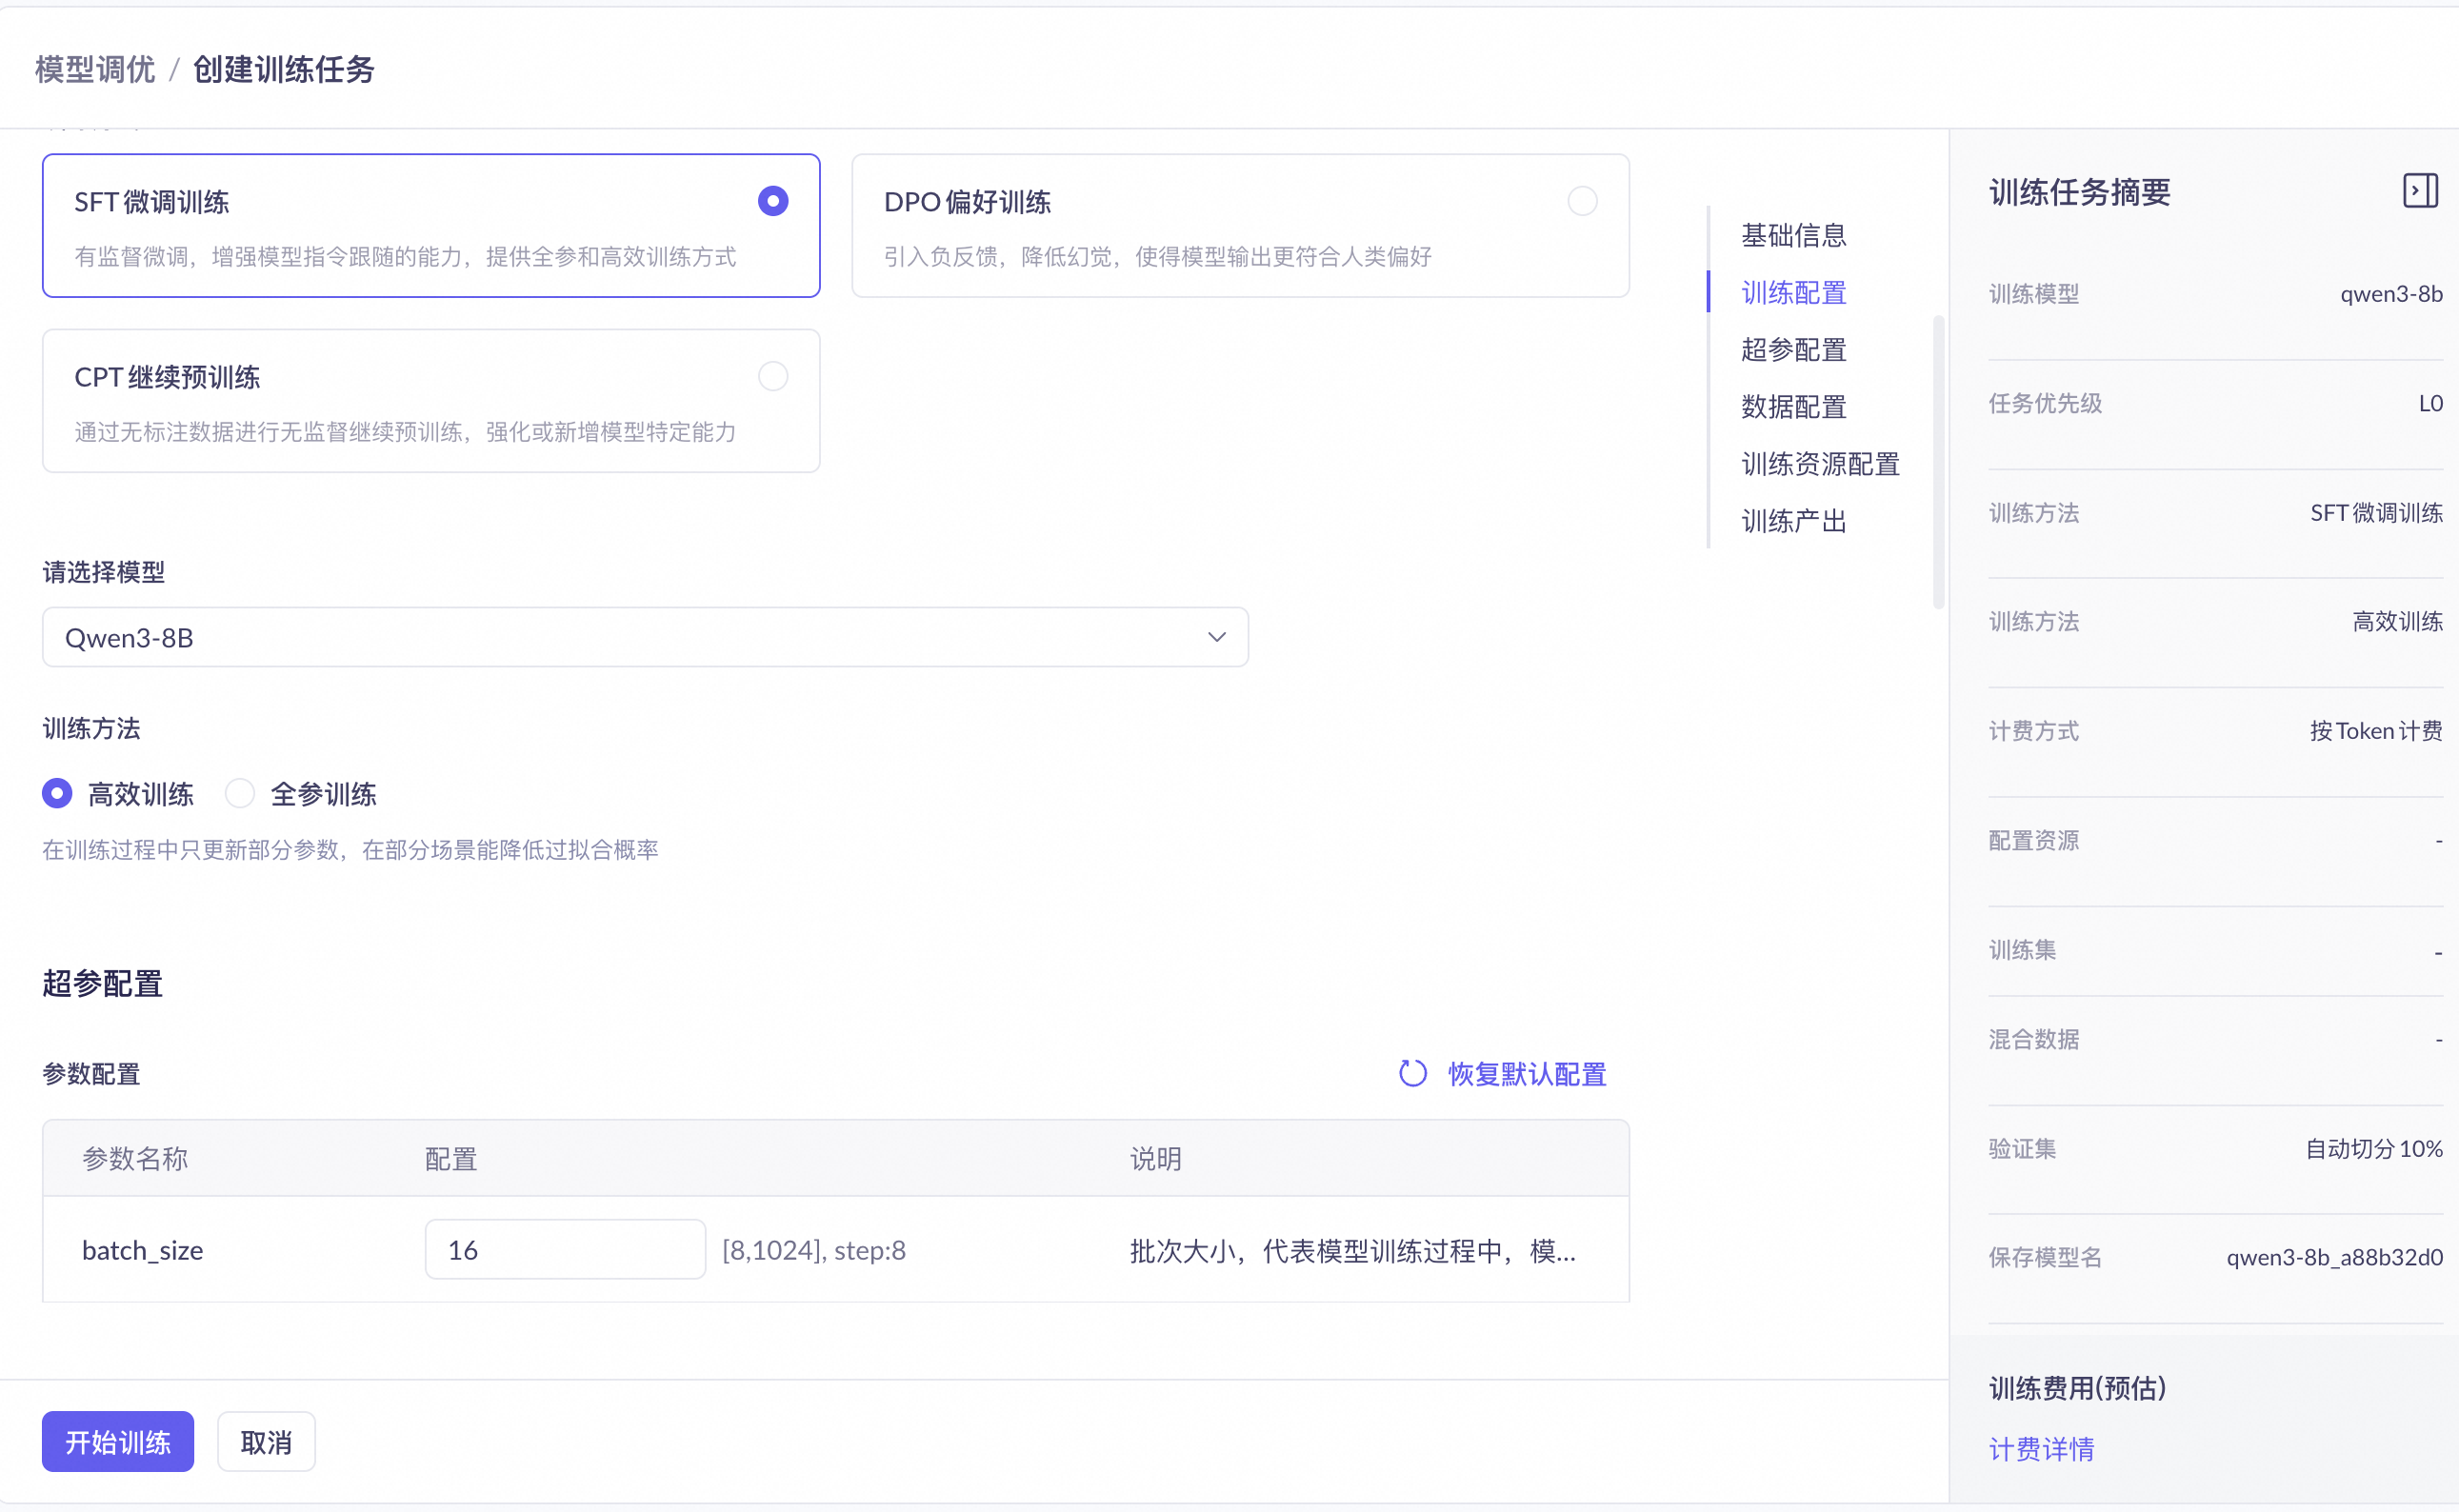
步驟一:在模型調優頁面點擊创建训练任务。

image

步驟二:訓練配置

  • 训练方式:SFT微调训练

  • 选择模型: 千問3-8B

  • 训练方式:高效训练

  • 参数配置:保持預設即可,百鍊對微調超參提供了推薦配置。

這個組合訓練時間短,資料要求低。

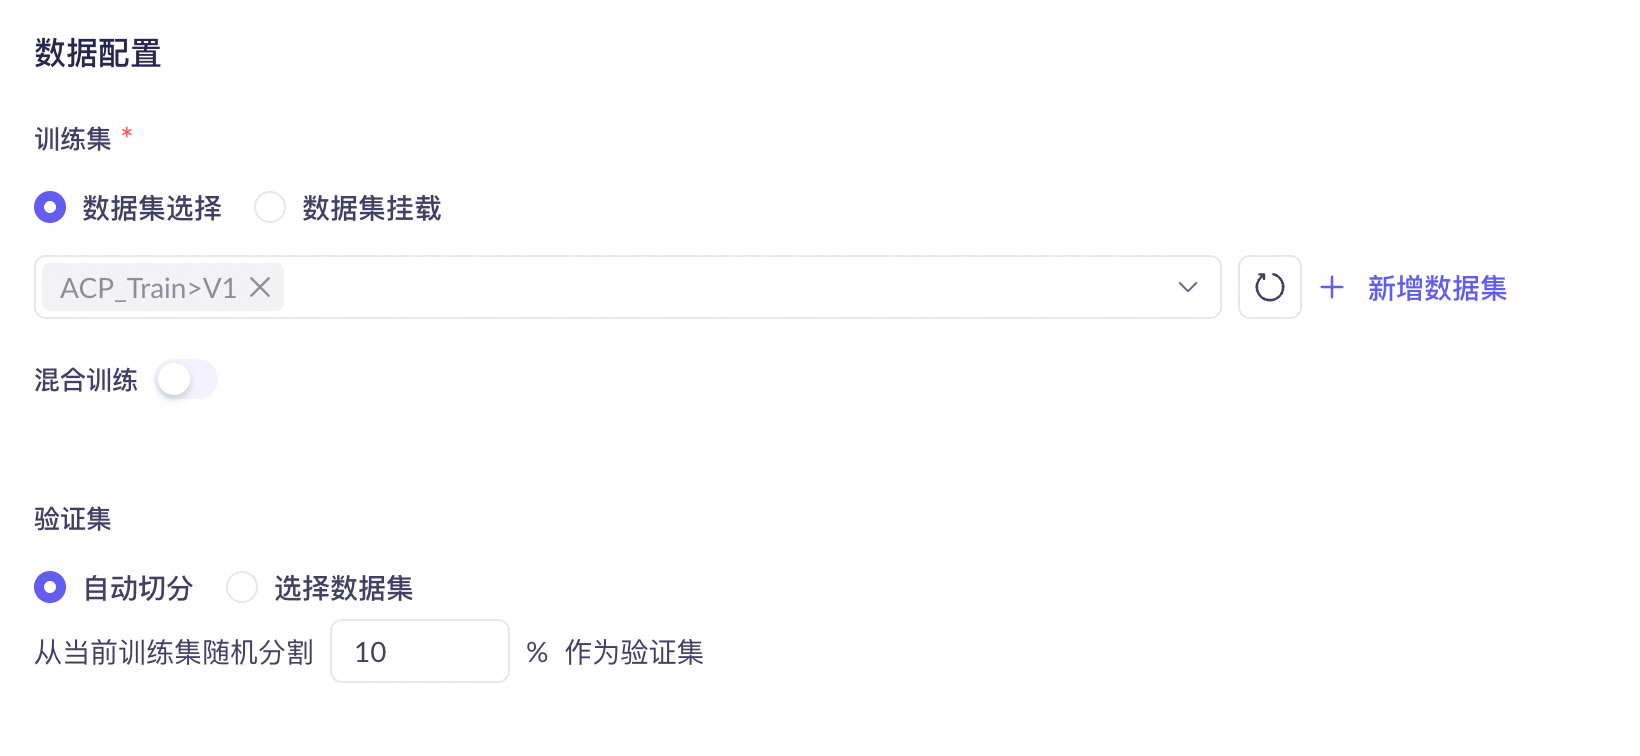
步驟三:資料配置

  • 训练集: 在平台上選擇構建模型所需的已上傳調優資料集。

    資料範例:SFT-ChatML格式樣本.jsonl;

  • 混合训练: 不開啟

  • 验证集:設定為自动切分,分割 10% 作為驗證集

image

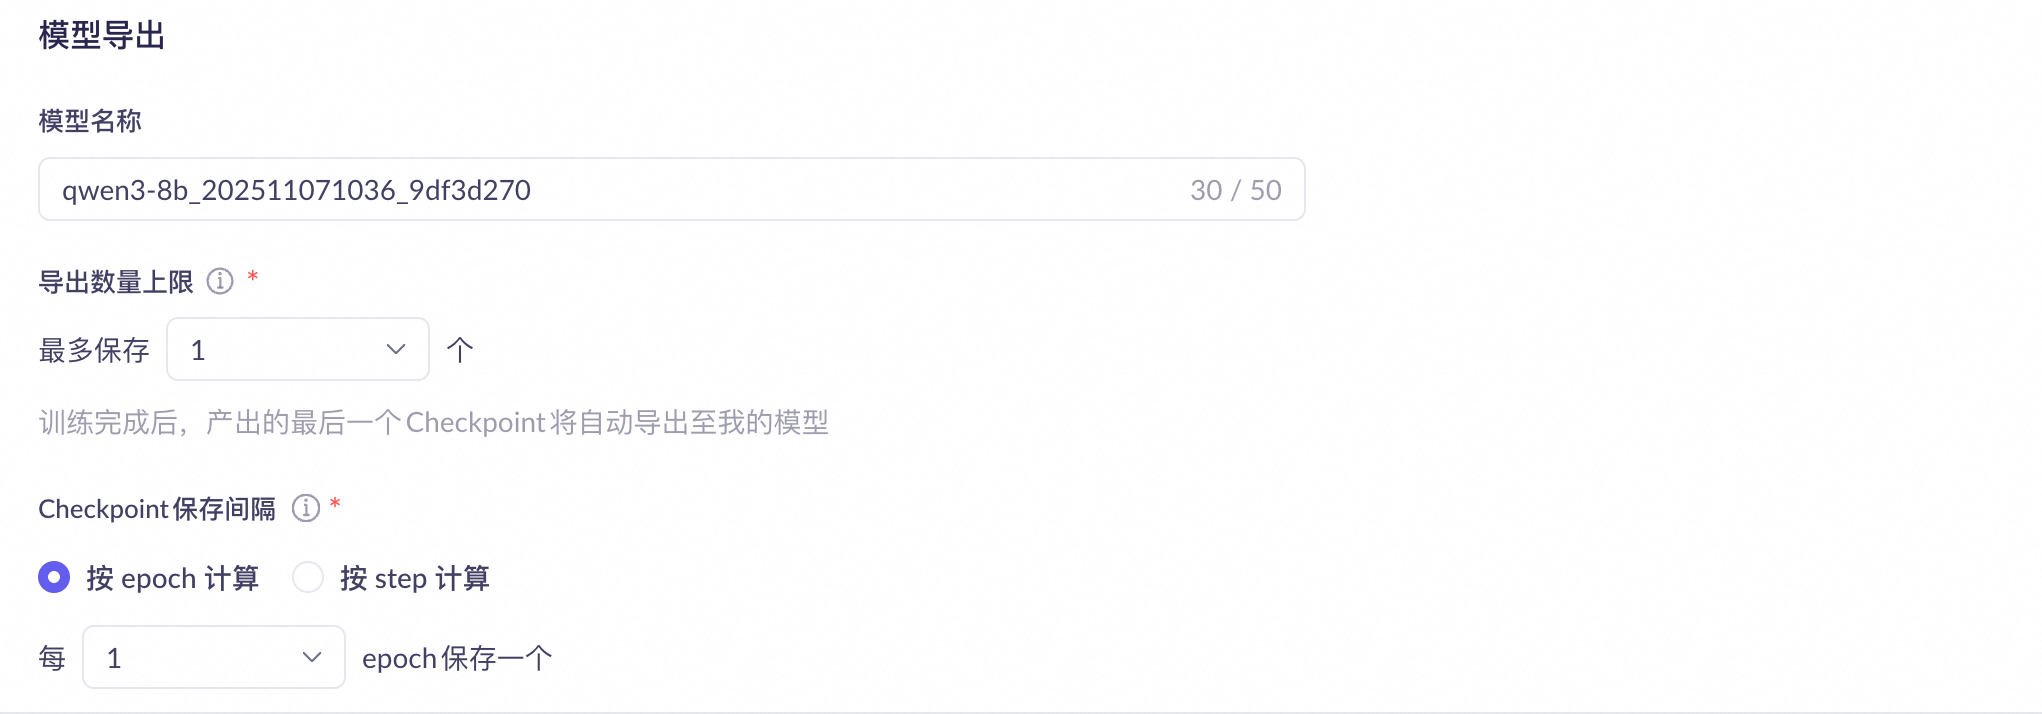
步驟四:配置模型參數快照(Checkpoint)儲存參數

  • 模型名称:保持預設即可

  • 匯出數量上限:保持預設即可

  • Checkpoint保存间隔:保持預設即可

在百鍊平台上,模型調優完成後可以匯出參數快照,匯出後才能基於此版本的參數快照在百鍊上進行模型部署。

匯出的參數快照儲存在雲端儲存中,暫不支援訪問或下載。

image

步驟五:點擊“開始訓練”後,等待模型訓練完畢。

步驟六:使用阿里雲百鍊的模型部署功能部署訓練好的自訂模型,部署好後就可以對調優好的模型進行評測。模型部署相關資訊請參見模型部署。

典型的調優流程

百鍊提供的三種調優方式並不互斥,而是遞進的、相輔相成的。

CPT(可選)→ SFT → DPO(可選)

  1. CPT (持續預訓練)- 補知識 (通用模型知識的“廣度”和“淺度”,無法滿足專業領域的“深度”和“精度”要求)

    • 金融模型: 學金融術語
    • 醫學模型: 記藥品病理
    • 法律模型: 懂法條判例
  2. SFT (監督微調)- 學做事

    • 客服機器人: 學客服流程
    • 代碼助手: 學編程範式
    • 工具調用 (Agent): 學使用 MCP
  3. DPO (直接偏好最佳化)- 做得更好

    • 安全與責任感: 拒有害建議
    • 簡潔與有效性: 答乾脆利落
    • 客觀與中立: 評公正客觀

調優資料格式

SFT/DPO/CPT 各訓練方式的資料格式規格、打包規則、大小與數量限制、API 上傳配額詳見調優資料上傳規則。各訓練方式支援的檔案格式概覽:

訓練方式

檔案格式

SFT 文本產生

jsonl(ChatML messages 多輪結構)

SFT 多模態(圖片/視頻)

zip(data.jsonl + 圖片/視頻檔案)

DPO

jsonl(chosen/rejected 偏好對比)

CPT

jsonl(純文字 {text})

評測集

xlsx

資料集構建技巧

資料集的規模要求

對於CPT來說,資料集最少需要五千萬Token優質預訓練資料;對於 SFT 來說,資料集最少需要上千條優質調優資料;對於 DPO 來說,資料集一般需要上百條人類偏好資料。如果資料調優後的模型評測結果不佳,最簡單的改進方法是收集更多資料進行訓練。

如果您缺乏資料,建議構建智能體應用(Agent 1.0),使用知識庫索引來增強模型能力。當然在很多複雜的業務情境,可以綜合採用模型調優和知識庫檢索結合的技術方案。

以客服情境為例,可以藉助模型調優解決客服回答的語氣、表達習慣、自我認知等問題,情境涉及的專業知識可以結合知識庫,動態引入到模型上下文中。

阿里雲百鍊推薦您可以先構建 RAG 應用試運行,在收集到足夠的應用資料後再通過模型調優繼續提升模型表現。

您也可以採用以下策略擴充資料集:

  1. 讓大模型類比產生特定業務/情境的相關內容,輔助您產生更多用於調優資料。(產生模型建議選取表現優異、規模更大的模型)
  2. 通過應用情境收集、網路爬蟲、社交媒體和線上論壇、公開資料集、夥伴與行業資源、使用者貢獻等各種方式,人工擷取更多資料。

資料的多樣性與均衡性

模型調優有不同情境,針對具體業務情境時,專業性更重要;而針對問答情境時通用性更重要。您需要根據模型負責的業務模組或使用情境進行資料用例設計。因此訓練效果好壞並不是僅取決於資料量,更需要考慮針對情境的專業性和多樣性。

這裡以智能 AI 對話情境為例,介紹一個專業、多樣的資料集應該包含的各種業務情境:

具體業務

多樣化情境/業務

電商客服

活動推送、售前諮詢、售中引導、售後服務、售後回訪、投訴處理等。

金融服務

貸款諮詢、投資理財顧問、信用卡服務、銀行賬戶管理等。

線上醫學

病症諮詢、挂號預約、就診須知、藥品資訊查詢、健康小建議等。

AI 秘書

IT 資訊、行政資訊、HR 資訊、員工福利解答、公司日曆查詢等。

旅遊出行助手

旅行規劃、出入境指南、旅行保險諮詢、目的地風土人情介紹等。

企業法律顧問

合約審核、智慧財產權保護、合規性檢查、勞動法律答疑、跨境交易諮詢、個案法律分析等。

還請特別注意的是各個情境/業務的資料數量應相對均衡,資料比例符合實際情境比例,避免某一類資料過多導致模型偏向於學習該類特徵,影響模型的泛化能力。

訓練集與驗證集拆分

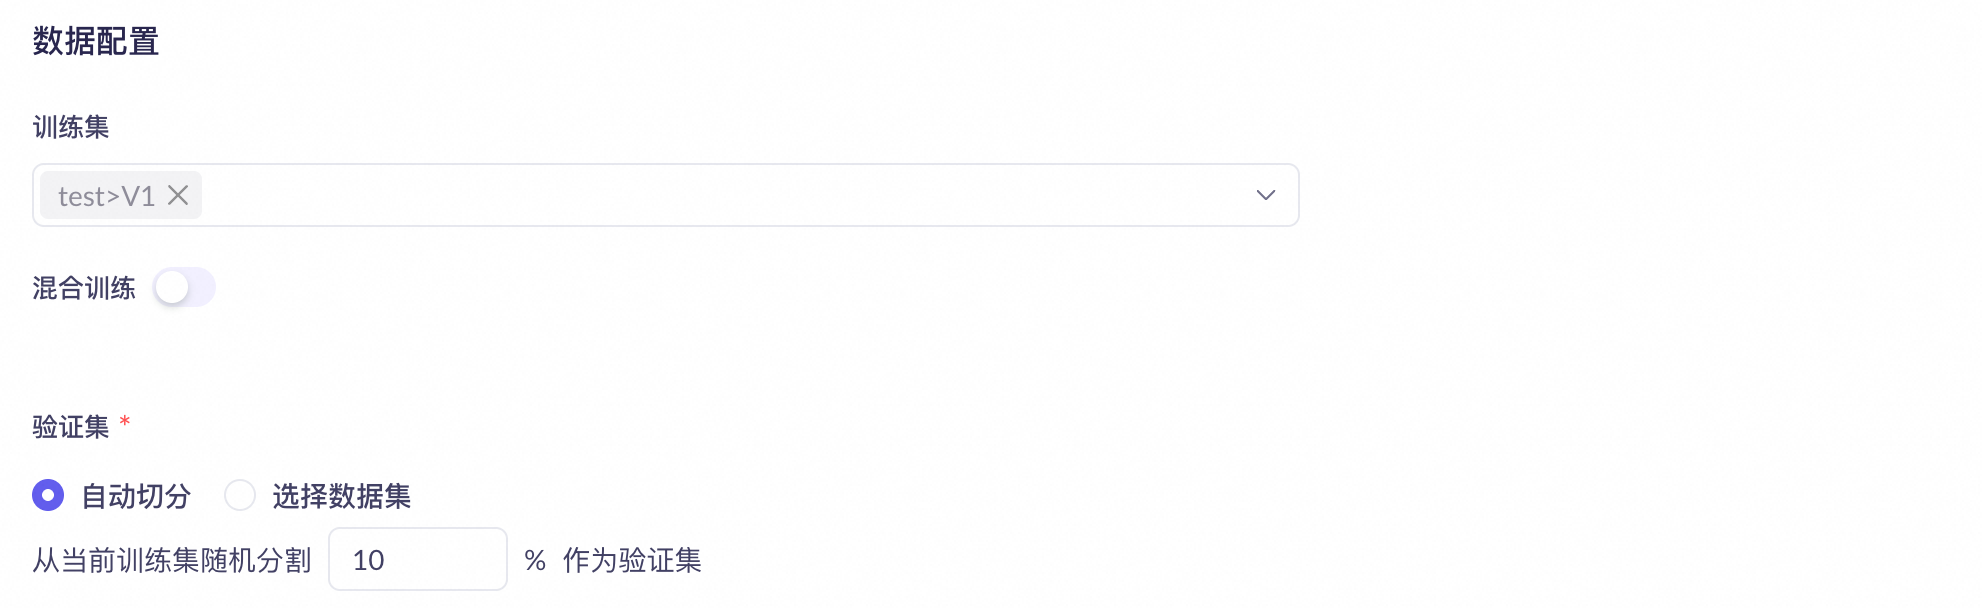
當您使用控制台進行模型調優時,支援

  • 自動將一個完整訓練資料集拆分,隨機抽取少量資料群組成驗證集。
  • 選擇獨立上傳資料集。

控制台可以在訓練時及時方便地顯示驗證集 Loss 和 Token Accuracy。
image

常見問題

是否支援調優自己的模型呢?

百鍊不支援調優和上傳自己的模型,也不支援匯出下載後的模型。