大語言模型(LLM)基於無狀態設計,每次推理獨立進行,不具備跨會話記憶能力。通過 Mem0 架構管理記憶生命週期,結合 Elasticsearch 提供向量檢索能力,可以構建支援記憶持久化儲存、語義檢索和智能更新的生產級 AI 記憶系統。
適用情境
長互動資訊處理:在長對話情境中避免上下文遺忘。
跨會話上下文保持:Agent 需要瞭解使用者的互動歷史和個人化偏好。
記憶持久化管理:將對話中的關鍵資訊結構化儲存。
多 Agent 協同:多個 Agent 共用同一記憶儲存。
以下兩個情境進一步說明記憶系統的價值。
電商智能導購
當使用者開啟新會話諮詢“洗碗機需要支援軟水鹽自動提醒”時,若系統不支援跨會話記憶,則無法啟用首次諮詢中提出的“家裡有嬰兒,水質安全優先”的約束。預設的上下文截斷機制會將其降級為孤立問答,而記憶系統可以通過向量索引,將“嬰兒家庭”標籤持久化綁定至使用者識別碼,並在新會話中以結構化記憶片段注入上下文,實現跨會話意圖繼承。
智能 AI 客服
客戶投訴“上個月購買的掃地機器人 APP 無法串連”,在缺乏記憶系統時,系統需重複確認:“您購買的是哪款?序號是多少?”——重複詢問會嚴重影響客戶體驗,而且每輪互動都在消耗寶貴的上下文空間。而記憶系統可以將使用者裝置識別碼、歷史工單資訊、已嘗試解決方案等作為可版本化記憶單元進行儲存。新會話啟動時,系統僅用少量 token 的語意查詢即可精準召回結構化狀態,使客服響應從“重新診斷”躍遷至“續接處置”。
方案架構
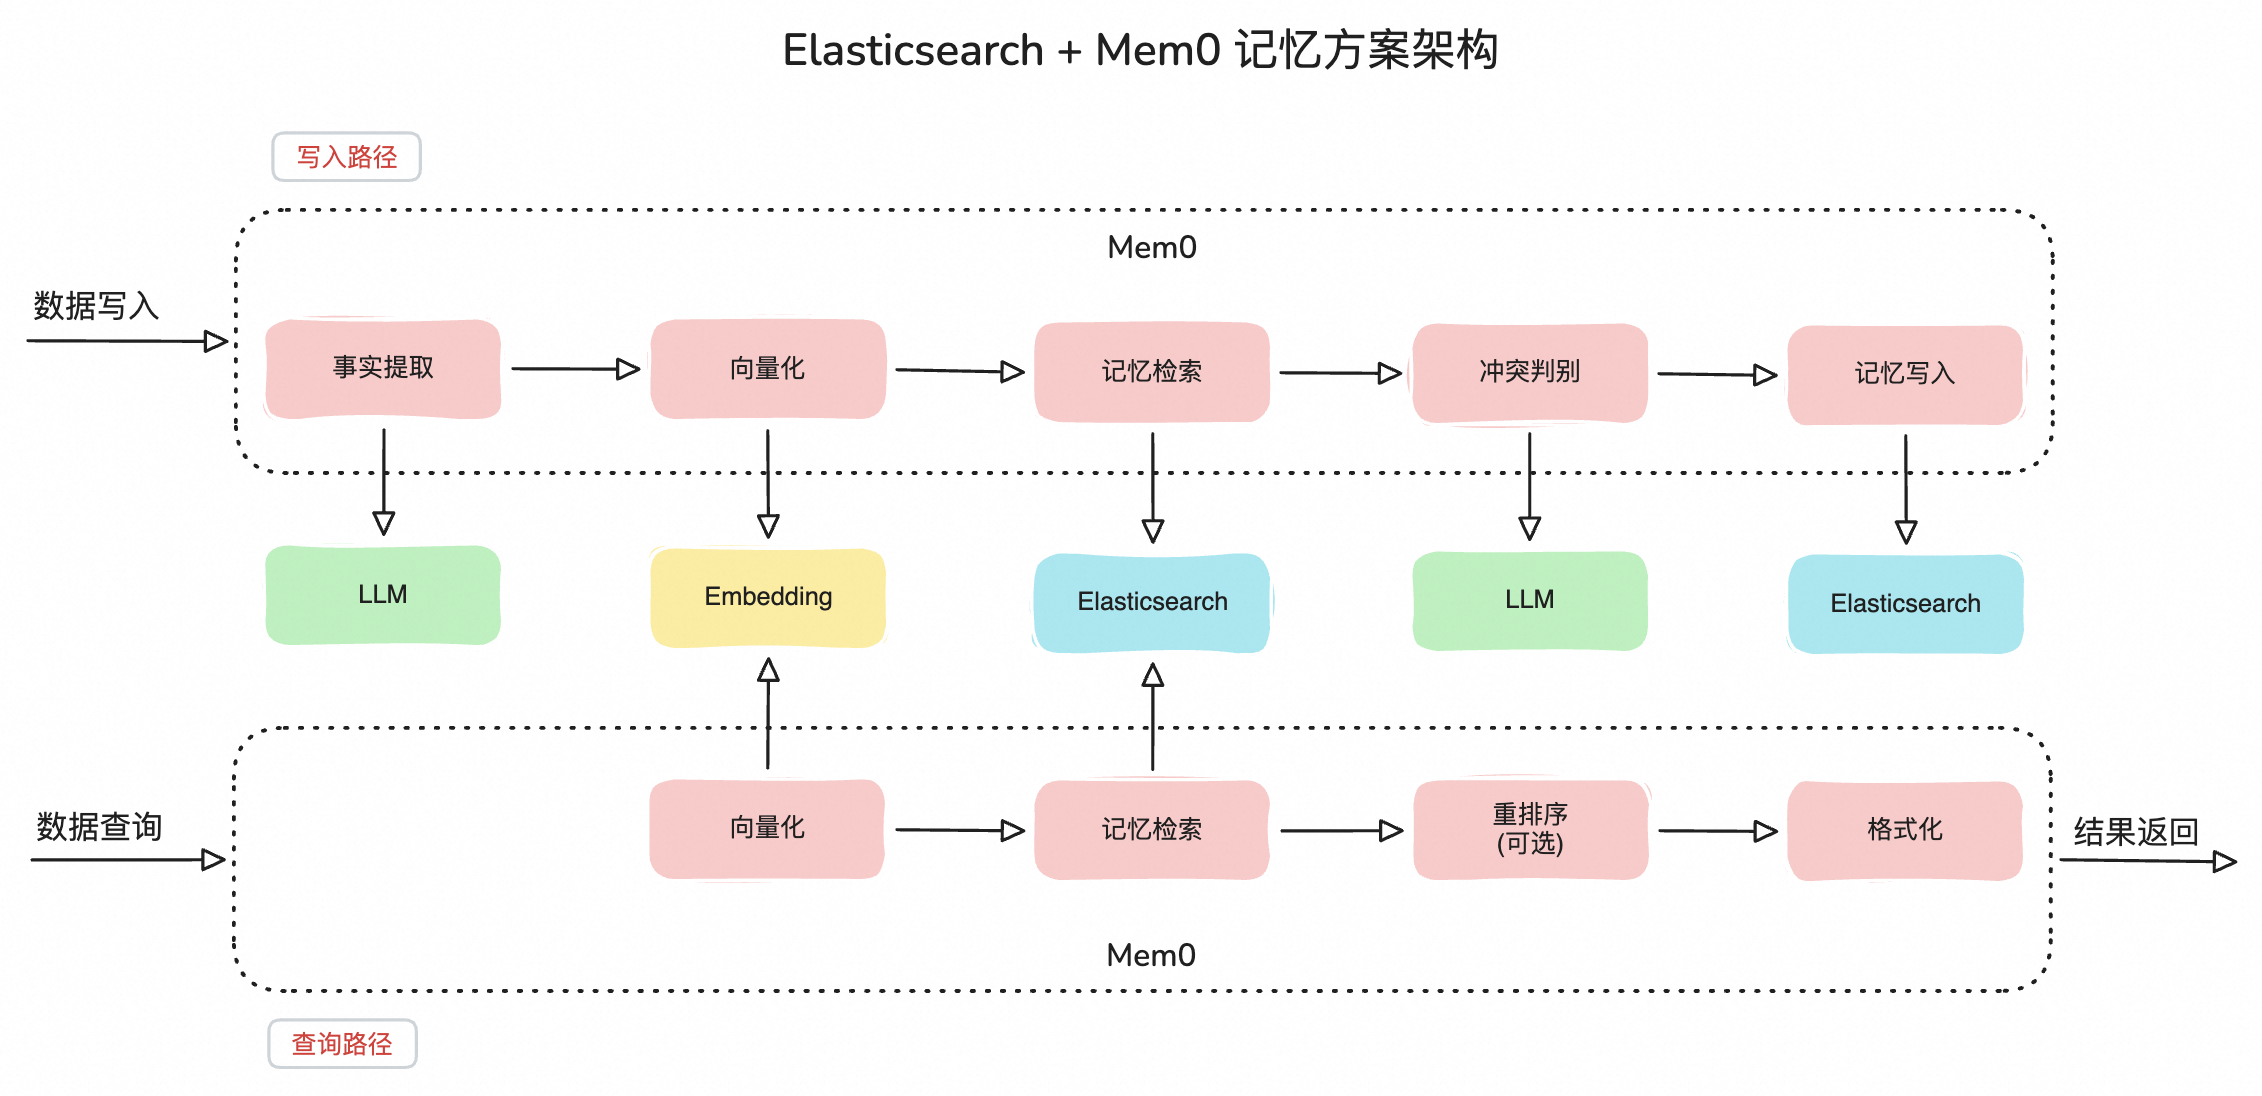
系統的核心工作流程如下:
事實提取:調用 LLM 對輸入內容進行事實提取。
向量化:調用 Embedding 模型將文本轉換為向量,確保語義相近的記憶在向量空間中距離相近。
記憶檢索:調用 Elasticsearch 執行 Top-K 相似向量檢索,返回最相關的記憶片段。
衝突判別:調用 LLM 判斷對記憶執行 update、merge、ignore 或 create 操作。
寫入執行:調用 Elasticsearch 將最新記憶持久化儲存。
在檢索路徑中,還可以配置重排序模型(Reranker)對檢索結果進行二次排序,提升召回精度。
整合案例:為 OpenClaw 接入記憶系統
OpenClaw是一個開源的個人 AI Agent 架構,它將 LLM 與作業系統、Web 存取、檔案操作等能力相結合,使 AI 能夠連貫執行複雜任務。OpenClaw 的原生記憶系統存在上下文長度受限、檢索效率不高、不支援跨會話連續性等短板,接入 Mem0 + Elasticsearch 可以解決這些問題。
步驟一:準備 Elasticsearch
按照快速入門建立執行個體並設定登入密碼。
配置 Kibana 公網訪問白名單:
進入目標執行個體基本資料頁面,在左側導覽列單擊,在Kibana地區單擊修改配置。
配置Kibana公網訪問白名單:Kibana公網訪問白名單預設為127.0.0.1,表示禁止所有IPv4地址訪問,需要將您的實際裝置IP添加到公網白名單才能訪問Kibana。更多白名單配置資訊,請參見通過Kibana串連叢集。
返回Kibana地區,單擊公網入口,在Kibana登入頁面,輸入使用者名稱和密碼,成功登入後在 Kibana Dev Tools 中建立名為
mem0的索引:PUT /mem0 { "settings": { "number_of_shards": 1, "number_of_replicas": 1 } }
步驟二:部署 Mem0 Server
安裝 Mem0 和 Flask:
pip install mem0ai flask更多安裝方式請參見 Mem0 README。
建立 Mem0 Server 目錄:
mkdir -p /opt/mem0-server
cd /opt/mem0-server
建立
server.py檔案,內容如下,將其中的變數替換為實際值:$API_KEY:百鍊 API Key
$ELASTICSEARCH_HOST、$ELASTICSEARCH_PORT:Elasticsearch 執行個體的訪問地址和連接埠
$ELASTICSEARCH_USER、$ELASTICSEARCH_PASSWORD:Elasticsearch 的使用者名稱和密碼
# server.py - Run this as a standalone service
from mem0 import Memory
from flask import Flask, request, jsonify

app = Flask(__name__)

# Configure Mem0 here
config = {
    "llm": {
        "provider": "openai",
        "config": {
            "model": "qwen-plus",
            "api_key": "$API_KEY",
            "openai_base_url": "https://dashscope.aliyuncs.com/compatible-mode/v1",
        }
    },
    "embedder": {
        "provider": "openai",
        "config": {
            "model": "text-embedding-v4",
            "api_key": "$API_KEY",
            "openai_base_url": "https://dashscope.aliyuncs.com/compatible-mode/v1",
        }
    },
    "vector_store": {
        "provider": "elasticsearch",
        "config": {
            "host": "$ELASTICSEARCH_HOST",     # Elasticsearch 的 host
            "port": "$ELASTICSEARCH_PORT",     # Elasticsearch 的 port
            "user": "$ELASTICSEARCH_USER",     # Elasticsearch 的 user
            "password": "$ELASTICSEARCH_PASSWORD",  # Elasticsearch 的 password
            "collection_name": "mem0",         # 步驟一中建立的索引名稱
        }
    },
}

memory = Memory.from_config(config)

@app.route('/v1/memories', methods=['POST'])
def add_memory():
    data = request.json
    result = memory.add(
        messages=data['messages'],
        user_id=data['user_id']
    )
    return jsonify(result)

@app.route('/v2/memories/search', methods=['POST'])
def search_memories():
    data = request.json
    result = memory.search(
        query=data['query'],
        user_id=data['user_id']
    )
    return jsonify(result)

@app.route('/v1/memories', methods=['DELETE'])
def delete_memories():
    user_id = request.args.get('user_id')
    memory.delete_all(user_id=user_id)
    return jsonify({"status": "success"})

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=8420)
啟動 Mem0 Server:
python server.py
步驟三:配置 OpenClaw
在 ECS 上部署 OpenClaw。可以選擇以下兩種方式:
方式一(計算巢一鍵部署):在 ECS 上部署 OpenClaw
方式二(Workbench 一鍵安裝):
登入 ECS 控制台,選擇目標執行個體。
單擊遠端連線 > 立即登入。
在 Workbench 終端工具列點擊一鍵管理 OpenClaw。
選擇安裝 Openclaw並確認執行。
登入 ECS,建立 Skill 目錄:
mkdir -p ~/.openclaw/workspace/skills/agentic-memory-es
cd ~/.openclaw/workspace/skills/agentic-memory-es
在該目錄下建立以下三個檔案:
agentic-memory-es/
├── manifest.json    # Metadata 與 API 定義
├── handler.py       # 核心處理邏輯
└── SKILL.md         # 指令文檔
manifest.json:
{
  "name": "agentic memory",
  "id": "agentic-memory-es",
  "version": "1.0.0",
  "description_for_model": "基於 Mem0 + Elasticsearch 的記憶平台。支援記憶儲存 (add)、檢索 (search) 、按 run id 刪除 (delete_by_run_id)以及按 user id 刪除(delete_by_user_id)。",
  "description_for_human": "基於阿里雲 Elasticsearch 驅動的 Agent 記憶平台。",
  "auth": {
    "type": "token",
    "token_header": "Authorization",
    "token_prefix": "Token"
  },
  "api": {
    "type": "python",
    "main_file": "handler.py",
    "functions": [
      {
        "name": "add",
        "description": "從會話中提取事實,使用者偏好或習慣並進行持久化。",
        "parameters": {
          "type": "object",
          "properties": {
            "user_id": { "type": "string", "description": "user id" },
            "context": { "type": "string", "description": "會話內容" }
          },
          "required": ["user_id", "context"]
        }
      },
      {
        "name": "search",
        "description": "檢索使用者層級的歷史記憶(跨會話)。",
        "parameters": {
          "type": "object",
          "properties": {
            "user_id": { "type": "string", "description": "user id" },
            "query": { "type": "string", "description": "檢索條件" }
          },
          "required": ["user_id", "query"]
        }
      },
      {
        "name": "delete_by_run_id",
        "description": "清空 run id 對應的歷史記憶。",
        "parameters": {
          "type": "object",
          "properties": {
            "run_id": { "type": "string", "description": "run id" }
          },
          "required": ["run_id"]
        }
      },
      {
        "name": "delete_by_user_id",
        "description": "清空 user id 對應的歷史記憶。",
        "parameters": {
          "type": "object",
          "properties": {
            "user_id": { "type": "string", "description": "user id" }
          },
          "required": ["user_id"]
        }
      }
    ]
  }
}
handler.py:
將
$Mem0_HOST替換為步驟二中 Mem0 Server 的實際地址:如果 Mem0 Server 和 OpenClaw 在同一台 ECS,使用
http://127.0.0.1:8420如果在不同機器,使用 Mem0 Server 的內網或公網 IP 位址
import json
import subprocess

HOST = "$Mem0_HOST"

def _run_safe_curl(url, payload, method='POST'):
    if payload is not None:
        input_data = json.dumps(payload, ensure_ascii=False)
    else:
        input_data = ""

    cmd = [
        "curl", "-s", "-X", method, url,
        "-H", "Content-Type: application/json",
        "--data-binary", "@-",
        "--max-time", "15",
        "--no-buffer"
    ]

    try:
        input_data = json.dumps(payload)

        result = subprocess.run(
            cmd, input=input_data, capture_output=True,
            text=True, check=True, encoding='utf-8'
        )

        output = result.stdout.strip()
        if not output:
            return {"status": "success"}
        return json.loads(output)

    except subprocess.CalledProcessError as e:
        return {"error": f"Curl command failed: {e.stderr}"}
    except Exception as e:
        return {"error": str(e)}

def add(user_id, context):
    url = f"{HOST}/v1/memories"
    payload = {
        "messages": [
            {"role": "user", "content": context}
        ],
        "user_id": str(user_id)
    }
    return _run_safe_curl(url, payload, method='POST')

def search(user_id, query):
    url = f"{HOST}/v2/memories/search"
    payload = {
        "query": query,
        "user_id": str(user_id)
    }
    return _run_safe_curl(url, payload, method='POST')

def delete_by_run_id(run_id):
    url = f"{HOST}/v1/memories?run_id={run_id}"
    return _run_safe_curl(url, payload=None, method='DELETE')

def delete_by_user_id(user_id):
    url = f"{HOST}/v1/memories?user_id={user_id}"
    return _run_safe_curl(url, payload=None, method='DELETE')
SKILL.md:
---
name: agentic memory
description: 基於 Mem0 + Elasticsearch 的記憶平台。
allowed-tools:
  - add
  - search
  - delete_by_run_id
  - delete_by_user_id
metadata:
  category: memory
  provider: elasticsearch
---

# Instructions
你現在已擁有由 Elasticsearch 驅動的記憶儲存。該 skill 整合了 Mem0 + Elasticsearch 服務,為 OpenClaw 提供長期記憶能力,取代原生.md檔案儲存體,它能夠實現對使用者偏好、事實記憶和事件關係的精確提取及毫秒級檢索,支援跨會話的知識持久化。請遵循以下原則:
1. 主動記憶:捕捉核心事實(身份、技能)或明確偏好(習慣、禁忌)。
   - 使用者提到"我正在開發 Agent 助手"時,調用 add。
   - 使用者表示偏好"我喜歡先計劃好再開始執行"、"我在工作的時候不喜歡被打擾",調用 add。
2. 上下文檢索:啟動新任務或追溯歷史時,調用 search 擷取記憶,確保對話連貫。
3. 記憶遺忘:使用者放棄了某項決策(例如"我不想再糾結這個問題了"),調用 delete_by_run_id。刪除 run id 對應記憶。
4. 記憶清除:使用者決定清除所有記憶,調用 delete_by_user_id。刪除 user id 對應記憶。

# Tools
## Memory Management (Mem0 + Elasticsearch)
該工具集提供基於 Mem0 + Elasticsearch 的記憶能力,使智能體能夠跨不同會話持久化儲存、檢索記憶。

### 1. add
- **描述**: 從會話中提取事實,使用者偏好或習慣並進行持久化。
- **所需參數**:
  - `user_id` (string): 使用者唯一標識。
  - `context` (string): 會話內容。
- **返回**: 包含操作狀態或新儲存記錄 ID 的對象。

### 2. search
- **描述**: 檢索使用者層級的歷史記憶(跨會話)。
- **所需參數**:
  - `user_id` (string): 使用者唯一標識。
  - `query` (string): 檢索條件。
- **返回**: 包含按相關性排序的結果。

### 3. delete_by_run_id
- **描述**: 清空 run id 對應的歷史記憶。
- **所需參數**:
  - `run_id` (string): 用於隔離短期會話或臨時流程的實體標識符。適用於支援工單、聊天會話、實驗等需要獨立重設或到期的情境。
- **返回**: 操作確認資訊。

### 4. delete_by_user_id
- **描述**: 清空 user id 對應的歷史記憶。
- **所需參數**:
  - `user_id` (string): 使用者唯一標識。
- **返回**: 操作確認資訊。

# Output Format
1. **自然融合**: 禁止提及"搜尋記憶"等術語。將事實作為已知背景直接嵌入回複(如:"基於你正在學習 Rust,建議...")。
2. **上下文感知**: 優先使用檢索到的事實進行個人化決策,提供定製化的技術指導。
3. **優雅處理**: 若未檢索到相關記憶,直接產生高品質回應,嚴禁提及"未找到記憶"或"搜尋失敗"。
4. **動作反饋**: 調用 add 成功後,在回複結尾以簡潔自然的方式確認(如:"已記下你的偏好"),避免機械化的系統提示。

# 樣本
### 情境 1: 記憶添加(Add)
**使用者輸入**: "我計划下個月擴容 Elasticsearch 服務。"
**動作**: add(user_id="user_01", context="計划下個月擴容 Elasticsearch")

### 情境 2: 記憶檢索 (Search)
**使用者輸入**:"幫我查看我之前的擴容計劃"
**動作**: search(user_id="user_01", query="擴容計劃")

### 情境 3:記憶遺忘(Delete by run id)
**使用者輸入**: "忘掉之前的擴容計劃吧,我們不打算擴容了。"
**動作**: delete_by_run_id(run_id="run_01")

### 情境 4:使用者記憶清除(Delete by user id)
**使用者輸入**: "清除本使用者所有記憶。"
**動作**: delete_by_user_id(user_id="user_01")

# Tags
`Memory-as-a-Service` `Elasticsearch` `Mem0`

# Limitations
- **複雜度限制**: 避免將極長的段落作為單一事實儲存;請將其拆分為較短的、具有語義定義的陳述,以獲得更好的檢索準確性。
重新整理 Skills 或重啟 OpenClaw Gateway。
步驟四:驗證效果
完成 Mem0 Server 部署後,您可以通過以下方式驗證記憶系統功能:
記憶寫入:
在網關聊天介面發送
/new開啟新會話,然後發送"記住我家裡有寶寶。",若 Assistant 的回複確認已記住該資訊,則表明基於 Mem0 + Elasticsearch 的 agentic memory 記憶寫入成功。記憶檢索:
在網關聊天介面發送
/new開啟新會話,使用者僅輸入"幫我推薦一款洗碗機,需要支援軟水鹽自動提醒",未提及家庭成員資訊。若 Assistant 的回複自動引用了已記錄的記憶,則表明系統基於 Mem0 + Elasticsearch 驅動的 agentic memory 從歷史會話中召回了使用者家有寶寶的上下文,跨會話記憶檢索生效。
上述樣本基於阿里雲託管的 OpenClaw 搭建,支援快速一鍵部署。如需本地部署,參見 OpenClaw GitHub 倉庫。