Um throughput de I/O elevado em uma instância pode degradar o desempenho das consultas. Este tópico descreve como visualizar o throughput de I/O e solucionar problemas relacionados a I/O alto.
Contexto
O desempenho de I/O é medido principalmente por IOPS e throughput de I/O. Raramente os IOPS se tornam um gargalo de desempenho. No entanto, o throughput de I/O pode causar gargalos ao atingir seu limite superior.
Limites de throughput de I/O
-
Instâncias que usam SSDs locais premium
Instâncias com SSDs locais premium compartilham os SSDs locais do mesmo host físico. Apenas o IOPS máximo de uma única instância é limitado, enquanto o throughput de I/O não possui essa restrição. Como resultado, o throughput de I/O de uma única instância pode exceder 1 GB/s. Contudo, essa arquitetura compartilhada pode levar à contenção de recursos de I/O. Para obter recursos de I/O dedicados, selecione dedicated host instance types.
-
Instâncias que usam discos cloud
Instâncias com discos cloud possuem recursos de I/O dedicados e isolados, pois cada instância tem seu próprio disco cloud anexado. O limite superior de throughput de I/O para uma única instância depende dos dois fatores a seguir:
Especificações da instância: As especificações de computação para instâncias do ApsaraDB RDS for SQL Server que utilizam discos cloud baseiam-se principalmente nas famílias de instâncias ECS de geração g6. O throughput de I/O está sujeito aos the limits of the corresponding specifications.
Tipo e capacidade de armazenamento: Instâncias do ApsaraDB RDS for SQL Server com discos cloud suportam tipos de armazenamento que incluem SSDs padrão, ESSD . O throughput de I/O desses tipos é limitado pelo the corresponding storage type and capacity.
Visualizar o throughput de I/O
Este recurso não está disponível para instâncias do ApsaraDB RDS for SQL Server 2008 R2 que utilizam discos cloud.
Acesse a página Instances. Na barra de navegação superior, selecione a região onde a instância RDS está localizada. Em seguida, localize a instância RDS e clique em ID da instância.
No painel de navegação à esquerda, escolha Autonomy Services > Performance Optimization e clique em aba Performance Insight.
-
No canto superior direito, clique em Custom metric, selecione as métricas de desempenho relacionadas a I/O Throughput e clique em OK.
NotaA categoria I/O Throughput inclui as seguintes métricas de desempenho:
IO_Throughput_Read_Kb: Throughput de I/O de leitura do disco, em KB/s.
IO_Throughput_Write_kb: Throughput de I/O de gravação do disco, em KB/s.
IO_Throughput_Total_Kb: Soma dos throughputs de I/O de leitura e gravação do disco, em KB/s.
Análise e otimização do throughput de I/O
A carga de I/O em uma instância do ApsaraDB RDS for SQL Server consiste principalmente em solicitações de leitura para arquivos de dados e solicitações de leitura/gravação para arquivos de log de transações. As solicitações de leitura de arquivos de dados originam-se primordialmente de leituras de páginas de dados durante consultas e backups de banco de dados. Já os arquivos de log de transações sofrem alta carga de I/O de leitura durante backups e, nas demais situações, apresentam predominantemente carga de I/O de gravação.
Caso observe um throughput de I/O elevado na sua instância, adicione as métricas de desempenho abaixo no painel Custom metric para analisar qual tipo de carga causa o aumento.
|
Métrica |
Tipo |
Descrição |
|
Page_Reads |
Leitura |
Quantidade de páginas de dados lidas dos arquivos de dados por segundo devido a uma falha de cache. |
|
Page_Write |
Gravação |
Quantidade de páginas de dados gravadas nos arquivos de dados por segundo. |
|
Log_Bytes_Flushed/sec |
Gravação |
Volume de bytes gravados nos arquivos de log por segundo. |
|
Backup_Restore_Throughput/sec |
Leitura |
Volume de bytes lidos e gravados em arquivos de dados e log por segundo durante operações de backup ou restauração. |
Cada página de dados tem tamanho de 8 KB.
Estudo de caso
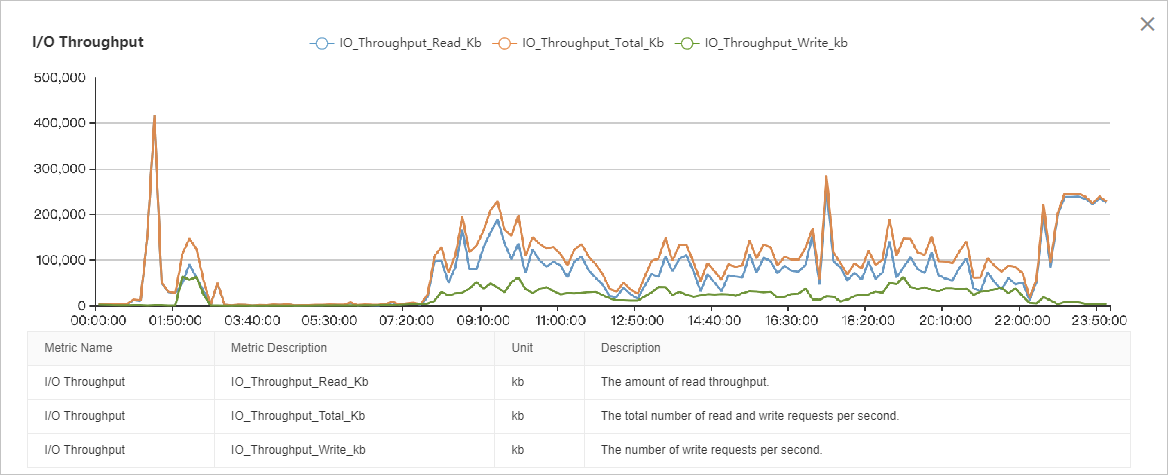
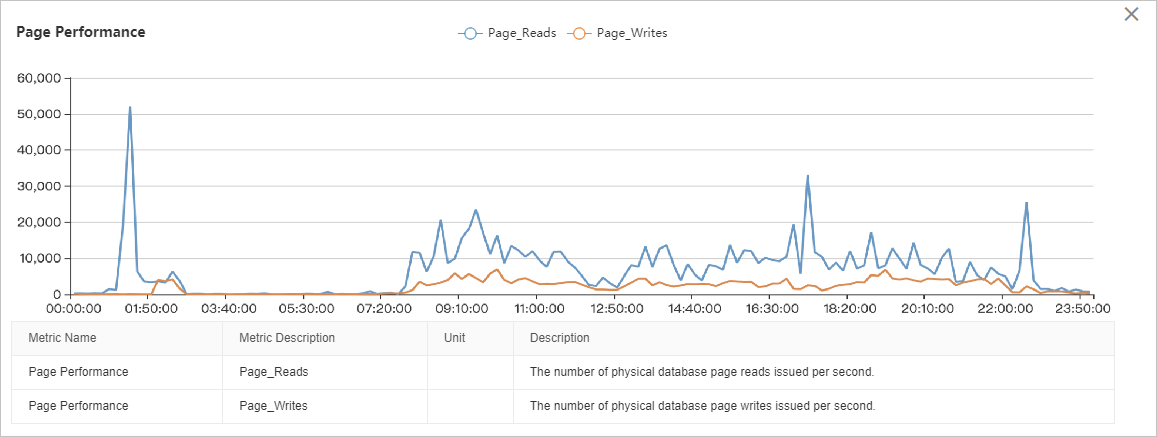
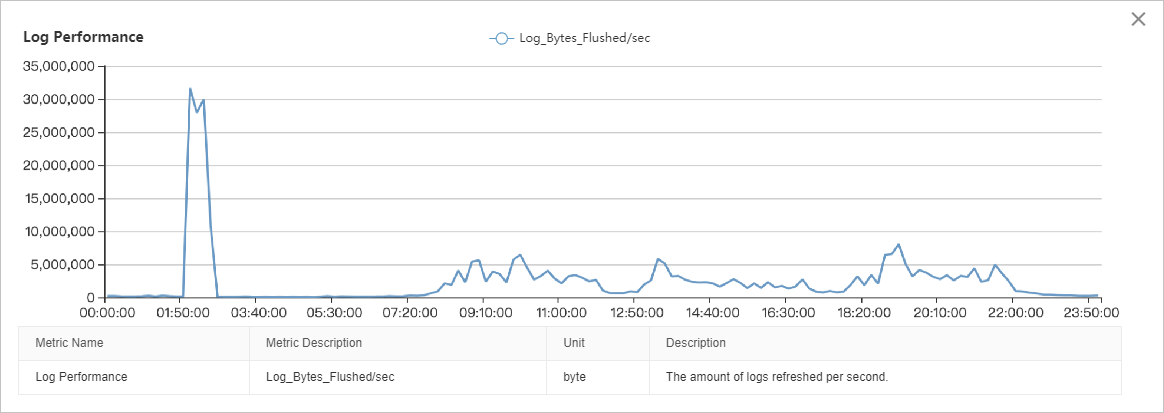
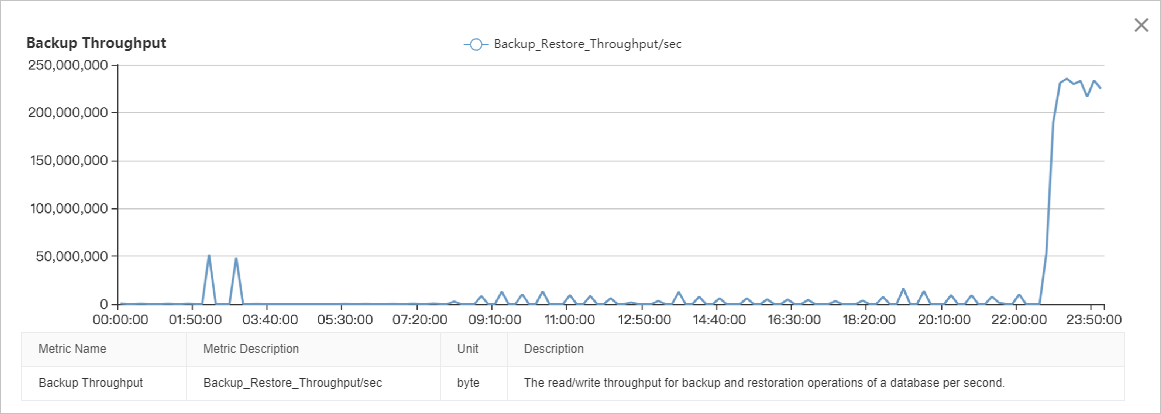
O gráfico de throughput de I/O mostra que o I/O de leitura é significativamente maior que o de gravação. A carga de I/O permanece relativamente estável entre 08:00 e 22:00, com dois picos distintos: um entre 01:00 e 03:00 e outro entre 22:00 e 00:00. Uma análise detalhada exige a correlação desses dados com outras métricas de desempenho.
As métricas de desempenho de páginas indicam que o pico de throughput de I/O por volta das 01:00 foi causado por leituras de páginas de dados, atingindo aproximadamente 50.000 páginas por segundo, o que equivale a 400 MB/s.
As métricas de throughput de páginas, logs e backups revelam que o pico de I/O entre 02:00 e 03:00 resultou da combinação de leituras de páginas de dados (pico de ~40 MB/s), gravações de páginas de dados (pico de ~40 MB/s), gravações em arquivos de log (pico de ~30 MB/s) e backups de log (pico de ~50 MB/s). O throughput acumulado de I/O atingiu cerca de 150 MB/s.
As métricas de páginas e logs demonstram que o throughput de I/O entre 08:00 e 22:00 compõe-se majoritariamente por leituras de páginas de dados (~80-100 MB/s), seguidas por gravações de páginas de dados (~30 MB/s) e gravações em arquivos de log (~5 MB/s).
A métrica de throughput de backup evidencia que o pico de I/O entre 22:00 e 00:00 deve-se inteiramente aos backups, mantendo-se consistentemente acima de 220 MB/s.
Throughput elevado de I/O por leituras de páginas de dados
O alto throughput de I/O proveniente de leituras de páginas de dados (Page Reads) figura entre as causas mais comuns de I/O elevado em instâncias do ApsaraDB RDS for SQL Server. Isso ocorre principalmente devido à memória insuficiente para o buffer pool. Quando as consultas não encontram os dados necessários no cache (falha de cache), o sistema precisa ler um grande volume de páginas de dados diretamente do disco.
Uma métrica fundamental para diagnosticar o desempenho do cache é a Page Life Expectancy (PLE). Ela representa o tempo médio, em segundos, que uma página de dados permanece no buffer pool. Um valor de PLE mais baixo indica maior pressão de memória sobre a instância.
Como regra geral, mantenha um valor de PLE de pelo menos 300 segundos. Para instâncias com mais memória, recomenda-se um limiar mais alto. Utilize a seguinte fórmula:
Recommended threshold = (Buffer pool size in GB / 4) × 300
Por exemplo, em uma instância com 16 GB de memória, a memória disponível para o buffer pool não excede 12 GB. O limiar recomendado é: (12 / 4) * 300 = 900 (seconds)
Para mais informações, consulte Page Life Expectancy (PLE) in SQL Server.
Se o throughput elevado de I/O for causado por leituras de páginas de dados, recomendamos upgrading the memory specifications da instância em vez de aumentar o nível de desempenho (PL) do disco.
No nível do banco de dados, também é possível reduzir a carga de leitura de páginas de dados diminuindo o número total de páginas. Por exemplo, arquive ou limpe dados históricos, ative a compressão de dados de tabelas, exclua índices de baixo valor ou desfragmente índices.
Throughput elevado de I/O por gravações em páginas de dados e arquivos de log
Ao enfrentar throughput alto de I/O devido a gravações em páginas de dados e arquivos de log, utilize o Autonomy Services para verificar a ocorrência frequente de operações DML (Data Manipulation Language), como INSERT, DELETE, UPDATE e MERGE, ou operações DDL (Data Definition Language), como CREATE INDEX e ALTER INDEX, durante o período de alto throughput. Considere as soluções a seguir:
-
Operações de gravação DML
Primeiramente, determine se essas são operações rotineiras de negócio. Caso não sejam, como em processamentos temporários de dados ou arquivamentos, execute-as fora do horário de pico. Se forem rotineiras, recomendamos upgrading the disk performance level (PL), por exemplo, de ESSD PL1 para PL2.
Também sugerimos otimizar a estrutura de índices e excluir índices não clusterizados desnecessários.
-
Operações de gravação DDL
Geralmente, trata-se de operações de manutenção ou temporárias. Execute-as fora do horário de pico.
Além disso, ao criar ou recriar índices, use a opção MAXDOP nas instruções SQL para limitar o grau de paralelismo. Essa prática reduz o pico de throughput de I/O durante a operação, mas aumenta o tempo total de execução da operação DDL.
Throughput elevado de I/O por backups
Atualmente, o ApsaraDB RDS for SQL Server suporta backups de dados apenas na instância primária. Isso aumenta o throughput de I/O do disco nessa instância. Backups completos causam o impacto mais significativo, enquanto backups de log têm um impacto menor.
Como os backups são essenciais para a segurança e confiabilidade dos dados, recomendamos que você configure a suitable backup schedule para minimizar o impacto nos seus negócios.
É possível visualizar a duração dos backups de dados na página Restoration da sua instância. Use essas informações para escolher um horário de backup adequado que evite os horários de pico de negócio.
Clique em aba Data Backup e calcule a duração do backup utilizando as colunas Backup Start Time e Backup End Time na tabela.
Se um backup completo leva cerca de 6 horas, seu horário de pico de negócio vai das 09:00 às 21:00 e tarefas de processamento de dados em segundo plano rodam das 22:00 à 01:00, defina o início do backup entre 01:00 e 02:00. Assim, o backup completo termina antes das 08:00. Configure também o ciclo de backup como diário, o que melhora a eficiência das operações de restauração.
Caso um backup completo demore aproximadamente 15 horas e executá-lo em qualquer horário durante a semana afete seus negócios, considere definir o ciclo de backup para fins de semana (sábado e domingo). Entretanto, essa abordagem pode aumentar o tempo necessário para recuperação point-in-time.
Se ajustar o horário de backup não evitar conflitos entre backups completos e operações de negócio, considere atualizar o nível de desempenho (PL) do disco ou distribuir seus dados em várias instâncias para reduzir o volume de dados em uma única instância. Isso encurta o tempo necessário para realizar um backup completo.