O pgvector adiciona armazenamento de vetores e busca por similaridade ao ApsaraDB RDS for PostgreSQL. Armazene embeddings de modelos de machine learning e consulte-os por distância cosseno, distância euclidiana ou produto interno.
Como funciona
Embeddings são representações numéricas de dados — texto, imagens, áudio ou vídeo — expressas como vetores em um espaço de alta dimensão. Objetos semanticamente semelhantes correspondem a vetores próximos.
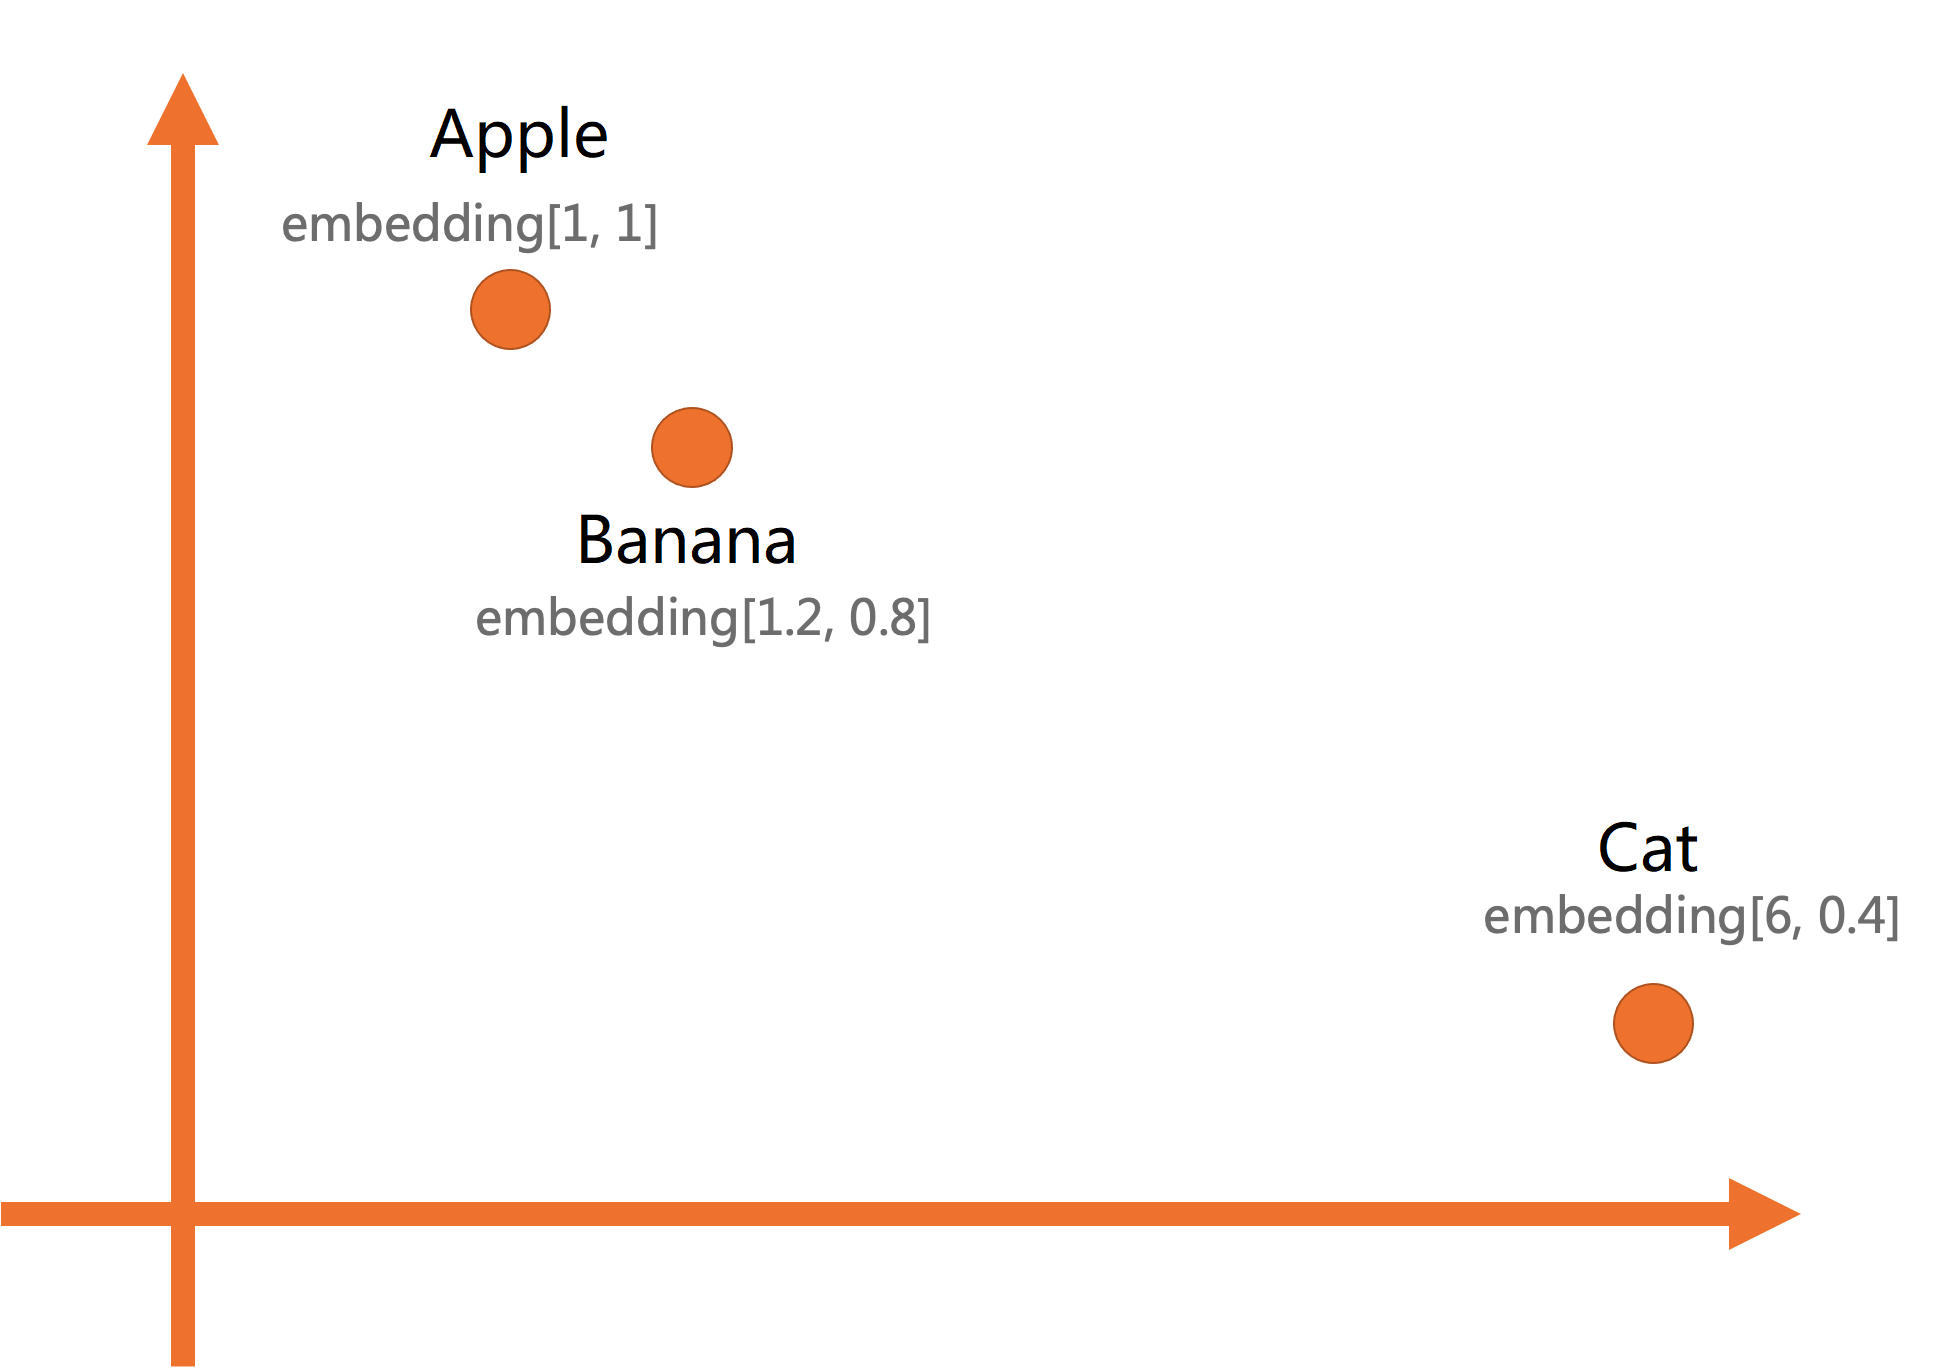
Por exemplo, se você representar uma maçã como [1, 1], uma banana como [1.2, 0.8] e um gato como [6, 0.4], a busca vetorial classificará a banana como mais semelhante à maçã, pois ambas compartilham propriedades de frutas.
O pgvector oferece suporte a:
Buscas exatas e aproximadas do vizinho mais próximo (ANN)
Índices Hierarchical Navigable Small World (HNSW) e índices paralelos IVFFLAT para busca ANN rápida
Vetores com até 16.000 dimensões; índices em vetores com até 2.000 dimensões
Métricas de distância: distância euclidiana L2, similaridade de cosseno e produto interno
Operações adicionais: distância L1, multiplicação elemento a elemento e agregação de soma
Pré-requisitos
Verifique se:
A instância RDS executa o PostgreSQL 14 ou posterior, com versão secundária do mecanismo 20230430 ou superior. Para o PostgreSQL 17, a versão secundária do mecanismo deve ser 20241030 ou superior.
Existe uma conta privilegiada para a instância RDS.
Para atualizar a versão principal do mecanismo, consulte Atualizar a versão principal do mecanismo de uma instância ApsaraDB RDS for PostgreSQL . Para atualizar a versão secundária do mecanismo, consulte Atualizar a versão secundária do mecanismo de uma instância ApsaraDB RDS for PostgreSQL . Para criar uma conta privilegiada, consulte Criar uma conta .
Instalar a extensão
Instale pelo console (recomendado)
Acesse a página Instances. Na barra de navegação superior, selecione a região onde a instância RDS está localizada. Clique em ID da instância.
No painel de navegação à esquerda, clique em Plug-ins.
-
Na aba Extension Marketplace, localize a extensão de vetor e clique em Install. Alternativamente, mude para a aba Extension Management, pesquise a extensão de vetor e clique em Install na coluna Actions.
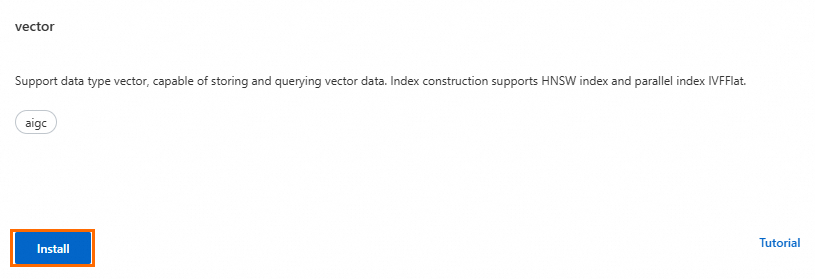
Na caixa de diálogo, defina Database Name e Database Account e clique em Install.
A instalação da extensão é concluída quando o status da instância muda de Maintaining Instance para Running.
Para atualizar ou desinstalar a extensão:
Na aba Extension Management, acesse Installed Extensions, localize a extensão e clique em Upgrade Version ou Uninstall na coluna Actions.
Se Upgrade Version não estiver visível, a extensão já está na versão mais recente.
Instale com SQL
Essas operações exigem uma conta privilegiada. Para criar uma, consulte Criar uma conta.
-- Create
CREATE EXTENSION IF NOT EXISTS vector;

-- Update
ALTER EXTENSION vector UPDATE [ TO new_version ];

-- Delete
DROP EXTENSION vector;
new_version é a versão de destino da extensão pgvector. Para histórico de versões e recursos, consulte a documentação do pgvector .Armazenar e consultar vetores
Armazene embeddings e execute buscas por similaridade com o pgvector. Para a referência completa da API, consulte a documentação do pgvector.
Crie uma tabela
CREATE TABLE items (
  id        bigserial PRIMARY KEY,
  item      text,
  embedding vector(2)
);
Este exemplo usa vetores bidimensionais para ilustração. O pgvector suporta até 16.000 dimensões.
Inserir vetores
INSERT INTO items (item, embedding)
VALUES
  ('Apple',  '[1,1]'),
  ('Banana', '[1.2,0.8]'),
  ('Cat',    '[6,0.4]');
Consultar por similaridade
Use um operador de distância para classificar os resultados por similaridade. Quanto menor a distância, mais semelhantes são os itens.
Operadores de distância:
|
Operador |
Métrica |
|
|
Distância L2 (Euclidiana) |
|
|
Distância de cosseno |
|
|
Produto interno |
Consulta básica de similaridade:
-- Find items most similar to Banana, ranked by cosine distance
SELECT item,
       embedding <=> '[1.2, 0.8]' AS cosine_distance
FROM items
ORDER BY cosine_distance;
Saída de exemplo:
  item  |    cosine_distance
--------+------------------------
 Banana |                      0
 Apple  | 0.019419362524530137
 Cat    | 0.13289443670962842
Uma distância de
0indica correspondência exata.O valor
0.019representa alta similaridade.Já
0.133sinaliza baixa similaridade.
Especifique um limiar de similaridade para filtrar resultados com baixa correspondência.
Criar índices
Sem um índice, o pgvector varre toda a tabela em busca de correspondências exatas. Para grandes conjuntos de dados, crie um índice vetorial para acelerar as buscas aproximadas do vizinho mais próximo (ANN).
Crie um índice HNSW
CREATE INDEX ON items USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
Parâmetros:
|
Parâmetro |
Descrição |
|
|
Número máximo de conexões por nó em cada camada. Valores maiores aumentam a densidade do grafo e o recall, mas tornam a criação do índice e as consultas mais lentas. |
|
|
Tamanho do conjunto de candidatos durante a construção do índice. Valores mais altos melhoram o recall, porém reduzem a velocidade de criação do índice. |
Métodos de acesso (campo vector_cosine_ops):
|
Valor |
Métrica de distância |
|
|
Distância de cosseno |
|
|
Distância L2 (Euclidiana) |
|
|
Produto interno |
Crie um índice IVF
CREATE INDEX ON items USING ivfflat (embedding vector_cosine_ops)
WITH (lists = 100);
Parâmetros:
|
Parâmetro |
Descrição |
|
|
Quantidade de listas nas quais o conjunto de dados é particionado. Mais listas resultam em buscas mais rápidas, mas podem reduzir o recall. Se |
|
|
Número de listas a serem verificadas durante uma consulta. Mais probes melhoram o recall, mas tornam a busca mais lenta. |
Defina ivfflat.probes no nível de sessão ou transação:
-- Session level
SET ivfflat.probes = 10;

-- Transaction level
BEGIN;
SET LOCAL ivfflat.probes = 10;
SELECT ...;
COMMIT;Se ivfflat.probes for igual ao valor de lists usado na criação do índice, o sistema ignorará o índice e executará uma varredura completa da tabela. Isso pode degradar significativamente o desempenho da busca.
Ajuste ivfflat.probes juntamente com lists com base no seu conjunto de dados e nos requisitos de recall.
Dados de desempenho
Para dados de benchmark sobre índices HNSW e IVF, consulte:
Próximos passos
Crie aplicações de IA em produção usando o pgvector: